Ripple-65B mueve un agente de programación en una tarjeta de 48 GB, despacio y sin fallos
Ripple-65B a 4 bits en una RTX A6000: unos 15 tokens/s y un bug plantado arreglado en 6 turnos. Una RTX 3090 de 24 GB lo mueve a 2 bits, con un test mal.
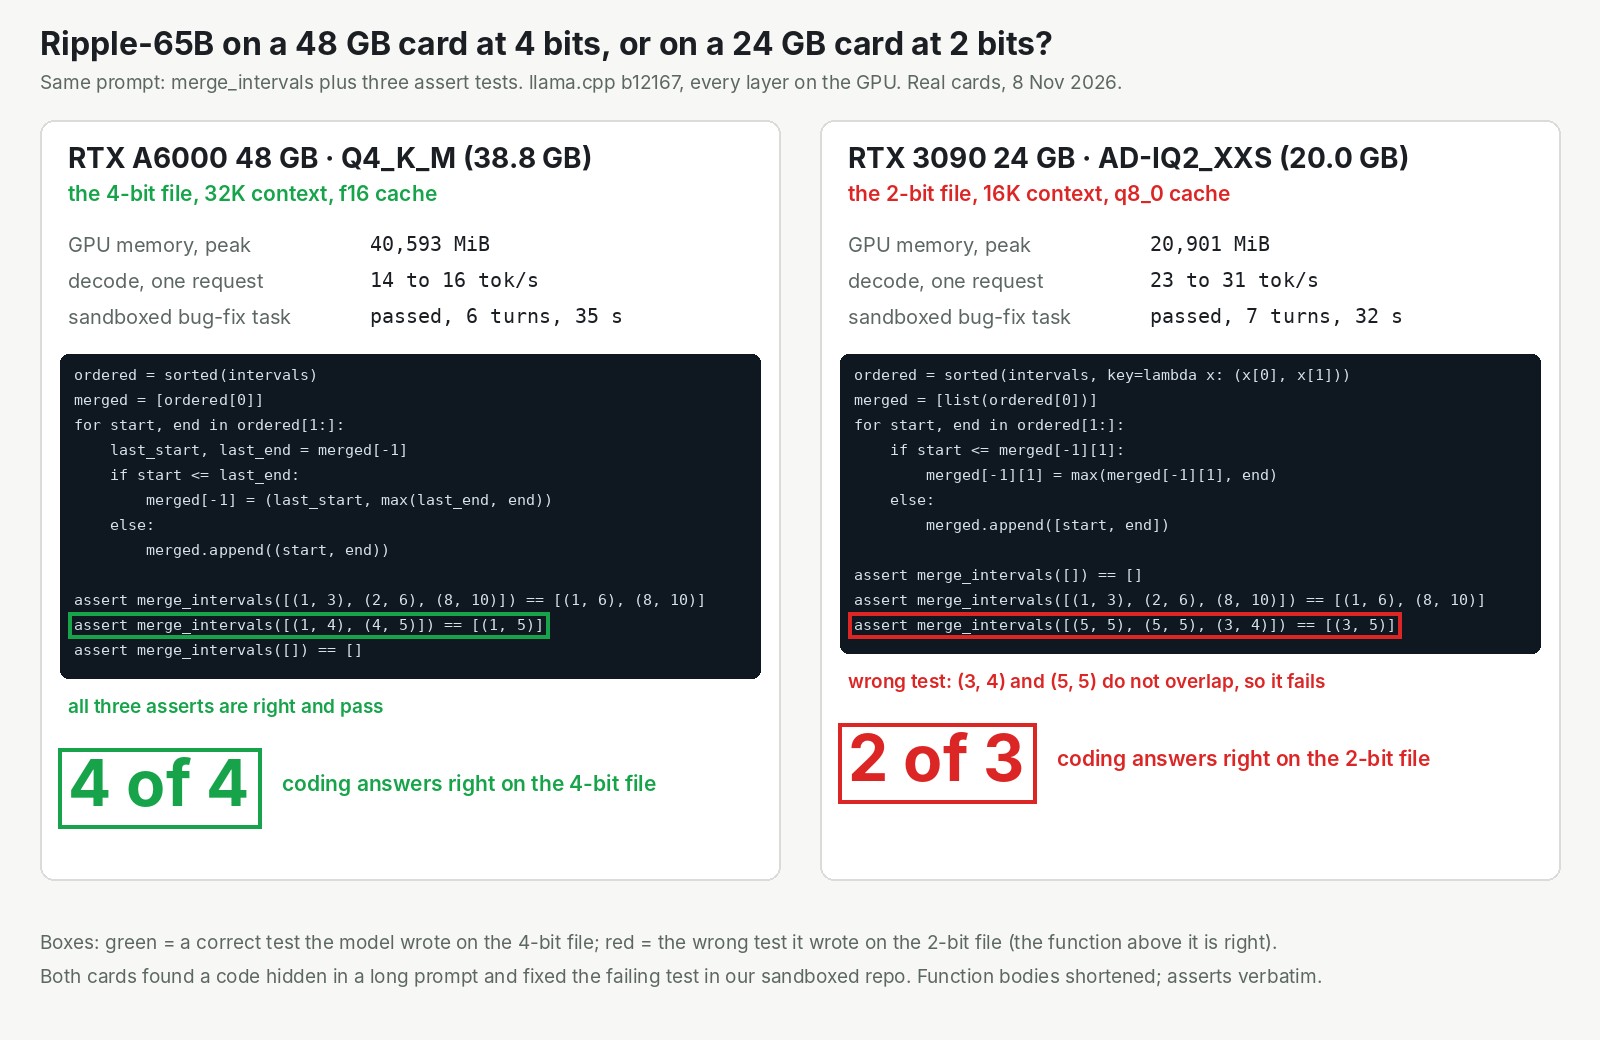
¿Puede un equipo ejecutar un nuevo modelo abierto de programación de 65B parámetros en una sola tarjeta alquilada por horas? Sí, si la tarjeta tiene 48 GB y no te importa esperar. Ripple-65B Preview, del laboratorio estadounidense Ricursive Intelligence, funcionó en una sola RTX A6000 de nuestra nube con un fichero de 4 bits de 38,8 GB. Escribió unos 15 tokens (más o menos palabras) por segundo. Arregló un bug que plantamos en un repositorio de juguete en 6 turnos y 35 segundos, y todas sus llamadas a herramientas fueron válidas. Para quien despliega modelos, eso es un agente de programación con licencia Apache 2.0 que controlas tú, en hardware que puedes alquilar hoy. Una RTX 3090 de 24 GB también lo mueve, a 2 bits y más rápido, pero una de sus tres respuestas de programación llegó con un test mal hecho. La tarjeta de 48 GB dio el resultado limpio.
Un modelo de programación abierto hecho desde cero, y una comunidad que lo portó en dos días
Ricursive entrenó Ripple desde cero y lo regala con licencia Apache 2.0, sin formulario que rellenar. Los pesos se subieron a Hugging Face el 4 de noviembre. Los autores dicen que se entrenó con 12 billones de tokens y que lee prompts de hasta un millón, más o menos.
Su cifra estrella es en Terminal-Bench 2.1, una prueba de agentes que trabajan en la línea de comandos: 80,5, que en su propia tabla es una ventaja de 0,4 puntos sobre Reflection Beam, un modelo de 501B. En la práctica, un empate, y declarado por ellos mismos: los propios autores lo llaman un "best-effort attempt". En la mayoría de las demás filas de esa misma tabla va por delante algún rival. En SWE-bench Verified, construido sobre issues reales de GitHub, Ripple saca 76,5 frente a 81,6 de Reflection Beam. Un resultado abierto sólido, no la pretensión de superar a los mejores modelos cerrados de programación.
Las versiones propias de Ricursive apuntan a hardware de centro de datos que la mayoría de los equipos no tiene. El camino a una sola tarjeta vino de la comunidad. Un port de Ripple a llama.cpp, un programa gratuito para ejecutar modelos en tu propia tarjeta, se mergeó el 5 de noviembre. Lo envió Nik Bogatyrev, y la ficha de AtomicChat dice que lo escribió AtomicChat. AtomicChat publicó ficheros para llama.cpp esa misma semana, desde 129,6 GB a precisión completa hasta 18,5 GB. Lo nuestro fue el despliegue, los prompts, la tarea de agente en un sandbox y las pruebas de memoria en dos tarjetas reales.
Denso significa unos 15 tokens por segundo, y ese es el trato
Todos los rivales de la tabla de Ricursive son mezclas de expertos: cada palabra que escriben usa solo entre 23B y 55B de sus parámetros. Ripple es denso. Cada palabra pasa por los 65B enteros, así que a 4 bits la tarjeta lee casi todo el fichero de 38,8 GB de su memoria para cada palabra. La A6000 puede hacerlo unas 15 veces por segundo. El techo lo pone la velocidad de la memoria, no la aritmética.
En la práctica, eso es una respuesta de 400 tokens en unos 27 segundos, y las preguntas cortas empiezan a responderse en menos de un segundo. Para un desarrollador que maneja un agente, se puede trabajar, pero no es ágil.
Lo que vimos en la tarjeta de 48 GB
La tarea del agente era un repositorio de juguete con un error de uno (off-by-one) que hacía fallar un test. El modelo tenía una sola herramienta, una shell, dentro de un sandbox sin red. Ripple leyó el código, ejecutó los tests, vio que fallaban, cambió un <= por un <, los volvió a ejecutar e informó del resultado. No tocó los tests en ningún momento. Sus 4 respuestas de programación con el fichero de 4 bits fueron correctas, y todas las llamadas a herramientas volvieron en el formato estándar que lee el código de agentes que ya existe.
Los prompts largos salen baratos en memoria. La misma tarjeta encontró una contraseña escondida en el token 237.532, usando unos 46 GB. La pega es el tiempo: leer ese prompt llevó unos 13 minutos. Y el millón completo queda fuera de alcance en una sola tarjeta de 48 GB. Unos 256K tokens, con las notas que el modelo guarda sobre el prompt comprimidas, es su límite.
| Tarjeta | Fichero | Velocidad (tokens/s) | Respuestas de programación bien |
|---|---|---|---|
| RTX A6000 48 GB | 4 bits, 38,8 GB | 14 a 16 | 4 de 4 |
| RTX 3090 24 GB | 2 bits, 20,0 GB | 23 a 31 | 2 de 3 |
La 3090 es una tarjeta gaming real de 24 GB, no un presupuesto que simulamos. Con menos bits por número el fichero es más pequeño y se lee más rápido, pero los números son más toscos. La tarea de arreglar el bug se superó igualmente. El fallo apareció donde el modelo tenía que escribir un test nuevo por su cuenta. Eso apunta en la misma dirección que las mediciones de la propia AtomicChat: su ficha dice que el fichero de 2 bits discrepa del modelo completo en la siguiente palabra casi 20 veces de cada 100, frente a unas 7 del fichero de 4 bits.
En InferenceKey, una vez que el fichero estaba en la máquina, Ripple respondía 19,0 segundos después de pedirlo en la A6000, y 19,3 en la 3090, porque el worker descargó un llama.cpp ya compilado en lugar de compilarlo.
A quién le interesa
- Tienes una tarjeta de 48 GB y quieres un agente de programación abierto que controles tú: merece la pena probarlo. El fichero de 4 bits nos dio los resultados más limpios.
- Necesitas prompts largos: un prompt de 237K tokens entró en 48 GB. Cuenta con minutos por pregunta, no segundos.
- Tienes una tarjeta de 24 GB: el fichero de 2 bits funciona, y más rápido, pero revisa los tests que escribe.
- Necesitas velocidad por encima de todo: busca en otra parte. Al ser denso, Ripple lee el modelo entero para cada palabra.
El límite, sin rodeos: enviamos una petición cada vez con nuestros propios prompts pequeños, cada comprobación una vez o unas pocas, así que una tarjeta compartida por varios agentes irá más lenta en una proporción que no hemos medido, y esto es una Preview.
Lee la prueba completa de Ripple-65B para ver la tabla de memoria por tamaño de tarjeta, los ejemplos de llamadas a herramientas y las ejecuciones con prompts largos.