Ripple-65B fait tourner un agent de code sur une carte de 48 GB, lentement et proprement
Ripple-65B en 4 bits sur une RTX A6000 : environ 15 tokens/s, un bug planté corrigé en 6 tours. Une RTX 3090 de 24 GB le lance en 2 bits, avec un test faux.
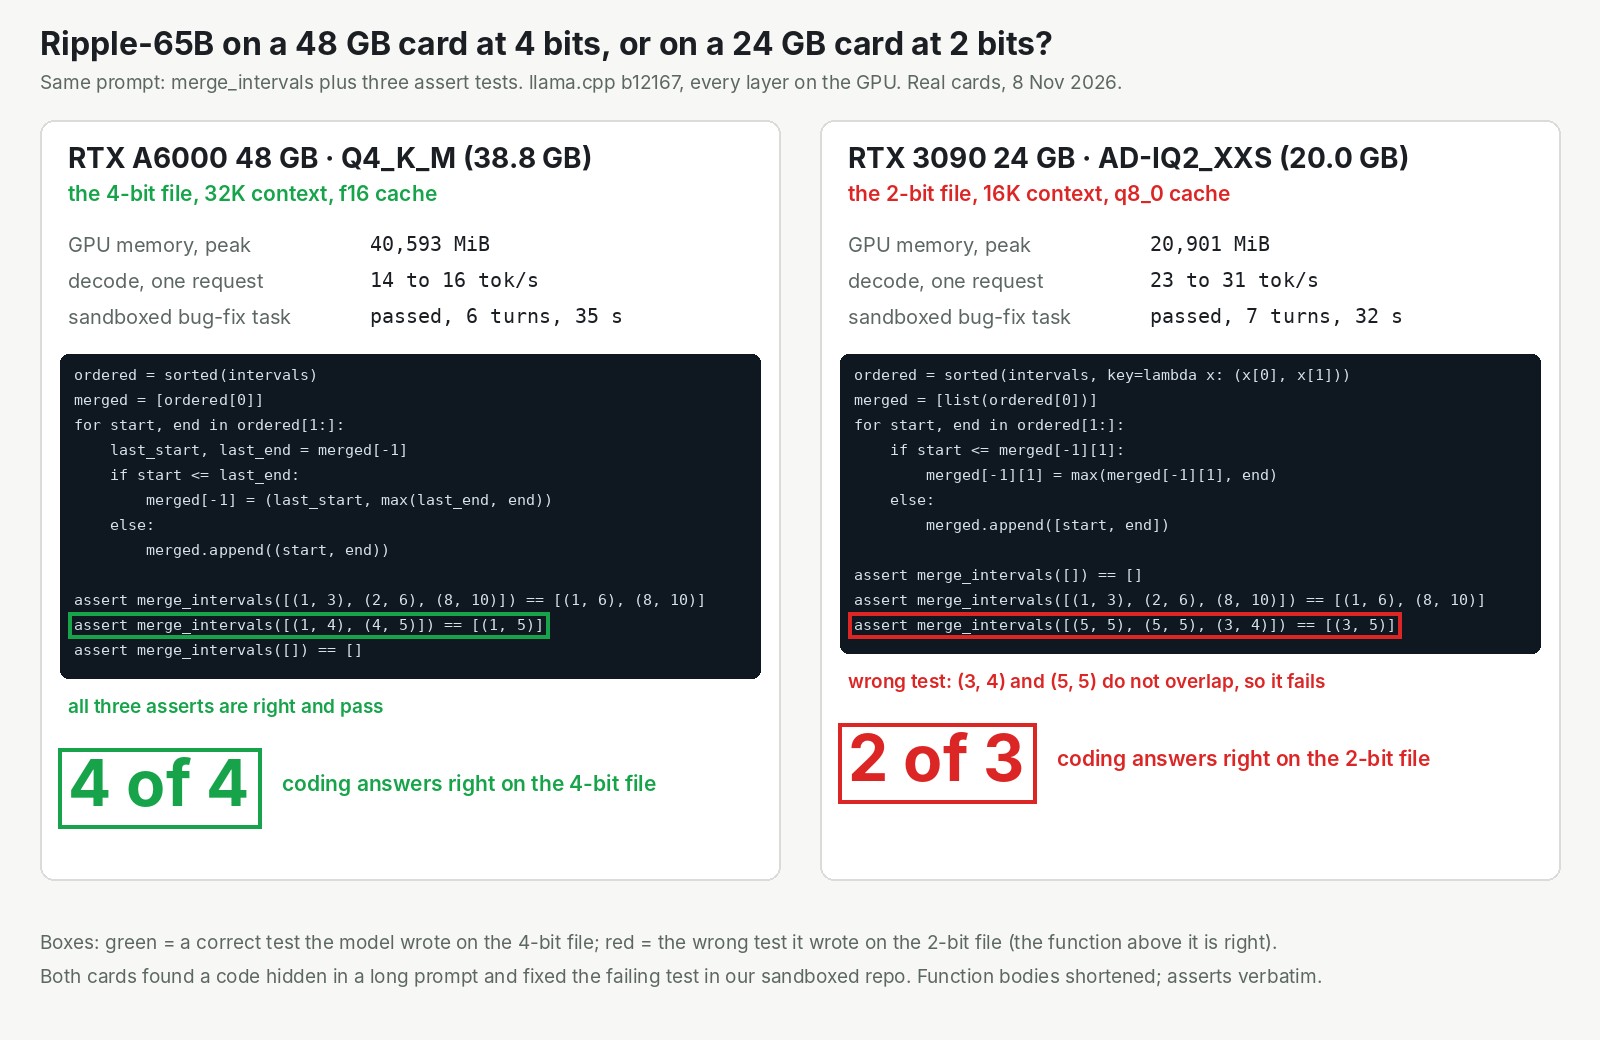
Une équipe peut-elle faire tourner un nouveau modèle de code ouvert de 65 milliards de paramètres sur une seule carte louée à l'heure ? Oui, si la carte a 48 GB et que vous savez attendre. Ripple-65B Preview, du laboratoire américain Ricursive Intelligence, a tourné sur une seule RTX A6000 de notre cloud avec un fichier 4 bits de 38,8 GB. Il a écrit environ 15 tokens (en gros, des mots) par seconde. Il a corrigé un bug que nous avions planté dans un dépôt jouet en 6 tours et 35 secondes, et chacun de ses appels d'outil était valide. Pour qui déploie des modèles, c'est un agent de code sous Apache 2.0 que vous contrôlez, sur du matériel que l'on peut louer dès aujourd'hui. Une RTX 3090 de 24 GB le fait tourner aussi, en 2 bits et plus vite, mais l'une de ses trois réponses de code est arrivée avec un test faux. La carte de 48 GB a donné le résultat propre.
Un modèle de code ouvert entraîné de zéro, et une communauté qui l'a porté en deux jours
Ricursive a entraîné Ripple de zéro et l'a distribué sous Apache 2.0, sans formulaire à remplir. Les poids ont été mis en ligne sur Hugging Face le 4 novembre. Les auteurs disent qu'il a été entraîné sur 12 000 milliards de tokens et qu'il lit des prompts allant jusqu'à environ un million.
Leur chiffre phare porte sur Terminal-Bench 2.1, un test d'agents qui travaillent en ligne de commande : 80,5, soit, dans leur propre tableau, 0,4 point d'avance sur Reflection Beam, un modèle de 501B. Autant dire une égalité, et c'est un chiffre déclaré par les auteurs : eux-mêmes parlent d'une "best-effort attempt". Sur la plupart des autres lignes du même tableau, un concurrent est devant. Sur SWE-bench Verified, construit à partir de vrais tickets GitHub, Ripple obtient 76,5 contre 81,6 pour Reflection Beam. Un bon résultat ouvert, pas une prétention à battre les meilleurs modèles de code fermés.
Les versions de Ricursive visent du matériel de data center que la plupart des équipes n'ont pas. La voie vers une seule carte est venue de la communauté. Un portage de Ripple dans llama.cpp, un programme gratuit pour faire tourner des modèles sur sa propre carte, a été fusionné le 5 novembre. Nik Bogatyrev l'a soumis, et la fiche d'AtomicChat dit qu'AtomicChat l'a écrit. AtomicChat a publié des fichiers llama.cpp la même semaine, de 129,6 GB en pleine précision jusqu'à 18,5 GB. Notre part : le déploiement, les prompts, la tâche d'agent en bac à sable et les tests de mémoire sur deux vraies cartes.
Dense veut dire environ 15 tokens par seconde, et c'est le marché
Tous les concurrents du tableau de Ricursive sont des mixtures d'experts : chaque mot qu'ils écrivent n'utilise que 23B à 55B de leurs paramètres. Ripple est dense. Chaque mot passe par les 65 milliards, donc en 4 bits la carte relit presque tout le fichier de 38,8 GB en mémoire pour chaque mot. L'A6000 sait le faire environ 15 fois par seconde. Le plafond, c'est la vitesse de la mémoire, pas le calcul.
En pratique, une réponse de 400 tokens prend environ 27 secondes, et les questions courtes commencent à recevoir leur réponse en moins d'une seconde. Pour un développeur seul qui pilote un agent, c'est utilisable, pas vif.
Ce que nous avons vu sur la carte de 48 GB
La tâche d'agent était un dépôt jouet avec une erreur de décalage d'un qui faisait échouer un test. Le modèle avait un seul outil, un shell, dans un bac à sable sans réseau. Ripple a lu le code, lancé les tests, constaté l'échec, changé un <= en <, relancé les tests et rendu compte. Il n'a jamais touché aux tests. Ses 4 réponses de code avec le fichier 4 bits étaient toutes justes, et chaque appel d'outil est revenu dans le format standard que lit le code d'agent existant.
Les longs prompts coûtent peu en mémoire. La même carte a retrouvé une phrase secrète cachée au token 237 532, en utilisant environ 46 GB. Le hic, c'est le temps : lire ce prompt a pris environ 13 minutes. Et le million complet est hors de portée sur une seule carte de 48 GB. Environ 256K tokens, avec les notes du modèle sur le prompt compressées, c'est sa limite.
| Carte | Fichier | Vitesse (tokens/s) | Réponses de code justes |
|---|---|---|---|
| RTX A6000 48 GB | 4 bits, 38,8 GB | 14 à 16 | 4 sur 4 |
| RTX 3090 24 GB | 2 bits, 20,0 GB | 23 à 31 | 2 sur 3 |
La 3090 est une vraie carte de jeu de 24 GB, pas un budget que nous avons simulé. Avec moins de bits par nombre, le fichier est plus petit et plus rapide à lire, mais les nombres sont plus grossiers. La correction de bug a quand même réussi. L'erreur est apparue là où le modèle devait écrire lui-même un nouveau test. Cela va dans le même sens que les mesures d'AtomicChat : leur fiche indique que le fichier 2 bits est en désaccord avec le modèle complet sur le mot suivant presque 20 fois sur 100, contre environ 7 pour le fichier 4 bits.
Sur InferenceKey, une fois le fichier sur la machine, Ripple répondait 19,0 secondes après que nous l'avons demandé sur l'A6000, et 19,3 sur la 3090, parce que le worker a téléchargé un llama.cpp prêt à l'emploi au lieu de le compiler.
À qui ça s'adresse
- Vous avez une carte de 48 GB et voulez un agent de code ouvert que vous contrôlez : ça vaut l'essai. Le fichier 4 bits nous a donné nos résultats les plus propres.
- Vous avez besoin de longs prompts : un prompt de 237K tokens a tenu sur 48 GB. Comptez des minutes par question, pas des secondes.
- Vous avez une carte de 24 GB : le fichier 2 bits tourne, et plus vite, mais relisez les tests qu'il écrit.
- Vous avez besoin de vitesse avant tout : cherchez ailleurs. Comme il est dense, Ripple relit tout le modèle pour chaque mot.
La limite honnête : nous avons envoyé une requête à la fois avec nos propres petits prompts, chaque vérification une fois ou quelques fois, donc une carte partagée par plusieurs agents sera plus lente, d'un écart que nous n'avons pas mesuré, et il s'agit d'une Preview.
Lisez le test complet de Ripple-65B pour le tableau de mémoire par taille de carte, les exemples d'appels d'outil et les exécutions avec de longs prompts.