LFM3-Omni-2B entend, voit et répond à voix haute sur une carte de 16 GB
Le modèle omni 2B de Liquid AI a produit 10 s de réponse parlée en environ 7 s de GPU, sur environ 5 GB de mémoire. Le serveur rapide ne parle pas encore.
Entendre, regarder, réfléchir et parler tiennent désormais dans environ 5 GB de mémoire GPU. LFM3-Omni-2B, un nouveau modèle ouvert de Liquid AI, prend de la parole, des photos et de la vidéo, et répond en texte, avec sa propre voix, ou les deux. Sur une RTX A5000 de 24 GB de notre cloud, une réponse parlée de 10 secondes a demandé environ 7 secondes de GPU. Une vraie carte de 16 GB, la RTX 2000 Ada, a donné les mêmes résultats sans ralentir. Pour une équipe qui déploie ses propres modèles, cela met toutes les étapes d'un assistant vocal sur une seule petite carte que l'on possède ou que l'on loue. Vous pouvez construire dessus dès aujourd'hui avec un backend sur mesure qui pilote le code du modèle lui-même. Deux pièges avant de vous lancer. Le serveur open source rapide pour ce modèle, SGLang, ne produit que du texte, et sa prise en charge n'est pas encore publiée. Et la licence interdit l'usage commercial dès que votre chiffre d'affaires annuel atteint 10 millions de dollars.
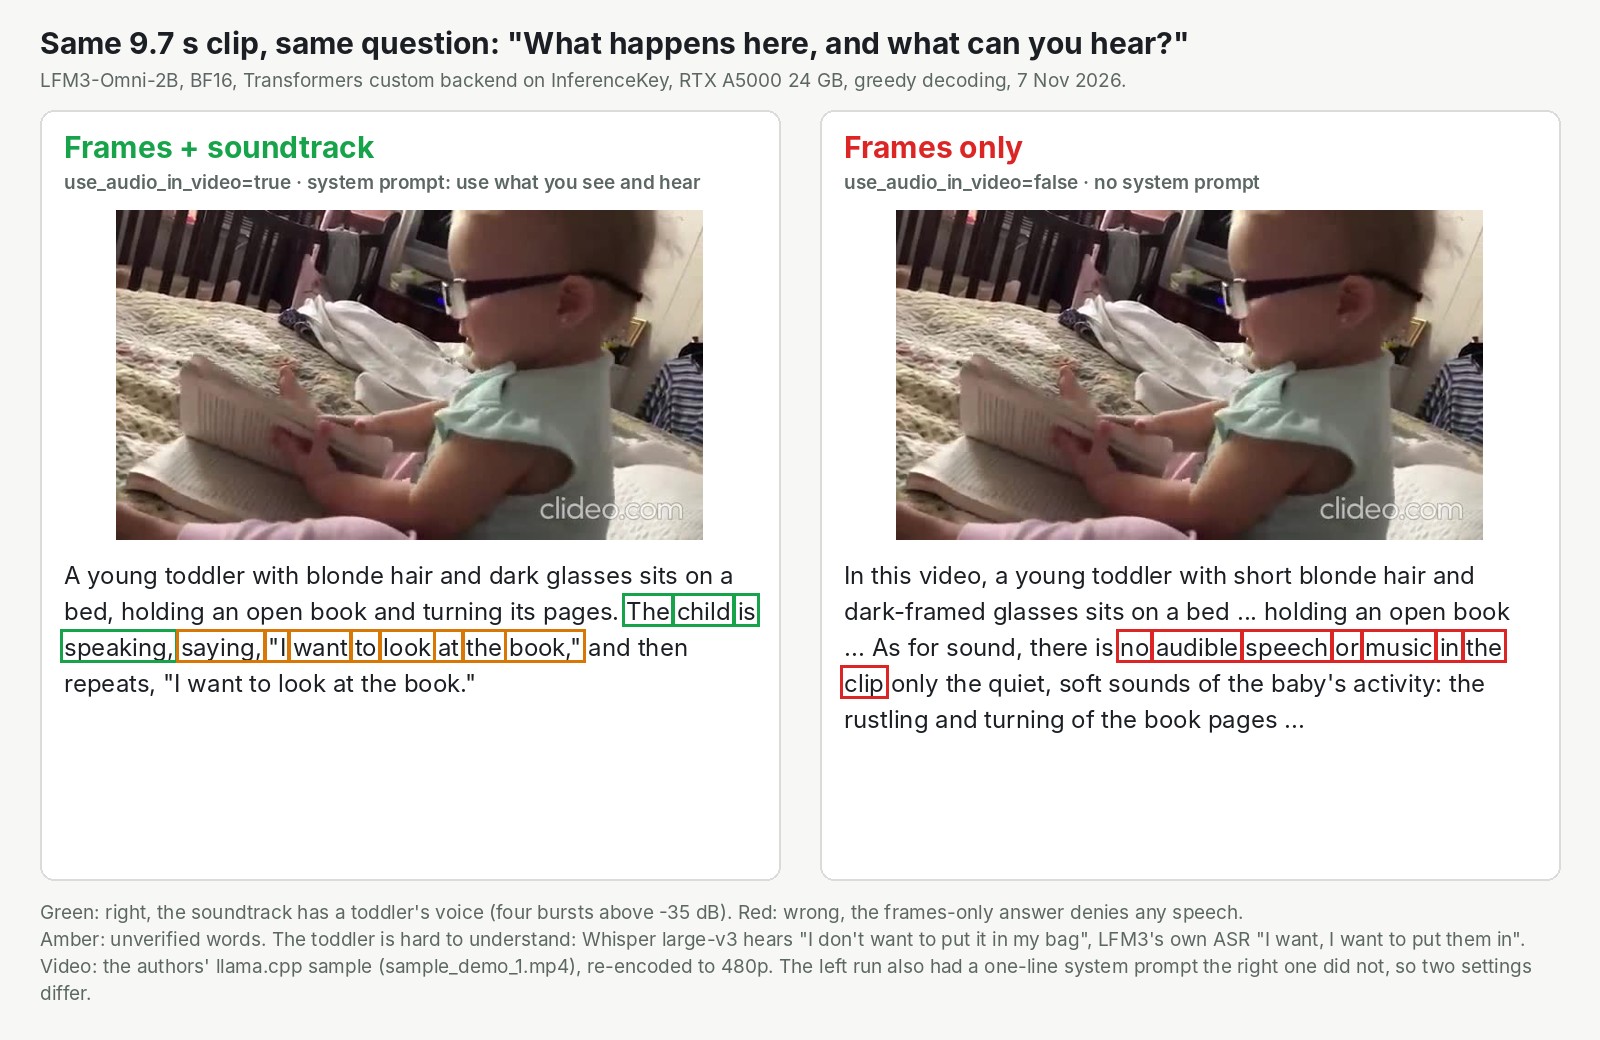
Même extrait, même question tapée. Avec la bande son, le modèle entend un enfant parler ; avec les images seules, il déclare l'extrait silencieux. L'exécution avec le son portait aussi une consigne d'une ligne demandant d'utiliser ce qu'il voit et ce qu'il entend : deux réglages ont donc changé, pas un seul.
Quatre métiers dans un seul jeu de poids de 4,5 GB
Un assistant vocal est en général un relais de quatre modèles : un qui entend, un qui regarde, un qui réfléchit, un qui parle. La fiche du modèle de Liquid AI dit que celui-ci "replaces a separate ASR model, vision-language model, LLM and TTS model".
Il est construit sur LFM3-1.7B, le nouveau petit modèle de langage de Liquid AI, avec un lecteur d'images, un lecteur de son et une partie qui transforme sa sortie en audio. Selon la liste de Liquid AI, il parle 19 combinaisons de langues et d'accents ; nous avons essayé l'anglais et l'espagnol. L'annonce de LFM3 date du 27 octobre, et nous avons repéré le modèle dans la vidéo d'actualité d'AI Search.
Ce qu'une seule petite carte en a fait
Nous avons fait tourner le modèle complet, non compressé, via InferenceKey sur deux cartes : l'A5000 pour l'essai principal, et la RTX 2000 Ada, une carte de station de travail de 70 watts, sur une machine neuve. Chaque réponse parlée a pris moins de temps à produire qu'à écouter.
| Ce que nous avons demandé | Temps GPU (A5000 / carte de 16 GB) |
|---|---|
| Question parlée sur la plus haute montagne d'Afrique, réponse à voix haute (environ 10 s de parole) | 7,4 s / 6,6 s |
| Affiche de concert plus une question parlée sur le lieu et l'heure | 0,84 s / 0,93 s |
| Demande parlée de mettre le volume à 30, avec un outil de volume | 0,56 s / 0,45 s |
L'affiche est revenue juste : "The concert starts at 7:30 PM, and it is located at Pier 9 Warehouse, 410 Bay Street." La demande de volume est revenue sous la forme set_volume({"volume": 30}), une commande qu'une application peut exécuter.
L'appelant a attendu plus longtemps que le GPU. Une réponse de 10 secondes lui est parvenue au bout de 8 à 10 secondes, parce que notre montage envoie l'audio en un seul fichier à la fin. Dans le serveur, le premier morceau de parole était prêt après 0,2 à 0,5 seconde : le streaming pourrait donc réduire cette attente. Nous ne l'avons ni construit ni testé.
Côté mémoire, le modèle a besoin d'environ 5 GB libres pour la voix, les photos et les extraits courts, et d'environ 6 GB pour une vidéo d'une minute. Quand nous avons plafonné sa mémoire par logiciel sur la plus grosse carte, tout est passé à 4,8 GB, et la vidéo de 10 secondes a manqué de mémoire à 4,7 GB.
Là où il trébuche : les nombres et les mots marmonnés
Les faits simples étaient justes. Interrogé à voix haute dix fois sur la hauteur du Kilimandjaro, il a donné les mètres justes neuf fois et les pieds faux dans la plupart des essais. Un assistant vocal qui lit des nombres à voix haute a besoin d'une vérification, ou d'un outil, pour les conversions.
Sur l'extrait du tout-petit, il a cité l'enfant disant "I want to look at the book". Nous n'avons pas pu le vérifier. Whisper, un outil de reconnaissance vocale distinct, a entendu autre chose, et le modèle lui-même aussi quand on lui a seulement demandé de transcrire. Prenez les mots cités à partir d'un audio peu clair pour une supposition.
Le serveur rapide écrit quatre fois plus vite, et ne sait pas parler
C'est le mur que vous rencontrerez en premier. La documentation de Liquid AI donne une commande SGLang d'une ligne, mais la version publiée de SGLang (0.5.23) ne prend pas en charge ce modèle et a planté au démarrage sur notre carte. La correction est une modification proposée, la #46858 de tugot17, encore ouverte le jour du test. Compilé à la main, il a écrit du texte environ quatre fois plus vite avec des réponses identiques, 158 morceaux de mots par seconde contre 38 à 40. Il ne renvoie que du texte.
Pour la parole, nous avons donc écrit un backend sur mesure : un court fichier Python que l'on envoie à InferenceKey, qui installe ses dépendances sur votre machine GPU et lui transmet les requêtes. Un seul backend sur un seul GPU a servi la voix, les photos, la vidéo et les commandes depuis une seule adresse. Il était prêt 46 secondes après la demande sur l'A5000, et 59,5 secondes sur la machine neuve de 16 GB.
Le modèle, ses benchmarks et les extraits d'exemple sont le travail de Liquid AI, la prise en charge dans SGLang celui de tugot17, la relecture indépendante de chaque enregistrement celui de Whisper. Notre part : le backend, le déploiement sur deux cartes, les tests et l'exemple du SDK.
À qui ça s'adresse
- Les équipes qui construisent un assistant vocal sur leur propre matériel. Ça vaut la peine de construire dessus, avec une vérification des nombres qu'il lit à voix haute. Tel que testé, l'appelant attend la réponse entière.
- Les équipes qui ont besoin de texte rapide pour un trafic élevé. Pas encore. Attendez la version publiée de SGLang.
- Les équipes avec une carte de moins de 16 GB. Les plafonds de mémoire indiquent qu'environ 5 GB libres suffisent, mais nous n'avons fait tourner aucune vraie carte aussi petite.
- Les entreprises avec 10 millions de dollars ou plus de chiffre d'affaires annuel. Parlez à Liquid AI d'autres conditions avant le premier déploiement.
La limite honnête : une requête à la fois, sur nos propres entrées courtes, sans personne pour juger la voix et sans comparaison avec une chaîne de quatre petits modèles séparés sur la même carte.
Lire le test complet
L'article Research contient chaque mesure de temps, l'échelle de mémoire, la voix du modèle lui-même et l'exemple du SDK. Lisez le test complet de LFM3-Omni-2B dans l'article Research.