LFM3-Omni-2B hört, sieht und antwortet mit eigener Stimme auf einer 16-GB-Karte
Das 2B-Omni-Modell von Liquid AI erzeugte 10 Sekunden gesprochene Antwort in etwa 7 Sekunden GPU-Zeit, mit etwa 5 GB. Der schnelle Server spricht noch nicht.
Hören, Sehen, Denken und Sprechen passen jetzt in etwa 5 GB GPU-Speicher. LFM3-Omni-2B, ein neues offenes Modell von Liquid AI, nimmt Sprache, Fotos und Video entgegen und antwortet in Text, mit eigener Stimme oder mit beidem. Auf einer RTX A5000 mit 24 GB in unserer Cloud kostete eine gesprochene Antwort von 10 Sekunden etwa 7 Sekunden GPU-Zeit. Eine echte 16-GB-Karte, die RTX 2000 Ada, lieferte dieselben Ergebnisse, ohne langsamer zu werden. Für ein Team, das seine eigenen Modelle betreibt, heißt das: jede Stufe eines Sprachassistenten auf einer kleinen Karte, die Sie besitzen oder mieten. Sie können heute darauf aufbauen, über ein eigenes Backend, das den Code des Modells selbst ansteuert. Zwei Haken vorher. Der schnelle Open-Source-Server dafür, SGLang, schreibt nur Text, und seine Unterstützung ist noch nicht veröffentlicht. Und die Lizenz untersagt die kommerzielle Nutzung, sobald Ihr Jahresumsatz 10 Millionen Dollar erreicht.
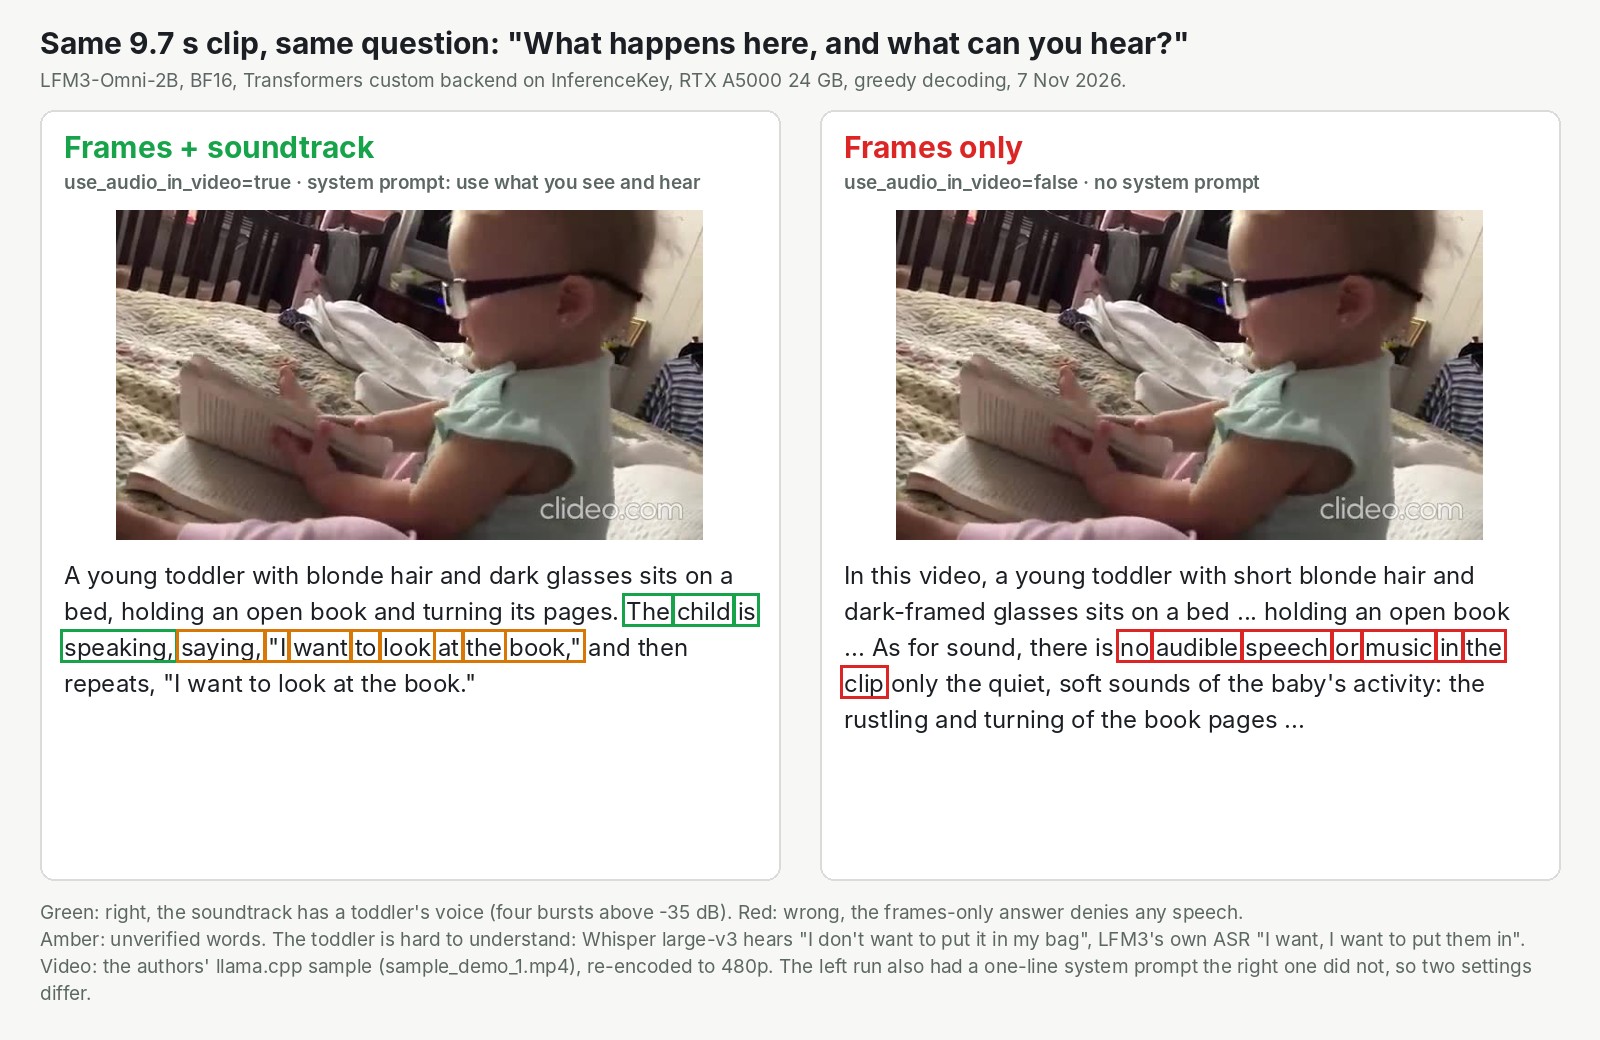
Derselbe Clip, dieselbe getippte Frage. Mit Tonspur hört das Modell ein sprechendes Kind; nur mit Bildern hält es den Clip für stumm. Der Lauf mit Ton hatte außerdem eine einzeilige Anweisung, das Gesehene und Gehörte zu nutzen. Es haben sich also zwei Einstellungen geändert, nicht eine.
Vier Aufgaben in einem Satz Gewichte von 4,5 GB
Ein Sprachassistent ist normalerweise eine Staffel aus vier Modellen: eines hört, eines schaut, eines denkt, eines spricht. Laut Model Card von Liquid AI ersetzt dieses hier "a separate ASR model, vision-language model, LLM and TTS model".
Es baut auf LFM3-1.7B auf, dem neuen kleinen Sprachmodell von Liquid AI, mit einem Bildleser, einem Tonleser und einem Teil, der seine Ausgabe in Audio verwandelt. Laut der Liste von Liquid AI spricht es 19 Kombinationen aus Sprache und Akzent; wir haben Englisch und Spanisch ausprobiert. Die Ankündigung von LFM3 ist auf den 27. Oktober datiert, und wir sind im News-Video von AI Search auf das Modell gestoßen.
Was eine kleine Karte damit geschafft hat
Wir haben das vollständige, unkomprimierte Modell über InferenceKey auf zwei Karten laufen lassen: auf der A5000 für den Hauptlauf und auf der RTX 2000 Ada, einer Workstation-Karte mit 70 Watt, auf einer frischen Maschine. Jede gesprochene Antwort war schneller erzeugt als abgespielt.
| Was wir gefragt haben | GPU-Zeit (A5000 / 16-GB-Karte) |
|---|---|
| Gesprochene Frage nach dem höchsten Berg Afrikas, Antwort per Stimme (etwa 10 s Sprache) | 7.4 s / 6.6 s |
| Konzertflyer plus gesprochene Frage, wann und wo | 0.84 s / 0.93 s |
| Gesprochene Bitte, die Lautstärke auf 30 zu stellen, mit einem Lautstärke-Tool | 0.56 s / 0.45 s |
Der Flyer kam richtig zurück: "The concert starts at 7:30 PM, and it is located at Pier 9 Warehouse, 410 Bay Street." Die Lautstärke-Bitte kam als set_volume({"volume": 30}) zurück, ein Befehl, den eine App ausführen kann.
Der Aufrufer hat länger gewartet als die GPU. Eine Antwort von 10 Sekunden kam nach 8 bis 10 Sekunden beim Aufrufer an, weil unser Aufbau das Audio am Ende als eine einzige Datei schickt. Im Server war das erste Stück Sprache nach 0,2 bis 0,5 Sekunden fertig, Streaming könnte diese Wartezeit also verkürzen. Gebaut oder getestet haben wir das nicht.
Beim Speicher braucht das Modell etwa 5 GB frei für Stimme, Fotos und kurze Clips und etwa 6 GB für ein Video von einer Minute. Als wir seinen Speicher auf der größeren Karte per Software begrenzt haben, bestand bei 4,8 GB alles, und bei 4,7 GB ging dem Video von 10 Sekunden der Speicher aus.
Wo es danebenliegt: Zahlen und genuschelte Worte
Die einfachen Fakten stimmten. Zehnmal per Stimme nach der Höhe des Kilimandscharo gefragt, lag es bei den Metern neunmal richtig und bei den Fuß in den meisten Läufen falsch. Ein Sprachassistent, der Zahlen vorliest, braucht für Umrechnungen eine Prüfung oder ein Tool.
Beim Kleinkind-Clip zitierte es das Kind mit "I want to look at the book". Das konnten wir nicht prüfen. Whisper, eine separate Spracherkennung, hörte etwas anderes, und das Modell selbst auch, als es nur transkribieren sollte. Behandeln Sie zitierte Worte aus undeutlichem Audio als Vermutung.
Der schnelle Server schreibt viermal schneller und kann nicht sprechen
Das ist die Wand, gegen die Sie zuerst laufen. Die Doku von Liquid AI nennt einen einzeiligen SGLang-Befehl, aber das veröffentlichte SGLang (0.5.23) unterstützt dieses Modell nicht und stürzte auf unserer Karte beim Start ab. Die Lösung ist eine vorgeschlagene Änderung, #46858 von tugot17, am Tag des Tests noch offen. Von Hand gebaut schrieb es Text etwa viermal schneller, mit identischen Antworten: 158 Wortstücke pro Sekunde gegen 38 bis 40. Es gibt nur Text zurück.
Für Sprache haben wir deshalb ein eigenes Backend geschrieben: eine kurze Python-Datei, die Sie auf InferenceKey hochladen, die ihre Abhängigkeiten auf Ihrer GPU-Maschine installiert und Anfragen an sie schickt. Ein Backend auf einer GPU bediente Stimme, Fotos, Video und Befehle unter einer Adresse. Auf der A5000 war es 46 Sekunden nach unserer Anfrage bereit, auf der frischen 16-GB-Maschine nach 59,5 Sekunden.
Das Modell, seine Benchmarks und die Beispielclips sind die Arbeit von Liquid AI, die SGLang-Unterstützung die von tugot17, das unabhängige Gegenhören jeder Aufnahme die von Whisper. Unser Teil: das Backend, das Deployment auf zwei Karten, die Tests und das SDK-Beispiel.
Für wen das wichtig ist
- Teams, die einen Sprachassistenten auf eigener Hardware bauen. Es lohnt sich, darauf aufzubauen, mit einer Prüfung für vorgelesene Zahlen. So wie getestet wartet der Aufrufer auf die ganze Antwort.
- Teams, die schnellen Text für viel Verkehr brauchen. Noch nicht. Warten Sie auf das SGLang-Release.
- Teams mit einer Karte unter 16 GB. Die Speichergrenzen sagen, dass etwa 5 GB frei reichen, aber auf einer echten Karte dieser Größe haben wir nichts laufen lassen.
- Unternehmen mit 10 Millionen Dollar Jahresumsatz oder mehr. Sprechen Sie vor dem ersten Deployment mit Liquid AI über andere Bedingungen.
Die ehrliche Grenze: jeweils eine Anfrage, auf unseren eigenen kurzen Eingaben, ohne einen Menschen, der die Stimme beurteilt, und ohne Vergleich mit einer Kette aus vier getrennten kleinen Modellen auf derselben Karte.
Den vollständigen Test lesen
Der Research-Beitrag enthält jede Zeitmessung, die Speicherstufen, die Stimme des Modells selbst und das SDK-Beispiel. Lesen Sie den vollständigen Test von LFM3-Omni-2B im Research-Beitrag.