Ripple-65B betreibt einen Coding-Agenten auf einer 48-GB-Karte, langsam und sauber
Ripple-65B mit 4 Bit auf einer RTX A6000: etwa 15 Tokens/s, ein eingebauter Bug in 6 Runden behoben. Eine RTX 3090 schafft 2 Bit, mit einem falschen Test.
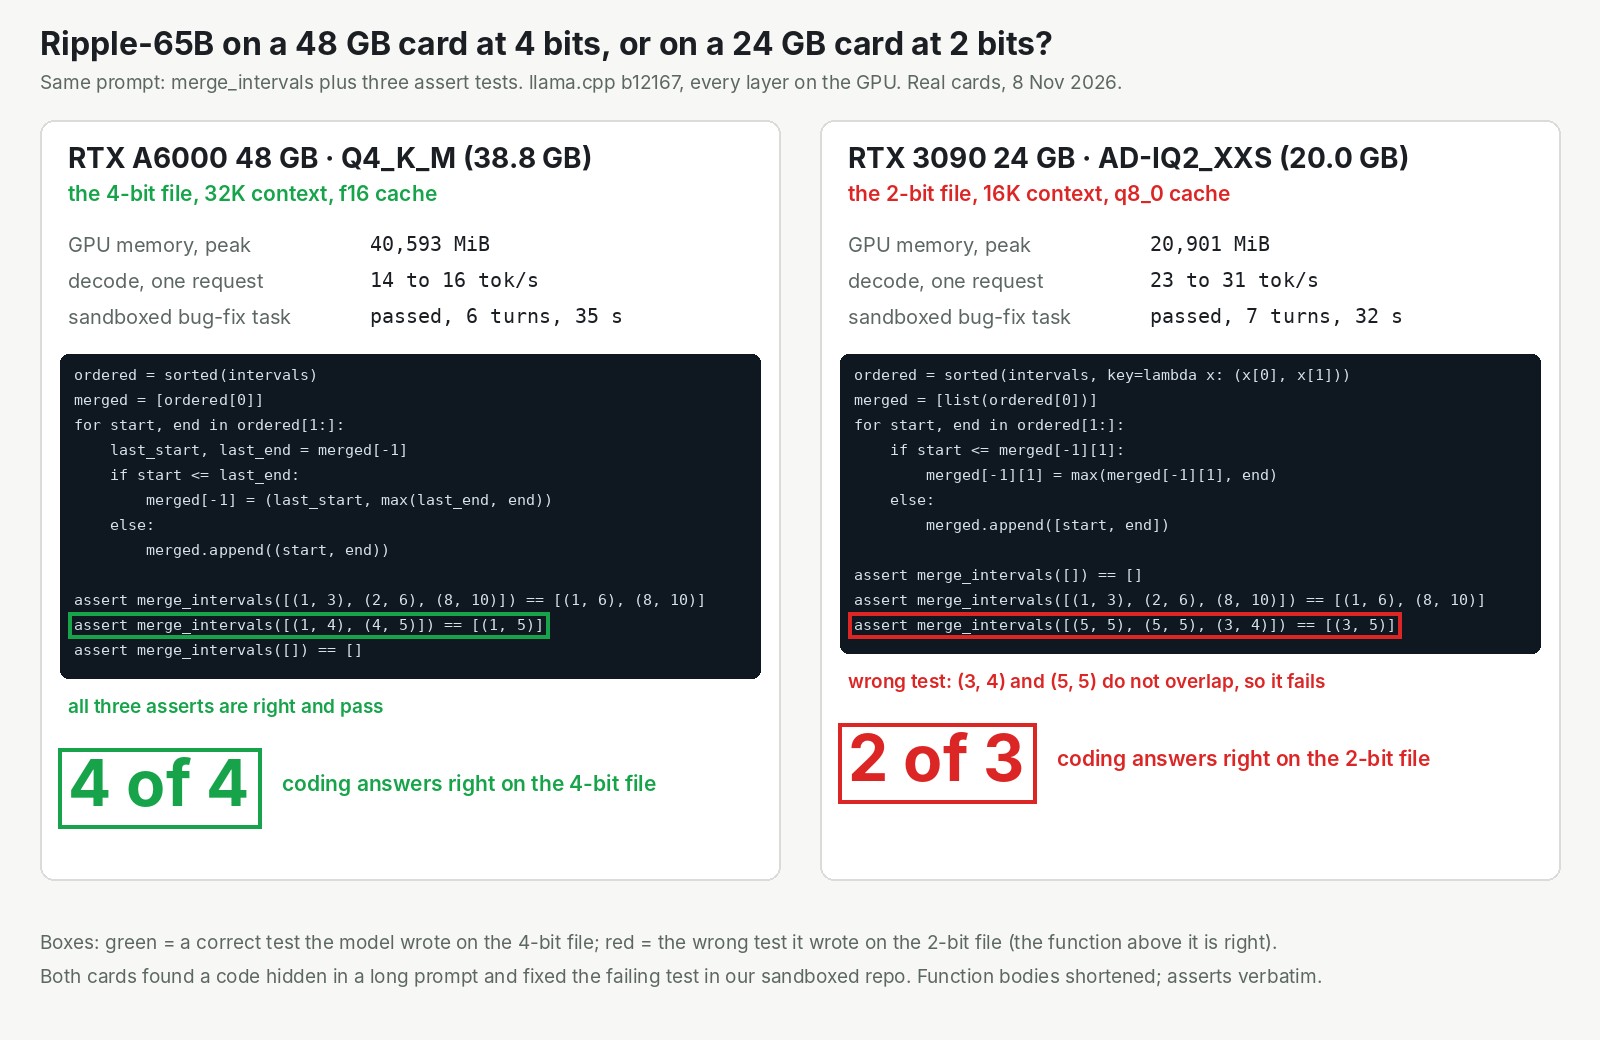
Kann ein Team einen neuen offenen Coder mit 65 Milliarden Parametern auf einer einzigen Karte betreiben, die es stundenweise mietet? Ja, wenn die Karte 48 GB hat und Sie Geduld mitbringen. Ripple-65B Preview vom US-Labor Ricursive Intelligence lief in unserer Cloud auf einer RTX A6000, mit einer 4-Bit-Datei von 38,8 GB. Es schrieb etwa 15 Tokens (grob: Wörter) pro Sekunde. Einen Bug, den wir in ein kleines Spielzeug-Repository eingebaut hatten, behob es in 6 Runden und 35 Sekunden, und jeder seiner Tool-Aufrufe war gültig. Für alle, die Modelle deployen, heißt das: ein Coding-Agent unter Apache 2.0, den Sie selbst kontrollieren, auf Hardware, die Sie heute mieten können. Eine RTX 3090 mit 24 GB schafft es auch, mit 2 Bit und schneller, aber eine ihrer drei Coding-Antworten kam mit einem falschen Test. Das saubere Ergebnis lieferte die 48-GB-Karte.
Ein offener Coder von Grund auf, und eine Community, die ihn in zwei Tagen portiert hat
Ricursive hat Ripple von Grund auf trainiert und unter Apache 2.0 verschenkt, ohne Formular. Die Gewichte kamen am 4. November auf Hugging Face. Laut den Autoren wurde es mit 12 Billionen Tokens trainiert und liest Eingaben von bis zu etwa einer Million.
Ihre Schlagzeilenzahl stammt aus Terminal-Bench 2.1, einem Test für Agenten, die in der Kommandozeile arbeiten: 80,5, laut ihrer eigenen Tabelle 0,4 Punkte vor Reflection Beam, einem 501B-Modell. Praktisch ein Gleichstand, und selbst gemeldet: Die Autoren nennen es selbst einen "best-effort attempt". In den meisten anderen Zeilen derselben Tabelle liegt ein Konkurrent vorn. Bei SWE-bench Verified, gebaut aus echten GitHub-Issues, erreicht Ripple 76,5 gegen 81,6 für Reflection Beam. Ein starkes offenes Ergebnis, aber kein Anspruch, die besten geschlossenen Coder zu schlagen.
Ricursives eigene Builds zielen auf Rechenzentrums-Hardware, die die meisten Teams nicht besitzen. Der Weg auf eine einzelne Karte kam aus der Community. Eine Portierung von Ripple nach llama.cpp, einem freien Programm, um Modelle auf der eigenen Karte laufen zu lassen, wurde am 5. November gemergt. Eingereicht hat sie Nik Bogatyrev, und laut der Model Card von AtomicChat hat AtomicChat sie geschrieben. AtomicChat hat in derselben Woche llama.cpp-Dateien veröffentlicht, von 129,6 GB in voller Präzision bis hinunter auf 18,5 GB. Unser Teil waren das Deployment, die Prompts, die Agenten-Aufgabe in der Sandbox und die Speichertests auf zwei echten Karten.
Dicht heißt etwa 15 Tokens pro Sekunde, und das ist der Deal
Jeder Konkurrent in Ricursives Tabelle ist ein Mixture of Experts: Jedes Wort, das sie schreiben, nutzt nur 23B bis 55B ihrer Parameter. Ripple ist dicht (dense). Jedes Wort läuft durch alle 65 Milliarden, also liest die Karte bei 4 Bit für jedes Wort fast die ganze Datei von 38,8 GB aus dem Speicher. Die A6000 schafft das etwa 15-mal pro Sekunde. Die Grenze setzt die Speichergeschwindigkeit, nicht die Rechenleistung.
In der Praxis heißt das: eine Antwort von 400 Tokens in etwa 27 Sekunden, und auf kurze Fragen beginnt die Antwort in unter einer Sekunde. Für einen Entwickler, der einen Agenten steuert, brauchbar, aber nicht flott.
Was wir auf der 48-GB-Karte gesehen haben
Die Agenten-Aufgabe war ein Spielzeug-Repository mit einem Off-by-one-Bug, der einen Test scheitern ließ. Das Modell hatte ein einziges Tool, eine Shell, in einer Sandbox ohne Netzwerk. Ripple las den Code, ließ die Tests laufen, sah sie scheitern, änderte ein <= in <, ließ sie erneut laufen und meldete sich zurück. Die Tests hat es nie angefasst. Alle 4 Coding-Antworten mit der 4-Bit-Datei waren richtig, und jeder Tool-Aufruf kam im Standardformat zurück, das bestehender Agenten-Code liest.
Lange Prompts kosten wenig Speicher. Dieselbe Karte fand eine Passphrase, die bei Token 237.532 versteckt war, und brauchte dafür etwa 46 GB. Der Haken ist die Zeit: Das Lesen dieses Prompts dauerte etwa 13 Minuten. Und die volle Million ist auf einer einzelnen 48-GB-Karte außer Reichweite. Bei etwa 256K Tokens, mit komprimierten Notizen des Modells zum Prompt, ist Schluss.
| Karte | Datei | Geschwindigkeit (Tokens/s) | Coding-Antworten richtig |
|---|---|---|---|
| RTX A6000 48 GB | 4-Bit, 38.8 GB | 14 bis 16 | 4 von 4 |
| RTX 3090 24 GB | 2-Bit, 20.0 GB | 23 bis 31 | 2 von 3 |
Die 3090 ist eine echte Gaming-Karte mit 24 GB, kein Budget, das wir simuliert haben. Mit weniger Bits pro Zahl ist die Datei kleiner und schneller zu lesen, aber die Zahlen werden gröber. Die Bugfix-Aufgabe bestand sie trotzdem. Der Ausrutscher kam dort, wo das Modell selbst einen neuen Test schreiben musste. Das passt zu den eigenen Messungen von AtomicChat: Laut ihrer Model Card weicht die 2-Bit-Datei beim nächsten Wort fast 20-mal von 100 vom vollen Modell ab, gegen etwa 7-mal bei der 4-Bit-Datei.
Auf InferenceKey antwortete Ripple, sobald die Datei auf der Maschine lag, 19,0 Sekunden nach unserer Anfrage auf der A6000 und 19,3 Sekunden auf der 3090, weil der Worker ein fertiges llama.cpp heruntergeladen hat, statt es zu bauen.
Für wen das wichtig ist
- Sie haben eine 48-GB-Karte und wollen einen offenen Coding-Agenten, den Sie selbst kontrollieren: einen Versuch wert. Die 4-Bit-Datei lieferte unsere saubersten Ergebnisse.
- Sie brauchen lange Prompts: Ein Prompt mit 237K Tokens passte auf 48 GB. Rechnen Sie mit Minuten pro Frage, nicht mit Sekunden.
- Sie haben eine 24-GB-Karte: Die 2-Bit-Datei läuft, und schneller, aber prüfen Sie die Tests, die sie schreibt.
- Sie brauchen vor allem Geschwindigkeit: Schauen Sie sich anderswo um. Weil Ripple dicht ist, liest es für jedes Wort das ganze Modell.
Die ehrliche Grenze: Wir haben jeweils eine Anfrage geschickt, mit unseren eigenen kleinen Prompts, jede Prüfung einmal oder ein paar Mal. Eine Karte, die sich mehrere Agenten teilen, wird also langsamer sein, um wie viel, haben wir nicht gemessen. Und das hier ist eine Preview.
Lesen Sie den vollständigen Test von Ripple-65B mit der Speichertabelle nach Kartengröße, den Beispielen für Tool-Aufrufe und den Läufen mit langen Prompts.