SenseNova-Loop-9B spielt seine mittleren Layer zweimal und braucht beide Durchläufe
SenseNova-Loop-9B passt auf eine echte 20-GB-Karte und antwortet richtig, mit 2 bis 3 tokens/s. Mit nur einem Durchlauf doppelt so schnell und kaputt.
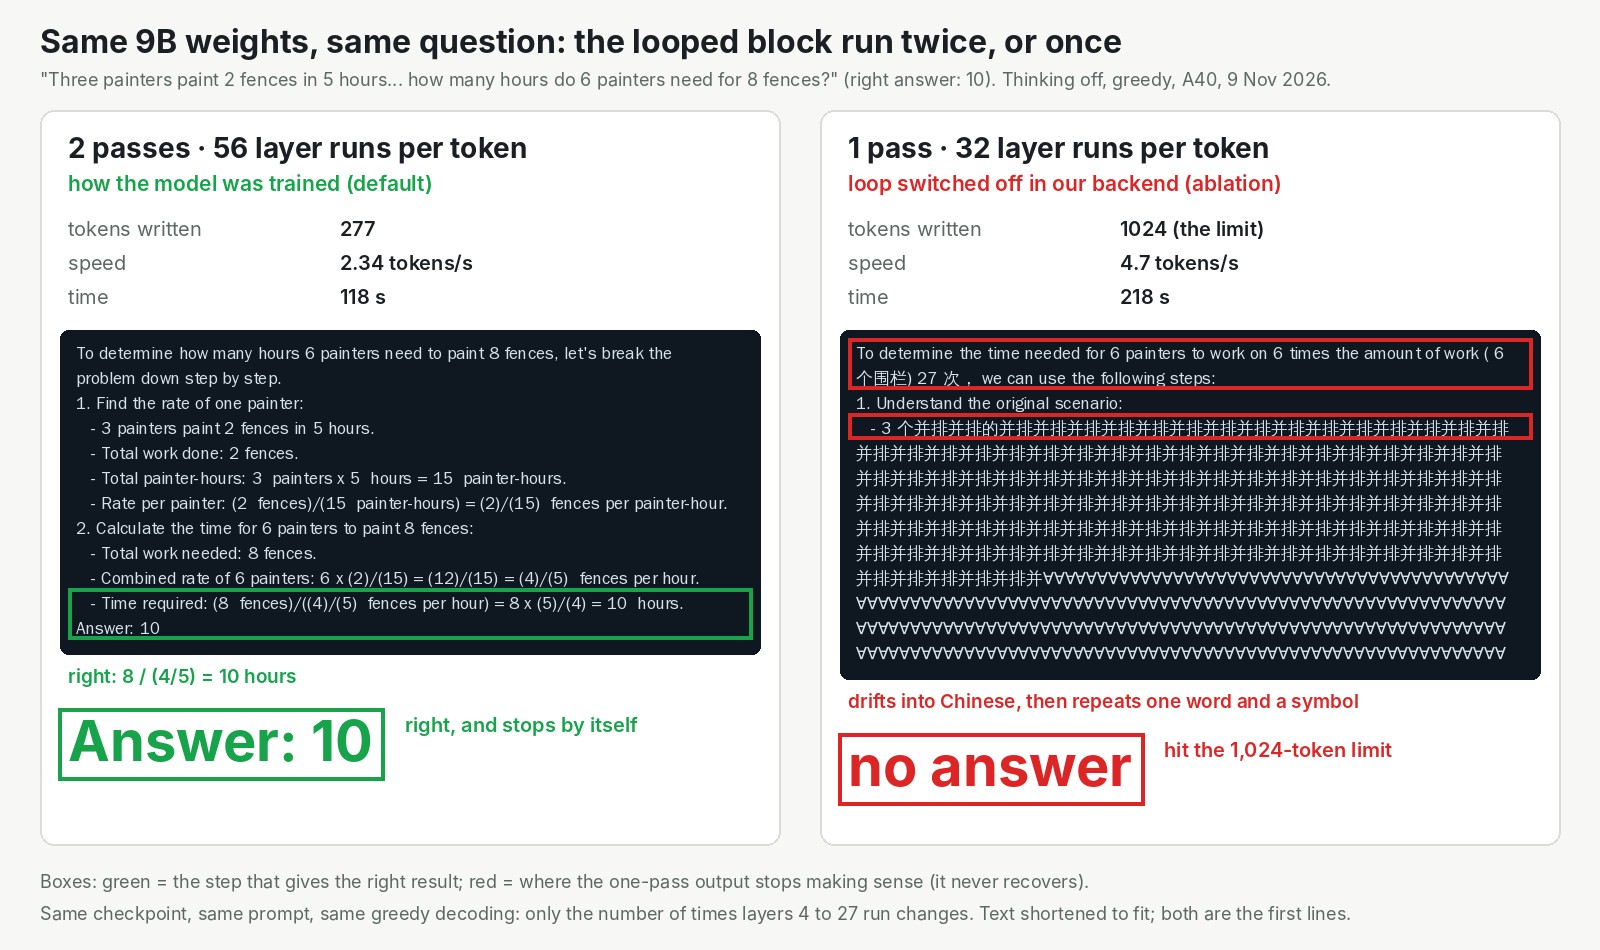
Zweiunddreißig Layer gespeichert, sechsundfünfzig Layer pro Wort ausgeführt. Das ist der Trick in SenseNova-Loop-9B-Preview, einem offenen Modell von SenseTime, das Bilder liest, Tools aufruft und unter Apache 2.0 steht. Es verwendet seine mittleren Layer erneut, statt neue hinzuzufügen, und braucht deshalb den Speicher eines 9B-Modells. Wir haben es unkomprimiert auf einer echten RTX 4000 Ada mit 20 GB laufen lassen: Es hat ein Diagramm gelesen, eine Textaufgabe gelöst und ein Tool aufgerufen, alles korrekt. Der Preis ist die Geschwindigkeit, 2 bis 3 Wörter pro Sekunde mit dem Code der Autoren. Und die Schleife ist nicht optional: Als wir das Modell seine mittleren Layer einmal statt zweimal durchlaufen ließen, schrieb es doppelt so schnell und ergab keinen Sinn mehr. Für alle, die Modelle deployen, heißt das: ein multimodales offenes Modell auf einer Workstation-Karte, schon heute, für kurze Prompts und Jobs, die warten können.
Ein Wiederholungszeichen über der Bridge
Das Modell ist ein Stapel aus 32 Verarbeitungsschritten, den sogenannten Layern. Die Layer 4 bis 27 laufen einmal und dann noch einmal, mit genau denselben gelernten Zahlen. Stellen Sie sich ein Leadsheet einer Band vor, mit einem Wiederholungszeichen über der Bridge: Die Band spielt die Bridge zweimal, und die Noten bekommen keine Seite mehr. SenseTime schreibt dazu "~9B total parameters; ~14.6B inference parameters", die eigene Zählung des Rechenaufwands pro Wort, die wir nicht geprüft haben.
Trainiert wurde es mit Texten von bis zu 262.144 Tokens, und die Autoren melden 40,45 auf Terminal-Bench 2.1, einem Test für Agenten, die in einem Terminal arbeiten, gegenüber 29,20 für Qwen3.5 9B. Diese Zahlen haben wir nicht nachgemessen.
Der Haken für alle, die es diese Woche ausprobieren wollen: Die üblichen Tools haben noch keinen Code für das Wiederholungszeichen. Das offizielle llama.cpp kann es nicht laden, und laut Modellseite unterstützen es auch LM Studio und Ollama nicht. Unterstützung in vLLM und SGLang gibt es nur als offene Pull Requests, nicht als Releases. Der einzige Weg, es auf einer Karte mit Text und Bildern zu betreiben, ist daher der eigene Python-Code der Autoren, der mit den Gewichten ausgeliefert wird. Genau den haben wir auf InferenceKey deployt.
Was unser Test gezeigt hat: Der zweite Durchlauf hält es bei Verstand
Wir haben dieselben drei Anfragen an eine A40 mit 48 GB in unserer Cloud und an die echte RTX 4000 Ada mit 20 GB geschickt. Beide Karten lieferten dieselben richtigen Antworten. Bei einer erfundenen Stromrechnung einer Bäckerei fand das Modell den August als schwächsten Monat mit 2.140 kWh, errechnete 3.110 kWh Einsparung und bezifferte sie auf 653,10 Euro. Der Tool-Aufruf kam als saubere Abfrage eines Wechselkurses zurück.
Dann haben wir unserem Ladecode einen Schalter hinzugefügt, der die mittleren Layer einmal statt zweimal ausführt. Dieselbe Datei, dieselbe Frage. Die Geschwindigkeit stieg von 2,34 auf 4,7 Tokens pro Sekunde. Bei der Zaun-Aufgabe lag das Modell schon im ersten Satz falsch, driftete ins Chinesische ab und wiederholte ein einziges Wort, bis es unser Limit von 1.024 Tokens erreichte, ohne Antwort. Beim Diagramm las es eine Zahl falsch und antwortete 1.414 kWh und 293,34 Euro, beides falsch. Wer die Schleife kürzt, kauft Geschwindigkeit, mit der er nichts anfangen kann: Das Modell wurde darauf trainiert, diesen zweiten Durchlauf zu erwarten.
| 2 Durchläufe (wie trainiert) | 1 Durchlauf (Schleife aus) | |
|---|---|---|
| Layer-Ausführungen pro Wort | 56 | 32 |
| Geschwindigkeit auf der A40 | 2,34 tokens/s | 4,7 tokens/s |
| Zaun-Aufgabe | Answer: 10, richtig, in 118 s | keine Antwort nach 1.024 Tokens, 218 s |
| Diagramm | richtig | 1.414 kWh und 293,34 EUR, falsch |
Langsam wegen der Software, mehr als wegen der Karte
Mit dem Code der Autoren dauerte eine Antwort zum Diagramm mit Thinking etwa drei Minuten. Was es bremst, sieht nach Software aus, nicht nach der GPU: Ein CPU-Kern lief auf 100 % und reichte der GPU kleine Arbeitspakete zu, während die GPU auf der A40 nur 38 bis 53 % der Zeit beschäftigt war. Jedes Wort zahlt für 56 Layer dieses Zureichens.
Der noch nicht veröffentlichte SGLang-Pull-Request, den wir auf derselben A40 gebaut haben, lief mit 9,1 bis 9,2 Tokens pro Sekunde. Die Textaufgabe, die mit dem Code der Autoren 101 Sekunden brauchte, dauerte dort 33,6 Sekunden, mit identischem Text. Die eingebaute Beschleunigung, die die Modellseite als "Available" aufführt, ein kleiner Teil, der die nächsten paar Wörter errät, lief auf keiner Engine, die wir auf einer GPU ausprobiert haben.
Für wen das relevant ist
- Teams, die ein offenes Modell wollen, das Bilder liest und Tools aufruft, auf einer kleinen Karte. Eine echte Karte mit 20 GB hat es unkomprimiert betrieben, mit richtigen Antworten, für Prompts bis etwa 3.000 Tokens. Ein Prompt mit etwa 6.000 Tokens lief in einen Speicherfehler, und der Server bediente die nächste Anfrage weiter.
- Teams mit langen Prompts. Planen Sie 24 GB oder mehr ein: Ein Prompt mit 12.046 Tokens lief durch, als wir die A40 auf ein Budget von 24 GB begrenzt hatten.
- Alle, die Chat-Geschwindigkeit brauchen. Noch nicht. Behalten Sie den SGLang-Pull-Request im Auge.
- Alle, die versucht sind, die Schleife für mehr Tempo zu kürzen. Lassen Sie es, siehe die Tabelle oben.
Die ehrliche Grenze: Wir haben jede Anfrage einmal ausgeführt, eine nach der anderen, mit Prompts von höchstens 12.046 Tokens und ohne ein normales 9B-Modell auf derselben Karte zum Vergleich. Das zeigt also, dass das Modell von Anfang bis Ende funktioniert, nicht, wie gut es ist oder wie viel der Langsamkeit von der Schleife selbst kommt.
Die Speicherleiter, der SGLang-Build, die Versuche zur Beschleunigung und das Beispiel, das es auf Ihrem eigenen Worker betreibt, stehen im vollständigen Test von SenseNova-Loop-9B.