SenseNova-Loop-9B joue ses couches du milieu deux fois, et il a besoin des deux passages
SenseNova-Loop-9B tient sur une vraie carte de 20 GB et répond juste, à 2 ou 3 tokens/s. Sa boucle jouée une seule fois double la vitesse et le casse.
Trente-deux couches stockées, cinquante-six couches exécutées pour chaque mot. C'est l'astuce de SenseNova-Loop-9B-Preview, un modèle ouvert de SenseTime qui lit des images, appelle des outils et sort sous Apache 2.0. Il réutilise ses couches du milieu au lieu d'en ajouter de nouvelles, donc il demande la mémoire d'un modèle de 9B. Nous l'avons fait tourner sans compression sur une vraie RTX 4000 Ada de 20 GB : il a lu un graphique, résolu un problème et appelé un outil, à chaque fois correctement. Le prix, c'est la vitesse : 2 à 3 mots par seconde avec le code des auteurs. Et la boucle n'est pas facultative : quand nous avons fait passer le modèle une seule fois par ses couches du milieu au lieu de deux, il a écrit deux fois plus vite et a cessé d'avoir du sens. Pour qui déploie des modèles, cela veut dire un modèle ouvert multimodal sur une carte de station de travail, dès aujourd'hui, pour des prompts courts et des tâches qui peuvent attendre.
Un signe de reprise au-dessus du pont
Le modèle est une pile de 32 étapes de traitement, appelées couches. Les couches 4 à 27 s'exécutent une fois, puis une seconde fois, avec exactement les mêmes nombres appris. Imaginez une grille d'accords avec un signe de reprise au-dessus du pont : le groupe joue le pont deux fois, et la partition ne gagne aucune page. SenseTime parle de "~9B total parameters; ~14.6B inference parameters", leur propre décompte du travail par mot, que nous n'avons pas vérifié.
Il a été entraîné sur des textes allant jusqu'à 262 144 tokens, et les auteurs annoncent 40,45 sur Terminal-Bench 2.1, un test d'agents qui travaillent dans un terminal, contre 29,20 pour Qwen3.5 9B. Nous n'avons pas reproduit ces chiffres.
Le hic pour qui veut l'essayer cette semaine : les outils habituels n'ont pas encore de code pour le signe de reprise. Le llama.cpp officiel ne sait pas le charger, et sa fiche de modèle dit que LM Studio et Ollama ne le prennent pas en charge non plus. Le support dans vLLM et SGLang n'existe que sous forme de pull requests ouvertes, pas de versions publiées. La seule façon de le faire tourner sur une carte avec le texte et les images, c'est donc le code Python des auteurs, livré avec les poids. C'est ce que nous avons déployé sur InferenceKey.
Ce que notre test a montré : c'est le second passage qui le garde lucide
Nous avons envoyé les trois mêmes requêtes à une A40 de 48 GB de notre cloud et à la vraie RTX 4000 Ada de 20 GB. Les deux cartes ont donné les mêmes bonnes réponses. Sur une facture d'électricité inventée de boulangerie, le modèle a trouvé août comme mois le plus bas, à 2 140 kWh, calculé 3 110 kWh économisés et chiffré le tout à 653,10 euros. L'appel d'outil est revenu sous la forme d'une recherche de taux de change propre.
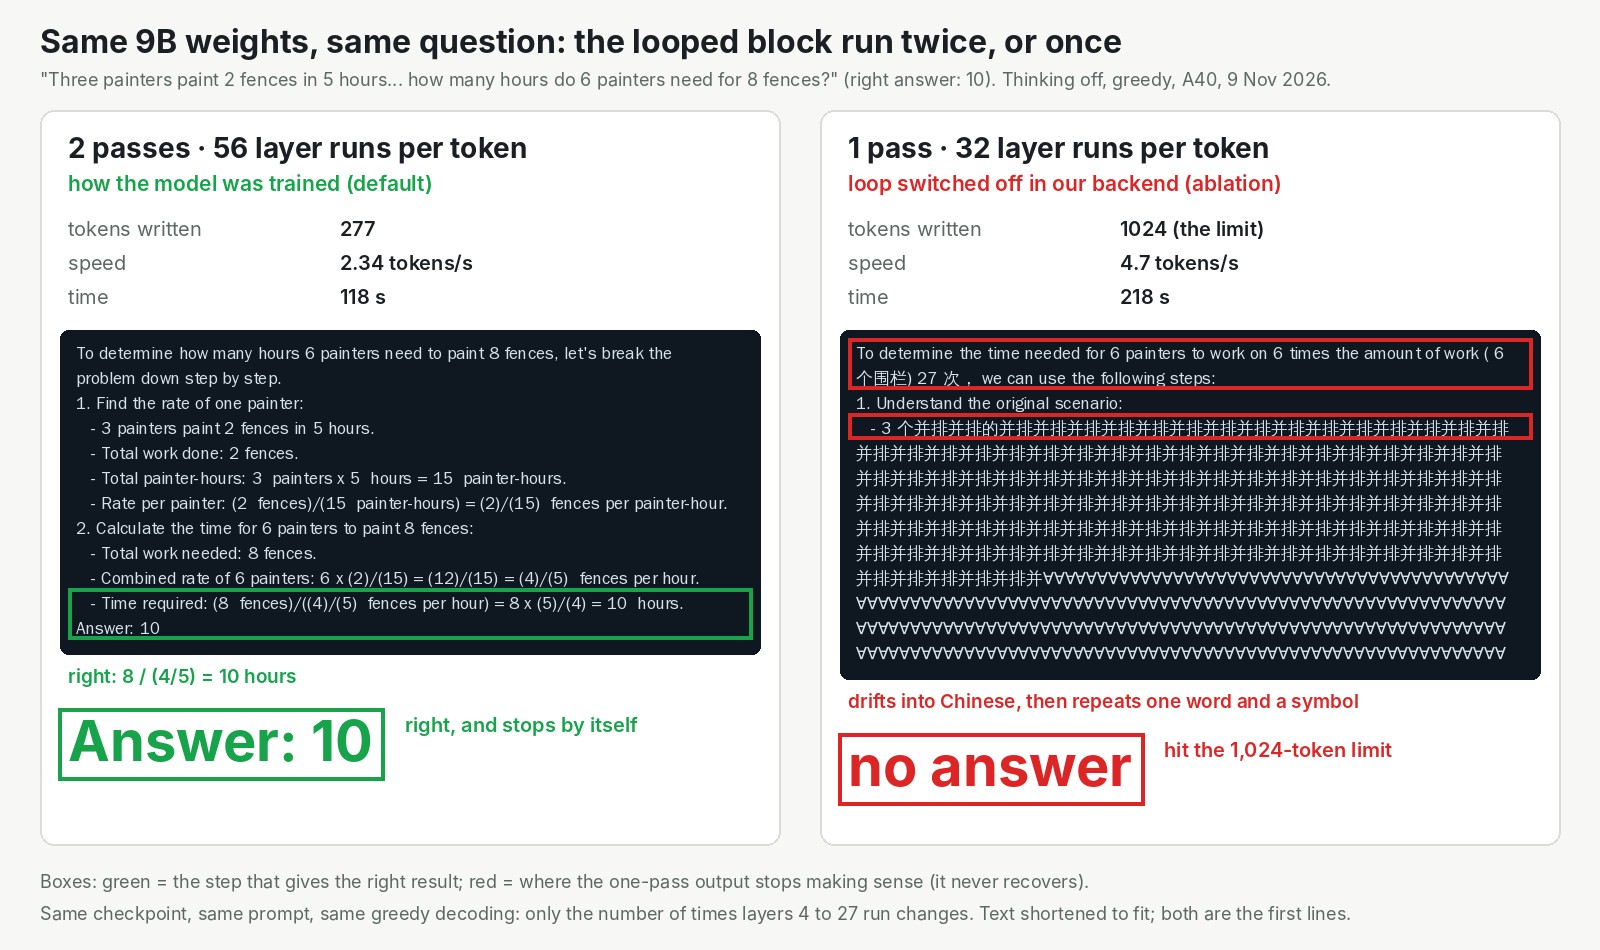
Nous avons ensuite ajouté à notre code de chargement un interrupteur qui exécute les couches du milieu une fois au lieu de deux. Même fichier, même question. La vitesse est passée de 2,34 à 4,7 tokens par seconde. Sur le problème des clôtures, le modèle s'est trompé dès sa première phrase, a dérivé vers le chinois et a répété un mot jusqu'à atteindre notre limite de 1 024 tokens, sans réponse. Sur le graphique, il a mal lu un nombre et répondu 1 414 kWh et 293,34 euros, deux résultats faux. Raccourcir la boucle achète une vitesse inutilisable : le modèle a été entraîné à attendre ce second passage.
| 2 passages (comme à l'entraînement) | 1 passage (boucle coupée) | |
|---|---|---|
| Exécutions de couche par mot | 56 | 32 |
| Vitesse sur l'A40 | 2,34 tokens/s | 4,7 tokens/s |
| Problème des clôtures | Answer: 10, juste, en 118 s | pas de réponse après 1 024 tokens, 218 s |
| Graphique | juste | 1 414 kWh et 293,34 EUR, faux |
Lent à cause du logiciel, plus que de la carte
Avec le code des auteurs, une réponse sur le graphique avec raisonnement a pris environ trois minutes. Ce qui le freine ressemble au logiciel, pas au GPU : un cœur de CPU restait à 100 % à distribuer de petits morceaux de travail au GPU, tandis que le GPU n'était occupé que 38 à 53 % du temps sur l'A40. Chaque mot paie 56 couches de cette distribution.
La pull request SGLang non publiée, que nous avons compilée sur la même A40, a tourné à 9,1 à 9,2 tokens par seconde. Le problème qui prenait 101 secondes avec le code des auteurs y a pris 33,6 secondes, avec un texte identique. L'accélération intégrée que la fiche du modèle indique comme "Available", une petite partie qui devine les quelques mots suivants, n'a tourné sur aucun des moteurs que nous avons essayés sur un seul GPU.
Qui est concerné
- Les équipes qui veulent un modèle ouvert qui lit des images et appelle des outils sur une seule petite carte. Une vraie carte de 20 GB l'a fait tourner sans compression, avec de bonnes réponses, pour des prompts jusqu'à environ 3 000 tokens. Un prompt d'environ 6 000 tokens a manqué de mémoire, et le serveur a continué à servir la requête suivante.
- Les équipes avec de longs prompts. Prévoyez 24 GB ou plus : un prompt de 12 046 tokens est passé quand nous avons plafonné l'A40 à un budget de 24 GB.
- Ceux qui ont besoin d'une vitesse de chat. Pas encore. Surveillez la pull request SGLang.
- Ceux qui seraient tentés de couper la boucle pour gagner en vitesse. Ne le faites pas, voir le tableau ci-dessus.
La limite, honnêtement : nous avons lancé chaque requête une seule fois, une à la fois, avec des prompts de 12 046 tokens au plus et sans modèle 9B classique sur la même carte pour comparer. Cela montre donc que le modèle fonctionne de bout en bout, pas à quel point il est bon ni quelle part de la lenteur vient de la boucle elle-même.
L'échelle de mémoire, la compilation de SGLang, les tentatives d'accélération et l'exemple pour le faire tourner sur votre propre worker sont dans le test complet de SenseNova-Loop-9B.