SenseNova-Loop-9B toca dos veces sus capas centrales, y necesita las dos pasadas
SenseNova-Loop-9B entra en una tarjeta real de 20 GB y acierta, a 2 o 3 tokens/s. Con el bucle a una sola pasada va el doble de rápido y se rompe.
Treinta y dos capas guardadas, cincuenta y seis capas ejecutadas por cada palabra. Ese es el truco de SenseNova-Loop-9B-Preview, un modelo abierto de SenseTime que lee imágenes, llama a herramientas y se publica con licencia Apache 2.0. Reutiliza sus capas centrales en vez de añadir otras nuevas, así que necesita la memoria de un modelo de 9B. Lo ejecutamos sin comprimir en una RTX 4000 Ada real de 20 GB: leyó un gráfico, resolvió un problema de enunciado y llamó a una herramienta, todo bien. El precio es la velocidad, de 2 a 3 palabras por segundo con el código de los autores. Y el bucle no es opcional: cuando hicimos que el modelo pasara una sola vez por sus capas centrales en lugar de dos, escribió el doble de rápido y dejó de tener sentido. Para quien despliega modelos, eso significa un modelo abierto multimodal en una tarjeta de estación de trabajo, hoy, para prompts cortos y trabajos sin prisa.
Un signo de repetición sobre el puente
El modelo es una pila de 32 pasos de procesamiento, llamados capas. Las capas 4 a 27 se ejecutan una vez y luego otra, con exactamente los mismos números aprendidos. Imagina la partitura de un grupo con un signo de repetición sobre el puente: el grupo toca el puente dos veces y la partitura no gana ni una página. SenseTime lo describe como "~9B total parameters; ~14.6B inference parameters", su propia cuenta del trabajo por palabra, no una que hayamos comprobado.
Se entrenó con textos de hasta 262.144 tokens, y los autores declaran 40,45 en Terminal-Bench 2.1, una prueba de agentes que trabajan en un terminal, frente a 29,20 de Qwen3.5 9B. No reprodujimos esas cifras.
La pega para quien quiera probarlo esta semana: las herramientas habituales todavía no tienen código para el signo de repetición. El llama.cpp oficial no puede cargarlo, y la ficha del modelo dice que LM Studio y Ollama tampoco lo soportan. El soporte en vLLM y SGLang solo existe como pull requests abiertas, no como versiones publicadas. Así que la única forma de ejecutarlo en una sola tarjeta, con texto e imágenes, es el propio código Python de los autores, que viene con los pesos. Eso es lo que desplegamos en InferenceKey.
Lo que encontró nuestra prueba: la segunda pasada es lo que lo mantiene cuerdo
Mandamos las mismas tres peticiones a una A40 de 48 GB de nuestra nube y a la RTX 4000 Ada real de 20 GB. Las dos tarjetas dieron las mismas respuestas correctas. Con una factura de luz inventada de una panadería, el modelo encontró agosto como el mes más bajo, con 2.140 kWh, calculó un ahorro de 3.110 kWh y le puso precio: 653,10 euros. La llamada a herramienta volvió como una consulta limpia de tipo de cambio.
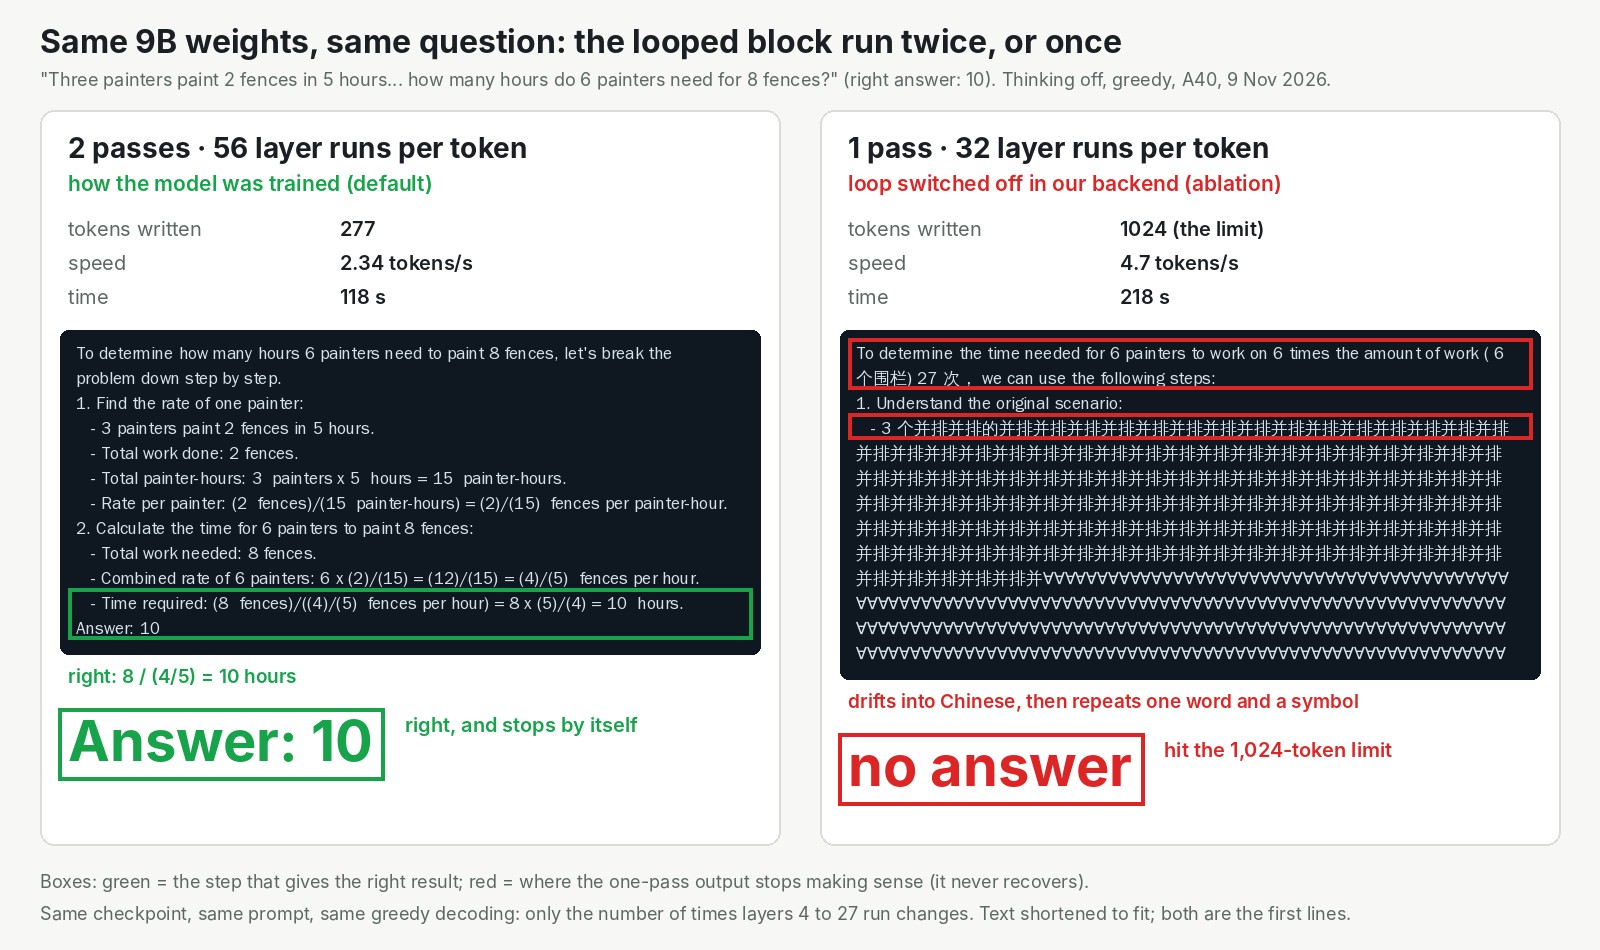
Después añadimos a nuestro código de carga un interruptor que ejecuta las capas centrales una vez en lugar de dos. El mismo fichero, la misma pregunta. La velocidad pasó de 2,34 a 4,7 tokens por segundo. En el problema de las vallas, el modelo se equivocó en la primera frase, se desvió al chino y repitió una palabra hasta llegar a nuestro límite de 1.024 tokens, sin respuesta. En el gráfico leyó mal un número y respondió 1.414 kWh y 293,34 euros, las dos cosas mal. Recortar el bucle compra una velocidad que no sirve de nada: el modelo se entrenó esperando esa segunda pasada.
| 2 pasadas (como se entrenó) | 1 pasada (bucle apagado) | |
|---|---|---|
| Ejecuciones de capa por palabra | 56 | 32 |
| Velocidad en la A40 | 2,34 tokens/s | 4,7 tokens/s |
| Problema de las vallas | Answer: 10, bien, en 118 s | sin respuesta tras 1.024 tokens, 218 s |
| Gráfico | bien | 1.414 kWh y 293,34 euros, mal |
Lento por el software, más que por la tarjeta
Con el código de los autores, una respuesta sobre el gráfico con razonamiento tardó unos tres minutos. Lo que lo frena parece software, no la GPU: un núcleo de la CPU estaba al 100 % pasándole a la GPU trozos pequeños de trabajo, mientras la GPU solo estaba ocupada entre el 38 y el 53 % del tiempo en la A40. Cada palabra paga ese reparto por 56 capas.
La pull request de SGLang sin publicar, que compilamos en la misma A40, fue a 9,1 o 9,2 tokens por segundo. El problema de enunciado que tardó 101 segundos con el código de los autores tardó 33,6 segundos ahí, con un texto idéntico. La aceleración integrada que la ficha del modelo marca como "Available", una pieza pequeña que adivina las siguientes palabras, no funcionó en ningún motor que probamos con una sola GPU.
A quién le importa
- Equipos que quieren un modelo abierto que lea imágenes y llame a herramientas en una sola tarjeta pequeña. Una tarjeta real de 20 GB lo ejecutó sin comprimir, con respuestas correctas, para prompts de hasta unos 3.000 tokens. Un prompt de unos 6.000 tokens se quedó sin memoria, y el servidor siguió atendiendo la siguiente petición.
- Equipos con prompts largos. Cuenta con 24 GB o más: un prompt de 12.046 tokens pasó cuando limitamos la A40 a un presupuesto de 24 GB.
- Quien necesite velocidad de chat. Todavía no. Sigue la pull request de SGLang.
- Quien tenga la tentación de recortar el bucle para ganar velocidad. Mejor no, por la tabla de arriba.
El límite honesto: ejecutamos cada petición una sola vez, de una en una, con prompts de no más de 12.046 tokens y sin un 9B normal en la misma tarjeta con el que comparar, así que esto demuestra que el modelo funciona de principio a fin, no lo bueno que es ni cuánto de la lentitud se debe al propio bucle.
La escalera de memoria, la compilación de SGLang, los intentos de aceleración y el ejemplo que lo ejecuta en tu propio worker están en la prueba completa de SenseNova-Loop-9B.