Nanbeige4.3-33B sur une seule carte : 42 tokens/s sur 24 GB, et sur 16 GB seul le fichier 3 bits fonctionne
Un modèle d'agent dense de 33B à 42 tokens/s sur une RTX 4090. Sur 16 GB, le fichier 3 bits tourne à 14 tokens/s ; le 4 bits rampe à 1,6.
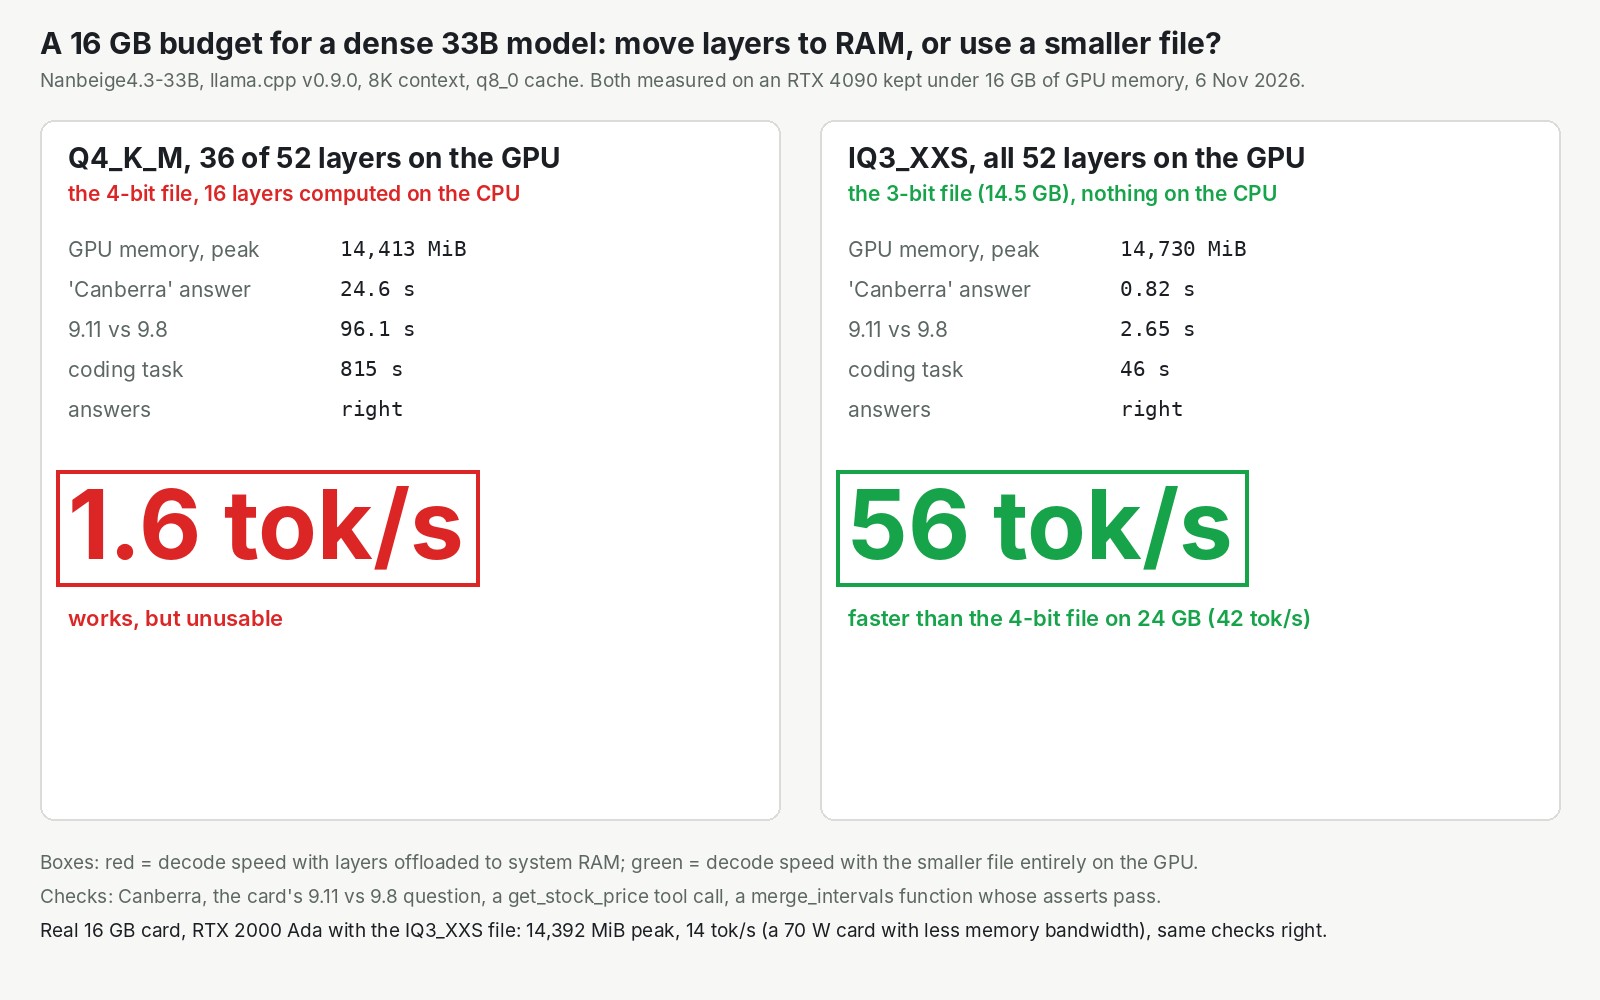
Avec un modèle dense, le fichier qui tient sur la carte bat le meilleur fichier qui n'y tient pas. Nanbeige4.3-33B, un nouveau modèle d'agent sous Apache-2.0 pour le code, a écrit environ 42 tokens par seconde sur une seule RTX 4090 de 24 GB de notre cloud, avec des appels d'outil valides à chaque fois. Avec un budget de 16 GB, son fichier 4 bits, dont un tiers du modèle sortait de la carte, s'est traîné à 1,6 token par seconde. Le fichier 3 bits, plus petit et entièrement sur la carte, a passé toutes les vérifications, à environ 14 tokens par seconde sur une vraie carte de station de travail de 16 GB. Pour une équipe qui déploie ses propres modèles, cela donne un modèle d'agent ouvert sur une seule carte que l'on possède ou que l'on loue, et une règle claire pour choisir le fichier. Essayez-le sur 24 GB, ou sur 16 GB avec le fichier 3 bits. Un piège d'abord : avec le raisonnement activé, le réglage par défaut, la réponse finale de l'agent est revenue vide dans 2 exécutions sur 3.
Un 33B où tout l'orchestre joue chaque mesure
Les modèles d'agent que nous avons testés avant lui, comme Groot-19B et Clover-35B-A3B, n'utilisent qu'une petite partie de leurs paramètres pour chaque mot : un grand orchestre où seuls quelques solistes jouent chaque mesure. Nanbeige4.3-33B est dense. Ses 33 milliards de paramètres travaillent tous sur chaque token.
Cela a un prix que l'on peut mesurer. Pour écrire chaque mot, la carte relit tout le fichier du modèle dans sa propre mémoire. Avec le fichier 4 bits, cela fait 20,8 GB par mot. Un fichier plus petit, c'est moins à lire et plus de mots par seconde. Tout ce qui reste hors de la mémoire de la carte se lit beaucoup plus lentement, et la vitesse s'effondre.
Le modèle a été publié sur Hugging Face le 24 octobre par l'équipe Nanbeige de BOSS Zhipin. Ses auteurs revendiquent "state-of-the-art agentic performance among open models in the ~30B parameter class". Non compressé, il pèse 66 GB, et leurs propres recettes de service le répartissent sur quatre GPU. bartowski a publié des versions compressées en un seul fichier pour llama.cpp, le moteur gratuit que nous avons utilisé.
Les auteurs le placent devant Qwen3.8-27B sur deux des trois tests de code pour agents, et ils publient aussi la défaite. Ce sont leurs chiffres, avec le raisonnement au maximum. Nous ne les avons pas reproduits.
| Test (chiffres des auteurs) | Nanbeige4.3-33B | Qwen3.8-27B |
|---|---|---|
| Terminal-Bench 2.1 | 80,9 | 73,0 |
| DeepSWE | 65,5 | 42,5 |
| SWE-Bench Pro | 60,3 | 61,7 |
Ce qu'une seule carte de 24 GB nous a donné
Avec le fichier 4 bits recommandé par bartowski, tout le modèle tenait sur la RTX 4090. Il a écrit de 42 à 44 tokens par seconde pour une requête, et le premier token revenait en un quart à une demi-seconde sur des prompts courts.
Nos vérifications étaient modestes : une réponse en un mot, la question 9.11 ou 9.8 de la page du modèle, une tâche de code avec ses propres tests, et deux appels d'outil. Un appel d'outil, c'est le modèle qui demande à votre code d'exécuter une fonction, ici un cours de bourse et une recherche météo pour deux villes à la fois. Le code a passé ses tests en 24,6 secondes. Chaque appel d'outil est revenu valide, au format OpenAI standard.
La même carte a tenu un prompt de 64K tokens, environ 50 000 mots, et a trouvé un mot secret caché au token 61 428. L'écriture est descendue à 16 tokens par seconde à mesure que le prompt se remplissait.
La règle des 16 GB : un fichier plus petit, tout sur la carte
La plus petite carte qui a passé les tests est une vraie : une RTX 2000 Ada, une carte de station de travail de 16 GB et 70 watts, avec le fichier 3 bits de bartowski. Elle a passé les mêmes vérifications à environ un tiers de la vitesse de la 4090, donc une réponse de 400 tokens prend environ 30 secondes au lieu de 10.
Les deux lignes à 16 GB de l'image ont tourné sur la 4090 complète, avec un pic sous le budget : lisez-les comme des chiffres de mémoire, pas comme des promesses de vitesse. La leçon tient quand même : un tiers d'un modèle dense hors de la carte a transformé un modèle rapide en un modèle qui a mis 815 secondes pour une tâche de code. Plus bas, le fichier 2 bits tenait sous 12 GB et a bien répondu 9.8, mais a mal expliqué sa décimale, ce qui suffit pour le tenir à l'écart du code.
Le problème des réponses vides
Avec le raisonnement activé, certaines réponses arrivent vides, avec tout le texte rangé dans le champ de raisonnement du modèle. C'est arrivé à chaque dissertation de 400 mots que nous avons demandée, et à la réponse finale de l'agent après les résultats météo dans 2 exécutions sur 3, une fois sur chaque carte. Les appels d'outil eux-mêmes n'ont jamais été touchés.
Avec le raisonnement désactivé dans une requête envoyée directement à llama.cpp, la dissertation est revenue dans la réponse normale. Via InferenceKey, cet interrupteur par requête ne passe pas encore : notre endpoint le supprime. Statut : ouvert de notre côté. Un réglage du serveur devrait désactiver le raisonnement pour toutes les requêtes, mais nous ne l'avons pas essayé, et les auteurs recommandent de garder le raisonnement activé pour les agents.
Sur InferenceKey, la plateforme n'a eu besoin d'aucun changement : un numéro de version et une commande de lancement. Le déploiement était prêt en 303,7 secondes sur la 4090, presque tout ce temps passé par le worker (le petit programme sur votre machine GPU qui reçoit les ordres de la plateforme) à compiler llama.cpp pour ce GPU. Sur un hôte de 16 GB bridé, la même compilation a pris 19 minutes 50 secondes.
Le modèle et les benchmarks sont le travail de l'équipe Nanbeige, les fichiers compressés celui de bartowski, le moteur celui des mainteneurs de llama.cpp. Notre part : le déploiement, les tests et l'exemple du SDK.
À qui ça s'adresse
- Les équipes avec une carte de 24 GB qui veulent un modèle d'agent ouvert pour le code. Ça vaut l'essai. Comparez les scores des auteurs avec vos propres tâches.
- Les équipes avec une carte de 16 GB. Utilisez le fichier 3 bits entièrement sur la carte, jamais le 4 bits avec un tiers qui en sort.
- Les équipes qui l'utilisent déjà comme agent. Attendez-vous à des réponses finales vides avec le raisonnement activé, tant que cet interrupteur ne passe pas.
La limite honnête : nous avons envoyé une requête à la fois sur nos propres petits prompts, des appels d'outil isolés et un seul tour d'agent, pas un agent qui travaille dans une vraie base de code.
Lire le test complet
L'article Research contient l'échelle de mémoire, chaque mesure de temps et l'exemple du SDK. Lisez le test complet de Nanbeige4.3-33B dans l'article Research.