Ming-3.0-tts bringt Voice Cloning, Voice Design und Spanisch in 3 GB unter, mit zwei Dritteln der Echtzeit
Ming-3.0-tts brauchte auf einer 16-GB-Karte höchstens 2,9 GB, traf 17 von 19 Sätzen Wort für Wort und sprach mit etwa 0,65x Echtzeit.
Wie klein darf eine Grafikkarte für einen Stimmklon sein? Für Ming-3.0-tts-0.5B, ein neues Sprachmodell von inclusionAI unter MIT-Lizenz, lautet die Antwort aus unserem Test: etwa 3 GB GPU-Speicher. Auf einer RTX 2000 Ada mit 16 GB lag die Spitze bei 2,9 GB. Auf 3 GB begrenzt, erzeugte es Byte für Byte dasselbe Audio. Das ist wichtig, wenn Sie Ihre eigenen GPUs betreiben: Eine kleine Workstation-Karte kann eine Stimme aus einem kurzen Clip klonen, aus einer schriftlichen Beschreibung eine neue Stimme erfinden und neben Englisch auch Spanisch sprechen, mit einer Lizenz, die kommerzielle Nutzung erlaubt. Der Preis ist die Geschwindigkeit. Es erzeugt Sprache langsamer, als sie abläuft, auf der kleinen Karte mit etwa zwei Dritteln der Echtzeit und selbst auf einer viel schnelleren Karte noch unter Echtzeit. Nutzen Sie es also für aufgezeichnete Sprechertexte und Voice-overs, nicht für einen Sprachagenten, der live antworten muss.
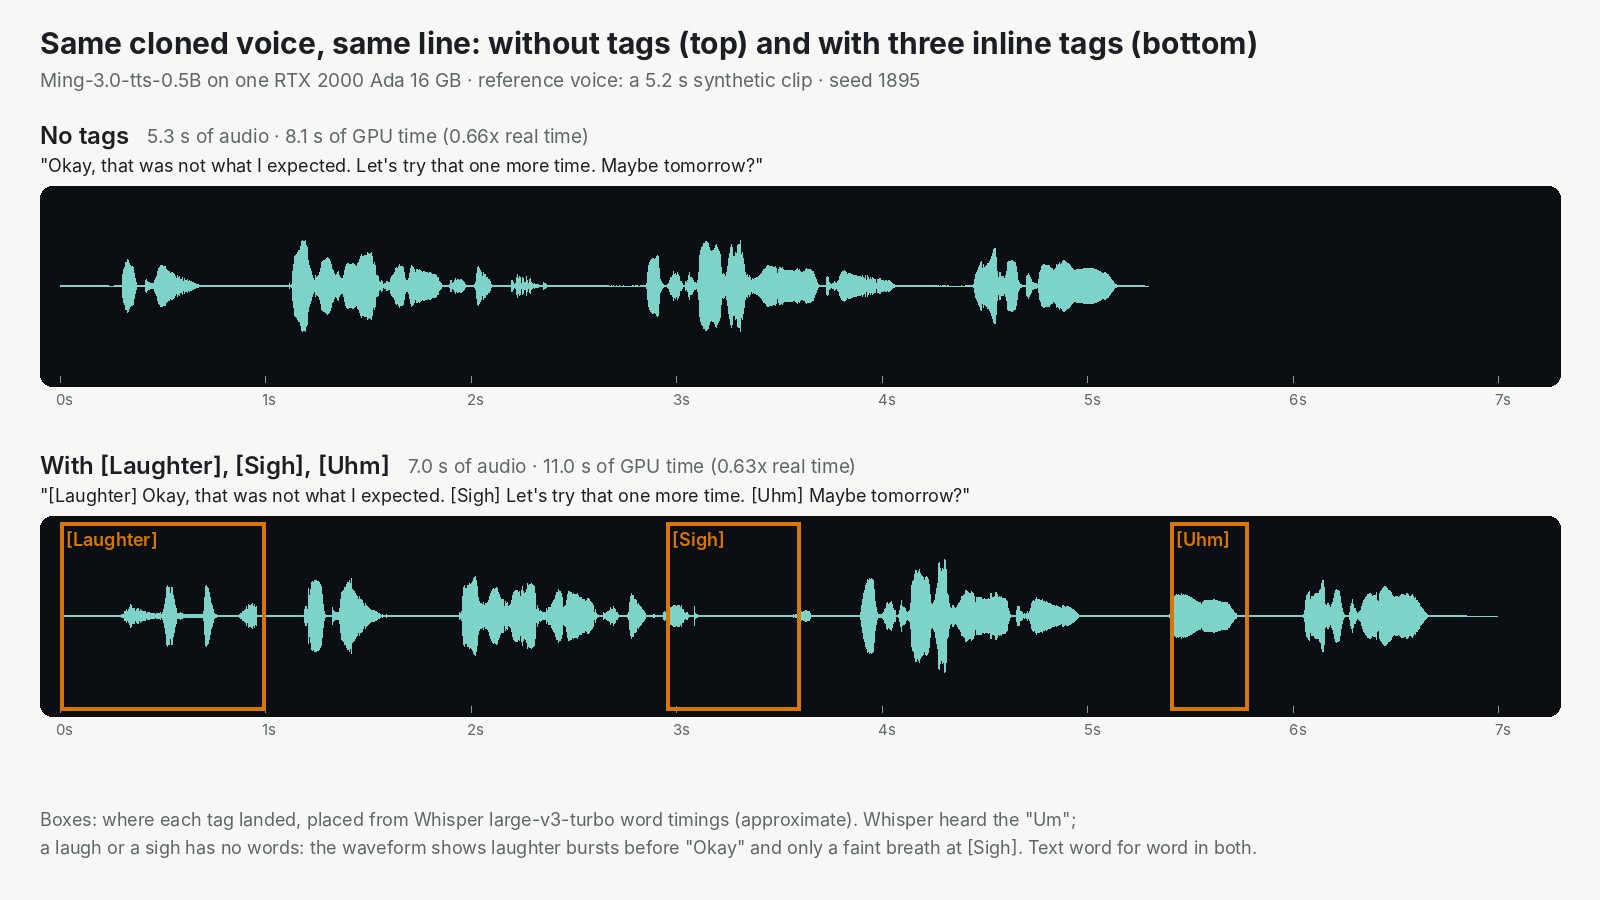
Eine geklonte Stimme, ein Satz, eine Karte. Drei Tags in eckigen Klammern fügten 1,7 Sekunden Klang hinzu, und die Wörter stimmten beide Male.
Ein Stimmwerkzeug mit fünf Funktionen in einem kleinen Download
Das Modell stammt vom inclusionAI-Team der Ant Group, das Gewichte und Code unter MIT veröffentlicht hat, mit eigenen Benchmarks und einem ehrlichen Abschnitt zu den Grenzen. Das Verdienst für das Modell gehört ihnen. Unser Teil war, ihren Code zu verpacken, ihn auf einer kleineren Karte laufen zu lassen, als sie angeben, und die Ausgabe zu prüfen.
Die Modellseite nennt fünf Wege, eine Stimme zu formen. Es klont eine Stimme aus einem kurzen Clip. Es baut aus einem Satz eine neue Stimme, was die Autoren Voice Design nennen. Es folgt freien Anweisungen dazu, wie ein Satz gesprochen werden soll. Es bringt fertige englische und chinesische Stimmen mit. Und es versteht 14 Inline-Tags, Wörter in eckigen Klammern wie [Laughter] oder [Sigh], die mitten im Satz zu Geräuschen werden.
Entdeckt haben wir es im News-Video von AI Search vom 25. Oktober, in dem der Moderator sagte, es sollte auf vielen Consumer-GPUs laufen. Die Autoren sagen nur, dass sie es auf zwei Rechenzentrumskarten mit 80 GB und 96 GB getestet haben, und nennen keine Speicherangabe. Genau diese Lücke wollten wir prüfen.
Was wir gefunden haben: wenig Speicher, richtige Wörter, langsam
Wir haben den Code der Autoren unverändert auf einer RTX 2000 Ada in unserer Cloud laufen lassen. Das ist eine kleine Workstation-Karte mit einem Leistungslimit von 70 Watt. Wir haben 19 Testsätze auf Englisch, Spanisch und Chinesisch geschickt und fünf davon dann auf einer RTX 4090 wiederholt.
Die Wörter stimmten fast immer genau. Whisper, das Speech-to-Text-Modell von OpenAI, hat jeden Clip transkribiert, und 17 von 19 kamen Wort für Wort zurück, darunter Absätze von 18 bis 21 Sekunden. Beide Fehler betrafen Zahlen.
Die Klone hielten, sogar über Sprachen hinweg. Ein Modell zur Sprechererkennung bewertete jeden Clip gegen unsere Referenzstimme, von 0 (nichts gemeinsam) bis 1 (identisch):
| Clip | Dieselbe Stimme wie die Referenz? (0 bis 1) |
|---|---|
| Englischer Klon | 0,87 |
| Spanischer Klon, aus der englischen Referenz | 0,84 |
| Entworfene Erzählerstimme (kein Klon) | 0,32 |
Aus einer englischen Referenz hielt der spanische Klon die Stimme so gut wie der englische. Die Referenz selbst war synthetisch, eine Standardstimme aus Pocket TTS, wir haben also eine Stimme geklont, die niemandem gehört. Das folgt der Regel der Autoren selbst, niemanden ohne Einwilligung nachzuahmen.
Der Haken ist die Geschwindigkeit. Auf der kleinen Karte brauchte ein englischer Absatz von 20,7 Sekunden 31 bis 32 Sekunden. Die RTX 4090 erzeugte einen Absatz von 20,9 Sekunden in 27 Sekunden, etwa 17 % schneller für eine viel größere Karte. Die Karte war nicht der Engpass: Die kleine war weniger als ein Drittel der Zeit beschäftigt. Ming schreibt Audio in Scheiben von 80 Millisekunden, eine nach der anderen, und eine Python-Schleife zwischen den Scheiben gibt das Tempo vor. Stellen Sie sich einen Session-Gitarristen vor, der darauf wartet, dass der Bandleader jeden Akkord ansagt: Ein schnellerer Gitarrist macht den Song nicht kürzer.
Für wen das interessant ist
- Teams, die Voice-overs, Hörbuchproben oder vertonte Demos machen. Eine kleine Karte liefert Klonen, entworfene Stimmen und Tags, unter einer kommerziellen Lizenz.
- Alle, die spanische Sprechertexte aus einer englischen Stimme brauchen. Der sprachübergreifende Klon hielt bei unseren maschinellen Prüfungen.
- Teams mit kleinen GPUs. Wir schätzen, dass etwa 4 GB Speicher reichen, ungetestet auf einer echten Karte dieser Größe.
- Alle, die einen Live-Sprachagenten bauen. Suchen Sie vorerst woanders: Es spricht langsamer, als es abläuft, und eine größere Karte hilft kaum.
Zwei kleinere Warnungen. Zahlen sind unzuverlässig: Eine Telefonnummer kam als Subtraktion heraus, und spanische Preise kamen verstümmelt heraus, prüfen Sie also jeden Preis, jedes Datum und jede Bestellnummer im Audio. Und auf InferenceKey gibt es keine fertige Unterstützung für Ming, deshalb haben wir den Code der Autoren in ein Custom Backend gepackt, eine kurze Python-Datei, die unsere Plattform auf Ihrer GPU-Maschine installiert und ausführt. Auf einer frischen Maschine lief es nach 60,3 Sekunden.
Die ehrliche Grenze: Jede Prüfung lief maschinell und niemand hat zugehört. Wir stehen also für die Wörter und die Stimmübereinstimmung ein, nicht dafür, wie natürlich es klingt.
Der vollständige Test
Der Research-Beitrag hat die Audiobeispiele, die Zahlen Satz für Satz, die Speichergrenzen, die wir ausprobiert haben, die Zahlen, die schiefgingen, und das SDK-Beispiel, das es auf Ihrer eigenen GPU deployt. Lesen Sie den vollständigen Test von Ming-3.0-tts im Research-Beitrag.