Ming-3.0-tts fait tenir clonage de voix, création de voix et espagnol dans 3 GB, aux deux tiers du temps réel
Ming-3.0-tts a culminé à 2,9 GB sur une carte de 16 GB, a rendu 17 phrases sur 19 mot pour mot et a parlé à environ 0,65x le temps réel.
Quelle taille de carte graphique faut-il pour cloner une voix ? Pour Ming-3.0-tts-0.5B, un nouveau modèle de synthèse vocale d'inclusionAI sous licence MIT, notre test répond : environ 3 GB de mémoire GPU. Sur une RTX 2000 Ada de 16 GB, il a culminé à 2,9 GB. Plafonné à 3 GB, il a produit exactement le même audio, octet pour octet. C'est important si vous faites tourner vos propres GPU : une seule petite carte de station de travail peut cloner une voix à partir d'un court extrait, inventer une voix nouvelle à partir d'une description écrite et parler espagnol aussi bien qu'anglais, avec une licence qui autorise l'usage commercial. Le prix à payer, c'est la vitesse. Il génère la parole plus lentement qu'elle ne se joue, environ aux deux tiers du temps réel sur la petite carte, et toujours sous le temps réel sur une carte bien plus rapide. Utilisez-le donc pour de la narration enregistrée et des voix off, pas pour un agent vocal qui doit répondre en direct.
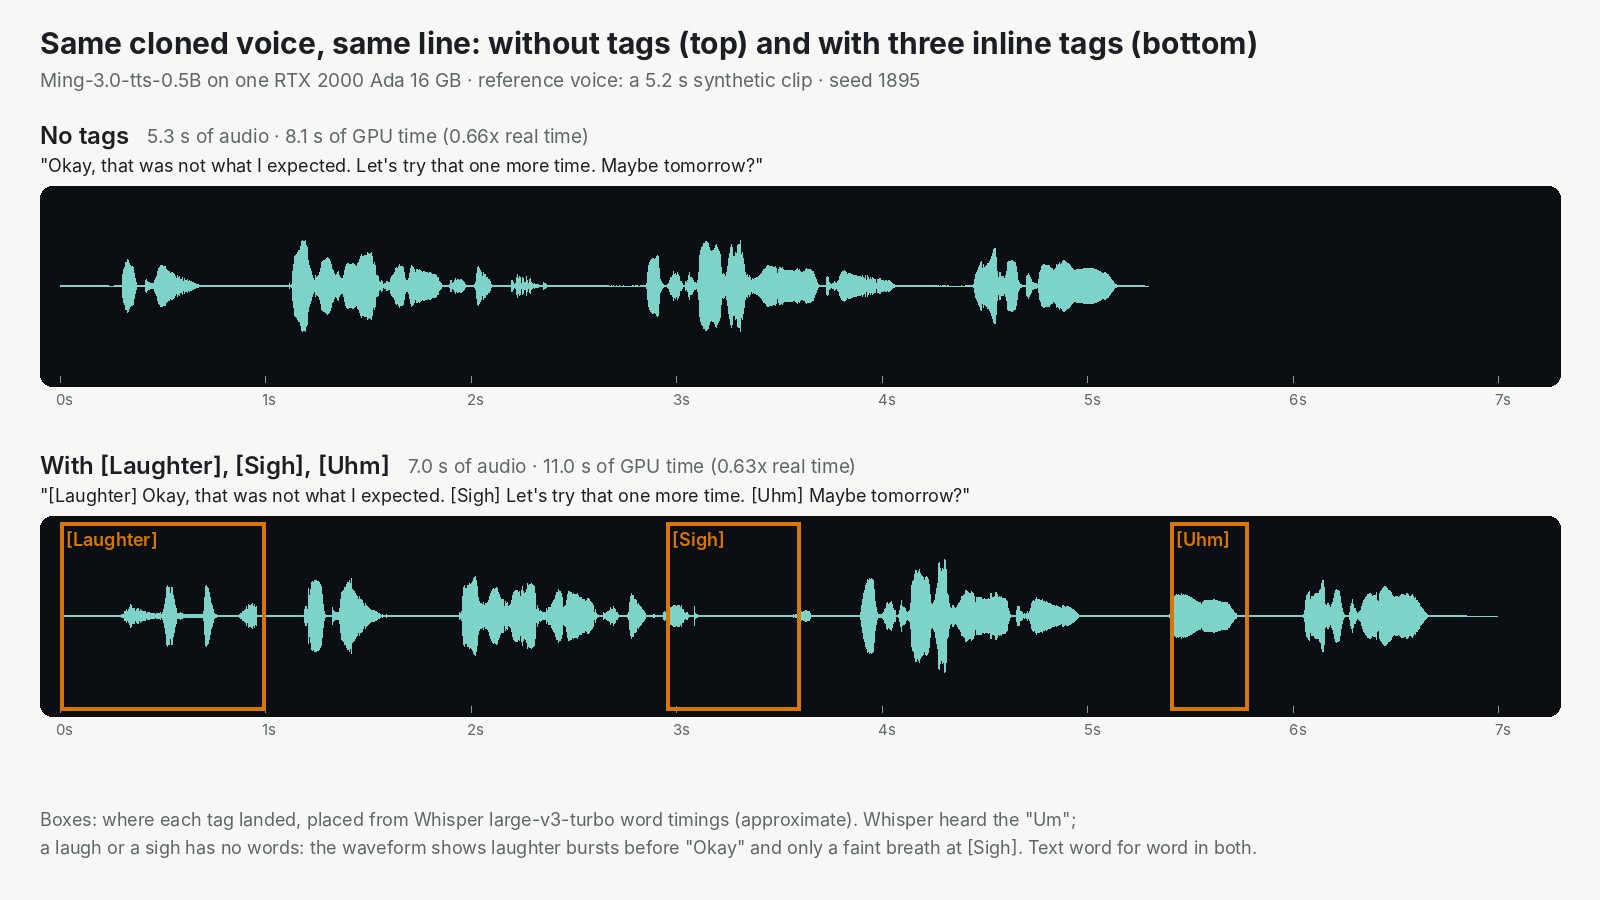
Une voix clonée, une phrase, une carte. Trois balises entre crochets ont ajouté 1,7 seconde de son, et les mots sont sortis justes les deux fois.
Une boîte à outils vocale à cinq fonctions dans un petit téléchargement
Le modèle vient de l'équipe inclusionAI d'Ant Group, qui a publié les poids et le code sous MIT, avec ses propres benchmarks et une section honnête sur les limites. Le mérite du modèle leur revient. Notre part a été d'empaqueter leur code, de le faire tourner sur une carte plus petite que celles qu'ils indiquent et de vérifier le résultat.
La page du modèle liste cinq façons de façonner une voix. Il clone une voix à partir d'un court extrait. Il construit une voix nouvelle à partir d'une phrase, ce que les auteurs appellent la création de voix (voice design). Il suit des consignes libres sur la manière de dire une phrase. Il embarque des voix intégrées en anglais et en chinois. Et il accepte 14 balises en ligne, des mots entre crochets comme [Laughter] ou [Sigh], qui deviennent des sons au milieu d'une phrase.
Nous l'avons repéré dans la vidéo d'actualité d'AI Search du 25 octobre, où le présentateur disait qu'il devrait tourner sur beaucoup de GPU grand public. Les auteurs disent seulement l'avoir testé sur deux cartes de data center de 80 GB et 96 GB, sans donner de chiffre de mémoire. C'est cet écart que nous sommes allés vérifier.
Ce que nous avons trouvé : léger en mémoire, juste sur les mots, lent en temps
Nous avons fait tourner le code des auteurs, sans modification, sur une RTX 2000 Ada de notre cloud. C'est une petite carte de station de travail limitée à 70 watts. Nous avons envoyé 19 phrases de test en anglais, en espagnol et en chinois, puis en avons répété cinq sur une RTX 4090.
Les mots étaient presque toujours exacts. Whisper, le modèle de transcription d'OpenAI, a transcrit chaque extrait, et 17 sur 19 sont revenus mot pour mot, y compris des paragraphes de 18 à 21 secondes. Les deux ratés concernaient des nombres.
Les clones ont tenu, même d'une langue à l'autre. Un modèle de reconnaissance du locuteur a noté chaque extrait de 0 (sans rapport) à 1 (identique) par rapport à notre voix de référence :
| Extrait | Même voix que la référence ? (0 à 1) |
|---|---|
| Clone en anglais | 0,87 |
| Clone en espagnol, à partir de la référence anglaise | 0,84 |
| Voix de narrateur créée (pas un clone) | 0,32 |
À partir d'une référence anglaise, le clone espagnol a gardé la voix aussi bien que l'anglais. La référence elle-même était synthétique, une voix standard de Pocket TTS, donc nous avons cloné une voix qui n'appartient à personne. Cela respecte la règle des auteurs eux-mêmes : ne jamais imiter quelqu'un sans son consentement.
La vitesse, c'est le hic. Sur la petite carte, un paragraphe anglais de 20,7 secondes a pris 31 à 32 secondes à générer. La RTX 4090 a produit un paragraphe de 20,9 secondes en 27 secondes, environ 17 % plus vite pour une carte bien plus grosse. La carte n'était pas le goulot d'étranglement : la petite était occupée moins d'un tiers du temps. Ming écrit l'audio par tranches de 80 millisecondes, l'une après l'autre, et c'est une boucle Python entre les tranches qui donne la cadence. Imaginez un guitariste de studio qui attend que le chef d'orchestre annonce chaque accord : un guitariste plus rapide ne raccourcit pas le morceau.
À qui ça s'adresse
- Les équipes qui produisent des voix off, des extraits de livres audio ou des démos commentées. Une seule petite carte vous donne le clonage, les voix créées et les balises, sous une licence commerciale.
- Quiconque a besoin d'une narration en espagnol à partir d'une voix anglaise. Le clone d'une langue à l'autre a tenu lors de nos vérifications automatiques.
- Les équipes sur de petits GPU. Nous estimons qu'environ 4 GB suffisent côté mémoire, sans l'avoir testé sur une vraie carte de cette taille.
- Quiconque construit un agent vocal en direct. Cherchez ailleurs pour l'instant : il parle plus lentement que l'audio ne se joue, et une carte plus grosse aide à peine.
Deux avertissements plus mineurs. Les nombres ne sont pas fiables : un numéro de téléphone est sorti comme une soustraction, et des prix en espagnol sont sortis brouillés, donc vérifiez chaque prix, date et numéro de commande dans l'audio. Et sur InferenceKey, Ming n'a pas de support prêt à l'emploi, donc nous avons enveloppé le code des auteurs dans un backend personnalisé, un court fichier Python que notre plateforme installe et exécute sur votre machine GPU. Il servait des requêtes en 60,3 secondes à partir d'une machine vierge.
La limite honnête : toutes les vérifications ont été faites par des machines et personne n'a écouté, donc nous garantissons les mots et la ressemblance de la voix, pas le naturel du rendu.
Le test complet
L'article Research contient les échantillons audio, les chiffres phrase par phrase, les plafonds de mémoire que nous avons essayés, les nombres qui ont déraillé et l'exemple SDK qui le déploie sur votre propre GPU. Lisez le test complet de Ming-3.0-tts dans l'article Research.