Ming-3.0-tts mete clonación de voz, diseño de voces y español en 3 GB, a dos tercios del tiempo real
Ming-3.0-tts llegó a 2,9 GB en una tarjeta de 16 GB, clavó 17 de 19 frases palabra por palabra y generó voz a unas 0,65x del tiempo real.
¿Qué tarjeta gráfica tan pequeña basta para clonar una voz? Para Ming-3.0-tts-0.5B, un nuevo modelo de voz de inclusionAI con licencia MIT, la respuesta de nuestra prueba es unos 3 GB de memoria de GPU. En una RTX 2000 Ada de 16 GB llegó como máximo a 2,9 GB. Con un tope de 3 GB, generó exactamente el mismo audio, byte a byte. Eso importa si tienes tus propias GPU: una sola tarjeta pequeña de estación de trabajo puede clonar una voz a partir de un clip corto, inventar una voz nueva a partir de una descripción escrita y hablar español además de inglés, con una licencia que permite el uso comercial. El precio es la velocidad. Genera la voz más despacio de lo que dura al reproducirla, unos dos tercios del tiempo real en la tarjeta pequeña, y sigue por debajo del tiempo real en una mucho más rápida. Así que úsalo para narraciones grabadas y locuciones, no para un agente de voz que tenga que responder en directo.
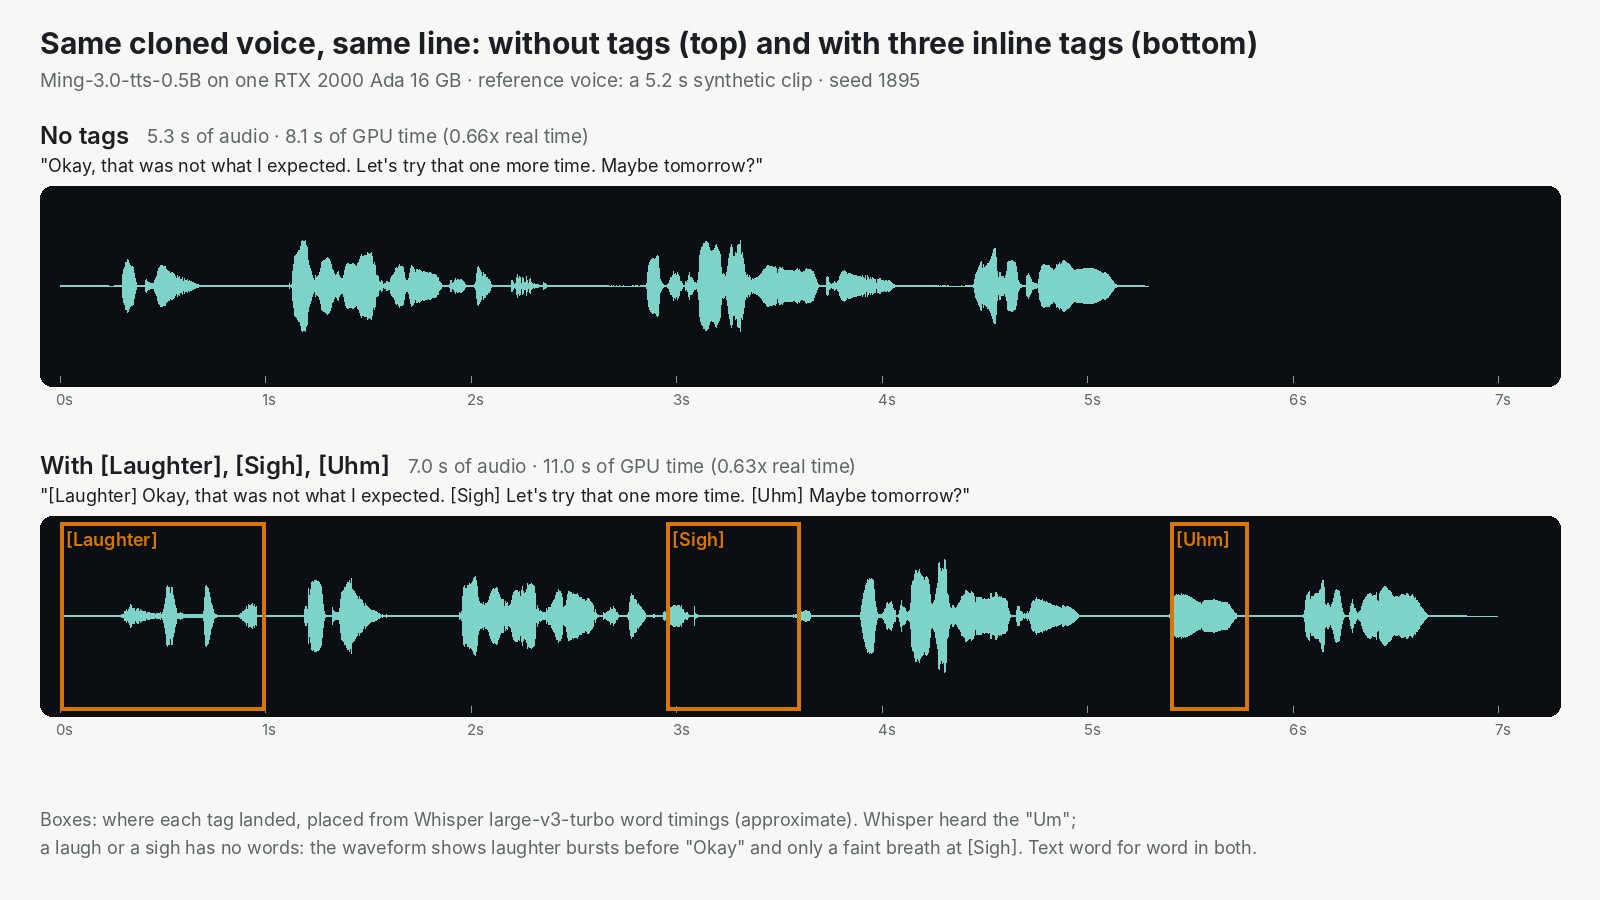
Una voz clonada, una frase, una tarjeta. Tres etiquetas entre corchetes añadieron 1,7 segundos de sonido, y las palabras salieron bien las dos veces.
Cinco herramientas de voz en una descarga pequeña
El modelo es obra del equipo inclusionAI de Ant Group, que publicó los pesos y el código bajo MIT, con sus propios benchmarks y una sección de limitaciones honesta. El mérito del modelo es suyo. Nuestra parte fue empaquetar su código, ejecutarlo en una tarjeta más pequeña que las que ellos indican y comprobar el resultado.
La página del modelo enumera cinco formas de dar forma a una voz. Clona una voz a partir de un clip corto. Crea una voz nueva a partir de una frase, lo que los autores llaman diseño de voz. Sigue indicaciones libres sobre cómo decir una línea. Trae voces integradas en inglés y chino. Y acepta 14 etiquetas en línea, palabras entre corchetes como [Laughter] o [Sigh], que se convierten en sonidos en mitad de una frase.
Lo vimos en el vídeo de noticias de AI Search del 25 de octubre, donde el presentador dijo que debería funcionar en muchas GPU de consumo. Los autores solo dicen que lo probaron en dos tarjetas de centro de datos de 80 GB y 96 GB, y no dan ninguna cifra de memoria. Ese hueco es lo que fuimos a comprobar.
Lo que encontramos: poca memoria, palabras correctas, lento
Ejecutamos el código de los autores, sin cambios, en una RTX 2000 Ada de nuestra nube. Es una tarjeta pequeña de estación de trabajo con un límite de potencia de 70 vatios. Enviamos 19 frases de prueba en inglés, español y chino, y después repetimos cinco de ellas en una RTX 4090.
Las palabras salieron exactas casi siempre. Whisper, el modelo de voz a texto de OpenAI, transcribió cada clip, y 17 de 19 coincidieron palabra por palabra, incluidos párrafos de 18 a 21 segundos. Los dos fallos fueron números.
Los clones aguantaron, incluso al cambiar de idioma. Un modelo de reconocimiento de hablante puntuó cada clip de 0 (sin relación) a 1 (idéntico) frente a nuestra voz de referencia:
| Clip | ¿Misma voz que la referencia? (0 a 1) |
|---|---|
| Clon en inglés | 0,87 |
| Clon en español, a partir de la referencia en inglés | 0,84 |
| Voz de narrador diseñada (no es un clon) | 0,32 |
A partir de una referencia en inglés, el clon en español mantuvo la voz tan bien como el inglés. La propia referencia era sintética, una voz de serie de Pocket TTS, así que clonamos una voz que no es de nadie. Eso sigue la propia regla de los autores contra suplantar a nadie sin su consentimiento.
La pega es la velocidad. En la tarjeta pequeña, un párrafo en inglés de 20,7 segundos tardó entre 31 y 32 segundos en generarse. La RTX 4090 generó un párrafo de 20,9 segundos en 27 segundos, alrededor de un 17 % más rápido con una tarjeta mucho más grande. La tarjeta no era el cuello de botella: la pequeña estuvo ocupada menos de un tercio del tiempo. Ming escribe el audio en trozos de 80 milisegundos, uno detrás de otro, y un bucle de Python entre trozo y trozo marca el ritmo. Imagina un guitarrista de sesión que espera a que el director de la banda le cante cada acorde: un guitarrista más rápido no hace la canción más corta.
A quién le interesa
- Equipos que hacen locuciones, muestras de audiolibros o demos narradas. Una tarjeta pequeña te da clonación, voces diseñadas y etiquetas, con licencia comercial.
- Cualquiera que necesite narración en español con una voz en inglés. El clon entre idiomas aguantó en nuestras comprobaciones automáticas.
- Equipos con GPU pequeñas. Calculamos que unos 4 GB bastan en memoria, sin probarlo en una tarjeta real de ese tamaño.
- Quien esté construyendo un agente de voz en directo. Por ahora, busca en otra parte: habla más despacio de lo que se reproduce, y una tarjeta más grande apenas ayuda.
Dos avisos menores. Los números no son fiables: un número de teléfono salió como una resta y los precios en español salieron ininteligibles, así que revisa cada precio, fecha y número de pedido en el audio. Y en InferenceKey no hay soporte listo para Ming, así que envolvimos el código de los autores en un backend personalizado, un fichero corto de Python que nuestra plataforma instala y ejecuta en tu máquina con GPU. Estaba sirviendo en 60,3 segundos desde una máquina limpia.
El límite honesto: todas las comprobaciones las hizo una máquina y nadie lo escuchó, así que respondemos de las palabras y del parecido de la voz, no de lo natural que suena.
Lee la prueba completa
El post de Research tiene las muestras de audio, las cifras por frase, los topes de memoria que probamos, los números que se rompieron y el ejemplo del SDK que lo despliega en tu propia GPU. Lee la prueba completa de Ming-3.0-tts en el post de Research.