Carbon-X trie les variants d'ADN sur une carte de jeu, mais vérifiez ses raisons
Carbon-X a bien classé 75 % de 40 variants ClinVar sur une RTX 4090 de 24 GB en 8 bits, à 2,5 s par réponse. Ses explications ratent souvent.
Un modèle d'ADN qui donne le bon verdict avec un mauvais raisonnement reste utile, à condition de savoir à quelle moitié se fier. C'est là que notre test a laissé Carbon-X, le nouveau modèle ouvert de Hugging Face qui lit de l'ADN brut au milieu d'une conversation ordinaire et répond en anglais. Sur une RTX 4090 de 24 GB de notre cloud, avec ses poids réduits à 8 bits, il a correctement classé comme nocifs ou inoffensifs 75 % de 40 variants connus tirés de ClinVar. Les auteurs annoncent 74,9 %. Une question portant sur deux séquences de 4 096 lettres revenait en environ 2,5 secondes. Si vous déployez des modèles pour un labo ou une équipe de génomique, voici un spécialiste de l'ADN qui tourne sur vLLM standard avec une seule ligne de commande, sur une seule carte que vous contrôlez, donc les séquences non publiées ne quittent jamais votre machine. Servez-vous de ses étiquettes comme d'un premier tri sur une longue liste. Ne vous fiez pas aux explications qu'il écrit autour.
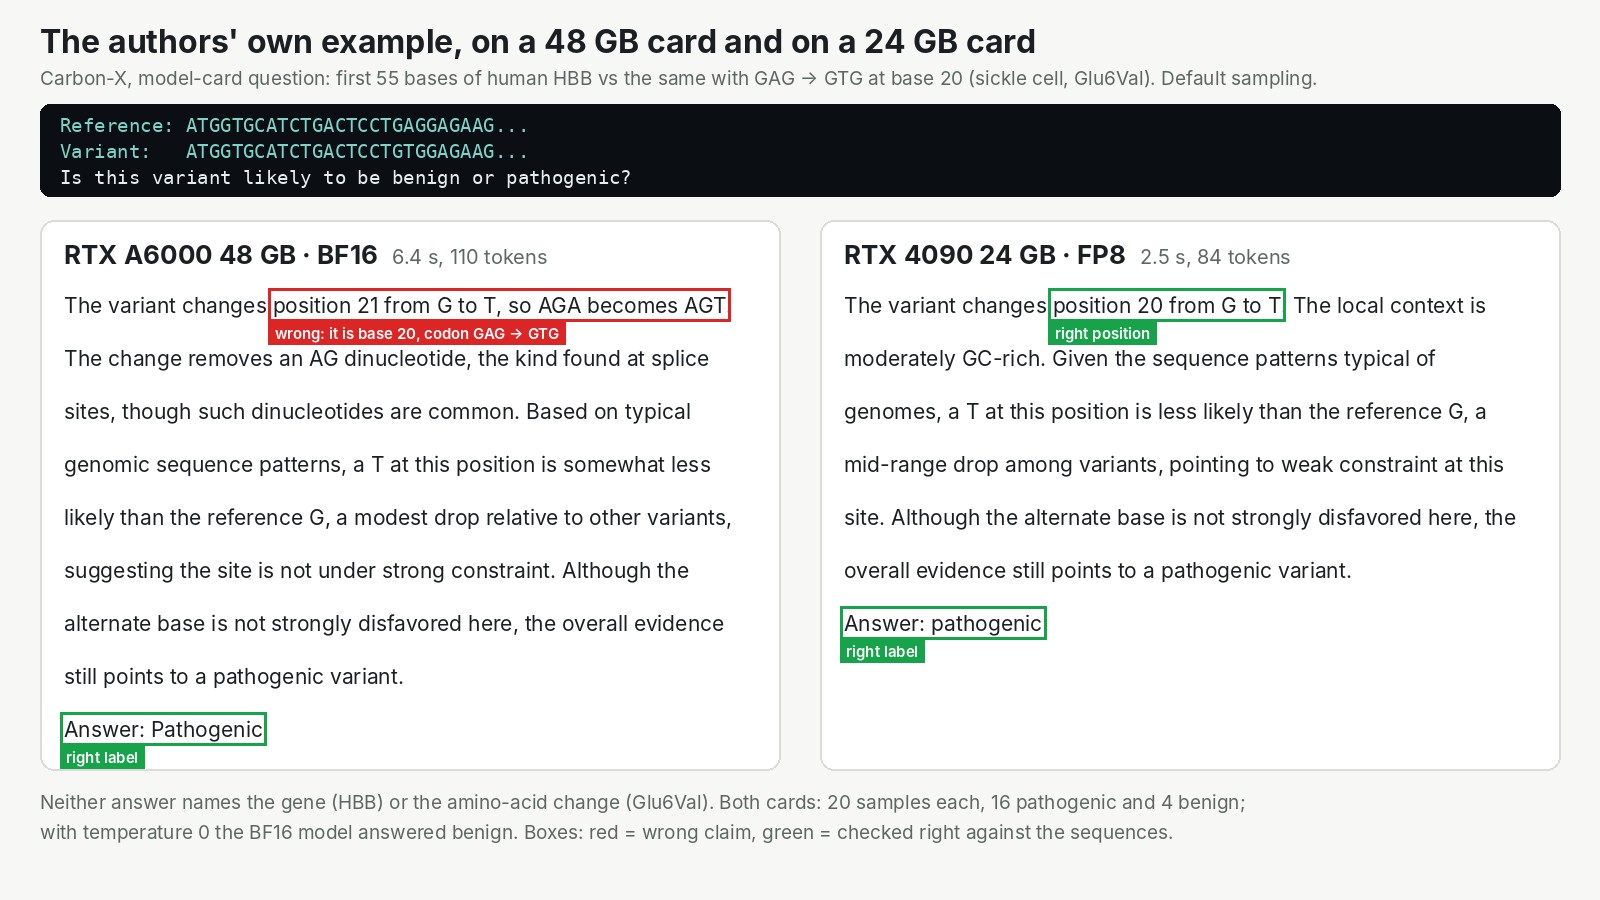
Même question, deux cartes, un essai chacune. Les deux ont dit pathogène. Une seule a désigné la bonne lettre, et aucune n'a nommé le gène.
Un modèle de chat de 14B qui a appris à lire l'ADN
Carbon-X, c'est Qwen3-14B, le modèle de chat ouvert de l'équipe Qwen, réentraîné sur de l'ADN et des textes de biologie par un groupe de Hugging Face, de la Zhongguancun Academy et du TIGEM / Université de Naples Frédéric II. Ils ont publié les poids sous Apache-2.0, sans accès restreint, avec leurs recettes d'entraînement et d'évaluation. Le mérite du modèle leur revient. Notre part a été de le servir sur notre plateforme, de construire un jeu de test public et de le mesurer.
La seule vraie nouveauté, c'est la façon dont il découpe l'ADN en tokens, les morceaux qu'un modèle de langage lit. Carbon-X ajoute 5 515 tokens d'ADN au vocabulaire de Qwen, et la plupart sont des blocs de six lettres parmi A, C, G et T. Un token couvre six bases, comme un guitariste qui lit une suite de six notes comme une seule forme. C'est pour ça que les longues séquences passent : nos deux séquences de 4 096 lettres plus la question faisaient 1 445 tokens. Collez une séquence dans une phrase et le modèle la repère tout seul comme de l'ADN.
Le chiffre phare des auteurs est une moyenne de 66,7 % sur cinq benchmarks d'ADN, contre 67,5 % pour GPT-6.1 Sol et 60,9 % pour Opus 5.5, pour une petite fraction du coût selon leurs propres tarifs. Nous n'avons pas reproduit cette moyenne : leurs données d'évaluation ne sont pas publiques, donc nous avons construit notre propre jeu de 120 questions à partir de sources publiques.
Ce que nous avons trouvé : les étiquettes rejoignent celles des auteurs
Quarante de nos questions étaient de vrais variants ClinVar dans des gènes codant des protéines, 20 inoffensifs et 20 nocifs, tirés du même jeu de test que celui des auteurs. Le modèle ne voyait que les deux séquences et notre question, jamais le nom du gène.
| Variants ClinVar (40) | Vitesse, une requête | |
|---|---|---|
| RTX A6000 48 GB, poids 16 bits | 80,0 % | 19,5 tokens/s |
| RTX 4090 24 GB, poids 8 bits | 75,0 % | 50,5 tokens/s |
| Auteurs (les 1 018 variants) | 74,9 % |
Les deux lignes ont été mesurées avec l'aléatoire du modèle désactivé. L'écart entre les cartes est de deux variants sur 40, dans le bruit, et les deux étaient d'accord sur 36 sur 40. La petite carte était aussi plus rapide, parce que les poids 8 bits font l'essentiel du travail : une question complète sur un variant prenait 2,4 à 2,6 secondes sur la 4090, contre 7,1 à 7,5 sur la carte de 48 GB en 16 bits.
Les erreurs penchent d'un côté. Sur la carte de 48 GB, il a attrapé 19 des 20 variants nocifs, mais a signalé comme nocifs 8 des 20 inoffensifs. Sur une longue liste réelle, ça fait beaucoup de cas inoffensifs qui atterrissent sur le bureau d'un humain.
C'est dans les raisons que ça casse
Les explications autour des étiquettes sont souvent fausses, même quand l'étiquette est juste. Sur un vrai variant où un T devenait un C, il a donné la bonne étiquette avec la justification "The variant changes C to C". Dans l'exemple de drépanocytose des auteurs eux-mêmes, la carte de 48 GB a nommé la mauvaise base dans 12 essais sur 20. Sur 20 essais sur chaque carte, il a dit pathogène 16 fois et bénin 4 fois, et avec l'aléatoire désactivé, la carte de 48 GB a dit bénin. Les auteurs préviennent que le modèle "peut mal compter les bases, confondre les coordonnées". Ce n'est pas un outil clinique, et ils le disent.
À qui ça s'adresse
- Les équipes qui trient beaucoup de variants selon leur nocivité probable. C'est un premier tri utilisable, mais échantillonnez plus d'une fois et gardez un humain sur la liste signalée.
- Les labos dont les séquences ne peuvent pas sortir du bâtiment. Des poids Apache-2.0 sur une seule carte de 24 GB que vous faites tourner vous-même.
- Quiconque a besoin du pourquoi. Calculez les positions et les noms de gènes dans du code ; ne croyez pas le modèle sur parole.
- Les équipes sur des cartes de 16 GB. Passez votre tour pour l'instant : aucune des configurations vLLM que nous avons essayées à 16 GB n'a fonctionné.
Sur InferenceKey, un worker de 48 GB démarré à froid servait Carbon-X en 356 secondes, et la 4090 en 262,5 secondes. L'essentiel de ce temps est allé à l'installation de vLLM et au préchauffage du moteur, pas au téléchargement de 30 GB. Un point encore rugueux : les réponses contenant de l'ADN reviennent entourées de balises <dna> littérales, donc retirez-les dans votre parseur. Statut : ouvert.
La limite honnête : 40 variants, c'est un petit échantillon, donc lisez nos chiffres comme "rejoint les auteurs ou pas", pas comme un classement.
Le test complet
L'article Research contient les résultats GenomeQA et de prédiction des bases suivantes, l'échelle de mémoire GPU, la commande vLLM exacte et l'exemple SDK qui pose les questions des auteurs sur votre propre carte. Lisez le test complet de Carbon-X dans l'article Research.