Hy-SimulMT interprète le chinois et l'anglais pendant que l'orateur parle, sur une seule carte de 48 GB
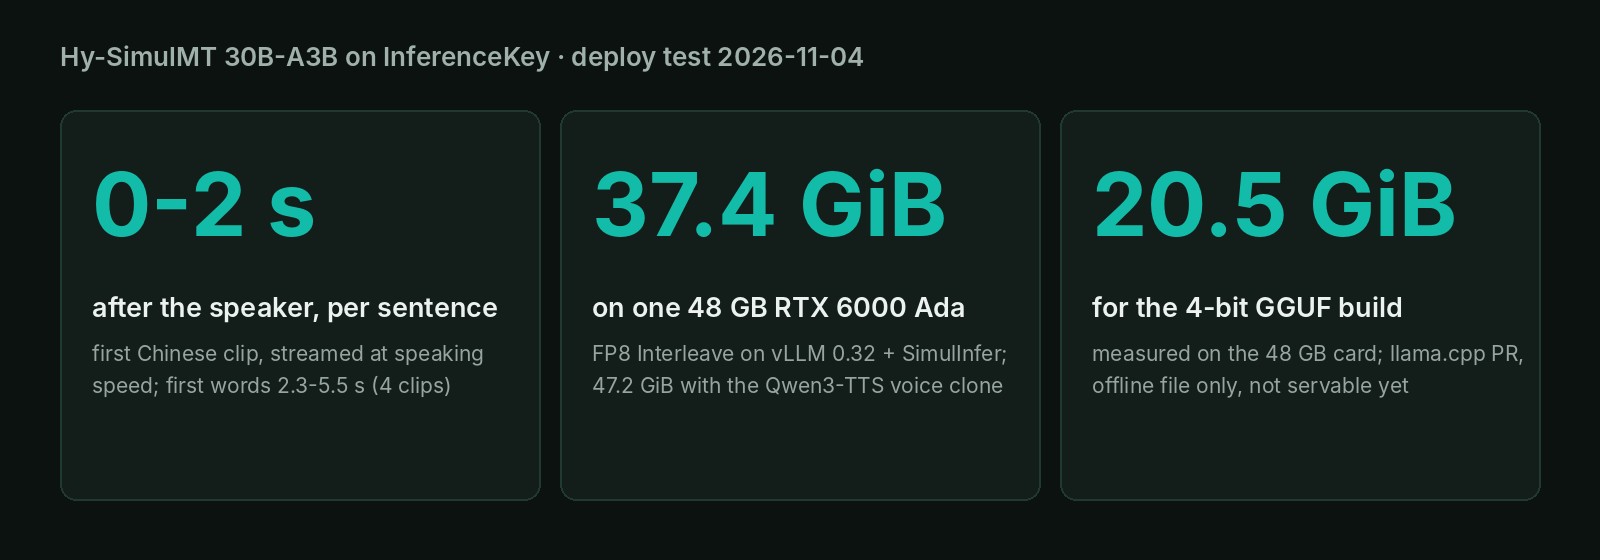
L'interprète ouvert de Tencent sur une RTX 6000 Ada : premiers mots en 2 à 5,5 s, chaque phrase du premier clip chinois finie à 2 s de l'orateur.
Cinq secondes et demie après le début d'un clip en chinois, les premiers mots anglais sont arrivés : "The United Nations also". L'orateur parlait encore. C'est Hy-SimulMT, le modèle ouvert de Tencent Hunyuan pour l'interprétation en direct entre le chinois et l'anglais. Nous l'avons fait tourner sur une seule RTX 6000 Ada de 48 GB sur notre cloud. Les premiers mots sont arrivés 2,3 à 5,5 secondes après le début de chaque clip. Dans le premier clip chinois, le seul que nous avons chronométré phrase par phrase, chaque phrase était terminée environ 2 secondes au plus après l'orateur. Si vous faites tourner vos propres GPU, l'audio de la réunion et sa traduction ne quittent jamais une carte que vous possédez ou louez. Il a occupé 38 GB de la carte, et un clone de la voix de l'orateur a rempli le reste. Deux limites : l'un de nos deux clips anglais a perdu deux de ses six phrases, et notre API prend des fichiers enregistrés joués à la vitesse de la parole, pas encore un micro en direct.
| Ce que vous voulez savoir | Ce que nous avons mesuré |
|---|---|
| Retard sur l'orateur | premiers mots après 2,3 à 5,5 s, et dans le premier clip chinois chaque phrase terminée 0 à 2 s après l'orateur |
| Mémoire sur la carte | 38 GB sur 48 en service, presque les 48 avec le clone de voix |
| Plus petit GPU qui l'a servi | une vraie carte de 48 GB (32 GB n'a marché que sous une limite simulée) |
| Précision | chinois vers anglais solide, anglais vers chinois inégal (un clip a perdu 2 phrases sur 6) |
| Sortie vocale | a fonctionné du chinois vers l'anglais, bloquée de l'anglais vers le chinois (ouvert) |
Un interprète en un seul modèle, pas un transcripteur suivi d'un traducteur
Hy-SimulMT écoute et traduit dans le même modèle, il peut donc commencer la traduction avant la fin de la phrase. La façon habituelle de traduire la parole est un relais. Un programme note ce qui a été dit, puis un second traduit le texte terminé. C'est comme une sténographe de tribunal qui passe ses pages à un traducteur dans la pièce voisine. Le traducteur ne peut pas commencer avant qu'une page soit finie, et le retard grandit avec chaque phrase longue.
Hy-SimulMT fonctionne plutôt comme l'interprète en cabine lors d'une conférence. Il entend un morceau de parole, décide s'il en a assez pour dire quelque chose, et le dit. Un petit service des mêmes auteurs, SimulInfer, lui fournit l'audio par tranches de 1,6 seconde et recolle les morceaux.
Tencent Hunyuan l'a publié le 26 octobre sous Apache-2.0, une licence qui autorise l'usage commercial, et tout le monde peut le télécharger sans rien demander. C'est un modèle de 30B où environ 3B paramètres seulement travaillent sur chaque mot. Imaginez une grande équipe de spécialistes où chaque mot en consulte une poignée pendant que les autres attendent. Cela le garde rapide, mais la carte doit quand même contenir toute l'équipe.
Nous avons testé une version compressée de 32 GB qui écrit aussi la parole d'origine à côté de la traduction. Les autres versions sont dans l'annexe.
Deux limites d'emblée. Il ne fait que chinois vers anglais et anglais vers chinois. Sa page de téléchargement liste 40 langues, mais son texte et le logiciel officiel ne prennent en charge que ces deux sens. SimulInfer refuse tout autre sens avec une erreur. Et il ne parle pas tout seul : la sortie vocale demande un second modèle, Qwen3-TTS, qui tourne comme un service séparé à côté.
Les auteurs annoncent un retard et une qualité d'interprète, et nous n'avons pas refait leurs tests
L'annonce principale des auteurs porte sur le retard. Sur de longues conférences enregistrées d'un test public, il suivait l'orateur avec environ 3 secondes de retard selon leur mesure. C'était le plus faible de tous les systèmes de leur comparaison, qui inclut des services commerciaux de traduction en direct. Sur FLEURS, un ensemble public de courts clips lus, son score de qualité de traduction se situe entre ceux des traducteurs en direct de Google et d'Alibaba : 90,3, contre 92,4 et 88,4. Sur trois autres tests de clips courts, il est premier sur l'un et derrière celui de Google ou d'Alibaba sur les deux autres.
Ils l'ont aussi opposé à six interprètes professionnels sur 18 enregistrements en chinois et en anglais d'environ six minutes chacun. Leur page du modèle dit que la qualité était au niveau des experts, souvent avec moins de retard, et seulement pour ces échantillons. Nous avons repéré le modèle dans la vidéo d'actualité du 1er novembre d'AI Search. La vidéo dit qu'il bat les interprètes humains, ce qui va plus loin que ce que disent les auteurs. Nous nous en tenons aux auteurs.
Notre test : une carte, quatre clips lus, joués à la vitesse de la parole
Trois questions : tourne-t-il sur une seule carte de 48 GB, avec quel retard, et que coûte la voix ? Nous avons utilisé une RTX 6000 Ada sur notre cloud.
L'audio vient de FLEURS, un ensemble public de phrases de style Wikipédia lues à voix haute, avec des traductions humaines. Nous avons construit quatre clips de 50 à 56 secondes, deux en chinois et deux en anglais, de cinq ou six phrases chacun. Nous avons envoyé chaque clip au service par morceaux d'un dixième de seconde, à la vitesse normale de la parole, comme le ferait un micro. Puis nous avons noté l'heure d'arrivée de chaque morceau de traduction.
Les limites : quatre clips lus, une exécution chacun plus quelques répétitions, une session à la fois. Les longues conférences, la parole spontanée, les accents et les salles bruyantes n'ont pas été testés. Cela vous dit si le modèle suit le rythme et, en gros, s'il traduit bien. Ce n'est pas un benchmark, et personne ne parlait en même temps qu'un autre.
Il a suivi le rythme : premiers mots en 2 à 5,5 secondes
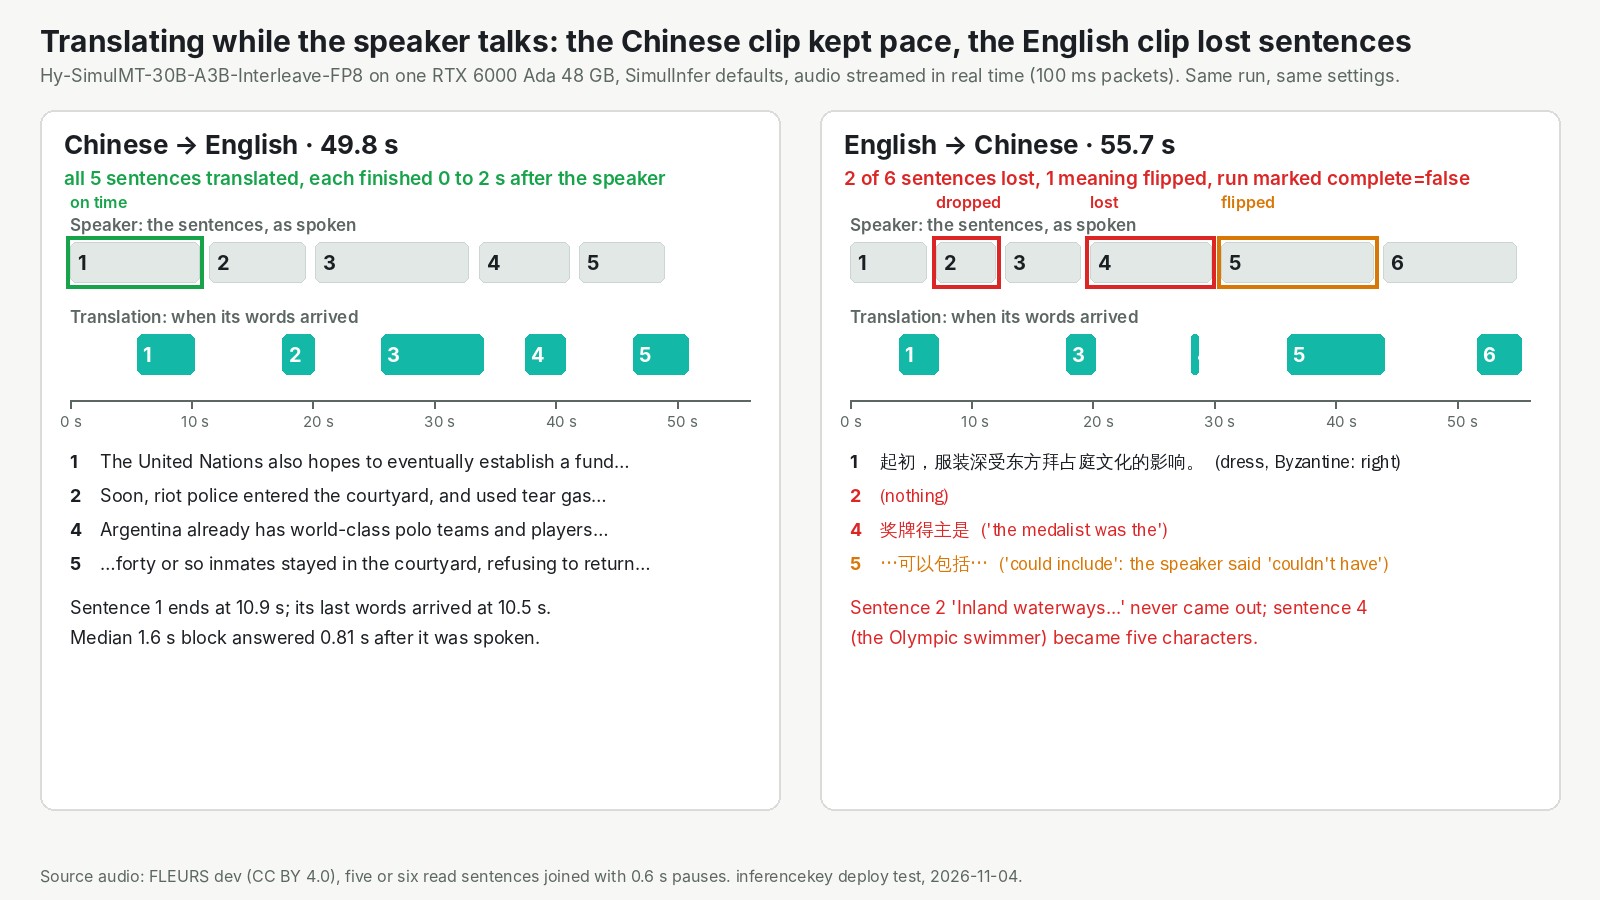
Chaque phrase du premier clip chinois était terminée 0 à 2 secondes après que l'orateur l'a finie. Sa première phrase se terminait à 10,9 secondes, et sa traduction était déjà complète à 10,5. Sous le capot, le service donne au modèle une nouvelle tranche d'audio de 1,6 seconde. Une tranche typique recevait sa réponse 0,4 à 0,8 seconde après sa fin, dans les quatre clips. Une tranche sur dix a pris 1,5 seconde ou plus, la plus lente 2,9.
| Clip | Attente typique après la fin d'une tranche | Premiers mots | Terminé ? |
|---|---|---|---|
| Chinois 1 (49,8 s) | 0,81 s | 5,5 s | oui |
| Chinois 2 (52,7 s) | 0,74 s | 2,3 s | oui |
| Anglais 1 (53,6 s) | 0,73 s | 4,4 s | oui |
| Anglais 2 (55,7 s) | 0,43 s | 4,0 s | non |
Les premiers mots prennent quelques secondes parce que le modèle attend d'avoir quelque chose qui vaille la peine d'être dit.
Si vous n'avez pas besoin du direct, il existe un mode plus rapide. Envoyés en un seul fichier, 50 à 56 secondes de parole sont revenues traduites en 26 secondes environ, à peu près deux fois plus vite que leur durée de lecture.
Le chinois vers l'anglais a tenu, l'anglais vers le chinois a perdu des phrases
La vitesse était égale dans les deux sens, la précision non. Nous avons noté de 0 à 100 à quel point les mots de chaque sortie correspondaient aux traductions humaines. Comme repère, une version plus petite que nous testons plus bas a eu juste chaque phrase du premier clip chinois et a obtenu 66. Les clips chinois ont obtenu 60,6 et 51,7 vers l'anglais, et les clips anglais 42,2 et 23,4 vers le chinois.
Le clip à 23,4 a perdu deux de ses six phrases. Une phrase, sur les voies navigables intérieures comme thème de voyage, n'est jamais sortie. Nous avons relancé ce clip à part et elle a encore été supprimée. Une autre phrase, sur un nageur olympique, s'est réduite à cinq caractères chinois qui veulent dire "le médaillé était". Une troisième phrase a inversé son sens : l'orateur a dit "couldn't have included" et la traduction dit "could include". Le service a marqué cette exécution comme incomplète. Dans l'autre clip anglais, l'exécution principale a supprimé une phrase sur les rails en fer en 1767.
Cette négation inversée est le genre d'erreur qu'un auditeur ne peut pas repérer. Une phrase supprimée laisse un trou que vous remarquerez peut-être. Un "could" faux sonne parfaitement fluide.
Nous ne savons pas pourquoi. Envoyé en un seul fichier, le même clip est revenu marqué incomplet lui aussi, donc le montage en direct n'est pas la seule cause. Considérez l'anglais vers le chinois comme quelque chose à tester d'abord sur votre propre audio.
Le clone de voix remplit la carte, et n'a marché que du chinois vers l'anglais
Le clone de voix a marché dans un sens et s'est bloqué dans l'autre. Il copie la voix de l'orateur à partir des premières secondes de sa propre parole et lit la traduction à voix haute avec elle. Aucun enregistrement de référence n'est nécessaire. Il tourne comme un second petit modèle, Qwen3-TTS-0.6B de l'équipe Qwen d'Alibaba, sur la même carte.
Sur le premier clip chinois, la première parole anglaise est sortie 8,7 secondes après le début du clip. Au total, il a produit 33,7 secondes d'audio anglais pour 49,8 secondes de chinois. La traduction texte a gardé son rythme, donc la voix n'a pas ralenti le traducteur. Elle a en revanche pris la mémoire : la carte est passée de 38 GB à 48 GB utilisés, presque toute la carte.
L'anglais vers le chinois avec la voix activée n'a jamais répondu. L'audio s'est terminé, puis rien n'est revenu pendant plus de quatre minutes. Statut : ouvert, non étudié. Personne n'a non plus écouté la voix clonée dans cette exécution sans surveillance, donc nous n'affirmons rien sur sa ressemblance.
Quel GPU : une vraie carte de 48 GB est la taille prouvée, 32 GB n'est pas prouvé
La plus petite carte qui l'a servi est une vraie carte de 48 GB. Nous avons essayé deux options moins chères sur la même carte de 48 GB.
- Un budget de 32 GB, simulé. Nous avons demandé au serveur de n'utiliser que 32 GB sur les 48. Il a démarré, avec de la place pour une conversation bien plus courte et un seul auditeur à la fois. Il a traduit les deux clips de test au même rythme en direct. Mais le démarrage prend brièvement toute la carte, à chaque exécution, avant de se stabiliser. Une limite de mémoire n'empêche pas cela, donc une vraie carte de 32 GB comme une RTX 5090 risque d'échouer au démarrage.
- La version 4 bits, environ 21 GB. Le fichier 4 bits des auteurs, une version qui ne fait que traduire, a tourné en 21 GB sur la carte de 48 GB. Il a traduit chaque phrase des deux clips qu'il a reçus, moins d'une minute de parole en 3 secondes environ, sans compter le chargement du modèle. Le hic : il lui faut une version de prévisualisation d'un outil séparé, et il ne traduit qu'un fichier terminé. Aucun serveur ne peut encore le charger.
Nous n'avons pas essayé la version complète de 61 GB, une vraie carte de 32 GB ou de 24 GB, ni plusieurs auditeurs à la fois.
Sur InferenceKey : trois services sur une carte que vous contrôlez, prêts en 6 minutes environ, 73 secondes au redémarrage
Une seule carte de 48 GB a contenu le traducteur, son service de streaming et la voix. Sur notre plateforme, un worker est une machine GPU que vous possédez ou louez et que vous y connectez. Ce modèle demande plus qu'un simple serveur de modèle, alors nous avons écrit du code Python qui l'installe avec SimulInfer et les démarre dans l'ordre.
Depuis le premier déploiement sur une machine neuve, le serveur du modèle était prêt en 6 minutes environ. Un redémarrage sur la même machine était prêt en 73 secondes.
Le premier problème que vous rencontrerez si vous déployez vous-même la version compressée : SimulInfer ne la reconnaît pas. Il ne connaît les versions complètes que par leur nom, et s'arrête avec une erreur en chinois qui dit qu'il ne peut pas identifier le format de sortie du modèle. Notre code écrit le petit fichier que cherche SimulInfer. Statut : corrigé dans notre exemple, pas encore corrigé par les auteurs au moment de notre test.
Une limite vient de nous. Notre API prend un fichier envoyé d'une minute environ au maximum et le joue au modèle à la vitesse de la parole. La chronologie des arrivées revient à la fin. Un micro en direct ne peut pas encore passer par notre API. Statut : ouvert. Les autres problèmes et les temps complets sont dans l'annexe.
Pour quelques appels par semaine, un service hébergé de traduction en direct est le chemin le plus court. Ce montage s'adresse aux équipes qui veulent le modèle sur une carte qu'elles contrôlent.
Faut-il l'utiliser ? Oui pour le chinois vers l'anglais sur votre propre carte, testez d'abord l'autre sens
- Si vous avez besoin du chinois vers l'anglais en direct, c'est une option ouverte solide. Pour un micro en direct aujourd'hui, connectez-vous directement à SimulInfer sur la carte.
- Si vous avez besoin de l'anglais vers le chinois, testez-le sur votre propre audio avant que quiconque s'y fie.
- Si vous voulez aussi la voix de l'orateur, prévoyez une carte de 48 GB complète et le sens chinois vers anglais seulement, pour l'instant.
- Si vous avez une carte de 24 GB ou de 32 GB, la version 4 bits a utilisé 20,5 GB sur une carte de 48 GB, pour des fichiers enregistrés seulement. Nous ne l'avons pas essayée sur une vraie carte de 24 GB, et elle demande une version de llama.cpp non fusionnée.
- Si vous avez besoin d'une autre langue, ce n'est pas votre modèle.
Lancez python publish.py puis python main.py depuis l'exemple du SDK Hy-SimulMT. Il déploie le même montage sur votre GPU et rejoue vos clips à la vitesse de la parole, avec les heures d'arrivée par tranche. Il faut un projet InferenceKey avec un token du SDK et une clé d'API. Apportez un worker NVIDIA privé avec 48 GB et environ 70 GB de disque. Les étapes d'installation sont dans l'annexe.
Pour les ingénieurs
Crédits
- Hy-SimulMT : Tencent Hunyuan. Ils ont entraîné le modèle, publié les versions BF16, FP8, GGUF, Interleave, Interleave-FP8 et Interleave-GGUF, le plugin vLLM
simulst, le service et le lanceur SimulInfer, l'intégration TTS, la prise en charge des versions GGUF dans llama.cpp (PR #31198, toujours ouverte), les benchmarks et la comparaison avec les interprètes. Dépôts : base, Interleave-FP8, GGUF, GitHub. - Voix : Qwen3-TTS-12Hz-0.6B-Base de l'équipe Qwen, servi avec vLLM-Omni.
- Service : le projet vLLM (0.32.0 pour la traduction, 0.31.0 côté TTS), le projet llama.cpp, auquel la prise en charge GGUF a été soumise, et l'équipe SGLang-Omni pour son cookbook.
- Audio de test : FLEURS dev (Google, CC BY 4.0).
- Où nous l'avons repéré : AI Search, "AI finally sleeps, Gemini 4 Carbon, ...", 2026-11-01, Hy-SimulMT à 10:02. Nous avons utilisé sa transcription enregistrée, pas un visionnage complet.
- Notre part : le backend personnalisé, le déploiement via la plateforme, le harnais de streaming, les mesures, l'échelle de VRAM, l'exemple du SDK et la vidéo de démo.
Modèle et fichiers
HYV3SpeechForCausalLM: tour audio plus un MoE Hunyuan v3, 48 couches, 128 experts avec top-8 par token plus 1 partagé, 4 têtes KV, head_dim 128. Environ 30B au total, environ 3B actifs.- Interleave-FP8 (la version testée ; Interleave écrit aussi la transcription source) : fp8 e4m3, activations dynamiques,
weight_block_size[128,128] sur les experts. lm_head, les portes du routeur et les projections d'attention restent en BF16. 32,16 GB (17 shards plus un fichier de tour audio de 0,66 GB), sha7f37cb76. - Tailles selon l'API HF : BF16 60,86 GB, GGUF Q4_K_M 19,75 GB, Q8_0 33,31 GB (traduction seulement, fichier unique avec le projecteur audio inclus).
- Licence :
apache-2.0sur les fiches base et Interleave-FP8,LICENSE-Hy-SimulMT.txtdans le dépôt (Apache-2.0 sauf les parties tierces listées). La fiche GGUF n'a pas de champ de licence. Aucun des dépôts n'est à accès restreint. - Étiquettes de langue : la fiche en liste 40, mais le texte de la fiche, SimulInfer et la recette SGLang-Omni ne prennent en charge que zh<->en.
- Sens : SimulInfer lève une
ValueErrorsauf si le sens estzh-enouen-zh(simulinfer/translation.py:36), le client ne propose que ces deux-là (client.py:90). - Tableau des auteurs sur clips courts (non reproduit) : Hy-SimulMT FLEURS 90,3, CoVoST2 75,5, ACL6060 81,2, RealSI-Sentence 84,7. Gemini3.5-LiveTranslate 92,4 / 74,4 / 82,6 / 82,2, Qwen3.8-LiveTranslate 88,4 / 82,1 / 80,5 / 84,4. Sur format long, RealSI StreamLAAL environ 3 s, le plus bas de leur graphique ; GEMBA au-dessus des modèles ouverts et de quatre API commerciales sur cinq. StreamLAAL n'est pas le délai jusqu'à la première parole.
- SGLang-Omni (non testé par nous) : checkpoint BF16 de traduction seule, texte seulement, environ 57 GiB de poids, une seule H200.
sgl-omni serve --model-path tencent/Hy-SimulMT-30B-A3B --mem-fraction-static 0.75 --enable-realtime --port 8000. Entrée hors ligne jusqu'à 30 s par requête, temps réel sur/v1/realtime?intent=transcription(PCM16 16 kHz, hypothèses toutes les 1,6 s), le contexte redémarre après 30 s, sans la VAD ni les heuristiques de récupération de SimulInfer.
Choix du GPU et backend
- GPU prévu : une L40S de 48 GB. Elle n'était pas disponible sur notre cloud au moment du test. Une première machine L40 est arrivée sans SSH direct et le manager l'a écartée après environ 3 minutes. Nous avons utilisé une RTX 6000 Ada Generation de 48 GB (49 140 MiB, sm_89, pilote 595.91.07, CUDA 13.2), même génération Ada et même mémoire que la L40S.
- FP8 sur Ada : vLLM 0.32.0 fait tourner ces experts block-FP8 avec le kernel Marlin weight-only ("Your GPU does not have native support for FP8 computation ... Weight-only FP8 compression will be used"). Une L40S ferait de même. Le mode fichier restait environ 2x plus rapide que le temps réel.
- Pourquoi un backend personnalisé : le backend
vllmstandard ne peut pas ajouter le pluginsimulst, et la logique simultanée vit dans SimulInfer, un service séparé devant vLLM. - Backend
hy-simulmt0.1.2 :setup()récupère Hy-SimulMT à7efcb18c, construit un environnement Python 3.12 avec uv (vllm==0.32.0,simulst[audio]==0.1.0,SimulInfer[vad]), télécharge la révision épinglée sur le disque du conteneur, lancesimulinfer-prepare-model, écritexport_manifest.jsons'il manque, prend la commande vLLM desimulinfer.launch --dry-run, puis démarre SimulInfer sur la configuration par défaut des auteurs, pointée sur loopback. Environnement TTS optionnel (vllm==0.31.0,vllm-omni==0.31.0rc1) avecsimulinfer-tts-omnià util 0.15. - Flags vLLM utilisés :
--enforce-eager, prefix caching, chunked prefill,--limit-mm-per-prompt '{"audio":1024}', le chat template des auteurs,--gpu-memory-utilization 0.78 --max-model-len 8192 --max-num-seqs 4 --max-num-batched-tokens 4096. process(): multipart ou JSON,direction(oulanguage),transportrealtime(WebSocket, paquets PCM16 de 100 ms cadencés en temps réel) oufile(SSE/translate/stream),tts. Renvoie le texte, le texte source, chaque événement avect_ms, les délais, le premier texte et le wav TTS.- Les processus enfants reçoivent
PR_SET_PDEATHSIG, et un backend redémarré arrête les serveurs restés dansservers.pid.
Pas à pas avec l'exemple du SDK
Exemple : hy-simulmt-speech-translation-custom-backend-private-nvidia, commits 61f823f (exemple) et 769745e (note du README sur le pic de mémoire au démarrage).
git clone https://github.com/inferencekey/inferencekey-sdk
cd inferencekey-sdk/examples/hy-simulmt-speech-translation-custom-backend-private-nvidia
cp .env.example .env        # SDK token, API key, IK_WORKER_ID, IK_CLIPS
pip install -r requirements.txt
python publish.py           # uploads the custom backend
python main.py              # ensure -> wait -> each clip in realtime -> outputs -> delete
- Demande un GPU NVIDIA de 48 GB, prouvé avec et sans le sidecar de voix (le README de l'exemple dit 40 GB et plus, ce que nous n'avons pas testé ; le pic au démarrage remplit 47,4 GiB), un pilote compatible CUDA 13 et environ 70 GB de disque.
- Variables d'environnement :
IK_WORKER_ID,IK_KEEP_ALIVE=1(garder le déploiement),HYSIMULMT_TTS=1(clone de voix),HYSIMULMT_GPU_MEMORY_UTILIZATION,HYSIMULMT_MAX_MODEL_LEN,HYSIMULMT_MAX_NUM_SEQS. - Endpoint :
/v1/audio/transcriptionsavecfile,direction(zh-enouen-zh),transport(realtimeoufile) ettts. Limite de requête de 2 MiB, environ une minute de WAV 16 kHz.
En dehors de notre plateforme, le chemin en une commande des auteurs est :
git clone https://github.com/Tencent-Hunyuan/Hy-SimulMT && cd Hy-SimulMT/SimulInfer
git checkout 7efcb18c   # the commit we tested
bash deploy.sh --install-server --model tencent/Hy-SimulMT-30B-A3B-Interleave
# Ready: http://127.0.0.1:8080/   (model server on :8800)
curl -N http://127.0.0.1:8080/translate/stream -F direction=en-zh -F file=@audio.wav
Cette commande charge la version BF16 Interleave (la base BF16 seule fait 60,86 GB), qui ne tient pas sur la carte de 48 GB testée ici. À 7efcb18c, SimulInfer ne reconnaît pas non plus les noms des dépôts FP8 sans le correctif export_manifest.json (problème 1).
Endpoints de SimulInfer : GET /health, GET /config, GET /, POST /translate/submit, GET /translate/task/{task_id}, POST /translate/stream, WebSocket /translate/ws. Valeurs par défaut : blocs de 1600 ms (standard), VAD activée, max_sessions 4, timeout 900 s, ws_audio_mode noise_resistant. Pour la voix : simulinfer-tts-omni --model Qwen/Qwen3-TTS-12Hz-0.6B-Base --host 0.0.0.0 --port 8091 et [tts] tts_backend = "vllm_omni", tts_url = "http://127.0.0.1:8091/v1".
Mesures complètes
Délai avant d'être prêt :
- À froid (backend 0.1.0) : environ 6,2 min de
ensure()à l'API vLLM. Environnement 47,2 s, téléchargement de 32 GB 26,0 s, import de vLLM environ 2 min (le CPU de la machine compilait aussi llama.cpp), chargement des poids 27,5 s, initialisation du moteur 71,2 s. - À chaud (0.1.1) : 73 s (vLLM 57,2 s, SimulInfer 6,0 s).
- Avec la construction de l'environnement TTS (0.1.2) : 376 s.
Traduction, RTX 6000 Ada, FP8 Interleave, valeurs par défaut de SimulInfer :
| Clip | Mode | Audio s | Durée réelle s | Premier texte | Délai de bloc médiane / p90 / max (ms) | Retard façon LAAL (le nôtre) | chrF | BLEU | complete |
|---|---|---|---|---|---|---|---|---|---|
| zh1 zh->en | realtime | 49,8 | 51,07 | 5,51 s | 809 / 1546 / 2058 | 7,34 s | 60,6 | 28,8 | true |
| zh2 zh->en | realtime | 52,66 | 53,55 | 2,34 s | 738 / 1847 / 2907 | 3,98 s | 51,7 | 15,8 | true |
| en1 en->zh | realtime | 53,64 | 54,08 | 4,44 s | 733 / 1633 / 1876 | 1,58 s | 42,2 | 48,5 | true |
| en2 en->zh | realtime | 55,68 | 55,82 | 3,97 s | 434 / 1774 / 2729 | 15,18 s (gonflé par les pertes) | 23,4 | 25,1 | false |
| zh1 | file | 49,8 | 26,29 | non-CA 5,50 s | 62,8 | 32,0 | true | ||
| zh2 | file | 52,66 | 27,52 | non-CA 3,02 s | 51,8 | 16,4 | true | ||
| en1 | file | 53,64 | 25,34 | non-CA 4,22 s | 29,5 | 33,2 | true | ||
| en2 | file | 55,68 | 25,05 | non-CA 6,50 s | 39,2 | 47,1 | false |
- Délai de bloc = heure d'arrivée réelle moins la position de fin audio du bloc qui l'a produite. Les blocs font 1,6 s, donc un mot du début d'un bloc attend plus longtemps que le délai de bloc.
- Score de qualité : chrF de sacrebleu, qui compte les séquences de caractères communes entre la sortie et la référence, de 0 à 100.
- Le retard façon LAAL est notre approximation sur tout le clip (alignement uniforme sur la longueur de la référence, en tenant compte du calcul), pas le StreamLAAL des auteurs, et n'est pas comparable à leurs 3 s.
- chrF et BLEU avec sacrebleu 2.6.0 (tokenizer BLEU
zhpour la sortie en chinois). Un clip chacun : ce n'est pas un benchmark. - Via
main.pysur la plateforme : zh1 premiers mots 6,14 s, médiane 825 ms ; en1 4,44 s, médiane 713 ms. - Testeur du panel : un clip chinois de 20 s a renvoyé
ok · 20943 msavec "The UN also hopes to eventually establish a fund to help relevant countries address the impacts of global warming. Soon, police equipped with riot gear entered the courtyard, and used tear gas to corner the prisoners."
Mémoire GPU :
- vLLM : chargement du modèle 30,05 GiB, cache KV 5,09 GiB = 55 552 tokens, concurrence maximale 6,78x à 8 192 tokens.
- nvidia-smi chaque seconde : 38 256 MiB en service, 48 302 MiB avec Qwen3-TTS, 48 510 MiB (toute la carte) pendant le profilage de l'encodeur au démarrage, à chaque exécution.
Clone de voix (zh1 avec tts=true) : premier audio à 8 721 ms, 33,67 s d'anglais mono 24 kHz pour 49,8 s d'entrée, premier texte 5,52 s, délai de bloc médian 820 ms, p90 1 538 ms, aller-retour 56,2 s.
Échelle de VRAM
| GPU ou plafond | Configuration | VRAM max | Temps par sortie | Sortie correcte ? | Réel ou émulé |
|---|---|---|---|---|---|
| RTX 6000 Ada 48 GB | FP8 Interleave, vLLM 0.32 + SimulInfer, util 0.78, len 8192, 4 seqs, batched 4096 | 37,4 GiB (47,4 GiB au démarrage) | environ 26 s par fichier de 50 à 56 s | oui (en2 perd des phrases) | réel |
| idem + Qwen3-TTS 0.6B | + vLLM-Omni 0.31.0rc1, util 0.15 | 47,2 GiB | premier audio 8,7 s | zh->en oui, en->zh bloqué | réel |
| plafond de 32 GB sur la carte de 48 GB | util 0.66 (31,27 GiB), len 4096, 1 seq, 7 136 tokens KV | 31,6 GiB (démarrage toujours à 47,4 GiB) | 51,6 s réelles zh1, 55,0 s en1 (realtime) | oui : zh1 chrF 62,8, en1 chrF 37,6 | émulé |
| GGUF Q4_K_M, 19,75 GB | llama.cpp PR #31198 (d38e66aa), llama-mtmd-cli -ngl 99 -c 16384, fichier hors ligne | 20,5 GiB | 3,2 s de tours par clip, environ 16x le temps réel | oui : toutes les phrases, zh1 chrF 66,1, en1 chrF 42,3 | mesuré sur la carte de 48 GB, pas servable |
Le plafond de 32 GB se situe à 32 394 MiB contre 32 607 MiB pour une RTX 5090, sans aucune marge, et le plafond ne couvre pas le pic au démarrage. Pas essayés : une vraie carte de 32 GB ou de 24 GB, BF16, SGLang-Omni, Interleave-GGUF, le FP8 non Interleave, la concurrence.
Problèmes et statut
- SimulInfer ne reconnaît pas les checkpoints FP8.
ValueError: 无法识别所选模型的输出格式...depuismodel_discovery.py: pas deexport_manifest.jsonet le nom n'est pas dansPROVIDED_CHECKPOINTS. Corrigé dans notre backend (il écrit le manifeste). Ouvert en amont à7efcb18c. - Le profilage de l'encodeur au démarrage remplit la carte. Avec les 16 384 batched tokens des auteurs, vLLM a profilé 3 276 éléments audio factices, a enregistré des milliers d'avertissements OOM de l'allocateur, puis s'est rétabli. Nous utilisons 4 096. Le pic de 47,4 GiB (48 510 MiB) reste, même sous un plafond de 0.66. Une carte plus petite peut échouer ici.
- Piège de version de vLLM-Omni. 0.32.0 et 0.32.0rc1 échouent avec
ImportError: cannot import name 'Qwen3TTSSpeakerEncoder'. 0.31.0rc1 sur vLLM 0.31.0 fonctionne. Corrigé dans le backend 0.1.2. - L'anglais vers le chinois avec la voix s'est bloqué après la fin de l'audio, aucune réponse après 4 minutes avec le GPU inactif. Ouvert, non étudié.
- Phrases supprimées et déformées en anglais vers chinois (en2 en realtime et en mode fichier, même phrase supprimée lors d'une seconde exécution ; en1 a perdu une fois la phrase de 1767). Comportement du modèle ou du streaming, rapporté tel quel.
- Pas de micro en direct via notre API. Limite de requête de 2 MiB et pas de passage WebSocket. Le backend cadence l'audio envoyé et renvoie les événements horodatés à la fin. Ouvert.
- vLLM orphelin après une relance du watchdog, qui occupait 47,4 GiB après un démarrage raté. Corrigé dans 0.1.1 par une vérification des serveurs restés actifs.
- FP8 Marlin weight-only sur Ada (voir plus haut). Pas un échec, une remarque sur la vitesse.
Vidéo de démo
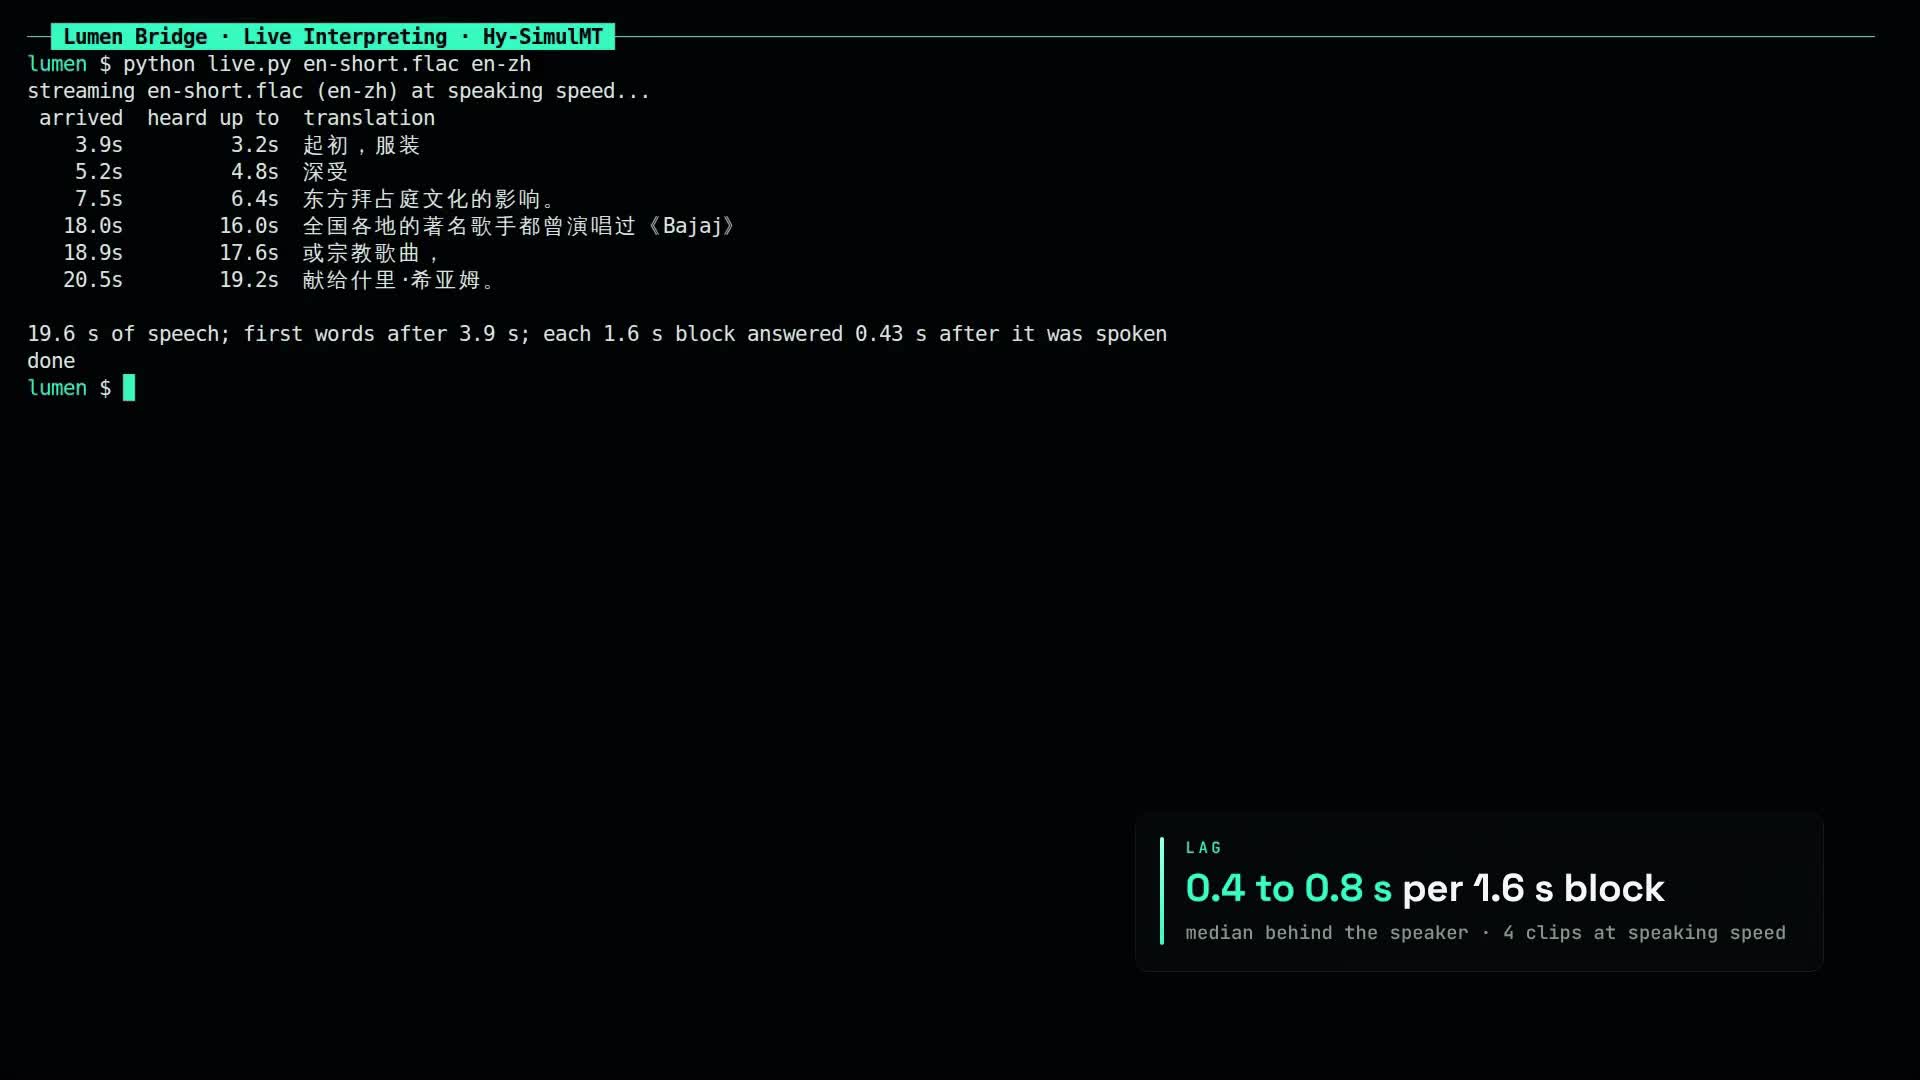
161 s, 1920x1080, narrée, avec chapitres et un fichier de sous-titres de 40 répliques. Elle montre les démos des auteurs avec crédit, le déploiement dans le panel, le testeur, les heures d'arrivée dans le terminal et l'échelle de mémoire.
Limites de ce test
- Quatre clips FLEURS lus, une exécution chacun plus des répétitions, une session à la fois. Le chrF sur des clips isolés n'est pas un benchmark.
- Notre mesure du retard n'est pas StreamLAAL. Les benchmarks des auteurs et la comparaison avec les interprètes n'ont pas été reproduits.
- Aucun humain n'a écouté la voix clonée.
- Les faits sur la source viennent du dépôt au commit
7efcb18c(2026-10-27). Les changements ultérieurs en amont, comme SimulInfer qui apprendrait les noms FP8 ou la fusion de la PR llama.cpp, n'ont pas été vérifiés.
Sources
- tencent/Hy-SimulMT-30B-A3B (fiche du modèle, benchmarks, comparaison avec les interprètes)
- tencent/Hy-SimulMT-30B-A3B-Interleave-FP8
- tencent/Hy-SimulMT-30B-A3B-GGUF
- Tencent-Hunyuan/Hy-SimulMT et son guide TTS
- Cookbook SGLang-Omni pour Hy-SimulMT (BF16 seulement, texte seulement, une seule H200)
- Vidéo d'actualité d'AI Search, 2026-11-01 (où nous l'avons repéré)
- Nos articles précédents sur la voix : Nemotron 3.5 Transcribe, Underdog Bark, Ming TTS