Hy-SimulMT dolmetscht Chinesisch und Englisch, während gesprochen wird, auf einer 48-GB-Karte
Tencents offener Live-Dolmetscher auf einer RTX 6000 Ada: erste Wörter nach 2 bis 5,5 s, im ersten chinesischen Clip jeder Satz binnen 2 s nach Satzende fertig.
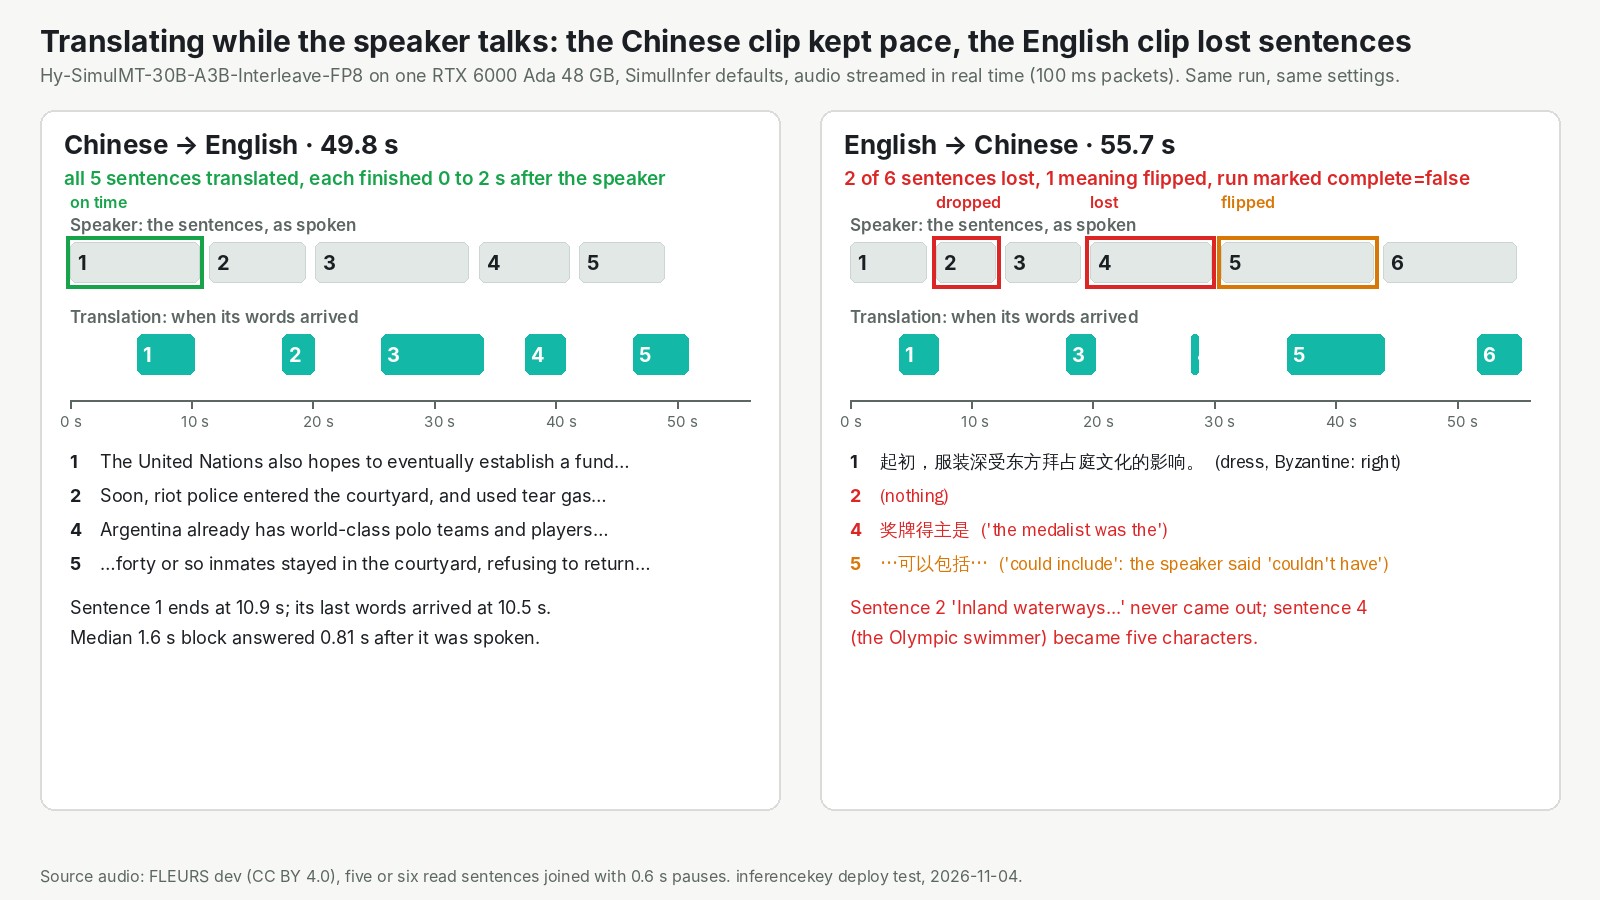
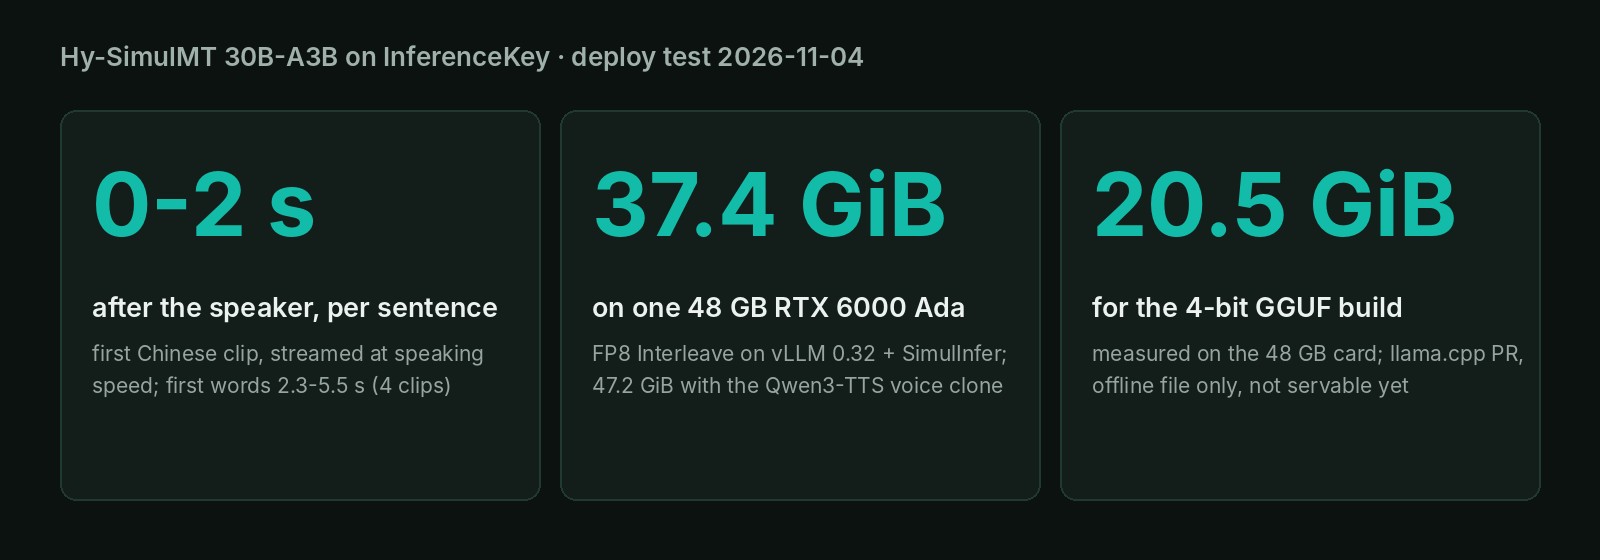
Fünfeinhalb Sekunden nach Beginn eines chinesischen Clips kamen die ersten englischen Wörter zurück: "The United Nations also". Der Sprecher redete noch. Das ist Hy-SimulMT, das offene Modell von Tencent Hunyuan zum Live-Dolmetschen zwischen Chinesisch und Englisch. Wir haben es auf einer RTX 6000 Ada mit 48 GB in unserer Cloud betrieben. Die ersten Wörter kamen 2,3 bis 5,5 Sekunden nach Beginn jedes Clips. Im ersten chinesischen Clip, dem einzigen, den wir Satz für Satz gemessen haben, war jeder Satz spätestens etwa 2 Sekunden nach der Sprecher fertig. Wenn du eigene GPUs betreibst, verlassen das Meeting-Audio und seine Übersetzung nie eine Karte, die dir gehört oder die du mietest. Es belegte 38 GB der Karte, und ein Klon der Sprecherstimme füllte den Rest. Zwei Grenzen: Einer unserer zwei englischen Clips verlor zwei seiner sechs Sätze, und unsere API nimmt aufgenommene Dateien an, die in Sprechgeschwindigkeit abgespielt werden, noch kein Live-Mikrofon.
| Was du wissen willst | Was wir gemessen haben |
|---|---|
| Wie weit hinter dem Sprecher | erste Wörter nach 2,3 bis 5,5 s, und im ersten chinesischen Clip jeder Satz 0 bis 2 s nach dem Sprecher fertig |
| Speicher auf der Karte | 38 GB von 48 im Betrieb, fast alle 48 mit dem Stimmklon |
| Kleinste GPU, die es bedient hat | eine echte 48-GB-Karte (32 GB nur unter einer simulierten Grenze) |
| Genauigkeit | Chinesisch nach Englisch solide, Englisch nach Chinesisch durchwachsen (ein Clip verlor 2 von 6 Sätzen) |
| Sprachausgabe | funktionierte Chinesisch nach Englisch, blieb Englisch nach Chinesisch hängen (offen) |
Ein Dolmetscher in einem Modell, nicht Transkription und Übersetzung hintereinander
Hy-SimulMT hört zu und übersetzt im selben Modell, also kann es mit der Übersetzung anfangen, bevor der Satz zu Ende ist. Der übliche Weg, Sprache zu übersetzen, ist eine Staffel. Ein Programm schreibt auf, was gesagt wurde, dann übersetzt ein zweites den fertigen Text. Wie eine Gerichtsstenografin, die Seiten an einen Übersetzer im Nebenraum weiterreicht. Der Übersetzer kann erst anfangen, wenn eine Seite fertig ist, also wächst die Verzögerung mit jedem langen Satz.
Hy-SimulMT arbeitet stattdessen wie die Person in der Dolmetscherkabine auf einer Konferenz. Es hört ein Stück Sprache, entscheidet, ob es genug hat, um etwas zu sagen, und sagt es. Ein kleiner Dienst derselben Autoren, SimulInfer, füttert es mit Audio in Stücken von 1,6 Sekunden und setzt die Teile zusammen.
Tencent Hunyuan hat es am 26. Oktober veröffentlicht, unter Apache-2.0, was kommerzielle Nutzung erlaubt, und jeder kann es ohne Anfrage herunterladen. Es ist ein 30B-Modell, bei dem pro Wort nur etwa 3B Parameter arbeiten. Stell dir ein großes Team von Fachleuten vor, bei dem jedes Wort eine Handvoll fragt und der Rest wartet. Das hält es schnell, aber die Karte muss trotzdem das ganze Team halten.
Wir haben eine komprimierte Version mit 32 GB getestet, die neben der Übersetzung auch die Originalsprache mitschreibt. Die anderen Builds stehen im Anhang.
Zwei Grenzen vorab. Es kann nur Chinesisch nach Englisch und Englisch nach Chinesisch. Die Download-Seite listet 40 Sprachen, aber ihr Text und die offizielle Software unterstützen nur diese zwei Richtungen. SimulInfer lehnt jede andere Richtung mit einem Fehler ab. Und es spricht nicht von selbst: Für gesprochene Ausgabe braucht es ein zweites Modell, Qwen3-TTS, das als eigener Dienst daneben läuft.
Die Autoren versprechen Verzögerung und Qualität auf Dolmetscherniveau, ihre Tests haben wir nicht wiederholt
Die Hauptaussage der Autoren betrifft die Verzögerung. Bei langen aufgezeichneten Vorträgen aus einem öffentlichen Test lag es nach ihrer Messung etwa 3 Sekunden hinter dem Sprecher. Das war der niedrigste Wert aller Systeme in ihrem Vergleich, zu dem auch kommerzielle Live-Übersetzungsdienste gehören. Auf FLEURS, einem öffentlichen Set kurzer vorgelesener Clips, liegt sein Qualitätswert zwischen den Live-Übersetzern von Google und Alibaba: 90,3, gegenüber 92,4 und 88,4. Auf drei anderen Tests mit kurzen Clips liegt es einmal vorn und zweimal hinter Google oder Alibaba.
Sie haben es auch mit sechs professionellen Dolmetschern verglichen, auf 18 chinesischen und englischen Aufnahmen von je etwa sechs Minuten. Laut ihrer Modellseite war die Qualität auf dem Niveau der Profis, oft mit weniger Verzögerung, und nur für diese Stichproben. Aufgefallen ist uns das Modell im News-Video von AI Search vom 1. November. Das Video sagt, es schlage menschliche Dolmetscher, was mehr ist, als die Autoren behaupten. Wir halten uns an die Autoren.
Unser Test: eine Karte, vier vorgelesene Clips, in Sprechgeschwindigkeit abgespielt
Drei Fragen: Läuft es auf einer Karte mit 48 GB, wie weit hängt es hinterher, und was kostet die Stimme? Wir haben eine RTX 6000 Ada in unserer Cloud verwendet.
Das Audio stammt aus FLEURS, einem öffentlichen Set vorgelesener Sätze im Stil von Wikipedia, mit menschlichen Übersetzungen. Wir haben vier Clips von 50 bis 56 Sekunden gebaut, zwei auf Chinesisch und zwei auf Englisch, jeder fünf oder sechs Sätze lang. Jeden Clip haben wir in Stücken von einer Zehntelsekunde in normaler Sprechgeschwindigkeit an den Dienst gestreamt, so wie es ein Mikrofon tun würde. Dann haben wir protokolliert, wann jedes Stück Übersetzung zurückkam.
Die Grenzen: vier vorgelesene Clips, je ein Lauf plus ein paar Wiederholungen, eine Sitzung gleichzeitig. Lange Vorträge, freie Rede, Akzente und laute Räume haben wir nicht getestet. Der Test zeigt, ob das Modell mithält und ungefähr wie gut es übersetzt. Ein Benchmark ist er nicht, und niemand hat jemandem ins Wort geredet.
Es hielt Schritt: erste Wörter nach 2 bis 5,5 Sekunden
Jeder Satz des ersten chinesischen Clips war 0 bis 2 Sekunden, nachdem der Sprecher ihn beendet hatte, fertig übersetzt. Der erste Satz endete bei 10,9 Sekunden, und seine Übersetzung war schon bei 10,5 vollständig. Unter der Haube gibt der Dienst dem Modell jeweils ein neues Audiostück von 1,6 Sekunden. Ein typisches Stück wurde in allen vier Clips 0,4 bis 0,8 Sekunden nach seinem Ende beantwortet. Eines von zehn Stücken brauchte 1,5 Sekunden oder mehr, das langsamste 2,9.
| Clip | Typische Wartezeit nach Ende eines Stücks | Erste Wörter | Fertig? |
|---|---|---|---|
| Chinesisch 1 (49,8 s) | 0,81 s | 5,5 s | ja |
| Chinesisch 2 (52,7 s) | 0,74 s | 2,3 s | ja |
| Englisch 1 (53,6 s) | 0,73 s | 4,4 s | ja |
| Englisch 2 (55,7 s) | 0,43 s | 4,0 s | nein |
Die ersten Wörter dauern ein paar Sekunden, weil das Modell wartet, bis es etwas hat, das sich zu sagen lohnt.
Wenn du es nicht live brauchst, gibt es einen schnelleren Modus. Als ganze Datei hochgeladen, kamen 50 bis 56 Sekunden Sprache in etwa 26 Sekunden übersetzt zurück, ungefähr doppelt so schnell wie die Abspieldauer.
Chinesisch nach Englisch hielt, Englisch nach Chinesisch ließ Sätze weg
Die Geschwindigkeit war in beiden Richtungen gleich, die Genauigkeit nicht. Wir haben bewertet, wie genau der Wortlaut jeder Ausgabe menschlichen Übersetzungen entsprach, von 0 bis 100. Als Anhaltspunkt: Eine kleinere Version, die wir weiter unten testen, übersetzte jeden Satz des ersten chinesischen Clips richtig und kam auf 66. Die chinesischen Clips kamen ins Englische auf 60,6 und 51,7, die englischen Clips ins Chinesische auf 42,2 und 23,4.
Der Clip mit 23,4 verlor zwei seiner sechs Sätze. Ein Satz, über Binnenwasserstraßen als Reisethema, kam gar nicht heraus. Wir haben diesen Clip separat noch einmal laufen lassen, und er fiel wieder weg. Ein anderer Satz, über einen olympischen Schwimmer, schrumpfte auf fünf chinesische Schriftzeichen, die "der Medaillengewinner war" bedeuten. Ein dritter Satz drehte seine Bedeutung um: Gesagt wurde "couldn't have included", und die Übersetzung sagt "could include". Der Dienst markierte diesen Lauf als unvollständig. Im anderen englischen Clip ließ der Hauptlauf einen Satz über Eisenschienen im Jahr 1767 weg.
Diese umgedrehte Verneinung ist die Art Fehler, die ein Zuhörer nicht bemerken kann. Ein weggelassener Satz hinterlässt eine Lücke, die dir vielleicht auffällt. Ein falsches "could" klingt völlig flüssig.
Wir wissen nicht, warum. Als ganze Datei hochgeladen, kam derselbe Clip ebenfalls als unvollständig markiert zurück, also ist das Live-Setup nicht die einzige Ursache. Englisch nach Chinesisch solltest du zuerst auf deinem eigenen Audio testen.
Der Stimmklon füllt die Karte, und er funktionierte nur Chinesisch nach Englisch
Der Stimmklon funktionierte in einer Richtung und blieb in der anderen hängen. Er kopiert die Stimme des Sprechers aus den ersten Sekunden seiner eigenen Rede und liest die Übersetzung damit vor. Eine Referenzaufnahme ist nicht nötig. Er läuft als zweites, kleines Modell auf derselben Karte, Qwen3-TTS-0.6B vom Qwen-Team von Alibaba.
Beim ersten chinesischen Clip kam die erste englische Sprache 8,7 Sekunden nach Beginn des Clips heraus. Insgesamt erzeugte er 33,7 Sekunden englisches Audio für 49,8 Sekunden Chinesisch. Die Textübersetzung hielt ihr Tempo, die Stimme hat den Übersetzer also nicht ausgebremst. Den Speicher hat sie aber genommen: Die belegte Menge auf der Karte stieg von 38 GB auf 48 GB, fast die ganze Karte.
Englisch nach Chinesisch mit eingeschalteter Stimme hat nie geantwortet. Das Audio endete, und danach kam über vier Minuten lang nichts zurück. Status: offen, nicht untersucht. In diesem unbeaufsichtigten Lauf hat sich auch niemand die geklonte Stimme angehört, also sagen wir nichts darüber, wie nah sie am Original klingt.
Welche GPU: Eine echte 48-GB-Karte ist die belegte Größe, 32 GB ist nicht belegt
Die kleinste Karte, die es bedient hat, ist eine echte Karte mit 48 GB. Zwei günstigere Varianten haben wir auf derselben 48-GB-Karte ausprobiert.
- Ein Budget von 32 GB, simuliert. Wir haben dem Server gesagt, nur 32 GB der 48 zu nutzen. Er startete, mit Platz für ein deutlich kürzeres Gespräch und einen Zuhörer gleichzeitig. Er übersetzte beide Testclips im selben Live-Tempo. Aber der Start belegt in jedem Lauf kurz die ganze Karte, bevor er sich einpendelt. Eine Speichergrenze verhindert das nicht, also kann eine echte 32-GB-Karte wie eine RTX 5090 beim Start scheitern.
- Der 4-Bit-Build, etwa 21 GB. Die 4-Bit-Datei der Autoren, ein Build nur für Übersetzung, lief mit 21 GB auf der 48-GB-Karte. Sie übersetzte jeden Satz beider Clips, die sie bekam, unter einer Minute Sprache in etwa 3 Sekunden, ohne das Laden des Modells. Der Haken: Sie braucht eine Vorabversion eines separaten Werkzeugs und übersetzt nur eine fertige Datei. Noch kann kein Server sie laden.
Nicht ausprobiert haben wir den vollen 61-GB-Build, eine echte Karte mit 32 GB oder 24 GB und mehrere Zuhörer gleichzeitig.
Auf InferenceKey: drei Dienste auf einer Karte, die du kontrollierst, bereit nach etwa 6 Minuten, nach einem Neustart nach 73 Sekunden
Eine 48-GB-Karte hielt den Übersetzer, seinen Streaming-Dienst und die Stimme. Auf unserer Plattform ist ein Worker eine GPU-Maschine, die dir gehört oder die du mietest und mit der Plattform verbindest. Dieses Modell braucht mehr als einen einfachen Modellserver, also haben wir Python-Code geschrieben, der es zusammen mit SimulInfer installiert und beides der Reihe nach startet.
Ab dem ersten Deployment auf einer frischen Maschine war der Modellserver nach etwa 6 Minuten bereit. Ein Neustart auf derselben Maschine war nach 73 Sekunden bereit.
Das Problem, auf das du zuerst stößt, wenn du den komprimierten Build selbst deployst: SimulInfer erkennt ihn nicht. Es kennt nur die vollen Builds beim Namen und bricht mit einer Fehlermeldung auf Chinesisch ab, die sagt, dass es das Ausgabeformat des Modells nicht erkennen kann. Unser Code schreibt die kleine Datei, die SimulInfer sucht. Status: in unserem Beispiel behoben, bei den Autoren zum Testzeitpunkt noch nicht.
Eine Grenze liegt bei uns. Unsere API nimmt eine hochgeladene Datei von bis zu etwa einer Minute an und spielt sie dem Modell in Sprechgeschwindigkeit vor. Die Zeitachse der Ankünfte kommt am Ende zurück. Ein Live-Mikrofon geht noch nicht über unsere API. Status: offen. Die anderen Probleme und alle Zeiten stehen im Anhang.
Für ein paar Gespräche pro Woche ist ein gehosteter Live-Übersetzungsdienst der kürzere Weg. Dieses Setup ist für Teams, die das Modell auf einer Karte haben wollen, die sie kontrollieren.
Solltest du es nutzen? Ja für Chinesisch nach Englisch auf deiner eigenen Karte, die andere Richtung erst testen
- Wenn du Chinesisch nach Englisch live brauchst, ist das eine starke offene Option. Für ein Live-Mikrofon verbindest du dich heute direkt mit SimulInfer auf der Karte.
- Wenn du Englisch nach Chinesisch brauchst, teste es auf deinem eigenen Audio, bevor sich jemand darauf verlässt.
- Wenn du auch die Stimme des Sprechers willst, plane vorerst eine volle 48-GB-Karte und nur die Richtung Chinesisch nach Englisch ein.
- Wenn du eine Karte mit 24 GB oder 32 GB hast: Der 4-Bit-Build brauchte 20,5 GB auf einer 48-GB-Karte, nur für aufgenommene Dateien. Auf einer echten 24-GB-Karte haben wir ihn nicht ausprobiert, und er braucht einen noch nicht gemergten llama.cpp-Build.
- Wenn du eine andere Sprache brauchst, ist das nicht dein Modell.
Führe python publish.py und dann python main.py aus dem Hy-SimulMT-SDK-Beispiel aus. Es deployt dasselbe Setup auf deiner GPU und spielt deine Clips in Sprechgeschwindigkeit ab, mit Ankunftszeiten pro Stück. Du brauchst ein InferenceKey-Projekt mit SDK-Token und API-Key. Bring einen privaten NVIDIA-Worker mit 48 GB und etwa 70 GB Festplatte mit. Die Setup-Schritte stehen im Anhang.
Für Ingenieure
Credits
- Hy-SimulMT: Tencent Hunyuan. Sie haben das Modell trainiert und die Builds BF16, FP8, GGUF, Interleave, Interleave-FP8 und Interleave-GGUF veröffentlicht, dazu das vLLM-Plugin
simulst, den Dienst SimulInfer samt Launcher, die TTS-Integration, die llama.cpp-Unterstützung für die GGUF-Builds (PR #31198, noch offen), die Benchmarks und den Dolmetschervergleich. Repos: Basis, Interleave-FP8, GGUF, GitHub. - Stimme: Qwen3-TTS-12Hz-0.6B-Base vom Qwen-Team, bereitgestellt mit vLLM-Omni.
- Serving: das vLLM-Projekt (0.32.0 für die Übersetzung, 0.31.0 für die TTS-Seite), das llama.cpp-Projekt, bei dem die GGUF-Unterstützung eingereicht wurde, und das SGLang-Omni-Team für sein Cookbook.
- Testaudio: FLEURS dev (Google, CC BY 4.0).
- Wo es uns aufgefallen ist: AI Search, "AI finally sleeps, Gemini 4 Carbon, ...", 2026-11-01, Hy-SimulMT bei 10:02. Wir haben das gespeicherte Transkript verwendet, das Video nicht ganz angesehen.
- Unser Teil: das eigene Backend, das Deployment über die Plattform, das Streaming-Harness, die Messungen, die VRAM-Stufen, das SDK-Beispiel und das Demovideo.
Modell und Dateien
HYV3SpeechForCausalLM: Audio-Tower plus ein Hunyuan-v3-MoE, 48 Schichten, 128 Experten mit Top-8 pro Token plus 1 geteilter, 4 KV-Heads, head_dim 128. Insgesamt etwa 30B, etwa 3B aktiv.- Interleave-FP8 (der getestete Build; Interleave schreibt auch das Transkript der Quelle aus): fp8 e4m3, dynamische Aktivierungen,
weight_block_size[128,128] auf den Experten. lm_head, Router-Gates und Attention-Projektionen bleiben BF16. 32,16 GB (17 Shards plus eine Audio-Tower-Datei mit 0,66 GB), sha7f37cb76. - Größen laut HF-API: BF16 60,86 GB, GGUF Q4_K_M 19,75 GB, Q8_0 33,31 GB (nur Übersetzung, eine Datei mit dem Audio-Projektor darin).
- Lizenz:
apache-2.0auf den Cards von Basis und Interleave-FP8,LICENSE-Hy-SimulMT.txtim Repo (Apache-2.0 außer den aufgeführten Teilen Dritter). Die GGUF-Card hat kein Lizenzfeld. Keines der Repos ist zugangsbeschränkt. - Sprach-Tags: Die Card listet 40, aber der Card-Text, SimulInfer und das SGLang-Omni-Rezept unterstützen nur zh<->en.
- Richtungen: SimulInfer wirft einen
ValueError, außer die Richtung istzh-enoderen-zh(simulinfer/translation.py:36), der Client bietet nur diese beiden an (client.py:90). - Short-Form-Tabelle der Autoren (nicht nachgemessen): Hy-SimulMT FLEURS 90,3, CoVoST2 75,5, ACL6060 81,2, RealSI-Sentence 84,7. Gemini3.5-LiveTranslate 92,4 / 74,4 / 82,6 / 82,2, Qwen3.8-LiveTranslate 88,4 / 82,1 / 80,5 / 84,4. Long-Form RealSI StreamLAAL etwa 3 s, der niedrigste Wert in ihrem Diagramm; GEMBA über den offenen Modellen und vier von fünf kommerziellen APIs. StreamLAAL ist nicht die Zeit bis zur ersten Sprachausgabe.
- SGLang-Omni (von uns nicht getestet): BF16-Checkpoint nur für Übersetzung, nur Text, etwa 57 GiB Gewichte, eine einzelne H200.
sgl-omni serve --model-path tencent/Hy-SimulMT-30B-A3B --mem-fraction-static 0.75 --enable-realtime --port 8000. Offline-Eingabe bis 30 s pro Anfrage, Echtzeit unter/v1/realtime?intent=transcription(16 kHz PCM16, Hypothesen alle 1,6 s), der Kontext startet nach 30 s neu, ohne die VAD- und Recovery-Heuristiken von SimulInfer.
GPU-Wahl und Backend
- Geplante GPU: eine L40S mit 48 GB. Sie war zum Testzeitpunkt in unserer Cloud nicht verfügbar. Eine erste L40-Maschine kam ohne direktes SSH hoch, und der Manager verwarf sie nach etwa 3 Minuten. Wir haben eine RTX 6000 Ada Generation mit 48 GB verwendet (49.140 MiB, sm_89, Treiber 595.91.07, CUDA 13.2), dieselbe Ada-Generation und derselbe Speicher wie bei der L40S.
- FP8 auf Ada: vLLM 0.32.0 führt diese Block-FP8-Experten mit dem Weight-only-Marlin-Kernel aus ("Your GPU does not have native support for FP8 computation ... Weight-only FP8 compression will be used"). Eine L40S würde dasselbe tun. Der Dateimodus lief trotzdem etwa doppelt so schnell wie Echtzeit.
- Warum ein eigenes Backend: Das Standard-Backend
vllmkann das Pluginsimulstnicht hinzufügen, und die simultane Logik steckt in SimulInfer, einem separaten Dienst vor vLLM. - Backend
hy-simulmt0.1.2:setup()holt Hy-SimulMT bei7efcb18c, baut mit uv eine Python-3.12-Umgebung (vllm==0.32.0,simulst[audio]==0.1.0,SimulInfer[vad]), lädt die festgelegte Revision auf die Container-Festplatte, führtsimulinfer-prepare-modelaus, schreibtexport_manifest.json, wenn sie fehlt, übernimmt den vLLM-Befehl aussimulinfer.launch --dry-runund startet dann SimulInfer mit der Standardkonfiguration der Autoren, auf Loopback gerichtet. Optionale TTS-Umgebung (vllm==0.31.0,vllm-omni==0.31.0rc1) mitsimulinfer-tts-omnibei util 0,15. - vLLM-Flags im Lauf:
--enforce-eager, Prefix-Caching, Chunked Prefill,--limit-mm-per-prompt '{"audio":1024}', das Chat-Template der Autoren,--gpu-memory-utilization 0.78 --max-model-len 8192 --max-num-seqs 4 --max-num-batched-tokens 4096. process(): Multipart oder JSON,direction(oderlanguage),transportrealtime(WebSocket, PCM16-Pakete von 100 ms im Echtzeittakt) oderfile(/translate/streamSSE),tts. Gibt Text, Quelltext, jedes Event mitt_ms, Verzögerungen, ersten Text und das TTS-WAV zurück.- Kindprozesse bekommen
PR_SET_PDEATHSIG, und ein neu gestartetes Backend stoppt Server, die inservers.pidübrig geblieben sind.
Schritt für Schritt mit dem SDK-Beispiel
Beispiel: hy-simulmt-speech-translation-custom-backend-private-nvidia, Commits 61f823f (Beispiel) und 769745e (README-Hinweis zur Speicherspitze beim Start).
git clone https://github.com/inferencekey/inferencekey-sdk
cd inferencekey-sdk/examples/hy-simulmt-speech-translation-custom-backend-private-nvidia
cp .env.example .env        # SDK token, API key, IK_WORKER_ID, IK_CLIPS
pip install -r requirements.txt
python publish.py           # uploads the custom backend
python main.py              # ensure -> wait -> each clip in realtime -> outputs -> delete
- Braucht eine NVIDIA-GPU mit 48 GB, belegt mit und ohne den Stimm-Sidecar (das README des Beispiels sagt 40 GB+, was wir nicht getestet haben; die Spitze beim Start füllt 47,4 GiB), einen Treiber mit CUDA-13-Unterstützung und etwa 70 GB Festplatte.
- Umgebungsvariablen:
IK_WORKER_ID,IK_KEEP_ALIVE=1(Deployment behalten),HYSIMULMT_TTS=1(Stimmklon),HYSIMULMT_GPU_MEMORY_UTILIZATION,HYSIMULMT_MAX_MODEL_LEN,HYSIMULMT_MAX_NUM_SEQS. - Endpunkt:
/v1/audio/transcriptionsmitfile,direction(zh-enoderen-zh),transport(realtimeoderfile) undtts. Anfragegrenze 2 MiB, etwa eine Minute WAV mit 16 kHz.
Außerhalb unserer Plattform ist der Ein-Befehl-Weg der Autoren:
git clone https://github.com/Tencent-Hunyuan/Hy-SimulMT && cd Hy-SimulMT/SimulInfer
git checkout 7efcb18c   # the commit we tested
bash deploy.sh --install-server --model tencent/Hy-SimulMT-30B-A3B-Interleave
# Ready: http://127.0.0.1:8080/   (model server on :8800)
curl -N http://127.0.0.1:8080/translate/stream -F direction=en-zh -F file=@audio.wav
Dieser Befehl lädt den BF16-Interleave-Build (allein die BF16-Basis hat 60,86 GB), der nicht auf die hier getestete 48-GB-Karte passt. Bei 7efcb18c erkennt SimulInfer außerdem die FP8-Repo-Namen ohne den Fix mit export_manifest.json nicht (Problem 1).
SimulInfer-Endpunkte: GET /health, GET /config, GET /, POST /translate/submit, GET /translate/task/{task_id}, POST /translate/stream, WebSocket /translate/ws. Standardwerte: Blöcke von 1600 ms (standard), VAD an, max_sessions 4, Timeout 900 s, ws_audio_mode noise_resistant. Für die Stimme: simulinfer-tts-omni --model Qwen/Qwen3-TTS-12Hz-0.6B-Base --host 0.0.0.0 --port 8091 und [tts] tts_backend = "vllm_omni", tts_url = "http://127.0.0.1:8091/v1".
Alle Messungen
Zeit bis bereit:
- Kalt (Backend 0.1.0): etwa 6,2 min von
ensure()bis zur vLLM-API. Umgebung 47,2 s, Download von 32 GB 26,0 s, vLLM-Import etwa 2 min (die CPU der Maschine baute nebenbei llama.cpp), Laden der Gewichte 27,5 s, Engine-Initialisierung 71,2 s. - Warm (0.1.1): 73 s (vLLM 57,2 s, SimulInfer 6,0 s).
- Mit dem Bau der TTS-Umgebung (0.1.2): 376 s.
Übersetzung, RTX 6000 Ada, FP8 Interleave, SimulInfer-Standardwerte:
| Clip | Modus | Audio s | Wall s | Erster Text | Blockverzögerung Median / p90 / max (ms) | Verzögerung im LAAL-Stil (unsere) | chrF | BLEU | complete |
|---|---|---|---|---|---|---|---|---|---|
| zh1 zh->en | realtime | 49,8 | 51,07 | 5,51 s | 809 / 1546 / 2058 | 7,34 s | 60,6 | 28,8 | true |
| zh2 zh->en | realtime | 52,66 | 53,55 | 2,34 s | 738 / 1847 / 2907 | 3,98 s | 51,7 | 15,8 | true |
| en1 en->zh | realtime | 53,64 | 54,08 | 4,44 s | 733 / 1633 / 1876 | 1,58 s | 42,2 | 48,5 | true |
| en2 en->zh | realtime | 55,68 | 55,82 | 3,97 s | 434 / 1774 / 2729 | 15,18 s (durch Auslassungen aufgebläht) | 23,4 | 25,1 | false |
| zh1 | file | 49,8 | 26,29 | non-CA 5,50 s | 62,8 | 32,0 | true | ||
| zh2 | file | 52,66 | 27,52 | non-CA 3,02 s | 51,8 | 16,4 | true | ||
| en1 | file | 53,64 | 25,34 | non-CA 4,22 s | 29,5 | 33,2 | true | ||
| en2 | file | 55,68 | 25,05 | non-CA 6,50 s | 39,2 | 47,1 | false |
- Blockverzögerung = Ankunftszeit (Wall Time) minus Audio-Endposition des Blocks, der sie erzeugt hat. Blöcke sind 1,6 s lang, also wartet ein Wort vom Anfang eines Blocks länger als die Blockverzögerung.
- Qualitätswert: sacrebleu chrF, das gemeinsame Zeichenfolgen zwischen Ausgabe und Referenz zählt, 0 bis 100.
- Die Verzögerung im LAAL-Stil ist unsere Näherung über den ganzen Clip (gleichmäßige Zuordnung zur Referenzlänge, rechenzeitbewusst), nicht das StreamLAAL der Autoren und nicht mit ihren 3 s vergleichbar.
- chrF und BLEU mit sacrebleu 2.6.0 (BLEU-Tokenizer
zhfür chinesische Ausgabe). Je ein Clip: kein Benchmark. - Über
main.pyauf der Plattform: zh1 erste Wörter 6,14 s, Median 825 ms; en1 4,44 s, Median 713 ms. - Tester im Panel: Ein chinesischer Clip von 20 s lieferte
ok · 20943 msmit "The UN also hopes to eventually establish a fund to help relevant countries address the impacts of global warming. Soon, police equipped with riot gear entered the courtyard, and used tear gas to corner the prisoners."
GPU-Speicher:
- vLLM: Laden des Modells 30,05 GiB, KV-Cache 5,09 GiB = 55.552 Tokens, maximale Concurrency 6,78x bei 8.192 Tokens.
- nvidia-smi jede Sekunde: 38.256 MiB im Betrieb, 48.302 MiB mit Qwen3-TTS, 48.510 MiB (die ganze Karte) beim Encoder-Profiling während des Starts, in jedem Lauf.
Stimmklon (zh1 mit tts=true): erstes Audio 8.721 ms, 33,67 s englisches Mono-Audio mit 24 kHz für 49,8 s Eingabe, erster Text 5,52 s, Blockverzögerung Median 820 ms, p90 1.538 ms, Round Trip 56,2 s.
VRAM-Stufen
| GPU oder Grenze | Konfiguration | VRAM-Spitze | Zeit pro Ausgabe | Ausgabe OK? | Echt oder emuliert |
|---|---|---|---|---|---|
| RTX 6000 Ada 48 GB | FP8 Interleave, vLLM 0.32 + SimulInfer, util 0.78, len 8192, 4 seqs, batched 4096 | 37,4 GiB (47,4 GiB beim Start) | etwa 26 s pro Datei mit 50 bis 56 s | ja (en2 verliert Sätze) | echt |
| dasselbe + Qwen3-TTS 0.6B | + vLLM-Omni 0.31.0rc1, util 0.15 | 47,2 GiB | erstes Audio 8,7 s | zh->en ja, en->zh hängen geblieben | echt |
| Grenze 32 GB auf der 48-GB-Karte | util 0.66 (31,27 GiB), len 4096, 1 seq, 7.136 KV-Tokens | 31,6 GiB (Start weiter 47,4 GiB) | 51,6 s Wall zh1, 55,0 s en1 (realtime) | ja: zh1 chrF 62,8, en1 chrF 37,6 | emuliert |
| GGUF Q4_K_M, 19,75 GB | llama.cpp PR #31198 (d38e66aa), llama-mtmd-cli -ngl 99 -c 16384, Offline-Datei | 20,5 GiB | 3,2 s Turns pro Clip, etwa 16x Echtzeit | ja: alle Sätze, zh1 chrF 66,1, en1 chrF 42,3 | gemessen auf der 48-GB-Karte, nicht servierbar |
Die Grenze von 32 GB liegt bei 32.394 MiB gegenüber den 32.607 MiB einer RTX 5090, ohne Reserve, und die Grenze deckt die Spitze beim Start nicht ab. Nicht ausprobiert: eine echte Karte mit 32 GB oder 24 GB, BF16, SGLang-Omni, Interleave-GGUF, das FP8 ohne Interleave, Concurrency.
Probleme und Status
- SimulInfer erkennt die FP8-Checkpoints nicht.
ValueError: 无法识别所选模型的输出格式...ausmodel_discovery.py: keineexport_manifest.json, und der Name steht nicht inPROVIDED_CHECKPOINTS. In unserem Backend behoben (schreibt das Manifest). Upstream bei7efcb18coffen. - Das Encoder-Profiling beim Start füllt die Karte. Mit den 16.384 Batched Tokens der Autoren profilierte vLLM 3.276 Dummy-Audioeinträge, schrieb Tausende OOM-Warnungen des Allocators ins Log und fing sich dann. Wir nutzen 4.096. Die Spitze von 47,4 GiB (48.510 MiB) bleibt, auch unter einer Grenze von 0,66. Eine kleinere Karte kann hier scheitern.
- Versionsfalle bei vLLM-Omni. 0.32.0 und 0.32.0rc1 scheitern mit
ImportError: cannot import name 'Qwen3TTSSpeakerEncoder'. 0.31.0rc1 auf vLLM 0.31.0 funktioniert. In Backend 0.1.2 behoben. - Englisch nach Chinesisch mit Stimme hing nach dem Ende des Audios, keine Antwort nach 4 Minuten bei untätiger GPU. Offen, nicht untersucht.
- Weggelassene und verstümmelte Sätze bei Englisch nach Chinesisch (en2 in realtime und im Dateimodus, derselbe Satz in einem zweiten Lauf wieder weggelassen; en1 verlor einmal den Satz über 1767). Verhalten des Modells oder des Streamings, so berichtet, wie es war.
- Kein Live-Mikrofon über unsere API. Anfragegrenze 2 MiB und kein WebSocket-Durchreichen. Das Backend taktet hochgeladenes Audio und gibt die zeitgestempelten Events am Ende zurück. Offen.
- Verwaistes vLLM nach einem Watchdog-Retry hielt nach einem gescheiterten Start 47,4 GiB. In 0.1.1 mit einer Prüfung auf veraltete Server behoben.
- Weight-only-Marlin-FP8 auf Ada (siehe oben). Kein Fehler, ein Hinweis zur Geschwindigkeit.
Demovideo
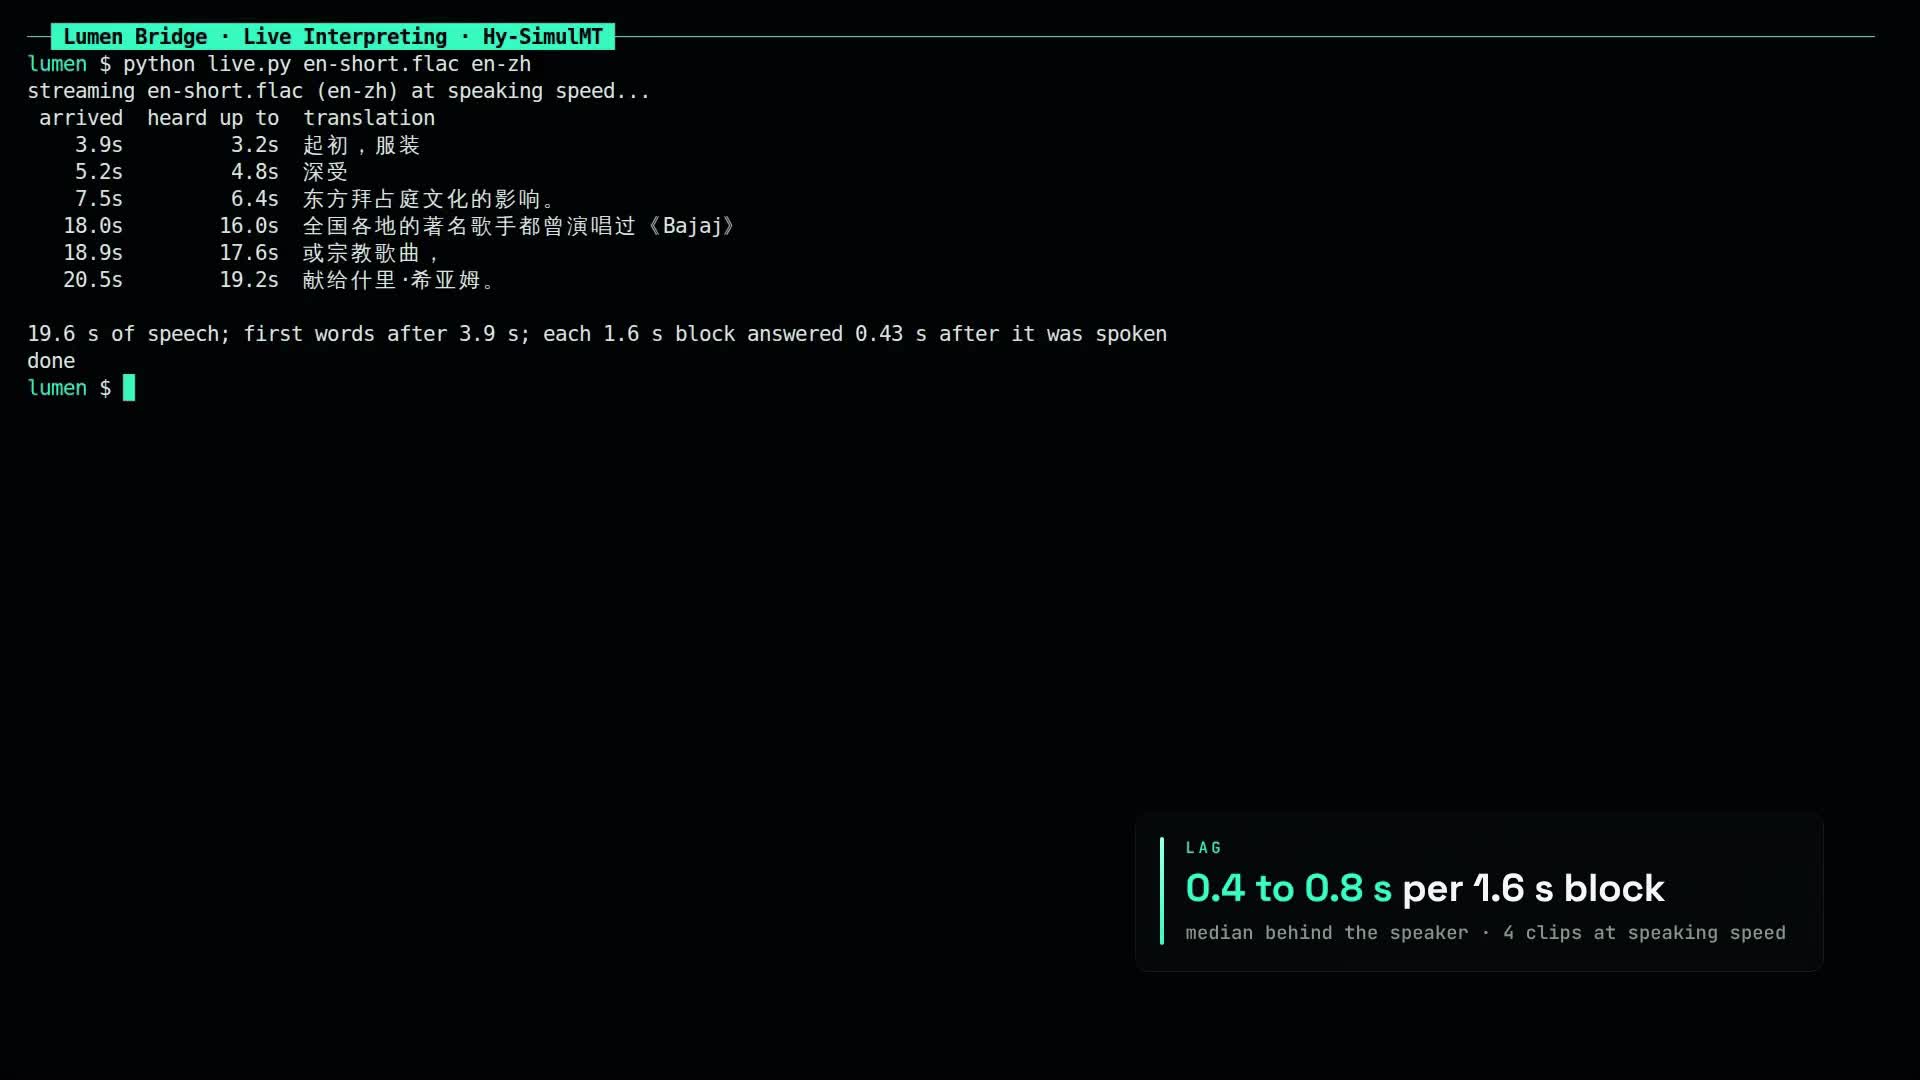
161 s, 1920x1080, mit Sprecherstimme, Kapiteln und einer Untertiteldatei mit 40 Einträgen. Es zeigt die Demos der Autoren mit Quellenangabe, das Deployment im Panel, den Tester, die Ankunftszeiten im Terminal und die Speicherstufen.
Grenzen dieses Tests
- Vier vorgelesene FLEURS-Clips, je ein Lauf plus Wiederholungen, eine Sitzung gleichzeitig. chrF auf einzelnen Clips ist kein Benchmark.
- Unser Verzögerungsmaß ist nicht StreamLAAL. Die Benchmarks der Autoren und der Dolmetschervergleich wurden nicht nachgemessen.
- Kein Mensch hat sich die geklonte Stimme angehört.
- Die Fakten zur Quelle stammen aus dem Repo bei Commit
7efcb18c(2026-10-27). Spätere Änderungen upstream, etwa dass SimulInfer die FP8-Namen lernt oder der llama.cpp-PR gemergt wird, haben wir nicht geprüft.
Quellen
- tencent/Hy-SimulMT-30B-A3B (Model Card, Benchmarks, Dolmetschervergleich)
- tencent/Hy-SimulMT-30B-A3B-Interleave-FP8
- tencent/Hy-SimulMT-30B-A3B-GGUF
- Tencent-Hunyuan/Hy-SimulMT und sein TTS-Leitfaden
- SGLang-Omni-Cookbook für Hy-SimulMT (nur BF16, nur Text, eine einzelne H200)
- News-Video von AI Search, 2026-11-01 (wo es uns aufgefallen ist)
- Unsere früheren Beiträge zu Sprache: Nemotron 3.5 Transcribe, Underdog Bark, Ming TTS