Nemotron 3.5 Transcribe auf einer 32-GB-Karte: ein Prompt bestimmt das Transkript, 3 Minuten in 4,4 Sekunden
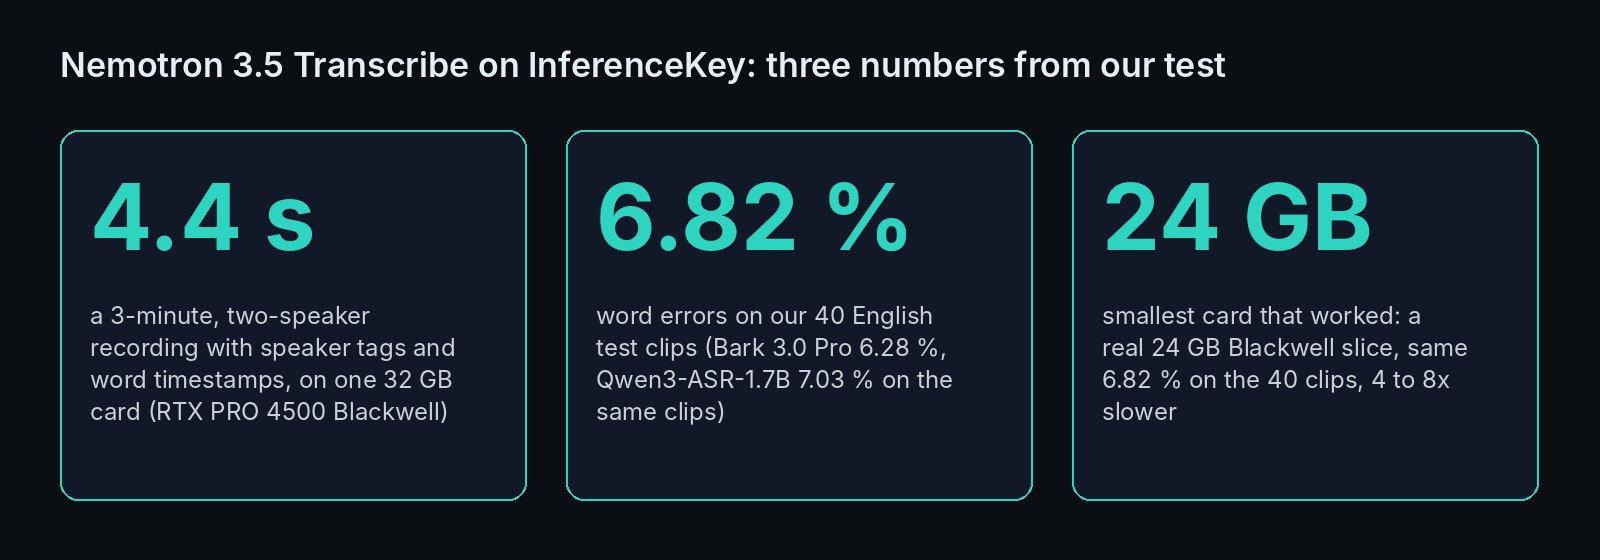
NVIDIAs offenes Sprachmodell machte aus 3 Minuten Gespräch zweier Sprecher in 4,4 s Text mit Zeiten und Sprecher-Tags, auf einer 32-GB-Karte. 24 GB: langsamer.
Bitte Nemotron 3.5 Transcribe um Sprecher-Tags. Ein dreiminütiger Arztbesuch kommt nach 4,4 Sekunden GPU-Zeit zurück, aufgeteilt in Arzt und Patient, mit Start- und Endzeit für jedes seiner 561 Wörter. Bitte um ein bereinigtes Transkript, und dasselbe Modell lässt stattdessen die "ähs" weg.
Wir haben NVIDIAs neues offenes Sprachmodell auf einer Blackwell-Grafikkarte mit 32 GB betrieben, mit der Open-Source-Software, die NVIDIA mitliefert. Für alle, die eigene GPUs betreiben, heißt das: Ein Deployment liefert jedem Team das Transkript, das es braucht, ausgewählt pro Anfrage. Auf 40 Standard-Testclips lag es bei 6,82 % falschen Wörtern, im selben Bereich wie die Modelle, mit denen wir es verglichen haben. Ein 24-GB-Anteil einer größeren Blackwell-Karte hat es ebenfalls ausgeführt, vier- bis achtmal langsamer. Unser SDK-Beispiel deployt es auf deiner eigenen Blackwell-GPU.
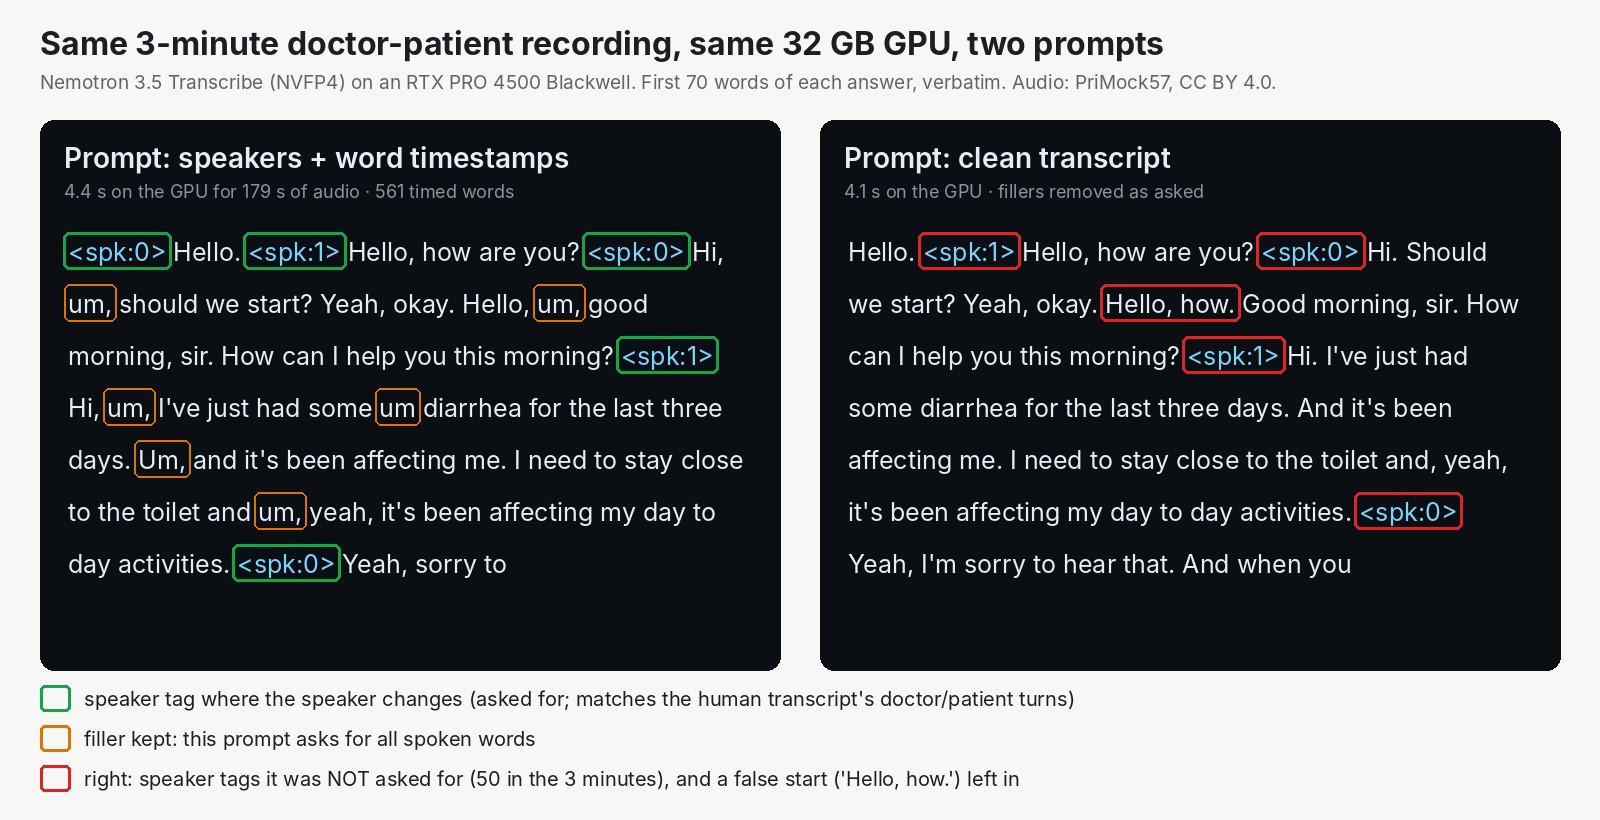
Dieselbe Aufnahme, dieselbe Karte, zwei Prompts. Die bereinigte Version rechts fügt Sprecher-Tags hinzu, um die niemand gebeten hat.
Ein Modell, und die Anweisung entscheidet, welches Transkript du bekommst
Nemotron 3.5 Transcribe funktioniert eher wie ein Chatmodell, das zuhört. Du schickst das Audio plus einen Satz als Anweisung, und die Anweisung wählt das Transkript.
NVIDIAs Modellseite listet auf, was dieser Satz verlangen kann. Wort für Wort, mit jedem Füllwort. Bereinigt zum Lesen. Nach Sprechern getaggt, mit einer Zeit für jedes Wort. Übersetzt. Es kann auch die Sprache nennen oder eine Frage zum Audio beantworten. Es deckt 40 Sprachen ab und Aufnahmen bis zu einer Stunde.
Für ein Team ist das der Unterschied zwischen drei Systemen und einem. Eine medizinische Dokumentation will die bereinigte Version, ein Compliance-Team will jedes "äh", und ein Meeting-Tool will wissen, wer was gesagt hat. Ohne dieses Modell sind Sprecherlabels und Bereinigung separate Schritte, die du selbst einbaust. Hier ist es eher wie ein Studio, das einen Take aufnimmt und ihn für jeden Hörer anders abmischt: eine geladene Kopie, ein anderer Satz in jeder Anfrage.
Für ein Sprachmodell ist es groß. Es hat insgesamt 34 Milliarden Parameter, aber nur etwa 4,3 Milliarden arbeiten an jedem Stück Audio. Stell dir ein großes Team von Spezialisten vor, bei dem jedes Wort eine Handvoll davon befragt, während der Rest wartet. Deshalb ist es für seine Größe schnell.
NVIDIA hat es am 28. Oktober in drei Dateigrößen veröffentlicht: 67,5 GB, 34,7 GB und 21,6 GB. Die kleinste Datei läuft nur auf NVIDIAs neuester Kartengeneration, Blackwell. Laut NVIDIA ist sie fast so genau: 3,6 % mehr Fehler als die größte Version.
Die Lizenz ist OpenMDW-1.1. Sie erlaubt, das Modell ohne Einschränkung zu nutzen, zu verändern und weiterzugeben, solange der Hinweis erhalten bleibt. Was du mit den Transkripten machst, ist an keine Bedingung geknüpft. NVIDIAs Seite sagt klar, dass kommerzielle Nutzung erlaubt ist.
NVIDIA hat das Modell und sein offenes Serving-Rezept gebaut, Open-Source-Projekte die Engine, auf der es läuft. Uns ist es im News-Video von AI Search vom 1. November aufgefallen. Wir haben es paketiert, auf Karten betrieben, die ein Team mieten kann, und die Fehler gezählt. Im Anhang nennen wir alle Beteiligten.
NVIDIAs Zahlen sind stark, und die schnellste Angabe ist noch nicht offen
In NVIDIAs eigenen Tests liegt das Modell vor den offenen Sprachmodellen, mit denen es verglichen wird. Auf neun englischen Standard-Testsets kommt es im Schnitt auf 4,71 % falsche Wörter, gegenüber 4,94 % bei Qwen3-ASR-1.7B. In sieben anderen Sprachen erreicht es 4,62 % gegenüber 6,49 % beim selben Qwen-Modell. Wenn Leute durcheinanderreden, sind etwa 16 von 100 Wörtern falsch oder dem falschen Sprecher zugeordnet (15,80), gegenüber 16,83 beim stärksten Vergleich, den NVIDIA aufführt. Das sind NVIDIAs Läufe der größten Version, erfasst am 12. Oktober. Wir haben sie nicht nachgemessen.
Die Geschwindigkeitsangabe muss man genauer lesen. NVIDIAs Seite sagt, eine RTX PRO 6000 Blackwell mit 96 GB transkribiert bis zu 2.238 Sekunden (etwa 37 Minuten) Audio pro Sekunde. Die Seite ergänzt, dass diese Zahl von NVIDIAs eigener paketierter Engine stammt. Diese Optimierungen "are not yet part of the open-source release". Die offene Version vom Veröffentlichungstag "is expected to be roughly two times slower". Wir haben die offene Version verwendet, unsere Zahlen kommen also von diesem langsameren Weg.
Noch eine Grenze, ebenfalls von NVIDIAs Seite: Das ist ein Offline-Modell. Du gibst ihm eine fertige Aufnahme und bekommst ein Transkript zurück. Es untertitelt kein laufendes Gespräch, während die Leute sprechen.
Der Test: eine RTX PRO 4500 Blackwell mit 32 GB und die offene Software
Was bringt dir eine Blackwell-Karte mit 32 GB mit der Software, die jeder herunterladen kann? NVIDIAs Seite führt die RTX 5090, eine Gaming-Karte mit 32 GB, als kompatibel mit der kleinen Datei. An dem Tag war in unserer Cloud keine RTX 5090 verfügbar. Wir haben eine RTX PRO 4500 Blackwell verwendet, eine Workstation-Karte mit denselben 32 GB und derselben Chipgeneration. Ihr Speicher ist etwa halb so schnell wie der einer 5090. Eine 5090 haben wir nicht gemessen.
Wir haben ihr drei Arten von Audio gegeben:
- die ersten drei Minuten einer PriMock57-Konsultation, ein nachgestellter Arztbesuch mit menschlichem Transkript
- fünf Minuten Audio aus Earnings Calls, zusammengesetzt aus 33 Segmenten eines öffentlichen Testsets
- dieselben 40 kurzen englischen Clips aus einem öffentlichen Spracherkennungs-Benchmark, mit denen wir letzte Woche Underdog Bark und Qwen3-ASR verglichen haben.
Das ergibt einen direkten Vergleich mit zwei Modellen, die wir schon kennen. Eines davon, Qwen3-ASR, ist das Sprachmodell, das wir bereits für unsere eigene Transkription betreiben. Die Stichprobe ist klein: 924 Wörter in Clips, eine Datei mit drei und eine mit fünf Minuten, eine Anfrage nach der anderen.
Drei Minuten Arztbesuch in 4,4 Sekunden, mit wer was wann gesagt hat
Jeder Prompt in der Tabelle brauchte für drei Minuten Audio weniger als fünf Sekunden GPU-Zeit, etwa vierzigmal schneller, als die Aufnahme läuft.
| Prompt | GPU-Zeit für 3 Minuten | Was zurückkam |
|---|---|---|
| verbatim | 4,1 s | 11,74 % Wortfehler gegenüber dem menschlichen Transkript, 33 der 34 "um" und "uh" erhalten |
| clean | 4,1 s | alle Füllwörter entfernt (siehe unten) |
| speakers + word timestamps | 4,4 s | Turns von Arzt und Patient, 561 Wörter mit Start- und Endzeit |
Verbatim behielt die Zögerlaute, die ein Compliance-Team braucht, und speakers trennte die Turns. Nebeneinander gelesen passen die Turns zur menschlichen Referenz, aber das haben wir nur mit dem Auge geprüft: Bewertet haben wir die Wörter, nicht die Sprecherlabels. Ein vierter Prompt, "translate to Spanish", kam nach 4,9 Sekunden auf der GPU auf Spanisch zurück. Bewertet haben wir das nicht.
Die fünfminütige Earnings-Call-Datei brauchte in einer Anfrage 4,8 Sekunden auf der GPU. 16,11 % der Wörter waren falsch, aber die zusammengesetzte Referenz hat Lücken an den Stellen, wo die Segmente aufeinandertreffen, also zählt nur der Vergleich: Bark kam im Test letzte Woche auf derselben Datei auf 18,69 %, und Qwen3-ASR hat in unserem Setup von letzter Woche mittendrin aufgehört.
Auf den 40 kurzen Clips, der Genauigkeitszahl, die sich zwischen Modellen vergleichen lässt, lag es bei 6,82 % Fehlern. Bark 3.0 Pro kam auf denselben Clips auf 6,28 % und Qwen3-ASR-1.7B auf 7,03 %, gleich bewertet. Nemotron liegt also dazwischen, näher an Qwen. Die beiden liefen im Test letzte Woche auf einer anderen Karte, also lassen sich die Fehlerraten vergleichen, die Geschwindigkeiten nicht.
Wo es patzt: der clean-Prompt taggt zu viel, und Meetings sind sein schwächstes Set
Den clean-Prompt solltest du testen, bevor du ihm vertraust. Unsere clean-Anweisung sagt "omit fillers and accidental repetitions; keep the remaining spoken wording unchanged" und endet mit "Output: transcript only". Tags verlangt sie nicht. Das Modell hat jedes Füllwort entfernt und zusätzlich 50 Sprecher-Tags in drei Minuten eingefügt. Einen Fehlstart, "Hello, how.", hat es stehen lassen, obwohl ein Leser ihn weg erwarten würde. Wenn deine Pipeline reinen Fließtext erwartet, entferne die Tags oder nutze bewusst den speakers-Prompt.
Auf den 40 Clips war es bei Hörbuch-Sprache das beste der drei: 0,94 % falsch, gegenüber 1,88 % bei Qwen3-ASR und 2,35 % bei Bark. AMI, aufgezeichnete Büromeetings, in denen Leute durcheinanderreden, war mit 14,62 % sein schwächstes Set, hinter Bark (11,54 %) und vor Qwen3-ASR (16,92 %). Ein Meeting-Tool sollte vor dem Wechsel seine eigenen Aufnahmen prüfen.
Welche GPU: ein echter 24-GB-Anteil hat funktioniert, vier- bis achtmal langsamer
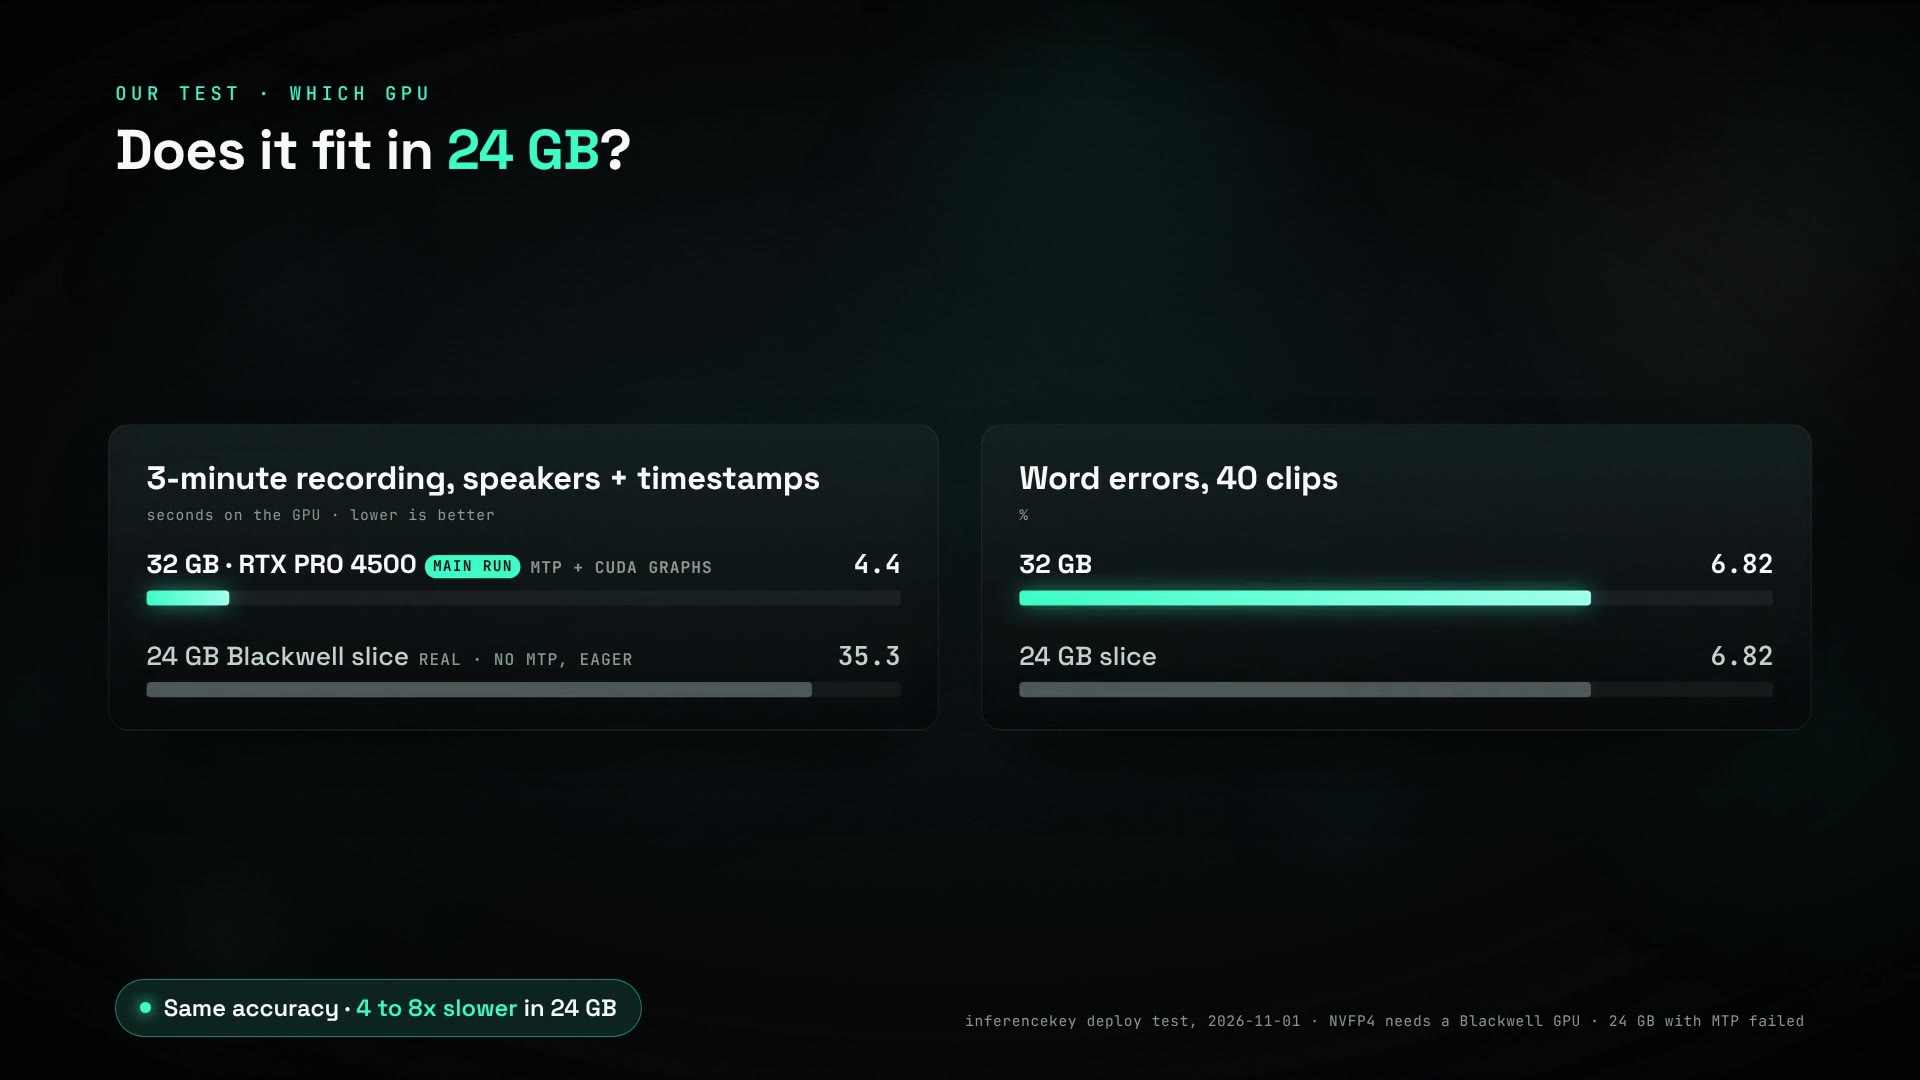
Die kleinste Hardware, die funktioniert hat, war ein echter 24-GB-Anteil einer Blackwell-Karte. Die 32-GB-Karte ist die schnelle Option, nicht das Minimum.
Dieser Anteil stammt von einer RTX PRO 6000 Blackwell, einer Karte mit 96 GB, die sich in isolierte Stücke aufteilen lässt. Jedes Stück bekommt 24 GB Speicher und ein Viertel der Rechenleistung der Karte. Darauf brauchte der dreiminütige speakers-Lauf 35,3 Sekunden statt 4,4. Das ist achtmal langsamer und immer noch etwa fünfmal schneller, als die Aufnahme läuft. Kurze Clips waren etwa viermal langsamer, die fünfminütige Datei etwa siebenmal.
Die zwei Setups, die funktioniert haben:
| Hardware | Einstellungen | Ergebnis |
|---|---|---|
| RTX PRO 4500 Blackwell, 32 GB | schnellste Einstellungen | funktioniert, die Zahlen oben, in der Spitze etwa 30 GB belegt |
| 24-GB-Anteil einer Blackwell-Karte | langsamere Einstellungen, kürzere Aufnahmen, 2 Anfragen gleichzeitig | funktioniert |
Im schnellen Modus passte das Modell nicht in den 24-GB-Anteil. Nicht ausprobiert haben wir eine vollständige Blackwell-Karte mit 24 GB, 16 GB, die mittelgroße Datei auf einer 48-GB-Karte und viele Anfragen gleichzeitig.
Auf InferenceKey: eine geladene Kopie bedient jeden Stil
Eine laufende Kopie auf einer gemieteten Karte hat alle vier Stile unter derselben Adresse beantwortet, ein neuer Transkript-Stil kostet also einen Satz, kein weiteres Deployment. Über die Plattform war ein Neustart nach 88 Sekunden bereit. Eine frische Maschine war nach 217 Sekunden bereit. Unser allererster Start dauerte etwa sechs Minuten, während einmaliger GPU-Code gebaut wurde.
Es brauchte ein eigenes Backend, eine kurze Python-Datei, die unserer Plattform sagt, wie sie ein Modell auf jeder GPU-Maschine installiert und startet. Unsere eingebaute Option installiert nur die Serving-Engine und kann NVIDIAs Sprach-Add-on nicht hinzufügen, deshalb baut unsere Datei beides nach NVIDIAs Rezept. Unser Backend stellt die Standard-Sprachroute von OpenAI bereit, /v1/audio/transcriptions. Unser Qwen3-ASR-Deployment antwortet auf derselben Route, die Anfrage, die ein Team schon schickt, behält also ihre Form. Neu ist das Prompt-Feld.
Eine Grenze, auf die du stoßen wirst, ist noch offen. Unsere Transkriptionsadresse nimmt Dateien bis 2 MB an, etwa acht Minuten komprimierte Sprache. Das Modell nimmt eine Stunde Audio, also schneide längere Aufnahmen vorerst zu oder komprimiere sie stark. Jede Anfrage wird für sich diarisiert, Sprecherlabels bleiben über die Stücke hinweg also womöglich nicht gleich; geteilte Aufnahmen haben wir nicht getestet.
Solltest du es nutzen? Ja für mehrere Transkript-Stile von einer Blackwell-Karte
- Du brauchst verschiedene Transkripte für verschiedene Teams. Ein Deployment liefert wörtlichen, bereinigten, nach Sprechern getaggten und übersetzten Text. Prüfe die bereinigte Ausgabe auf verirrte Tags.
- Du brauchst die niedrigste Fehlerrate auf englischen Clips. Auf unserer Stichprobe liegt es im selben Bereich wie Bark 3.0 Pro und Qwen3-ASR-1.7B, nicht davor. Sein Gewinn ist die Wahl der Ausgabe, nicht die reine Genauigkeit.
- Du hast eine Blackwell-Karte mit 32 GB. Es läuft schnell. Ein 24-GB-Anteil einer Blackwell-Karte läuft auch, langsamer.
- Du betreibst RTX 4090 oder ältere Karten. Die kleine Datei läuft nicht, sie braucht Blackwell. NVIDIA führt die mittelgroße Datei auf einer L40S mit 48 GB.
- Du brauchst Live-Untertitel. Nicht mit diesem Modell, es ist nur offline.
Folge dem SDK-Beispiel für Nemotron 3.5 Transcribe, um die drei Transkripte deiner eigenen Aufnahme auf deiner eigenen Blackwell-GPU zu bekommen. Fülle .env aus, führe einmal python publish.py aus und dann python main.py. Für die Standardeinstellungen braucht es eine Karte mit 32 GB, etwa 50 GB Platte und eine Audiodatei unter 2 MB.
Für Ingenieure
Credits
- NVIDIA: das Modell, das vLLM-Plugin von NeMo Speech (
nemo_speechlm, Apache-2.0), das Serving-Rezept und die Benchmarks. - vLLM-Projekt: die Serving-Engine (0.32.0), auf der der offene Weg läuft.
- FlashInfer-Team: die vorgebauten sm120-Kernel (
flashinfer-jit-cache,flashinfer-jit-cache-sm120f) von flashinfer.ai. - SGLang-Omni (sgl-project/sglang-omni, Apache-2.0): der alternative Serving-Weg, Release v0.2.0 am 2026-10-27.
- Babylon Health: PriMock57 (CC BY 4.0), die Arzt-Patienten-Aufnahmen. Unser 3-Minuten-Schnitt von
day1_consultation01stammt aus den Demodaten in NVIDIAs Hugging Face Space. - hf-audio: die Testdaten des Open ASR Leaderboard, aus denen die 40 Clips stammen.
- AI Search: wo es uns aufgefallen ist (Video, Kapitel bei 32:04).
- InferenceKey: das eigene Backend, das Deployment, die Messungen und das SDK-Beispiel.
Modell und Dateien
| Modell | Sprach-Encoder und Sprecher-Encoder vor dem Sprachmodell Nemotron 3.5 Lightning: hybrides Mamba-2/Transformer-MoE-LM (Nemotron 3.5 Lightning 30B-A3B: Mamba-2 x23, MoE x23, Attention x6, 128 Experten top-6) + Parallel Expert Encoder (600M ASR-Transformer, ~99M Sortformer-Sprecher-Encoder) + 47M CTC-Zeitstempel-Heads. 34B gesamt, ~4,3B aktiv inkl. Audio-Encoder. Kontext von 65.536 Tokens |
| Spekulatives Decoding | nativer MTP-Head; optionaler DFlash2-Draft (1,14 GB, damit keine Wort-Zeitstempel) |
| Checkpoints (HF-API, Summe der Dateien; die Card nennt keine Größen) | BF16 67,52 GB; FP8 34,69 GB; NVFP4 21,58 GB |
| Verwendet | NVFP4 sha 66c6adc4020179567074d0399cda2a4eeb2bb347: 2 NVFP4-Shards 9,99 + 9,19 GB, Perception 0,84 GB, MTP FP8 1,34 GB, CTC BF16 0,20 GB. Gemischter ModelOpt-Export (NVFP4-Decoder, FP8-Mamba-Layer, FP8-Audio-Encoder, FP8-MTP-Head); nur Blackwell; --kv-cache-dtype fp8; die quantisierten Kernel brauchen nvcc aus CUDA 13 |
| Qualitätskosten laut Card | NVFP4 3,6 % höherer Fehler als BF16 (relativ), FP8 1,0 % |
| Release | 28.10.2026 auf build.nvidia.com, GitHub, Hugging Face und NGC; HF lastModified 2026-10-29T23:04Z |
| Lizenz | OpenMDW-1.1 |
Was die Card zur Hardware sagt
Die Kompatibilitätstabelle der Card nennt keine Speichergrößen. Sie führt auf: A100 80GB SXM (BF16); B200, GB200, GB300, DGX Spark, Jetson Thor (BF16, FP8, NVFP4); RTX 5090 (NVFP4, mit vLLM 0.32.0, Transformers, GGML); RTX PRO 6000 Blackwell Server Edition (BF16, FP8, NVFP4; auch SGLang-Omni 0.2.0); H100 (BF16, FP8; auch SGLang-Omni); H200 (BF16, FP8); L40S PCIe 48GB (FP8). Die Zeilen unter "Deployment": BF16-Card "1x H100 80 GB"; NVFP4- und FP8-Cards "1x RTX PRO 6000 Blackwell (96 GB)". RTX 5090 und L40S erscheinen nur als Kompatibilitätszeilen.
Serving-Wege und Endpunkte
- vLLM 0.32.0 + NeMo-Speech-Plugin (was wir verwendet haben). Die Card dokumentiert
/v1/chat/completions(base64audio_url+ Text-Prompt); Wort-Zeitstempel kommen in einemctc_timestamps-Objekt auf oberster Ebene zurück (wordsmit start/end/speaker,diarization,speaker_tag_to_diarization_speaker,error). Zeitstempel-Anfragen nehmen eine Aufnahme,stream=false,n=1. Unser eigenes Backend umhüllt das und stellt auf der Plattform die OpenAI-Route/v1/audio/transcriptionsbereit. - SGLang-Omni 0.2.0 (pinnt SGLang 0.5.22). Transkribiert ganze Dateien auf
/v1/audio/transcriptions, eine GPU, nur BF16 oder FP8 (validiert auf einer H100 80 GB und einer RTX PRO 6000 Blackwell), kein NeMo nötig. Laut Card sind "word timestamps, speaker-attributed output, translation and speculative decoding are not part of this integration". Das Cookbook bietetstream=true-Textdeltas, nachdem der ganze Upload kodiert ist, also kein Live-Streaming. Es nennt RTFx 23,40 bei Concurrency 1 und 102,17 bei 16 auf einer H100 BF16 mit kurzen Clips. - NIM: das optimierte vLLM hinter der Angabe von 2.238 s/s (NVFP4 + DFlash2 auf einer RTX PRO 6000 Blackwell Server Edition). Noch nicht Open Source.
Setup
| Haupt-GPU | RTX PRO 4500 Blackwell 32 GB (32.623 MiB, GB203, sm_120), Limit 200 W, Treiber 595.91.07 (CUDA 13.2), nvcc 13.0.88, Container mit 62 GB RAM / 10,2 CPUs, 100 GB Platte |
| Warum keine 5090 | RTX 5090 zum Testzeitpunkt in unserer Cloud nicht verfügbar. Die PRO 4500 hat dieselben 32 GB und sm_120, etwa die halbe Speicherbandbreite einer 5090 und lief mit einem Limit von 200 W. Auf einer 5090 nicht gemessen |
| GPU für die Stufen | RTX PRO 6000 Blackwell Server Edition, MIG-Slice 1g.24gb |
| Stack | lokaler InferenceKey-Manager (nie die Produktion), eigenes Backend nemotron-transcribe 0.1.4 |
| Backend | lädt NeMo Speech bei e5d79d5a49cbec49d79440b0070aac0c32a8dbb8 herunter; uv venv --python 3.13; uv sync --extra asr --extra vllm --locked --no-install-project; -e .; av==19.0.2, opencv-python-headless==5.0.0.93; vorgebaute FlashInfer-Kernel 0.7.0.post1+cu130; MAX_JOBS=6; snapshot_download der gepinnten Revision |
vllm serve | VLLM_PLUGINS=nemo_speechlm; fp8-KV-Cache, --use-replayssm, --mamba-backend flashinfer, CTC-Zeitstempel-Middleware, --reasoning-parser nemotron_v3, MTP 8; util 0,92, --max-model-len 65536, 8 Sequenzen; ein Audio pro Prompt bis 57.600.000 Samples; Warm-up mit 2 s Stille. Das Rezept der Autoren zielt auf eine H100 80 GB (util 0,94, 192 Sequenzen) |
| Anfragen | multipart file, prompt (Stilname verbatim, clean, speakers, nearfield, translate oder freier Text), timestamp_granularities[]=word; Temperatur 0, Thinking aus |
| Gesendeter Stiltext | verbatim: "Audio transcription. Language: as spoken. Wording: verbatim, including fillers and repetitions. Formatting: punctuation and capitalization. Output: transcript only." clean: "Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only." speakers: "Transcribe this audio with punctuation and capitalization. Include all spoken words and verbal fillers. Write numbers in their standard written form. Put speaker tags spk:0 spk:1 spk:2 spk:3 on the transcription." (STYLES in backend.py; das Modell sieht den Stilnamen nie) |
| Bewertung | jiwer mit dem englischen Whisper-Normalizer; Sprecher-Tags vor der Bewertung entfernt |
Schritt für Schritt mit dem SDK-Beispiel
Das Beispiel (Commit 5017429 auf main) enthält backend.py, publish.py, main.py, requirements.txt und .env.example.
cp .env.example .env                # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY,
                                    # INFERENCEKEY_PROJECT, IK_WORKER_ID, IK_AUDIO (< 2 MiB),
                                    # INFERENCEKEY_TENANT_ID, INFERENCEKEY_USER_TOKEN (for publish.py)
pip install inferencekey requests openai  # client side; requirements.txt is the backend's
python publish.py                   # once: packages dist/*.tar.gz and uploads it to your tenant;
                                    # without the two publish variables, upload that file from
                                    # Dashboard -> Custom backends
python main.py                      # ensure, wait, verbatim/clean/speakers on IK_AUDIO, delete
IK_KEEP_ALIVE=1 behält den Workload. Voraussetzungen: eine Blackwell-GPU, ein Treiber für CUDA 13, etwa 50 GB Platte, 32 GB VRAM für die Standardeinstellungen. Für eine 24-GB-Karte setzt du, was auf dem MIG-Slice lief:
NEMOTRON_GPU_MEMORY_UTILIZATION=0.93
NEMOTRON_MAX_MODEL_LEN=16384
NEMOTRON_MAX_NUM_SEQS=2
NEMOTRON_MTP=0
NEMOTRON_ENFORCE_EAGER=1
Den deployten Workload mit dem OpenAI-Client aufrufen:
from openai import OpenAI
client = OpenAI(base_url="https://cloud.inferencekey.com/endpoint/<project>/nemotron-transcribe/v1",
                api_key="ik_live_...")
out = client.audio.transcriptions.create(model="default", file=open("meeting.ogg", "rb"),
                                         prompt="speakers", timestamp_granularities=["word"])
Alle Messungen
Hauptlauf über die Plattform, RTX PRO 4500 Blackwell, NVFP4, MTP 8, CUDA Graphs. GPU-Zeit im Backend; Round Trip vom Client aus.
| Eingabe | Prompt | GPU s | Round Trip s | Ergebnis |
|---|---|---|---|---|
| Konsultation 3 min (178,61 s) | verbatim | 4,113 | 4,62 | 11,74 % WER gegenüber dem menschlichen PriMock57-Transkript (S 17, D 32, I 15); 33 um/uh erhalten (Referenz 34) |
| Konsultation 3 min | clean | 4,054 | 4,58 | 14,68 % gegenüber der verbatim-Referenz (Füllwörter absichtlich entfernt); 50 nicht verlangte Sprecher-Tags |
| Konsultation 3 min | speakers + word timestamps | 4,401 | 4,97 | 13,58 % (Tags entfernt); 57 Tags, Zuordnung {"0":0,"1":1}, 561 Wörter mit Zeitangabe, error: null |
| Konsultation 3 min | "Please translate the given speech to Spanish." | 4,857 | 5,33 | spanischer Text, nicht bewertet |
| Earnings-22 zusammengesetzt (303,4 s) | verbatim | 4,818 | 5,243 | 16,11 % (Bark 18,69 %; Qwen3-ASR 72,04 %, abgeschnitten, im früheren Test) |
| 40 Clips (347,5 s, 924 Wörter) | verbatim | 12,956 | Median 0,50 pro Clip | 6,82 % (S 30, D 17, I 16) |
Pro Set auf den 40 Clips:
| Set (je 8 Clips) | Nemotron NVFP4 | Bark 3.0 Pro (früherer Test) |
|---|---|---|
| AMI | 14,62 % | 11,54 % |
| Earnings-22 | 9,78 % | 8,15 % |
| GigaSpeech | 3,54 % | 3,54 % |
| LibriSpeech test-other | 0,94 % | 2,35 % |
| VoxPopuli | 8,54 % | 8,04 % |
| Alle 40 | 6,82 % | 6,28 % (Qwen3-ASR-1.7B 7,03 %) |
Bark und Qwen3-ASR liefen auf einer RTX 3090 (Qwen auf dem eingebauten sglang-Backend 0.5.14), WER lässt sich also vergleichen, Geschwindigkeit nicht.
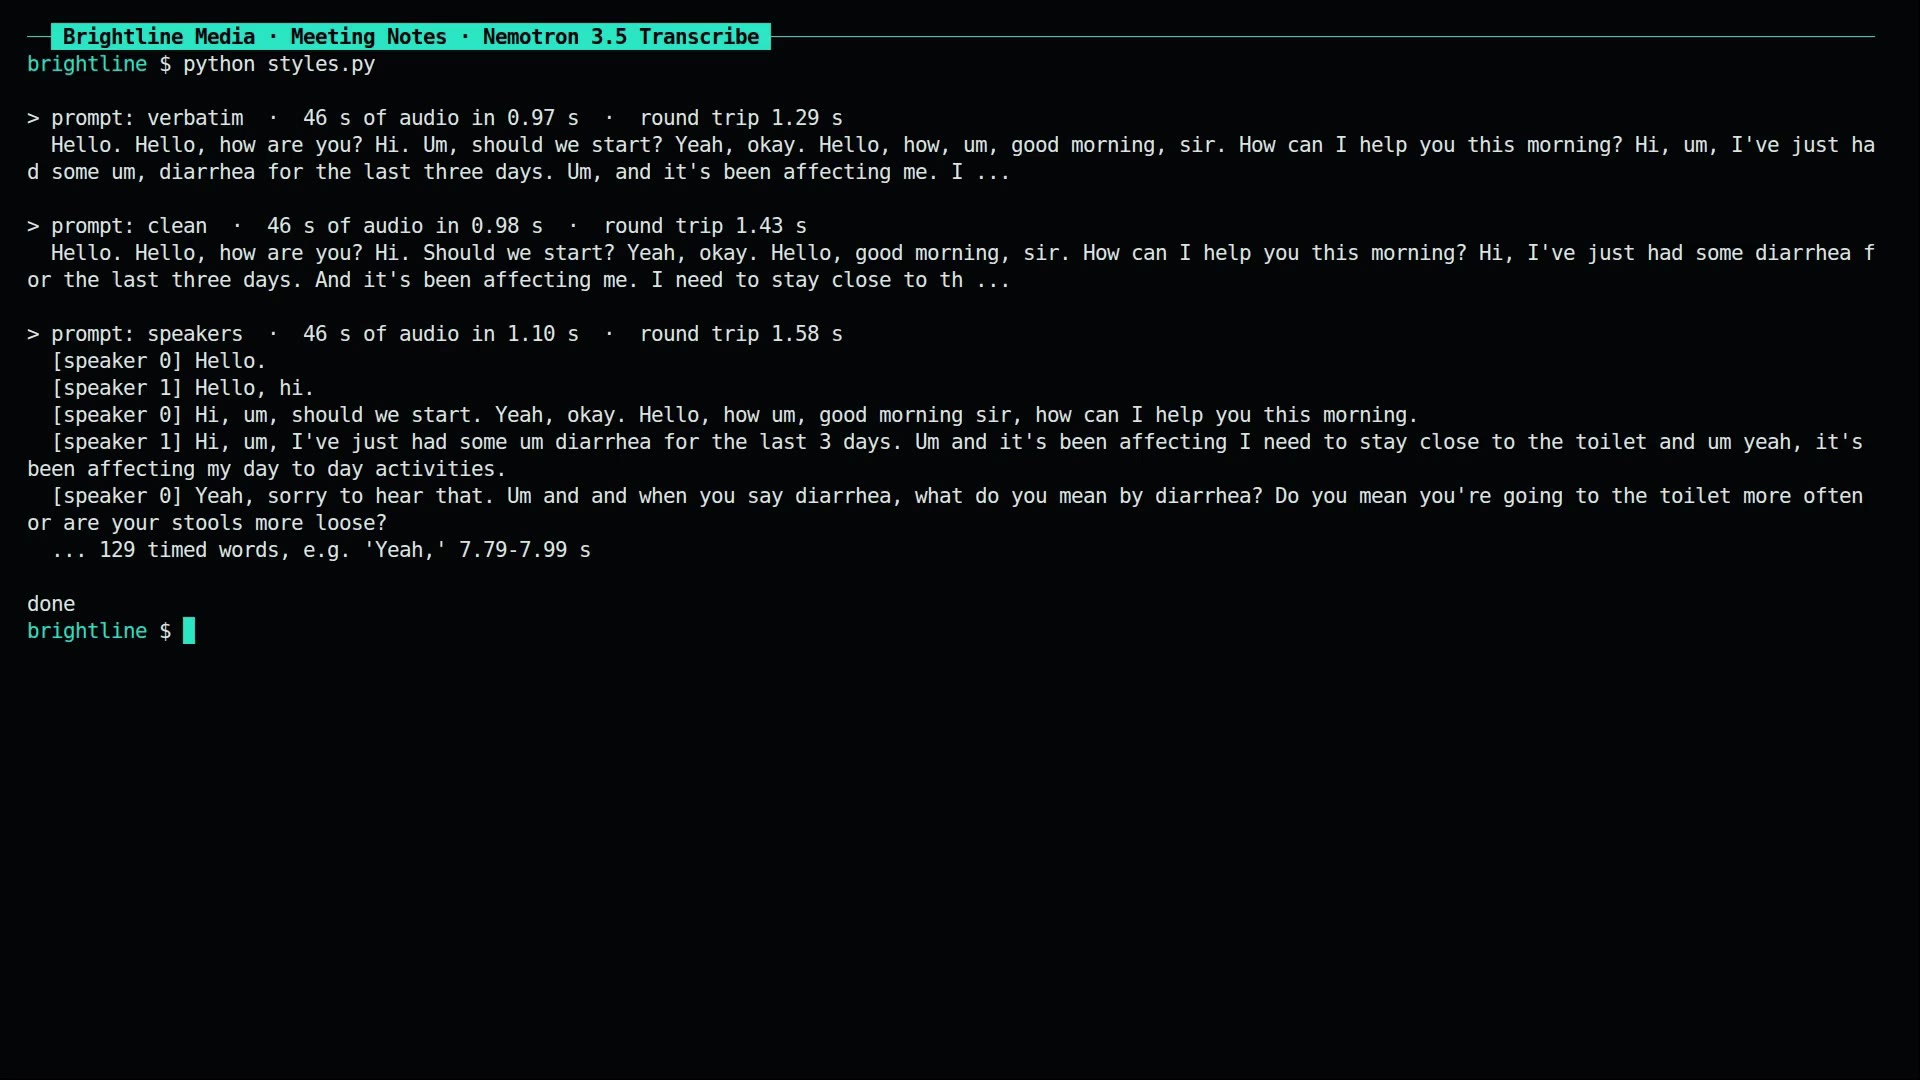
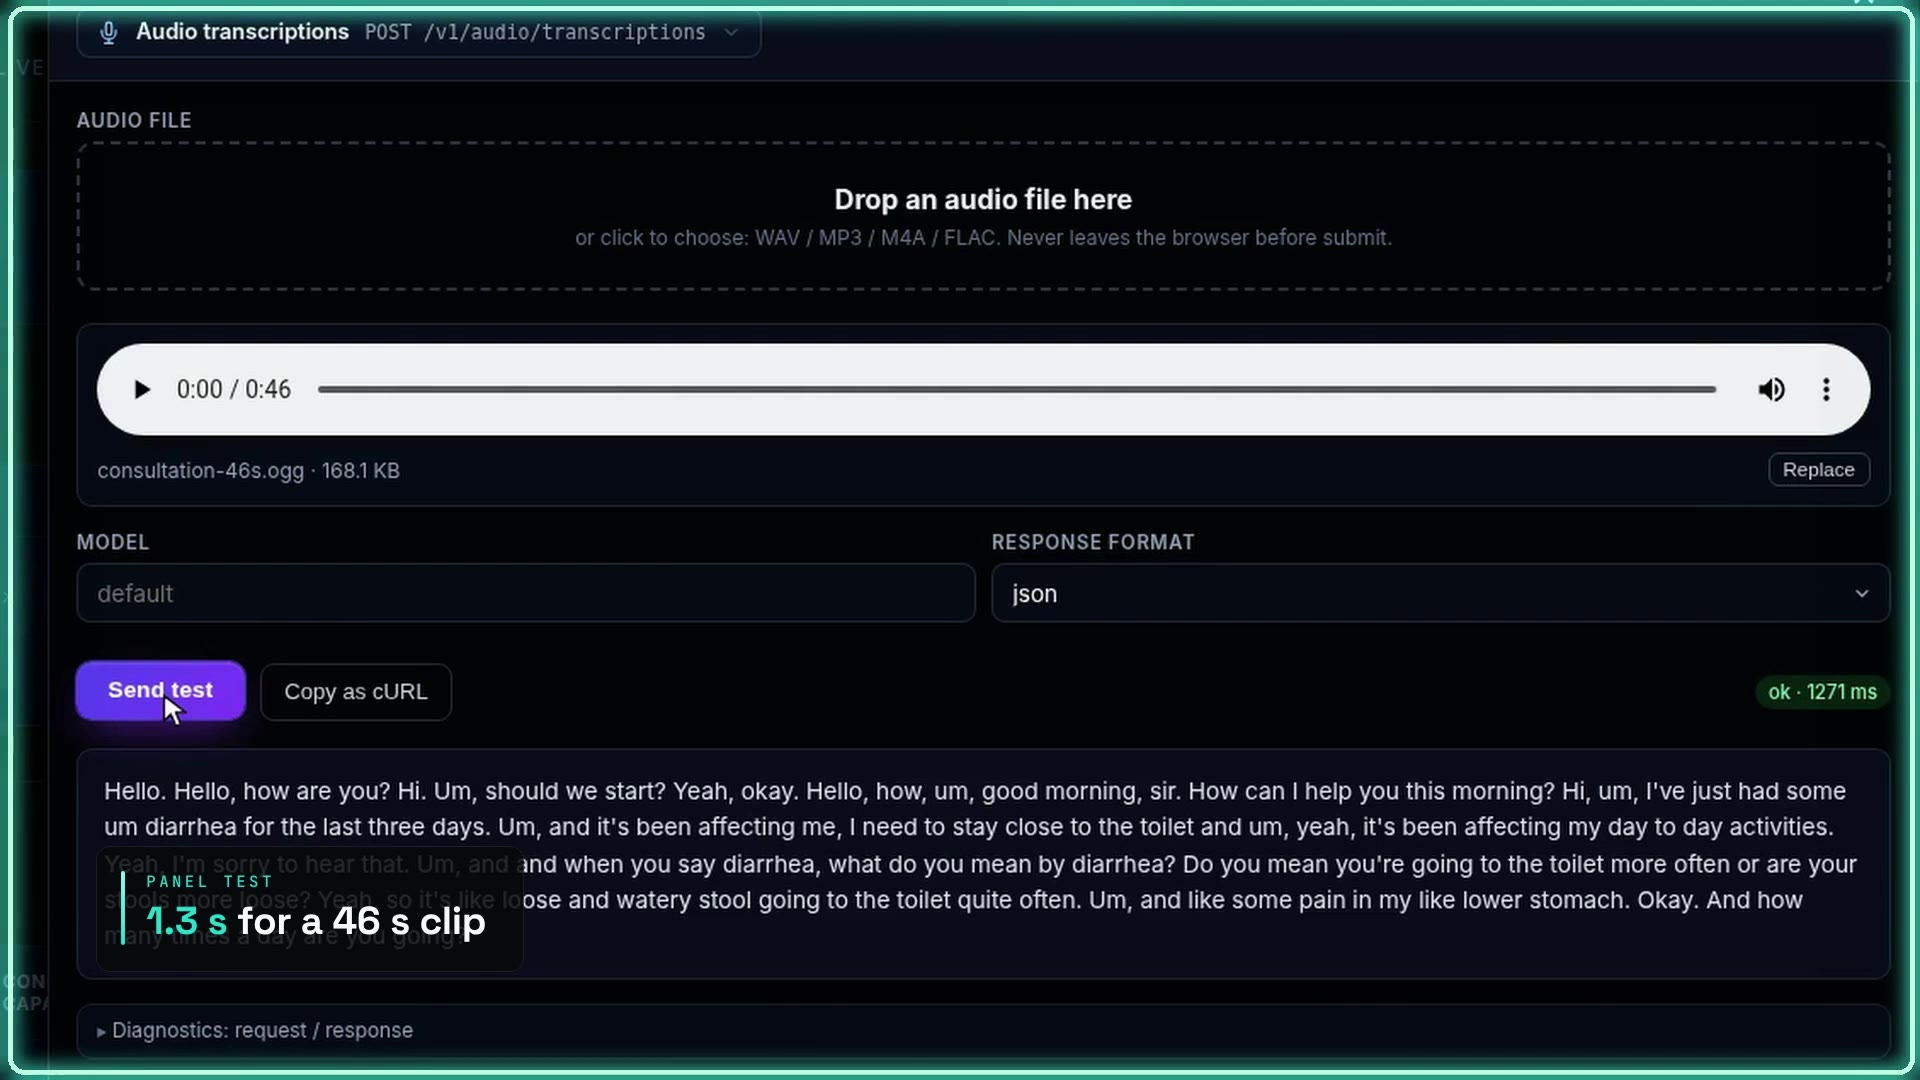
Kurzer Clip, 46 s Konsultation: Panel-Tester ok · 1271 ms; im Terminal verbatim 0,97 s GPU / 1,29 s Round Trip, clean 0,98 / 1,43 s, speakers 1,10 / 1,58 s (129 Wörter mit Zeitangabe).
Zeit bis bereit:
| Start | Zeit |
|---|---|
| Erste Maschine, kalt, von Hand | Umgebung 84 s, Gewichte 21,6 GB in ~18 s, vLLM-Engine-Init 255 s (FlashInfer-JIT-Builds), insgesamt etwa 6 min |
Warmer Neustart über ensure() | 88 s |
| Zweite Maschine, kalt, Backend 0.1.4 (eager, ohne MTP) | 217 s (Umgebung 53,4 s, Gewichte 39,0 s) |
| Erste Anfrage nach dem Start | 12,30 s für einen 9-s-Clip (Kernel-Warm-up); zweite 0,393 s |
GPU-Speicher auf 32 GB: Laden des Modells 20,7 GiB (19,41 GiB ohne MTP-Head), KV-Cache 4,78 GiB = 1.066.780 Tokens (16,28x Concurrency bei 65.536), CUDA Graphs 0,21 GiB. Karte nach dem Start im Leerlauf bei 28.146 MiB, Spitze 30.254 MiB während des Plattformlaufs (31.442 MiB im direkten Harness).
VRAM-Stufen
| GPU oder Grenze | Konfiguration | VRAM-Spitze | Zeiten | Ausgabe OK | Echt |
|---|---|---|---|---|---|
| RTX PRO 4500 Blackwell 32 GB | util 0,92, len 65.536, 8 seqs, MTP 8, CUDA Graphs | 30.254 MiB Karte | 3 min speakers 4,401 s; 5 min 4,818 s; 40 Clips 12,956 s | ja | echt |
| Grenze 22,6 GiB auf der 32-GB-Karte | util 0,72, len 32.768, 4 seqs, MTP 8, Graphs | - | - | nein: ValueError: No available memory for the cache blocks | emuliert |
| Grenze 23,5 GiB auf der 32-GB-Karte | util 0,75, eager, ohne MTP, len 16.384, 2 seqs | 25.712 MiB Karte | 3 min 46,203 s; 5 min 44,088 s; 40 Clips 63,441 s | lief, aber über 24 GB; 9,42 %, weil gigaspeech-06 leer zurückkam | emuliert |
| 24-GB-MIG-Slice (RTX PRO 6000 Blackwell 1g.24gb) | util 0,93, eager, ohne MTP, len 16.384, 2 seqs | Gewichte 19,41 GiB + KV 1,4 GiB (221.184 Tokens), aus den vLLM-Logs | 3 min speakers 35,34 s; 5 min 31,733 s; 40 Clips 53,23 s | ja: 6,82 % (identisch), Konsultation 13,76 %, lange Datei 15,65 % | echt |
| derselbe MIG-Slice | util 0,95, MTP 8, CUDA Graphs, len 16.384 | - | - | nein: RuntimeError: NVML_SUCCESS == r INTERNAL ASSERT FAILED at CUDACachingAllocator.cpp:1407 nach dem Laden des MTP-Heads (Speicher voll) | echt |
Die emulierten Zeilen lehren eins: Eine Software-Grenze mit --gpu-memory-utilization ist keine 24-GB-Karte (bei 0,75, einem Budget von 23,5 GiB, belegte die Karte 25.712 MiB). Nur der echte Slice zählt als Beleg für 24 GB.
Verlangsamung auf dem Slice: 4,1x bei kurzen Clips (GPU-Zeit), 6,6x bei der 5-Minuten-Datei, 8,0x beim 3-minütigen speakers-Lauf. Der 1g-Slice hat ein Viertel der SMs der PRO 6000. nvidia-smi kann den MIG-Speicher nicht auslesen, der VRAM dort stammt also aus dem Log von vLLM. Es gibt keine GeForce-Blackwell-Karte mit 24 GB, und NVFP4 läuft nicht auf Ada (RTX 4090) oder älter. Nicht ausprobiert: 16 GB, 24 GB mit MTP, aber ohne Graphs, FP8 auf 48 GB, DFlash2, Concurrency.
Beispielausgaben
- Konsultation,
speakers+ Wort-Zeitstempel, 4,401 s: "spk:0 Hello. spk:1 Hello, how are you? spk:0 Hi, um, should we start? Yeah, okay. Hello, um, good morning, sir. How can I help you this morning? spk:1 Hi, um, I've just had some um diarrhea for the last three days. ..." Erste Wörter:Hello.2,94 bis 3,25 s Sprecher 0;Hello,3,919 bis 3,97 s Sprecher 1. - earnings22-01 (9,3 s), verbatim, 0,381 s: "Can you, uh, yeah, just perhaps give us an update on on how things have progressed there, and um, you know, how how we're tracking relative to perhaps where where you where you were last quarter? Thank you."
Demovideo
Ein kommentierter Rundgang von 183 Sekunden: der Panel-Tester auf einem 46-Sekunden-Clip, die drei Prompts in einem Terminal, der zentrale Vergleich und die 24-GB-Stufen.
Probleme und Status
- Upload-Grenze von 2 MiB auf
/v1/audio/transcriptions(Plattform, offen). Etwa 8 Minuten Opus mit 32 kbps. Die wichtigste Grenze für dieses Modell auf der Plattform. - FlashInfer-JIT-Build in einem 62-GB-Container abgeschossen (im Backend behoben).
fp4_gemm_cutlass_sm120scheiterte mitFAILED: [code=137] ... KilledundRuntimeError: Ninja build failed: ninja ließ etwa 18 nvcc parallel laufen. Behoben mit den vorgebauten Kerneln undMAX_JOBS=6. Dasflashinfer_jit_cache-Wheel aus dem GitHub-Release ist ein 16-KB-Stub. Du brauchst das Provider-Paket pro Architektur plus das Paket auf oberster Ebene; ohne Letzteres kamAttributeError ... __version__, behoben in 0.1.4. - Verwaister vLLM-Kindprozess nach einem Delete (Plattform, umgangen). Der Worker stoppt eigene Backends mit SIGKILL, also überlebte
vllm servemit PPID 1 und hielt 25 bis 29 GB, und der nächste Start scheiterte mitFree memory on device cuda:0 (2.8/31.37 GiB).... Im Backend behoben mitPR_SET_PDEATHSIGund einer veralteten pid-Datei. Plattform-Fix, noch als Ticket anzulegen: SIGTERM mit Schonfrist, dann die Prozessgruppe beenden. - Retry des Worker-Watchdogs kollidiert mit einem Delete (Plattform, klein, offen).
cleanfügt nicht verlangte Sprecher-Tags ein (Modellverhalten): 50 in 3 Minuten, plus ein stehen gebliebener Fehlstart.- Leere Antwort auf gigaspeech-06 nur in der emulierten 23,5-GiB-Stufe (1 Token,
finish_reason: stop). Auf 32 GB und auf dem Slice in Ordnung. Nicht untersucht. - Emulierte Grenzen zählen zu wenig: bei util 0,75 (Budget 23,5 GiB) belegte die Karte 25.712 MiB, also ist nur der echte Slice ein Beleg für 24 GB.
Grenzen dieses Tests
924 Wörter in Clips, eine Datei mit 3 und eine mit 5 Minuten, Greedy Decoding, eine Anfrage nach der anderen. Keine Messung von Durchsatz oder Concurrency, also keine Prüfung der Angabe von 2.238 s/s oder der Aussage "roughly two times slower". NVIDIAs Benchmarks sind BF16 und wurden nicht nachgemessen. Nichts gemessen auf einer RTX 5090, einer vollständigen Blackwell-Karte mit 24 GB, dem FP8-Checkpoint, DFlash2 oder in anderen Sprachen (Übersetzungsausgabe nicht bewertet).
Benchmarks der Autoren (BF16, erfasst am 12. Okt. 2026, nicht nachgemessen)
| Benchmark | Nemotron 3.5 Transcribe | Vergleich |
|---|---|---|
| English Open ASR, 9 Sets, mittlere WER | 4,71 | Qwen3-ASR-1.7B 4,94 |
| Long-form-WER | 10,98 | Parakeet-TDT-0.6B-v3 13,37 |
| Mehrsprachig, 7 Sprachen | 4,62 | Qwen3-ASR-1.7B 6,49 |
| Mehrere Sprecher, mittlere cpWER (AMI, CALLHOME, Mixer 6, NOTSOFAR-1) | 15,80 | DiCoW v3.3 + DiariZen 16,83 |
| Preference-ASR, Standard / instruiert | 7,56 / 6,16 | Canary-Qwen 8,16 / 8,36 |
RTFx laut Card auf einer H100 BF16 unter abgestimmter Batch-Last: MTP2 410, MTP8 270, DFlash2 K=7 340, DFlash2 K=15 260.
Quellen
- Model Cards: BF16, NVFP4, FP8, DFlash2
- Lizenz: OpenMDW-1.1
- NeMo Speech (vLLM-Plugin in
nemo/collections/speechlm2/vllm/salm) - SGLang-Omni und sein Nemotron-Transcribe-Cookbook
- PriMock57, Daten des Open ASR Leaderboard
- Unser früherer Test: Underdog Bark 3.0 Pro gegen Qwen3-ASR-1.7B
- Wo es uns aufgefallen ist: News-Video von AI Search, 1. November 2026
- SDK-Beispiel