Nemotron 3.5 Transcribe en una tarjeta de 32 GB: el prompt elige la transcripción, 3 minutos en 4,4 segundos
El modelo de voz abierto de NVIDIA transcribió 3 minutos de dos hablantes, con tiempos y quién habla, en 4,4 s en una Blackwell de 32 GB. Con 24 GB, más lento.
Pide a Nemotron 3.5 Transcribe etiquetas de hablante. Una consulta médica de tres minutos vuelve en 4,4 segundos de tiempo de GPU, separada en médico y paciente, con hora de inicio y de fin en cada una de sus 561 palabras. Pide una transcripción limpia y el mismo modelo quita los "um".
Ejecutamos el nuevo modelo de voz abierto de NVIDIA en una tarjeta gráfica Blackwell de 32 GB, con el software de código abierto que publica NVIDIA. Para quien tiene sus propias GPU, significa que un solo despliegue devuelve la transcripción que necesita cada equipo, elegida en cada petición. En 40 clips de prueba estándar falló el 6,82 % de las palabras, en la misma franja que los modelos con los que lo comparamos. Una porción de 24 GB de una tarjeta Blackwell más grande también lo ejecutó, entre cuatro y ocho veces más lento. Nuestro ejemplo del SDK lo despliega en tu propia GPU Blackwell.
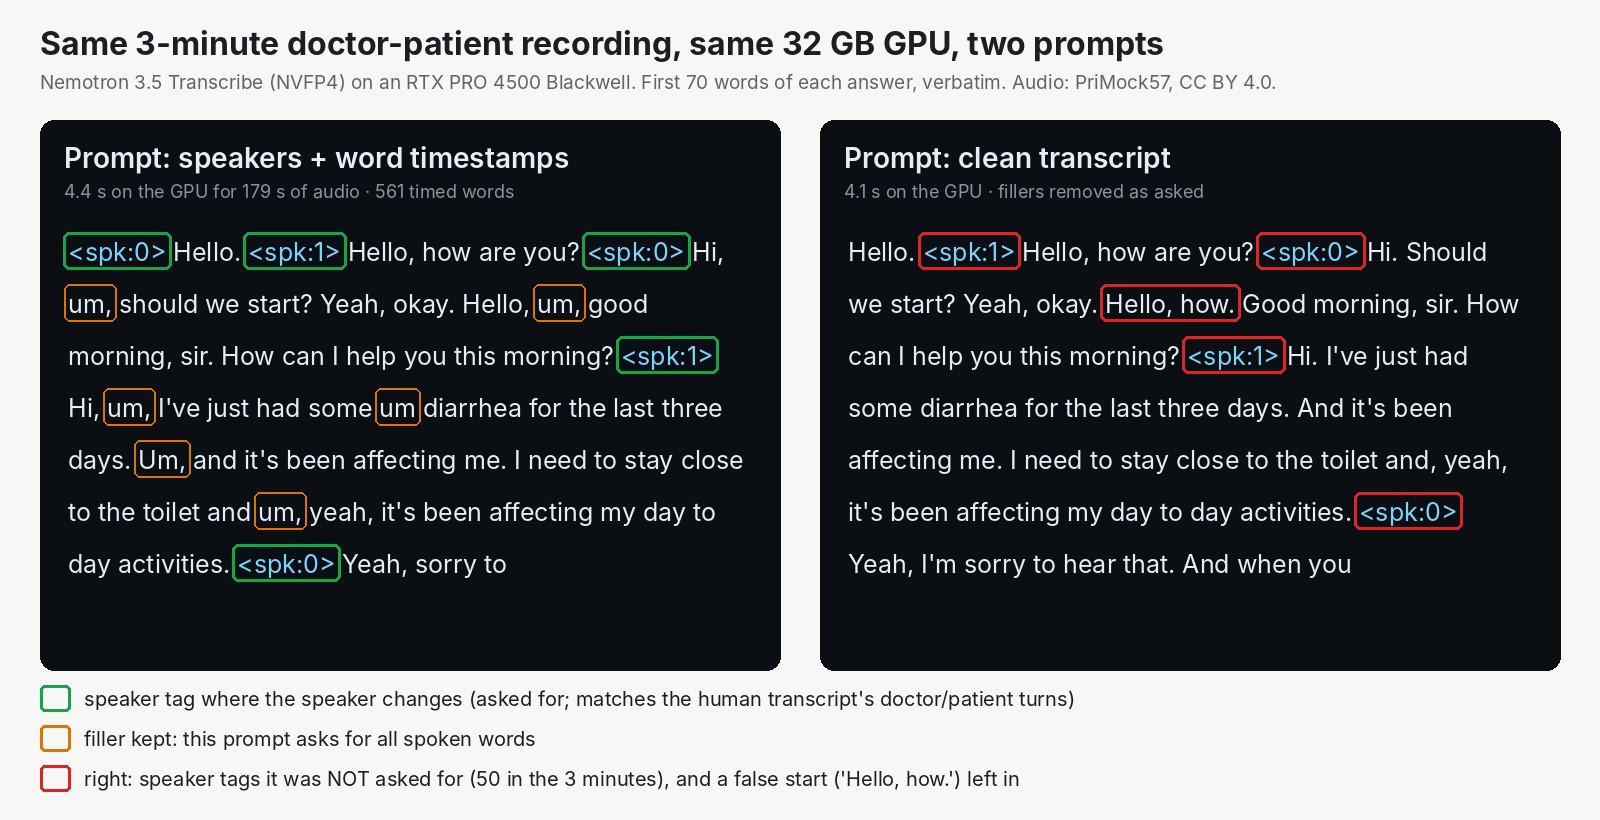
Misma grabación, misma tarjeta, dos prompts. La versión limpia de la derecha añade etiquetas de hablante que nadie pidió.
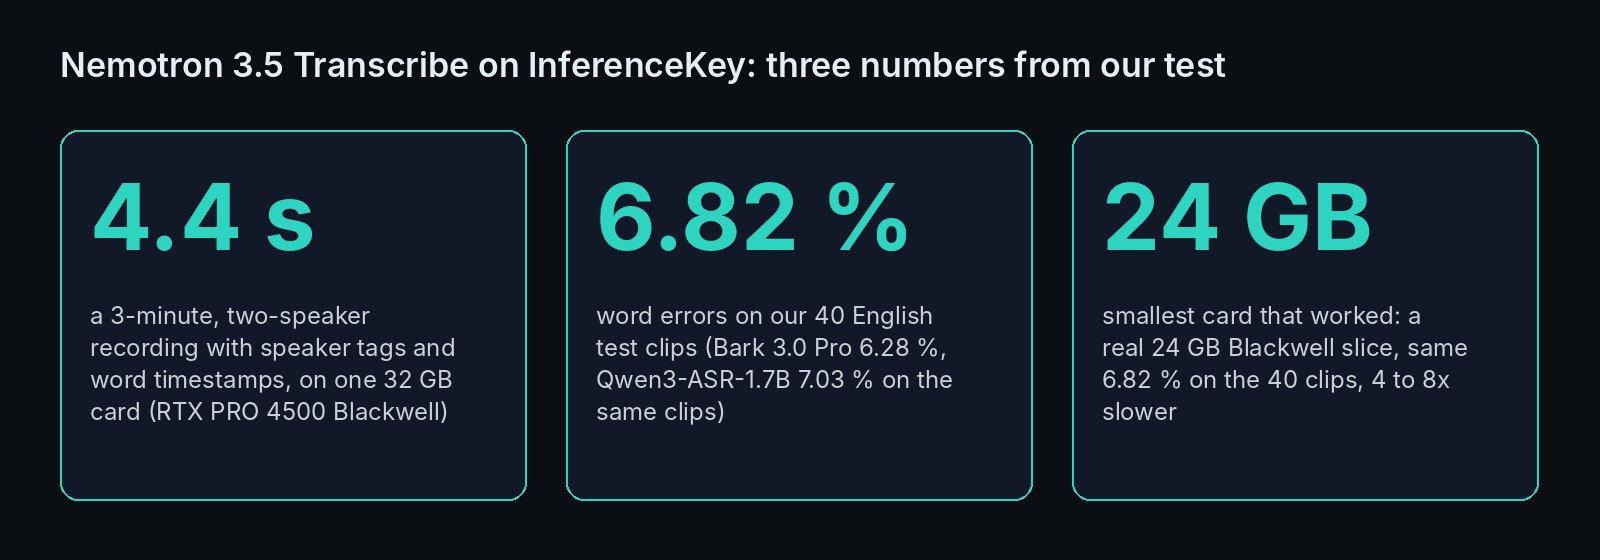
Un solo modelo, y la instrucción decide qué transcripción recibes
Nemotron 3.5 Transcribe funciona más bien como un modelo de chat que escucha. Le mandas el audio y una frase de instrucción, y la instrucción elige la transcripción.
La página del modelo de NVIDIA enumera lo que puede pedir esa frase. Palabra por palabra, con cada muletilla. Limpia para leer. Etiquetada por hablante, con un tiempo para cada palabra. Traducida. También puede decir el idioma o responder a una pregunta sobre el audio. Cubre 40 idiomas y grabaciones de hasta una hora.
Para un equipo, es la diferencia entre mantener tres sistemas y mantener uno. Quien redacta informes médicos quiere la versión limpia, un equipo de cumplimiento normativo quiere cada "um" y una herramienta de reuniones quiere saber quién dijo qué. Sin esto, las etiquetas de hablante y la limpieza son pasos aparte que añades tú. Aquí se parece más a un estudio que graba una sola toma y la mezcla distinta para cada oyente: una copia cargada, una frase distinta en cada petición.
El modelo es grande para ser de voz. Tiene 34B parámetros en total, pero solo unos 4,3B trabajan en cada trozo de audio. Imagina un equipo grande de especialistas en el que cada palabra consulta a unos pocos mientras el resto espera. Por eso va rápido para su tamaño.
NVIDIA lo publicó el 28 de octubre en tres tamaños de fichero: 67,5 GB, 34,7 GB y 21,6 GB. El fichero más pequeño solo funciona en la generación más nueva de tarjetas de NVIDIA, Blackwell. NVIDIA dice que es casi igual de preciso: un 3,6 % más de errores que la versión más grande.
La licencia es OpenMDW-1.1. Permite usar, modificar y compartir el modelo sin restricciones, manteniendo el aviso. No pone condiciones a lo que hagas con las transcripciones. La página de NVIDIA dice claramente que se permite el uso comercial.
NVIDIA construyó el modelo y su receta abierta para servirlo, y proyectos de código abierto construyeron el motor sobre el que funciona. Lo vimos en el vídeo de noticias de AI Search del 1 de noviembre. Nosotros lo empaquetamos, lo ejecutamos en tarjetas que un equipo puede alquilar y contamos los errores. El apéndice reconoce el mérito de cada uno por su nombre.
Las cifras de NVIDIA son buenas, y la más rápida todavía no es abierta
En las pruebas de la propia NVIDIA, el modelo va por delante de los modelos de voz abiertos con los que se compara. En nueve conjuntos de prueba estándar en inglés falla de media el 4,71 % de las palabras, frente al 4,94 % de Qwen3-ASR-1.7B. En otros siete idiomas saca un 4,62 % frente al 6,49 % del mismo modelo de Qwen. Cuando la gente habla a la vez, falla o atribuye al hablante equivocado unas 16 palabras de cada 100 (15,80), frente a 16,83 de la comparación más fuerte que cita NVIDIA. Son ejecuciones de NVIDIA con la versión más grande, recogidas el 12 de octubre. No las reprodujimos.
La cifra de velocidad pide una lectura más atenta. La página de NVIDIA dice que una RTX PRO 6000 Blackwell de 96 GB transcribe hasta 2.238 segundos de audio (unos 37 minutos) por cada segundo. La página añade que esa cifra sale del motor empaquetado de la propia NVIDIA. Esas optimizaciones "are not yet part of the open-source release". La versión abierta publicada el día del lanzamiento "is expected to be roughly two times slower". Nosotros usamos la versión abierta, así que nuestras cifras salen de ese camino más lento.
Un límite más, también de la página de NVIDIA: es un modelo offline. Le das una grabación terminada y te devuelve una transcripción. No subtitula una llamada en directo mientras la gente habla.
La prueba: una RTX PRO 4500 Blackwell de 32 GB y el software abierto
¿Qué te da una tarjeta Blackwell de 32 GB con el software que cualquiera puede descargar? La página de NVIDIA cita la RTX 5090, una tarjeta para juegos de 32 GB, como compatible con el fichero pequeño. Ese día no había ninguna RTX 5090 disponible en nuestra nube. Usamos una RTX PRO 4500 Blackwell, una tarjeta de estación de trabajo con los mismos 32 GB y la misma generación de chip. Su memoria es más o menos la mitad de rápida que la de una 5090. No medimos una 5090.
Le dimos tres tipos de audio:
- los tres primeros minutos de una consulta de PriMock57, una visita médica simulada entre médico y paciente con transcripción humana
- cinco minutos de audio de conferencias de resultados, unidos a partir de 33 segmentos de un conjunto de prueba público
- los mismos 40 clips cortos en inglés de un benchmark público de reconocimiento de voz que usamos la semana pasada para comparar Underdog Bark y Qwen3-ASR.
Eso da una comparación directa con dos modelos que ya conocemos. Uno de ellos, Qwen3-ASR, es el modelo de voz que ya usamos para nuestras propias transcripciones. La muestra es pequeña: 924 palabras en clips, un fichero de tres minutos y otro de cinco, una petición cada vez.
Tres minutos de consulta médica en 4,4 segundos, con quién dijo qué y cuándo
Cada prompt de la tabla tardó menos de cinco segundos de GPU para tres minutos de audio, unas cuarenta veces más rápido de lo que dura la grabación.
| Prompt | Tiempo de GPU para 3 minutos | Qué devolvió |
|---|---|---|
| verbatim | 4,1 s | 11,74 % de errores por palabra frente a la transcripción humana, 33 de los 34 "um" y "uh" conservados |
| clean | 4,1 s | todas las muletillas eliminadas (ver más abajo) |
| speakers + marcas de tiempo por palabra | 4,4 s | turnos de médico y paciente, 561 palabras con hora de inicio y de fin |
Verbatim conservó las vacilaciones que necesita un equipo de cumplimiento normativo, y speakers separó los turnos. Los turnos coinciden con la referencia humana cuando las lees una al lado de la otra, pero lo comprobamos a ojo: puntuamos las palabras, no las etiquetas de hablante. Un cuarto prompt, "translate to Spanish", volvió en español tras 4,9 segundos de GPU. No lo puntuamos.
El fichero de cinco minutos de conferencias de resultados tardó 4,8 segundos de GPU, en una sola petición. Falló el 16,11 % de las palabras, pero la referencia unida tiene huecos donde se juntan los segmentos, así que solo cuenta la comparación: Bark sacó un 18,69 % en el mismo fichero en la prueba de la semana pasada, y Qwen3-ASR, con el montaje de la semana pasada, se paró a mitad.
En los 40 clips cortos, la cifra de precisión que sirve para comparar modelos, falló el 6,82 %. Bark 3.0 Pro sacó un 6,28 % y Qwen3-ASR-1.7B un 7,03 % en los mismos clips, puntuados igual. Así que Nemotron queda entre los dos, más cerca de Qwen. Esos dos funcionaron en otra tarjeta en la prueba de la semana pasada, así que las tasas de error se pueden comparar y las velocidades no.
Dónde falla: el prompt limpio etiqueta de más, y las reuniones son su peor conjunto
El prompt limpio es el que hay que probar antes de fiarse. Nuestra instrucción clean dice "omit fillers and accidental repetitions; keep the remaining spoken wording unchanged" y acaba con "Output: transcript only". No pide etiquetas. El modelo quitó todas las muletillas y además añadió 50 etiquetas de hablante en tres minutos. Dejó un arranque en falso, "Hello, how.", que un lector esperaría ver eliminado. Si tu flujo espera prosa sin más, quita las etiquetas o usa a propósito el prompt de hablantes.
En los 40 clips fue el mejor de los tres con voz de audiolibro: 0,94 % de fallos, frente al 1,88 % de Qwen3-ASR y el 2,35 % de Bark. AMI, reuniones de oficina grabadas con gente hablando a la vez, fue su peor conjunto con un 14,62 %, por detrás de Bark (11,54 %) y por delante de Qwen3-ASR (16,92 %). Una herramienta de reuniones debería probar con sus propias grabaciones antes de cambiar.
Qué GPU: una porción real de 24 GB funcionó, entre cuatro y ocho veces más lenta
El hardware más pequeño que funcionó fue una porción real de 24 GB de una tarjeta Blackwell. La tarjeta de 32 GB es la opción rápida, no el mínimo.
Esa porción sale de una RTX PRO 6000 Blackwell, una tarjeta de 96 GB que se puede dividir en trozos aislados. Cada trozo recibe 24 GB de memoria y la cuarta parte del cómputo de la tarjeta. En ella, la ejecución de tres minutos con hablantes tardó 35,3 segundos en lugar de 4,4. Es ocho veces más lento, y aun así unas cinco veces más rápido de lo que dura la grabación. Los clips cortos fueron unas cuatro veces más lentos, y el fichero de cinco minutos unas siete.
Los dos montajes que funcionaron:
| Hardware | Ajustes | Resultado |
|---|---|---|
| RTX PRO 4500 Blackwell, 32 GB | ajustes más rápidos | funciona, las cifras de arriba, unos 30 GB en uso en el pico |
| Porción Blackwell de 24 GB | ajustes más lentos, grabaciones más cortas, 2 peticiones a la vez | funciona |
En su modo rápido el modelo no entró en la porción de 24 GB. No probamos una tarjeta Blackwell completa de 24 GB, 16 GB, el fichero mediano en una tarjeta de 48 GB ni muchas peticiones a la vez.
En InferenceKey: una copia cargada responde a todos los estilos
Una sola copia en marcha en una tarjeta alquilada respondió a los cuatro estilos en la misma dirección, así que un estilo de transcripción nuevo cuesta una frase, no otro despliegue. A través de la plataforma, un reinicio estuvo listo en 88 segundos. Una máquina nueva estuvo lista en 217 segundos. Nuestro primerísimo arranque tardó unos seis minutos mientras se compilaba código de GPU que solo se compila una vez.
Hizo falta un backend propio, un fichero corto de Python que le dice a nuestra plataforma cómo instalar y ejecutar un modelo en cada máquina con GPU. Nuestra opción integrada instala solo el motor de servicio y no puede añadir el complemento de voz de NVIDIA, así que nuestro fichero construye los dos a partir de la receta de NVIDIA. Nuestro backend expone la ruta de voz estándar de OpenAI, /v1/audio/transcriptions. Nuestro despliegue de Qwen3-ASR responde en la misma ruta, así que la petición que un equipo ya envía mantiene su forma. Lo nuevo es el campo prompt.
Hay un límite con el que vas a toparte y que sigue abierto. Nuestra dirección de transcripción admite ficheros de hasta 2 MB, unos ocho minutos de voz comprimida. El modelo admite una hora de audio, así que de momento corta las grabaciones más largas o comprímelas mucho. Cada petición separa los hablantes por su cuenta, así que las etiquetas de hablante pueden no mantenerse entre trozos; no probamos grabaciones partidas.
¿Merece la pena usarlo? Sí para varios estilos de transcripción desde una tarjeta Blackwell
- Necesitas transcripciones distintas para equipos distintos. Un solo despliegue da texto literal, limpio, con etiquetas de hablante y traducido. Revisa la salida limpia por si trae etiquetas sueltas.
- Necesitas la menor tasa de error en clips en inglés. Está en la misma franja que Bark 3.0 Pro y Qwen3-ASR-1.7B en nuestra muestra, no por delante. Lo que gana es poder elegir la salida, no precisión pura.
- Tienes una tarjeta Blackwell de 32 GB. Va rápido. Una porción Blackwell de 24 GB también funciona, más lenta.
- Usas RTX 4090 o tarjetas más antiguas. El fichero pequeño no funcionará, necesita Blackwell. NVIDIA cita el fichero mediano en una L40S de 48 GB.
- Necesitas subtítulos en directo. Este modelo no, es solo offline.
Sigue el ejemplo del SDK de Nemotron 3.5 Transcribe para sacar las tres transcripciones de tu propia grabación en tu propia GPU Blackwell. Rellena .env, ejecuta python publish.py una vez y después python main.py. Necesita una tarjeta de 32 GB para los valores por defecto, unos 50 GB de disco y un fichero de audio de menos de 2 MB.
Para ingenieros
Créditos
- NVIDIA: el modelo, el plugin de vLLM de NeMo Speech (
nemo_speechlm, Apache-2.0), la receta para servirlo y los benchmarks. - Proyecto vLLM: el motor de servicio (0.32.0) sobre el que funciona el camino abierto.
- Equipo de FlashInfer: los kernels sm120 precompilados (
flashinfer-jit-cache,flashinfer-jit-cache-sm120f) de flashinfer.ai. - SGLang-Omni (sgl-project/sglang-omni, Apache-2.0): el camino alternativo para servirlo, versión v0.2.0 del 2026-10-27.
- Babylon Health: PriMock57 (CC BY 4.0), las grabaciones entre médico y paciente. Nuestro corte de 3 minutos de
day1_consultation01salió de los datos de demo del Hugging Face Space de NVIDIA. - hf-audio: los datos de prueba del Open ASR Leaderboard de los que salen los 40 clips.
- AI Search: donde lo vimos (vídeo, capítulo en 32:04).
- InferenceKey: el backend propio, el despliegue, las mediciones y el ejemplo del SDK.
Modelo y ficheros
| Modelo | Codificador de voz y codificador de hablantes delante del modelo de lenguaje Nemotron 3.5 Lightning: LM MoE híbrido Mamba-2/Transformer (Nemotron 3.5 Lightning 30B-A3B: Mamba-2 x23, MoE x23, atención x6, 128 expertos top-6) + Parallel Expert Encoder (transformer ASR de 600M, codificador de hablantes Sortformer de ~99M) + cabezas de marcas de tiempo CTC de 47M. 34B en total, ~4,3B activos incluido el codificador de audio. Contexto de 65.536 tokens |
| Decodificación especulativa | cabeza MTP nativa; borrador DFlash2 opcional (1,14 GB, sin marcas de tiempo por palabra con él) |
| Checkpoints (API de HF, suma de ficheros; la ficha no da tamaños) | BF16 67,52 GB; FP8 34,69 GB; NVFP4 21,58 GB |
| Usado | NVFP4 sha 66c6adc4020179567074d0399cda2a4eeb2bb347: 2 shards NVFP4 de 9,99 + 9,19 GB, percepción 0,84 GB, MTP FP8 1,34 GB, CTC BF16 0,20 GB. Exportación mixta de ModelOpt (decodificador NVFP4, capas Mamba FP8, codificador de audio FP8, cabeza MTP FP8); solo Blackwell; --kv-cache-dtype fp8; los kernels cuantizados necesitan nvcc de CUDA 13 |
| Coste de calidad según la ficha | NVFP4 un 3,6 % más de error que BF16 (relativo), FP8 un 1,0 % |
| Publicación | 28/10/2026 en build.nvidia.com, GitHub, Hugging Face y NGC; lastModified de HF 2026-10-29T23:04Z |
| Licencia | OpenMDW-1.1 |
Qué dice la ficha sobre el hardware
La tabla de compatibilidad de la ficha no tiene tamaños de memoria. Enumera: A100 80GB SXM (BF16); B200, GB200, GB300, DGX Spark, Jetson Thor (BF16, FP8, NVFP4); RTX 5090 (NVFP4, con vLLM 0.32.0, Transformers, GGML); RTX PRO 6000 Blackwell Server Edition (BF16, FP8, NVFP4; también SGLang-Omni 0.2.0); H100 (BF16, FP8; también SGLang-Omni); H200 (BF16, FP8); L40S PCIe 48GB (FP8). Las filas de "Deployment": ficha BF16 "1x H100 80 GB"; fichas NVFP4 y FP8 "1x RTX PRO 6000 Blackwell (96 GB)". La RTX 5090 y la L40S solo aparecen como filas de compatibilidad.
Caminos para servirlo y endpoints
- vLLM 0.32.0 + plugin de NeMo Speech (lo que usamos). La ficha documenta
/v1/chat/completions(audio_urlen base64 + prompt de texto); las marcas de tiempo por palabra vuelven en un objetoctc_timestampsde primer nivel (wordscon start/end/speaker,diarization,speaker_tag_to_diarization_speaker,error). Las peticiones con marcas de tiempo admiten una grabación,stream=false,n=1. Nuestro backend propio envuelve esto y expone la ruta/v1/audio/transcriptionsde OpenAI en la plataforma. - SGLang-Omni 0.2.0 (fija SGLang 0.5.22). Sirve transcripción de fichero completo en
/v1/audio/transcriptions, una GPU, solo BF16 o FP8 (validado en una H100 80 GB y una RTX PRO 6000 Blackwell), sin necesidad de NeMo. Según la ficha, "word timestamps, speaker-attributed output, translation and speculative decoding are not part of this integration". El cookbook ofrece deltas de texto constream=truedespués de codificar toda la subida, lo cual no es streaming en directo. Da un RTFx de 23,40 con concurrencia 1 y de 102,17 con 16 en una H100 BF16 con clips cortos. - NIM: el vLLM optimizado detrás de la cifra de 2.238 s/s (NVFP4 + DFlash2 en una RTX PRO 6000 Blackwell Server Edition). Todavía no es de código abierto.
Montaje
| GPU principal | RTX PRO 4500 Blackwell 32 GB (32.623 MiB, GB203, sm_120), límite de 200 W, driver 595.91.07 (CUDA 13.2), nvcc 13.0.88, contenedor con 62 GB de RAM / 10,2 CPU, 100 GB de disco |
| Por qué no una 5090 | No había RTX 5090 disponible en nuestra nube cuando hicimos la prueba. La PRO 4500 tiene los mismos 32 GB y sm_120, más o menos la mitad del ancho de banda de memoria de una 5090, y funcionó con un límite de 200 W. No medido en una 5090 |
| GPU de la escalera | RTX PRO 6000 Blackwell Server Edition, porción MIG 1g.24gb |
| Stack | manager local de InferenceKey (nunca producción), backend propio nemotron-transcribe 0.1.4 |
| Backend | descarga NeMo Speech en e5d79d5a49cbec49d79440b0070aac0c32a8dbb8; uv venv --python 3.13; uv sync --extra asr --extra vllm --locked --no-install-project; -e .; av==19.0.2, opencv-python-headless==5.0.0.93; kernels precompilados de FlashInfer 0.7.0.post1+cu130; MAX_JOBS=6; snapshot_download de la revisión fijada |
vllm serve | VLLM_PLUGINS=nemo_speechlm; caché KV fp8, --use-replayssm, --mamba-backend flashinfer, middleware de marcas de tiempo CTC, --reasoning-parser nemotron_v3, MTP 8; util 0,92, --max-model-len 65536, 8 secuencias; un audio por prompt de hasta 57.600.000 muestras; calentamiento con 2 s de silencio. La receta de los autores apunta a una H100 80 GB (util 0,94, 192 secuencias) |
| Peticiones | multipart file, prompt (nombre de estilo verbatim, clean, speakers, nearfield, translate, o texto libre), timestamp_granularities[]=word; temperatura 0, thinking desactivado |
| Texto de estilo enviado | verbatim: "Audio transcription. Language: as spoken. Wording: verbatim, including fillers and repetitions. Formatting: punctuation and capitalization. Output: transcript only." clean: "Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only." speakers: "Transcribe this audio with punctuation and capitalization. Include all spoken words and verbal fillers. Write numbers in their standard written form. Put speaker tags spk:0 spk:1 spk:2 spk:3 on the transcription." (STYLES en backend.py; el modelo nunca ve el nombre del estilo) |
| Puntuación | jiwer con el normalizador de inglés de Whisper; etiquetas de hablante quitadas antes de puntuar |
Paso a paso con el ejemplo del SDK
El ejemplo (commit 5017429 en main) tiene backend.py, publish.py, main.py, requirements.txt y .env.example.
cp .env.example .env                # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY,
                                    # INFERENCEKEY_PROJECT, IK_WORKER_ID, IK_AUDIO (< 2 MiB),
                                    # INFERENCEKEY_TENANT_ID, INFERENCEKEY_USER_TOKEN (for publish.py)
pip install inferencekey requests openai  # client side; requirements.txt is the backend's
python publish.py                   # once: packages dist/*.tar.gz and uploads it to your tenant;
                                    # without the two publish variables, upload that file from
                                    # Dashboard -> Custom backends
python main.py                      # ensure, wait, verbatim/clean/speakers on IK_AUDIO, delete
IK_KEEP_ALIVE=1 mantiene el workload. Necesita: una GPU Blackwell, un driver de CUDA 13, unos 50 GB de disco y 32 GB de VRAM para los valores por defecto. Para una tarjeta de 24 GB, pon lo que funcionó en la porción MIG:
NEMOTRON_GPU_MEMORY_UTILIZATION=0.93
NEMOTRON_MAX_MODEL_LEN=16384
NEMOTRON_MAX_NUM_SEQS=2
NEMOTRON_MTP=0
NEMOTRON_ENFORCE_EAGER=1
Llamar al workload desplegado con el cliente de OpenAI:
from openai import OpenAI
client = OpenAI(base_url="https://cloud.inferencekey.com/endpoint/<project>/nemotron-transcribe/v1",
                api_key="ik_live_...")
out = client.audio.transcriptions.create(model="default", file=open("meeting.ogg", "rb"),
                                         prompt="speakers", timestamp_granularities=["word"])
Mediciones completas
Ejecución principal a través de la plataforma, RTX PRO 4500 Blackwell, NVFP4, MTP 8, CUDA graphs. Tiempo de GPU dentro del backend; ida y vuelta desde el cliente.
| Entrada | Prompt | GPU s | Ida y vuelta s | Resultado |
|---|---|---|---|---|
| consulta 3 min (178,61 s) | verbatim | 4,113 | 4,62 | 11,74 % de WER frente a la transcripción humana de PriMock57 (S 17, D 32, I 15); 33 um/uh conservados (ref 34) |
| consulta 3 min | clean | 4,054 | 4,58 | 14,68 % frente a la referencia literal (muletillas quitadas a propósito); 50 etiquetas de hablante no pedidas |
| consulta 3 min | speakers + marcas de tiempo por palabra | 4,401 | 4,97 | 13,58 % (sin etiquetas); 57 etiquetas, mapeo {"0":0,"1":1}, 561 palabras con tiempo, error: null |
| consulta 3 min | "Please translate the given speech to Spanish." | 4,857 | 5,33 | texto en español, sin puntuar |
| Earnings-22 unido (303,4 s) | verbatim | 4,818 | 5,243 | 16,11 % (Bark 18,69 %; Qwen3-ASR 72,04 %, cortado, en la prueba anterior) |
| 40 clips (347,5 s, 924 palabras) | verbatim | 12,956 | mediana 0,50 por clip | 6,82 % (S 30, D 17, I 16) |
Por conjunto en los 40 clips:
| Conjunto (8 clips cada uno) | Nemotron NVFP4 | Bark 3.0 Pro (prueba anterior) |
|---|---|---|
| AMI | 14,62 % | 11,54 % |
| Earnings-22 | 9,78 % | 8,15 % |
| GigaSpeech | 3,54 % | 3,54 % |
| LibriSpeech test-other | 0,94 % | 2,35 % |
| VoxPopuli | 8,54 % | 8,04 % |
| Los 40 | 6,82 % | 6,28 % (Qwen3-ASR-1.7B 7,03 %) |
Bark y Qwen3-ASR funcionaron en una RTX 3090 (Qwen en el backend sglang integrado 0.5.14), así que el WER se puede comparar y la velocidad no.
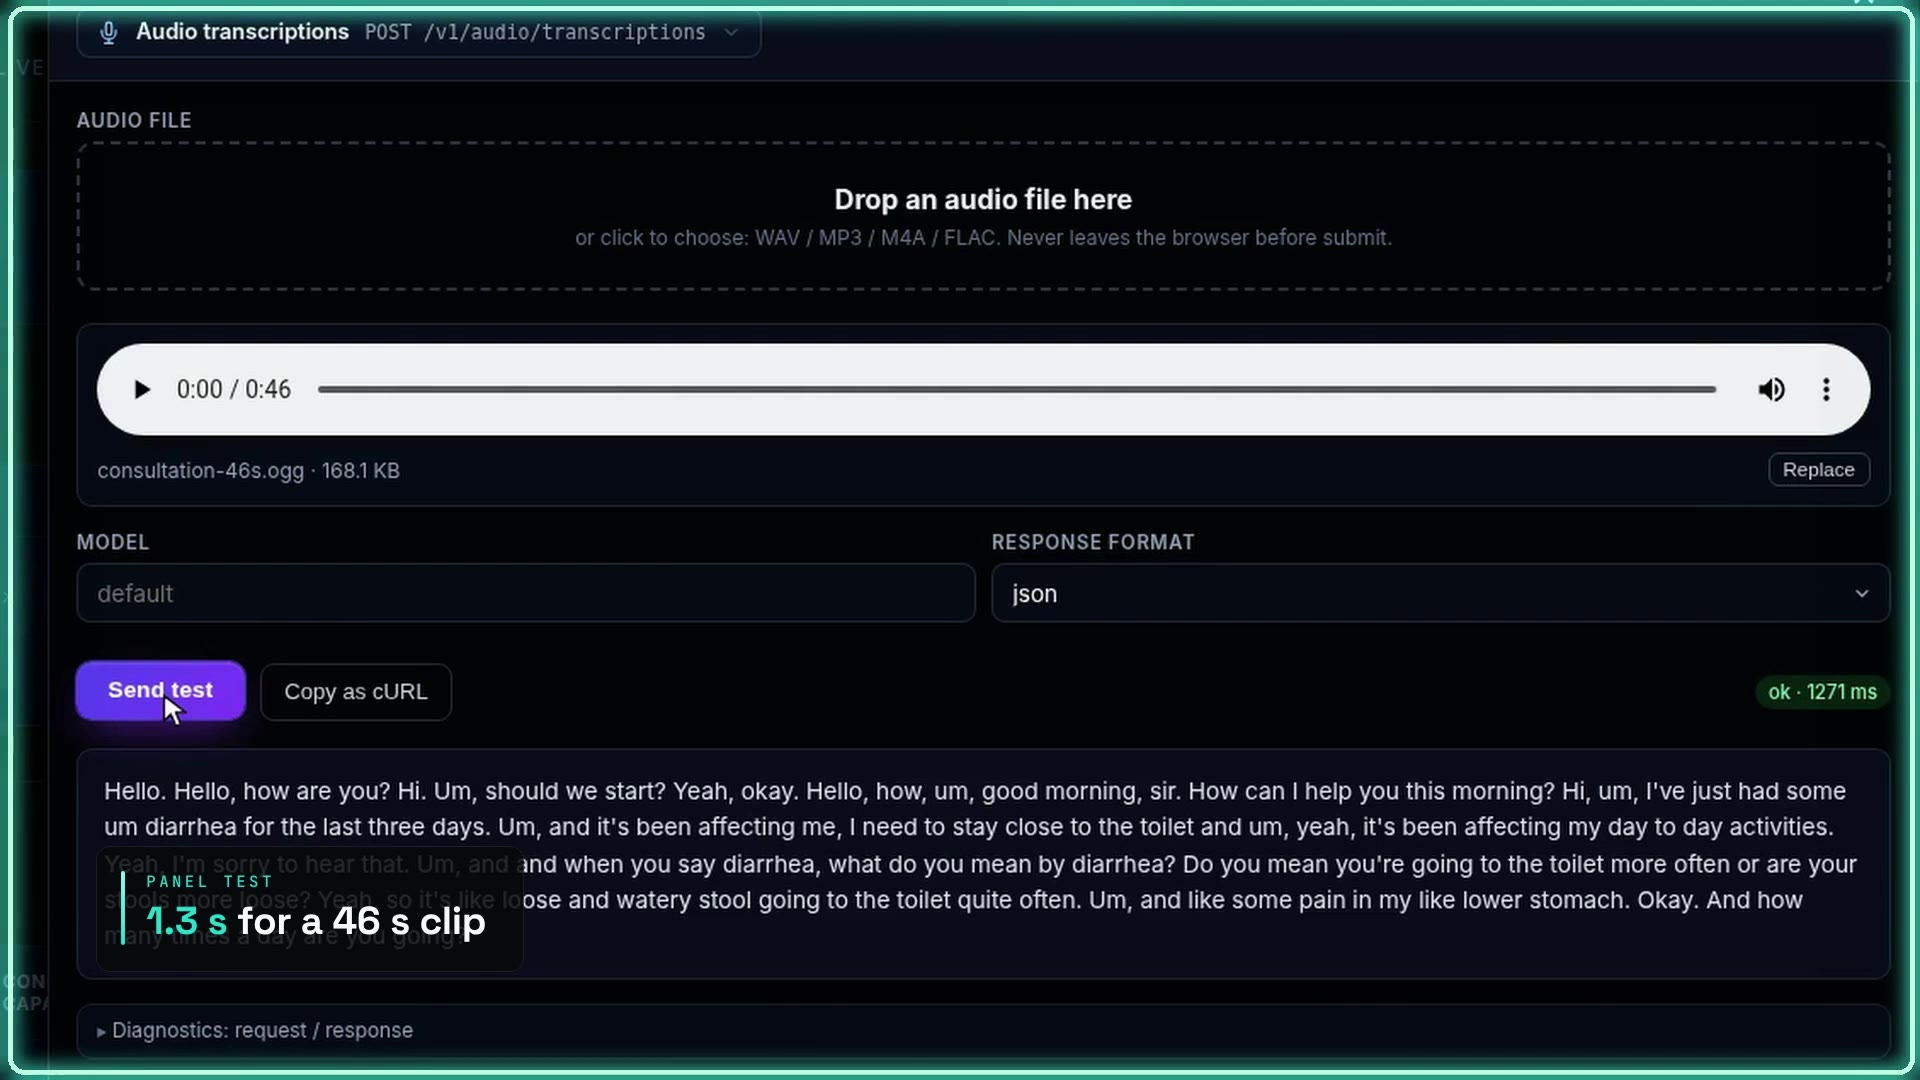
Clip corto, consulta de 46 s: tester del panel ok · 1271 ms; en terminal, verbatim 0,97 s de GPU / 1,29 s de ida y vuelta, clean 0,98 / 1,43 s, speakers 1,10 / 1,58 s (129 palabras con tiempo).
Tiempo hasta estar listo:
| Arranque | Tiempo |
|---|---|
| Primera máquina, en frío, a mano | entorno 84 s, pesos de 21,6 GB en ~18 s, init del motor vLLM 255 s (compilaciones JIT de FlashInfer), unos 6 min en total |
Reinicio en caliente con ensure() | 88 s |
| Segunda máquina, en frío, backend 0.1.4 (eager, sin MTP) | 217 s (entorno 53,4 s, pesos 39,0 s) |
| Primera petición tras el arranque | 12,30 s para un clip de 9 s (calentamiento de kernels); la segunda 0,393 s |
Memoria de GPU en 32 GB: carga del modelo 20,7 GiB (19,41 GiB sin la cabeza MTP), caché KV 4,78 GiB = 1.066.780 tokens (concurrencia de 16,28x a 65.536), CUDA graphs 0,21 GiB. La tarjeta, 28.146 MiB en reposo tras el arranque, pico de 30.254 MiB durante la ejecución en la plataforma (31.442 MiB en el arnés directo).
Escalera de VRAM
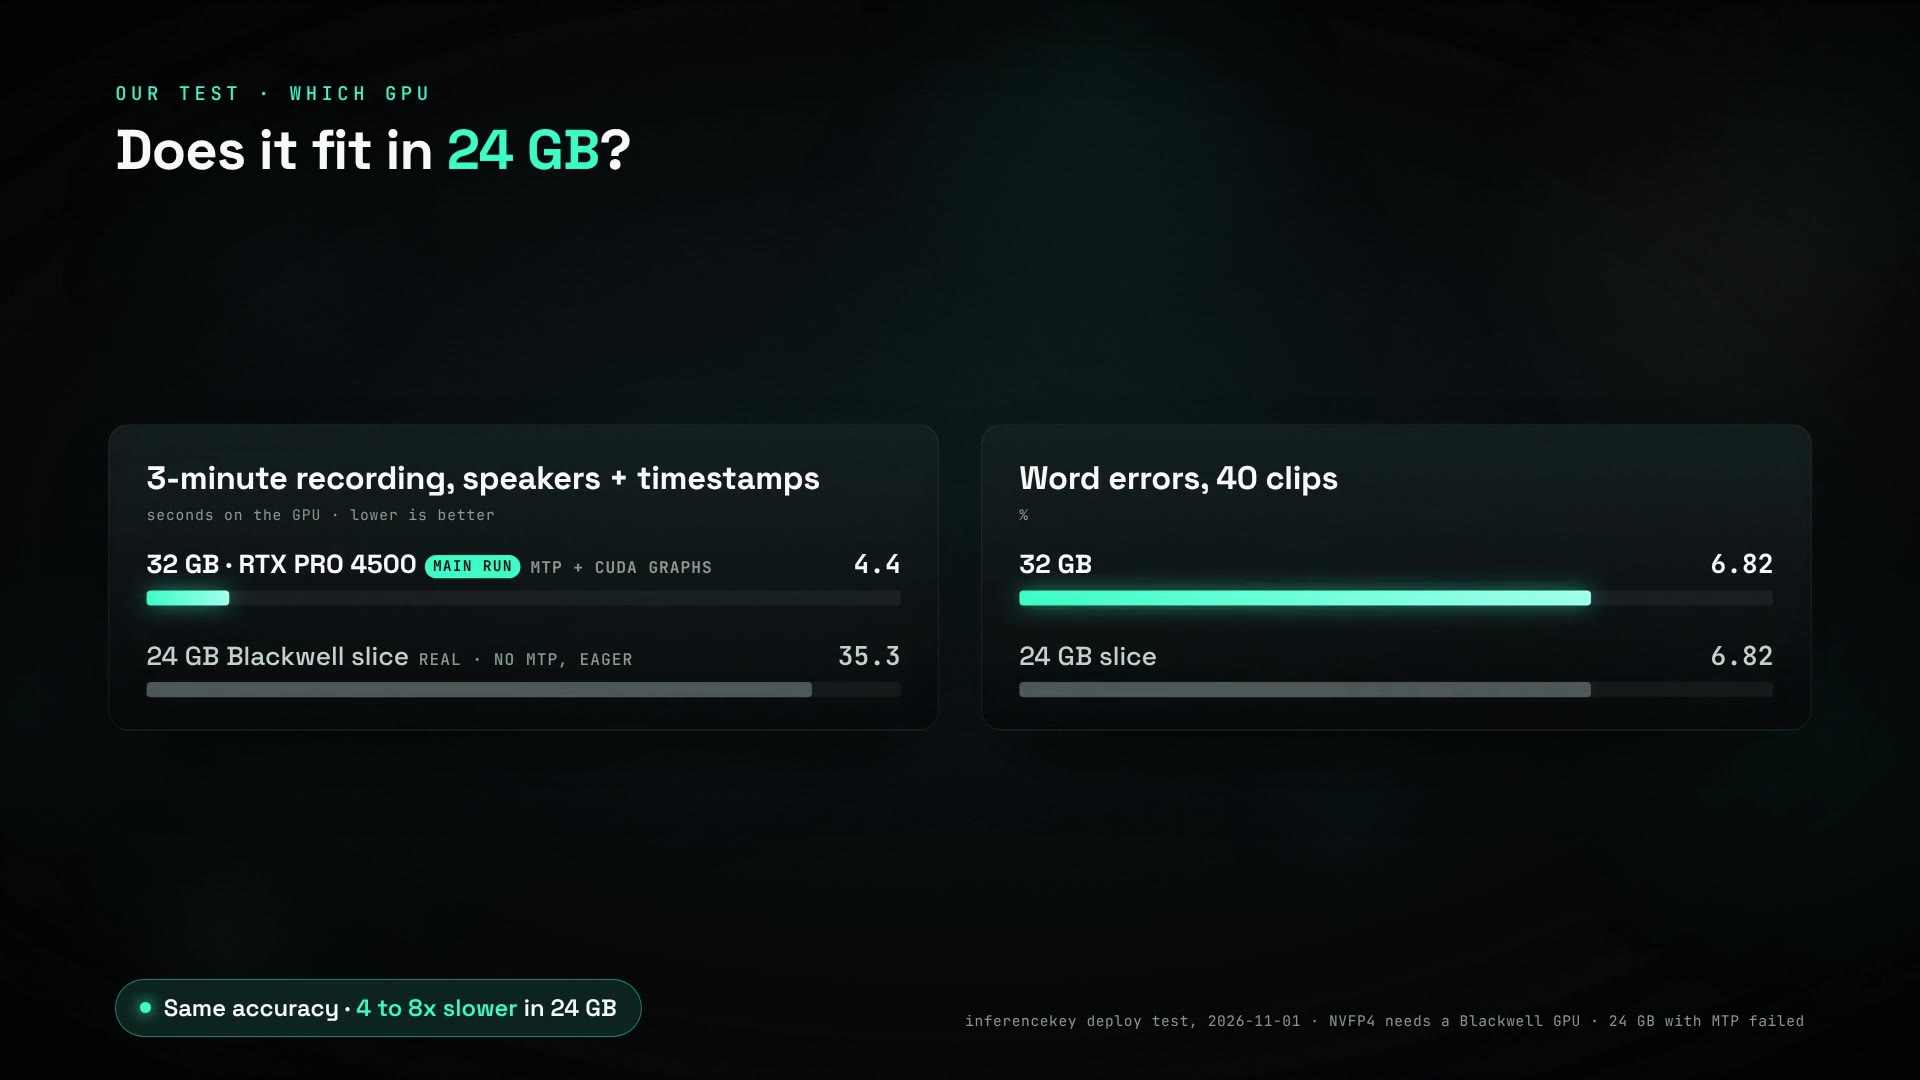
| GPU o límite | Configuración | VRAM pico | Tiempos | Salida correcta | Real |
|---|---|---|---|---|---|
| RTX PRO 4500 Blackwell 32 GB | util 0,92, len 65.536, 8 seqs, MTP 8, CUDA graphs | 30.254 MiB en la tarjeta | 3 min speakers 4,401 s; 5 min 4,818 s; 40 clips 12,956 s | sí | real |
| límite de 22,6 GiB en la tarjeta de 32 GB | util 0,72, len 32.768, 4 seqs, MTP 8, graphs | - | - | no: ValueError: No available memory for the cache blocks | emulado |
| límite de 23,5 GiB en la tarjeta de 32 GB | util 0,75, eager, sin MTP, len 16.384, 2 seqs | 25.712 MiB en la tarjeta | 3 min 46,203 s; 5 min 44,088 s; 40 clips 63,441 s | sirvió pero por encima de 24 GB; 9,42 % porque gigaspeech-06 volvió vacío | emulado |
| porción MIG de 24 GB (RTX PRO 6000 Blackwell 1g.24gb) | util 0,93, eager, sin MTP, len 16.384, 2 seqs | pesos 19,41 GiB + KV 1,4 GiB (221.184 tokens), de los logs de vLLM | 3 min speakers 35,34 s; 5 min 31,733 s; 40 clips 53,23 s | sí: 6,82 % (idéntico), consulta 13,76 %, largo 15,65 % | real |
| la misma porción MIG | util 0,95, MTP 8, CUDA graphs, len 16.384 | - | - | no: RuntimeError: NVML_SUCCESS == r INTERNAL ASSERT FAILED at CUDACachingAllocator.cpp:1407 después de cargar la cabeza MTP (sin memoria) | real |
Las filas emuladas enseñan una cosa: un límite por software con --gpu-memory-utilization no es una tarjeta de 24 GB (con 0,75, un presupuesto de 23,5 GiB, la tarjeta usó 25.712 MiB). Solo la porción real cuenta como prueba para 24 GB.
Ralentización en la porción: 4,1x en clips cortos (tiempo de GPU), 6,6x en el fichero de 5 minutos, 8,0x en la ejecución de 3 minutos con hablantes. La porción 1g tiene la cuarta parte de los SM de la PRO 6000. nvidia-smi no puede leer la memoria MIG, así que ahí la VRAM sale del log de vLLM. No existe ninguna tarjeta GeForce Blackwell de 24 GB, y NVFP4 no funciona en Ada (RTX 4090) ni en generaciones anteriores. Sin probar: 16 GB, 24 GB con MTP pero sin graphs, FP8 en 48 GB, DFlash2, concurrencia.
Ejemplos de salida
- Consulta,
speakers+ marcas de tiempo por palabra, 4,401 s: "spk:0 Hello. spk:1 Hello, how are you? spk:0 Hi, um, should we start? Yeah, okay. Hello, um, good morning, sir. How can I help you this morning? spk:1 Hi, um, I've just had some um diarrhea for the last three days. ..." Primeras palabras:Hello.de 2,94 a 3,25 s, hablante 0;Hello,de 3,919 a 3,97 s, hablante 1. - earnings22-01 (9,3 s), verbatim, 0,381 s: "Can you, uh, yeah, just perhaps give us an update on on how things have progressed there, and um, you know, how how we're tracking relative to perhaps where where you where you were last quarter? Thank you."
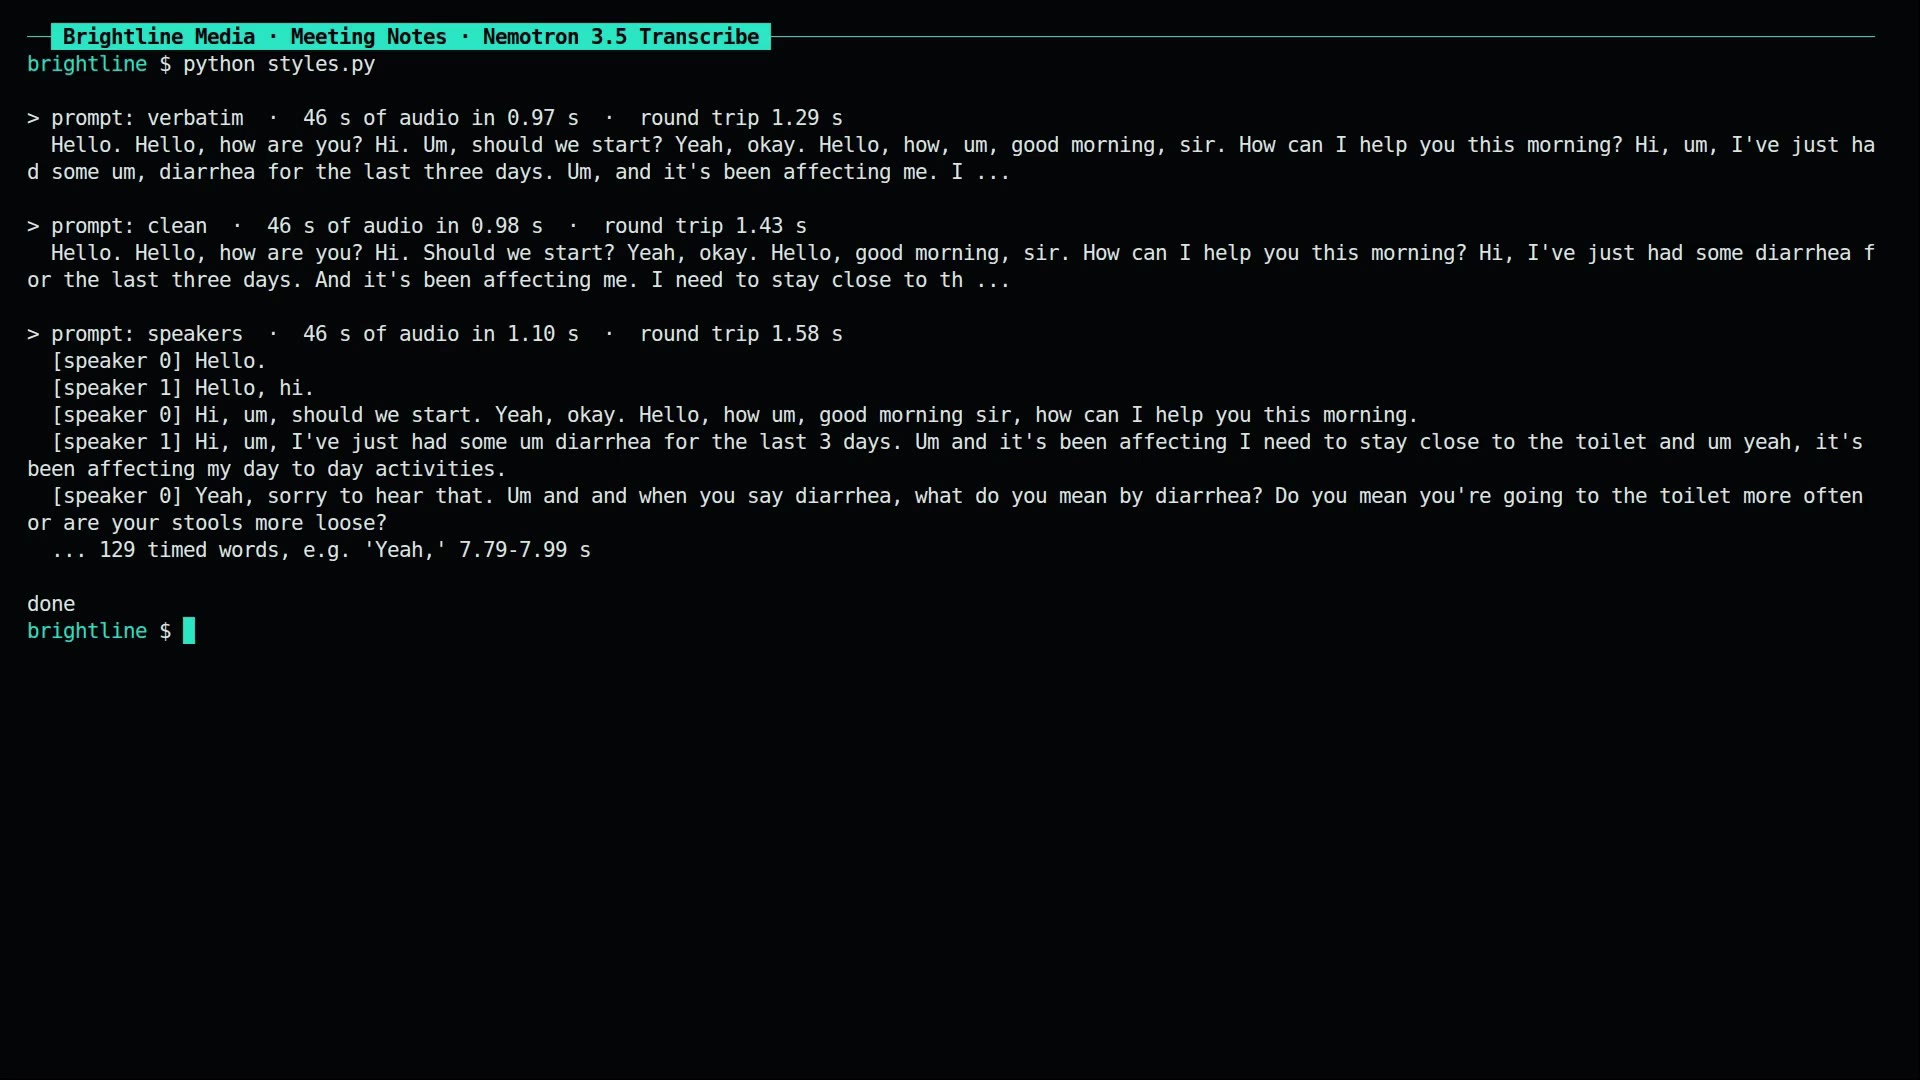
Vídeo de la demo
Un recorrido narrado de 183 segundos: el tester del panel con un clip de 46 segundos, los tres prompts en una terminal, la comparación clave y la escalera de 24 GB.
Problemas y estado
- Límite de subida de 2 MiB en
/v1/audio/transcriptions(plataforma, abierto). Unos 8 minutos de Opus a 32 kbps. El principal límite de este modelo en la plataforma. - Compilación JIT de FlashInfer matada en un contenedor de 62 GB (arreglado en el backend).
fp4_gemm_cutlass_sm120falló conFAILED: [code=137] ... KilledyRuntimeError: Ninja build failed: ninja lanzaba unos 18 nvcc en paralelo. Arreglado con los kernels precompilados yMAX_JOBS=6. El wheelflashinfer_jit_cachede las releases de GitHub es un stub de 16 KB. Hace falta el paquete proveedor por arquitectura más el paquete de primer nivel; sin este último salíaAttributeError ... __version__, arreglado en 0.1.4. - Proceso hijo de vLLM huérfano tras un delete (plataforma, con apaño). El worker para los backends propios con SIGKILL, así que
vllm servesobrevivía con PPID 1 ocupando entre 25 y 29 GB, y el siguiente arranque fallaba conFree memory on device cuda:0 (2.8/31.37 GiB).... Arreglado en el backend conPR_SET_PDEATHSIGy un fichero pid obsoleto. Arreglo de plataforma por abrir: SIGTERM con un periodo de gracia y después matar el grupo de procesos. - El reintento del watchdog del worker compite con un delete (plataforma, menor, abierto).
cleanañade etiquetas de hablante no pedidas (comportamiento del modelo): 50 en 3 minutos, más un arranque en falso que se queda.- Respuesta vacía en gigaspeech-06 solo en el peldaño emulado de 23,5 GiB (1 token,
finish_reason: stop). Bien en 32 GB y en la porción. Sin investigar. - Los límites emulados se quedan cortos: con util 0,75 (presupuesto de 23,5 GiB) la tarjeta usó 25.712 MiB, así que solo la porción real es prueba para 24 GB.
Límites de esta prueba
924 palabras en clips, un fichero de 3 minutos y otro de 5, decodificación greedy, una petición cada vez. Sin medición de throughput ni de concurrencia, así que sin comprobar la cifra de 2.238 s/s ni la afirmación de "roughly two times slower". Los benchmarks de NVIDIA son en BF16 y no se reprodujeron. Nada medido en una RTX 5090, una tarjeta Blackwell completa de 24 GB, el checkpoint FP8, DFlash2 ni otros idiomas (la salida traducida no se puntuó).
Benchmarks de los autores (BF16, recogidos el 12 oct 2026, no reproducidos)
| Benchmark | Nemotron 3.5 Transcribe | Comparación |
|---|---|---|
| English Open ASR, 9 conjuntos, WER medio | 4,71 | Qwen3-ASR-1.7B 4,94 |
| WER en audio largo | 10,98 | Parakeet-TDT-0.6B-v3 13,37 |
| Multilingüe, 7 idiomas | 4,62 | Qwen3-ASR-1.7B 6,49 |
| cpWER medio con varios hablantes (AMI, CALLHOME, Mixer 6, NOTSOFAR-1) | 15,80 | DiCoW v3.3 + DiariZen 16,83 |
| Preference-ASR, por defecto / con instrucción | 7,56 / 6,16 | Canary-Qwen 8,16 / 8,36 |
RTFx de la ficha en una H100 BF16 con carga por lotes ajustada: MTP2 410, MTP8 270, DFlash2 K=7 340, DFlash2 K=15 260.
Fuentes
- Fichas del modelo: BF16, NVFP4, FP8, DFlash2
- Licencia: OpenMDW-1.1
- NeMo Speech (plugin de vLLM en
nemo/collections/speechlm2/vllm/salm) - SGLang-Omni y su cookbook de Nemotron Transcribe
- PriMock57, datos del Open ASR Leaderboard
- Nuestra prueba anterior: Underdog Bark 3.0 Pro frente a Qwen3-ASR-1.7B
- Donde lo vimos: vídeo de noticias de AI Search, 1 de noviembre de 2026
- Ejemplo del SDK