Underdog Bark 3.0 Pro frente a Qwen3-ASR-1.7B: casi los mismos errores, la cuarta parte de tamaño y funciona en CPU
En 40 clips en inglés, Bark 3.0 Pro falló el 6,28 % de las palabras y Qwen3-ASR-1.7B el 7,03 %, casi empate. Bark también funcionó sin GPU, con 4 hilos de CPU.
¿Puede un modelo de voz a texto que ocupa la cuarta parte que Qwen3-ASR-1.7B aguantar el ritmo con las mismas grabaciones? En 40 clips en inglés de los conjuntos de prueba habituales, quedó muy cerca, ligeramente por delante. Underdog Bark 3.0 Pro, un modelo abierto de 1,25 GB de Conway Research, falló el 6,28 % de las palabras. Qwen3-ASR-1.7B, un modelo de 4,7 GB, falló el 7,03 % con el mismo audio y en la misma RTX 3090. Casi toda la diferencia sale de una costumbre: Bark conserva las muletillas y las repeticiones que dice la gente, y Qwen se come muchas. Bark pasó cinco minutos de voz a texto en menos de tres segundos de trabajo de GPU, 4,5 segundos contando el viaje por la red. Cuatro hilos de procesador transcriben una grabación más rápido de lo que dura. Una GPU necesita unos 2 GB de memoria cuando el audio largo se corta en trozos.
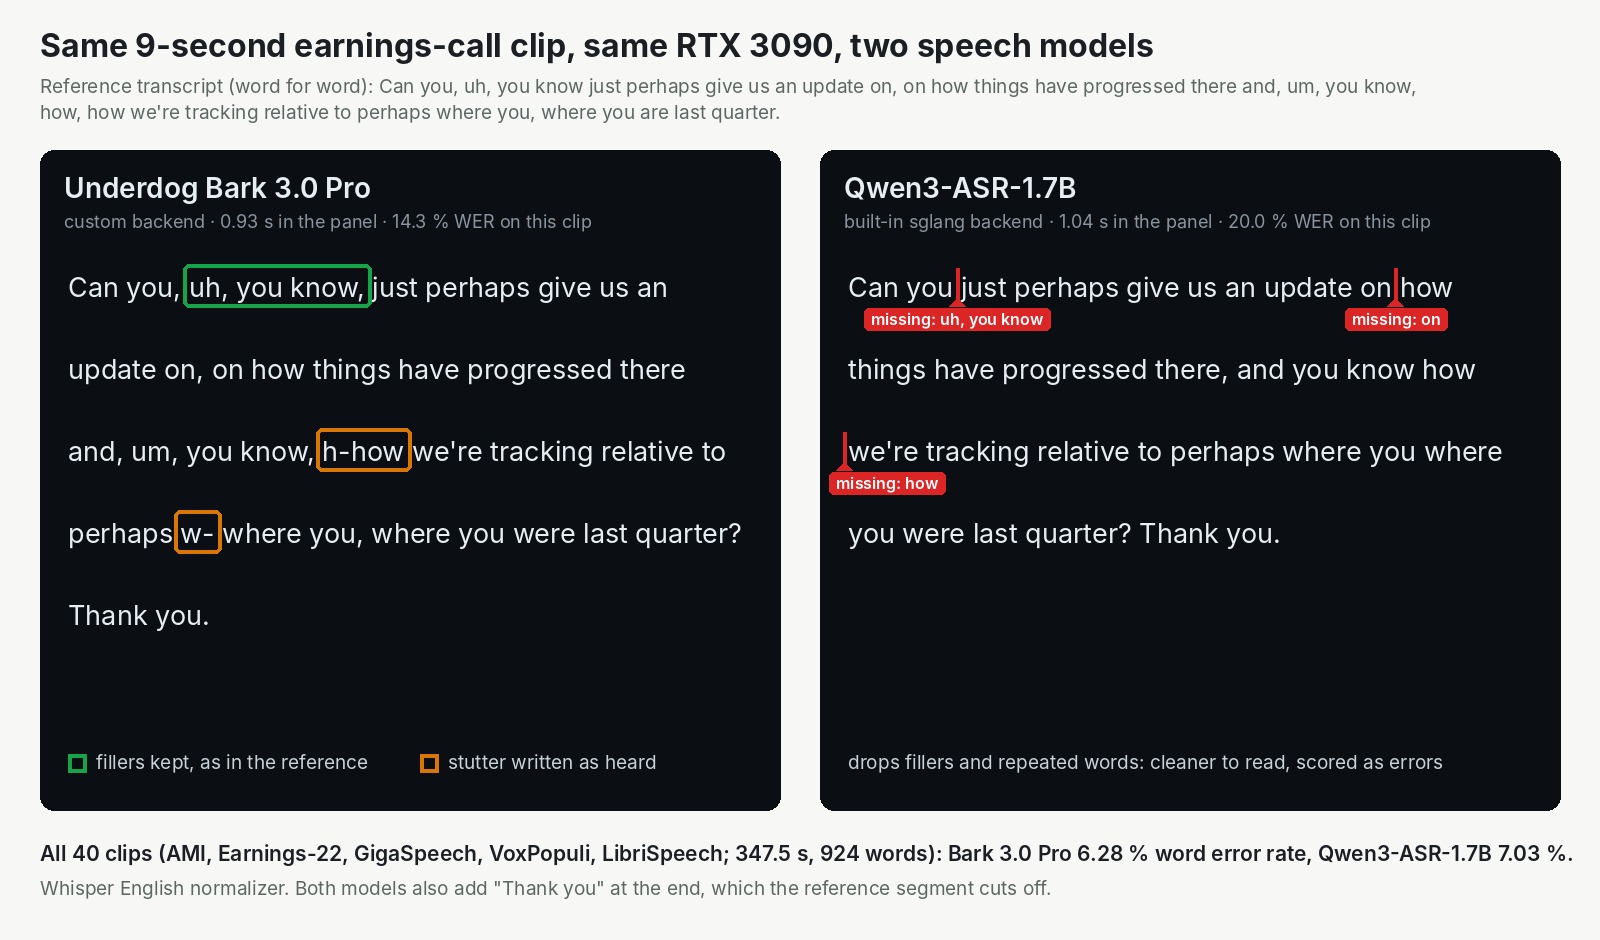
Mismo clip, misma tarjeta. Bark conserva el "you know" y las repeticiones que conserva la referencia, y el texto más limpio de Qwen pierde puntos por ello.
Un modelo de 1,25 GB que empata con la mejor nota abierta, según sus propias cuentas
Lo que nos hizo mirarlo está en la página del modelo en Hugging Face. Bark saca una tasa de error por palabra media del 4,29 % en los siete conjuntos de prueba en inglés del Open ASR Leaderboard, una clasificación pública de modelos de voz a texto. La tasa de error por palabra es la proporción de palabras que un modelo falla, así que cuanto más baja, mejor. La página dice que es la más baja de cualquier modelo abierto. La ventaja es de 4,286 frente a 4,291 de Hojo-ASR-V1, un empate con un modelo unas diez veces más grande. La misma tabla pone a Qwen3-ASR-1.7B en el 4,43 % y a Whisper large-v3 de OpenAI en el 6,04 %.
Esa nota la declaran los propios autores. La página dice que las filas de Bark usan el código de puntuación de la clasificación pero "are not on the leaderboard yet". La diferencia de tamaño no requiere fe: 1.254 MB en disco frente a 4.699 MB de Qwen3-ASR-1.7B, algo más de la cuarta parte.
NVIDIA entrenó el modelo base, Parakeet TDT 0.6B v3, un modelo de voz para 25 idiomas europeos publicado en agosto de 2025. Después Moondream hizo una versión mejorada. Conway Research lo reentrenó y lo comprimió hasta convertirlo en Bark, y lo publicó en Hugging Face el 15 de octubre. El equipo de Underdog escribió el anuncio, que también presenta tres hermanos más pequeños, de hasta solo 163 MB. El equipo de hf-audio mantiene la clasificación y publica el audio de prueba que usamos. Vimos Bark en el vídeo de noticias de AI Search del 25 de octubre. El presentador dijo que el Pro "should still be able to fit on most consumer GPUs". Lo nuestro fue empaquetar Bark para desplegarlo, ponerlo junto a Qwen3-ASR en una sola tarjeta y contar los errores.
Los tres modelos de la cadena usan la misma licencia, CC-BY-4.0. Permite el uso comercial, siempre que reconozcas el mérito de NVIDIA, Moondream y Conway Research.
La prueba: 40 clips comparan los dos modelos, no repiten las cifras de la ficha
La página del modelo puntúa cuatro de los conjuntos después de corregir errores en su texto de referencia. Nosotros usamos las versiones originales, así que nuestras cifras absolutas no son comparables con la tabla de la página. Solo lo es la comparación entre los dos modelos.
Sacamos ocho clips al azar de cada uno de cinco conjuntos de los datos de prueba de la propia clasificación:
- AMI: reuniones de oficina.
- Earnings-22: conferencias de resultados de empresas.
- GigaSpeech: pódcasts y YouTube.
- VoxPopuli: discursos del Parlamento Europeo.
- LibriSpeech test-other: audiolibros.
Cada clip dura entre 4 y 20 segundos, casi seis minutos y 924 palabras en total. Además juntamos otros 33 fragmentos de conferencias de resultados en un solo fichero de cinco minutos para probar audio largo.
Los dos modelos corrieron en la misma RTX 3090 de 24 GB, una petición cada vez. Puntuamos los dos igual, con las reglas de puntuación que OpenAI escribió para Whisper: ignoran mayúsculas, puntuación y los "uh" o "um", así que solo cuentan las diferencias reales de palabras. La prueba corrió en nuestra nube a través de una compilación local de prueba de InferenceKey, no del servicio alojado.
Resultados: 6,28 % frente a 7,03 %, y la diferencia son sobre todo muletillas como "you know"
Bark falló el 6,28 % de las palabras en los 40 clips, y Qwen3-ASR-1.7B el 7,03 %. Conjunto por conjunto, el resultado está repartido:
| Conjunto (8 clips cada uno) | Bark 3.0 Pro | Qwen3-ASR-1.7B |
|---|---|---|
| Reuniones (AMI) | 11,54 % | 16,92 % |
| Conferencias de resultados (Earnings-22) | 8,15 % | 10,87 % |
| Pódcasts y YouTube (GigaSpeech) | 3,54 % | 4,04 % |
| Discursos parlamentarios (VoxPopuli) | 8,04 % | 5,53 % |
| Audiolibros (LibriSpeech test-other) | 2,35 % | 1,88 % |
| Los 40 clips, 924 palabras | 6,28 % | 7,03 % |
924 palabras es una muestra pequeña. Un par de palabras mueven la cifra de un conjunto, así que lee el total como "muy cerca, con Bark por delante", no como una clasificación.
Para ver de dónde sale la diferencia hace falta una idea: una transcripción literal frente a una limpia. Una transcripción literal escribe lo que se dijo, con arranques en falso y muletillas incluidos. Una limpia escribe lo que el hablante quería decir. Imagina la grabación pirata de un concierto, con toses y todo, frente a la versión de estudio. Las claves de respuesta de la clasificación, escritas por personas, son literales. Y Bark también, a propósito: "Bark 3.0 writes what was said, fillers included. It does not clean speech up", escriben sus autores. Qwen3-ASR tira a limpio.
Eso explica casi toda la diferencia. Qwen se dejó 29 palabras que sí están en las claves de respuesta, Bark 11. La mayoría de las de Qwen eran muletillas y repeticiones: "you know", "on, on", "how, how". En palabras mal oídas, Qwen iba ligeramente por delante (28 frente a 32), así que la ventaja de Bark está en conservar lo que se dijo, no en oír mejor. Bark pierde puntos por el otro lado. Escribe los tartamudeos tal como se oyen, "h-how" y "w- where", y esos también cuentan como errores.
El clip de la conferencia de resultados de la imagen de arriba enseña las dos costumbres en nueve segundos. Bark sacó un 14,3 % en él, Qwen un 20,0 %. Esto es Bark:
Can you, uh, you know, just perhaps give us an update on, on how things have progressed there and, um, you know, h-how we're tracking relative to perhaps w- where you, where you were last quarter? Thank you.
Y esto es Qwen3-ASR:
Can you just perhaps give us an update on how things have progressed there, and you know how we're tracking relative to perhaps where you where you were last quarter? Thank you.
La ventaja de Bark es mayor en reuniones y conferencias de resultados, donde las claves de respuesta conservan muchas muletillas y repeticiones que Qwen elimina. No averiguamos por qué Qwen lo hace mejor en discursos parlamentarios y audiolibros.
Cinco minutos de audio en menos de tres segundos de trabajo de GPU, de una pieza
Bark es tan rápido que lo lento es la red. Los 40 clips llevaron menos de cinco segundos de trabajo de GPU, unos 0,12 segundos cada uno. Contando el viaje por la red, un clip típico volvía en medio segundo. Con Qwen3-ASR, un clip típico tardó 0,73 segundos. Qwen3-ASR corrió con otro software de servicio, así que esto compara montajes tanto como modelos.
El fichero de cinco minutos llevó 2,8 segundos de trabajo de GPU en una sola petición. Contando la subida y la respuesta, tardó 4,5 segundos. Bark devolvió la transcripción entera, 715 palabras. No pudimos puntuarla limpiamente: el texto de referencia que juntamos tiene huecos donde se unen los trozos (cifra en el apéndice).
Qwen3-ASR devolvió 212 palabras y se paró. No investigamos por qué.
Dónde se queda corto: solo inglés, literal, sin marcas de tiempo
- Solo inglés. Su modelo base maneja 25 idiomas europeos. Bark no.
- Literal por diseño. Si quieres texto limpio, necesitas un paso de limpieza. Los autores publican aparte un Bark 3.0 Clean que quita las muletillas. No lo probamos.
- Todavía sin tiempos por palabra ni nombres de hablantes, según la página de los autores. Si tus subtítulos o tus actas los necesitan, tendrán que salir de otra herramienta.
Qué GPU: ninguna. Cuatro hilos de procesador hicieron cinco minutos en 31 segundos
La máquina más pequeña que funcionó no tenía tarjeta gráfica. Con cuatro hilos de un procesador de servidor, Bark transcribió el fichero de cinco minutos en 31 segundos. Con dieciséis hilos tardó 14 segundos. Las transcripciones fueron idénticas palabra por palabra a las de la GPU, en los 40 clips.
En una GPU, Bark es diminuto. El modelo ocupa unos 1,3 GB de memoria, y con solo Bark cargado la tarjeta nunca pasó de unos 2,8 GB, menos de la octava parte de sus 24 GB.
Para comprobar tarjetas más pequeñas sin tenerlas, limitamos cuánta memoria de la 3090 podía usar Bark. Eso copia el límite de memoria de una tarjeta más pequeña, no su chip más lento. Un límite de unos 4 GB no cambió nada: mismas transcripciones, misma velocidad.
Con un límite de unos 2 GB, todo pasó una vez que el audio largo se cortó en trozos de 60 segundos, un ajuste de nuestro ejemplo. Sin los trozos, el fichero de cinco minutos pidió demasiada memoria de golpe y falló. Con ellos, pasó muy por debajo del límite, y los 40 clips salieron con las mismas transcripciones que antes. En la GPU limitada, los trozos no ralentizaron nada.
También intentamos alquilar siete tipos de tarjeta pequeña, de 6 a 20 GB, como una RTX A2000, una RTX 3070 y una RTX 4000 Ada. En ocho intentos, ninguna estaba disponible. Así que no podemos señalar una tarjeta pequeña concreta como suficiente.
En InferenceKey: un fichero corto de Python, reinicios en 8 segundos
Un fichero de Python, de menos de 200 líneas, sirve Bark con la biblioteca Transformers de Hugging Face, como promete su página. Las herramientas de servicio habituales no lo ejecutan. El fichero descarga el modelo, lo carga y convierte audio en texto. Cualquier programa que ya hable con la API de transcripción de OpenAI puede enviarle un fichero.
El primer arranque tardó 322 segundos, unos 300 de ellos instalando software en una máquina recién creada. Descargar el modelo llevó 4 segundos, cargarlo 2,4. Después, los reinicios estaban listos en 7 a 8 segundos. Qwen3-ASR, que la plataforma ejecuta sin código a medida, tardó 357 segundos en su primer arranque. Los dos modelos compartieron la única 3090.
Dos asperezas con las que tú también te vas a encontrar:
- Las subidas de audio se cortan en unos 2 MB. Eso son unos 65 segundos de audio sin comprimir. Nuestro WAV de cinco minutos, de 9,7 MB, se rechazó por demasiado grande. La solución es un formato comprimido: los mismos cinco minutos entraron en 1,1 MB. Estado: abierto. El README del ejemplo lo documenta.
- Volver a ejecutar el ejemplo con el modelo aún desplegado deja colgado el script. El modelo sigue respondiendo, pero el script espera diez minutos. Solución: borra el despliegue antes de volver a ejecutarlo. Estado: abierto.
Los otros problemas que encontramos están en la sección para ingenieros, más abajo.
¿Deberías usarlo? Sí para transcripciones literales en inglés con hardware pequeño
- Si transcribes reuniones, llamadas o entrevistas en inglés y necesitas cada palabra tal como se dijo, merece la pena. Cometió menos errores literales que Qwen3-ASR-1.7B en nuestras reuniones y conferencias de resultados.
- Si quieres texto que la gente lea sin editar, cuenta con "uh" y "you know" en la salida y prevé un paso de limpieza.
- Si tu audio no está en inglés, busca otra cosa.
- Si no tienes una GPU libre, unos pocos hilos de un procesador de servidor sacan una grabación más rápido de lo que dura.
- Si lo metes en un producto, la licencia lo permite reconociendo la autoría.
Necesitas un proyecto de InferenceKey, un fichero de audio y un worker de NVIDIA con unos 2 GB libres, o BARK_DEVICE=cpu para prescindir de GPU. Para transcribir y puntuar tu propio audio, ejecuta python publish.py una vez y después python main.py, desde el ejemplo del SDK.
Para ingenieros
Modelo y ficheros
- Ficha del modelo, NOTICE, anuncio de Underdog (fechado el 15 de octubre de 2026, "The Underdog team"), ficha del Bark 3.0 pequeño, Parakeet TDT 0.6B v3.
- 0.6B parámetros, solo inglés, precisión completa (bf16). Repo
ConwayResearch/Underdog-Bark-3.0-Pro, creado y modificado por última vez el 2026-10-15 (07:05:36Z / 07:05:51Z), sha4b5c51e04aa8d16dda9ecdff71bc29f7360149e4, sin acceso restringido. Licenciacc-by-4.0, bibliotecatransformers, pipelineautomatic-speech-recognition,base_model: nvidia/parakeet-tdt-0.6b-v3conbase_model_relation: finetune. 1.079 descargas el último mes y 36 likes a 2026-10-27. - El repo ocupa 2,49 GB en total, porque también lleva copias para Core ML y MLX. Los ficheros de PyTorch que descarga el backend son
model.safetensors(1.254.196.636 bytes, bf16) más configuraciones y tokenizador, unos 1,26 GB. config.json:ParakeetForTDT, encoder FastConformer (24 capas, hidden 1024, 8 cabezas, 128 bandas mel, submuestreo 8) y un decoder TDT (2 capas, hidden 640, duraciones de 0 a 4), vocabulario de 8.193,transformers_version5.19.0.- Cadena de atribución (NOTICE):
nvidia/parakeet-tdt-0.6b-v3(c) NVIDIA Corporation, CC-BY-4.0, ymoondream/parakeet-ultra(c) Moondream, CC-BY-4.0. Cambios: "post-trained and compressed by Conway Research". - Carga recomendada en la ficha:
AutoProcessormásParakeetForTDT.from_pretrained(repo, dtype=torch.bfloat16).to("cuda"), entrada mono a 16 kHz, 4.000 muestras (0,25 s) de silencio al principio, y despuésmodel.generate(). Decodificación greedy. - Entornos de ejecución en la ficha: Windows con NVIDIA CUDA (Python 3.11,
torch==2.8.0cu128, una GPU con soporte BF16; float16 es una alternativa explícita que necesita su propia validación de precisión; CPU con--device cpu --dtype float32), Mac Core ML (macOS 15+, probado en un M5 Max, unos 1,23 GB de descarga), iOS 18+ a través de FluidAudio ("Not yet tested on an iPhone or iPad"). La app de Underdog lo ejecuta con MLX en Apple silicon. - Familia Bark 3.0 (anuncio): Bark 3.0, 163 MB, 4,94 % de media; Bark 3.0 Plus, 180 MB, 4,76 %; Bark 3.0 Pro, 1,25 GB, 4,29 %, "Hugging Face only"; Bark 3.0 Clean, 180 MB, 5,83 %, quita muletillas, el predeterminado en la app de Underdog. El Bark 3.0 pequeño se distribuye como un fichero empaquetado
model.barkque se carga conbark_loader.py. El anuncio también dice "English only", "No word timings or speaker names yet", y que el Bark 3.0 pequeño hace 5 minutos en medio segundo en un M5 Max (595x, cifra de los autores, no del Pro).
La tabla de benchmarks de la ficha (declarada por los autores, no reproducida)
Conjuntos de prueba completos, con versiones limpias de AMI, Earnings-22, GigaSpeech y VoxPopuli. Las filas que no son de Bark son las filas publicadas de la clasificación a 9 de octubre de 2026. Las filas de Bark "use its scoring code and are not on the leaderboard yet". La afirmación completa de la ficha: "the lowest of any open model by the leaderboard's own scoring: 4.286 against 4.291 for Hojo-ASR-V1, a 12 GB download."
| Modelo | Descarga | LS clean | LS other | AMI | Earnings-22 | GigaSpeech | SPGISpeech | VoxPopuli | Media |
|---|---|---|---|---|---|---|---|---|---|
| Bark 3.0 Pro | 1.254 MB | 1,38 | 3,11 | 7,16 | 5,65 | 7,46 | 3,54 | 1,70 | 4,29 |
| Qwen3-ASR-1.7B | 4.699 MB | 1,26 | 2,94 | 8,31 | 5,84 | 7,22 | 2,57 | 2,85 | 4,43 |
| Parakeet TDT 0.6B v3 | 2.508 MB | 1,52 | 3,13 | 9,42 | 5,85 | 7,99 | 3,63 | 3,05 | 4,94 |
| Whisper large-v3 | 9.261 MB | 1,56 | 3,52 | 13,63 | 7,99 | 8,35 | 2,71 | 4,53 | 6,04 |
| Hojo-ASR-V1 | 11.957 MB | 4,29 |
También en la ficha: Canary-Qwen 2.5B 4,55 %, y API de pago que no están en la tabla (OpenAI GPT-Transcribe 4,70 %, AssemblyAI Universal-3.5 Pro 4,46 %, Gladia Solaria-3 4,70 %, Smallest.ai Pulse 4,54 %, Meta Muse Voice Transcribe 4,93 %). En DisfluencySpeech (250 clips, literal, con las muletillas contadas) la ficha da un 2,95 %.
La propia ficha de Parakeet TDT 0.6B v3 da una media del 6,34 % con cifras distintas por conjunto. La razón probable son versiones distintas (limpias) de los conjuntos; no lo confirmamos. El Space de la clasificación es una app de Gradio, y no leímos directamente sus filas actuales.
Nuestro montaje
- Una RTX 3090 de 24 GB en nuestra nube (driver 580.65.06, 21 vCPU AMD EPYC 7C13, disco de contenedor de 100 GB, una imagen PyTorch 2.8 CUDA 12.8 Ubuntu 24.04), 41 minutos en total. Un manager local de InferenceKey (de
mainencc0024a4) la arrancó a través de túneles de desarrollo. Ningún parche de código en la plataforma. - Bark: backend a medida
underdog-bark-pro0.1.0,task_typeaudio2text, transformers 5.19.0, torch 2.8.0 cu128, bf16. - Qwen3-ASR-1.7B: backend integrado
sglang, sglang 0.5.14,--trust-remote-code --mem-fraction-static 0.45, el mismo montaje que el ejemplo del SDKsglang-qwen3-asr-private. No pudo compartir el backend a medida de Bark porque el paqueteqwen-asrfija transformers 4.57.6. - Por qué un backend a medida: vLLM, SGLang y llama.cpp no sirven modelos Parakeet TDT.
- Clips: 8 por conjunto de los shards parquet de
hf-audio/open-asr-leaderboard(ami test-00002, earnings22 test-00001, gigaspeech test-00004, voxpopuli test-00001, librispeech test.other), semilla 20261027, de 4 a 20 s, 347,5 s y 924 palabras en total. Fichero largo: otros 33 fragmentos de Earnings-22 unidos con huecos de 0,4 s, 303,4 s. - Puntuación:
jiwerdespués del normalizador de inglés de Whisper (whisper-normalizer). Una petición cada vez, decodificación greedy. - Antes de alquilar nada, el backend corrió en local en CPU (torch 2.8.0+cpu) y transcribió bien dos clips.
Paso a paso con el ejemplo del SDK
El ejemplo (commit fb18916b en main) contiene backend.py, requirements.txt, publish.py, main.py, asr_eval.py (llamada multipart más WER), compare_qwen3_asr.py (Qwen3-ASR-1.7B en sglang, mismos clips, lado a lado), README.md y .env.example.
cp .env.example .env              # tokens, project slug, IK_WORKER_ID, IK_AUDIO
python -m venv .venv && . .venv/bin/activate
pip install maturin requests jiwer whisper-normalizer
( cd ../../bindings/python && maturin develop --release )
python publish.py                 # once: uploads the backend if INFERENCEKEY_TENANT_ID and INFERENCEKEY_USER_TOKEN are set, else builds dist/*.tar.gz to upload from Dashboard -> Custom backends
python main.py                    # ensure -> wait_until_ready -> transcribe -> score -> delete
IK_KEEP_ALIVE=1 python main.py && python compare_qwen3_asr.py   # side by side
.env necesita INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY, INFERENCEKEY_PROJECT, IK_WORKER_ID (un worker de NVIDIA con un driver para CUDA 12.8 y Python 3.12) e IK_AUDIO (un fichero o una carpeta; un manifest.json con filas {"id", "ref"} activa la puntuación WER). Para que publish.py suba el backend por sí mismo, define también INFERENCEKEY_TENANT_ID e INFERENCEKEY_USER_TOKEN (un token de sesión del panel); sin ellos, sube el dist/*.tar.gz que genera desde Dashboard -> Custom backends. Define INFERENCEKEY_BASE_URL de forma explícita: las llamadas de control del SDK van por defecto a https://api.inferencekey.com, pero la llamada de transcripción de main.py y compare_qwen3_asr.py recurre a https://cloud.inferencekey.com cuando no está definida. Cualquier cliente de OpenAI funciona contra el endpoint:
curl -s "${INFERENCEKEY_BASE_URL:-https://api.inferencekey.com}/endpoint/$INFERENCEKEY_PROJECT/underdog-bark-pro/v1/audio/transcriptions" \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" -F file=@call.opus -F model=default
La respuesta es {"text", "duration", "seconds", "rtfx", "chunks", "vram_peak_gib", "device", "dtype", "model"}.
Qué hace backend.py: snapshot_download de la revisión fijada con allow_patterns (solo ficheros de PyTorch), ParakeetForTDT.from_pretrained en bf16 sobre CUDA (float16 como alternativa en tarjetas anteriores a Ampere, float32 en CPU), un calentamiento con 1 s de silencio, y después, por cada trabajo: decodificar con soundfile (librosa como alternativa), remuestrear con soxr, añadir 0,25 s de silencio al principio, generate(). Ajustes:
| Variable | Por defecto | Efecto |
|---|---|---|
BARK_DEVICE | cuda | cpu ejecuta en float32 sin GPU |
BARK_DTYPE | bfloat16 en CUDA | float16 o float32 |
BARK_VRAM_LIMIT_GIB | sin definir | limita la memoria con torch.cuda.set_per_process_memory_fraction |
BARK_CHUNK_SECONDS | 600 | corta el audio largo en trozos de esta duración |
BARK_CPU_THREADS | sin definir | número de hilos en CPU |
Cambiar una variable BARK_* exige borrar y hacer un ensure() nuevo.
Mediciones completas
Precisión, 40 clips (summary.json por ejecución):
| Conjunto | Palabras | Bark 3.0 Pro | Qwen3-ASR-1.7B |
|---|---|---|---|
| AMI (4 a 5 s) | 130 | 11,54 % | 16,92 % |
| Earnings-22 (7 a 11 s) | 184 | 8,15 % | 10,87 % |
| GigaSpeech (9 s) | 198 | 3,54 % | 4,04 % |
| VoxPopuli (8 a 13 s) | 199 | 8,04 % | 5,53 % |
| LibriSpeech test-other (4 a 19 s) | 213 | 2,35 % | 1,88 % |
| Todos (347,5 s) | 924 | 6,28 % (S 32, D 11, I 15) | 7,03 % (S 28, D 29, I 8) |
Velocidad:
- Bark, bf16: 4,864 s de tiempo de GPU para los 40 clips (mediana de 0,118 s por clip), 71x tiempo real. Ida y vuelta: mediana de 0,50 s (de 0,456 a 0,713 s, la primera petición 1,73 s), 20,81 s en total. Probador del panel con el clip de la conferencia de resultados: 928 ms.
- Qwen3-ASR-1.7B: ida y vuelta con mediana de 0,73 s (de 0,52 a 2,60 s), 30,61 s en total. Probador del panel: 1.039 ms. sglang no informa del tiempo de GPU.
- Fichero de cinco minutos, una petición: Bark 2,833 s de GPU, 4,48 s de ida y vuelta (107x). Qwen 3,71 s de ida y vuelta, salida truncada.
Audio largo: Bark devolvió 715 palabras, 18,69 % de WER (S 39, D 22, I 62) frente a la referencia unida de 658 palabras, y 17,78 % con trozos de 60 s. El alineamiento muestra tramos que están en el audio pero faltan en la referencia y al revés (fronteras entre fragmentos de Earnings-22), así que la cifra absoluta dice más de la referencia unida que del modelo. Qwen3-ASR con sglang 0.5.14 y la configuración por defecto devolvió 212 palabras, terminando en "...Matthew Walker, Credit Suisse. Please go ahead,": faltan 454 de las 658 palabras de la referencia (72,04 %). No investigamos la causa.
Memoria de GPU: pesos en la GPU tras la carga, 1,18 GiB. Pico asignado por PyTorch: 1,243 GiB en los 40 clips, 2,151 GiB en el fichero de cinco minutos en una sola petición, 1,369 GiB con trozos de 60 s. Pico de la tarjeta según nvidia-smi (muestras de 1 s): 2.682 MiB (2,81 GB) con solo Bark cargado, 17.027 MiB con Qwen3-ASR cargado al lado (sglang reserva el 45 % de la tarjeta por configuración, así que esto no es lo que necesita Qwen). Transformers avisa en cada llamada de que usa el max_length predeterminado genérico (de 1.000 a 1.300), igual que el runner de los autores. No vimos ningún truncado.
Tiempo hasta estar listo: primer arranque de Bark, 322 s (venv y pip de PyTorch con las librerías de CUDA y transformers, unos 300 s; descarga del snapshot, 4,0 s; carga, 2,4 s). Reinicios en caliente: 7,6 s (límite de 4 GiB), 7,3 s (límite de 2 GiB), 8,1 s (límite de 2 GiB más trozos), 6,9 s (CPU, 16 hilos), 6,7 s (CPU, 4 hilos), 8 s (main.py final). Primer arranque de Qwen3-ASR, 357 s (unos 235 s de ellos instalando sglang).
Escalera de VRAM:
| GPU o límite | Configuración | Pico | Tiempo | Salida | Real o emulado |
|---|---|---|---|---|---|
| RTX 3090 24 GB | bf16, una petición | 2,151 GiB asignados, 2.682 MiB de tarjeta | 40 clips 4,864 s; 5 min 2,833 s (107x) | referencia, 6,28 % | real |
| Límite de 4 GiB | bf16, una petición | 2,151 GiB | 40 clips 4,909 s; 5 min 2,644 s | 6,28 %, textos idénticos | emulado |
| Límite de 2 GiB | bf16, una petición | 1,243 GiB en los clips | clips 4,889 s | clips OK; 5 min: CUDA out of memory. Tried to allocate 476.00 MiB ... 2.00 GiB allowed | emulado |
| Límite de 2 GiB | bf16, BARK_CHUNK_SECONDS=60 | 1,369 GiB | clips 4,94 s; 5 min 2,476 s (123x) | textos idénticos en los 40 clips | emulado |
| CPU, 16 hilos, AMD EPYC 7C13 | float32, trozos de 60 s | sin GPU | clips 20,478 s (17x); 5 min 14,082 s (21,5x) | textos idénticos en los 40 clips | real |
| CPU, 4 hilos | float32, trozos de 60 s | sin GPU | clips 37,934 s (9,2x); 5 min 30,817 s (9,8x) | textos idénticos en los 40 clips | real |
| RTX A2000 6 GB, RTX 2000 Ada, RTX A4000, RTX 3070, RTX 3080, RTX 4070 Ti, RTX 4000 Ada | tarjeta pequeña real | sin ejecutar: ninguna disponible | tarjeta real, sin probar |
Tampoco probamos: fp16 en una tarjeta anterior a Ampere, int8, los checkpoints más pequeños Bark 3.0 y Plus (otro formato, model.bark), las rutas de Apple Core ML y MLX.
Salidas de ejemplo
earnings22-01(9,26 s): las dos transcripciones citadas en el texto. Bark 14,3 % (0,79 s de ida y vuelta en la primera ejecución), Qwen 20,0 %. Las dos añaden "Thank you", que el fragmento de referencia corta.librispeech_other-03(18,6 s): Bark "At a quarter to ten, a valet entered. He composed with a little groom ..." en 0,62 s de ida y vuelta, 0 % de WER.
Vídeo de la demo
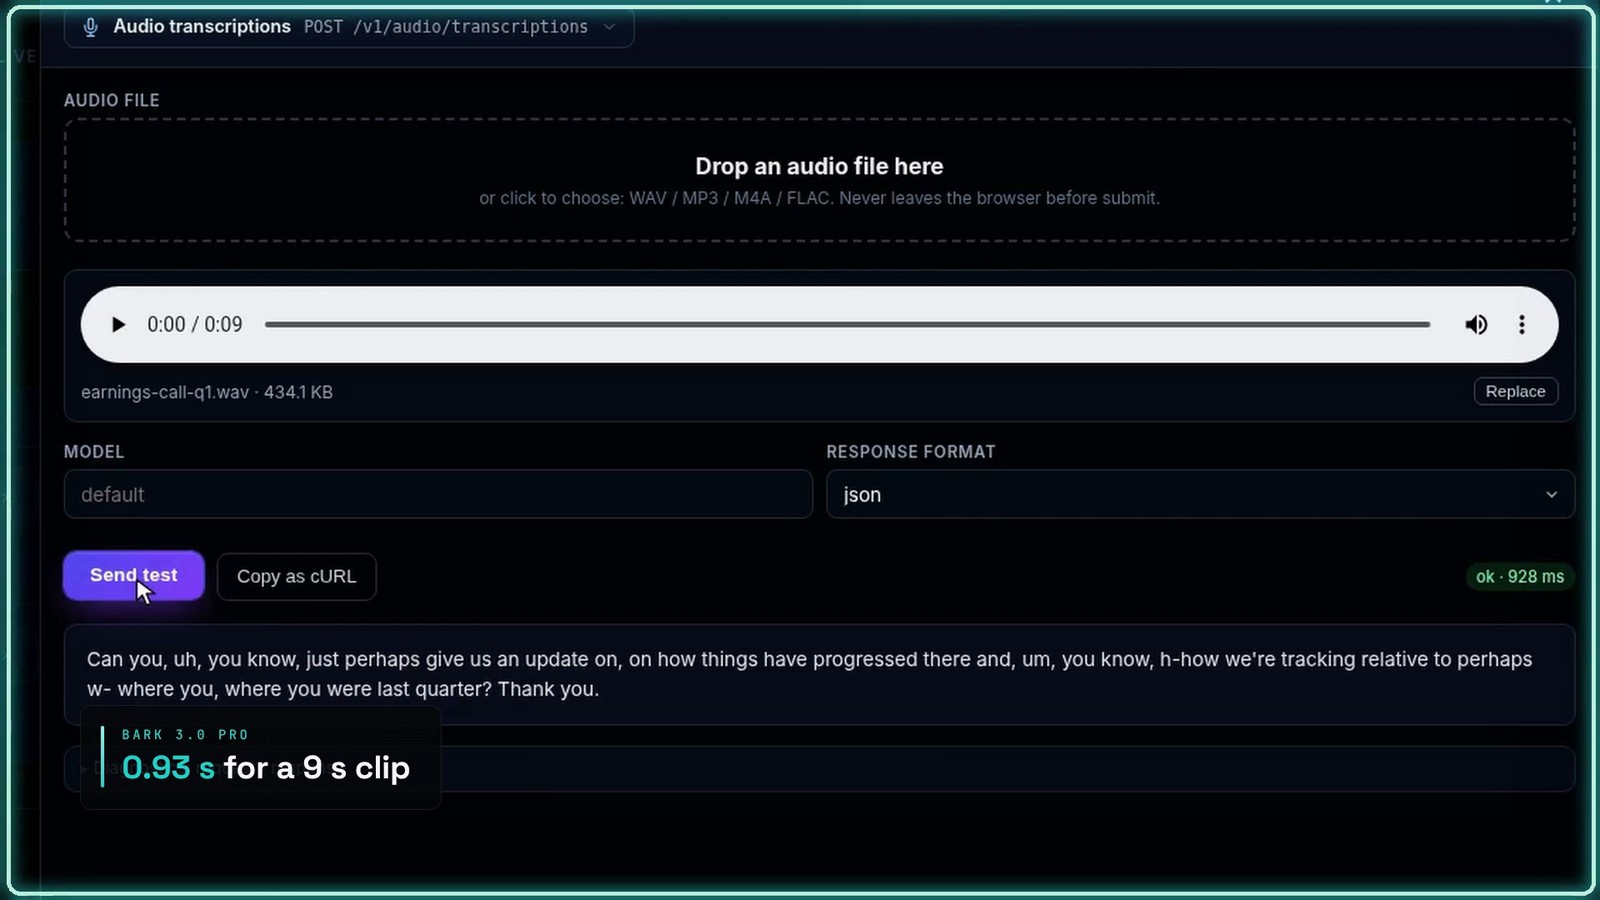
148 s. Capítulos: el modelo (la página de los autores con el reconocimiento en pantalla, y su benchmark marcado como "not reproduced by us"), nuestra prueba (los dos modelos en una RTX 3090, el clip de la conferencia de resultados en 928 ms y 1.039 ms, el WER de los 40 clips) y qué hardware. El vídeo dice "under three seconds" para cinco minutos de audio: 2,833 s de tiempo de GPU, 4,48 s de ida y vuelta.
Problemas encontrados
- Límite de 2 MiB en el cuerpo de
/v1/audio/transcriptions(abierto).POST /endpoint/.../v1/audio/transcriptionscon un WAV de 9,7 MB devolvió413 Payload Too Large: Failed to buffer the request body: length limit exceeded. Encrates/manager/src/api/openai.rs, solo las rutas de chat y messages recibenDefaultBodyLimit::max(8 MiB). La ruta de transcripciones se queda con el valor por defecto de axum, 2 MiB, unos 65 s de WAV mono de 16 bits a 16 kHz. Solución: Opus a 40 kbps (1,1 MB para 5 minutos), MP3, o partir el fichero. El límite se confirmó en una copia posterior del manager; la compilación que probamos se borró con su worktree. - Volver a ejecutar
ensure()con la misma especificación sobre un workload de backend a medida ya listo (abierto).wait_until_ready()se quedó en[0s] schedulingdurante 10 minutos. El worker registrócustom backend: driven by ProjectConfigSnapshot; skipping legacy LoadModel, y el endpoint siguió sirviendo (una llamada directa respondió en 0,73 s). Solución: borrar antes el workload.main.pysiempre llama aensure()antes dewait_until_ready(), así que transcribir sin desplegar obliga a editar el script. - Qwen3-ASR en sglang trunca una petición larga única (sin investigar): 212 de unas 700 palabras para el fichero de cinco minutos con los valores por defecto del ejemplo. Que sea un límite de salida por defecto de sglang es una suposición que no hemos comprobado.
- El disco de la máquina de desarrollo estaba lleno al empezar (el MinIO local respondió
XMinioStorageFullal subir el backend). Liberamos solo nuestros propios ficheros, y después la subida funcionó. - Ninguna GPU pequeña disponible para el peldaño de tarjeta real: siete tipos de tarjeta (de 6 a 20 GB), ocho intentos (RTX A4000 en dos pools), todos rechazados.
Límites de esta prueba
- 40 clips y 924 palabras, una petición cada vez, decodificación greedy. Conjuntos sin limpiar, así que no comparables con la tabla de la ficha.
- No reprodujimos las cifras de la clasificación que da la ficha.
- Una sola GPU real (RTX 3090). Las GPU más pequeñas, solo como límites de memoria emulados, que no copian un chip más lento.
- Corrió a través de un manager local de InferenceKey en nuestra nube, no del servicio alojado.
Fuentes
- Ficha del modelo y ficheros: ConwayResearch/Underdog-Bark-3.0-Pro, ConwayResearch/Underdog-Bark-3.0.
- Anuncio: underdog.ai/bark.
- Modelo base: nvidia/parakeet-tdt-0.6b-v3.
- Clasificación y datos de prueba: hf-audio/open_asr_leaderboard, dataset
hf-audio/open-asr-leaderboard. - Dónde lo vimos: vídeo de noticias de AI Search, 25 de octubre de 2026, segmento de Bark de 03:10 a 04:53.
- Nuestro código: ejemplo del SDK, commit
fb18916b. - Licencias: Bark 3.0 Pro CC-BY-4.0 (NVIDIA, Moondream, Conway Research). Qwen3-ASR-1.7B, del equipo de Qwen, Apache-2.0 según el README de nuestro SDK.