MemT-1.0-Nano guarda la memoria de un chat en un fichero de 41,9 MB, y acertó 9 de 9 preguntas tras recargarlo
MemT-1.0-Nano en una A100 de 80 GB: datos guardados en un fichero fijo de 41,9 MB, recargado en una sesión vacía en unos 2 s, 9 de 9 recordados.
Un fichero de 41,9 MB y una sesión de chat vacía: el modelo seguía sabiendo que el código del proveedor de harina era BX-4471. Ese modelo es MemT-1.0-Nano, un modelo abierto de MemTensor. Escribe los turnos pasados en una memoria de tamaño fijo que puedes guardar en un fichero y volver a cargar más tarde. Le contamos unos cuantos datos, guardamos el fichero y cerramos la sesión. Después cargamos el fichero en una sesión nueva, con cero mensajes. Acertó 9 de 9 preguntas sobre esos datos. Para quien tiene sus propias GPU, una sesión pasa a ser un fichero de tamaño fijo que se recarga en unos dos segundos, en lugar de un historial que el modelo tiene que releer. Los límites están claros. Necesita una tarjeta de 80 GB, la primera versión es lenta y los propios autores reconocen que los mejores sistemas de memoria basados en texto siguen recordando mejor los historiales largos y detallados. Así que merece un piloto para medir el recuerdo sobre tus propios historiales largos, y todavía no una apuesta para un producto que tenga que citar al pie de la letra detalles antiguos.
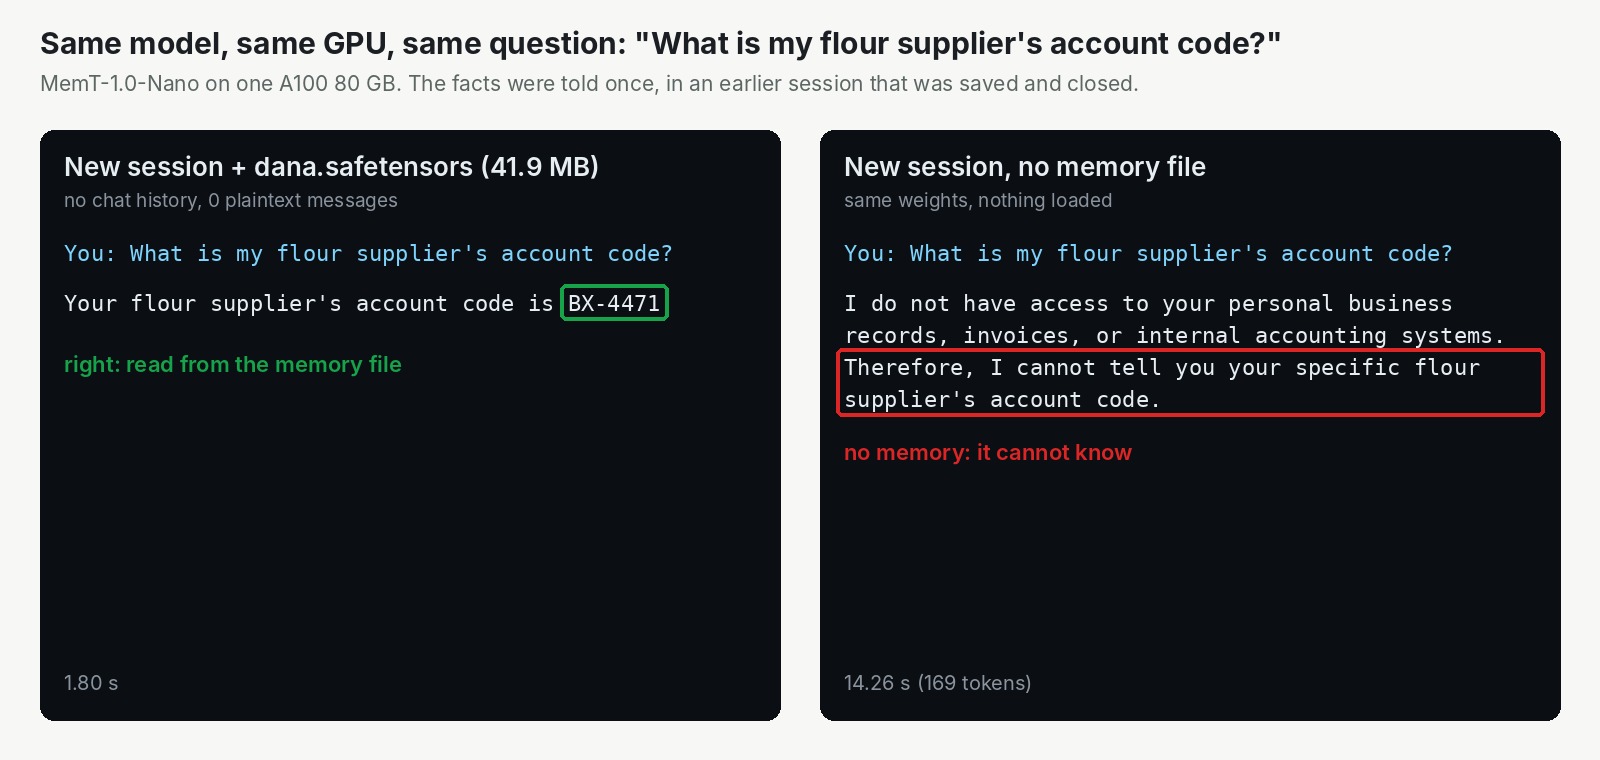
Las dos sesiones empiezan vacías. La única diferencia es el fichero de 41,9 MB de la izquierda.
Los turnos pasados se pliegan en una memoria de tamaño fijo que puedes guardar, en lugar de un historial que crece
Imagina una cinta y una libreta. La mayoría de los modelos de chat trabajan con una cinta. Cada mensaje se queda, y el modelo relee la cinta entera antes de cada respuesta. La cinta crece con cada turno, y con ella el espacio de trabajo que ocupa en la tarjeta gráfica. Cuando la sesión termina, ese espacio de trabajo se tira y la cinta vuelve a una base de datos.
MemT-1.0-Nano tiene una libreta. Cuando le dices que recuerde un turno, pliega lo dicho en un conjunto de números de tamaño fijo y después descarta el texto. La libreta nunca engorda. Puedes guardarla como fichero, cerrarlo todo y devolvérsela mañana. El precio del tamaño fijo es el detalle: la libreta guarda lo que marcaste, no cada palabra.
El modelo es obra de MemTensor, construido sobre Qwen3.6-35B-A3B, del equipo de Qwen. Los pesos son Apache-2.0, así que puedes usarlos con fines comerciales.
La prueba: una tarjeta de 80 GB, datos inventados, guardar, cerrar y recargar
Esto es una comprobación de comportamiento, no un benchmark. Usamos los pesos publicados tal cual, sin comprimir, en una A100 de 80 GB. El modelo corrió con el código de los propios autores, detrás de una copia de prueba de InferenceKey compilada desde su código más reciente.
Nos inventamos una clienta, Dana, que tiene una panadería. En dos turnos le contó al modelo el nombre y la ciudad de su panadería, su horno, el código de cliente de su proveedor de harina, una alergia al sésamo y el día en que su hija empieza el colegio. Guardamos la memoria, cerramos la sesión, abrimos una nueva desde el fichero e hicimos cuatro preguntas. Después hicimos una versión más difícil. Una nota larga de 1.467 tokens (los tokens son trozos de palabra) contenía cuarenta frases de rutina de panadería con cinco datos escondidos dentro, seguida de cinco preguntas. En total, nueve preguntas de recuerdo, más una hecha a una sesión sin el fichero, un usuario cada vez.
Resultados: 9 de 9 datos recuperados del fichero, y una sesión en blanco que no sabía nada
Todas las preguntas sobre los datos salieron bien tras la recarga. El control fue una sesión nueva sin el fichero, a la que preguntamos por el código del proveedor. Dijo que no tenía acceso a sus registros y que no podía decírselo.
| Pregunta, tras la recarga | Respuesta | Segundos |
|---|---|---|
| ¿Mi panadería y mi ciudad? | "Forno Azul, and it is located in Porto." | 2,05 |
| ¿El código de cliente de mi proveedor? | "BX-4471." | 1,80 |
| ¿Un pan para el fin de semana, con mi alergia? | Un pan de masa madre portugués, "naturally free of sesame" | 6,72 |
| ¿Cuándo empieza el colegio mi hija? | "Your daughter, Ines, starts school on September 9." | 1,83 |
| Código del proveedor, sesión nueva sin el fichero | "I do not have access to your personal business records" | 14,26 |
Tiempo en la tarjeta para cada respuesta. Las respuestas más largas tardaron más: la del pan y la negativa de 169 tokens del control.
El control solo demuestra que el fichero lleva información.
Con la nota larga pasó lo mismo. Los cinco datos escondidos volvieron, cada respuesta corta en 1,55 a 2,45 segundos. Plegar la nota en la memoria llevó 4 segundos.
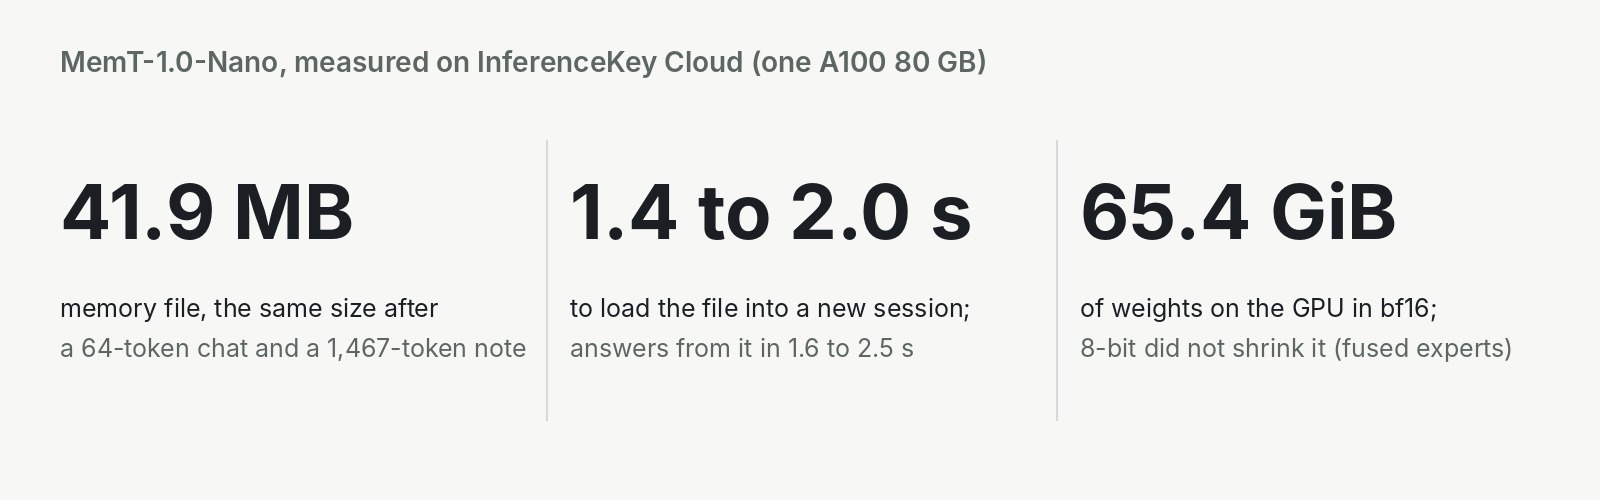
El fichero se quedó exactamente en 41.944.024 bytes, tras las dos líneas de Dana y tras la nota larga. Guardarlo llevó alrededor de un segundo (de 0,66 a 1,02 s). Cargarlo en una sesión nueva llevó entre 1,35 y 1,99 segundos en la tarjeta.
Hay un comportamiento que importa si construyes encima. Solo los turnos que marcas como "remember" entran en la libreta. Las preguntas normales se quedan en la sesión como texto plano, como en cualquier modelo de chat. Así que es la aplicación la que decide qué se guarda en la memoria, no el modelo.
El texto siempre ocupa menos en disco, y el fichero solo compensa con historiales largos
Un chat de soporte corto no gana nada. Un asistente que conoce a una persona durante meses, sí podría.
Guardada como texto, una conversación siempre ocupa menos que este fichero. El historial de Dana eran 107 tokens, unos cientos de bytes. Así que el fichero no ahorra disco.
Lo que sí puede ahorrar es la relectura. Un modelo que trabaja con la cinta reconstruye el espacio de trabajo a partir del historial completo antes de responder, y lo mantiene en la tarjeta mientras la sesión está viva. Ese espacio de trabajo crece con cada token. Según nuestras cuentas, el fichero solo ocupa menos que él a partir de unos 2.000 tokens de historial, algo más que nuestra nota larga. Con 128K tokens, el fichero es unas 64 veces más pequeño.
En velocidad el punto de equilibrio llega mucho más tarde. De principio a fin, el paper vio a Nano más lento con historiales cortos, más o menos igual con 32.000 tokens (más de veinte veces nuestra nota larga) y unas 1,86 veces más rápido con 128K. No medimos ninguna de las dos cosas. Las cifras de tamaño son cuentas nuestras, las de velocidad son del paper.
Dónde se queda corto: los mejores sistemas de memoria en texto van muy por delante con historiales largos y detallados
Los autores dicen que los mejores sistemas que guardan la conversación como texto y buscan el pasaje adecuado siguen ganando, y por mucho. En los 11 benchmarks de memoria de su paper, Flash, el hermano mayor de Nano, queda primero y Nano segundo entre los modelos que guardan la memoria como números dentro del modelo. Los mejores sistemas de memoria en texto, y simplemente conservar la conversación entera, sacan entre 1,4 y 1,5 veces el 47,0 de Nano.
La distancia es mayor cuando importa un detalle de hace mucho. En una prueba de historiales de chat largos, Nano saca 32,6 frente a 76,8 si se conserva la conversación completa. La ficha lo dice en una línea: "Strong textual-memory systems remain ahead overall, particularly on long histories that require detailed evidence retrieval."
Es otra vez la libreta. Guarda lo esencial y los datos que marcaste, en un espacio fijo. Si tu producto tiene que citar una cláusula exacta de un contrato firmado hace seis meses, quédate con un almacén de texto. Nuestras nueve preguntas eran datos cortos que se le acababan de contar al modelo. Demuestran que guardar y recargar funciona. No demuestran el recuerdo a lo largo de mucho tiempo, y en nuestra prueba nadie escribió muchas memorias a lo largo del tiempo para ver si los datos nuevos desplazan a los antiguos.
En seis pruebas generales saca más o menos lo mismo que el modelo de Qwen sobre el que está construido (0,9 puntos menos de media), con una prueba de programación 5,8 puntos por debajo.
Qué GPU: funcionó una tarjeta de 80 GB, y el atajo de 8 bits falló
La tarjeta más pequeña que funcionó es la que usamos: una A100 de 80 GB, con el modelo sin comprimir y todo en la tarjeta. En el pico usó unos 66,5 GiB de la memoria de la tarjeta. No encontramos nada más pequeño que funcionara.
Intentamos apretarlo. Primero limitamos la A100 a lo que de verdad puede usar una tarjeta de 48 GB y cargamos el modelo comprimido a 8 bits. Se quedó sin memoria al cargar, porque primero pidió unos 64 GiB. Después ejecutamos el mismo modelo de 8 bits en la tarjeta real de 80 GB, sin límite, para ver por qué. Ocupó más o menos la misma memoria, y el primer "remember" cayó con un error interno. La mayoría de los pesos están guardados en una forma que la herramienta de 8 bits se salta, así que la compresión solo ahorró unos 2 GiB.
Esa prueba de 48 GB fue un límite sobre la A100, no una tarjeta real de 48 GB, y no probamos otras formas de reducir el modelo. MemTensor no publica ninguna versión comprimida. Cuenta con una tarjeta de 80 GB.
En InferenceKey: un fichero de memoria detrás de un endpoint al estilo de OpenAI, listo en 20 segundos
Una sola copia del modelo en una tarjeta alquilada mantiene sesiones con nombre, cada una con su fichero de memoria en disco, detrás de una API de chat estándar con un campo extra. Nuestro worker, un programa en tu máquina con GPU, carga el modelo una vez y mantiene vivas esas sesiones. Solo el código Python de los autores gestiona su memoria, así que lo envolvimos en un fichero pequeño. El campo extra dice remember, ask, save, close o load.
El primer arranque descargó 70,3 GB de pesos en unos cuatro minutos. Con ellos ya en disco, un reinicio estuvo listo en 20 segundos, 14,8 de ellos cargando el modelo en la tarjeta. Una respuesta de 128 tokens a un turno "remember" tardó unos 13 segundos, que es lento. No instalamos los componentes opcionales más rápidos ni lo afinamos.
Un problema con el que probablemente te encontrarás, y su estado:
- Cargar desde la carpeta de descargas de Hugging Face falla. Cargar el modelo desde la carpeta donde Hugging Face guarda sus descargas se para con un error de "file not found". Estado: arreglado en el ejemplo del SDK cargando por el nombre del modelo y una versión fijada.
El código de Hugging Face que ejecutamos es Apache-2.0, y es la ruta lenta. En nuestro backend las peticiones van una detrás de otra, y no probamos concurrencia. El servidor SGLang de dos GPU de los autores tiene licencia solo para uso no comercial, y no lo probamos.
¿Deberías usarlo? Merece un piloto con tus propios historiales largos, todavía no una apuesta de producción
- Si construyes un asistente que acompaña a una persona durante semanas, haz un piloto y mide el recuerdo con tus propios historiales largos. La memoria es un fichero que puedes guardar, copiar, mover y borrar por persona.
- Si tus conversaciones son cortas, sáltatelo.
- Si necesitas detalles exactos de historiales largos, quédate con una memoria basada en texto. Las cifras de los propios autores ponen a las mejores muy por delante ahí.
- Si tu tarjeta más grande tiene 48 GB, no encontramos forma de ejecutarlo en ella: no existe versión comprimida y nuestro intento con 8 bits falló.
- Si necesitas velocidad, el código de serie es lento hoy.
Para guardar y recargar un fichero de memoria en tu propia máquina NVIDIA, clona el ejemplo del SDK. Rellena su .env, incluidos INFERENCEKEY_TENANT_ID e INFERENCEKEY_USER_TOKEN para que publish.py pueda subir el backend. Después compila el binding de Python y ejecuta python publish.py y python main.py. Necesita una tarjeta de 80 GB, unos 90 GB de disco local y un driver para CUDA 13 (580 o posterior).
Para ingenieros
Modelo y ficheros
MemTensor/MemT-1.0-Nano, sha30fe0b22422c4cc4c87475f98db5c8baa5c1a902, creado el 2026-10-15, última modificación 2026-10-20T05:49:52Z, sin acceso restringido, Apache-2.0. 26 shards de safetensors másmemt_block.safetensors,configuration_memt.py,modeling_memt.pyytech_report.pdf. 70,3 GB descargados. 18.765 descargas y 123 likes el 2026-10-26.- Ficha: 36B en total, 3B activos, 451M de parámetros de memoria entrenables, 10M de estado de memoria dinámico.
library: transformers, etiquetacustom_code. config.json:model_typememt_qwen3_5_moe,MemTQwen3_5MoeForCausalLM. Backboneqwen3_5_moe: 40 capas confull_attention_interval4 (10 de atención completa, 30 de atención lineal, GatedDeltaNet), hidden 2048, 256 expertos con 8 por token, 16 cabezas de atención, 2 cabezas KV, head_dim 256, vocabulario de 248.320,max_position_embeddings262.144. Bloque memt:gdn_versionstable_gdn2,memory_update_modetoken,num_memory_heads16,chunk_tokens2048.- Publicación: paper el 19 de octubre de 2026, pesos y código el 20 de octubre.
- Hermano
MemTensor/MemT-1.0-Flash: backbone DeepSeek-V4-Flash, 288B en total, 17B activos, 3,61B de parámetros de memoria entrenables, 336M de estado de memoria dinámico, etiqueta de licencia en HFmit. - Licencias: pesos Apache-2.0 (ficha de HF). Todo el código original de
MemTensor/MemT-1.0en GitHub, incluidomemt-sglang, es PolyForm Noncommercial 1.0.0 ("Commercial use of the repository software is not permitted"). El paper es CC BY-NC-SA 4.0.
API de sesión (modeling_memt.py en el sha fijado)
chat(query, *, memory=None, enable_memory=False, enable_thinking=None, return_dict=False). Conenable_memory=Trueel historial en texto del turno se consolida en el estado de memoria y se descarta. Los demás turnos se quedan como historial en texto en la sesión.save_state(path, *, overwrite=False)se niega por defecto a sobrescribir un fichero existente, vuelca los turnos en texto y escribe tensores FP32 como safetensors con el formato de metadatosmemt-memory-v1más un hash de identidad (config, plantilla de chat, vocabulario).- Las sesiones están protegidas por un
threading.RLock. - El estado es un dict de 10 tensores FP32
[1, 16, 256, 256], uno por capa de atención completa: 10 x 16 x 256 x 256 x 4 B = 41.943.040 B. Fichero medido: 41.944.024 B, así que unos 984 B de cabecera y metadatos.
Resumido del Quick Start de la ficha (Python 3.11+, PyTorch 2.11.0 compilado para CUDA 13, pip install transformers==5.12.1 accelerate==1.15.0 safetensors==0.8.0):
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

repo = "MemTensor/MemT-1.0-Nano"
tokenizer = AutoTokenizer.from_pretrained(repo, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    repo,
    trust_remote_code=True,
    dtype=torch.bfloat16,
    device_map="auto",
    attn_implementation="sdpa",
)

session = model.create_session(tokenizer)
session.chat("<facts to remember>", enable_memory=True, enable_thinking=False)
session.save_state("memmy_memory.safetensors")
session.close()

restored = model.create_session(tokenizer, state="memmy_memory.safetensors")
print(len(restored.messages))  # 0
Cuentas de almacenamiento (nuestras, no medidas)
Caché KV simple de este backbone: 10 capas de atención completa x 2 cabezas KV x 256 x 2 (K y V) x 2 B (bf16) = 20.480 B por token. El estado de 41,9 MB equivale a la KV de unos 2.048 tokens. Con 131.072 tokens la KV ocupa 2,68 GB, 64 veces el estado (la ficha y el paper dicen unas 66 veces, como tamaño lógico por trayectoria que excluye los pesos compartidos). Por debajo de unos 2.000 tokens de historial el fichero es más grande que la KV que sustituye. Los estados de atención lineal (GatedDeltaNet) existen en los dos casos y no se cuentan. El paper también señala que el almacenamiento de DenseRAG es más barato que el estado fijo de Nano con historiales cortos y solo lo supera a medida que se acumulan registros.
Nuestro montaje
- Una NVIDIA A100-SXM4-80GB en nuestra nube, driver 595.91.07, CUDA 13.2, 170 GB de disco de contenedor (otras dos configuraciones de A100 no tenían stock en ese momento). Pesos en el disco del contenedor, nunca en un volumen de red.
- Un manager local de InferenceKey compilado desde
main, conectado al worker por túneles. Producción no se tocó en ningún momento. - Backend a medida en Python
memt-1-0-nano0.1.1: Transformers 5.12.1 contrust_remote_code, PyTorch 2.11 (CUDA 13).setup()descarga la revisión fijada consnapshot_downloady después carga por id del repo más revisión condtype=torch.bfloat16,device_map={"": 0}(el modelo entero en la GPU 0, sin desbordes silenciosos a CPU) yattn_implementation="sdpa". Decodificación greedy (do_sample=False),max_new_tokens256 por defecto. task_typetext2text, soloprocess(). Las operaciones viajan enextra_body.memt = {"op": "remember" | "ask" | "save" | "close" | "load" | "status", "session": ..., "text" | "name": ...}sobre/v1/chat/completions. También funciona el texto de chat normal (remember: ...,save: <name>,forget,load: <name>, cualquier otra cosa es un ask). Cada respuesta devuelve un JSON con la respuesta, recuentos de tokens, segundos, tokens/s,memory_updated,plaintext_messages_kept, tamaño y sha256 del fichero, y VRAM.
Despliegue paso a paso
Desde el ejemplo del SDK (commit ef656124 en main):
git clone https://github.com/inferencekey/inferencekey-sdk
cd inferencekey-sdk/examples/memt-nano-memory-state-custom-backend-private-nvidia
cp .env.example .env          # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY,
                              # INFERENCEKEY_PROJECT, IK_WORKER_ID, and for the
                              # upload INFERENCEKEY_TENANT_ID, INFERENCEKEY_USER_TOKEN
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )
python publish.py             # once: packages backend.py; uploads only if TENANT_ID and USER_TOKEN are set
python main.py                # deploy, remember x2, save, close, load, ask x4, control ask
- Necesita un driver de NVIDIA para CUDA 13 (580+), una tarjeta de 80 GB, unos 90 GB de disco local y Python 3.11 a 3.13 en el worker.
- Env opcional:
MEMT_MAX_NEW_TOKENS(256 por defecto),IK_KEEP_ALIVE=1para conservar el workload tras la ejecución,MEMT_LOAD_IN_8BIT=1(bitsandbytes; ver la escalera, falla),MEMT_GPU_CAP_GIB(torch.cuda.set_per_process_memory_fraction, para emular una tarjeta más pequeña),MEMT_REVISION. main.pyescribe cada petición, respuesta, recuento de tokens y tiempo enoutputs/memory-test.json.
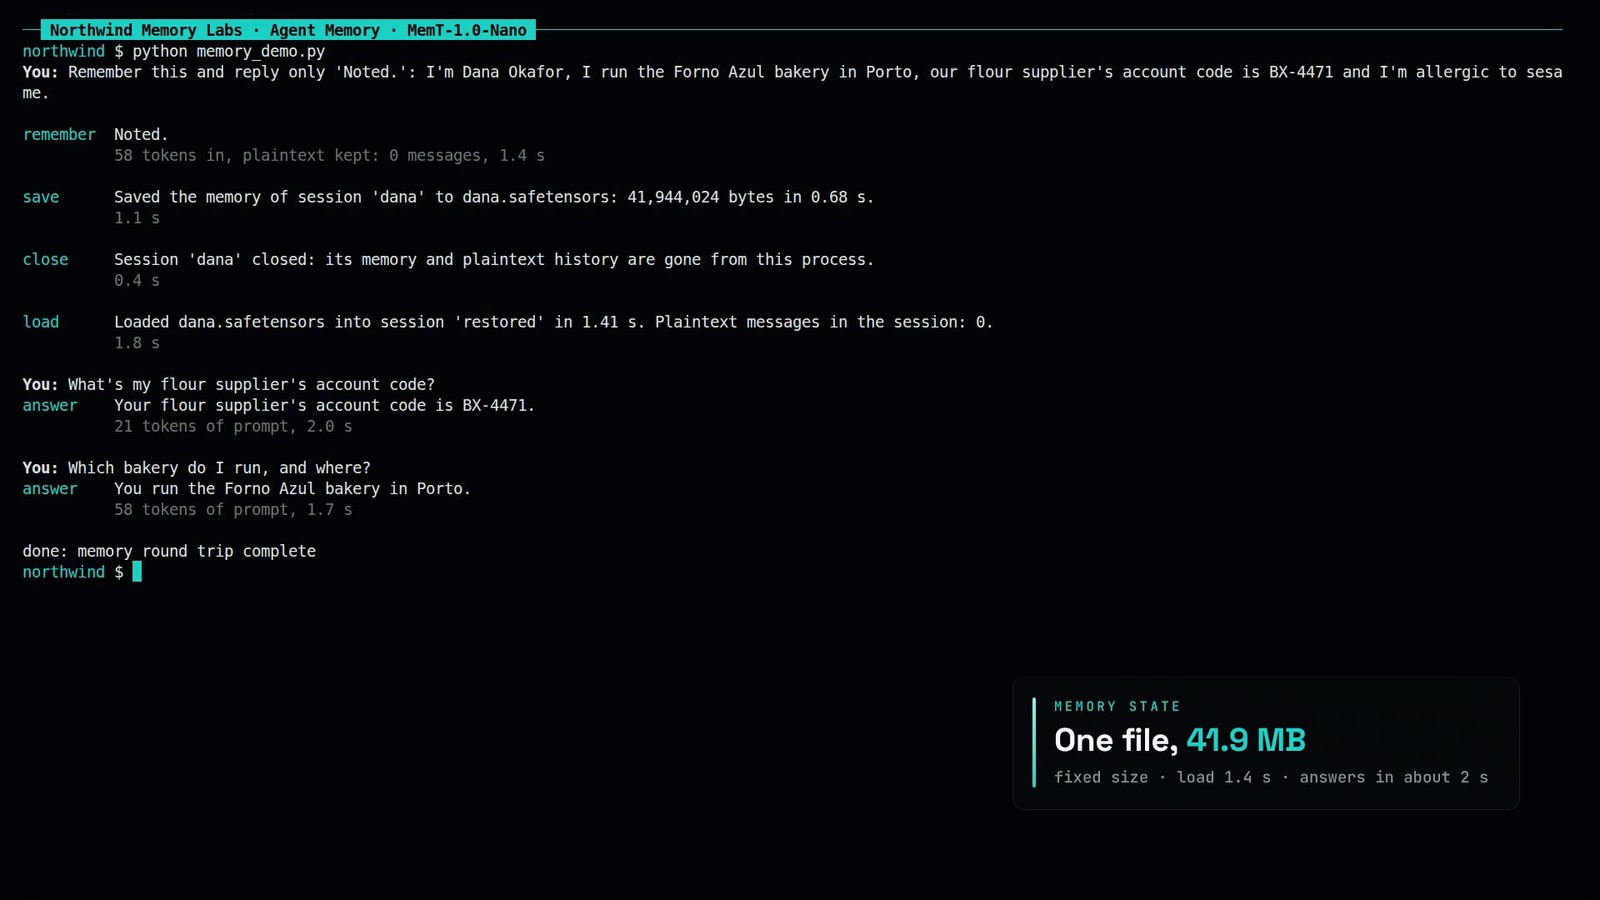
La demo de 65 segundos: remember, save, close, load y ask, desde un cliente de terminal contra el worker.
Tiempo hasta estar listo
| Fase | Tiempo |
|---|---|
| venv del backend | unos 23 s |
| Descarga de pesos (37 ficheros, 70,3 GB, sin autenticar, unos 300 MB/s) | 235,5 s |
| Primera carga (backend 0.1.0) | falló, ver el problema 1 |
Arranque en caliente, de ensure() a listo | 20,3 s (carga del modelo 14,8 s), 20,0 s en la segunda ejecución |
| Arranque en caliente, 8 bits | 29,8 s (carga del modelo 24,3 s) |
Mediciones
Prueba de memoria, ejecución 2 (bf16; los segundos son tiempo de GPU en el backend, la ida y vuelta añade de 0,3 a 1,1 s):
| Paso | Tokens de entrada | Tokens de salida | Segundos | Resultado |
|---|---|---|---|---|
| remember 1: nombre, Forno Azul en Oporto, horno Rational iCombi Pro, código de proveedor BX-4471 | 64 | 128 | 12,72 | respuesta, texto conservado 0 |
| remember 2: alergia al sésamo, su hija Ines empieza el colegio el 9 de septiembre | 43 | 53 | 5,68 | "Noted! ...", texto conservado 0 |
save dana | 1,02 | 41.944.024 B | ||
| close | sesión eliminada | |||
load dana en una sesión nueva | 1,99 | 0 mensajes en texto | ||
| ask: panadería y ciudad | 27 | 19 | 2,05 | correcto |
| ask: código del proveedor | 68 | 16 | 1,80 | correcto |
| ask: pan para el fin de semana con la alergia | 113 | 71 | 6,72 | correcto (masa madre portuguesa sin sésamo) |
| ask: nombre de la hija y fecha del colegio | 210 | 16 | 1,83 | correcto |
| control: sesión nueva, sin fichero, código del proveedor | 21 | 169 | 14,26 | se niega, no lo sabe |
Los tokens de entrada crecen de 27 a 210 en la sesión restaurada porque los turnos ask se quedan como historial en texto. La primera comprobación por palabras clave de main.py dio la fecha del colegio como fallo porque buscaba "9 september"; leyéndola, es correcta, y la comprobación del commit es más laxa.
Prueba de entrada larga (bf16, MEMT_MAX_NEW_TOKENS=96): un remember de 1.467 tokens de entrada, respuesta "Noted.", 4,02 s, texto conservado 0. Save 0,66 s, 41.944.024 B. Load 1,35 s. Cinco de cinco recordados: código de la nevera 5832 (1,55 s), casero Rui Matos con el alquiler el día 3 (2,01 s), póliza PT-77-0912 (1,76 s), tarta Silva el 14 de noviembre, de limón y tres pisos (2,45 s), técnico de reserva Marta con un teléfono acabado en 4410 (2,21 s).
Cliente de la demo: remember de 58 tokens, "Noted." en 1,4 s; save 0,68 s; load 1,41 s; "BX-4471" en 2,0 s (prompt de 21 tokens); "Forno Azul bakery in Porto" en 1,7 s (prompt de 58 tokens).
Velocidad: unos 9 a 10 tokens/s de decodificación (128 tokens en 12,72 s) con los kernels GatedDeltaNet de referencia de PyTorch (flash-linear-attention y causal-conv1d sin instalar) y generate de HF. Sin afinar.
Memoria de GPU, bf16: 65,4 GiB reservados tras la carga, de 65,45 a 65,55 GiB de pico reservado durante las peticiones, 67.605 MiB en la tarjeta en reposo tras la carga, 68.117 MiB de pico en la tarjeta (nvidia-smi, muestras cada 1 s). El texto principal los da en GiB (66,5 GiB de pico; la carga de 8 bits pidió 63,67 GiB).
Escalera de VRAM
| GPU o límite | Config | Pico de VRAM | Tiempo por salida | ¿Salida correcta? | Real o emulada |
|---|---|---|---|---|---|
| A100-SXM4 80 GB | bf16, Transformers 5.12.1, sdpa, el modelo entero en la GPU 0 | 68.117 MiB en la tarjeta (65,5 GiB reservados) | ask de 1,6 a 2,5 s, unos 9 a 10 tokens/s | sí, 9/9 recordados | real |
| 48 GB (límite de torch de 44 GiB en la A100) | bitsandbytes 8 bits | falló al cargar | no: torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 63.67 GiB ... 44.00 GiB allowed | emulada | |
| A100 80 GB, sin límite (diagnóstico) | bitsandbytes 8 bits | 67.695 MiB en la tarjeta (63,67 GiB reservados) | no: el primer remember falla con expected mat1 and mat2 to have the same dtype, but got: c10::BFloat16 != signed char | real |
Por qué 8 bits apenas reduce: los 256 expertos fusionados por capa son parámetros 3D, no nn.Linear, así que bitsandbytes los deja en bf16 (unos 2 GiB ahorrados). Sin probar: una tarjeta real de 48 GB, H100, descarga a CPU, fp8, cuantizaciones de la comunidad (ninguna de MemTensor en el momento de la prueba). La más pequeña que pasó: una A100 de 80 GB en bf16.
La ruta SGLang de los autores (sin probar)
memt-sglang(import memt_sglang) enMemTensor/MemT-1.0: memoria de sesión nativa sobre SGLang 0.5.16. Fija PyTorch 2.11.0, Transformers 5.12.1,flashinfer-python[cu13]0.6.14,sglang-kernel0.4.5. PolyForm Noncommercial 1.0.0.inference/start_memt_nano.sh:CUDA_VISIBLE_DEVICES=0,1,--tp-size 2 --ep 1 --dp-size 1,--max-prefill-tokens 16384,--max-sessions-per-rank 6,--max-inflight-commits-per-rank 2,--min-kv-tokens 2048,--max-total-tokens 65536,--max-running-requests 8,--mem-fraction-static 0.60,--dtype bfloat16, backends triton de atención, atención lineal y MoE, snapshots en./memt-state, puerto 30000. La guía dice que estos ajustes no están "deeply optimized".- Restricciones: ejecución eager en un solo nodo, solo safetensors BF16 sin cuantizar; el chunked prefill, la radix cache, el overlap scheduling y los CUDA graphs tienen que seguir desactivados; el lanzador rechaza
trust_remote_code. - Los snapshots son
.safetensorsen el servidor, bajo--state-directory. Rutas:GET /memt/identity,GET /memt/capabilities,POST /memt/control,POST /generatecon un RID de MemT. Leases (TTL de 1 a 3600 s, 300 por defecto), transacciones y épocas; un reinicio del servidor necesita una sesión nueva más la importación de un snapshot. Los snapshots de HF y las exportaciones del servidor son intercambiables para el mismo modelo y tokenizer. - Si mete Nano en una sola tarjeta de 80 GB, y su throughput, no están documentados y no se probaron.
- No encontramos soporte de vLLM para MemT. El lanzador de
memt-sglanges la integración propia de los autores, no SGLang de serie.
Cifras del paper (no reproducidas)
arXiv 2610.26825, "MemT-1.0: Towards Memory-Native Evolution", MemTensor Team, v1 del 19 de octubre de 2026, v2 del 20 de octubre. 34B tokens de entrenamiento, preentrenamiento continuado más post-entrenamiento, Gated DeltaNet-2 con una actualización de memoria estable a nivel de token, Mixture-of-Storage.
- Tabla 2, 11 benchmarks de memoria, media: MemT-1.0-Flash 50,6, MemT-1.0-Nano 47,0, Temp-LoRA 38,1 (el mejor otro método paramétrico). Memoria en texto sobre el backbone Qwen3.6-35B-A3B: MemOS 68,5, Full Context 66,3, Mem0 66,0, OpenViking 65,4, DenseRAG 56,5, Graphiti 45,7. Nano en LongMemEval-S 32,6 frente a Full Context 76,8 y MemOS 80,8; en BEAM-1M 35,8 frente a MemOS 71,3.
- Tabla 3, capacidades generales en el escenario con ruido, diferencia frente a Qwen3.6-35B-A3B: MMLU-Pro -1,6, GPQA Diamond -1,5, IFEval +3,3, LongBench v2 -2,0, BigCodeBench-Hard +2,0, LiveCodeBench v6 -5,8, media -0,9.
- Sección 6.5, inferencia con HF en dos GPU, concurrencia 1, historiales de BEAM: más lento que el contexto completo con historiales cortos, más o menos igual con 32K, aceleraciones de principio a fin de unas 1,20x con 64K, 1,86x con 128K y 3,99x con 256K. TTFT de la consulta (tiempo hasta la primera palabra de la respuesta) de unos 104 a 112 ms frente a unos 257 ms (128K) y 445 ms (256K) con contexto completo.
- Secciones 4.3 y 6.6: estado por trayectoria unas 33 veces más pequeño que el contexto completo con 64K y 66 veces con 128K.
Problemas pendientes y estado
- Cargar desde la ruta del snapshot de la caché de HF falla con
trust_remote_code.from_pretrained(<snapshot dir>)lanzaFileNotFoundError: ... models--MemTensor--MemT-1.0-Nano/blobs/configuration_memt.py, porque Transformers sigue el enlace simbólico demodeling_memt.pyhastablobs/y resuelve allí el import relativo. Estado: arreglado en el backend 0.1.1 cargando por id del repo más revisión. - 8 bits no entra en una tarjeta más pequeña (escalera de arriba). Estado: sin solución; hace falta una cuantización oficial o una cuantización que tenga en cuenta los expertos.
- Cambiar
config.enven un workload de backend a medida en marcha no hace nada. El manager envíareload_backendy el worker registrareload_backend handle_load_model failed: unknown backend memt-1-0-nano; el backend antiguo sigue sirviendo. Solución temporal: borrar el workload y volver a ejecutarmain.py. Estado: abierto. - La creación manual de máquinas GPU ignora el ajuste de disco. El handler fija en el código
DEFAULT_POD_DISK_GB = 100y ya no leeRUNPOD_CONTAINER_DISK_GB. 70,3 GB de pesos más un venv de torch van justos en 100 GB. Estado: parcheado en local solo para esta prueba, abierto. - El probador de chat del panel no puede manejar un backend solo con
process()(hace streaming). La demo usó un cliente de terminal. Estado: conocido, abierto. - El fichero de estado no puede viajar por la API (41,9 MB frente a un límite de resultado de 8 MB). Estado: así por diseño de momento; se queda en el disco del worker y la API devuelve tamaño y sha256.
- Los túneles entre nuestro manager de prueba y el worker se cayeron una vez; un bucle supervisor los reconectó sin reiniciar el worker.
Límites
Nueve preguntas de recuerdo más un control sobre datos inventados por nosotros (dos más en el cliente de la demo), decodificación greedy, peticiones de una en una. La sesión de HF usa un lock por sesión y el backend serializa las peticiones, así que el throughput con varios usuarios es desconocido. Un solo tipo de tarjeta. No se reprodujo ningún benchmark del paper, y nuestro 64x es aritmética, no una medición. No medimos el tiempo de relectura ni la memoria de tarjeta por sesión frente a una referencia de contexto completo. El endpoint alojado de InferenceKey está sin probar: esto corrió en un manager de prueba local.
Créditos
MemTensor construyó MemT-1.0, entrenó el bloque de memoria, escribió la API de sesión, la integración con SGLang y el paper, y publicó los pesos de Nano bajo Apache-2.0. El equipo de Qwen hizo Qwen3.6-35B-A3B, el backbone de Nano. Hugging Face Transformers ejecuta el código a medida de los autores. Vimos el modelo en el vídeo de noticias de AI Search del 25 de octubre, y r/LocalLLaMA tuvo un hilo sobre él el 22 de octubre. Nuestra parte: el backend a medida, el despliegue en InferenceKey, el arreglo de la carga, las pruebas de memoria y las mediciones.