MemT-1.0-Nano speichert das Gedächtnis eines Chats in einer 41,9-MB-Datei und beantwortete nach dem Neuladen 9 von 9 Fragen
MemT-1.0-Nano auf einer A100 mit 80 GB: Fakten in einer festen 41,9-MB-Datei, in etwa 2 s in eine leere Sitzung geladen, 9 von 9 erinnert.
Eine Datei mit 41,9 MB und eine leere Chat-Sitzung: Das Modell wusste trotzdem, dass die Kundennummer beim Mehllieferanten BX-4471 lautet. Das Modell heißt MemT-1.0-Nano, ein offenes Modell von MemTensor. Es schreibt vergangene Turns in ein Gedächtnis fester Größe, das du als Datei speichern und später wieder laden kannst. Wir haben ihm ein paar Fakten erzählt, die Datei gespeichert und die Sitzung geschlossen. Dann haben wir die Datei in eine brandneue Sitzung mit null Nachrichten geladen. Es beantwortete 9 von 9 Fragen zu diesen Fakten. Wer eigene GPUs betreibt, bekommt so aus einer Sitzung eine Datei fester Größe, die in etwa zwei Sekunden wieder geladen ist, statt eines Verlaufs, den das Modell erneut lesen muss. Die Grenzen sind klar. Es braucht eine 80-GB-Karte, die erste Version ist langsam, und die Autoren geben zu, dass die besten textbasierten Gedächtnissysteme lange, detaillierte Verläufe immer noch besser erinnern. Es lohnt sich also ein Pilot, um die Erinnerung an deinen eigenen langen Verläufen zu messen, aber noch keine Wette für ein Produkt, das alte Details exakt zitieren muss.
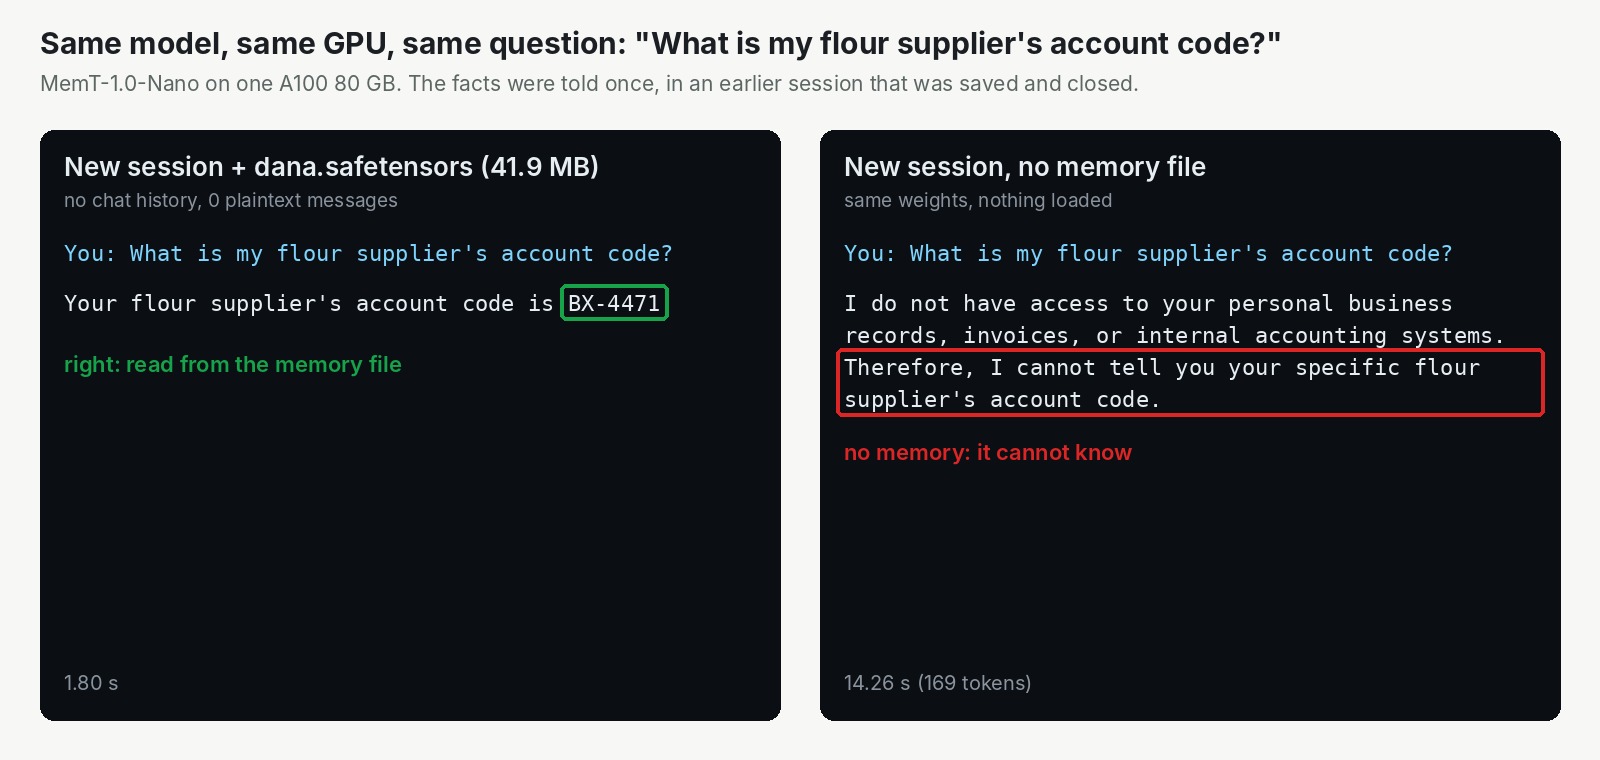
Beide Sitzungen starten leer. Der einzige Unterschied ist die 41,9-MB-Datei links.
Vergangene Turns werden zu einem Gedächtnis fester Größe, das du speichern kannst, statt zu einem wachsenden Verlauf
Stell dir ein Tonband und ein Notizbuch vor. Die meisten Chat-Modelle arbeiten mit einem Tonband. Jede Nachricht bleibt, und das Modell hört vor jeder Antwort das ganze Band noch einmal ab. Das Band wird mit jedem Turn länger, und mit ihm der Arbeitsspeicher, den es auf der Grafikkarte belegt. Endet die Sitzung, wird der Arbeitsspeicher verworfen und das Band wandert zurück in eine Datenbank.
MemT-1.0-Nano hat ein Notizbuch. Wenn du ihm sagst, es soll sich einen Turn merken, faltet es das Gesagte in einen Satz Zahlen fester Größe und verwirft dann den Text. Das Notizbuch wird nie dicker. Du kannst es als Datei speichern, alles schließen und es ihm morgen wieder geben. Der Preis der festen Größe sind Details: Das Notizbuch behält, was du markiert hast, nicht jedes Wort.
Das Modell stammt von MemTensor und baut auf Qwen3.6-35B-A3B vom Qwen-Team auf. Die Gewichte stehen unter Apache-2.0, du kannst sie also kommerziell nutzen.
Der Test: eine 80-GB-Karte, erfundene Fakten, Speichern, Schließen und Neuladen
Das ist eine Verhaltensprüfung, kein Benchmark. Wir haben die veröffentlichten Gewichte unverändert und unkomprimiert auf einer A100 mit 80 GB verwendet. Das Modell lief mit dem Code der Autoren, hinter einer Testkopie von InferenceKey, gebaut aus dem aktuellen Quellcode.
Wir haben eine Kundin erfunden, Dana, die eine Bäckerei führt. In zwei Turns erzählte sie dem Modell den Namen und die Stadt ihrer Bäckerei, ihren Ofen, ihre Kundennummer beim Mehllieferanten, eine Sesamallergie und den Tag, an dem ihre Tochter eingeschult wird. Wir haben das Gedächtnis gespeichert, die Sitzung geschlossen, eine neue aus der Datei geöffnet und vier Fragen gestellt. Dann kam eine schwierigere Version. Eine lange Notiz mit 1.467 Tokens (Tokens sind Wortstücke) enthielt vierzig Sätze Bäckereialltag mit fünf darin versteckten Fakten, gefolgt von fünf Fragen. Insgesamt neun Erinnerungsfragen, plus eine an eine Sitzung ohne die Datei, immer ein Nutzer nach dem anderen.
Ergebnisse: 9 von 9 Fakten kamen aus der Datei zurück, und eine leere Sitzung wusste nichts
Jede Frage zu den Fakten kam nach dem Neuladen richtig zurück. Die Kontrolle war eine neue Sitzung ohne die Datei, gefragt nach der Lieferantennummer. Sie sagte, sie habe keinen Zugriff auf Danas Unterlagen und könne es ihr nicht sagen.
| Frage, nach dem Neuladen | Antwort | Sekunden |
|---|---|---|
| Meine Bäckerei und Stadt? | "Forno Azul, and it is located in Porto." | 2,05 |
| Meine Kundennummer beim Lieferanten? | "BX-4471." | 1,80 |
| Ein Brot fürs Wochenende, mit meiner Allergie? | Ein portugiesisches Sauerteigbrot, "naturally free of sesame" | 6,72 |
| Wann wird meine Tochter eingeschult? | "Your daughter, Ines, starts school on September 9." | 1,83 |
| Lieferantennummer, neue Sitzung ohne die Datei | "I do not have access to your personal business records" | 14,26 |
Zeit auf der Karte pro Antwort. Längere Antworten brauchten länger: die Brot-Antwort und die Weigerung der Kontrolle mit 169 Tokens.
Die Kontrolle zeigt nur, dass die Datei Information trägt.
Bei der langen Notiz lief es genauso. Alle fünf versteckten Fakten kamen zurück, jede kurze Antwort in 1,55 bis 2,45 Sekunden. Die Notiz ins Gedächtnis zu falten dauerte 4 Sekunden.
Die Datei blieb exakt 41.944.024 Bytes groß, nach Danas zwei Zeilen und nach der langen Notiz. Das Speichern dauerte etwa eine Sekunde (0,66 bis 1,02 s). Das Laden in eine frische Sitzung dauerte zwischen 1,35 und 1,99 Sekunden auf der Karte.
Ein Verhalten ist wichtig, wenn du darauf aufbaust. Nur die Turns, die du als "remember" markierst, landen im Notizbuch. Normale Fragen bleiben als Klartext in der Sitzung, wie bei jedem Chat-Modell. Also entscheidet die App, was ins Gedächtnis kommt, nicht das Modell.
Text ist auf der Platte immer kleiner, und die Datei lohnt sich nur bei langen Verläufen
Ein kurzer Support-Chat gewinnt nichts. Ein Assistent, der eine Person über Monate kennt, könnte gewinnen.
Als Text gespeichert ist ein Gespräch immer kleiner als diese Datei. Danas Verlauf hatte 107 Tokens, ein paar hundert Bytes. Plattenplatz spart die Datei also nicht.
Was sie sparen kann, ist das erneute Lesen. Ein Modell, das mit dem Band arbeitet, baut vor jeder Antwort den Arbeitsspeicher aus dem ganzen Verlauf neu auf und hält ihn auf der Karte, solange die Sitzung läuft. Dieser Arbeitsspeicher wächst mit jedem Token. Nach unserer Rechnung wird die Datei erst ab etwa 2.000 Tokens Verlauf kleiner als er, etwas mehr als unsere lange Notiz. Bei 128K Tokens ist die Datei etwa 64-mal kleiner.
Beim Tempo kommt der Gleichstand viel später. End to end fand das Paper Nano bei kurzen Verläufen langsamer, bei 32.000 Tokens (mehr als zwanzigmal unsere lange Notiz) etwa gleichauf und bei 128K etwa 1,86-mal schneller. Wir haben beides nicht gemessen. Die Größenangaben sind unsere Rechnung, die Tempoangaben stammen aus dem Paper.
Wo es nicht reicht: Die stärksten Text-Gedächtnissysteme liegen bei langen, detaillierten Verläufen weit vorn
Die Autoren sagen, dass die stärksten Systeme, die das Gespräch als Text behalten und die passende Stelle nachschlagen, immer noch gewinnen, und zwar deutlich. Über 11 Gedächtnis-Benchmarks in ihrem Paper liegt Flash, Nanos großer Bruder, auf Platz eins und Nano auf Platz zwei unter den Modellen, die ihr Gedächtnis als Zahlen im Modell halten. Die besten Text-Gedächtnissysteme, und auch das schlichte Behalten des ganzen Gesprächs, erreichen etwa das 1,4- bis 1,5-Fache von Nanos 47,0.
Am größten ist der Abstand, wenn ein Detail von weit zurück zählt. In einem Test mit langen Chat-Verläufen erreicht Nano 32,6, gegenüber 76,8, wenn man das ganze Gespräch behält. Die Model Card bringt es in einem Satz auf den Punkt: "Strong textual-memory systems remain ahead overall, particularly on long histories that require detailed evidence retrieval."
Das ist wieder das Notizbuch. Es hält den Kern und die markierten Fakten, auf festem Raum. Wenn dein Produkt eine exakte Klausel aus einem Vertrag zitieren muss, der vor sechs Monaten unterschrieben wurde, behalte einen Textspeicher. Unsere neun Fragen waren kurze Fakten, die dem Modell gerade erst erzählt worden waren. Sie beweisen, dass Speichern und Neuladen funktionieren. Sie beweisen keine Erinnerung über eine lange Lebensdauer, und niemand in unserem Test hat über längere Zeit viele Erinnerungen geschrieben, um zu sehen, ob neue Fakten alte verdrängen.
In sechs allgemeinen Tests schneidet es etwa so ab wie das Qwen-Modell, auf dem es aufbaut (im Schnitt 0,9 Punkte niedriger), bei einem Coding-Test 5,8 Punkte niedriger.
Welche GPU: Eine 80-GB-Karte funktionierte, die 8-Bit-Abkürzung scheiterte
Die kleinste Karte, die funktionierte, ist die, die wir benutzt haben: eine A100 mit 80 GB, Modell unkomprimiert, alles auf der Karte. In der Spitze belegte es etwa 66,5 GiB des Kartenspeichers. Nichts Kleineres hat bei uns funktioniert.
Wir haben versucht, es zu quetschen. Zuerst haben wir die A100 auf das begrenzt, was eine 48-GB-Karte tatsächlich nutzen kann, und das Modell auf 8 Bit komprimiert geladen. Beim Laden ging der Speicher aus, weil es zuerst etwa 64 GiB anforderte. Dann haben wir dasselbe 8-Bit-Modell ohne Grenze auf der echten 80-GB-Karte laufen lassen, um zu sehen, warum. Es belegte etwa genauso viel Speicher, und das erste "remember" stürzte mit einem internen Fehler ab. Die meisten Gewichte sind in einer Form gespeichert, die das 8-Bit-Tool überspringt, deshalb sparte die Kompression nur etwa 2 GiB.
Dieser 48-GB-Test war eine Grenze auf der A100, keine echte 48-GB-Karte, und andere Wege, das Modell zu verkleinern, haben wir nicht ausprobiert. MemTensor veröffentlicht keine komprimierte Version. Plan eine 80-GB-Karte ein.
Auf InferenceKey: eine Gedächtnisdatei hinter einem OpenAI-artigen Endpoint, bereit in 20 Sekunden
Eine Kopie des Modells auf einer gemieteten Karte hält benannte Sitzungen, jede mit ihrer Gedächtnisdatei auf der Platte, hinter einer Standard-Chat-API mit einem zusätzlichen Feld. Unser Worker, ein Programm auf deiner GPU-Maschine, lädt das Modell einmal und hält diese Sitzungen am Leben. Nur der Python-Code der Autoren betreibt das Gedächtnis, deshalb haben wir ihn in eine kleine Datei verpackt. Das zusätzliche Feld sagt: merken, fragen, speichern, schließen oder laden.
Der erste Start lud 70,3 GB an Gewichten in etwa vier Minuten herunter. Sobald sie auf der Platte lagen, war ein Neustart in 20 Sekunden bereit, 14,8 davon fürs Laden des Modells auf die Karte. Eine Antwort mit 128 Tokens auf einen "remember"-Turn dauerte etwa 13 Sekunden, das ist langsam. Die schnelleren optionalen Komponenten haben wir nicht installiert und nichts getunt.
Ein Problem, auf das du wahrscheinlich stößt, und sein Status:
- Laden aus dem Download-Ordner von Hugging Face scheitert. Lädt man das Modell aus dem Ordner, in dem Hugging Face seine Downloads ablegt, bricht es mit einem "file not found"-Fehler ab. Status: im SDK-Beispiel behoben, indem es über den Namen des Modells und eine festgelegte Version lädt.
Der Hugging-Face-Code, den wir genutzt haben, steht unter Apache-2.0, und er ist der langsame Weg. In unserem Backend laufen Anfragen nacheinander, Parallelität haben wir nicht getestet. Der SGLang-Server der Autoren für zwei GPUs ist nur für nichtkommerzielle Nutzung lizenziert, und wir haben ihn nicht getestet.
Solltest du es nutzen? Ein Pilot an deinen eigenen langen Verläufen lohnt sich, eine Wette für die Produktion noch nicht
- Wenn du einen Assistenten baust, der eine Person über Wochen begleitet, mach einen Pilot und miss die Erinnerung an deinen eigenen langen Verläufen. Das Gedächtnis ist eine Datei, die du pro Person speichern, sichern, verschieben und löschen kannst.
- Wenn deine Gespräche kurz sind, lass es.
- Wenn du exakte Details aus langen Verläufen brauchst, behalte ein textbasiertes Gedächtnis. Nach den eigenen Zahlen der Autoren liegen die stärksten dort weit vorn.
- Wenn deine größte Karte 48 GB hat, haben wir keinen Weg gefunden, es dort laufen zu lassen: Es gibt keine komprimierte Version, und unser 8-Bit-Versuch scheiterte.
- Wenn du Tempo brauchst, der Standardcode ist heute langsam.
Um eine Gedächtnisdatei auf deiner eigenen NVIDIA-Maschine zu speichern und neu zu laden, klon das SDK-Beispiel. Füll seine .env aus, inklusive INFERENCEKEY_TENANT_ID und INFERENCEKEY_USER_TOKEN, damit publish.py das Backend hochladen kann. Dann bau das Python-Binding und führ python publish.py und python main.py aus. Es braucht eine 80-GB-Karte, etwa 90 GB lokale Platte und einen Treiber für CUDA 13 (580 oder neuer).
Für Ingenieure
Modell und Dateien
MemTensor/MemT-1.0-Nano, sha30fe0b22422c4cc4c87475f98db5c8baa5c1a902, angelegt 2026-10-15, zuletzt geändert 2026-10-20T05:49:52Z, nicht gated, Apache-2.0. 26 Safetensors-Shards plusmemt_block.safetensors,configuration_memt.py,modeling_memt.pyundtech_report.pdf. 70,3 GB heruntergeladen. 18.765 Downloads und 123 Likes am 2026-10-26.- Model Card: 36B gesamt, 3B aktiv, 451M trainierbare Gedächtnisparameter, 10M dynamischer Gedächtniszustand.
library: transformers, Tagcustom_code. config.json:model_typememt_qwen3_5_moe,MemTQwen3_5MoeForCausalLM. Backboneqwen3_5_moe: 40 Layer mitfull_attention_interval4 (10 mit voller Attention, 30 mit linearer Attention, GatedDeltaNet), hidden 2048, 256 Experten mit 8 pro Token, 16 Attention-Heads, 2 KV-Heads, head_dim 256, Vokabular 248.320,max_position_embeddings262.144. memt-Block:gdn_versionstable_gdn2,memory_update_modetoken,num_memory_heads16,chunk_tokens2048.- Release: Paper am 19. Oktober 2026, Gewichte und Code bis zum 20. Oktober.
- Geschwistermodell
MemTensor/MemT-1.0-Flash: Backbone DeepSeek-V4-Flash, 288B gesamt, 17B aktiv, 3,61B trainierbare Gedächtnisparameter, 336M dynamischer Gedächtniszustand, HF-Lizenz-Tagmit. - Lizenzen: Gewichte Apache-2.0 (HF-Card). Der gesamte Originalcode in
MemTensor/MemT-1.0auf GitHub, inklusivememt-sglang, steht unter PolyForm Noncommercial 1.0.0 ("Commercial use of the repository software is not permitted"). Das Paper steht unter CC BY-NC-SA 4.0.
Session-API (modeling_memt.py beim festgelegten sha)
chat(query, *, memory=None, enable_memory=False, enable_thinking=None, return_dict=False). Mitenable_memory=Truewird der Klartextverlauf des Turns in den Gedächtniszustand übernommen und verworfen. Andere Turns bleiben als Klartextverlauf in der Sitzung.save_state(path, *, overwrite=False)überschreibt eine vorhandene Datei standardmäßig nicht, übernimmt die Klartext-Turns und schreibt FP32-Tensoren als Safetensors mit dem Metadatenformatmemt-memory-v1plus einem Identitäts-Hash (Config, Chat-Template, Vokabular).- Sitzungen sind durch ein
threading.RLockgeschützt. - Der Zustand ist ein Dict aus 10 FP32-Tensoren
[1, 16, 256, 256], einer pro Layer mit voller Attention: 10 x 16 x 256 x 256 x 4 B = 41.943.040 B. Gemessene Datei: 41.944.024 B, also etwa 984 B Header und Metadaten.
Gekürzt aus dem Quick Start der Model Card (Python 3.11+, PyTorch 2.11.0 für CUDA 13 gebaut, pip install transformers==5.12.1 accelerate==1.15.0 safetensors==0.8.0):
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

repo = "MemTensor/MemT-1.0-Nano"
tokenizer = AutoTokenizer.from_pretrained(repo, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    repo,
    trust_remote_code=True,
    dtype=torch.bfloat16,
    device_map="auto",
    attn_implementation="sdpa",
)

session = model.create_session(tokenizer)
session.chat("<facts to remember>", enable_memory=True, enable_thinking=False)
session.save_state("memmy_memory.safetensors")
session.close()

restored = model.create_session(tokenizer, state="memmy_memory.safetensors")
print(len(restored.messages))  # 0
Speicherrechnung (unsere, nicht gemessen)
Einfacher KV-Cache dieses Backbones: 10 Layer mit voller Attention x 2 KV-Heads x 256 x 2 (K und V) x 2 B (bf16) = 20.480 B pro Token. Der Zustand mit 41,9 MB entspricht dem KV von etwa 2.048 Tokens. Bei 131.072 Tokens ist der KV 2,68 GB groß, das 64-Fache des Zustands (Model Card und Paper nennen etwa das 66-Fache, als logische Größe pro Trajektorie ohne geteilte Gewichte). Unter etwa 2.000 Tokens Verlauf ist die Datei größer als der KV, den sie ersetzt. Die Zustände der linearen Attention (GatedDeltaNet) gibt es in beiden Fällen, sie sind nicht mitgezählt. Das Paper merkt außerdem an, dass der Speicher von DenseRAG bei kurzen Verläufen billiger ist als Nanos fester Zustand und ihn erst überholt, wenn sich Einträge ansammeln.
Unser Setup
- Eine NVIDIA A100-SXM4-80GB in unserer Cloud, Treiber 595.91.07, CUDA 13.2, 170 GB Container-Platte (zwei andere A100-Konfigurationen waren zu dem Zeitpunkt nicht verfügbar). Gewichte auf der Container-Platte, nie auf einem Netzwerk-Volume.
- Ein lokaler InferenceKey-Manager, gebaut aus
main, über Tunnel mit dem Worker verbunden. Die Produktion wurde nie angefasst. - Custom Python Backend
memt-1-0-nano0.1.1: Transformers 5.12.1 mittrust_remote_code, PyTorch 2.11 (CUDA 13).setup()lädt die festgelegte Revision mitsnapshot_downloadherunter und lädt dann über Repo-ID plus Revision mitdtype=torch.bfloat16,device_map={"": 0}(ganzes Modell auf GPU 0, kein stilles Auslagern auf die CPU) undattn_implementation="sdpa". Greedy Decoding (do_sample=False),max_new_tokensstandardmäßig 256. task_typetext2text, nurprocess(). Operationen reisen inextra_body.memt = {"op": "remember" | "ask" | "save" | "close" | "load" | "status", "session": ..., "text" | "name": ...}auf/v1/chat/completions. Einfacher Chat-Text funktioniert auch (remember: ...,save: <name>,forget,load: <name>, alles andere ist ein Ask). Jede Antwort liefert JSON mit der Antwort, Token-Zahlen, Sekunden, Tokens/s,memory_updated,plaintext_messages_kept, Dateigröße und sha256 sowie VRAM.
Deployment Schritt für Schritt
Aus dem SDK-Beispiel (Commit ef656124 auf main):
git clone https://github.com/inferencekey/inferencekey-sdk
cd inferencekey-sdk/examples/memt-nano-memory-state-custom-backend-private-nvidia
cp .env.example .env          # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY,
                              # INFERENCEKEY_PROJECT, IK_WORKER_ID, and for the
                              # upload INFERENCEKEY_TENANT_ID, INFERENCEKEY_USER_TOKEN
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )
python publish.py             # once: packages backend.py; uploads only if TENANT_ID and USER_TOKEN are set
python main.py                # deploy, remember x2, save, close, load, ask x4, control ask
- Braucht einen NVIDIA-Treiber für CUDA 13 (580+), eine 80-GB-Karte, etwa 90 GB lokale Platte und Python 3.11 bis 3.13 auf dem Worker.
- Optionale Env-Variablen:
MEMT_MAX_NEW_TOKENS(Standard 256),IK_KEEP_ALIVE=1, um den Workload nach dem Lauf zu behalten,MEMT_LOAD_IN_8BIT=1(bitsandbytes; siehe Leiter, es scheitert),MEMT_GPU_CAP_GIB(torch.cuda.set_per_process_memory_fraction, um eine kleinere Karte zu emulieren),MEMT_REVISION. main.pyschreibt jede Anfrage, Antwort, Token-Zahl und Zeitmessung nachoutputs/memory-test.json.
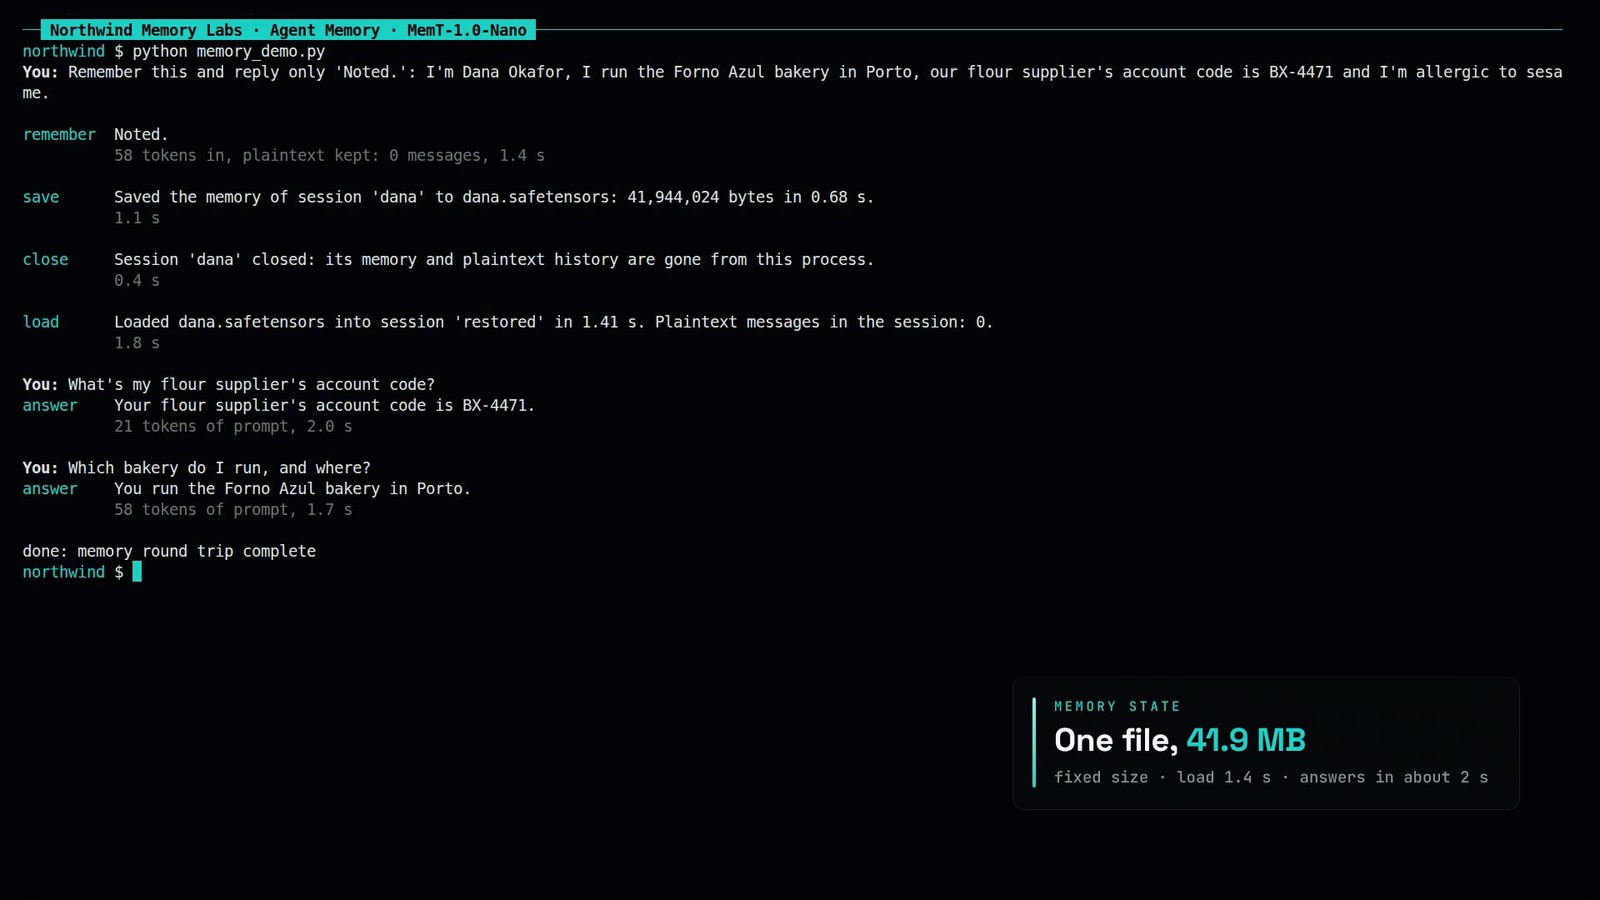
Die 65-Sekunden-Demo: merken, speichern, schließen, laden und fragen, aus einem Terminal-Client gegen den Worker.
Zeit bis bereit
| Phase | Zeit |
|---|---|
| venv des Backends | etwa 23 s |
| Download der Gewichte (37 Dateien, 70,3 GB, ohne Authentifizierung, etwa 300 MB/s) | 235,5 s |
| Erstes Laden (Backend 0.1.0) | gescheitert, siehe Problem 1 |
Warmstart, ensure() bis bereit | 20,3 s (Laden des Modells 14,8 s), 20,0 s im zweiten Lauf |
| Warmstart, 8-Bit | 29,8 s (Laden des Modells 24,3 s) |
Messungen
Gedächtnistest, Lauf 2 (bf16; Sekunden sind GPU-Zeit im Backend, der Round Trip kommt mit 0,3 bis 1,1 s dazu):
| Schritt | Input-Tokens | Output-Tokens | Sekunden | Ergebnis |
|---|---|---|---|---|
| remember 1: Name, Forno Azul in Porto, Ofen Rational iCombi Pro, Lieferantennummer BX-4471 | 64 | 128 | 12,72 | Antwort, Klartext behalten 0 |
| remember 2: Sesamallergie, Tochter Ines wird am 9. September eingeschult | 43 | 53 | 5,68 | "Noted! ...", Klartext behalten 0 |
save dana | 1,02 | 41.944.024 B | ||
| close | Sitzung weg | |||
load dana in eine neue Sitzung | 1,99 | 0 Klartextnachrichten | ||
| ask: Bäckerei und Stadt | 27 | 19 | 2,05 | richtig |
| ask: Lieferantennummer | 68 | 16 | 1,80 | richtig |
| ask: Wochenendbrot mit Allergie | 113 | 71 | 6,72 | richtig (sesamfreies portugiesisches Sauerteigbrot) |
| ask: Name der Tochter und Einschulungsdatum | 210 | 16 | 1,83 | richtig |
| Kontrolle: neue Sitzung, keine Datei, Lieferantennummer | 21 | 169 | 14,26 | verweigert, weiß es nicht |
Die Input-Tokens wachsen in der wiederhergestellten Sitzung von 27 auf 210, weil Ask-Turns als Klartextverlauf bleiben. Die erste Schlüsselwortprüfung von main.py wertete das Einschulungsdatum als Fehler, weil sie "9 september" erwartete; beim Lesen ist es richtig, und die committete Prüfung ist lockerer.
Test mit langem Input (bf16, MEMT_MAX_NEW_TOKENS=96): ein remember mit 1.467 Input-Tokens, Antwort "Noted.", 4,02 s, Klartext behalten 0. Speichern 0,66 s, 41.944.024 B. Laden 1,35 s. Fünf von fünf erinnert: Kühlraumcode 5832 (1,55 s), Vermieter Rui Matos mit Miete am 3. (2,01 s), Police PT-77-0912 (1,76 s), Torte für Silva am 14. November, dreistöckig mit Zitrone (2,45 s), Ersatztechnikerin Marta mit einer Telefonnummer, die auf 4410 endet (2,21 s).
Demo-Client: remember mit 58 Tokens, "Noted." in 1,4 s; Speichern 0,68 s; Laden 1,41 s; "BX-4471" in 2,0 s (Prompt mit 21 Tokens); "Forno Azul bakery in Porto" in 1,7 s (Prompt mit 58 Tokens).
Tempo: etwa 9 bis 10 Tokens/s Decode (128 Tokens in 12,72 s) mit den PyTorch-Referenzkerneln für GatedDeltaNet (flash-linear-attention und causal-conv1d nicht installiert) und HF generate. Nicht getunt.
GPU-Speicher, bf16: 65,4 GiB alloziert nach dem Laden, 65,45 bis 65,55 GiB Spitze alloziert während der Anfragen, 67.605 MiB auf der Karte im Leerlauf nach dem Laden, 68.117 MiB Spitze auf der Karte (nvidia-smi, Samples alle 1 s). Der Haupttext nennt diese Werte in GiB (66,5 GiB Spitze; das 8-Bit-Laden forderte 63,67 GiB an).
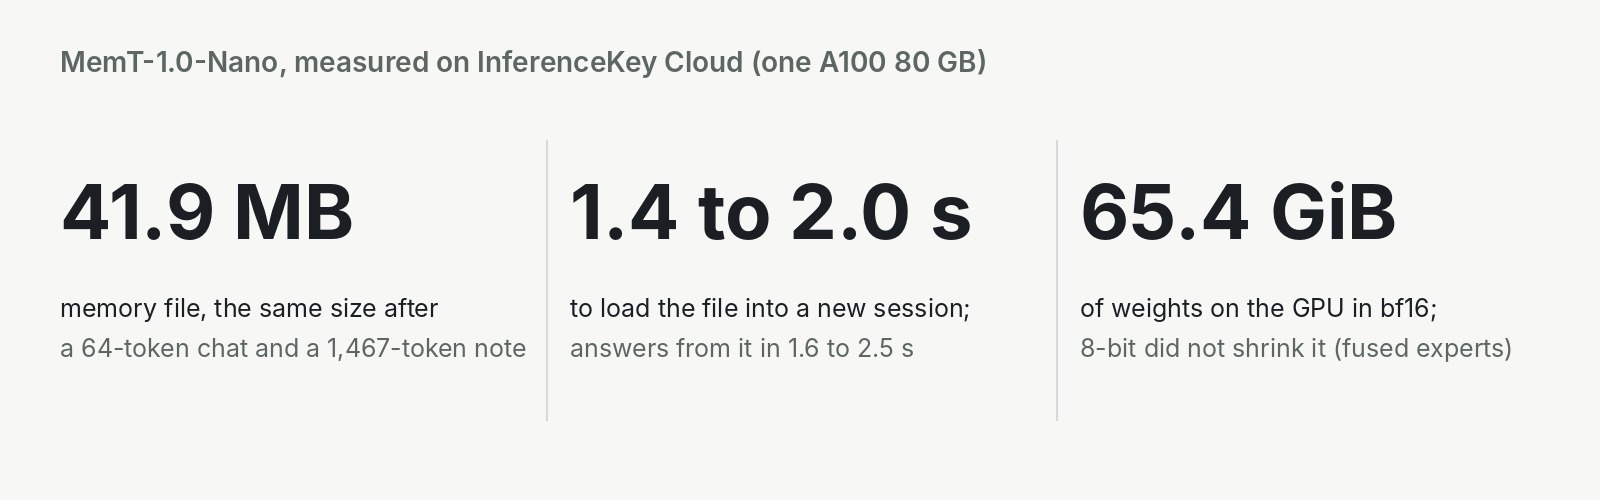
VRAM-Leiter
| GPU oder Grenze | Konfiguration | VRAM-Spitze | Zeit pro Ausgabe | Ausgabe OK? | Echt oder emuliert |
|---|---|---|---|---|---|
| A100-SXM4 80 GB | bf16, Transformers 5.12.1, sdpa, ganzes Modell auf GPU 0 | 68.117 MiB auf der Karte (65,5 GiB alloziert) | ask 1,6 bis 2,5 s, etwa 9 bis 10 Tokens/s | ja, 9/9 erinnert | echt |
| 48 GB (Torch-Grenze 44 GiB auf der A100) | bitsandbytes 8-Bit | beim Laden gescheitert | nein: torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 63.67 GiB ... 44.00 GiB allowed | emuliert | |
| A100 80 GB, ohne Grenze (Diagnose) | bitsandbytes 8-Bit | 67.695 MiB auf der Karte (63,67 GiB alloziert) | nein: erstes remember scheitert mit expected mat1 and mat2 to have the same dtype, but got: c10::BFloat16 != signed char | echt |
Warum 8 Bit kaum verkleinert: Die 256 fusionierten Experten pro Layer sind 3D-Parameter, kein nn.Linear, deshalb lässt bitsandbytes sie in bf16 (etwa 2 GiB gespart). Nicht ausprobiert: eine echte 48-GB-Karte, H100, CPU-Offload, fp8, Quantisierungen aus der Community (zum Testzeitpunkt keine von MemTensor). Das Kleinste, was bestand: eine A100 mit 80 GB in bf16.
Der SGLang-Weg der Autoren (nicht getestet)
memt-sglang(import memt_sglang) inMemTensor/MemT-1.0: natives Sitzungsgedächtnis auf SGLang 0.5.16. Pinnt PyTorch 2.11.0, Transformers 5.12.1,flashinfer-python[cu13]0.6.14,sglang-kernel0.4.5. PolyForm Noncommercial 1.0.0.inference/start_memt_nano.sh:CUDA_VISIBLE_DEVICES=0,1,--tp-size 2 --ep 1 --dp-size 1,--max-prefill-tokens 16384,--max-sessions-per-rank 6,--max-inflight-commits-per-rank 2,--min-kv-tokens 2048,--max-total-tokens 65536,--max-running-requests 8,--mem-fraction-static 0.60,--dtype bfloat16, Triton-Backends für Attention, lineare Attention und MoE, Snapshots in./memt-state, Port 30000. Laut Anleitung sind diese Einstellungen "not been deeply optimized".- Einschränkungen: Eager Execution auf einem einzelnen Node, nur unquantisierte BF16-Safetensors; Chunked Prefill, Radix Cache, Overlap Scheduling und CUDA Graphs müssen deaktiviert bleiben; der Launcher lehnt
trust_remote_codeab. - Snapshots sind serverseitige
.safetensorsunter--state-directory. Routen:GET /memt/identity,GET /memt/capabilities,POST /memt/control,POST /generatemit einer MemT-RID. Leases (TTL 1 bis 3600 s, Standard 300), Transaktionen und Epochen; ein Neustart des Servers braucht eine neue Sitzung plus einen Snapshot-Import. HF-Snapshots und Server-Exporte sind für dasselbe Modell und denselben Tokenizer austauschbar. - Ob Nano damit auf eine 80-GB-Karte passt und welchen Durchsatz es hat, ist nicht dokumentiert und wurde nicht getestet.
- Wir haben keine vLLM-Unterstützung für MemT gefunden. Der Launcher von
memt-sglangist die eigene Integration der Autoren, kein Standard-SGLang.
Zahlen aus dem Paper (nicht reproduziert)
arXiv 2610.26825, "MemT-1.0: Towards Memory-Native Evolution", MemTensor Team, v1 19. Oktober 2026, v2 20. Oktober. 34B Trainings-Tokens, fortgesetztes Pre-Training plus Post-Training, Gated DeltaNet-2 mit einem stabilen Gedächtnis-Update auf Token-Ebene, Mixture-of-Storage.
- Tabelle 2, 11 Gedächtnis-Benchmarks, Durchschnitt: MemT-1.0-Flash 50,6, MemT-1.0-Nano 47,0, Temp-LoRA 38,1 (beste andere parametrische Methode). Text-Gedächtnis auf dem Backbone Qwen3.6-35B-A3B: MemOS 68,5, Full Context 66,3, Mem0 66,0, OpenViking 65,4, DenseRAG 56,5, Graphiti 45,7. Nano auf LongMemEval-S 32,6 gegen Full Context 76,8 und MemOS 80,8; auf BEAM-1M 35,8 gegen MemOS 71,3.
- Tabelle 3, allgemeine Fähigkeiten im Noise-Setting, Delta gegenüber Qwen3.6-35B-A3B: MMLU-Pro -1,6, GPQA Diamond -1,5, IFEval +3,3, LongBench v2 -2,0, BigCodeBench-Hard +2,0, LiveCodeBench v6 -5,8, Durchschnitt -0,9.
- Abschnitt 6.5, HF-Inferenz auf zwei GPUs, Concurrency 1, BEAM-Verläufe: langsamer als Full Context bei kurzen Verläufen, etwa gleich bei 32K, End-to-End-Speedups von etwa 1,20x bei 64K, 1,86x bei 128K und 3,99x bei 256K. Query-TTFT (Zeit bis zum ersten Wort der Antwort) etwa 104 bis 112 ms gegenüber etwa 257 ms (128K) und 445 ms (256K) für Full Context.
- Abschnitte 4.3 und 6.6: Zustand pro Trajektorie etwa 33-mal kleiner als Full Context bei 64K und 66-mal bei 128K.
Offene Probleme und Status
- Laden aus dem Snapshot-Pfad des HF-Caches scheitert mit
trust_remote_code.from_pretrained(<snapshot dir>)wirftFileNotFoundError: ... models--MemTensor--MemT-1.0-Nano/blobs/configuration_memt.py, weil Transformers dem Symlink vonmodeling_memt.pynachblobs/folgt und den relativen Import dort auflöst. Status: in Backend 0.1.1 behoben, indem es über Repo-ID plus Revision lädt. - 8 Bit passt nicht auf eine kleinere Karte (Leiter oben). Status: kein Workaround; braucht eine offizielle Quantisierung oder eine Quantisierung, die die Experten berücksichtigt.
- Eine Änderung von
config.envan einem laufenden Custom-Backend-Workload bewirkt nichts. Der Manager schicktreload_backend, und der Worker loggtreload_backend handle_load_model failed: unknown backend memt-1-0-nano; das alte Backend bedient weiter. Workaround: den Workload löschen undmain.pyneu ausführen. Status: offen. - Das manuelle Anlegen einer GPU-Maschine ignoriert die Platten-Einstellung. Der Handler hat
DEFAULT_POD_DISK_GB = 100fest eincodiert und liestRUNPOD_CONTAINER_DISK_GBnicht mehr. 70,3 GB Gewichte plus ein Torch-venv sind auf 100 GB knapp. Status: nur für diesen Test lokal gepatcht, offen. - Der Chat-Tester im Dashboard kann ein Backend mit nur
process()nicht ansteuern (er streamt). Die Demo lief über einen Terminal-Client. Status: bekannt, offen. - Die Zustandsdatei kann nicht über die API reisen (41,9 MB gegenüber einer Ergebnisgrenze von 8 MB). Status: vorerst so gewollt; sie bleibt auf der Platte des Workers, und die API liefert Größe und sha256.
- Die Tunnel zwischen unserem Test-Manager und dem Worker sind einmal abgerissen; eine Supervisor-Schleife hat sie wieder verbunden, ohne den Worker neu zu starten.
Grenzen
Neun Erinnerungsfragen plus eine Kontrolle zu unseren eigenen erfundenen Fakten (zwei weitere im Demo-Client), Greedy Decoding, Anfragen eine nach der anderen. Die HF-Sitzung nutzt einen Lock pro Sitzung, und das Backend serialisiert die Anfragen, deshalb ist der Durchsatz mit mehreren Nutzern unbekannt. Ein Kartentyp. Kein Benchmark aus dem Paper wurde reproduziert, und unser 64-Fach ist eine Rechnung, keine Messung. Wir haben weder die Zeit fürs erneute Lesen noch den Kartenspeicher pro Sitzung gegen eine Full-Context-Baseline gemessen. Der gehostete InferenceKey-Endpoint ist ungetestet: Das hier lief auf einem lokalen Test-Manager.
Credits
MemTensor hat MemT-1.0 gebaut, den Gedächtnisblock trainiert, die Session-API, die SGLang-Integration und das Paper geschrieben und die Nano-Gewichte unter Apache-2.0 veröffentlicht. Das Qwen-Team hat Qwen3.6-35B-A3B gemacht, Nanos Backbone. Hugging Face Transformers führt den Custom Code der Autoren aus. Wir haben das Modell im News-Video von AI Search vom 25. Oktober entdeckt, und auf r/LocalLLaMA gab es am 22. Oktober einen Thread dazu. Unser Teil: das Custom Backend, das Deployment auf InferenceKey, der Fix fürs Laden, die Gedächtnistests und die Messungen.