MemT-1.0-Nano garde la mémoire d'un chat dans un fichier de 41,9 MB, et il a répondu juste à 9 questions sur 9 après un rechargement
MemT-1.0-Nano sur une A100 de 80 GB : faits gardés dans un fichier fixe de 41,9 MB, rechargé en 2 s environ dans une session vide, 9 sur 9 retrouvés.
Un fichier de 41,9 MB et une session de chat vide : le modèle savait encore que le code du fournisseur de farine était BX-4471. Ce modèle, c'est MemT-1.0-Nano, un modèle ouvert de MemTensor. Il écrit les tours passés dans une mémoire de taille fixe que l'on peut enregistrer dans un fichier et recharger plus tard. Nous lui avons donné quelques faits, avons enregistré le fichier et fermé la session. Puis nous avons chargé le fichier dans une session toute neuve, sans aucun message. Il a répondu juste à 9 questions sur 9 sur ces faits. Pour qui fait tourner ses propres GPU, une session devient un fichier de taille fixe qui se recharge en deux secondes environ, au lieu d'un historique que le modèle doit relire. Les limites sont claires. Il lui faut une carte de 80 GB, la première version est lente, et les auteurs reconnaissent que les meilleurs systèmes de mémoire en texte retrouvent encore mieux les détails d'historiques longs. Cela vaut donc un pilote pour mesurer le rappel sur vos propres historiques longs, mais pas encore un pari pour un produit qui doit citer d'anciens détails à l'identique.
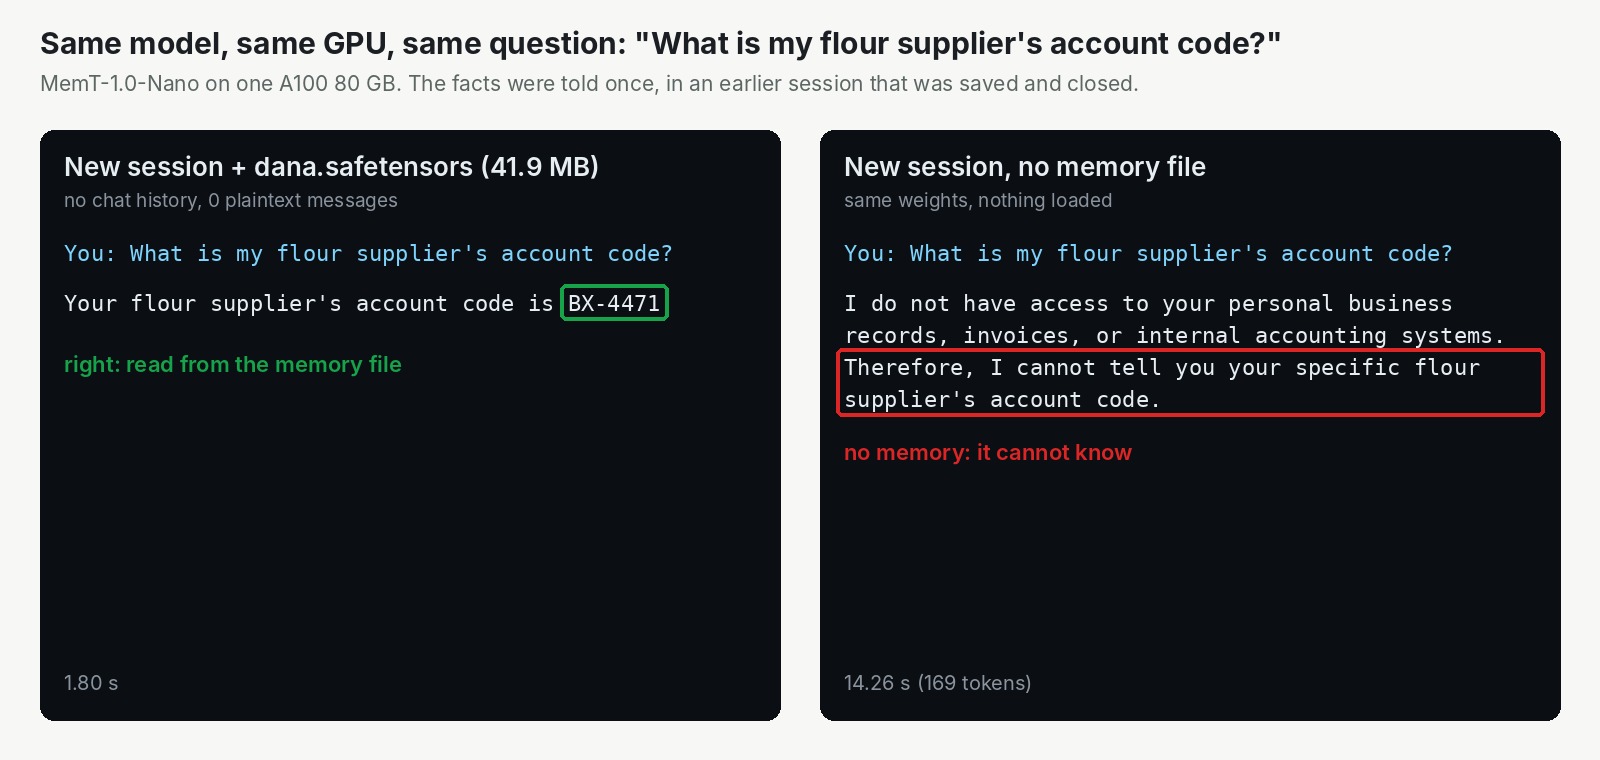
Les deux sessions démarrent vides. La seule différence, c'est le fichier de 41,9 MB à gauche.
Les tours passés se replient dans une mémoire de taille fixe qu'on peut enregistrer, au lieu d'un historique qui grossit
Imaginez un rouleau et un carnet. La plupart des modèles de chat travaillent avec un rouleau. Chaque message y reste, et le modèle relit tout le rouleau avant chaque réponse. Le rouleau s'allonge à chaque tour, et la mémoire de travail qu'il occupe sur la carte graphique aussi. Quand la session se termine, cette mémoire de travail est jetée et le rouleau repart dans une base de données.
MemT-1.0-Nano a un carnet. Quand vous lui dites de retenir un tour, il replie ce qui a été dit dans un ensemble de nombres de taille fixe, puis abandonne le texte. Le carnet ne s'épaissit jamais. Vous pouvez l'enregistrer dans un fichier, tout fermer et le lui rendre le lendemain. Le prix de la taille fixe, c'est le détail : le carnet garde ce que vous avez signalé, pas chaque mot.
Le modèle est l'œuvre de MemTensor, construit sur Qwen3.6-35B-A3B de l'équipe Qwen. Les poids sont sous Apache-2.0, donc l'usage commercial est permis.
Le test : une carte de 80 GB, des faits inventés, un enregistrement, une fermeture et un rechargement
C'est une vérification de comportement, pas un benchmark. Nous avons utilisé les poids publiés tels quels, sans compression, sur une A100 de 80 GB. Le modèle tournait avec le code des auteurs, derrière une copie de test d'InferenceKey construite à partir de ses dernières sources.
Nous avons inventé une cliente, Dana, qui tient une boulangerie. En deux tours, elle a donné au modèle le nom et la ville de sa boulangerie, son four, le code client chez son fournisseur de farine, une allergie au sésame et le jour de la rentrée de sa fille. Nous avons enregistré la mémoire, fermé la session, ouvert une nouvelle session à partir du fichier et posé quatre questions. Puis nous avons fait une version plus difficile. Une longue note de 1 467 tokens (les tokens sont des morceaux de mots) contenait quarante phrases de routine de boulangerie avec cinq faits cachés dedans, suivie de cinq questions. Au total, neuf questions de rappel, plus une posée à une session sans le fichier, un utilisateur à la fois.
Résultats : 9 faits sur 9 retrouvés depuis le fichier, et une session vierge qui ne savait rien
Chaque question sur les faits a reçu la bonne réponse après le rechargement. Le témoin était une nouvelle session sans le fichier, interrogée sur le code fournisseur. Elle a répondu qu'elle n'avait pas accès aux dossiers de Dana et ne pouvait pas le lui dire.
| Question, après le rechargement | Réponse | Secondes |
|---|---|---|
| Ma boulangerie et ma ville ? | "Forno Azul, and it is located in Porto." | 2,05 |
| Mon code client chez le fournisseur ? | "BX-4471." | 1,80 |
| Un pain pour le week-end, vu mon allergie ? | Un pain au levain portugais, "naturally free of sesame" | 6,72 |
| Quand ma fille fait-elle sa rentrée ? | "Your daughter, Ines, starts school on September 9." | 1,83 |
| Code fournisseur, nouvelle session sans le fichier | "I do not have access to your personal business records" | 14,26 |
Temps sur la carte pour chaque réponse. Les réponses longues ont pris plus de temps : celle sur le pain, et le refus de 169 tokens du témoin.
Le témoin montre seulement que le fichier transporte de l'information.
La longue note a donné le même résultat. Les cinq faits cachés sont revenus, chaque réponse courte en 1,55 à 2,45 secondes. Replier la note dans la mémoire a pris 4 secondes.
Le fichier est resté à exactement 41 944 024 octets, après les deux lignes de Dana comme après la longue note. L'enregistrer a pris environ une seconde (0,66 à 1,02 s). Le charger dans une session neuve a pris entre 1,35 et 1,99 seconde sur la carte.
Un comportement compte si vous construisez dessus. Seuls les tours que vous marquez "remember" entrent dans le carnet. Les questions ordinaires restent dans la session en texte brut, comme avec n'importe quel modèle de chat. C'est donc l'application qui décide de ce qui part en mémoire, pas le modèle.
Le texte est toujours plus petit sur disque, et le fichier ne paie que sur les longs historiques
Un court échange avec le support n'y gagne rien. Un assistant qui connaît une personne pendant des mois pourrait y gagner.
Stockée en texte, une conversation est toujours plus petite que ce fichier. L'historique de Dana faisait 107 tokens, quelques centaines d'octets. Le fichier n'économise donc pas de disque.
Ce qu'il peut économiser, c'est la relecture. Un modèle qui travaille avec le rouleau reconstruit la mémoire de travail à partir de tout l'historique avant de répondre, et la garde sur la carte tant que la session est vivante. Cette mémoire de travail grossit à chaque token. D'après nos calculs, le fichier ne devient plus petit qu'elle qu'au-delà d'environ 2 000 tokens d'historique, un peu plus que notre longue note. À 128K tokens, le fichier est environ 64 fois plus petit.
La vitesse s'équilibre bien plus tard. De bout en bout, l'article des auteurs trouve Nano plus lent sur les historiques courts, à peu près à égalité à 32 000 tokens (plus de vingt fois notre longue note) et environ 1,86 fois plus rapide à 128K. Nous n'avons mesuré ni l'un ni l'autre. Les chiffres de taille sont nos calculs, ceux de vitesse viennent de l'article.
Là où il reste en retrait : les meilleurs systèmes de mémoire en texte ont une large avance sur les historiques longs et détaillés
Les auteurs le disent : les meilleurs systèmes qui gardent la conversation en texte et vont chercher le bon passage gagnent encore, et de loin. Sur 11 benchmarks de mémoire de leur article, Flash, le grand frère de Nano, arrive premier et Nano deuxième parmi les modèles qui gardent la mémoire sous forme de nombres à l'intérieur du modèle. Les meilleurs systèmes de mémoire en texte, et le simple fait de garder toute la conversation, obtiennent environ 1,4 à 1,5 fois le 47,0 de Nano.
L'écart est le plus grand quand un détail lointain compte. Sur un test d'historiques de chat longs, Nano obtient 32,6 contre 76,8 quand on garde la conversation complète. La fiche du modèle le résume en une ligne : "Strong textual-memory systems remain ahead overall, particularly on long histories that require detailed evidence retrieval."
On retrouve le carnet. Il garde l'essentiel et les faits que vous avez signalés, dans un espace fixe. Si votre produit doit citer une clause exacte d'un contrat signé il y a six mois, gardez un stockage en texte. Nos neuf questions portaient sur des faits courts que le modèle venait d'apprendre. Elles prouvent que l'enregistrement et le rechargement fonctionnent. Elles ne prouvent pas le rappel sur une longue durée de vie, et personne dans notre test n'a écrit beaucoup de souvenirs au fil du temps pour voir si les nouveaux faits chassent les anciens.
Sur six tests généraux, il obtient à peu près les mêmes scores que le modèle Qwen sur lequel il est construit (0,9 point de moins en moyenne), avec un test de code 5,8 points en dessous.
Quel GPU : une carte de 80 GB a fonctionné, et le raccourci 8 bits a échoué
La plus petite carte qui a fonctionné est celle que nous avons utilisée : une A100 de 80 GB, modèle non compressé, tout sur la carte. Au pic, il a utilisé environ 66,5 GiB de la mémoire de la carte. Nous n'avons rien trouvé de plus petit qui marche.
Nous avons essayé de le tasser. D'abord, nous avons plafonné l'A100 à ce qu'une carte de 48 GB peut réellement utiliser, et chargé le modèle compressé en 8 bits. Il a manqué de mémoire pendant le chargement, parce qu'il demandait d'abord environ 64 GiB. Puis nous avons fait tourner le même modèle 8 bits sur la vraie carte de 80 GB sans plafond, pour comprendre pourquoi. Il a pris à peu près autant de mémoire, et le premier "remember" a planté avec une erreur interne. La plupart des poids sont stockés sous une forme que l'outil 8 bits ignore, donc la compression n'a fait gagner qu'environ 2 GiB.
Ce test à 48 GB était un plafond sur l'A100, pas une vraie carte de 48 GB, et nous n'avons pas essayé d'autres façons de réduire le modèle. MemTensor ne publie aucune version compressée. Prévoyez une carte de 80 GB.
Sur InferenceKey : un fichier de mémoire derrière un endpoint de style OpenAI, prêt en 20 secondes
Une seule copie du modèle sur une carte louée garde des sessions nommées, chacune avec son fichier de mémoire sur disque, derrière une API de chat standard avec un champ en plus. Notre worker, un programme sur votre machine GPU, charge le modèle une fois et garde ces sessions en vie. Seul le code Python des auteurs fait tourner sa mémoire, donc nous l'avons enveloppé dans un petit fichier. Le champ en plus dit retenir, demander, enregistrer, fermer ou charger.
Le premier démarrage a téléchargé 70,3 GB de poids en environ quatre minutes. Une fois les poids sur le disque, un redémarrage était prêt en 20 secondes, dont 14,8 pour charger le modèle sur la carte. Une réponse de 128 tokens à un tour "remember" a pris environ 13 secondes, ce qui est lent. Nous n'avons pas installé les composants optionnels plus rapides, ni fait de réglage.
Un problème sur lequel vous tomberez probablement, et son statut :
- Le chargement depuis le dossier de téléchargement de Hugging Face échoue. Charger le modèle depuis le dossier où Hugging Face garde ses téléchargements s'arrête sur une erreur "file not found". Statut : corrigé dans l'exemple du SDK en chargeant par le nom du modèle et une version épinglée.
Le code Hugging Face que nous avons utilisé est sous Apache-2.0, et c'est la voie lente. Dans notre backend, les requêtes passent l'une après l'autre, et nous n'avons pas testé la concurrence. Le serveur SGLang des auteurs, sur deux GPU, est sous licence pour un usage non commercial uniquement, et nous ne l'avons pas testé.
Faut-il l'utiliser ? Un pilote sur vos propres historiques longs, oui ; un pari de production, pas encore
- Si vous construisez un assistant qui suit une personne pendant des semaines, lancez un pilote et mesurez le rappel sur vos propres historiques longs. La mémoire est un fichier que vous pouvez stocker, sauvegarder, déplacer et supprimer par personne.
- Si vos conversations sont courtes, passez votre chemin.
- Si vous avez besoin de détails exacts dans de longs historiques, gardez une mémoire en texte. Les chiffres des auteurs eux-mêmes placent les meilleures loin devant sur ce terrain.
- Si votre plus grosse carte a 48 GB, nous n'avons trouvé aucun moyen de le faire tourner dessus : il n'existe pas de version compressée et notre essai en 8 bits a échoué.
- Si vous avez besoin de vitesse, le code d'origine est lent aujourd'hui.
Pour enregistrer et recharger un fichier de mémoire sur votre propre machine NVIDIA, clonez l'exemple du SDK. Remplissez son .env, y compris INFERENCEKEY_TENANT_ID et INFERENCEKEY_USER_TOKEN pour que publish.py puisse téléverser le backend. Puis compilez le binding Python et lancez python publish.py et python main.py. Il faut une carte de 80 GB, environ 90 GB de disque local et un driver pour CUDA 13 (580 ou plus récent).
Pour les ingénieurs
Modèle et fichiers
MemTensor/MemT-1.0-Nano, sha30fe0b22422c4cc4c87475f98db5c8baa5c1a902, créé le 2026-10-15, dernière modification le 2026-10-20T05:49:52Z, non restreint, Apache-2.0. 26 fragments safetensors plusmemt_block.safetensors,configuration_memt.py,modeling_memt.pyettech_report.pdf. 70,3 GB téléchargés. 18 765 téléchargements et 123 likes le 2026-10-26.- Fiche : 36B au total, 3B actifs, 451M paramètres de mémoire entraînables, 10M d'état de mémoire dynamique.
library: transformers, tagcustom_code. config.json:model_typememt_qwen3_5_moe,MemTQwen3_5MoeForCausalLM. Backboneqwen3_5_moe: 40 couches avecfull_attention_interval4 (10 en attention complète, 30 en attention linéaire, GatedDeltaNet), hidden 2048, 256 experts dont 8 par token, 16 têtes d'attention, 2 têtes KV, head_dim 256, vocabulaire 248 320,max_position_embeddings262 144. Bloc memt :gdn_versionstable_gdn2,memory_update_modetoken,num_memory_heads16,chunk_tokens2048.- Publication : article le 19 octobre 2026, poids et code le 20 octobre.
- Modèle frère
MemTensor/MemT-1.0-Flash: backbone DeepSeek-V4-Flash, 288B au total, 17B actifs, 3,61B paramètres de mémoire entraînables, 336M d'état de mémoire dynamique, tag de licence HFmit. - Licences : poids sous Apache-2.0 (fiche HF). Tout le code original de
MemTensor/MemT-1.0sur GitHub,memt-sglangcompris, est sous PolyForm Noncommercial 1.0.0 ("Commercial use of the repository software is not permitted"). L'article est sous CC BY-NC-SA 4.0.
API de session (modeling_memt.py au sha épinglé)
chat(query, *, memory=None, enable_memory=False, enable_thinking=None, return_dict=False). Avecenable_memory=True, l'historique en texte du tour est inscrit dans l'état de mémoire puis abandonné. Les autres tours restent dans la session comme historique en texte.save_state(path, *, overwrite=False)refuse par défaut d'écraser un fichier existant, vide les tours en texte et écrit des tenseurs FP32 en safetensors avec le format de métadonnéesmemt-memory-v1plus un hash d'identité (config, template de chat, vocabulaire).- Les sessions sont protégées par un
threading.RLock. - L'état est un dict de 10 tenseurs FP32
[1, 16, 256, 256], un par couche d'attention complète : 10 x 16 x 256 x 256 x 4 B = 41 943 040 B. Fichier mesuré : 41 944 024 B, soit environ 984 B d'en-tête et de métadonnées.
Version condensée du Quick Start de la fiche (Python 3.11+, PyTorch 2.11.0 compilé pour CUDA 13, pip install transformers==5.12.1 accelerate==1.15.0 safetensors==0.8.0) :
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

repo = "MemTensor/MemT-1.0-Nano"
tokenizer = AutoTokenizer.from_pretrained(repo, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    repo,
    trust_remote_code=True,
    dtype=torch.bfloat16,
    device_map="auto",
    attn_implementation="sdpa",
)

session = model.create_session(tokenizer)
session.chat("<facts to remember>", enable_memory=True, enable_thinking=False)
session.save_state("memmy_memory.safetensors")
session.close()

restored = model.create_session(tokenizer, state="memmy_memory.safetensors")
print(len(restored.messages))  # 0
Calcul du stockage (le nôtre, pas une mesure)
Cache KV simple de ce backbone : 10 couches d'attention complète x 2 têtes KV x 256 x 2 (K et V) x 2 B (bf16) = 20 480 B par token. L'état de 41,9 MB équivaut au KV d'environ 2 048 tokens. À 131 072 tokens, le KV pèse 2,68 GB, 64 fois l'état (la fiche et l'article disent environ 66 fois, en taille logique par trajectoire qui exclut les poids partagés). En dessous d'environ 2 000 tokens d'historique, le fichier est plus gros que le KV qu'il remplace. Les états d'attention linéaire (GatedDeltaNet) existent dans les deux cas et ne sont pas comptés. L'article note aussi que le stockage de DenseRAG coûte moins cher que l'état fixe de Nano sur les historiques courts et ne le dépasse qu'à mesure que les enregistrements s'accumulent.
Notre installation
- Une NVIDIA A100-SXM4-80GB sur notre cloud, driver 595.91.07, CUDA 13.2, disque de conteneur de 170 GB (deux autres configurations A100 étaient en rupture de stock à ce moment-là). Poids sur le disque du conteneur, jamais sur un volume réseau.
- Un manager InferenceKey local construit depuis
main, relié au worker par des tunnels. La production n'a jamais été touchée. - Backend Python sur mesure
memt-1-0-nano0.1.1 : Transformers 5.12.1 avectrust_remote_code, PyTorch 2.11 (CUDA 13).setup()télécharge la révision épinglée avecsnapshot_download, puis charge par repo id plus révision avecdtype=torch.bfloat16,device_map={"": 0}(tout le modèle sur le GPU 0, sans débordement silencieux sur le CPU) etattn_implementation="sdpa". Décodage glouton (do_sample=False),max_new_tokens256 par défaut. task_typetext2text,process()uniquement. Les opérations passent dansextra_body.memt = {"op": "remember" | "ask" | "save" | "close" | "load" | "status", "session": ..., "text" | "name": ...}sur/v1/chat/completions. Le texte de chat simple marche aussi (remember: ...,save: <name>,forget,load: <name>, tout le reste est une question). Chaque réponse renvoie un JSON avec la réponse, le nombre de tokens, les secondes, les tokens/s,memory_updated,plaintext_messages_kept, la taille et le sha256 du fichier, et la VRAM.
Déploiement pas à pas
Depuis l'exemple du SDK (commit ef656124 sur main) :
git clone https://github.com/inferencekey/inferencekey-sdk
cd inferencekey-sdk/examples/memt-nano-memory-state-custom-backend-private-nvidia
cp .env.example .env          # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY,
                              # INFERENCEKEY_PROJECT, IK_WORKER_ID, and for the
                              # upload INFERENCEKEY_TENANT_ID, INFERENCEKEY_USER_TOKEN
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )
python publish.py             # once: packages backend.py; uploads only if TENANT_ID and USER_TOKEN are set
python main.py                # deploy, remember x2, save, close, load, ask x4, control ask
- Il faut un driver NVIDIA pour CUDA 13 (580+), une carte de 80 GB, environ 90 GB de disque local, Python 3.11 à 3.13 sur le worker.
- Variables d'environnement optionnelles :
MEMT_MAX_NEW_TOKENS(256 par défaut),IK_KEEP_ALIVE=1pour garder le workload après l'exécution,MEMT_LOAD_IN_8BIT=1(bitsandbytes ; voir l'échelle, ça échoue),MEMT_GPU_CAP_GIB(torch.cuda.set_per_process_memory_fraction, pour émuler une carte plus petite),MEMT_REVISION. main.pyécrit chaque requête, réponse, nombre de tokens et temps dansoutputs/memory-test.json.
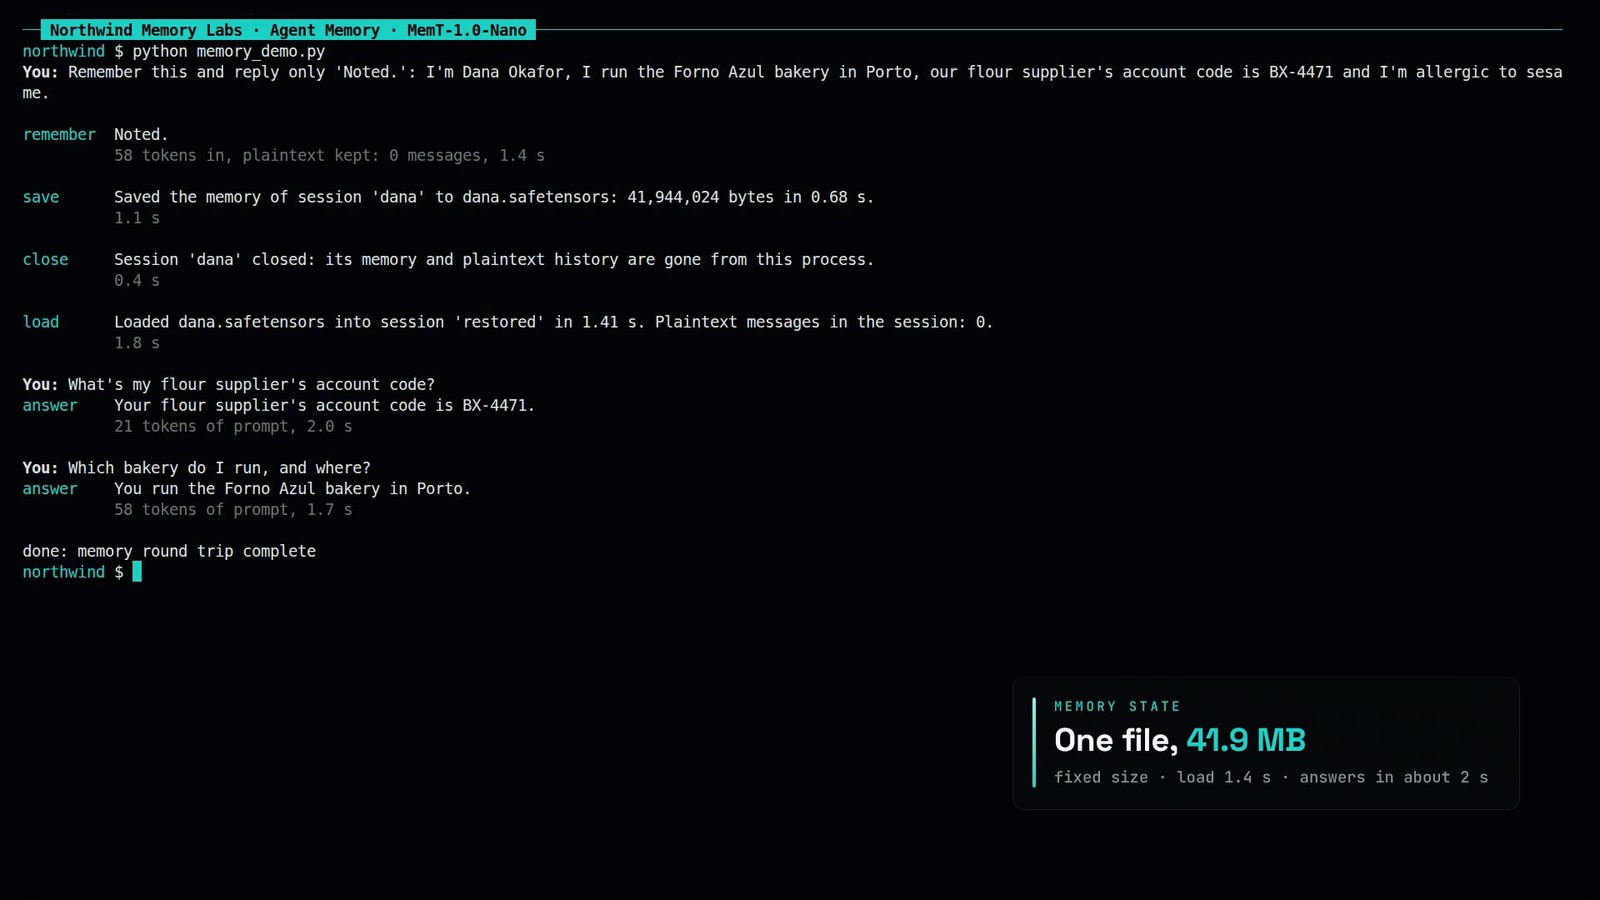
La démo de 65 secondes : retenir, enregistrer, fermer, charger et demander, depuis un client en terminal face au worker.
Délai de disponibilité
| Phase | Temps |
|---|---|
| venv du backend | environ 23 s |
| Téléchargement des poids (37 fichiers, 70,3 GB, sans authentification, environ 300 MB/s) | 235,5 s |
| Premier chargement (backend 0.1.0) | échec, voir le problème 1 |
Démarrage à chaud, de ensure() à prêt | 20,3 s (chargement du modèle 14,8 s), 20,0 s à la deuxième exécution |
| Démarrage à chaud, 8 bits | 29,8 s (chargement du modèle 24,3 s) |
Mesures
Test de mémoire, exécution 2 (bf16 ; les secondes sont du temps GPU dans le backend, l'aller-retour ajoute 0,3 à 1,1 s) :
| Étape | Tokens d'entrée | Tokens de sortie | Secondes | Résultat |
|---|---|---|---|---|
| remember 1 : nom, Forno Azul à Porto, four Rational iCombi Pro, code fournisseur BX-4471 | 64 | 128 | 12,72 | réponse, texte gardé 0 |
| remember 2 : allergie au sésame, rentrée de sa fille Ines le 9 septembre | 43 | 53 | 5,68 | "Noted! ...", texte gardé 0 |
save dana | 1,02 | 41 944 024 B | ||
| close | session disparue | |||
load dana dans une nouvelle session | 1,99 | 0 message en texte | ||
| ask : boulangerie et ville | 27 | 19 | 2,05 | juste |
| ask : code fournisseur | 68 | 16 | 1,80 | juste |
| ask : pain du week-end vu l'allergie | 113 | 71 | 6,72 | juste (pain au levain portugais sans sésame) |
| ask : prénom de la fille et date de rentrée | 210 | 16 | 1,83 | juste |
| témoin : nouvelle session, sans fichier, code fournisseur | 21 | 169 | 14,26 | refuse, ne sait pas |
Les tokens d'entrée passent de 27 à 210 dans la session restaurée parce que les tours de question restent comme historique en texte. La première vérification par mots-clés de main.py a compté la date de rentrée comme ratée parce qu'elle attendait "9 september" ; à la lecture, c'est juste, et la vérification commitée est plus souple.
Test d'entrée longue (bf16, MEMT_MAX_NEW_TOKENS=96) : un remember de 1 467 tokens d'entrée, réponse "Noted.", 4,02 s, texte gardé 0. Enregistrement 0,66 s, 41 944 024 B. Chargement 1,35 s. Cinq sur cinq retrouvés : code du frigo 5832 (1,55 s), propriétaire Rui Matos avec un loyer le 3 (2,01 s), police PT-77-0912 (1,76 s), gâteau Silva le 14 novembre, trois étages au citron (2,45 s), technicien de secours Marta avec un téléphone finissant par 4410 (2,21 s).
Client de la démo : remember de 58 tokens, "Noted." en 1,4 s ; enregistrement 0,68 s ; chargement 1,41 s ; "BX-4471" en 2,0 s (prompt de 21 tokens) ; "Forno Azul bakery in Porto" en 1,7 s (prompt de 58 tokens).
Vitesse : environ 9 à 10 tokens/s en décodage (128 tokens en 12,72 s) avec les kernels GatedDeltaNet de référence de PyTorch (flash-linear-attention et causal-conv1d non installés) et generate de HF. Sans réglage.
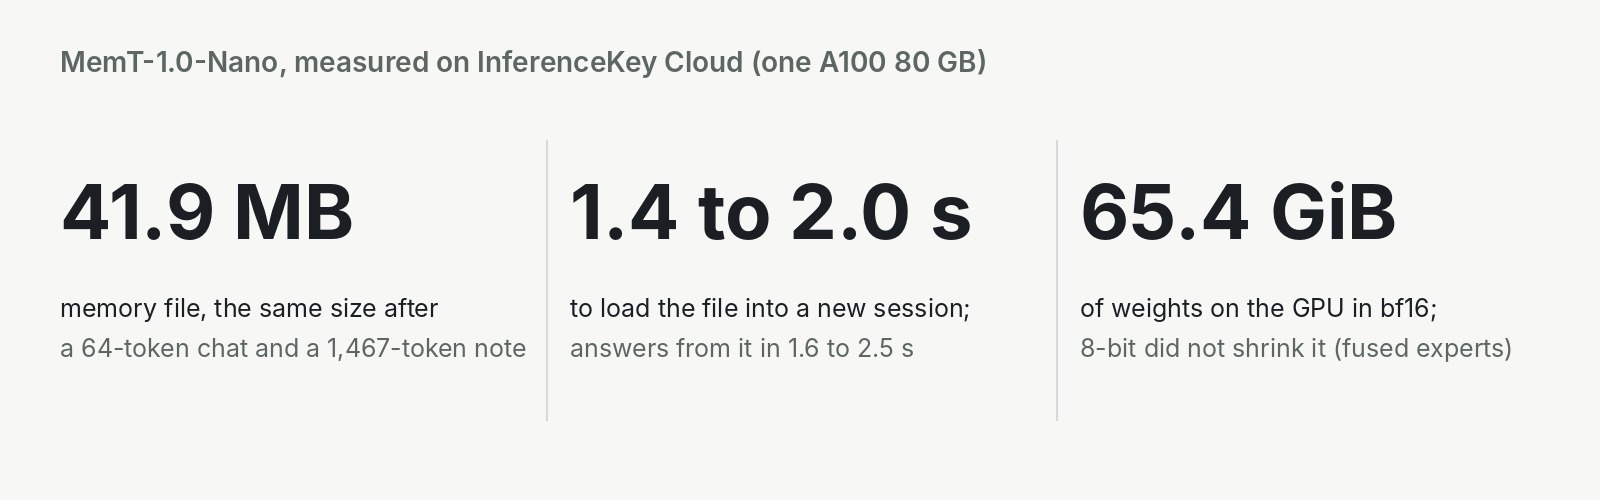
Mémoire GPU, bf16 : 65,4 GiB alloués après le chargement, pic alloué de 65,45 à 65,55 GiB pendant les requêtes, 67 605 MiB sur la carte au repos après le chargement, pic de la carte à 68 117 MiB (nvidia-smi, échantillons toutes les 1 s). Le récit donne ces valeurs en GiB (pic de 66,5 GiB ; le chargement 8 bits demandait 63,67 GiB).
Échelle de VRAM
| GPU ou plafond | Config | Pic de VRAM | Temps par sortie | Sortie OK ? | Réelle ou émulée |
|---|---|---|---|---|---|
| A100-SXM4 80 GB | bf16, Transformers 5.12.1, sdpa, tout le modèle sur le GPU 0 | 68 117 MiB carte (65,5 GiB alloués) | ask 1,6 à 2,5 s, environ 9 à 10 tokens/s | oui, rappel 9/9 | réelle |
| 48 GB (plafond torch de 44 GiB sur l'A100) | bitsandbytes 8 bits | échec au chargement | non : torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 63.67 GiB ... 44.00 GiB allowed | émulée | |
| A100 80 GB, sans plafond (diagnostic) | bitsandbytes 8 bits | 67 695 MiB carte (63,67 GiB alloués) | non : le premier remember échoue avec expected mat1 and mat2 to have the same dtype, but got: c10::BFloat16 != signed char | réelle |
Pourquoi le 8 bits réduit à peine : les 256 experts fusionnés par couche sont des paramètres 3D, pas des nn.Linear, donc bitsandbytes les laisse en bf16 (environ 2 GiB gagnés). Pas essayé : une vraie carte de 48 GB, H100, déchargement sur CPU, fp8, quantifications de la communauté (aucune de MemTensor au moment du test). Le plus petit qui a passé : une A100 de 80 GB en bf16.
La voie SGLang des auteurs (non testée)
memt-sglang(import memt_sglang) dansMemTensor/MemT-1.0: mémoire de session native sur SGLang 0.5.16. Épingle PyTorch 2.11.0, Transformers 5.12.1,flashinfer-python[cu13]0.6.14,sglang-kernel0.4.5. PolyForm Noncommercial 1.0.0.inference/start_memt_nano.sh:CUDA_VISIBLE_DEVICES=0,1,--tp-size 2 --ep 1 --dp-size 1,--max-prefill-tokens 16384,--max-sessions-per-rank 6,--max-inflight-commits-per-rank 2,--min-kv-tokens 2048,--max-total-tokens 65536,--max-running-requests 8,--mem-fraction-static 0.60,--dtype bfloat16, backends triton pour l'attention, l'attention linéaire et le MoE, snapshots dans./memt-state, port 30000. Le guide dit que ces réglages n'ont "not been deeply optimized".- Contraintes : exécution eager sur un seul nœud, safetensors BF16 non quantifiés uniquement ; le chunked prefill, le radix cache, l'overlap scheduling et les graphes CUDA doivent rester désactivés ; le lanceur rejette
trust_remote_code. - Les snapshots sont des
.safetensorscôté serveur sous--state-directory. Routes :GET /memt/identity,GET /memt/capabilities,POST /memt/control,POST /generateavec un RID MemT. Baux (TTL de 1 à 3600 s, 300 par défaut), transactions et époques ; un redémarrage du serveur demande une nouvelle session plus l'import d'un snapshot. Les snapshots HF et les exports du serveur sont interchangeables pour le même modèle et le même tokenizer. - La documentation ne dit pas si Nano tient sur une seule carte de 80 GB par cette voie, ni quel débit elle donne, et nous ne l'avons pas testé.
- Nous n'avons trouvé aucun support de MemT dans vLLM. Le lanceur
memt-sglangest l'intégration propre aux auteurs, pas SGLang d'origine.
Chiffres de l'article (non reproduits)
arXiv 2610.26825, "MemT-1.0: Towards Memory-Native Evolution", MemTensor Team, v1 le 19 octobre 2026, v2 le 20 octobre. 34B tokens d'entraînement, pré-entraînement continu plus post-entraînement, Gated DeltaNet-2 avec une mise à jour stable de la mémoire au niveau du token, Mixture-of-Storage.
- Tableau 2, 11 benchmarks de mémoire, moyenne : MemT-1.0-Flash 50,6, MemT-1.0-Nano 47,0, Temp-LoRA 38,1 (meilleure autre méthode paramétrique). Mémoire en texte sur le backbone Qwen3.6-35B-A3B : MemOS 68,5, Full Context 66,3, Mem0 66,0, OpenViking 65,4, DenseRAG 56,5, Graphiti 45,7. Nano sur LongMemEval-S 32,6 contre Full Context 76,8 et MemOS 80,8 ; sur BEAM-1M 35,8 contre MemOS 71,3.
- Tableau 3, capacités générales dans le réglage avec bruit, écart face à Qwen3.6-35B-A3B : MMLU-Pro -1,6, GPQA Diamond -1,5, IFEval +3,3, LongBench v2 -2,0, BigCodeBench-Hard +2,0, LiveCodeBench v6 -5,8, moyenne -0,9.
- Section 6.5, inférence HF sur deux GPU, concurrence 1, historiques BEAM : plus lent que le contexte complet sur les historiques courts, à peu près égal à 32K, accélérations de bout en bout d'environ 1,20x à 64K, 1,86x à 128K et 3,99x à 256K. TTFT de la question (temps jusqu'au premier mot de la réponse) d'environ 104 à 112 ms contre environ 257 ms (128K) et 445 ms (256K) pour le contexte complet.
- Sections 4.3 et 6.6 : état par trajectoire environ 33 fois plus petit que le contexte complet à 64K et 66 fois à 128K.
Problèmes restants et statut
- Le chargement depuis le chemin de snapshot du cache HF échoue avec
trust_remote_code.from_pretrained(<snapshot dir>)lèveFileNotFoundError: ... models--MemTensor--MemT-1.0-Nano/blobs/configuration_memt.py, parce que Transformers suit le lien symboliquemodeling_memt.pyjusque dansblobs/et y résout l'import relatif. Statut : corrigé dans le backend 0.1.1 en chargeant par repo id plus révision. - Le 8 bits ne tient pas sur une carte plus petite (échelle ci-dessus). Statut : pas de contournement ; il faut une quantification officielle ou une quantification qui tienne compte des experts.
- Modifier
config.envsur un workload de backend sur mesure en cours ne fait rien. Le manager envoiereload_backendet le worker loguereload_backend handle_load_model failed: unknown backend memt-1-0-nano; l'ancien backend continue de servir. Contournement : supprimer le workload et relancermain.py. Statut : ouvert. - La création manuelle d'une machine GPU ignore le réglage de disque. Le handler code en dur
DEFAULT_POD_DISK_GB = 100et ne lit plusRUNPOD_CONTAINER_DISK_GB. 70,3 GB de poids plus un venv torch, c'est juste sur 100 GB. Statut : patché localement pour ce test seulement, ouvert. - Le testeur de chat du panneau ne sait pas piloter un backend
process()uniquement (il fait du streaming). La démo a utilisé un client en terminal. Statut : connu, ouvert. - Le fichier d'état ne peut pas passer par l'API (41,9 MB face à une limite de résultat de 8 MB). Statut : voulu pour l'instant ; il reste sur le disque du worker et l'API renvoie la taille et le sha256.
- Les tunnels entre notre manager de test et le worker sont tombés une fois ; une boucle de supervision les a reconnectés sans redémarrer le worker.
Limites
Neuf questions de rappel plus un témoin, sur nos propres faits inventés (deux de plus dans le client de la démo), décodage glouton, requêtes une à la fois. La session HF utilise un verrou par session et le backend sérialise les requêtes, donc le débit multi-utilisateur est inconnu. Un seul type de carte. Aucun benchmark de l'article n'a été reproduit, et notre 64 fois est un calcul, pas une mesure. Nous n'avons mesuré ni le temps de relecture ni la mémoire de carte par session face à une référence en contexte complet. L'endpoint hébergé d'InferenceKey n'est pas testé : tout a tourné sur un manager de test local.
Crédits
MemTensor a construit MemT-1.0, entraîné le bloc de mémoire, écrit l'API de session, l'intégration SGLang et l'article, et publié les poids de Nano sous Apache-2.0. L'équipe Qwen a fait Qwen3.6-35B-A3B, le backbone de Nano. Hugging Face Transformers fait tourner le code sur mesure des auteurs. Nous avons repéré le modèle dans la vidéo d'actualité d'AI Search du 25 octobre, et r/LocalLLaMA en parlait dans un fil du 22 octobre. Notre part : le backend sur mesure, le déploiement sur InferenceKey, la correction du chargement, les tests de mémoire et les mesures.