Underdog Bark 3.0 Pro gegen Qwen3-ASR-1.7B: knapp bei den Fehlern, ein Viertel der Größe, läuft auf einer CPU
Auf 40 englischen Clips lag Bark 3.0 Pro bei 6,28 % falscher Wörter, Qwen3-ASR-1.7B bei 7,03 %, knapp. Bark lief auch ohne GPU, auf vier CPU-Threads.
Kann ein Speech-to-Text-Modell mit einem Viertel der Größe von Qwen3-ASR-1.7B auf denselben Aufnahmen mithalten? Auf 40 englischen Clips aus den Standard-Benchmark-Sets lag es knapp vorn. Underdog Bark 3.0 Pro, ein offenes Modell von Conway Research mit 1,25 GB, schrieb 6,28 % der Wörter falsch. Qwen3-ASR-1.7B, ein Modell mit 4,7 GB, lag auf demselben Audio und derselben RTX 3090 bei 7,03 %. Der Großteil des Abstands kommt von einer Angewohnheit: Bark behält die Füllwörter und Wiederholungen, die Menschen sagen, und Qwen lässt viele davon weg. Bark machte aus fünf Minuten Sprache Text in weniger als drei Sekunden GPU-Arbeit, 4,5 Sekunden inklusive Weg über das Netzwerk. Vier Prozessor-Threads transkribieren eine Aufnahme schneller, als sie abläuft. Eine GPU braucht etwa 2 GB Speicher, sobald langes Audio in Stücke geschnitten wird.
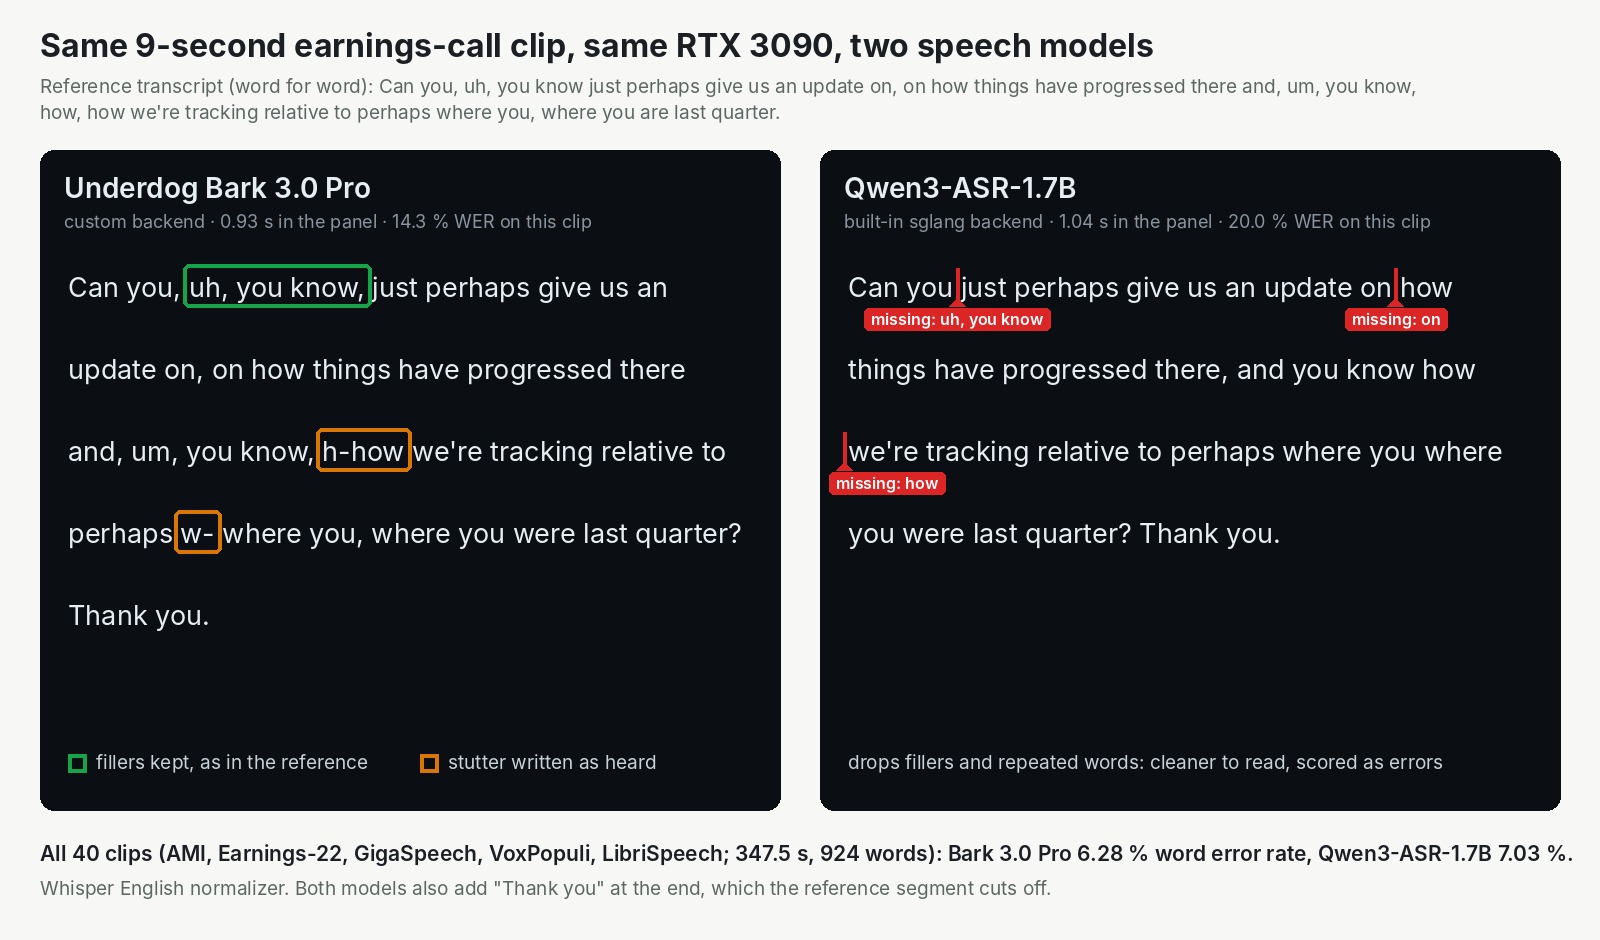
Gleicher Clip, gleiche Karte. Bark behält das "you know" und die Wiederholungen, die auch die Referenz behält, und Qwens saubererer Text verliert dafür Punkte.
Ein Modell mit 1,25 GB, das nach eigener Zählung beim besten offenen Ergebnis gleichauf liegt
Die Behauptung, die uns hinschauen ließ, steht auf der Hugging-Face-Seite des Modells. Bark kommt auf den sieben englischen Test-Sets des Open ASR Leaderboard, einer öffentlichen Speech-to-Text-Rangliste, auf eine durchschnittliche Wortfehlerrate von 4,29 %. Die Wortfehlerrate ist der Anteil der Wörter, die ein Modell falsch erkennt, weniger ist also besser. Die Seite nennt das den niedrigsten Wert aller offenen Modelle. Der Vorsprung beträgt 4,286 gegenüber 4,291 für Hojo-ASR-V1, ein Gleichstand mit einem Modell, das etwa zehnmal so groß ist. Dieselbe Tabelle führt Qwen3-ASR-1.7B bei 4,43 % und Whisper large-v3 von OpenAI bei 6,04 %.
Dieser Wert ist selbst gemeldet. Die Seite sagt, die Bark-Zeilen nutzten den Bewertungscode des Leaderboards, seien aber "not on the leaderboard yet". Der Größenunterschied braucht kein Vertrauen: 1.254 MB auf der Platte gegenüber 4.699 MB für Qwen3-ASR-1.7B, etwas mehr als ein Viertel.
NVIDIA hat das Basismodell trainiert, Parakeet TDT 0.6B v3, ein Sprachmodell für 25 europäische Sprachen, veröffentlicht im August 2025. Moondream hat daraus dann eine verbesserte Version gemacht. Conway Research hat sie anschließend nachtrainiert, zu Bark verkleinert und am 15. Oktober auf Hugging Face veröffentlicht. Das Underdog-Team hat den Release-Post geschrieben, der auch drei kleinere Geschwister auflistet, bis hinunter zu 163 MB. Das hf-audio-Team pflegt das Leaderboard und veröffentlicht das Test-Audio, das wir verwendet haben. Entdeckt haben wir Bark im News-Video von AI Search vom 25. Oktober. Der Moderator sagte, die Pro-Version "should still be able to fit on most consumer GPUs". Unser Teil war, Bark für das Deployment zu verpacken, es auf einer Karte neben Qwen3-ASR laufen zu lassen und die Fehler zu zählen.
Alle drei Modelle der Kette stehen unter derselben Lizenz, CC-BY-4.0. Sie erlaubt kommerzielle Nutzung, solange du NVIDIA, Moondream und Conway Research nennst.
Der Test: 40 Clips vergleichen die beiden Modelle, sie wiederholen nicht die Zahlen der Model Card
Die Seite des Modells bewertet vier der Sets, nachdem Fehler in ihren Referenztexten korrigiert wurden. Wir haben die Originalversionen verwendet, deshalb sind unsere absoluten Zahlen nicht mit der Tabelle der Seite vergleichbar. Vergleichbar ist nur das Verhältnis der beiden Modelle zueinander.
Wir haben aus fünf Sets der Testdaten des Leaderboards je acht Clips zufällig gezogen:
- AMI: Büro-Meetings.
- Earnings-22: Telefonkonferenzen von Unternehmen zu Quartalszahlen.
- GigaSpeech: Podcasts und YouTube.
- VoxPopuli: Reden im Europäischen Parlament.
- LibriSpeech test-other: Hörbücher.
Jeder Clip dauert 4 bis 20 Sekunden, insgesamt knapp sechs Minuten und 924 Wörter. Außerdem haben wir 33 weitere Abschnitte aus Telefonkonferenzen zu einer fünfminütigen Datei zusammengefügt, um langes Audio zu testen.
Beide Modelle liefen auf derselben RTX 3090 mit 24 GB, eine Anfrage nach der anderen. Wir haben beide gleich bewertet, mit den Bewertungsregeln, die OpenAI für Whisper geschrieben hat: Sie ignorieren Groß- und Kleinschreibung, Satzzeichen sowie "uh" oder "um", sodass nur echte Wortunterschiede zählen. Der Test lief in unserer Cloud über einen lokalen Test-Build von InferenceKey, nicht über den gehosteten Dienst.
Ergebnisse: 6,28 % gegen 7,03 %, und der Abstand sind vor allem Füllwörter wie "you know"
Bark schrieb über die 40 Clips 6,28 % der Wörter falsch, Qwen3-ASR-1.7B 7,03 %. Set für Set ist es eine geteilte Entscheidung:
| Set (je 8 Clips) | Bark 3.0 Pro | Qwen3-ASR-1.7B |
|---|---|---|
| Meetings (AMI) | 11,54 % | 16,92 % |
| Telefonkonferenzen zu Quartalszahlen (Earnings-22) | 8,15 % | 10,87 % |
| Podcasts und YouTube (GigaSpeech) | 3,54 % | 4,04 % |
| Parlamentsreden (VoxPopuli) | 8,04 % | 5,53 % |
| Hörbücher (LibriSpeech test-other) | 2,35 % | 1,88 % |
| Alle 40 Clips, 924 Wörter | 6,28 % | 7,03 % |
924 Wörter sind eine kleine Stichprobe. Ein paar Wörter verschieben die Zahl eines Sets, lies die Summe also als "knapp, mit Bark vorn", nicht als Rangliste.
Um zu sehen, woher der Abstand kommt, brauchst du eine Idee: ein wörtliches Transkript gegenüber einem bereinigten. Ein wörtliches Transkript schreibt auf, was gesagt wurde, inklusive Fehlstarts und Füllwörtern. Ein bereinigtes schreibt auf, was der Sprecher meinte. Stell dir den Live-Bootleg mit allem Husten vor, gegenüber der Studioversion. Die Referenztexte des Leaderboards, von Menschen geschrieben, sind wörtlich. Bark auch, und zwar absichtlich: "Bark 3.0 writes what was said, fillers included. It does not clean speech up," schreiben seine Autoren. Qwen3-ASR neigt zum bereinigten Text.
Das erklärt den Großteil des Unterschieds. Qwen ließ 29 Wörter weg, die in den Referenztexten stehen, Bark 11. Bei Qwen waren das meist Füllwörter und Wiederholungen: "you know", "on, on", "how, how". Bei falsch verstandenen Wörtern lag Qwen leicht vorn (28 gegenüber 32), Barks Vorsprung kommt also davon, dass es behält, was gesagt wurde, nicht davon, dass es besser hört. In die andere Richtung verliert Bark Punkte. Es schreibt Stotterer so, wie sie zu hören sind, "h-how" und "w- where", und auch die zählen als Fehler.
Der Clip aus der Telefonkonferenz im Bild oben zeigt beide Angewohnheiten in neun Sekunden. Bark kam darauf auf 14,3 %, Qwen auf 20,0 %. Hier ist Bark:
Can you, uh, you know, just perhaps give us an update on, on how things have progressed there and, um, you know, h-how we're tracking relative to perhaps w- where you, where you were last quarter? Thank you.
Und hier Qwen3-ASR:
Can you just perhaps give us an update on how things have progressed there, and you know how we're tracking relative to perhaps where you where you were last quarter? Thank you.
Am größten ist Barks Vorsprung bei Meetings und Telefonkonferenzen, wo die Referenztexte viele Füllwörter und Wiederholungen behalten, die Qwen weglässt. Warum Qwen bei Parlamentsreden und Hörbüchern besser abschneidet, haben wir nicht herausgefunden.
Fünf Minuten Audio in weniger als drei Sekunden GPU-Arbeit, in einem Stück
Bark ist so schnell, dass das Netzwerk der langsame Teil ist. Die 40 Clips brauchten weniger als fünf Sekunden GPU-Arbeit, etwa 0,12 Sekunden pro Clip. Inklusive Weg über das Netzwerk kam ein typischer Clip in einer halben Sekunde zurück. Bei Qwen3-ASR dauerte ein typischer Clip 0,73 Sekunden. Qwen3-ASR lief auf anderer Serving-Software, das vergleicht also genauso sehr die Setups wie die Modelle.
Die fünfminütige Datei brauchte 2,8 Sekunden GPU-Arbeit in einer einzigen Anfrage. Mit Upload und Antwort waren es 4,5 Sekunden. Bark lieferte das ganze Transkript, 715 Wörter. Sauber bewerten konnten wir es nicht: Der Referenztext, den wir zusammengefügt haben, hat Lücken an den Nahtstellen (Zahl im Anhang).
Qwen3-ASR lieferte 212 Wörter und hörte auf. Warum, haben wir nicht untersucht.
Wo es nicht reicht: nur Englisch, wörtlich, keine Zeitstempel
- Nur Englisch. Das Basismodell kann 25 europäische Sprachen. Bark nicht.
- Wörtlich, mit Absicht. Wenn du bereinigten Text willst, brauchst du einen Bereinigungsschritt. Die Autoren liefern ein separates Bark 3.0 Clean, das Füllwörter weglässt. Das haben wir nicht getestet.
- Noch keine Wort-Zeitstempel und keine Sprechernamen, laut der Seite der Autoren. Wenn deine Untertitel oder Protokolle sie brauchen, müssen sie aus einem anderen Tool kommen.
Welche GPU: keine. Vier Prozessor-Threads schafften fünf Minuten in 31 Sekunden
Die kleinste Maschine, die funktionierte, hatte keine Grafikkarte. Auf vier Threads eines Server-Prozessors transkribierte Bark die fünfminütige Datei in 31 Sekunden. Auf sechzehn Threads dauerte es 14 Sekunden. Die Transkripte waren auf allen 40 Clips Wort für Wort dieselben wie auf der GPU.
Auf einer GPU ist Bark winzig. Das Modell belegt etwa 1,3 GB Speicher, und mit nur Bark geladen kam die Karte nie über etwa 2,8 GB, weniger als ein Achtel ihrer 24 GB.
Um kleinere Karten zu prüfen, ohne sie zu haben, haben wir begrenzt, wie viel vom Speicher der 3090 Bark nutzen durfte. Das bildet das Speicherlimit einer kleineren Karte nach, nicht ihren langsameren Chip. Eine Grenze von etwa 4 GB änderte nichts: gleiche Transkripte, gleiches Tempo.
Unter einer Grenze von etwa 2 GB lief alles durch, sobald langes Audio in Stücke von 60 Sekunden geschnitten wurde, eine Einstellung in unserem Beispiel. Ohne die Stücke verlangte die fünfminütige Datei auf einmal zu viel Speicher und scheiterte. Mit ihnen lief sie deutlich unter der Grenze durch, und die 40 Clips kamen mit denselben Transkripten heraus wie zuvor. Auf der begrenzten GPU machten die Stücke nichts langsamer.
Wir haben außerdem versucht, sieben Typen kleiner Karten mit 6 bis 20 GB zu mieten, etwa eine RTX A2000, eine RTX 3070 und eine RTX 4000 Ada. In acht Versuchen war keine verfügbar. Wir können also keine bestimmte kleine Karte als ausreichend nennen.
Auf InferenceKey: eine kurze Python-Datei, Neustart in 8 Sekunden
Eine Python-Datei mit weniger als 200 Zeilen serviert Bark über die Transformers-Bibliothek von Hugging Face, wie es die Seite des Modells verspricht. Die üblichen Serving-Tools können es nicht ausführen. Die Datei lädt das Modell herunter, lädt es in den Speicher und macht aus Audio Text. Jedes Programm, das schon mit der Transkriptions-API von OpenAI spricht, kann ihr eine Datei schicken.
Der erste Start dauerte 322 Sekunden, etwa 300 davon für die Installation von Software auf einer frischen Maschine. Der Download des Modells dauerte 4 Sekunden, das Laden 2,4. Danach waren Neustarts in 7 bis 8 Sekunden bereit. Qwen3-ASR, das die Plattform ohne eigenen Code ausführt, brauchte beim ersten Start 357 Sekunden. Beide Modelle teilten sich die eine 3090.
Zwei Ecken und Kanten, an die du auch stoßen wirst:
- Audio-Uploads enden bei etwa 2 MB. Das sind etwa 65 Sekunden unkomprimiertes Audio. Unser fünfminütiges WAV mit 9,7 MB wurde als zu groß abgelehnt. Der Workaround ist ein komprimiertes Format: Dieselben fünf Minuten passen in 1,1 MB. Status: offen. Das README des Beispiels dokumentiert es.
- Wenn du das Beispiel erneut ausführst, während das Modell noch deployt ist, hängt das Skript. Das Modell antwortet weiter, aber das Skript wartet zehn Minuten. Workaround: Lösche das Deployment, bevor du es erneut ausführst. Status: offen.
Die anderen Probleme, die wir gefunden haben, stehen unten im Abschnitt für Ingenieure.
Solltest du es nutzen? Ja, für wortgetreue englische Transkripte auf kleiner Hardware
- Wenn du englische Meetings, Telefonate oder Interviews transkribierst und jedes Wort so brauchst, wie es gesagt wurde, lohnt es sich. Bei unseren Meetings und Telefonkonferenzen machte es weniger wörtliche Fehler als Qwen3-ASR-1.7B.
- Wenn du Text willst, den Menschen ohne Nachbearbeitung lesen, rechne mit "uh" und "you know" in der Ausgabe und plane einen Bereinigungsschritt ein.
- Wenn dein Audio nicht auf Englisch ist, such woanders.
- Wenn du keine freie GPU hast, schaffen ein paar Threads eines Server-Prozessors eine Aufnahme schneller, als sie abläuft.
- Wenn du es in einem Produkt auslieferst, erlaubt die Lizenz das mit Namensnennung.
Du brauchst ein InferenceKey-Projekt, eine Audiodatei und einen NVIDIA-Worker mit etwa 2 GB frei, oder BARK_DEVICE=cpu ohne GPU. Um dein eigenes Audio zu transkribieren und zu bewerten, führe einmal python publish.py aus, dann python main.py, aus dem SDK-Beispiel.
Für Ingenieure
Modell und Dateien
- Model Card, NOTICE, Underdog-Release-Post (datiert auf den 15. Oktober 2026, "The Underdog team"), Model Card des kleinen Bark 3.0, Parakeet TDT 0.6B v3.
- 0.6B Parameter, nur Englisch, volle Präzision (bf16). Repo
ConwayResearch/Underdog-Bark-3.0-Pro, erstellt und zuletzt geändert am 2026-10-15 (07:05:36Z / 07:05:51Z), sha4b5c51e04aa8d16dda9ecdff71bc29f7360149e4, nicht gated. Lizenzcc-by-4.0, Librarytransformers, Pipelineautomatic-speech-recognition,base_model: nvidia/parakeet-tdt-0.6b-v3mitbase_model_relation: finetune. 1.079 Downloads im letzten Monat und 36 Likes am 2026-10-27. - Das Repo ist insgesamt 2,49 GB groß, weil es auch Core-ML- und MLX-Kopien enthält. Die PyTorch-Dateien, die das Backend herunterlädt, sind
model.safetensors(1.254.196.636 Bytes, bf16) plus Configs und Tokenizer, etwa 1,26 GB. config.json:ParakeetForTDT, FastConformer-Encoder (24 Layer, hidden 1024, 8 Heads, 128 Mel-Bins, Subsampling 8) und ein TDT-Decoder (2 Layer, hidden 640, Dauern 0 bis 4), Vokabular 8.193,transformers_version5.19.0.- Namensnennungskette (NOTICE):
nvidia/parakeet-tdt-0.6b-v3(c) NVIDIA Corporation, CC-BY-4.0, undmoondream/parakeet-ultra(c) Moondream, CC-BY-4.0. Änderungen: "post-trained and compressed by Conway Research". - Empfohlenes Laden laut Model Card:
AutoProcessorplusParakeetForTDT.from_pretrained(repo, dtype=torch.bfloat16).to("cuda"), Mono-Eingang mit 16 kHz, 4.000 Samples (0,25 s) Stille vorangestellt, dannmodel.generate(). Greedy Decoding. - Laufzeitumgebungen laut Model Card: Windows mit NVIDIA CUDA (Python 3.11,
torch==2.8.0cu128, eine GPU mit BF16-Unterstützung; float16 ist eine ausdrückliche Alternative, die eine eigene Genauigkeitsprüfung braucht; CPU mit--device cpu --dtype float32), Mac Core ML (macOS 15+, getestet auf einem M5 Max, etwa 1,23 GB Download), iOS 18+ über FluidAudio ("Not yet tested on an iPhone or iPad"). Die Underdog-App führt es mit MLX auf Apple Silicon aus. - Bark-3.0-Familie (Release-Post): Bark 3.0, 163 MB, 4,94 % im Schnitt; Bark 3.0 Plus, 180 MB, 4,76 %; Bark 3.0 Pro, 1,25 GB, 4,29 %, "Hugging Face only"; Bark 3.0 Clean, 180 MB, 5,83 %, lässt Füllwörter weg, Standard in der Underdog-App. Das kleine Bark 3.0 kommt als gepackte Datei
model.bark, geladen mitbark_loader.py. Der Release-Post sagt außerdem "English only", "No word timings or speaker names yet" und dass das kleine Bark 3.0 auf einem M5 Max 5 Minuten in einer halben Sekunde schafft (595x, Angabe der Autoren, nicht die Pro-Version).
Die Benchmark-Tabelle der Model Card (selbst gemeldet, nicht reproduziert)
Vollständige Test-Sets, mit bereinigten Versionen von AMI, Earnings-22, GigaSpeech und VoxPopuli. Die Zeilen außer Bark sind die veröffentlichten Zeilen des Leaderboards mit Stand 9. Oktober 2026. Die Bark-Zeilen "use its scoring code and are not on the leaderboard yet". Die vollständige Behauptung der Model Card: "the lowest of any open model by the leaderboard's own scoring: 4.286 against 4.291 for Hojo-ASR-V1, a 12 GB download."
| Modell | Download | LS clean | LS other | AMI | Earnings-22 | GigaSpeech | SPGISpeech | VoxPopuli | Schnitt |
|---|---|---|---|---|---|---|---|---|---|
| Bark 3.0 Pro | 1.254 MB | 1,38 | 3,11 | 7,16 | 5,65 | 7,46 | 3,54 | 1,70 | 4,29 |
| Qwen3-ASR-1.7B | 4.699 MB | 1,26 | 2,94 | 8,31 | 5,84 | 7,22 | 2,57 | 2,85 | 4,43 |
| Parakeet TDT 0.6B v3 | 2.508 MB | 1,52 | 3,13 | 9,42 | 5,85 | 7,99 | 3,63 | 3,05 | 4,94 |
| Whisper large-v3 | 9.261 MB | 1,56 | 3,52 | 13,63 | 7,99 | 8,35 | 2,71 | 4,53 | 6,04 |
| Hojo-ASR-V1 | 11.957 MB | 4,29 |
Ebenfalls auf der Model Card: Canary-Qwen 2.5B 4,55 % und kostenpflichtige APIs, die nicht in der Tabelle stehen (OpenAI GPT-Transcribe 4,70 %, AssemblyAI Universal-3.5 Pro 4,46 %, Gladia Solaria-3 4,70 %, Smallest.ai Pulse 4,54 %, Meta Muse Voice Transcribe 4,93 %). Auf DisfluencySpeech (250 Clips, wörtlich, Füllwörter mitgezählt) meldet die Model Card 2,95 %.
Die eigene Model Card von Parakeet TDT 0.6B v3 nennt einen Schnitt von 6,34 % mit anderen Zahlen pro Set. Der wahrscheinliche Grund sind andere (bereinigte) Versionen der Sets; bestätigt haben wir das nicht. Der Leaderboard-Space ist eine Gradio-App, und seine aktuellen Zeilen haben wir nicht direkt gelesen.
Unser Setup
- Eine RTX 3090 mit 24 GB in unserer Cloud (Treiber 580.65.06, 21 vCPU AMD EPYC 7C13, 100 GB Container-Disk, ein Image mit PyTorch 2.8, CUDA 12.8 und Ubuntu 24.04), insgesamt 41 Minuten. Ein lokaler InferenceKey-Manager (von
mainbeicc0024a4) hat sie über Dev-Tunnel gebootstrappt. Kein Code-Patch an der Plattform. - Bark: Custom Backend
underdog-bark-pro0.1.0,task_typeaudio2text, transformers 5.19.0, torch 2.8.0 cu128, bf16. - Qwen3-ASR-1.7B: eingebautes Backend
sglang, sglang 0.5.14,--trust-remote-code --mem-fraction-static 0.45, dasselbe Setup wie im SDK-Beispielsglang-qwen3-asr-private. Es konnte Barks Custom Backend nicht mitnutzen, weil das Paketqwen-asrtransformers 4.57.6 festschreibt. - Warum ein Custom Backend: vLLM, SGLang und llama.cpp servieren keine Parakeet-TDT-Modelle.
- Clips: 8 pro Set aus Parquet-Shards von
hf-audio/open-asr-leaderboard(ami test-00002, earnings22 test-00001, gigaspeech test-00004, voxpopuli test-00001, librispeech test.other), Seed 20261027, 4 bis 20 s, insgesamt 347,5 s und 924 Wörter. Lange Datei: 33 weitere Earnings-22-Abschnitte, zusammengefügt mit 0,4 s Pausen, 303,4 s. - Bewertung:
jiwernach dem englischen Whisper-Normalizer (whisper-normalizer). Eine Anfrage nach der anderen, Greedy Decoding. - Bevor wir irgendetwas gemietet haben, lief das Backend lokal auf der CPU (torch 2.8.0+cpu) und transkribierte zwei Clips korrekt.
Schritt für Schritt mit dem SDK-Beispiel
Das Beispiel (Commit fb18916b auf main) enthält backend.py, requirements.txt, publish.py, main.py, asr_eval.py (Multipart-Aufruf plus WER), compare_qwen3_asr.py (Qwen3-ASR-1.7B auf sglang, gleiche Clips, nebeneinander), README.md und .env.example.
cp .env.example .env              # tokens, project slug, IK_WORKER_ID, IK_AUDIO
python -m venv .venv && . .venv/bin/activate
pip install maturin requests jiwer whisper-normalizer
( cd ../../bindings/python && maturin develop --release )
python publish.py                 # once: uploads the backend if INFERENCEKEY_TENANT_ID and INFERENCEKEY_USER_TOKEN are set, else builds dist/*.tar.gz to upload from Dashboard -> Custom backends
python main.py                    # ensure -> wait_until_ready -> transcribe -> score -> delete
IK_KEEP_ALIVE=1 python main.py && python compare_qwen3_asr.py   # side by side
.env braucht INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY, INFERENCEKEY_PROJECT, IK_WORKER_ID (ein NVIDIA-Worker mit einem Treiber für CUDA 12.8 und Python 3.12) und IK_AUDIO (eine Datei oder ein Ordner; eine manifest.json mit Zeilen {"id", "ref"} schaltet die WER-Bewertung ein). Damit publish.py das Backend selbst hochlädt, setze außerdem INFERENCEKEY_TENANT_ID und INFERENCEKEY_USER_TOKEN (ein Session-Token des Dashboards); ohne sie lädst du das dist/*.tar.gz, das es baut, über Dashboard -> Custom backends hoch. Setze INFERENCEKEY_BASE_URL ausdrücklich: Die Steueraufrufe des SDK nutzen standardmäßig https://api.inferencekey.com, aber der Transkriptionsaufruf in main.py und compare_qwen3_asr.py fällt auf https://cloud.inferencekey.com zurück, wenn die Variable nicht gesetzt ist. Jeder OpenAI-Client funktioniert gegen den Endpoint:
curl -s "${INFERENCEKEY_BASE_URL:-https://api.inferencekey.com}/endpoint/$INFERENCEKEY_PROJECT/underdog-bark-pro/v1/audio/transcriptions" \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" -F file=@call.opus -F model=default
Die Antwort ist {"text", "duration", "seconds", "rtfx", "chunks", "vram_peak_gib", "device", "dtype", "model"}.
Was backend.py tut: snapshot_download der festgelegten Revision mit allow_patterns (nur PyTorch-Dateien), ParakeetForTDT.from_pretrained in bf16 auf CUDA (float16 als Fallback auf Karten vor Ampere, float32 auf der CPU), ein Warm-up mit 1 s Stille, dann pro Job: Dekodieren mit soundfile (librosa als Fallback), Resampling mit soxr, 0,25 s Stille voranstellen, generate(). Stellschrauben:
| Variable | Standard | Wirkung |
|---|---|---|
BARK_DEVICE | cuda | cpu läuft in float32 ohne GPU |
BARK_DTYPE | bfloat16 auf CUDA | float16 oder float32 |
BARK_VRAM_LIMIT_GIB | nicht gesetzt | begrenzt den Speicher mit torch.cuda.set_per_process_memory_fraction |
BARK_CHUNK_SECONDS | 600 | schneidet langes Audio in Stücke dieser Länge |
BARK_CPU_THREADS | nicht gesetzt | Anzahl der Threads auf der CPU |
Eine Änderung an einer BARK_*-Variable braucht ein Delete und ein frisches ensure().
Alle Messungen
Genauigkeit, 40 Clips (summary.json pro Lauf):
| Set | Wörter | Bark 3.0 Pro | Qwen3-ASR-1.7B |
|---|---|---|---|
| AMI (4 bis 5 s) | 130 | 11,54 % | 16,92 % |
| Earnings-22 (7 bis 11 s) | 184 | 8,15 % | 10,87 % |
| GigaSpeech (9 s) | 198 | 3,54 % | 4,04 % |
| VoxPopuli (8 bis 13 s) | 199 | 8,04 % | 5,53 % |
| LibriSpeech test-other (4 bis 19 s) | 213 | 2,35 % | 1,88 % |
| Alle (347,5 s) | 924 | 6,28 % (S 32, D 11, I 15) | 7,03 % (S 28, D 29, I 8) |
Tempo:
- Bark, bf16: 4,864 s GPU-Zeit für die 40 Clips (Median 0,118 s pro Clip), 71-fache Echtzeit. Round Trip im Median 0,50 s (0,456 bis 0,713 s, die erste Anfrage 1,73 s), insgesamt 20,81 s. Panel-Tester mit dem Clip aus der Telefonkonferenz: 928 ms.
- Qwen3-ASR-1.7B: Round Trip im Median 0,73 s (0,52 bis 2,60 s), insgesamt 30,61 s. Panel-Tester: 1.039 ms. sglang meldet keine GPU-Zeit.
- Fünfminütige Datei, eine Anfrage: Bark 2,833 s GPU, 4,48 s Round Trip (107x). Qwen 3,71 s Round Trip, abgeschnittene Ausgabe.
Langes Audio: Bark lieferte 715 Wörter, 18,69 % WER (S 39, D 22, I 62) gegenüber der zusammengefügten Referenz mit 658 Wörtern, und 17,78 % mit 60-s-Stücken. Das Alignment zeigt Passagen, die im Audio vorkommen, aber in der Referenz fehlen, und umgekehrt (Abschnittsgrenzen von Earnings-22), die absolute Zahl sagt also mehr über die zusammengefügte Referenz als über das Modell. Qwen3-ASR über sglang 0.5.14 mit Standardeinstellungen lieferte 212 Wörter, endend mit "...Matthew Walker, Credit Suisse. Please go ahead,": 454 von 658 Referenzwörtern fehlten (72,04 %). Die Ursache haben wir nicht untersucht.
GPU-Speicher: Gewichte auf der GPU nach dem Laden 1,18 GiB. PyTorch-Peak (allocated) 1,243 GiB auf den 40 Clips, 2,151 GiB auf der fünfminütigen Datei in einer Anfrage, 1,369 GiB mit 60-s-Stücken. Peak der Karte laut nvidia-smi (Samples alle 1 s) 2.682 MiB (2,81 GB) mit nur Bark geladen, 17.027 MiB mit Qwen3-ASR daneben geladen (sglang reserviert per Einstellung 45 % der Karte, das ist also nicht Qwens Bedarf). Transformers warnt bei jedem Aufruf, dass es das modellunabhängige Standard-max_length (1.000 bis 1.300) nutzt, wie der Runner der Autoren. Kein Abschneiden beobachtet.
Zeit bis bereit: Bark erster Start 322 s (venv und pip von PyTorch mit CUDA-Bibliotheken und transformers etwa 300 s, Snapshot-Download 4,0 s, Laden 2,4 s). Warme Neustarts 7,6 s (4-GiB-Grenze), 7,3 s (2-GiB-Grenze), 8,1 s (2-GiB-Grenze plus Stücke), 6,9 s (CPU, 16 Threads), 6,7 s (CPU, 4 Threads), 8 s (finales main.py). Qwen3-ASR erster Start 357 s (davon etwa 235 s Installation von sglang).
VRAM-Leiter:
| GPU oder Grenze | Konfiguration | Peak | Zeit | Ausgabe | Echt oder emuliert |
|---|---|---|---|---|---|
| RTX 3090 24 GB | bf16, eine Anfrage | 2,151 GiB allocated, 2.682 MiB Karte | 40 Clips 4,864 s; 5 min 2,833 s (107x) | Referenz, 6,28 % | echt |
| 4-GiB-Grenze | bf16, eine Anfrage | 2,151 GiB | 40 Clips 4,909 s; 5 min 2,644 s | 6,28 %, identische Texte | emuliert |
| 2-GiB-Grenze | bf16, eine Anfrage | 1,243 GiB auf Clips | Clips 4,889 s | Clips OK; 5 min: CUDA out of memory. Tried to allocate 476.00 MiB ... 2.00 GiB allowed | emuliert |
| 2-GiB-Grenze | bf16, BARK_CHUNK_SECONDS=60 | 1,369 GiB | Clips 4,94 s; 5 min 2,476 s (123x) | identische Texte auf 40 Clips | emuliert |
| CPU, 16 Threads, AMD EPYC 7C13 | float32, 60-s-Stücke | keine GPU | Clips 20,478 s (17x); 5 min 14,082 s (21,5x) | identische Texte auf 40 Clips | echt |
| CPU, 4 Threads | float32, 60-s-Stücke | keine GPU | Clips 37,934 s (9,2x); 5 min 30,817 s (9,8x) | identische Texte auf 40 Clips | echt |
| RTX A2000 6 GB, RTX 2000 Ada, RTX A4000, RTX 3070, RTX 3080, RTX 4070 Ti, RTX 4000 Ada | echte kleine Karte | nicht gelaufen: keine davon verfügbar | echte Karte, nicht probiert |
Ebenfalls nicht probiert: fp16 auf einer Karte vor Ampere, int8, die kleineren Checkpoints Bark 3.0 und Plus (anderes Format model.bark), die Wege über Apple Core ML und MLX.
Beispielausgaben
earnings22-01(9,26 s): die beiden im Text zitierten Transkripte. Bark 14,3 % (0,79 s Round Trip im ersten Lauf), Qwen 20,0 %. Beide fügen "Thank you" hinzu, das der Referenzabschnitt abschneidet.librispeech_other-03(18,6 s): Bark "At a quarter to ten, a valet entered. He composed with a little groom ..." in 0,62 s Round Trip, 0 % WER.
Demo-Video
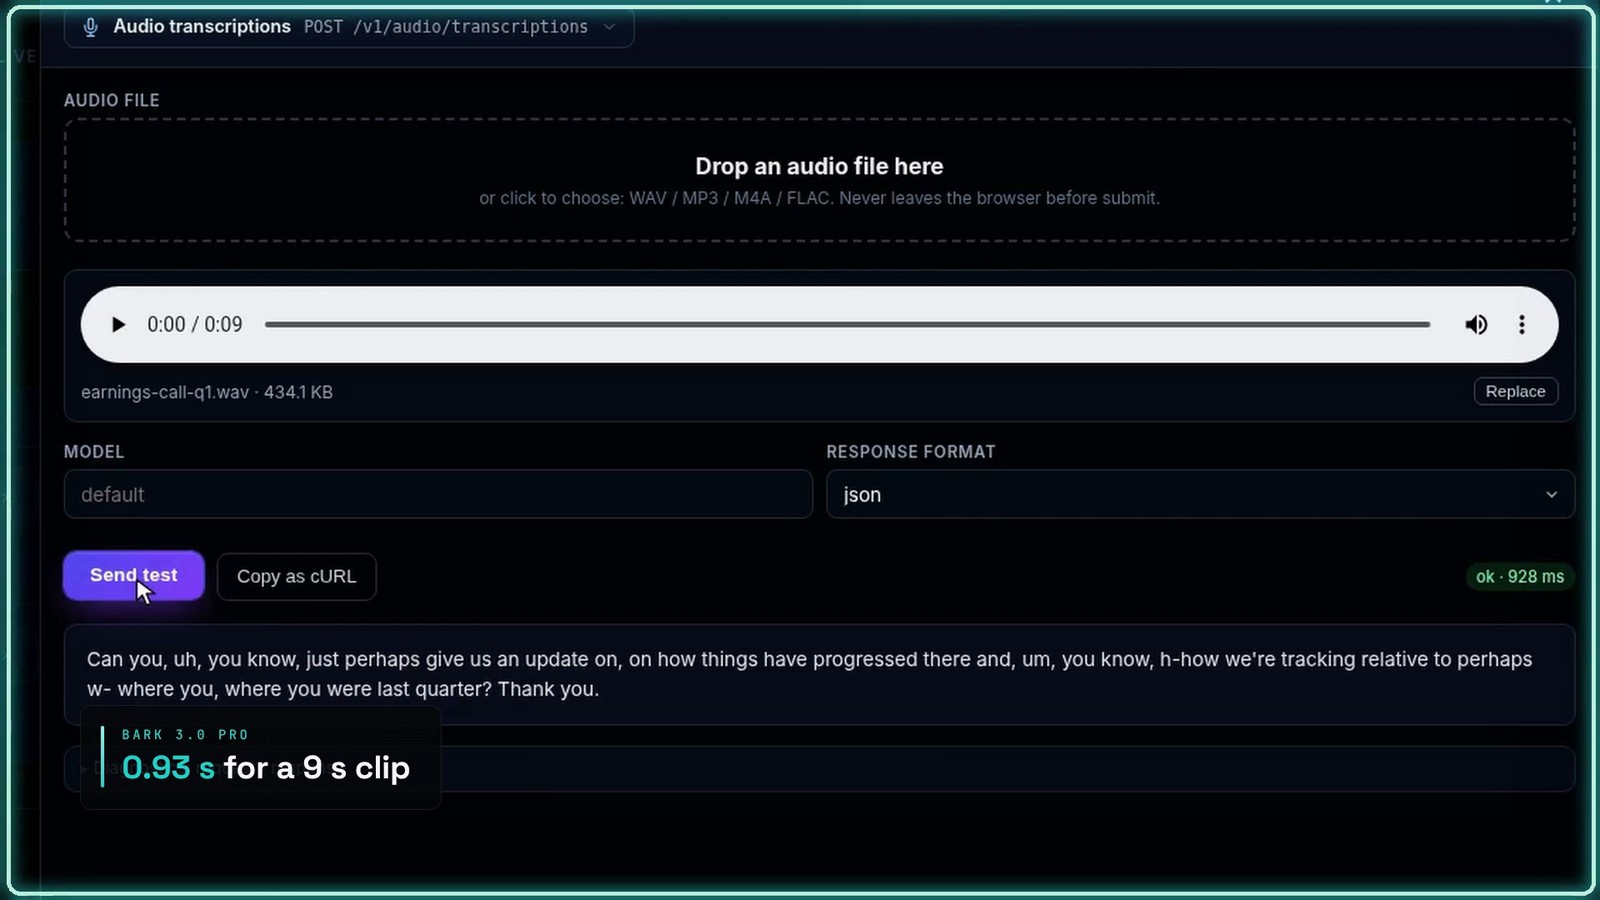
148 s. Kapitel: das Modell (die Seite der Autoren mit Nennung auf dem Bildschirm und ihr Benchmark, markiert als "not reproduced by us"), unser Test (beide Modelle auf einer RTX 3090, der Clip aus der Telefonkonferenz in 928 ms und 1.039 ms, die WER auf 40 Clips) und welche Hardware. Das Video sagt "under three seconds" für fünf Minuten Audio: 2,833 s GPU-Zeit, 4,48 s Round Trip.
Gefundene Probleme
- 2-MiB-Body-Limit auf
/v1/audio/transcriptions(offen).POST /endpoint/.../v1/audio/transcriptionsmit einem WAV von 9,7 MB lieferte413 Payload Too Large: Failed to buffer the request body: length limit exceeded. Incrates/manager/src/api/openai.rsbekommen nur die Chat- und Messages-RoutenDefaultBodyLimit::max(8 MiB). Die Transkriptionsroute behält den Standard von axum mit 2 MiB, etwa 65 s WAV mit 16 Bit, 16 kHz, mono. Workaround: Opus mit 40 kbps (1,1 MB für 5 Minuten), MP3, oder die Datei aufteilen. Das Limit wurde in einem späteren Checkout des Managers bestätigt; der getestete Build wurde mit seinem Worktree entfernt. - Erneutes
ensure()mit unveränderter Spezifikation auf einem bereiten Custom-Backend-Workload (offen).wait_until_ready()blieb 10 Minuten bei[0s] scheduling. Der Worker loggtecustom backend: driven by ProjectConfigSnapshot; skipping legacy LoadModel, und der Endpoint servierte weiter (ein direkter Aufruf antwortete in 0,73 s). Workaround: zuerst den Workload löschen.main.pyruft immerensure()vorwait_until_ready()auf, Transkribieren ohne Deploy heißt also, das Skript zu ändern. - Qwen3-ASR auf sglang schneidet eine lange Einzelanfrage ab (nicht untersucht): 212 von etwa 700 Wörtern für die fünfminütige Datei mit den Standardwerten des Beispiels. Ein Standard-Ausgabelimit von sglang ist eine Vermutung, die wir nicht geprüft haben.
- Die Platte der Dev-Maschine war zu Beginn voll (das lokale MinIO antwortete beim Backend-Upload mit
XMinioStorageFull). Wir haben nur unsere eigenen Dateien freigegeben, danach funktionierte der Upload. - Keine kleine GPU verfügbar für die Stufe mit echter Karte: sieben Kartentypen (6 bis 20 GB), acht Versuche (RTX A4000 in zwei Pools), alle abgelehnt.
Grenzen dieses Tests
- 40 Clips und 924 Wörter, eine Anfrage nach der anderen, Greedy Decoding. Unbereinigte Sets, also nicht mit der Tabelle der Model Card vergleichbar.
- Die Leaderboard-Zahlen der Model Card wurden nicht reproduziert.
- Eine echte GPU (RTX 3090). Kleinere GPUs nur als emulierte Speichergrenzen, die keinen langsameren Chip nachbilden.
- Lief über einen lokalen InferenceKey-Manager in unserer Cloud, nicht über den gehosteten Dienst.
Quellen
- Model Card und Dateien: ConwayResearch/Underdog-Bark-3.0-Pro, ConwayResearch/Underdog-Bark-3.0.
- Release-Post: underdog.ai/bark.
- Basismodell: nvidia/parakeet-tdt-0.6b-v3.
- Leaderboard und Testdaten: hf-audio/open_asr_leaderboard, Dataset
hf-audio/open-asr-leaderboard. - Wo wir es entdeckt haben: News-Video von AI Search, 25. Oktober 2026, Bark-Abschnitt bei 03:10 bis 04:53.
- Unser Code: SDK-Beispiel, Commit
fb18916b. - Lizenzen: Bark 3.0 Pro CC-BY-4.0 (NVIDIA, Moondream, Conway Research). Qwen3-ASR-1.7B vom Qwen-Team, Apache-2.0 laut unserem SDK-README.