Underdog Bark 3.0 Pro contre Qwen3-ASR-1.7B : presque autant d'erreurs, un quart de la taille, et il tourne sur un CPU
Sur 40 extraits en anglais, Bark 3.0 Pro a raté 6,28 % des mots et Qwen3-ASR-1.7B 7,03 %, un résultat serré. Bark a aussi tourné sans GPU, sur 4 threads CPU.
Un modèle de reconnaissance vocale quatre fois plus petit que Qwen3-ASR-1.7B peut-il suivre sur les mêmes enregistrements ? Sur 40 extraits en anglais tirés des jeux de test de référence, le résultat est serré, avec une légère avance pour lui. Underdog Bark 3.0 Pro, un modèle ouvert de 1,25 GB signé Conway Research, s'est trompé sur 6,28 % des mots. Qwen3-ASR-1.7B, un modèle de 4,7 GB, s'est trompé sur 7,03 % avec le même audio, sur la même RTX 3090. L'essentiel de l'écart vient d'une seule habitude : Bark garde les mots de remplissage et les répétitions que les gens prononcent, et Qwen en supprime beaucoup. Bark a transformé cinq minutes de parole en texte en moins de trois secondes de travail GPU, 4,5 secondes en comptant l'aller-retour réseau. Quatre threads de processeur transcrivent un enregistrement plus vite qu'il ne se joue. Un GPU a besoin d'environ 2 GB de mémoire dès que l'audio long est découpé en morceaux.
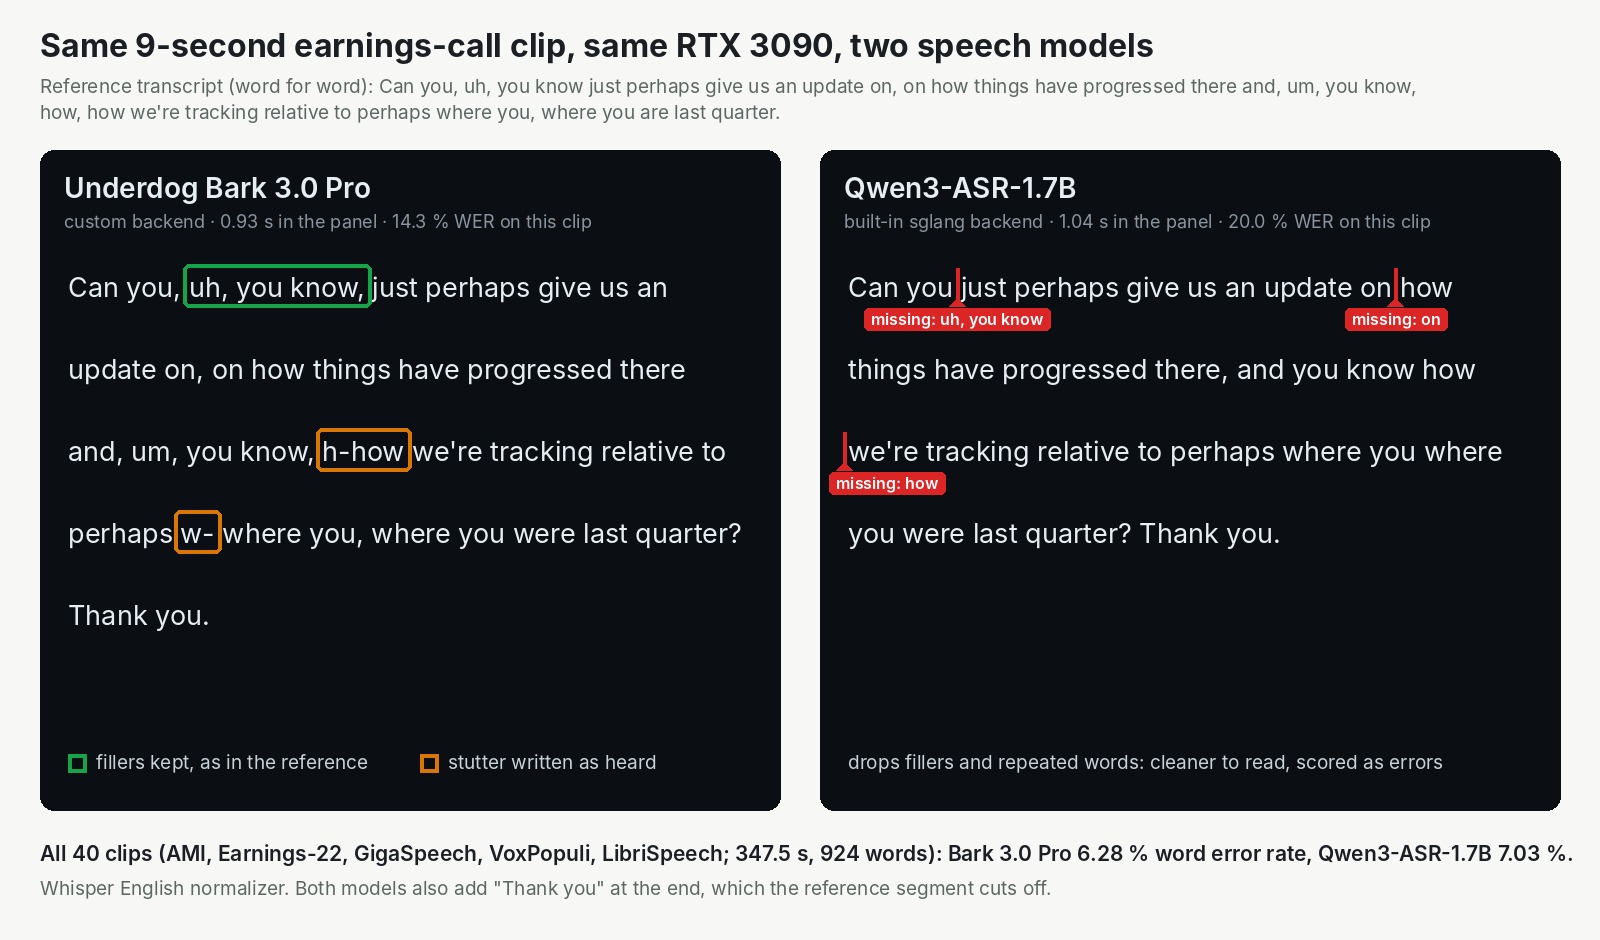
Même extrait, même carte. Bark garde le "you know" et les répétitions que garde la référence, et le texte plus propre de Qwen perd des points à cause de ça.
Un modèle de 1,25 GB à égalité avec le meilleur score ouvert, selon ses propres comptes
L'affirmation qui nous a fait regarder se trouve sur la page Hugging Face du modèle. Bark y affiche un taux d'erreur moyen sur les mots de 4,29 % sur les sept jeux de test en anglais de l'Open ASR Leaderboard, un classement public de la reconnaissance vocale. Le taux d'erreur sur les mots, c'est la part des mots qu'un modèle se trompe : plus il est bas, mieux c'est. La page le présente comme le plus bas de tous les modèles ouverts. L'avance est de 4,286 contre 4,291 pour Hojo-ASR-V1, une égalité avec un modèle environ dix fois plus gros. Le même tableau place Qwen3-ASR-1.7B à 4,43 % et Whisper large-v3 d'OpenAI à 6,04 %.
Ce score est autodéclaré. La page indique que les lignes de Bark utilisent le code de notation du classement mais "are not on the leaderboard yet". L'écart de taille, lui, n'exige aucune confiance : 1 254 MB sur disque contre 4 699 MB pour Qwen3-ASR-1.7B, un peu plus d'un quart.
NVIDIA a entraîné le modèle de base, Parakeet TDT 0.6B v3, un modèle de parole pour 25 langues européennes sorti en août 2025. Moondream en a ensuite fait une version améliorée. Conway Research l'a ensuite réentraîné et compressé pour en faire Bark, publié sur Hugging Face le 15 octobre. L'équipe Underdog a écrit l'article de lancement, qui présente aussi trois petits frères, jusqu'à 163 MB. L'équipe hf-audio maintient le classement et publie l'audio de test que nous avons utilisé. Nous avons repéré Bark dans la vidéo d'actualité d'AI Search du 25 octobre. Le présentateur y disait que le Pro "should still be able to fit on most consumer GPUs". Notre part : préparer Bark pour le déploiement, le mettre à côté de Qwen3-ASR sur une même carte et compter les erreurs.
Les trois modèles de la chaîne ont la même licence, CC-BY-4.0. Elle permet l'usage commercial, à condition de créditer NVIDIA, Moondream et Conway Research.
Le test : 40 extraits comparent les deux modèles, ils ne refont pas les chiffres de la fiche
La page du modèle note quatre des jeux après avoir corrigé des erreurs dans leur texte de référence. Nous avons utilisé les versions originales, donc nos chiffres absolus ne sont pas comparables au tableau de la page. Seule la comparaison entre les deux modèles l'est.
Nous avons tiré au hasard huit extraits dans chacun de cinq jeux des données de test du classement lui-même :
- AMI : réunions de bureau.
- Earnings-22 : conférences de résultats d'entreprises.
- GigaSpeech : podcasts et YouTube.
- VoxPopuli : discours au Parlement européen.
- LibriSpeech test-other : livres audio.
Chaque extrait dure de 4 à 20 secondes, presque six minutes et 924 mots au total. Nous avons aussi assemblé 33 autres segments de conférences de résultats en un seul fichier de cinq minutes pour tester l'audio long.
Les deux modèles ont tourné sur la même RTX 3090 24 GB, une requête à la fois. Nous les avons notés de la même façon, avec les règles de notation qu'OpenAI a écrites pour Whisper : elles ignorent la casse, la ponctuation et les "uh" ou "um", donc seules les vraies différences de mots comptent. Le test a tourné sur notre cloud via une version de test locale d'InferenceKey, pas le service hébergé.
Résultats : 6,28 % contre 7,03 %, et l'écart tient surtout à des mots de remplissage comme "you know"
Bark s'est trompé sur 6,28 % des mots sur les 40 extraits, et Qwen3-ASR-1.7B sur 7,03 %. Jeu par jeu, la décision est partagée :
| Jeu (8 extraits chacun) | Bark 3.0 Pro | Qwen3-ASR-1.7B |
|---|---|---|
| Réunions (AMI) | 11,54 % | 16,92 % |
| Conférences de résultats (Earnings-22) | 8,15 % | 10,87 % |
| Podcasts et YouTube (GigaSpeech) | 3,54 % | 4,04 % |
| Discours au Parlement (VoxPopuli) | 8,04 % | 5,53 % |
| Livres audio (LibriSpeech test-other) | 2,35 % | 1,88 % |
| Les 40 extraits, 924 mots | 6,28 % | 7,03 % |
924 mots, c'est un petit échantillon. Deux ou trois mots suffisent à faire bouger le chiffre d'un jeu, donc lisez le total comme "serré, avec Bark devant", pas comme un classement.
Pour voir d'où vient l'écart, il faut une idée : une transcription verbatim face à une transcription propre. Une transcription verbatim écrit ce qui a été dit, faux départs et mots de remplissage compris. Une transcription propre écrit ce que l'orateur voulait dire. Imaginez le bootleg d'un concert, toux comprises, face à la version studio. Les textes de référence du classement, écrits par des humains, sont verbatim. Bark aussi, exprès : "Bark 3.0 writes what was said, fillers included. It does not clean speech up," écrivent ses auteurs. Qwen3-ASR penche vers le propre.
Cela explique l'essentiel de la différence. Qwen a omis 29 mots présents dans les textes de référence, Bark 11. La plupart de ceux de Qwen étaient des mots de remplissage et des répétitions : "you know", "on, on", "how, how". Sur les mots mal entendus, Qwen avait une légère avance (28 contre 32), donc l'avance de Bark tient à ce qu'il garde ce qui a été dit, pas à une meilleure oreille. Bark perd des points dans l'autre sens. Il écrit les bégaiements tels qu'entendus, "h-how" et "w- where", et ceux-là comptent aussi comme des erreurs.
L'extrait de conférence de résultats de l'image ci-dessus montre les deux habitudes en neuf secondes. Bark y a obtenu 14,3 %, Qwen 20,0 %. Voici Bark :
Can you, uh, you know, just perhaps give us an update on, on how things have progressed there and, um, you know, h-how we're tracking relative to perhaps w- where you, where you were last quarter? Thank you.
Et voici Qwen3-ASR :
Can you just perhaps give us an update on how things have progressed there, and you know how we're tracking relative to perhaps where you where you were last quarter? Thank you.
L'avance de Bark est la plus nette sur les réunions et les conférences de résultats, où les textes de référence gardent beaucoup de mots de remplissage et de répétitions que Qwen supprime. Nous n'avons pas trouvé pourquoi Qwen fait mieux sur les discours au Parlement et les livres audio.
Cinq minutes d'audio en moins de trois secondes de travail GPU, d'un seul bloc
Bark est assez rapide pour que le réseau devienne la partie lente. Les 40 extraits ont demandé moins de cinq secondes de travail GPU, environ 0,12 seconde chacun. En comptant l'aller-retour réseau, un extrait typique revenait en une demi-seconde. Pour Qwen3-ASR, un extrait typique a pris 0,73 seconde. Qwen3-ASR tournait sur un autre logiciel de service, donc cela compare des installations autant que des modèles.
Le fichier de cinq minutes a pris 2,8 secondes de travail GPU en une seule requête. En comptant l'envoi et la réponse, il a pris 4,5 secondes. Bark a renvoyé la transcription entière, 715 mots. Nous n'avons pas pu la noter proprement : le texte de référence que nous avons assemblé a des trous aux jonctions entre les morceaux (chiffre en annexe).
Qwen3-ASR a renvoyé 212 mots et s'est arrêté. Nous n'avons pas cherché pourquoi.
Là où il reste en retrait : anglais uniquement, verbatim, pas d'horodatage
- Anglais uniquement. Son modèle de base gère 25 langues européennes. Bark, non.
- Verbatim par conception. Si vous voulez un texte propre, il vous faut une étape de nettoyage. Les auteurs proposent un Bark 3.0 Clean séparé qui supprime les mots de remplissage. Nous ne l'avons pas testé.
- Pas encore de minutage des mots ni de noms d'intervenants, d'après la page des auteurs. Si vos sous-titres ou vos comptes rendus en ont besoin, il faudra un autre outil.
Quel GPU : aucun. Quatre threads de processeur ont traité cinq minutes en 31 secondes
La plus petite machine qui a fonctionné n'avait pas de carte graphique. Sur quatre threads d'un processeur de serveur, Bark a transcrit le fichier de cinq minutes en 31 secondes. Sur seize threads, il a fallu 14 secondes. Les transcriptions étaient identiques mot pour mot à celles du GPU, sur les 40 extraits.
Sur un GPU, Bark est minuscule. Le modèle occupe environ 1,3 GB de mémoire, et avec Bark seul chargé, la carte n'a jamais dépassé environ 2,8 GB, moins d'un huitième de ses 24 GB.
Pour vérifier des cartes plus petites sans les avoir, nous avons plafonné la part de mémoire de la 3090 que Bark pouvait utiliser. Cela reproduit la limite de mémoire d'une carte plus petite, pas sa puce plus lente. Un plafond d'environ 4 GB n'a rien changé : mêmes transcriptions, même vitesse.
Sous un plafond d'environ 2 GB, tout est passé dès que l'audio long a été découpé en morceaux de 60 secondes, un réglage de notre exemple. Sans le découpage, le fichier de cinq minutes demandait trop de mémoire d'un coup et a échoué. Avec, il est passé bien en dessous du plafond, et les 40 extraits sont sortis avec les mêmes transcriptions qu'avant. Sur le GPU plafonné, le découpage n'a rien ralenti.
Nous avons aussi essayé de louer sept types de petites cartes, de 6 à 20 GB, comme une RTX A2000, une RTX 3070 et une RTX 4000 Ada. En huit tentatives, aucune n'était disponible. Nous ne pouvons donc pas désigner une petite carte précise comme suffisante.
Sur InferenceKey : un court fichier Python, des redémarrages en 8 secondes
Un seul fichier Python, moins de 200 lignes, sert Bark via la bibliothèque Transformers de Hugging Face, comme sa page le promet. Les outils de service habituels ne le font pas tourner. Le fichier télécharge le modèle, le charge et transforme l'audio en texte. Tout programme qui parle déjà à l'API de transcription d'OpenAI peut lui envoyer un fichier.
Le premier démarrage a pris 322 secondes, dont environ 300 à installer des logiciels sur une machine neuve. Le téléchargement du modèle a pris 4 secondes, son chargement 2,4. Ensuite, les redémarrages étaient prêts en 7 à 8 secondes. Qwen3-ASR, que la plateforme fait tourner sans code sur mesure, a pris 357 secondes à son premier démarrage. Les deux modèles partageaient la même 3090.
Deux aspérités sur lesquelles vous tomberez aussi :
- Les envois audio s'arrêtent à environ 2 MB. Cela fait environ 65 secondes d'audio non compressé. Notre WAV de cinq minutes, 9,7 MB, a été refusé car trop gros. Le contournement : un format compressé, où les mêmes cinq minutes tiennent en 1,1 MB. Statut : ouvert. Le README de l'exemple le documente.
- Relancer l'exemple pendant que le modèle est encore déployé bloque le script. Le modèle continue de répondre, mais le script attend dix minutes. Contournement : supprimer le déploiement avant de le relancer. Statut : ouvert.
Les autres problèmes que nous avons trouvés sont dans la section pour les ingénieurs ci-dessous.
Faut-il l'utiliser ? Oui pour des transcriptions anglaises mot pour mot sur du petit matériel
- Si vous transcrivez des réunions, des appels ou des interviews en anglais et qu'il vous faut chaque mot tel que prononcé, il vaut la peine de le faire tourner. Il a fait moins d'erreurs verbatim que Qwen3-ASR-1.7B sur nos réunions et nos conférences de résultats.
- Si vous voulez un texte que les gens lisent sans retouche, attendez-vous à des "uh" et des "you know" dans la sortie et prévoyez une étape de nettoyage.
- Si votre audio n'est pas en anglais, cherchez ailleurs.
- Si vous n'avez pas de GPU libre, quelques threads d'un processeur de serveur traitent un enregistrement plus vite qu'il ne se joue.
- Si vous l'intégrez dans un produit, la licence le permet avec attribution.
Il vous faut un projet InferenceKey, un fichier audio et un worker NVIDIA avec environ 2 GB libres, ou BARK_DEVICE=cpu sans GPU. Pour transcrire et noter votre propre audio, lancez python publish.py une fois, puis python main.py, depuis l'exemple du SDK.
Pour les ingénieurs
Modèle et fichiers
- Fiche du modèle, NOTICE, article de lancement d'Underdog (daté du 15 octobre 2026, "The Underdog team"), fiche du petit Bark 3.0, Parakeet TDT 0.6B v3.
- 0.6B paramètres, anglais uniquement, pleine précision (bf16). Repo
ConwayResearch/Underdog-Bark-3.0-Pro, créé et modifié pour la dernière fois le 2026-10-15 (07:05:36Z / 07:05:51Z), sha4b5c51e04aa8d16dda9ecdff71bc29f7360149e4, non restreint. Licencecc-by-4.0, bibliothèquetransformers, pipelineautomatic-speech-recognition,base_model: nvidia/parakeet-tdt-0.6b-v3avecbase_model_relation: finetune. 1 079 téléchargements le mois dernier et 36 likes le 2026-10-27. - Le repo pèse 2,49 GB au total, parce qu'il contient aussi des copies Core ML et MLX. Les fichiers PyTorch que le backend télécharge sont
model.safetensors(1 254 196 636 octets, bf16) plus les configs et le tokenizer, environ 1,26 GB. config.json:ParakeetForTDT, encodeur FastConformer (24 couches, hidden 1024, 8 têtes, 128 bandes mel, sous-échantillonnage 8) et un décodeur TDT (2 couches, hidden 640, durées de 0 à 4), vocabulaire 8 193,transformers_version5.19.0.- Chaîne d'attribution (NOTICE) :
nvidia/parakeet-tdt-0.6b-v3(c) NVIDIA Corporation, CC-BY-4.0, etmoondream/parakeet-ultra(c) Moondream, CC-BY-4.0. Modifications : "post-trained and compressed by Conway Research". - Chargement recommandé sur la fiche :
AutoProcessorplusParakeetForTDT.from_pretrained(repo, dtype=torch.bfloat16).to("cuda"), entrée mono 16 kHz, 4 000 échantillons (0,25 s) de silence ajoutés au début, puismodel.generate(). Décodage glouton. - Environnements d'exécution sur la fiche : Windows avec NVIDIA CUDA (Python 3.11,
torch==2.8.0cu128, un GPU compatible BF16 ; float16 est une alternative explicite qui demande sa propre validation de précision ; CPU avec--device cpu --dtype float32), Mac Core ML (macOS 15+, testé sur un M5 Max, environ 1,23 GB à télécharger), iOS 18+ via FluidAudio ("Not yet tested on an iPhone or iPad"). L'application Underdog le fait tourner avec MLX sur Apple silicon. - Famille Bark 3.0 (article de lancement) : Bark 3.0, 163 MB, 4,94 % de moyenne ; Bark 3.0 Plus, 180 MB, 4,76 % ; Bark 3.0 Pro, 1,25 GB, 4,29 %, "Hugging Face only" ; Bark 3.0 Clean, 180 MB, 5,83 %, supprime les mots de remplissage, choix par défaut dans l'application Underdog. Le petit Bark 3.0 est livré sous forme de fichier compacté
model.barkchargé avecbark_loader.py. L'article de lancement dit aussi "English only", "No word timings or speaker names yet", et que le petit Bark 3.0 traite 5 minutes en une demi-seconde sur un M5 Max (595x, chiffre des auteurs, pas le Pro).
Le tableau de benchmark de la fiche (autodéclaré, non reproduit)
Jeux de test complets, avec des versions nettoyées d'AMI, Earnings-22, GigaSpeech et VoxPopuli. Les lignes autres que Bark sont les lignes publiées du classement au 9 octobre 2026. Les lignes de Bark "use its scoring code and are not on the leaderboard yet". L'affirmation complète de la fiche : "the lowest of any open model by the leaderboard's own scoring: 4.286 against 4.291 for Hojo-ASR-V1, a 12 GB download."
| Modèle | Téléchargement | LS clean | LS other | AMI | Earnings-22 | GigaSpeech | SPGISpeech | VoxPopuli | Moy. |
|---|---|---|---|---|---|---|---|---|---|
| Bark 3.0 Pro | 1 254 MB | 1,38 | 3,11 | 7,16 | 5,65 | 7,46 | 3,54 | 1,70 | 4,29 |
| Qwen3-ASR-1.7B | 4 699 MB | 1,26 | 2,94 | 8,31 | 5,84 | 7,22 | 2,57 | 2,85 | 4,43 |
| Parakeet TDT 0.6B v3 | 2 508 MB | 1,52 | 3,13 | 9,42 | 5,85 | 7,99 | 3,63 | 3,05 | 4,94 |
| Whisper large-v3 | 9 261 MB | 1,56 | 3,52 | 13,63 | 7,99 | 8,35 | 2,71 | 4,53 | 6,04 |
| Hojo-ASR-V1 | 11 957 MB | 4,29 |
Aussi sur la fiche : Canary-Qwen 2.5B 4,55 %, et des API payantes absentes du tableau (OpenAI GPT-Transcribe 4,70 %, AssemblyAI Universal-3.5 Pro 4,46 %, Gladia Solaria-3 4,70 %, Smallest.ai Pulse 4,54 %, Meta Muse Voice Transcribe 4,93 %). Sur DisfluencySpeech (250 extraits, verbatim, mots de remplissage comptés), la fiche annonce 2,95 %.
La fiche de Parakeet TDT 0.6B v3 donne elle-même une moyenne de 6,34 % avec d'autres chiffres par jeu. La raison probable est une version différente (nettoyée) des jeux ; nous ne l'avons pas confirmé. Le Space du classement est une application Gradio, et nous n'avons pas lu directement ses lignes actuelles.
Notre installation
- Une RTX 3090 24 GB sur notre cloud (driver 580.65.06, 21 vCPU AMD EPYC 7C13, disque de conteneur de 100 GB, une image PyTorch 2.8 CUDA 12.8 Ubuntu 24.04), 41 minutes au total. Un manager InferenceKey local (depuis
mainàcc0024a4) l'a amorcée via des tunnels de dev. Aucun patch de code sur la plateforme. - Bark : backend sur mesure
underdog-bark-pro0.1.0,task_typeaudio2text, transformers 5.19.0, torch 2.8.0 cu128, bf16. - Qwen3-ASR-1.7B : backend intégré
sglang, sglang 0.5.14,--trust-remote-code --mem-fraction-static 0.45, même installation que l'exemple du SDKsglang-qwen3-asr-private. Il ne pouvait pas partager le backend sur mesure de Bark parce que le paquetqwen-asrépingle transformers 4.57.6. - Pourquoi un backend sur mesure : vLLM, SGLang et llama.cpp ne servent pas les modèles Parakeet TDT.
- Extraits : 8 par jeu tirés des fragments parquet de
hf-audio/open-asr-leaderboard(ami test-00002, earnings22 test-00001, gigaspeech test-00004, voxpopuli test-00001, librispeech test.other), seed 20261027, de 4 à 20 s, 347,5 s et 924 mots au total. Fichier long : 33 autres segments Earnings-22 assemblés avec des pauses de 0,4 s, 303,4 s. - Notation :
jiweraprès le normaliseur anglais de Whisper (whisper-normalizer). Une requête à la fois, décodage glouton. - Avant de louer quoi que ce soit, le backend a tourné en local sur CPU (torch 2.8.0+cpu) et a transcrit correctement deux extraits.
Pas à pas avec l'exemple du SDK
L'exemple (commit fb18916b sur main) contient backend.py, requirements.txt, publish.py, main.py, asr_eval.py (appel multipart plus WER), compare_qwen3_asr.py (Qwen3-ASR-1.7B sur sglang, mêmes extraits, côte à côte), README.md et .env.example.
cp .env.example .env              # tokens, project slug, IK_WORKER_ID, IK_AUDIO
python -m venv .venv && . .venv/bin/activate
pip install maturin requests jiwer whisper-normalizer
( cd ../../bindings/python && maturin develop --release )
python publish.py                 # once: uploads the backend if INFERENCEKEY_TENANT_ID and INFERENCEKEY_USER_TOKEN are set, else builds dist/*.tar.gz to upload from Dashboard -> Custom backends
python main.py                    # ensure -> wait_until_ready -> transcribe -> score -> delete
IK_KEEP_ALIVE=1 python main.py && python compare_qwen3_asr.py   # side by side
.env a besoin de INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY, INFERENCEKEY_PROJECT, IK_WORKER_ID (un worker NVIDIA avec un driver pour CUDA 12.8 et Python 3.12) et IK_AUDIO (un fichier ou un dossier ; un manifest.json avec des lignes {"id", "ref"} active la notation WER). Pour que publish.py envoie lui-même le backend, définissez aussi INFERENCEKEY_TENANT_ID et INFERENCEKEY_USER_TOKEN (un token de session du dashboard) ; sans eux, envoyez le dist/*.tar.gz qu'il construit depuis Dashboard -> Custom backends. Définissez INFERENCEKEY_BASE_URL explicitement : les appels de contrôle du SDK utilisent par défaut https://api.inferencekey.com, mais l'appel de transcription dans main.py et compare_qwen3_asr.py se rabat sur https://cloud.inferencekey.com quand elle n'est pas définie. N'importe quel client OpenAI fonctionne avec l'endpoint :
curl -s "${INFERENCEKEY_BASE_URL:-https://api.inferencekey.com}/endpoint/$INFERENCEKEY_PROJECT/underdog-bark-pro/v1/audio/transcriptions" \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" -F file=@call.opus -F model=default
La réponse est {"text", "duration", "seconds", "rtfx", "chunks", "vram_peak_gib", "device", "dtype", "model"}.
Ce que fait backend.py : snapshot_download de la révision épinglée avec allow_patterns (fichiers PyTorch uniquement), ParakeetForTDT.from_pretrained en bf16 sur CUDA (repli en float16 sur les cartes pré-Ampere, float32 sur CPU), un échauffement sur 1 s de silence, puis par job : décodage avec soundfile (repli sur librosa), rééchantillonnage avec soxr, ajout de 0,25 s de silence au début, generate(). Réglages :
| Variable | Défaut | Effet |
|---|---|---|
BARK_DEVICE | cuda | cpu tourne en float32 sans GPU |
BARK_DTYPE | bfloat16 sur CUDA | float16 ou float32 |
BARK_VRAM_LIMIT_GIB | non défini | plafonne la mémoire avec torch.cuda.set_per_process_memory_fraction |
BARK_CHUNK_SECONDS | 600 | découpe l'audio long en morceaux de cette durée |
BARK_CPU_THREADS | non défini | nombre de threads sur CPU |
Changer une variable BARK_* demande une suppression et un nouvel ensure().
Mesures complètes
Précision, 40 extraits (summary.json par exécution) :
| Jeu | Mots | Bark 3.0 Pro | Qwen3-ASR-1.7B |
|---|---|---|---|
| AMI (4 à 5 s) | 130 | 11,54 % | 16,92 % |
| Earnings-22 (7 à 11 s) | 184 | 8,15 % | 10,87 % |
| GigaSpeech (9 s) | 198 | 3,54 % | 4,04 % |
| VoxPopuli (8 à 13 s) | 199 | 8,04 % | 5,53 % |
| LibriSpeech test-other (4 à 19 s) | 213 | 2,35 % | 1,88 % |
| Total (347,5 s) | 924 | 6,28 % (S 32, D 11, I 15) | 7,03 % (S 28, D 29, I 8) |
Vitesse :
- Bark, bf16 : 4,864 s de temps GPU pour les 40 extraits (médiane 0,118 s par extrait), 71x le temps réel. Aller-retour médian 0,50 s (de 0,456 à 0,713 s, la première requête 1,73 s), 20,81 s au total. Testeur du panneau sur l'extrait de conférence de résultats : 928 ms.
- Qwen3-ASR-1.7B : aller-retour médian 0,73 s (de 0,52 à 2,60 s), 30,61 s au total. Testeur du panneau : 1 039 ms. sglang ne rapporte pas le temps GPU.
- Fichier de cinq minutes, une requête : Bark 2,833 s de GPU, 4,48 s d'aller-retour (107x). Qwen 3,71 s d'aller-retour, sortie tronquée.
Audio long : Bark a renvoyé 715 mots, 18,69 % de WER (S 39, D 22, I 62) face à la référence assemblée de 658 mots, et 17,78 % avec des morceaux de 60 s. L'alignement montre des passages présents dans l'audio mais absents de la référence, et l'inverse (frontières des segments Earnings-22), donc le chiffre absolu en dit plus sur la référence assemblée que sur le modèle. Qwen3-ASR via sglang 0.5.14 avec les réglages par défaut a renvoyé 212 mots, finissant par "...Matthew Walker, Credit Suisse. Please go ahead," : 454 des 658 mots de la référence manquants (72,04 %). Nous n'avons pas cherché la cause.
Mémoire GPU : poids sur le GPU après chargement 1,18 GiB. Pic alloué par PyTorch 1,243 GiB sur les 40 extraits, 2,151 GiB sur le fichier de cinq minutes en une requête, 1,369 GiB avec des morceaux de 60 s. Pic de la carte selon nvidia-smi (échantillons toutes les secondes) 2 682 MiB (2,81 GB) avec Bark seul chargé, 17 027 MiB avec Qwen3-ASR chargé à côté (sglang réserve 45 % de la carte par réglage, ce n'est donc pas le besoin de Qwen). Transformers avertit à chaque appel qu'il utilise la valeur par défaut générique de max_length (1 000 à 1 300), comme le script des auteurs. Aucune troncature observée.
Délai de disponibilité : premier démarrage de Bark 322 s (venv et pip de PyTorch avec les bibliothèques CUDA et transformers environ 300 s, téléchargement du snapshot 4,0 s, chargement 2,4 s). Redémarrages à chaud 7,6 s (plafond 4 GiB), 7,3 s (plafond 2 GiB), 8,1 s (plafond 2 GiB plus découpage), 6,9 s (CPU, 16 threads), 6,7 s (CPU, 4 threads), 8 s (main.py final). Premier démarrage de Qwen3-ASR 357 s (dont environ 235 s d'installation de sglang).
Échelle de VRAM :
| GPU ou plafond | Config | Pic | Temps | Sortie | Réel ou émulé |
|---|---|---|---|---|---|
| RTX 3090 24 GB | bf16, une requête | 2,151 GiB alloués, 2 682 MiB carte | 40 extraits 4,864 s ; 5 min 2,833 s (107x) | référence, 6,28 % | réel |
| Plafond 4 GiB | bf16, une requête | 2,151 GiB | 40 extraits 4,909 s ; 5 min 2,644 s | 6,28 %, textes identiques | émulé |
| Plafond 2 GiB | bf16, une requête | 1,243 GiB sur les extraits | extraits 4,889 s | extraits OK ; 5 min : CUDA out of memory. Tried to allocate 476.00 MiB ... 2.00 GiB allowed | émulé |
| Plafond 2 GiB | bf16, BARK_CHUNK_SECONDS=60 | 1,369 GiB | extraits 4,94 s ; 5 min 2,476 s (123x) | textes identiques sur les 40 extraits | émulé |
| CPU, 16 threads, AMD EPYC 7C13 | float32, morceaux de 60 s | pas de GPU | extraits 20,478 s (17x) ; 5 min 14,082 s (21,5x) | textes identiques sur les 40 extraits | réel |
| CPU, 4 threads | float32, morceaux de 60 s | pas de GPU | extraits 37,934 s (9,2x) ; 5 min 30,817 s (9,8x) | textes identiques sur les 40 extraits | réel |
| RTX A2000 6 GB, RTX 2000 Ada, RTX A4000, RTX 3070, RTX 3080, RTX 4070 Ti, RTX 4000 Ada | vraie petite carte | non lancé : aucune disponible | vraie carte, non essayée |
Pas essayés non plus : fp16 sur une carte pré-Ampere, int8, les checkpoints plus petits Bark 3.0 et Plus (autre format, model.bark), les voies Apple Core ML et MLX.
Exemples de sorties
earnings22-01(9,26 s) : les deux transcriptions citées dans le récit. Bark 14,3 % (0,79 s d'aller-retour lors de la première exécution), Qwen 20,0 %. Les deux ajoutent "Thank you", que le segment de référence coupe.librispeech_other-03(18,6 s) : Bark "At a quarter to ten, a valet entered. He composed with a little groom ..." en 0,62 s d'aller-retour, 0 % de WER.
Vidéo de démo
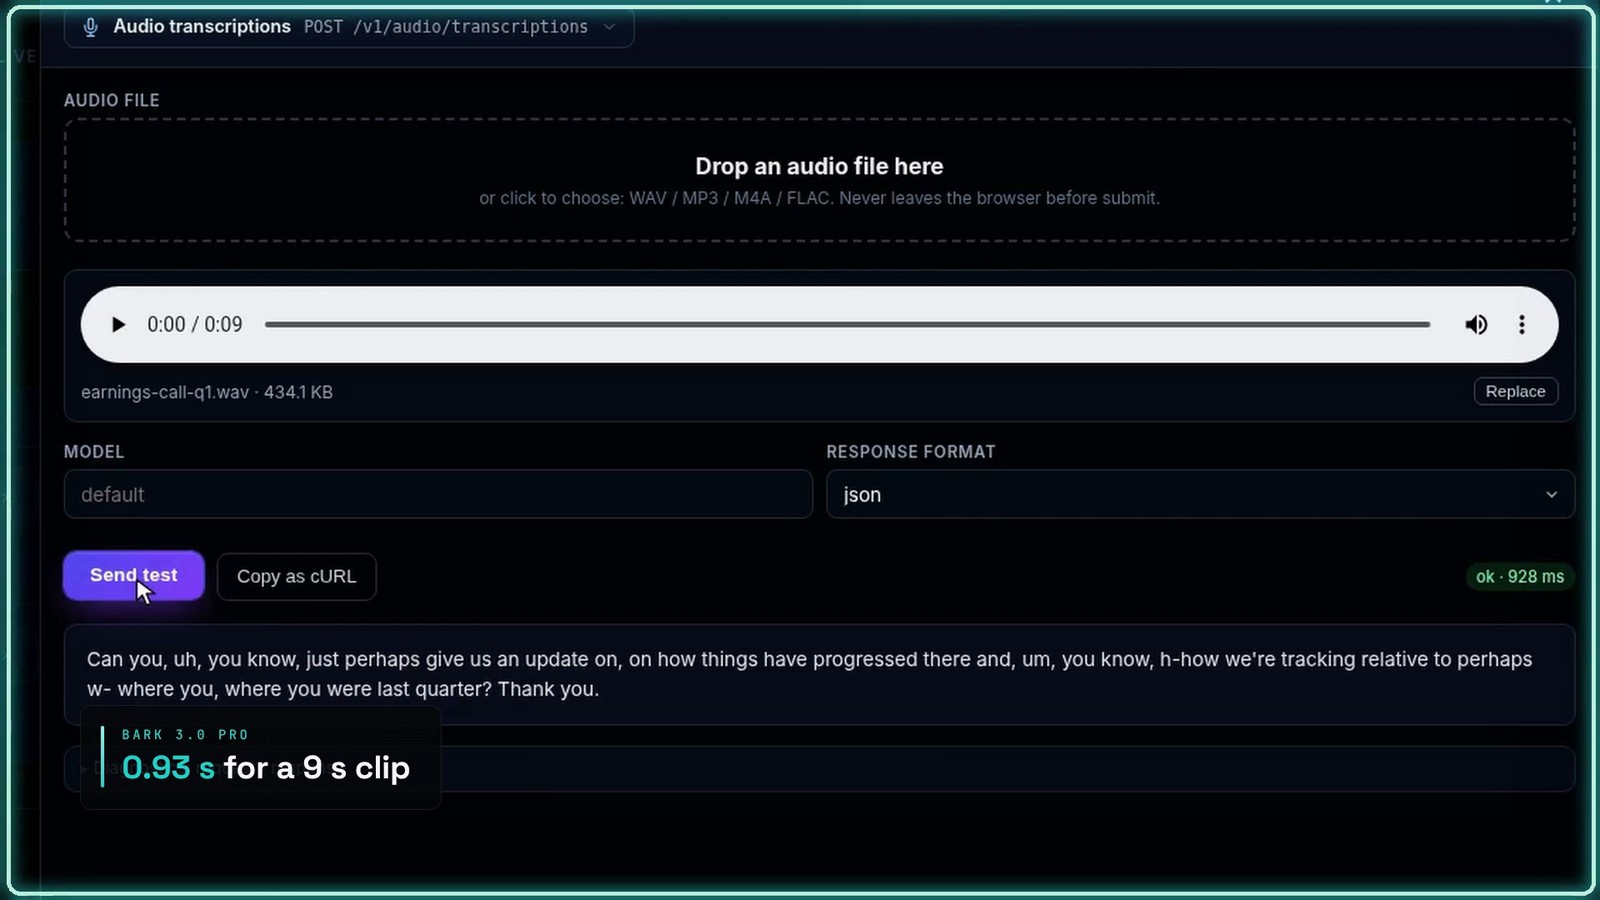
148 s. Chapitres : le modèle (la page des auteurs avec un crédit à l'écran, et leur benchmark marqué "not reproduced by us"), notre test (les deux modèles sur une RTX 3090, l'extrait de conférence de résultats en 928 ms et 1 039 ms, le WER sur 40 extraits) et le matériel. La vidéo dit "under three seconds" pour cinq minutes d'audio : 2,833 s de temps GPU, 4,48 s d'aller-retour.
Problèmes trouvés
- Limite de corps de 2 MiB sur
/v1/audio/transcriptions(ouvert).POST /endpoint/.../v1/audio/transcriptionsavec un WAV de 9,7 MB a renvoyé413 Payload Too Large: Failed to buffer the request body: length limit exceeded. Danscrates/manager/src/api/openai.rs, seules les routes chat et messages reçoiventDefaultBodyLimit::max(8 MiB). La route de transcription garde la valeur par défaut d'axum, 2 MiB, environ 65 s de WAV mono 16 bits à 16 kHz. Contournement : Opus à 40 kbps (1,1 MB pour 5 minutes), MP3, ou découper le fichier. La limite a été confirmée dans un checkout ultérieur du manager ; la version testée a été supprimée avec son worktree. - Relancer
ensure()avec une spec inchangée sur un workload de backend sur mesure prêt (ouvert).wait_until_ready()est resté à[0s] schedulingpendant 10 minutes. Le worker a loguécustom backend: driven by ProjectConfigSnapshot; skipping legacy LoadModel, et l'endpoint a continué de servir (un appel direct a répondu en 0,73 s). Contournement : supprimer d'abord le workload.main.pyappelle toujoursensure()avantwait_until_ready(), donc transcrire sans déployer oblige à modifier le script. - Qwen3-ASR sur sglang tronque une longue requête unique (non étudié) : 212 mots sur environ 700 pour le fichier de cinq minutes avec les réglages par défaut de l'exemple. Une limite de sortie par défaut de sglang est une hypothèse que nous n'avons pas vérifiée.
- Le disque de la machine de dev était plein au départ (le MinIO local répondait
XMinioStorageFullà l'envoi du backend). Nous n'avons libéré que nos propres fichiers, puis l'envoi a fonctionné. - Aucun petit GPU disponible pour le palier en vraie carte : sept types de cartes (de 6 à 20 GB), huit tentatives (RTX A4000 dans deux pools), toutes refusées.
Limites de ce test
- 40 extraits et 924 mots, une requête à la fois, décodage glouton. Jeux non nettoyés, donc pas comparables au tableau de la fiche.
- Les chiffres du classement donnés par la fiche n'ont pas été reproduits.
- Un seul vrai GPU (RTX 3090). Les GPU plus petits seulement sous forme de plafonds de mémoire émulés, qui ne reproduisent pas une puce plus lente.
- Exécuté via un manager InferenceKey local sur notre cloud, pas le service hébergé.
Sources
- Fiche du modèle et fichiers : ConwayResearch/Underdog-Bark-3.0-Pro, ConwayResearch/Underdog-Bark-3.0.
- Article de lancement : underdog.ai/bark.
- Modèle de base : nvidia/parakeet-tdt-0.6b-v3.
- Classement et données de test : hf-audio/open_asr_leaderboard, dataset
hf-audio/open-asr-leaderboard. - Où nous l'avons repéré : vidéo d'actualité d'AI Search, 25 octobre 2026, passage sur Bark de 03:10 à 04:53.
- Notre code : exemple du SDK, commit
fb18916b. - Licences : Bark 3.0 Pro CC-BY-4.0 (NVIDIA, Moondream, Conway Research). Qwen3-ASR-1.7B de l'équipe Qwen, Apache-2.0 d'après le README de notre SDK.