Nemotron 3.5 Transcribe sur une carte de 32 GB : le prompt choisit la transcription, 3 minutes en 4,4 secondes
Le modèle vocal ouvert de NVIDIA a transcrit 3 minutes à deux voix, horodatées et par locuteur, en 4,4 s sur une Blackwell de 32 GB. Sur 24 GB, plus lent.
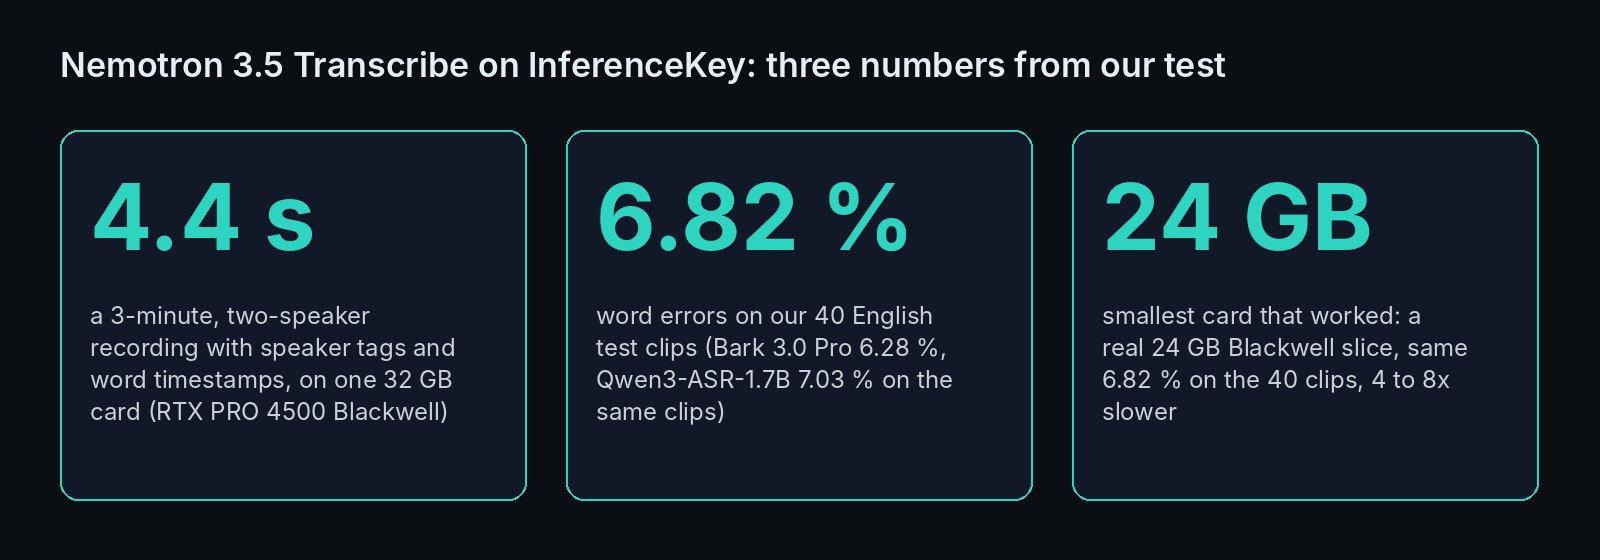
Demandez des étiquettes de locuteur à Nemotron 3.5 Transcribe. Une consultation médicale de trois minutes revient en 4,4 secondes de temps GPU, séparée entre médecin et patient, avec une heure de début et de fin sur chacun de ses 561 mots. Demandez une transcription propre, et le même modèle retire les "euh" à la place.
Nous avons fait tourner le nouveau modèle vocal ouvert de NVIDIA sur une seule carte graphique Blackwell de 32 GB, avec le logiciel open source que fournit NVIDIA. Pour qui fait tourner ses propres GPU, cela veut dire qu'un seul déploiement renvoie la transcription dont chaque équipe a besoin, choisie à chaque requête. Sur 40 clips de test standard, il s'est trompé sur 6,82 % des mots, dans la même fourchette que les modèles comparés. Une part de 24 GB d'une carte Blackwell plus grosse l'a aussi fait tourner, quatre à huit fois plus lentement. Notre exemple du SDK le déploie sur votre propre GPU Blackwell.
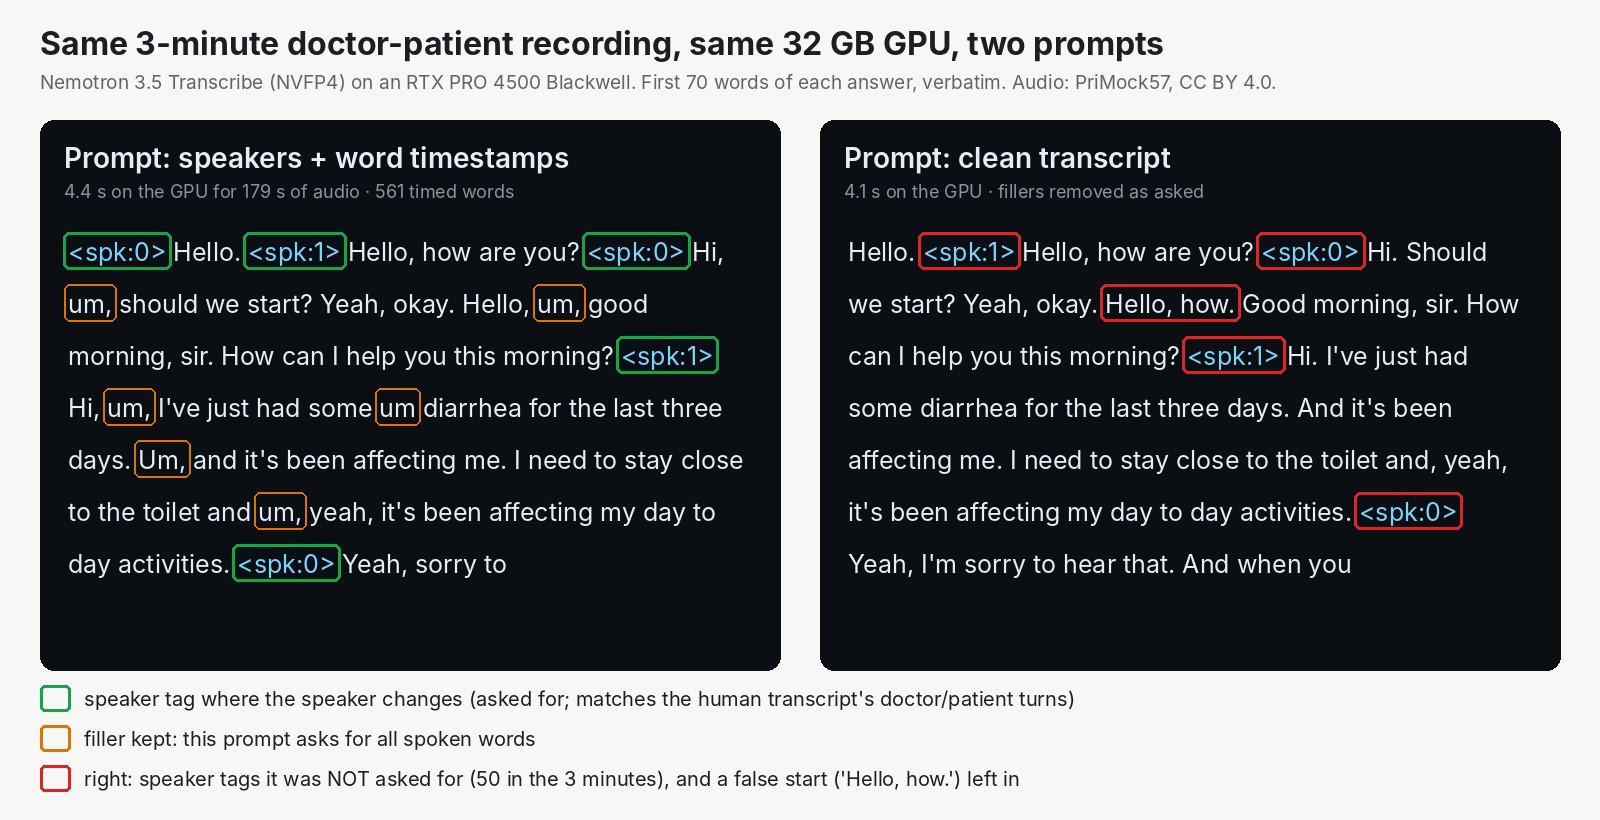
Même enregistrement, même carte, deux prompts. La version propre, à droite, ajoute des étiquettes de locuteur que personne n'a demandées.
Un seul modèle, et c'est l'instruction qui décide du type de transcription
Nemotron 3.5 Transcribe fonctionne plutôt comme un modèle de chat qui écoute. Vous envoyez l'audio avec une phrase d'instruction, et c'est l'instruction qui choisit la transcription.
La page du modèle de NVIDIA liste ce que cette phrase peut demander. Mot pour mot, avec chaque hésitation. Nettoyée pour la lecture. Étiquetée par locuteur, avec une heure pour chaque mot. Traduite. Il peut aussi identifier la langue ou répondre à une question sur l'audio. Il couvre 40 langues et des enregistrements jusqu'à une heure.
Pour une équipe, c'est la différence entre faire tourner trois systèmes et en faire tourner un seul. Un outil de prise de notes médicales veut la version propre, une équipe conformité veut chaque "euh", et un outil de réunion veut savoir qui a dit quoi. Sans lui, les étiquettes de locuteur et le nettoyage sont des étapes séparées que vous ajoutez vous-même. Ici, on se rapproche d'un studio qui enregistre une seule prise et la mixe différemment pour chaque auditeur : une seule copie chargée, une phrase différente dans chaque requête.
Le modèle est gros pour de la parole. Il a 34 milliards de paramètres au total, mais seuls environ 4,3 milliards travaillent sur chaque morceau d'audio. Imaginez une grande équipe de spécialistes où chaque mot en consulte une poignée pendant que les autres attendent. C'est pour cela qu'il est rapide pour sa taille.
NVIDIA l'a publié le 28 octobre en trois tailles de fichier : 67,5 GB, 34,7 GB et 21,6 GB. Le plus petit ne tourne que sur la génération de cartes la plus récente de NVIDIA, Blackwell. NVIDIA le dit presque aussi précis : 3,6 % d'erreurs en plus que la plus grande version.
La licence est OpenMDW-1.1. Elle permet d'utiliser, de modifier et de partager le modèle sans restriction, à condition de garder la notice. Elle n'impose aucune condition sur ce que vous faites des transcriptions. La page de NVIDIA dit clairement que l'usage commercial est autorisé.
NVIDIA a construit le modèle et sa recette de service ouverte, et des projets open source ont construit le moteur sur lequel il tourne. Nous l'avons repéré dans la vidéo d'actualité d'AI Search du 1er novembre. Nous l'avons empaqueté, fait tourner sur des cartes qu'une équipe peut louer, et nous avons compté les erreurs. L'annexe crédite chacun nommément.
Les chiffres de NVIDIA sont solides, et son chiffre le plus rapide n'est pas encore ouvert
Sur les tests de NVIDIA lui-même, le modèle devance les modèles vocaux ouverts auxquels il est comparé. Sur neuf jeux de test standard en anglais, il fait en moyenne 4,71 % de mots faux, contre 4,94 % pour Qwen3-ASR-1.7B. Dans sept autres langues, il obtient 4,62 % contre 6,49 % pour le même modèle Qwen. Quand les gens parlent en même temps, il se trompe sur environ 16 mots sur 100 ou les attribue au mauvais locuteur (15,80), contre 16,83 pour la meilleure comparaison que liste NVIDIA. Ce sont les exécutions de NVIDIA sur la plus grande version, relevées le 12 octobre. Nous ne les avons pas reproduites.
L'annonce de vitesse mérite une lecture plus attentive. La page de NVIDIA dit qu'une seule RTX PRO 6000 Blackwell de 96 GB transcrit jusqu'à 2 238 secondes (environ 37 minutes) d'audio par seconde. La page ajoute que ce chiffre vient du moteur packagé de NVIDIA. Ces optimisations "are not yet part of the open-source release". La version ouverte livrée le jour de la sortie "is expected to be roughly two times slower". Nous avons utilisé la version ouverte, donc nos chiffres viennent de ce chemin plus lent.
Une limite de plus, toujours d'après la page de NVIDIA : c'est un modèle hors ligne. Vous lui donnez un enregistrement terminé et vous récupérez une transcription. Il ne sous-titre pas un appel en direct pendant que les gens parlent.
Le test : une RTX PRO 4500 Blackwell de 32 GB et le logiciel ouvert
Que donne une carte Blackwell de 32 GB avec le logiciel que tout le monde peut télécharger ? La page de NVIDIA indique la RTX 5090, une carte gaming de 32 GB, comme compatible avec le petit fichier. Aucune RTX 5090 n'était disponible sur notre cloud ce jour-là. Nous avons utilisé une RTX PRO 4500 Blackwell, une carte de station de travail avec les mêmes 32 GB et la même génération de puce. Sa mémoire est environ deux fois moins rapide que celle d'une 5090. Nous n'avons pas mesuré de 5090.
Nous lui avons donné trois types d'audio :
- les trois premières minutes d'une consultation PriMock57, une consultation médecin-patient jouée, avec une transcription humaine
- cinq minutes d'audio de conférences sur les résultats financiers, assemblées à partir de 33 segments d'un jeu de test public
- les mêmes 40 clips courts en anglais, tirés d'un benchmark public de reconnaissance vocale, que nous avons utilisés pour comparer Underdog Bark et Qwen3-ASR la semaine dernière.
Cela donne une comparaison directe avec deux modèles que nous connaissons déjà. L'un d'eux, Qwen3-ASR, est le modèle vocal que nous utilisons déjà pour nos propres transcriptions. L'échantillon est petit : 924 mots de clips, un fichier de trois minutes et un de cinq minutes, une requête à la fois.
Trois minutes de consultation en 4,4 secondes, avec qui a dit quoi et quand
Chaque prompt du tableau a pris moins de cinq secondes de temps GPU pour trois minutes d'audio, environ quarante fois plus vite que la durée de l'enregistrement.
| Prompt | Temps GPU pour 3 minutes | Ce qui est revenu |
|---|---|---|
| verbatim | 4,1 s | 11,74 % d'erreurs de mots par rapport à la transcription humaine, 33 des 34 "um" et "uh" conservés |
| clean | 4,1 s | toutes les hésitations retirées (voir plus bas) |
| speakers + word timestamps | 4,4 s | tours de parole du médecin et du patient, 561 mots avec une heure de début et de fin |
Verbatim a gardé les hésitations dont une équipe conformité a besoin, et speakers a séparé les tours de parole. Les tours correspondent à la référence humaine quand on les lit côte à côte, mais nous l'avons vérifié à l'œil : nous avons noté les mots, pas les étiquettes de locuteur. Un quatrième prompt, "translate to Spanish", est revenu en espagnol après 4,9 secondes sur le GPU. Nous ne l'avons pas noté.
Le fichier de cinq minutes de conférence financière a pris 4,8 secondes sur le GPU, en une seule requête. Il s'est trompé sur 16,11 % des mots, mais la référence assemblée a des trous là où les segments se rejoignent, donc seule la comparaison compte : Bark a obtenu 18,69 % sur le même fichier dans le test de la semaine dernière, et Qwen3-ASR, dans la configuration de la semaine dernière, s'est arrêté en cours de route.
Sur les 40 clips courts, le chiffre de précision qui se compare d'un modèle à l'autre, il s'est trompé sur 6,82 % des mots. Bark 3.0 Pro a obtenu 6,28 % et Qwen3-ASR-1.7B 7,03 % sur les mêmes clips, notés de la même façon. Nemotron se place donc entre les deux, plus près de Qwen. Ces deux-là ont tourné sur une autre carte dans le test de la semaine dernière, donc les taux d'erreur se comparent, les vitesses non.
Là où il dérape : le prompt clean étiquette trop, et les réunions sont son point faible
Le prompt clean est celui à tester avant de lui faire confiance. Notre instruction clean dit "omit fillers and accidental repetitions; keep the remaining spoken wording unchanged" et se termine par "Output: transcript only". Elle ne demande aucune étiquette. Le modèle a retiré toutes les hésitations et a aussi ajouté 50 étiquettes de locuteur en trois minutes. Il a laissé un faux départ, "Hello, how.", qu'un lecteur s'attendrait à voir disparaître. Si votre pipeline attend du texte brut, retirez les étiquettes ou utilisez volontairement le prompt speakers.
Sur les 40 clips, il a été le meilleur des trois sur la lecture de livres audio : 0,94 % de mots faux, contre 1,88 % pour Qwen3-ASR et 2,35 % pour Bark. AMI, des réunions de bureau enregistrées où les gens parlent en même temps, a été son jeu le plus faible avec 14,62 %, derrière Bark (11,54 %) et devant Qwen3-ASR (16,92 %). Un outil de réunion devrait vérifier ses propres enregistrements avant de changer.
Quel GPU : une vraie tranche de 24 GB a fonctionné, quatre à huit fois plus lentement
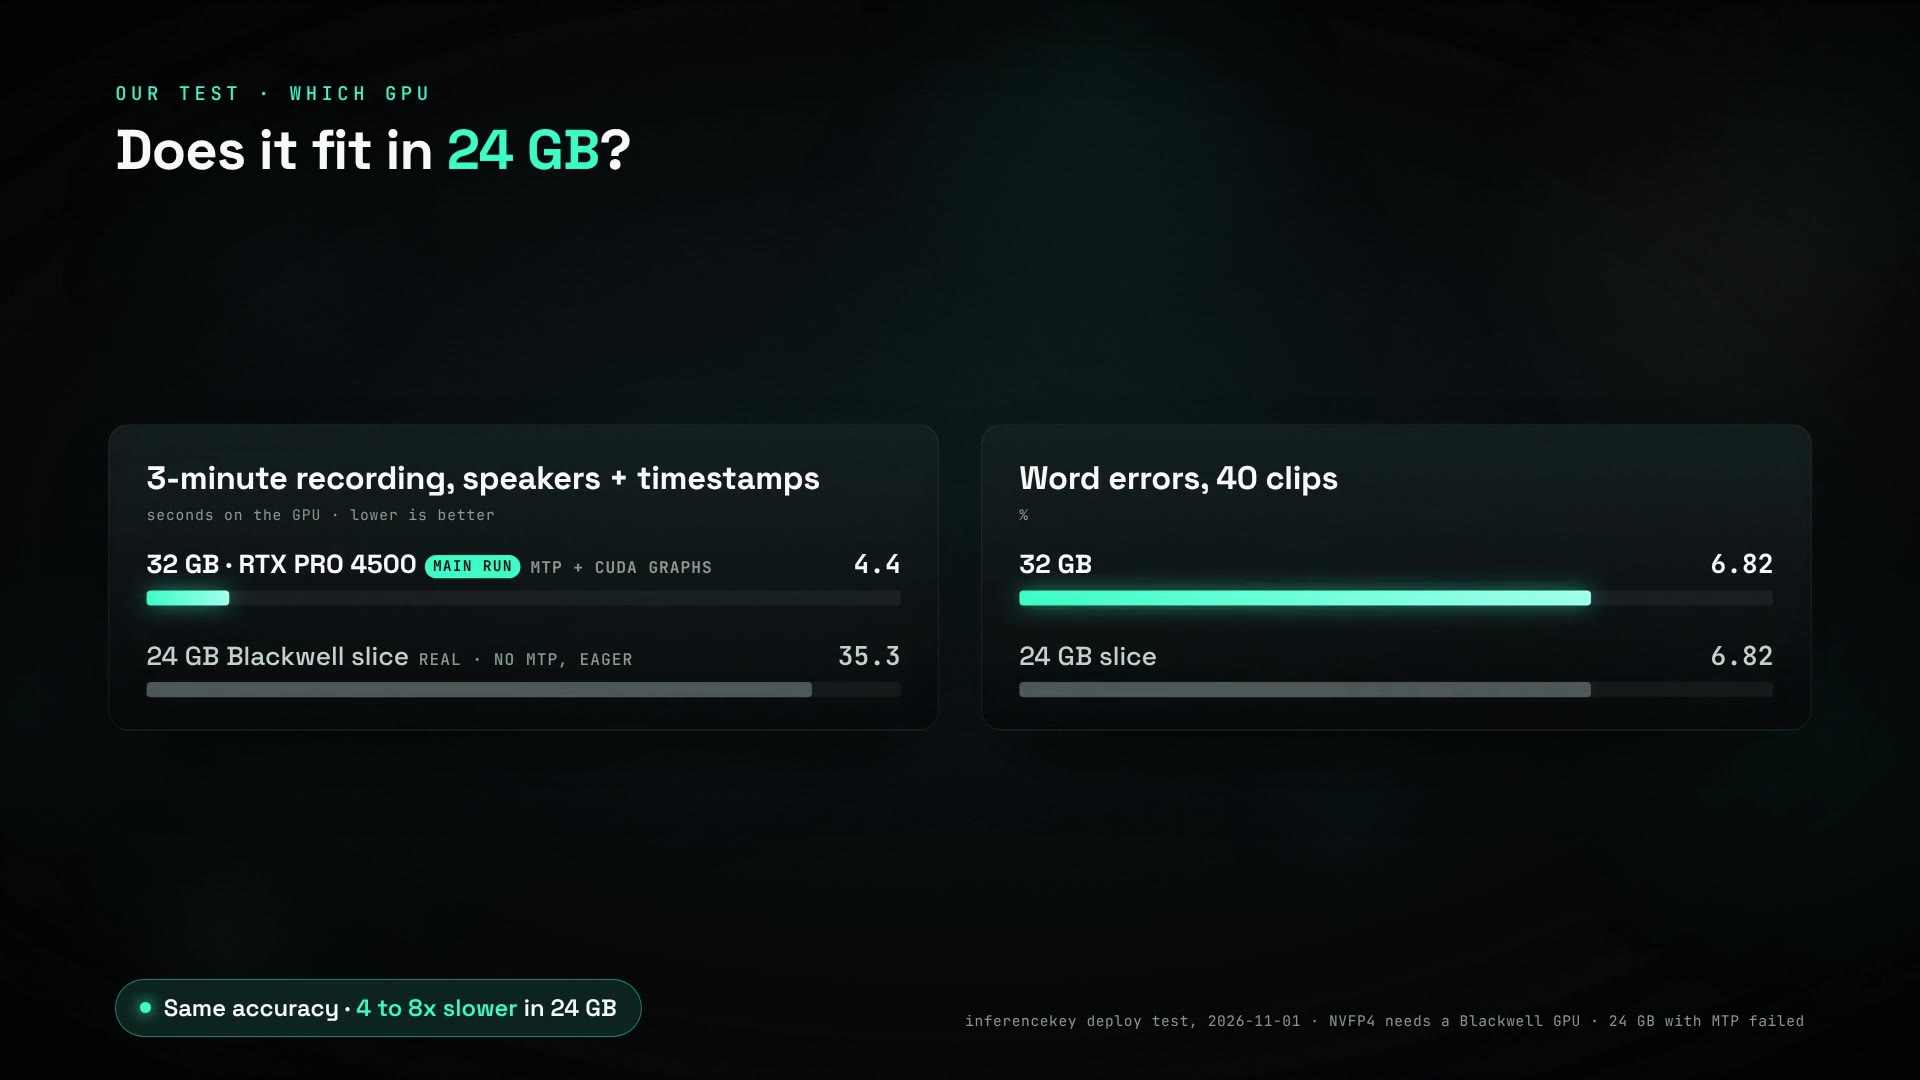
Le plus petit matériel qui a fonctionné est une vraie tranche de 24 GB d'une carte Blackwell. La carte de 32 GB est l'option rapide, pas le minimum.
Cette tranche vient d'une RTX PRO 6000 Blackwell, une carte de 96 GB qu'on peut découper en morceaux isolés. Chaque morceau reçoit 24 GB de mémoire et un quart de la puissance de calcul de la carte. Dessus, l'exécution speakers de trois minutes a pris 35,3 secondes au lieu de 4,4. C'est huit fois plus lent, et toujours environ cinq fois plus rapide que la durée de l'enregistrement. Les clips courts ont été environ quatre fois plus lents, le fichier de cinq minutes environ sept fois.
Les deux configurations qui ont fonctionné :
| Matériel | Réglages | Résultat |
|---|---|---|
| RTX PRO 4500 Blackwell, 32 GB | réglages les plus rapides | fonctionne, les chiffres ci-dessus, environ 30 GB utilisés au pic |
| Tranche Blackwell de 24 GB | réglages plus lents, enregistrements plus courts, 2 requêtes à la fois | fonctionne |
Dans son mode rapide, le modèle n'a pas tenu dans la tranche de 24 GB. Nous n'avons pas essayé une carte Blackwell complète de 24 GB, 16 GB, le fichier de taille moyenne sur une carte de 48 GB, ni de nombreuses requêtes à la fois.
Sur InferenceKey : une seule copie chargée répond à tous les styles
Une seule copie en marche sur une seule carte louée a répondu aux quatre styles à la même adresse, donc un nouveau style de transcription coûte une phrase, pas un déploiement de plus. À travers la plateforme, un redémarrage était prêt en 88 secondes. Une machine neuve était prête en 217 secondes. Notre tout premier démarrage a pris environ six minutes, le temps de compiler une fois pour toutes du code GPU.
Il a fallu un backend sur mesure, un court fichier Python qui indique à notre plateforme comment installer et lancer un modèle sur chaque machine GPU. Notre option intégrée installe le moteur de service seul et ne peut pas ajouter le module vocal de NVIDIA, donc notre fichier construit les deux à partir de la recette de NVIDIA. Notre backend expose la route vocale standard d'OpenAI, /v1/audio/transcriptions. Notre déploiement de Qwen3-ASR répond sur la même route, donc la requête qu'une équipe envoie déjà garde sa forme. La nouveauté, c'est le champ prompt.
Une limite que vous rencontrerez est encore ouverte. Notre adresse de transcription accepte des fichiers jusqu'à 2 MB, environ huit minutes de parole compressée. Le modèle accepte une heure d'audio, donc découpez les enregistrements plus longs pour l'instant, ou compressez-les fortement. Chaque requête est diarisée séparément, donc les étiquettes de locuteur peuvent ne pas se conserver d'un morceau à l'autre ; nous n'avons pas testé d'enregistrements découpés.
Faut-il l'utiliser ? Oui pour plusieurs styles de transcription depuis une carte Blackwell
- Vous avez besoin de transcriptions différentes pour différentes équipes. Un seul déploiement donne du texte verbatim, propre, étiqueté par locuteur et traduit. Vérifiez la sortie propre pour repérer les étiquettes parasites.
- Vous avez besoin du taux d'erreur le plus bas sur des clips en anglais. Il est dans la même fourchette que Bark 3.0 Pro et Qwen3-ASR-1.7B sur notre échantillon, pas devant. Son atout, c'est le choix de la sortie, pas la précision brute.
- Vous avez une carte Blackwell de 32 GB. Il tourne vite. Une tranche Blackwell de 24 GB tourne aussi, plus lentement.
- Vous utilisez des RTX 4090 ou des cartes plus anciennes. Le petit fichier ne tournera pas, il a besoin de Blackwell. NVIDIA indique le fichier de taille moyenne sur une L40S de 48 GB.
- Vous avez besoin de sous-titres en direct. Pas avec ce modèle, il fonctionne uniquement hors ligne.
Suivez l'exemple du SDK pour Nemotron 3.5 Transcribe pour obtenir les trois transcriptions de votre propre enregistrement sur votre propre GPU Blackwell. Remplissez .env, lancez python publish.py une fois puis python main.py. Il faut une carte de 32 GB pour les réglages par défaut, environ 50 GB de disque et un fichier audio de moins de 2 MB.
Pour les ingénieurs
Crédits
- NVIDIA : le modèle, le plugin vLLM de NeMo Speech (
nemo_speechlm, Apache-2.0), la recette de service et les benchmarks. - Projet vLLM : le moteur de service (0.32.0) sur lequel tourne le chemin ouvert.
- Équipe FlashInfer : les noyaux sm120 précompilés (
flashinfer-jit-cache,flashinfer-jit-cache-sm120f) de flashinfer.ai. - SGLang-Omni (sgl-project/sglang-omni, Apache-2.0) : le chemin de service alternatif, version v0.2.0 du 2026-10-27.
- Babylon Health : PriMock57 (CC BY 4.0), les enregistrements médecin-patient. Notre extrait de 3 minutes de
day1_consultation01vient des données de démo du Hugging Face Space de NVIDIA. - hf-audio : les données de test de l'Open ASR Leaderboard d'où viennent les 40 clips.
- AI Search : là où nous l'avons repéré (vidéo, chapitre à 32:04).
- InferenceKey : le backend sur mesure, le déploiement, les mesures et l'exemple du SDK.
Modèle et fichiers
| Modèle | Encodeur vocal et encodeur de locuteurs placés devant le modèle de langage Nemotron 3.5 Lightning : LM MoE hybride Mamba-2/Transformer (Nemotron 3.5 Lightning 30B-A3B : Mamba-2 x23, MoE x23, attention x6, 128 experts top-6) + Parallel Expert Encoder (transformer ASR de 600M, encodeur de locuteurs Sortformer d'environ 99M) + têtes d'horodatage CTC de 47M. 34B au total, environ 4,3B actifs encodeur audio compris. Contexte de 65 536 tokens |
| Décodage spéculatif | tête MTP native ; draft DFlash2 en option (1,14 GB, pas d'horodatage des mots avec lui) |
| Checkpoints (API HF, somme des fichiers ; la fiche n'indique pas les tailles) | BF16 67,52 GB ; FP8 34,69 GB ; NVFP4 21,58 GB |
| Utilisé | NVFP4 sha 66c6adc4020179567074d0399cda2a4eeb2bb347 : 2 shards NVFP4 de 9,99 + 9,19 GB, perception 0,84 GB, MTP FP8 1,34 GB, CTC BF16 0,20 GB. Export mixte ModelOpt (décodeur NVFP4, couches Mamba FP8, encodeur audio FP8, tête MTP FP8) ; Blackwell uniquement ; --kv-cache-dtype fp8 ; les noyaux quantifiés ont besoin du nvcc de CUDA 13 |
| Coût en qualité selon la fiche | NVFP4 3,6 % d'erreur en plus que BF16 (relatif), FP8 1,0 % |
| Sortie | 10/28/2026 sur build.nvidia.com, GitHub, Hugging Face et NGC ; lastModified HF 2026-10-29T23:04Z |
| Licence | OpenMDW-1.1 |
Ce que dit la fiche sur le matériel
Le tableau de compatibilité de la fiche n'indique aucune taille de mémoire. Il liste : A100 80GB SXM (BF16) ; B200, GB200, GB300, DGX Spark, Jetson Thor (BF16, FP8, NVFP4) ; RTX 5090 (NVFP4, avec vLLM 0.32.0, Transformers, GGML) ; RTX PRO 6000 Blackwell Server Edition (BF16, FP8, NVFP4 ; aussi SGLang-Omni 0.2.0) ; H100 (BF16, FP8 ; aussi SGLang-Omni) ; H200 (BF16, FP8) ; L40S PCIe 48GB (FP8). Les lignes "Deployment" : fiche BF16 "1x H100 80 GB" ; fiches NVFP4 et FP8 "1x RTX PRO 6000 Blackwell (96 GB)". La RTX 5090 et la L40S n'apparaissent que comme lignes de compatibilité.
Chemins de service et endpoints
- vLLM 0.32.0 + plugin NeMo Speech (ce que nous avons utilisé). La fiche documente
/v1/chat/completions(audio_urlen base64 + prompt texte) ; l'horodatage des mots revient dans un objetctc_timestampsde premier niveau (wordsavec start/end/speaker,diarization,speaker_tag_to_diarization_speaker,error). Les requêtes avec horodatage prennent un seul enregistrement,stream=false,n=1. Notre backend sur mesure enveloppe cela et expose la route OpenAI/v1/audio/transcriptionssur la plateforme. - SGLang-Omni 0.2.0 (fixe SGLang 0.5.22). Sert la transcription de fichiers entiers sur
/v1/audio/transcriptions, un GPU, BF16 ou FP8 uniquement (validé sur une H100 80 GB et une RTX PRO 6000 Blackwell), sans besoin de NeMo. D'après la fiche, "word timestamps, speaker-attributed output, translation and speculative decoding are not part of this integration". Le cookbook propose des deltas de texte enstream=trueune fois tout le fichier encodé, ce qui n'est pas du streaming en direct. Il indique un RTFx de 23,40 à une concurrence de 1 et de 102,17 à 16 sur une H100 BF16 avec des clips courts. - NIM : le vLLM optimisé derrière le chiffre de 2 238 s/s (NVFP4 + DFlash2 sur une RTX PRO 6000 Blackwell Server Edition). Pas encore open source.
Installation
| GPU principal | RTX PRO 4500 Blackwell 32 GB (32 623 MiB, GB203, sm_120), limite de 200 W, driver 595.91.07 (CUDA 13.2), nvcc 13.0.88, conteneur de 62 GB de RAM / 10,2 CPU, 100 GB de disque |
| Pourquoi pas une 5090 | RTX 5090 indisponible sur notre cloud au moment du test. La PRO 4500 a les mêmes 32 GB et le même sm_120, environ la moitié de la bande passante mémoire d'une 5090, et a tourné avec une limite de 200 W. Non mesuré sur une 5090 |
| GPU de l'échelle | RTX PRO 6000 Blackwell Server Edition, tranche MIG 1g.24gb |
| Pile | manager InferenceKey local (jamais la production), backend sur mesure nemotron-transcribe 0.1.4 |
| Backend | télécharge NeMo Speech à e5d79d5a49cbec49d79440b0070aac0c32a8dbb8 ; uv venv --python 3.13 ; uv sync --extra asr --extra vllm --locked --no-install-project ; -e . ; av==19.0.2, opencv-python-headless==5.0.0.93 ; noyaux précompilés FlashInfer 0.7.0.post1+cu130 ; MAX_JOBS=6 ; snapshot_download de la révision fixée |
vllm serve | VLLM_PLUGINS=nemo_speechlm ; cache KV fp8, --use-replayssm, --mamba-backend flashinfer, middleware d'horodatage CTC, --reasoning-parser nemotron_v3, MTP 8 ; util 0,92, --max-model-len 65536, 8 séquences ; un audio par prompt, jusqu'à 57 600 000 échantillons ; préchauffage sur 2 s de silence. La recette des auteurs vise une H100 80 GB (util 0,94, 192 séquences) |
| Requêtes | multipart file, prompt (nom de style verbatim, clean, speakers, nearfield, translate, ou texte libre), timestamp_granularities[]=word ; température 0, thinking désactivé |
| Texte de style envoyé | verbatim : "Audio transcription. Language: as spoken. Wording: verbatim, including fillers and repetitions. Formatting: punctuation and capitalization. Output: transcript only." clean : "Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only." speakers : "Transcribe this audio with punctuation and capitalization. Include all spoken words and verbal fillers. Write numbers in their standard written form. Put speaker tags spk:0 spk:1 spk:2 spk:3 on the transcription." (STYLES dans backend.py ; le modèle ne voit jamais le nom du style) |
| Notation | jiwer avec le normaliseur anglais de Whisper ; étiquettes de locuteur retirées avant la notation |
Pas à pas avec l'exemple du SDK
L'exemple (commit 5017429 sur main) contient backend.py, publish.py, main.py, requirements.txt et .env.example.
cp .env.example .env                # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY,
                                    # INFERENCEKEY_PROJECT, IK_WORKER_ID, IK_AUDIO (< 2 MiB),
                                    # INFERENCEKEY_TENANT_ID, INFERENCEKEY_USER_TOKEN (for publish.py)
pip install inferencekey requests openai  # client side; requirements.txt is the backend's
python publish.py                   # once: packages dist/*.tar.gz and uploads it to your tenant;
                                    # without the two publish variables, upload that file from
                                    # Dashboard -> Custom backends
python main.py                      # ensure, wait, verbatim/clean/speakers on IK_AUDIO, delete
IK_KEEP_ALIVE=1 garde le workload. Il faut : un GPU Blackwell, un driver CUDA 13, environ 50 GB de disque, 32 GB de VRAM pour les réglages par défaut. Pour une carte de 24 GB, reprenez ce qui a tourné sur la tranche MIG :
NEMOTRON_GPU_MEMORY_UTILIZATION=0.93
NEMOTRON_MAX_MODEL_LEN=16384
NEMOTRON_MAX_NUM_SEQS=2
NEMOTRON_MTP=0
NEMOTRON_ENFORCE_EAGER=1
Appel du workload déployé avec le client OpenAI :
from openai import OpenAI
client = OpenAI(base_url="https://cloud.inferencekey.com/endpoint/<project>/nemotron-transcribe/v1",
                api_key="ik_live_...")
out = client.audio.transcriptions.create(model="default", file=open("meeting.ogg", "rb"),
                                         prompt="speakers", timestamp_granularities=["word"])
Mesures complètes
Exécution principale à travers la plateforme, RTX PRO 4500 Blackwell, NVFP4, MTP 8, CUDA graphs. Temps GPU mesuré dans le backend ; aller-retour mesuré depuis le client.
| Entrée | Prompt | GPU s | Aller-retour s | Résultat |
|---|---|---|---|---|
| consultation 3 min (178,61 s) | verbatim | 4,113 | 4,62 | 11,74 % de WER par rapport à la transcription humaine de PriMock57 (S 17, D 32, I 15) ; 33 um/uh conservés (référence 34) |
| consultation 3 min | clean | 4,054 | 4,58 | 14,68 % par rapport à la référence verbatim (hésitations retirées par conception) ; 50 étiquettes de locuteur non demandées |
| consultation 3 min | speakers + word timestamps | 4,401 | 4,97 | 13,58 % (étiquettes retirées) ; 57 étiquettes, correspondance {"0":0,"1":1}, 561 mots horodatés, error: null |
| consultation 3 min | "Please translate the given speech to Spanish." | 4,857 | 5,33 | texte en espagnol, non noté |
| Earnings-22 assemblé (303,4 s) | verbatim | 4,818 | 5,243 | 16,11 % (Bark 18,69 % ; Qwen3-ASR 72,04 %, tronqué, dans le test précédent) |
| 40 clips (347,5 s, 924 mots) | verbatim | 12,956 | médiane 0,50 par clip | 6,82 % (S 30, D 17, I 16) |
Par jeu sur les 40 clips :
| Jeu (8 clips chacun) | Nemotron NVFP4 | Bark 3.0 Pro (test précédent) |
|---|---|---|
| AMI | 14,62 % | 11,54 % |
| Earnings-22 | 9,78 % | 8,15 % |
| GigaSpeech | 3,54 % | 3,54 % |
| LibriSpeech test-other | 0,94 % | 2,35 % |
| VoxPopuli | 8,54 % | 8,04 % |
| Les 40 | 6,82 % | 6,28 % (Qwen3-ASR-1.7B 7,03 %) |
Bark et Qwen3-ASR ont tourné sur une RTX 3090 (Qwen sur le backend sglang intégré 0.5.14), donc le WER se compare et la vitesse non.
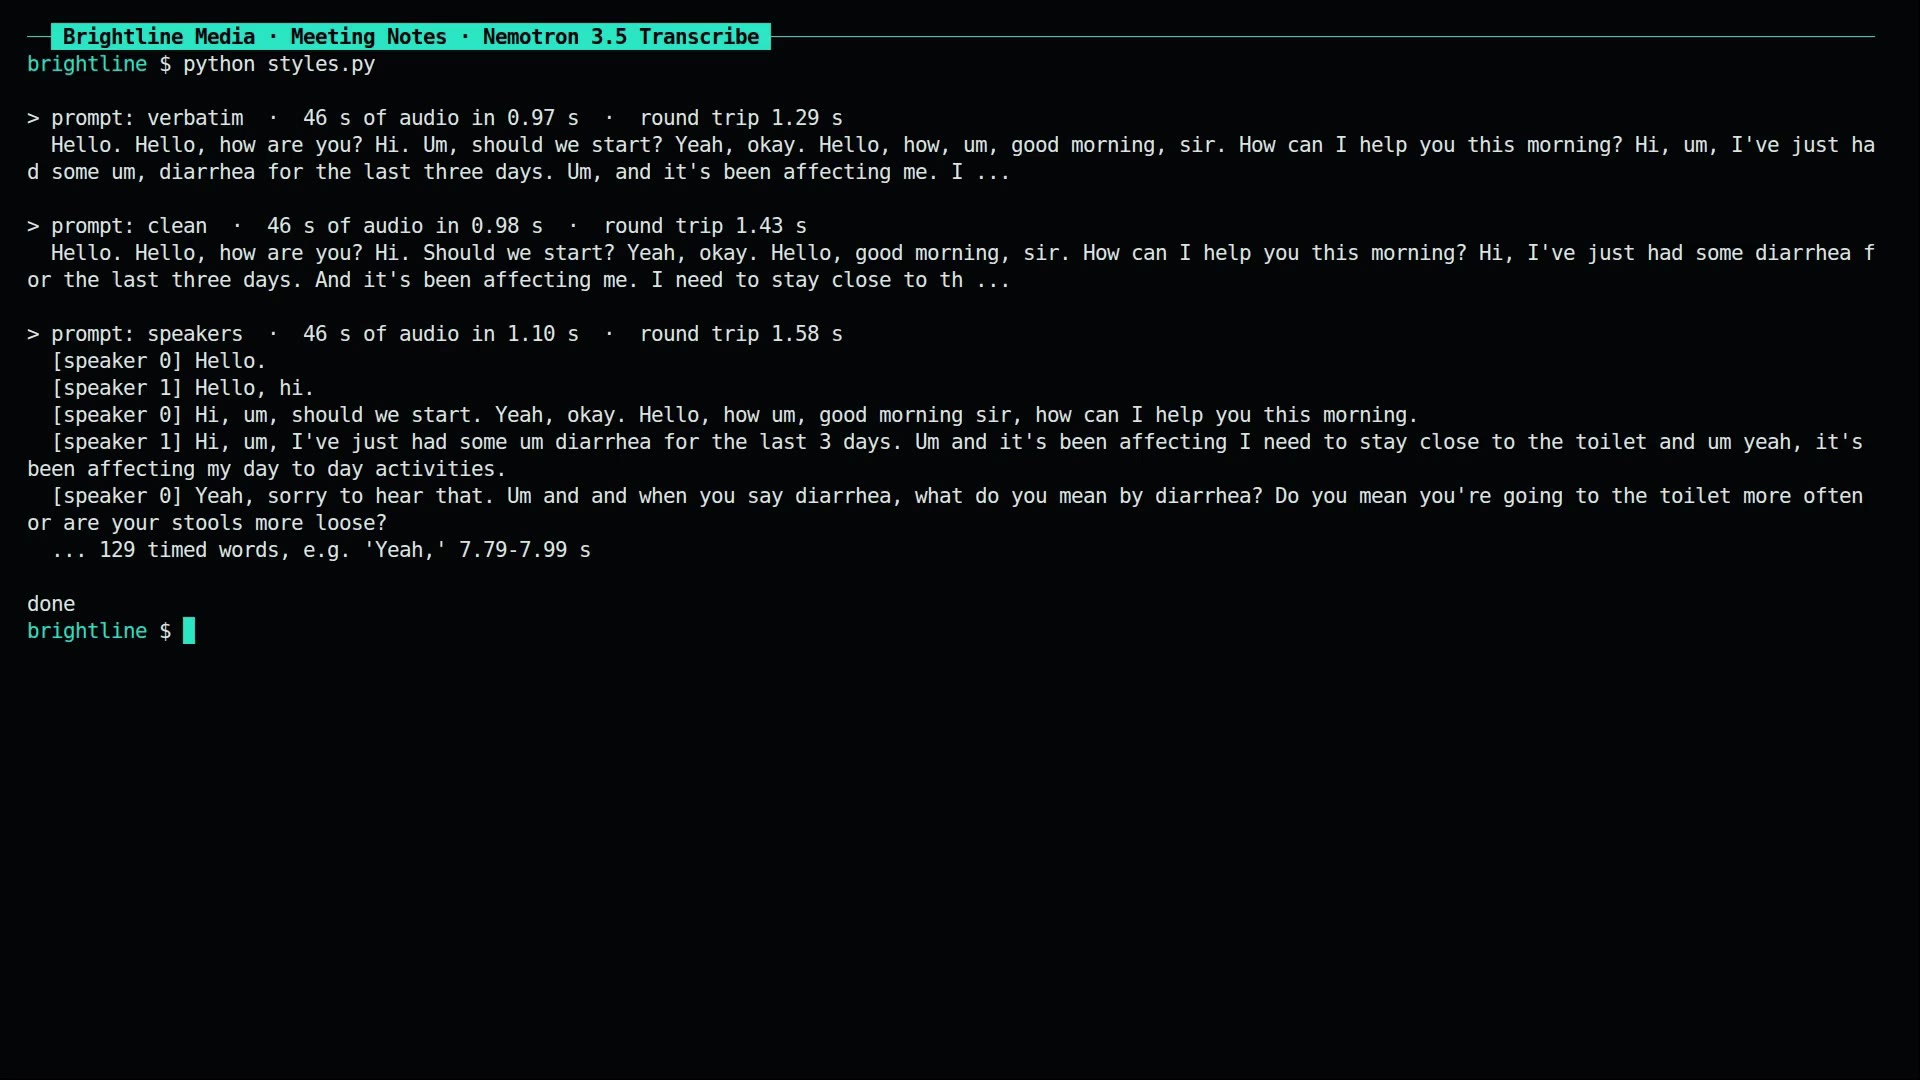
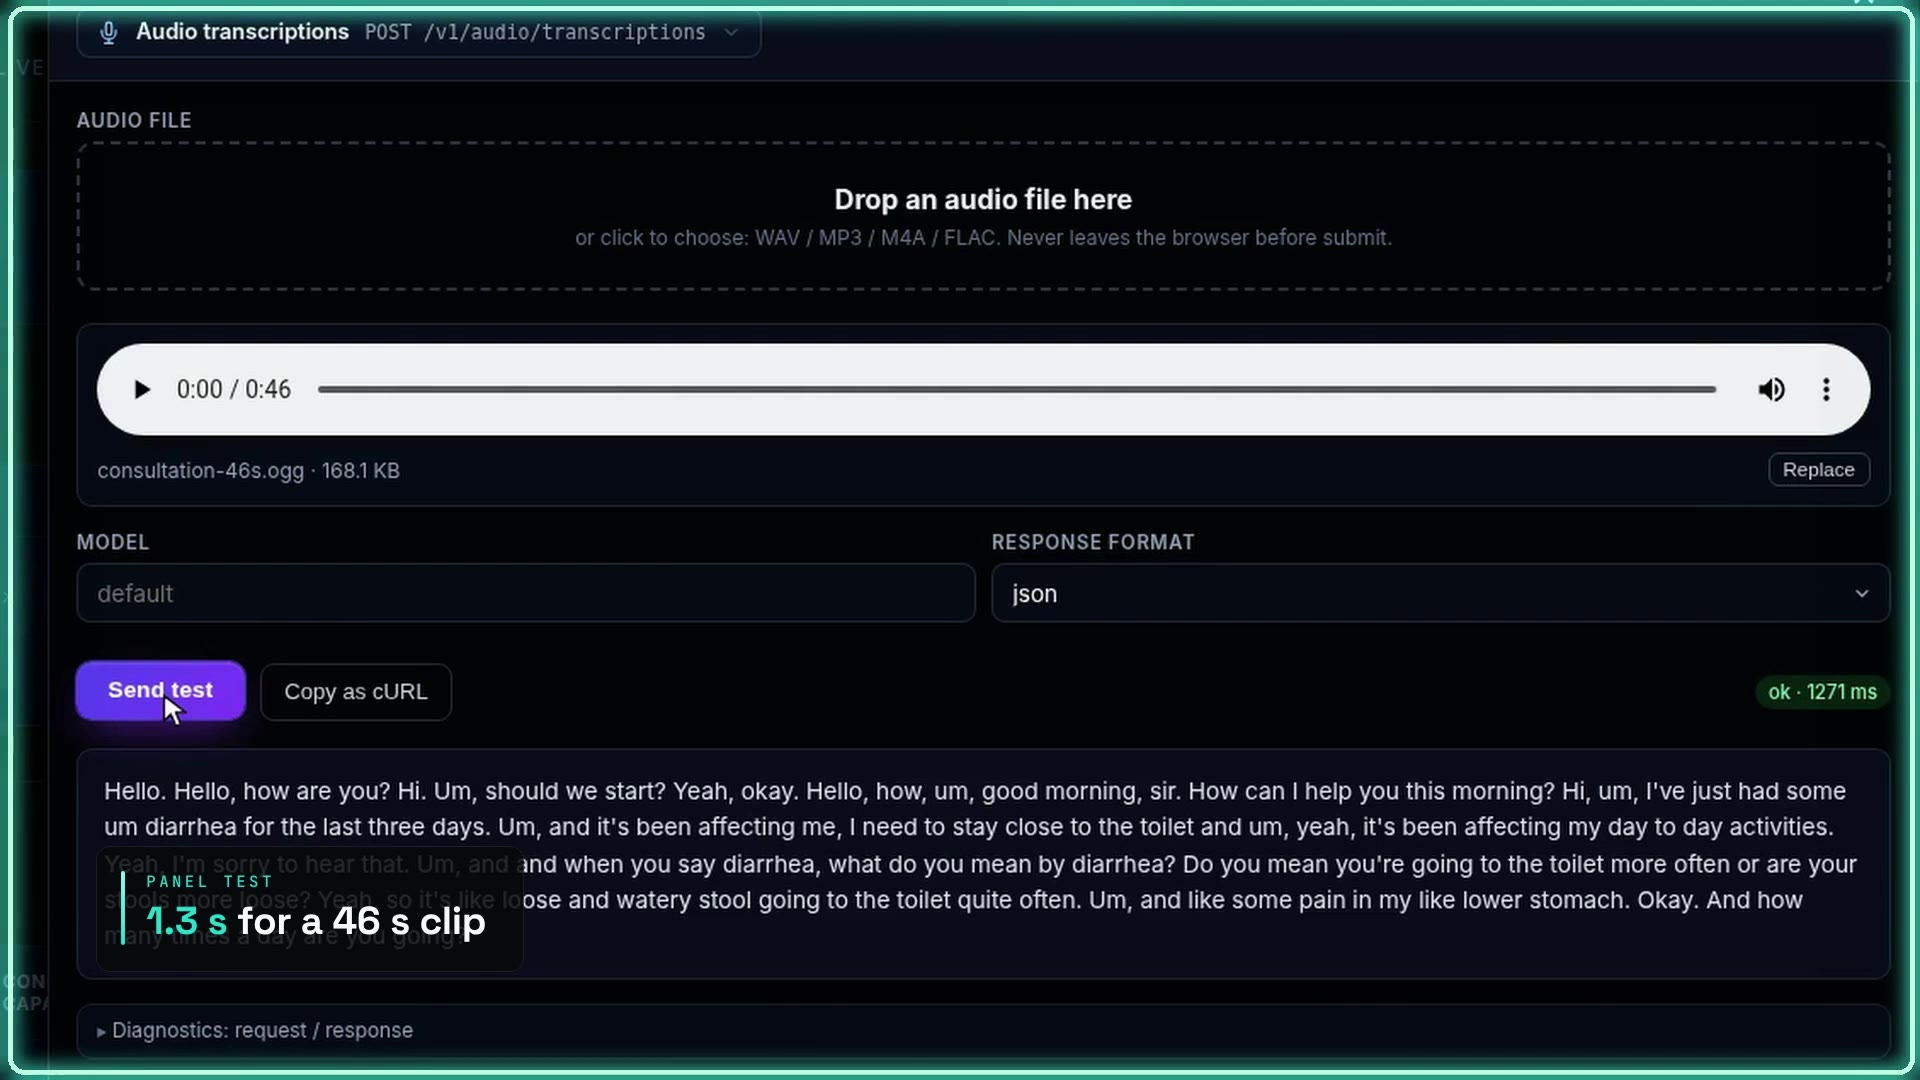
Clip court, consultation de 46 s : testeur du panneau ok · 1271 ms ; en terminal, verbatim 0,97 s GPU / 1,29 s aller-retour, clean 0,98 / 1,43 s, speakers 1,10 / 1,58 s (129 mots horodatés).
Délai avant d'être prêt :
| Démarrage | Durée |
|---|---|
| Première machine, à froid, à la main | environnement 84 s, poids de 21,6 GB en environ 18 s, initialisation du moteur vLLM 255 s (compilations JIT de FlashInfer), environ 6 min au total |
Redémarrage à chaud via ensure() | 88 s |
| Deuxième machine, à froid, backend 0.1.4 (eager, sans MTP) | 217 s (environnement 53,4 s, poids 39,0 s) |
| Première requête après le démarrage | 12,30 s pour un clip de 9 s (préchauffage des noyaux) ; la deuxième 0,393 s |
Mémoire GPU sur 32 GB : chargement du modèle 20,7 GiB (19,41 GiB sans la tête MTP), cache KV 4,78 GiB = 1 066 780 tokens (concurrence de 16,28x à 65 536), CUDA graphs 0,21 GiB. Carte à 28 146 MiB au repos après le démarrage, pic de 30 254 MiB pendant l'exécution sur la plateforme (31 442 MiB dans le harnais direct).
Échelle de VRAM
| GPU ou limite | Config | Pic de VRAM | Durées | Sortie correcte | Réel |
|---|---|---|---|---|---|
| RTX PRO 4500 Blackwell 32 GB | util 0,92, len 65 536, 8 seqs, MTP 8, CUDA graphs | 30 254 MiB carte | 3 min speakers 4,401 s ; 5 min 4,818 s ; 40 clips 12,956 s | oui | réel |
| limite de 22,6 GiB sur la carte de 32 GB | util 0,72, len 32 768, 4 seqs, MTP 8, graphs | - | - | non : ValueError: No available memory for the cache blocks | émulé |
| limite de 23,5 GiB sur la carte de 32 GB | util 0,75, eager, sans MTP, len 16 384, 2 seqs | 25 712 MiB carte | 3 min 46,203 s ; 5 min 44,088 s ; 40 clips 63,441 s | a servi mais au-dessus de 24 GB ; 9,42 % parce que gigaspeech-06 est revenu vide | émulé |
| tranche MIG de 24 GB (RTX PRO 6000 Blackwell 1g.24gb) | util 0,93, eager, sans MTP, len 16 384, 2 seqs | poids 19,41 GiB + KV 1,4 GiB (221 184 tokens), d'après les logs de vLLM | 3 min speakers 35,34 s ; 5 min 31,733 s ; 40 clips 53,23 s | oui : 6,82 % (identique), consultation 13,76 %, long 15,65 % | réel |
| même tranche MIG | util 0,95, MTP 8, CUDA graphs, len 16 384 | - | - | non : RuntimeError: NVML_SUCCESS == r INTERNAL ASSERT FAILED at CUDACachingAllocator.cpp:1407 après le chargement de la tête MTP (mémoire insuffisante) | réel |
Les lignes émulées n'enseignent qu'une chose : une limite logicielle avec --gpu-memory-utilization n'est pas une carte de 24 GB (à 0,75, soit un budget de 23,5 GiB, la carte a utilisé 25 712 MiB). Seule la vraie tranche compte comme preuve pour 24 GB.
Ralentissement sur la tranche : 4,1x sur les clips courts (temps GPU), 6,6x sur le fichier de 5 minutes, 8,0x sur l'exécution speakers de 3 minutes. La tranche 1g a un quart des SM de la PRO 6000. nvidia-smi ne lit pas la mémoire MIG, donc la VRAM y vient du log de vLLM. Il n'existe pas de carte GeForce Blackwell de 24 GB, et NVFP4 ne tourne pas sur Ada (RTX 4090) ni sur plus ancien. Pas essayé : 16 GB, 24 GB avec MTP mais sans graphs, FP8 sur 48 GB, DFlash2, concurrence.
Exemples de sorties
- Consultation,
speakers+ horodatage des mots, 4,401 s : "spk:0 Hello. spk:1 Hello, how are you? spk:0 Hi, um, should we start? Yeah, okay. Hello, um, good morning, sir. How can I help you this morning? spk:1 Hi, um, I've just had some um diarrhea for the last three days. ..." Premiers mots :Hello.de 2,94 à 3,25 s locuteur 0 ;Hello,de 3,919 à 3,97 s locuteur 1. - earnings22-01 (9,3 s), verbatim, 0,381 s : "Can you, uh, yeah, just perhaps give us an update on on how things have progressed there, and um, you know, how how we're tracking relative to perhaps where where you where you were last quarter? Thank you."
Vidéo de démo
Une présentation commentée de 183 secondes : le testeur du panneau sur un clip de 46 secondes, les trois prompts dans un terminal, la comparaison clé et l'échelle de 24 GB.
Problèmes et statut
- Limite de téléversement de 2 MiB sur
/v1/audio/transcriptions(plateforme, ouvert). Environ 8 minutes d'Opus à 32 kbps. La principale limite pour ce modèle sur la plateforme. - Compilation JIT de FlashInfer tuée dans un conteneur de 62 GB (corrigé dans le backend).
fp4_gemm_cutlass_sm120a échoué avecFAILED: [code=137] ... KilledetRuntimeError: Ninja build failed: ninja lançait environ 18 nvcc en parallèle. Corrigé avec les noyaux précompilés etMAX_JOBS=6. La wheelflashinfer_jit_cachedes releases GitHub est un stub de 16 KB. Il faut le paquet fournisseur par architecture plus le paquet de premier niveau ; l'absence de ce dernier donnaitAttributeError ... __version__, corrigé dans la 0.1.4. - Processus enfant vLLM orphelin après une suppression (plateforme, contourné). Le worker arrête les backends sur mesure avec SIGKILL, donc
vllm servesurvivait avec PPID 1 en occupant 25 à 29 GB, et le démarrage suivant échouait avecFree memory on device cuda:0 (2.8/31.37 GiB).... Corrigé dans le backend avecPR_SET_PDEATHSIGet un fichier pid périmé. Correctif de plateforme à ouvrir : SIGTERM avec un délai de grâce, puis kill du groupe de processus. - La relance du watchdog du worker entre en concurrence avec une suppression (plateforme, mineur, ouvert).
cleanajoute des étiquettes de locuteur non demandées (comportement du modèle) : 50 en 3 minutes, plus un faux départ conservé.- Réponse vide sur gigaspeech-06 uniquement dans le palier émulé de 23,5 GiB (1 token,
finish_reason: stop). Correct sur 32 GB et sur la tranche. Pas étudié. - Les limites émulées sous-estiment : à util 0,75 (budget de 23,5 GiB), la carte a utilisé 25 712 MiB, donc seule la vraie tranche fait preuve pour 24 GB.
Limites de ce test
924 mots de clips, un fichier de 3 minutes et un de 5 minutes, décodage glouton, une requête à la fois. Aucune mesure de débit ni de concurrence, donc aucune vérification du chiffre de 2 238 s/s ni de l'affirmation "roughly two times slower". Les benchmarks de NVIDIA sont en BF16 et n'ont pas été reproduits. Rien de mesuré sur une RTX 5090, une carte Blackwell complète de 24 GB, le checkpoint FP8, DFlash2 ou d'autres langues (sortie traduite non notée).
Benchmarks des auteurs (BF16, relevés le 12 oct. 2026, non reproduits)
| Benchmark | Nemotron 3.5 Transcribe | Comparaison |
|---|---|---|
| Open ASR anglais, 9 jeux, WER moyen | 4,71 | Qwen3-ASR-1.7B 4,94 |
| WER sur format long | 10,98 | Parakeet-TDT-0.6B-v3 13,37 |
| Multilingue, 7 langues | 4,62 | Qwen3-ASR-1.7B 6,49 |
| cpWER moyen multi-locuteurs (AMI, CALLHOME, Mixer 6, NOTSOFAR-1) | 15,80 | DiCoW v3.3 + DiariZen 16,83 |
| Preference-ASR, par défaut / avec instruction | 7,56 / 6,16 | Canary-Qwen 8,16 / 8,36 |
RTFx de la fiche sur une H100 BF16 sous charge de batch optimisée : MTP2 410, MTP8 270, DFlash2 K=7 340, DFlash2 K=15 260.
Sources
- Fiches du modèle : BF16, NVFP4, FP8, DFlash2
- Licence : OpenMDW-1.1
- NeMo Speech (plugin vLLM dans
nemo/collections/speechlm2/vllm/salm) - SGLang-Omni et son cookbook Nemotron Transcribe
- PriMock57, données de l'Open ASR Leaderboard
- Notre test précédent : Underdog Bark 3.0 Pro contre Qwen3-ASR-1.7B
- Où nous l'avons repéré : vidéo d'actualité d'AI Search, 1er novembre 2026
- Exemple du SDK