Hy-Nomas sur une RTX 4090 : un monde vidéo qui se souvient, environ 90 secondes par tour de 5 secondes
Le modèle de monde vidéo ouvert de Tencent sur une RTX 4090 de 24 GB : 88 à 94 s par segment de 5 s, pic de 18,5 GiB, 1 changement de scène sur 4 suivi.
La plupart des modèles vidéo ouverts vous donnent un clip, puis l'oublient. Hy-Nomas, un modèle ouvert de Tencent Hunyuan, garde le monde en mémoire : chaque nouvelle instruction ajoute cinq secondes à la même scène. La question, pour qui a son propre matériel, est de savoir si la recette sur une seule carte de Tencent fonctionne loin de ses huit GPU d'origine. Sur une seule RTX 4090 de 24 GB de notre cloud, elle a tourné, à environ une minute et demie par morceau de 5 secondes. Le renard, le chemin de pierre et la lumière se sont maintenus d'un appel à l'autre. Un changement de scène sur quatre a pris : des fleurs nouvelles oui, la neige et un orage non. Une seule carte gaming louée suffit donc à prototyper des scènes qui restent cohérentes d'un tour à l'autre, pas à faire tourner un jeu en direct. Le monde du renard en trois tours est fourni sous forme d'exemple du SDK que vous pouvez rejouer sur votre propre carte.
| Ce que vous voulez savoir | Ce que nous avons mesuré |
|---|---|
| Temps pour chaque tranche de 5 s de vidéo | 88 à 94 s sur une RTX 4090 |
| Mémoire GPU | pic de 18,5 GiB, environ les quatre cinquièmes de la carte |
| Plus petite configuration qui a fonctionné | une RTX 4090 de 24 GB, et la même carte limitée à 20 GiB sur deux tours |
| Le monde reste-t-il cohérent ? | oui, sur 3 tours (15 s de vidéo) |
| Suit-il les changements ? | 1 changement de scène sur 4 (un nouvel objet oui, la météo non), actions ignorées |
| Ce que vous téléchargez | environ 35 GB d'un dépôt de 196 GB |
Un modèle qui prend des notes sur le monde qu'il a déjà dessiné
Hy-Nomas fait de la vidéo par tours, et chaque tour part de ce qui précède. Un modèle vidéo classique, c'est un peintre qui reçoit une consigne, peint et s'en va. Hy-Nomas, c'est un peintre qui tient un carnet. Chaque fois qu'il termine cinq secondes, il note à quoi ressemble la scène. Quand vous envoyez l'instruction suivante, il relit d'abord le carnet. C'est pour cela que le renard du tour trois est le même que celui du tour un.
Les auteurs l'appellent un modèle de monde vidéo : vous le pilotez tour par tour, chaque segment de 5 secondes avec une nouvelle instruction texte ou une trajectoire de caméra. La version rapide produit de la vidéo 720p à 24 images par seconde, selon la fiche du modèle. Le papier, "Hy-Nomas: Towards Free-form Interactive World Generation", a été mis en ligne le 27 octobre, signé par 39 auteurs. Il lit vos instructions avec un modèle ouvert emprunté, Qwen2.5-VL-7B.
Les poids et le code sont sous Apache-2.0 : utilisables commercialement, sans formulaire à remplir. Le dépôt de code liste quelques composants tiers sous leurs propres licences.
Le téléchargement fait plus peur qu'il ne devrait. Le dépôt Hugging Face complet pèse 196 GB, parce qu'il contient les originaux en pleine taille, deux adaptateurs complémentaires (rendu cinéma, robotique) et un gros réécrivain de prompts. La configuration sur une carte n'a besoin que de trois éléments, dont deux compressés : le modèle vidéo, le décodeur qui le transforme en images, et le lecteur de texte. Cela fait environ 35 GB, et notre machine les a récupérés en une vingtaine de secondes.
Les auteurs le font tourner sur huit GPU, et publient une seconde recette pour un seul
Le lancement par défaut de la fiche du modèle répartit une vidéo sur huit GPU qui travaillent en groupe. À côté, les auteurs publient une recette pour une seule RTX 4090. Elle stocke les gros éléments sous forme compressée et les garde dans la mémoire principale de l'ordinateur. Chaque élément ne passe sur le GPU que pour sa propre étape : le lecteur de texte, puis le modèle vidéo, puis le décodeur qui transforme le résultat en images. Seules les quelques dernières secondes du carnet restent sur le GPU. Les pages plus anciennes partent en mémoire principale.
La fiche du modèle est honnête sur le compromis. Elle prévient que la mémoire principale doit contenir les modèles mis de côté et l'archive qui grossit, et que les allers-retours entre mémoire et GPU ajoutent du temps. Le papier ne donne aucune vitesse pour la 4090. C'était notre question : la recette sur une carte fonctionne-t-elle hors de l'installation de Tencent, et à quel point est-elle lente ?
La fiche du modèle précise que la promesse d'un seul GPU couvre la vidéo, pas le réécrivain de prompts qui peaufine chaque instruction. Leur démo réécrit chaque instruction avec Nomas-PE, un modèle bien plus gros dont le lanceur fourni utilise par défaut une machine entière de 8 GPU.
Notre test : une RTX 4090, la recette des auteurs, trois tours par monde
Les limites d'abord. Nous avons construit deux mondes courts, le plus long de trois tours, donc 15 secondes de vidéo. Nous avons écrit les prompts à la main, sans le réécrivain des auteurs, et utilisé un nombre aléatoire fixe (une seed) par monde. Nous n'avons pas testé les trajectoires de caméra. Cela vérifie si la recette tourne et tient une scène, pas jusqu'où un monde peut aller.
Nous avons utilisé telle quelle la recette sur une carte des auteurs, sur une RTX 4090 de notre cloud. Chaque requête est passée par l'API de notre plateforme, comme une application l'appellerait. La carte était sur notre cloud. Le logiciel de notre plateforme tournait sur notre propre serveur, donc le service hébergé lui-même n'est pas testé ici.
Le premier monde est l'exemple des auteurs eux-mêmes : un petit renard orange qui marche sur un chemin de pierre dans une forêt. Au tour deux, nous avons demandé que des fleurs bleues s'ouvrent au bord du chemin. Au tour trois, nous avons demandé de la neige, et que le renard s'arrête et lève la tête. Un second monde, un gardien de phare avec une lanterne, a tenté un orage.
Environ 90 secondes par segment de 5 secondes, et le monde est resté cohérent
Sur une RTX 4090, chaque segment de 5 secondes a pris de 88 à 94 secondes une fois le programme chaud. C'est environ 18 fois plus lent que le temps réel. Si ce rythme tient, un monde d'une minute, c'est douze tours et environ 18 minutes de travail GPU. Le premier appel après un démarrage à neuf a pris jusqu'à 138 secondes.
| Monde du renard, une RTX 4090 | Temps GPU | Pic de mémoire GPU |
|---|---|---|
| Tour 1 : le renard marche sur le chemin | 88,4 s | 17,4 GiB |
| Tour 2 : les fleurs bleues s'ouvrent | 93,1 s | 17,6 GiB |
| Tour 3 : neige, le renard s'arrête | 88,2 s | 17,9 GiB |
La mémoire a un peu augmenté à chaque tour, pour une raison que nous n'avons pas trouvée. En comptant tout ce qui était sur la carte, le pic a été de 18,5 GiB, environ les quatre cinquièmes de la carte de 24 GB. Sur chaque tranche de 90 secondes, environ 35 vont au dessin, environ 9 à l'écriture du carnet, et le reste à la conversion en images et en fichier MP4.
Le monde est resté cohérent, et c'est ce qui marche le mieux. Le renard a gardé son pelage, sa taille et sa démarche. Le chemin, les arbres et la lumière n'ont pas bougé. Dans le monde du gardien, le ciré, la lanterne et le phare se sont maintenus entre les appels. Chaque appel est une requête séparée, à une minute et demie d'écart, et la scène se lisait pourtant comme une seule prise.
C'est aussi reproductible. Les mêmes tours avec la même seed ont donné des fichiers vidéo identiques à l'octet près sur quatre exécutions. Pour une équipe, cela veut dire qu'un rapport de bug peut inclure les entrées exactes, et que quelqu'un d'autre sur la même installation obtient exactement le même clip. Nous ne l'avons vérifié que sur une seule machine.
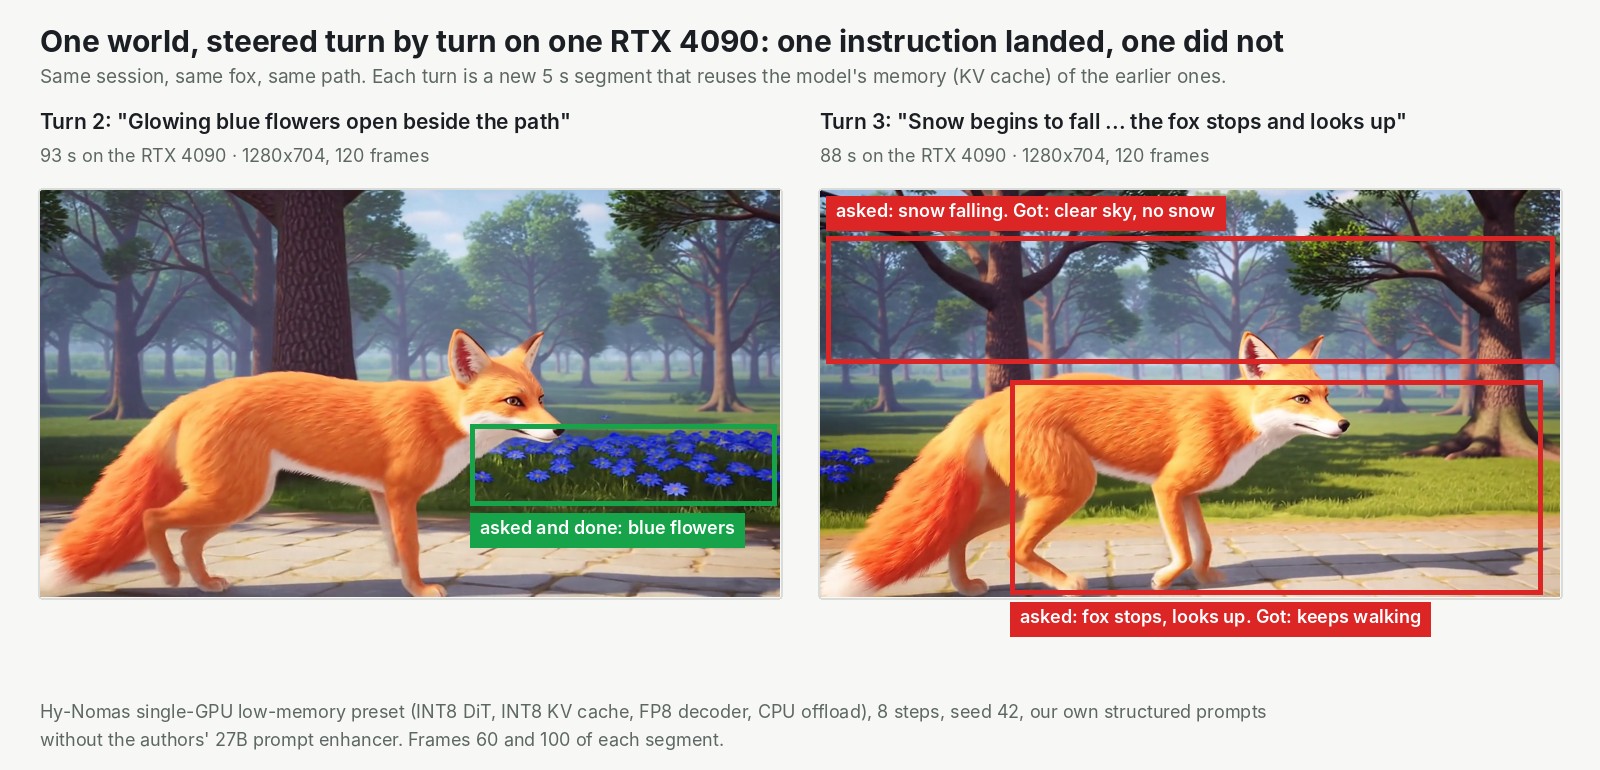
Un changement de scène sur quatre a pris : un nouvel objet oui, la météo et les actions non
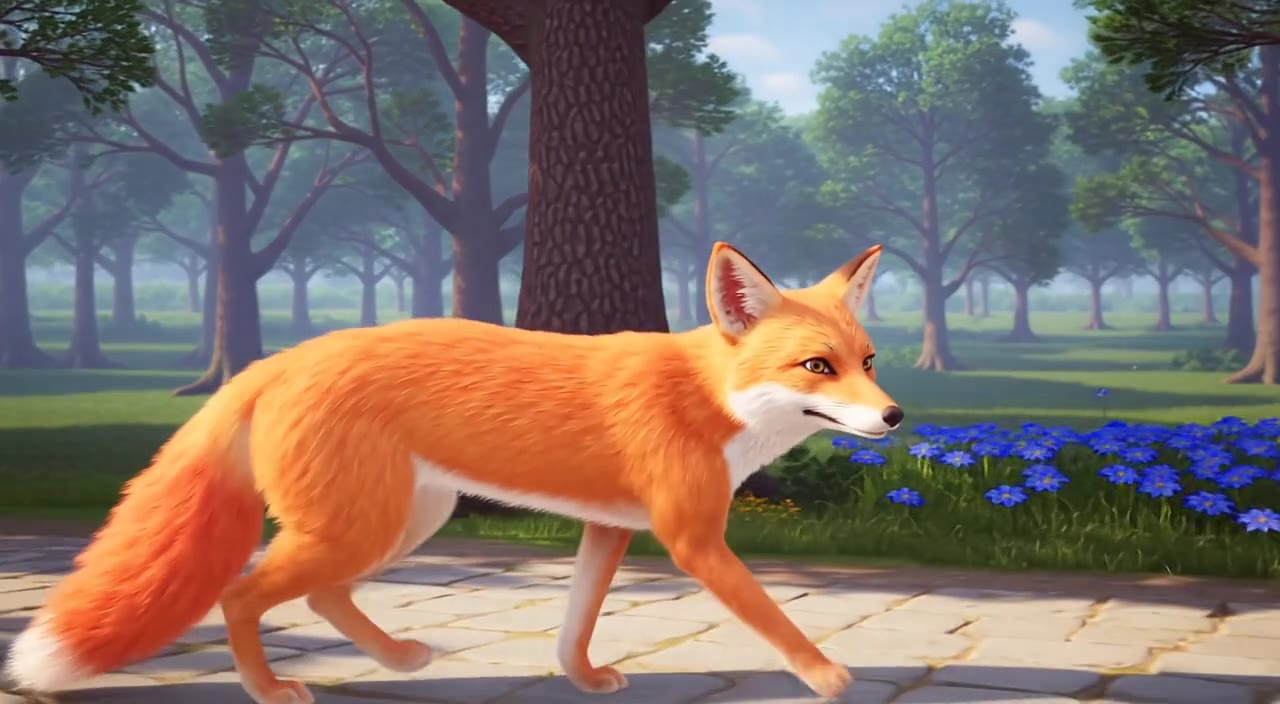
Hy-Nomas a ajouté l'objet demandé, au bon moment. Au tour deux, des fleurs bleues sont apparues au bord du chemin pendant que le renard passait. Elles ne brillaient pas, contrairement à ce que disait le prompt, mais elles étaient là, au bon endroit.
Les changements qui touchent toute la scène ne sont jamais apparus. Le tour trois demandait de la neige, et le ciel est resté ensoleillé. Nous avons réessayé avec une formulation plus forte, toujours pas de neige. Dans le monde du gardien, un orage avec pluie et éclairs n'est pas venu non plus. Cela fait un changement de scène sur quatre. Les actions ont échoué aussi : le renard a continué de marcher au lieu de s'arrêter pour lever la tête, et le gardien n'a jamais levé sa lanterne. Même les prompts de départ n'ont pris qu'en partie. La forêt n'avait ni lucioles ni lueur, juste la lumière du jour et de la brume.
On aurait dit un groupe qui tient le groove pendant trois morceaux et rate le changement de tonalité annoncé par le chanteur. Un suspect possible est le réécrivain absent. La démo des auteurs transforme chaque instruction courte en un prompt de génération structuré avant que le modèle ne la voie. Nous n'avons pas testé si Nomas-PE règle la neige et les orages, donc prenez cela comme une hypothèse. Le papier ajoute sa propre réserve : les raccourcis pour une seule carte "may introduce subtle differences that become more noticeable over successive segments".
Quel GPU : une vraie RTX 4090 de 24 GB a fonctionné, et une limite de 20 GiB sur cette carte est passée aussi
Une carte de 24 GB fonctionne, une limite de 20 GiB fonctionne, et 16 GiB échoue. La RTX 4090 est la seule vraie carte que nous ayons testée. Pour les tailles plus petites, nous avons demandé au logiciel d'utiliser moins de cette même carte.
- RTX 4090, 24 GB, vraie carte : fonctionne (voir plus haut).
- Limitée à 20 GiB sur la même carte : fonctionne, sans ralentissement (90,5 secondes pour le deuxième tour) et avec une vidéo identique à l'octet près, sur deux tours.
- Limitée à 16 GiB : échoue avant qu'aucune vidéo ne soit dessinée. Elle manque de mémoire en chargeant le lecteur de texte sur le GPU. Une résolution plus basse n'aiderait pas, puisque l'échec arrive avant.
Deux réserves changent la liste de courses. D'abord, une partie de la recette ne tourne que sur la génération Ada de NVIDIA, la famille de la RTX 4090. Une RTX 5090 plus récente ou une A40 plus ancienne devrait échouer, mais nous ne les avons pas fait tourner. Ensuite, la propre exécution sur une carte des auteurs a atteint un pic de 20,53 GiB, avec des segments plus longs que les nôtres. Une vraie carte de 20 GB est donc un pari que nous n'avons pas testé.
La mémoire principale compte aussi. Chaque tranche de 5 secondes de monde y ajoute environ 5,9 GiB d'anciennes pages du carnet. Notre exemple demande 64 GB, un choix de notre part, pas un minimum mesuré.
Sur InferenceKey : un appel par tour, le monde gardé entre les appels
Un modèle interactif a besoin d'un serveur qui garde le monde en mémoire entre les appels. Notre plateforme l'a gardé avec un petit programme sur mesure, qui ne fait qu'envelopper le service de génération des auteurs et leur recette sur une carte. Il garde un monde en mémoire GPU et en mémoire principale entre les appels, donc une carte sert un monde, et un utilisateur, à la fois. Chaque appel envoie un tour et reçoit un MP4 de cinq secondes. L'appel suivant continue le même monde. Avec les poids déjà sur le disque, le déploiement était prêt de 19 à 31 secondes après l'appel de déploiement.
Le seul problème que vous rencontrerez si vous partez des scripts des auteurs, c'est la mémoire. Leur script de démo en direct active un mode qui décode la vidéo pendant que le modèle vidéo est encore sur le GPU. Sur 24 GB, la mémoire ne suffit pas. Nous avons désactivé ce mode, donc le décodage commence après la fin du dessin. Statut : contourné dans notre exemple (ce mode désactivé), pas encore signalé aux auteurs. Les autres problèmes que nous avons trouvés, et leurs correctifs, sont en annexe.
Faut-il l'utiliser ? Oui pour des scènes cohérentes sur une carte, pas encore pour du jeu en direct
- Si vous voulez une scène qui reste cohérente d'un tour à l'autre, essayez-le.
- Si vous avez besoin qu'il suive des changements sur toute la scène, comme la météo ou une action soudaine, testez d'abord vos propres prompts. Les nôtres ont surtout échoué.
- Si vous avez besoin de temps réel, cherchez ailleurs. Cinq secondes de vidéo prennent une minute et demie sur une 4090.
- Si votre carte n'est pas une carte Ada de 24 GB, attendez-vous à retravailler la recette. Prévoyez aussi la mémoire principale, et davantage pour des mondes plus longs.
Pour jouer le même monde du renard en trois tours sur votre propre carte, lancez l'exemple du SDK du modèle de monde Hy-Nomas. Il faut un projet InferenceKey avec un token SDK et une clé d'API. Il faut aussi une machine NVIDIA privée avec une carte Ada de 24 GB comme une RTX 4090, 64 GB ou plus de mémoire principale et environ 60 GB de disque. Les étapes sont en annexe.
Pour les ingénieurs
Crédits
- Hy-Nomas : Tencent Hunyuan, papier de 39 auteurs, arXiv 2610.36729. Ils ont entraîné le modèle et écrit le preset basse mémoire pour un seul GPU, les poids INT8 et FP8 et le service de génération résident que notre backend enveloppe, le tout sous Apache-2.0.
- Conversion Diffusers : publiée par Tencent sous le nom Hy-Nomas-Diffusers ; elle dépend d'un fork de Diffusers par jiaxiangc (
github.com/jiaxiangc/diffusers@hy-nomas). - Encodeur de texte : la partie langage de Qwen2.5-VL-7B-Instruct, de l'équipe Qwen (Apache-2.0).
- Décodeur : affiné par Tencent à partir de PixelUMM (Wei et al., 2026), cité dans la section 6.2 du rapport technique.
- Noyau FP8 du décodeur : construit sur CUTLASS de NVIDIA (exemple de GEMM blockwise pour Ada).
- Clips de la vidéo de démo : les images promotionnelles des auteurs, créditées à l'écran avec "Source: Tencent Hunyuan, Hy-Nomas project page (promo video)".
- Où nous l'avons repéré : la vidéo d'actualités d'AI Search du 2026-10-25, chapitre Hy-Nomas de 9:27 à 11:14.
- Notre part : le backend sur mesure autour du service des auteurs, le déploiement à travers la plateforme, les prompts, les mesures, l'échelle de VRAM, l'exemple du SDK et la vidéo de démo.
Modèle et fichiers
tencent/Hy-Nomas, Apache-2.0, sans accès restreint, dernière modification le 2026-10-28. Code :Tencent-Hunyuan/Hy-Nomasmaineffb8a49b83e6f1d35e26710db35194f2fd952a7(2026-10-30). L'API de GitHub affiche la licence comme "Other/NOASSERTION" parce que le fichier LICENSE enveloppe Apache-2.0 avec une liste de composants tiers.- Architecture (fiche du modèle) : MMDiT dense, 54 blocs double flux, 0 simple flux, hidden 2048, 16 têtes x 128, FFN 8192, RoPE 3D, prédiction de vitesse de flux avec échantillonnage ODE d'Euler. Le résumé arXiv parle d'un "8B diffusion backbone". Encodeur de texte : modèle de langage Qwen2.5-VL-7B (3584 dimensions, token refiner à deux couches). Latents : DCAE-V f32t4c32. Décodeur : PixelUMM affiné, 36 couches, hidden 4096, une étape de décodage. La config distillée utilise 8 étapes de débruitage.
- Tailles des fichiers (API HF, GB décimaux) :
DiT/distilled_int89,06,VAE/PixelUMM_FT_FP89,13,VAE/DCAE-V4,28,DiT/distilledFP32 34,21,DiT/base_arFP32 34,21,PixelUMM_FT31,55, LoRA cinéma 6,12, LoRA robotique 12,24,PE/55,58 (18 shards). Dépôt complet 196,4 GB (182,9 GiB). Qwen2.5-VL-7B-Instruct : 16,6 GB, dépôt séparé. - Le preset lit le DiT INT8 + PixelUMM FP8 + Qwen2.5-VL-7B, environ 34,8 GB décimaux (environ 32,4 GiB). DCAE-V n'est pas lu quand PixelUMM est le décodeur (
pipeline/base.py) ; en le comptant quand même, on arrive à environ 39,1 GB. Le log de notre backend montre 33 GB téléchargés en environ 20 s (de 06:48:23 à 06:48:43 UTC). tencent/Hy-Nomas-Diffusers: BF16 (non quantifié, pas les originaux FP32), 45,2 GB,HyNomasModularPipeline, nécessitegithub.com/jiaxiangc/diffusers@hy-nomas. Son exemple utilise 4 étapes en 704x1280 et pas de PE. La fiche dit que la config INT8/FP8 pour RTX 4090 est un déploiement natif séparé. Non utilisé ici.- Versions fixées par le code : Python >= 3.12,
torch==2.10.0+cu130,transformers==4.57.1,diffusers==0.36.0,nvidia-cutlass-dsl[cu13]==4.8.0, flash-attn etflash-attn-3==3.0.0.
Le preset pour un seul GPU
configs/experiment/single_gpu_low_mem_inference.yaml règle seg_ar_attention_backend: flex ("for SM89 or below"), vae.cutlass_fp8: true, vae.cpu_offload: true, text_encoder_cpu_offload: true, dit_cpu_offload: true, dit_weight_quantization: int8, kv_cache_quantization: int8, fenêtre glissante past_frames: 18 (frames latentes ; un segment de 120 frames fait 30 frames latentes, donc 18 correspondent à environ 3 s de vidéo), attention sparse triton_bf16, torch_compile: true, sp_size: 1. Les poids et le KV sont stockés en INT8 et calculés en BF16. Le rapport technique (6.2) ajoute l'attention sparse : dense pour les deux premières étapes, puis 25 % des blocs vidéo candidats. La config standard utilise sp_size=8 et un décodage PixelUMM distribué, donc son lancement par défaut nécessite huit GPU dans un même groupe.
Le noyau FP8 CUTLASS du décodeur est compilé avec -gencode=arch=compute_89,code=sm_89 et lève "CUTLASS FP8 backend requires SM89" sur toute autre capability. Il a besoin de CUTLASS_PATH pointant vers un checkout de CUTLASS avec l'exemple 94 GemmBlockwise pour Ada (hymm/models/vae/pixelumm_decoder/cutlass_fp8.py). Tel qu'il est écrit, le preset nécessite un GPU Ada. Nos logs attribuent le premier appel plus lent dans un processus neuf à la compilation des noyaux et aux caches ; un de ces appels (84,9 s) n'a pas été plus lent que les tours à chaud.
Installation
- Une RTX 4090 24 GB (23,52 GiB annoncés par PyTorch) sur notre cloud (InferenceKey Cloud), driver 595.91.07 (CUDA 13.2), AMD EPYC 7513, 503 GB de RAM hôte, 100 GB de disque. Machine demandée avec au moins 64 GB de RAM.
- Un manager InferenceKey local a amorcé le worker. La production n'a pas été touchée.
- Backend Python sur mesure
hy-nomas-world0.1.2 :apps/seg_ar_web_server.GenerationService(rank=0, world_size=1, rollout_type="seg_ar")avec+experiment=single_gpu_low_mem_inference,preserve_kv_cache=Trueentre les requêtes, un monde résident. setup()récupère le tarball des sources au commit fixé et les headers de CUTLASS v4.8.1, lancesnapshot_downloaduniquement pour les fichiers du preset et Qwen2.5-VL-7B, met lebin/du venv et/usr/local/cuda/bindans lePATH, et règleCUTLASS_PATH.- Prompts de pilotage : une seed par monde, 42 pour le monde du renard et 7 pour celui du gardien ; la nouvelle tentative pour la neige a reproduit le segment 1 à l'octet près. Aucune autre seed essayée.
Pas à pas avec l'exemple du SDK
- Clonez inferencekey-sdk et ouvrez
examples/hy-nomas-world-model-custom-backend-private-nvidia/(commit403c619b). Fichiers :backend.py,publish.py,main.py,requirements.txt,README.md,.env.example. cp .env.example .envet renseignezINFERENCEKEY_SDK_TOKEN(ik_sdk_),INFERENCEKEY_API_KEY(ik_live_),INFERENCEKEY_PROJECTetIK_WORKER_ID. Optionnel :INFERENCEKEY_TENANT_IDetINFERENCEKEY_USER_TOKENpour quepublish.pytéléverse le backend et quemain.pyactive la route de chat (sinon, faites les deux dans le tableau de bord).pip install requestsplus le build local du SDK.python publish.pyune fois : empaquettebackend.pyet le téléverse.python main.py:ensure()d'un workload fixe (ready_timeout_secs3600,request_timeout_secs600), activation de la route de chat,wait_until_ready(), trois tours du monde du renard,outputs/segment-1.mp4àsegment-3.mp4, puisworld.mp4assemblé avec ffmpeg de votre côté.IK_KEEP_ALIVE=1garde le workload.
Exigences du worker : Ada (SM89) avec 24 GB, driver pour CUDA 13.0+ (580+), nvcc dans /usr/local/cuda/bin (le noyau FP8 est compilé à la première utilisation), 64 GB+ de RAM hôte, environ 60 GB de disque.
Un tour part en JSON dans le dernier message utilisateur de /v1/chat/completions :
{"step": "start", "style": "Cinematic fantasy", "perspective": "Third-person view",
 "subjects": [{"subject_id": "fox", "display_name": "a small orange fox",
               "subject_attribute": "Orange fur, white chest, and a fluffy tail."}],
 "scene": "A small orange fox stands on a stone path in a luminous forest.",
 "action": "The fox walks slowly along the path.", "seed": 42}
{"step": "continue", "session_id": "w50f42932fa5e",
 "change": "Glowing blue flowers open beside the path as the fox continues forward.",
 "action": "The fox passes the flowers and looks around."}
La réponse contient session_id, segment, video_b64 (le MP4 de ce segment, de 1,1 à 2,2 MB dans nos exécutions), width, height, frames et timings (gpu_s, peak_vram_mib). Réglages dans l'env du workload : NOMAS_VRAM_LIMIT_GIB, NOMAS_HEIGHT, NOMAS_WIDTH, NOMAS_EXTRA_OVERRIDES (overrides Hydra, par exemple inference.infer_steps_video=6).
Délais
| Mesure | Valeur |
|---|---|
setup() avec les poids sur le disque | 18,0 à 19,0 s (chargement du pipeline 12,1 à 13,1 s) |
De ensure() à prêt, venv et poids en cache | 31,1 s (exécution 2), 19,2 s (exécution 3), 19,5 s (redéploiement) |
| venv uv, à froid | 42 s |
| Téléchargement des poids | 33 GB en environ 20 s |
| Premier segment dans un processus neuf | 84,9 à 138,1 s |
| Chaque segment suivant | 88,2 à 96,1 s (88,2 à 93,7 s à travers la plateforme ; 96,1 s dans le harness) |
| Débruitage / écriture du cache KV | 30,8 à 38,7 s / 7,9 à 10,1 s |
| Décodage PixelUMM + encodage MP4 | environ 30 à 45 s (encodage MP4 2,5 à 3,4 s) |
Aucun temps de mise en route entièrement à froid de bout en bout à travers le worker (machine neuve, sans caches) n'a été mesuré.
Par segment, exécution principale à travers la plateforme
1280x704, 120 frames, 24 fps, 8 étapes, seed 42. Les MP4 des segments font 5,000 s, vidéo seule ; world.mp4 fait 360 frames, 15,000 s.
| Tour | Instruction | GPU s | Aller-retour s | Pic PyTorch MiB | Suivie ? |
|---|---|---|---|---|---|
| 1 start | petit renard orange sur un chemin de pierre dans une forêt lumineuse, lucioles bleues | 88,36 | 89,3 | 17 774 | renard, chemin, forêt oui ; lueur et lucioles non |
| 2 continue | des fleurs bleues lumineuses s'ouvrent au bord du chemin ; le renard regarde autour de lui | 93,05 | 93,6 | 18 056 | fleurs oui, sans lueur |
| 3 continue | la neige commence à tomber, le sol devient blanc ; le renard s'arrête et lève la tête | 88,21 | 88,5 | 18 336 | non : ensoleillé, le renard continue de marcher |
Autres exécutions : harness 84,9 / 96,1 s ; exécution 2 sur la plateforme 138,1 s (premier appel dans un processus neuf) / 93,7 s ; monde du gardien 87,4 / 90,5 s (orage non suivi) ; nouvelle tentative pour la neige 85,6 / 91,3 s. Pic de la carte 18 952 MiB (nvidia-smi, harness, deux tours).
Décompte du pilotage : quatre instructions de changement de scène (fleurs bleues, neige, nouvelle tentative pour la neige avec une formulation plus forte, orage), une suivie. En plus, deux actions ("stop and look up", "raise the lantern"), aucune suivie.
Les GiB sont binaires, un peu plus gros que les GB de la boîte, donc une carte de 24 GB affiche 23,5 GiB : 18 336 MiB font 17,9 GiB ; 18 952 MiB font 18,5 GiB.
Déterminisme par md5 : segment 1 (418955576ca2...) identique dans le harness, le palier de 20 GiB, la nouvelle tentative pour la neige et les exécutions 2 et 3 sur la plateforme ; segment 2 (0f87561f...) identique dans le harness, le palier de 20 GiB et les exécutions 2 et 3 sur la plateforme.
RAM système
Archive KV sur CPU d'après les logs du backend : cpu_archive_gib=5.881 après 1 segment, 11,763 après 2, 17,644 après 3 (total_frames 30/60/90, 18 frames latentes gardées sur le GPU). Linéaire, environ 5,88 GiB par segment. Aucun monde n'a dépassé 3 segments. Le RSS du processus n'a pas été mesuré. Les 64 GB de l'exemple sont un choix de provisionnement, pas un minimum mesuré.
Échelle de VRAM
Plafonds émulés sur la même 4090 avec torch.cuda.set_per_process_memory_fraction (NOMAS_VRAM_LIMIT_GIB).
| GPU ou plafond | Config | Pic de VRAM | Temps par segment | Sortie OK | Réel ou émulé |
|---|---|---|---|---|---|
| RTX 4090 24 GB | preset, 1280x704, 8 étapes, à travers la plateforme | 18 336 MiB PyTorch ; carte 18 952 MiB | 88 à 94 s (96,1 s dans le harness) | oui | réel |
| Plafond de 20 GiB | idem, start + continue | 18 056 MiB | 137,6 s le premier / 90,5 s | oui, MP4 identiques à l'octet près | émulé |
| Plafond de 16 GiB | idem | non : torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 26.00 MiB ... 15.98 GiB is allocated by PyTorch ... 16.00 GiB allowed dans _encode_prompt (Qwen2.5-VL-7B bf16 chargé sur le GPU) | émulé |
Pas essayé : un plafond de 18 GiB, une vraie carte Ada de 20 GB (RTX 4000 Ada), un encodeur de texte fp8 ou sur CPU, une résolution plus basse, moins d'étapes, des cartes non Ada (RTX 5090 sm_120, A40 sm_86, H100), et d'autres cartes Ada. Le plafond de 20 GiB a couvert deux segments. Le pic de 20,53 GiB du rapport technique concerne des segments plus longs (100 s en sept segments) ; le rapport lie le pic de mémoire à la longueur des segments, puisque l'historique sur le GPU est borné par la fenêtre glissante. De nombreux tours de 5 s sur une vraie carte de 20 GB ne sont pas testés.
Problèmes et statut
- OOM avec les flags de décodage du worker en ligne.
inference.seg_ar_segment_vae_decode=true+model.vae.stable_prefix_streaming=true(réglés parrun_seg_ar_gpu_worker.sh) décodent avec le DiT résident :torch.OutOfMemoryError ... Tried to allocate 826.00 MiB ... 22.50 GiB is allocated by PyTorch. Les deux flags ont été retirés ; le décodage a lieu après le débruitage. Contourné dans l'exemple, non signalé en amont. - Incompatibilité de torchvision. timm a tiré torchvision 0.25.0 de PyPI (CUDA 12) à côté de torch cu130 :
operator torchvision::nms does not exist. Corrigé en fixant la wheel cu130. Ninja is required to load C++ extensionspendant la compilation JIT du noyau FP8 : lebin/du venv n'est pas dans lePATH. Corrigé dans le backend.- Limite de message de 8 MB. Une réponse contenant le segment plus le MP4 du monde entier s'est terminée sur le worker mais n'a jamais atteint le client (NATS
max_payload8 388 608). La vidéo du monde a été retirée de la réponse ; le client assemble les segments. Des sorties plus longues ont besoin d'un stockage objet, pas de base64 en ligne. Ouvert dans la plateforme. - Pas de type de backend sur mesure
text2video. Le packager rejettetask_type 'text2video', et la modalité du workload doit correspondre au backend. L'exemple utilisetext2imagepour les deux et renvoie du MP4 sur la route de chat. Ouvert dans la plateforme. - Seed par monde. Un tour continue sans seed a reçu
400 {"error": "interactive continuation changed seed: existing=7, requested=42"}. Corrigé dans le backend 0.1.2, qui garde la seed de départ. - Limite synchrone de 300 s (
DEFAULT_TIMEOUT_MSdu manager), qui impose un segment par appel : un segment de 90 s passe, un rendu de plusieurs segments en un appel ne passerait pas. Les jobs asynchrones ne livrent que par webhook. Ouvert dans la plateforme. - Pilotage faible dans nos exécutions : changements sur toute la scène et actions non suivis, prompts de départ en partie absents. Pas testé si Nomas-PE corrige cela.
- Trajectoires de caméra non testées ("no camera_trajectory was provided"), et aucun monde n'a dépassé 3 segments.
Vidéo de démo
Correction pour la vidéo : son insert sur la mémoire indique un pic de "18.3 GiB". Il lit 18 336 MiB comme des milliers ; les bons chiffres sont 17,9 GiB de pic PyTorch et 18,5 GiB de pic de la carte.
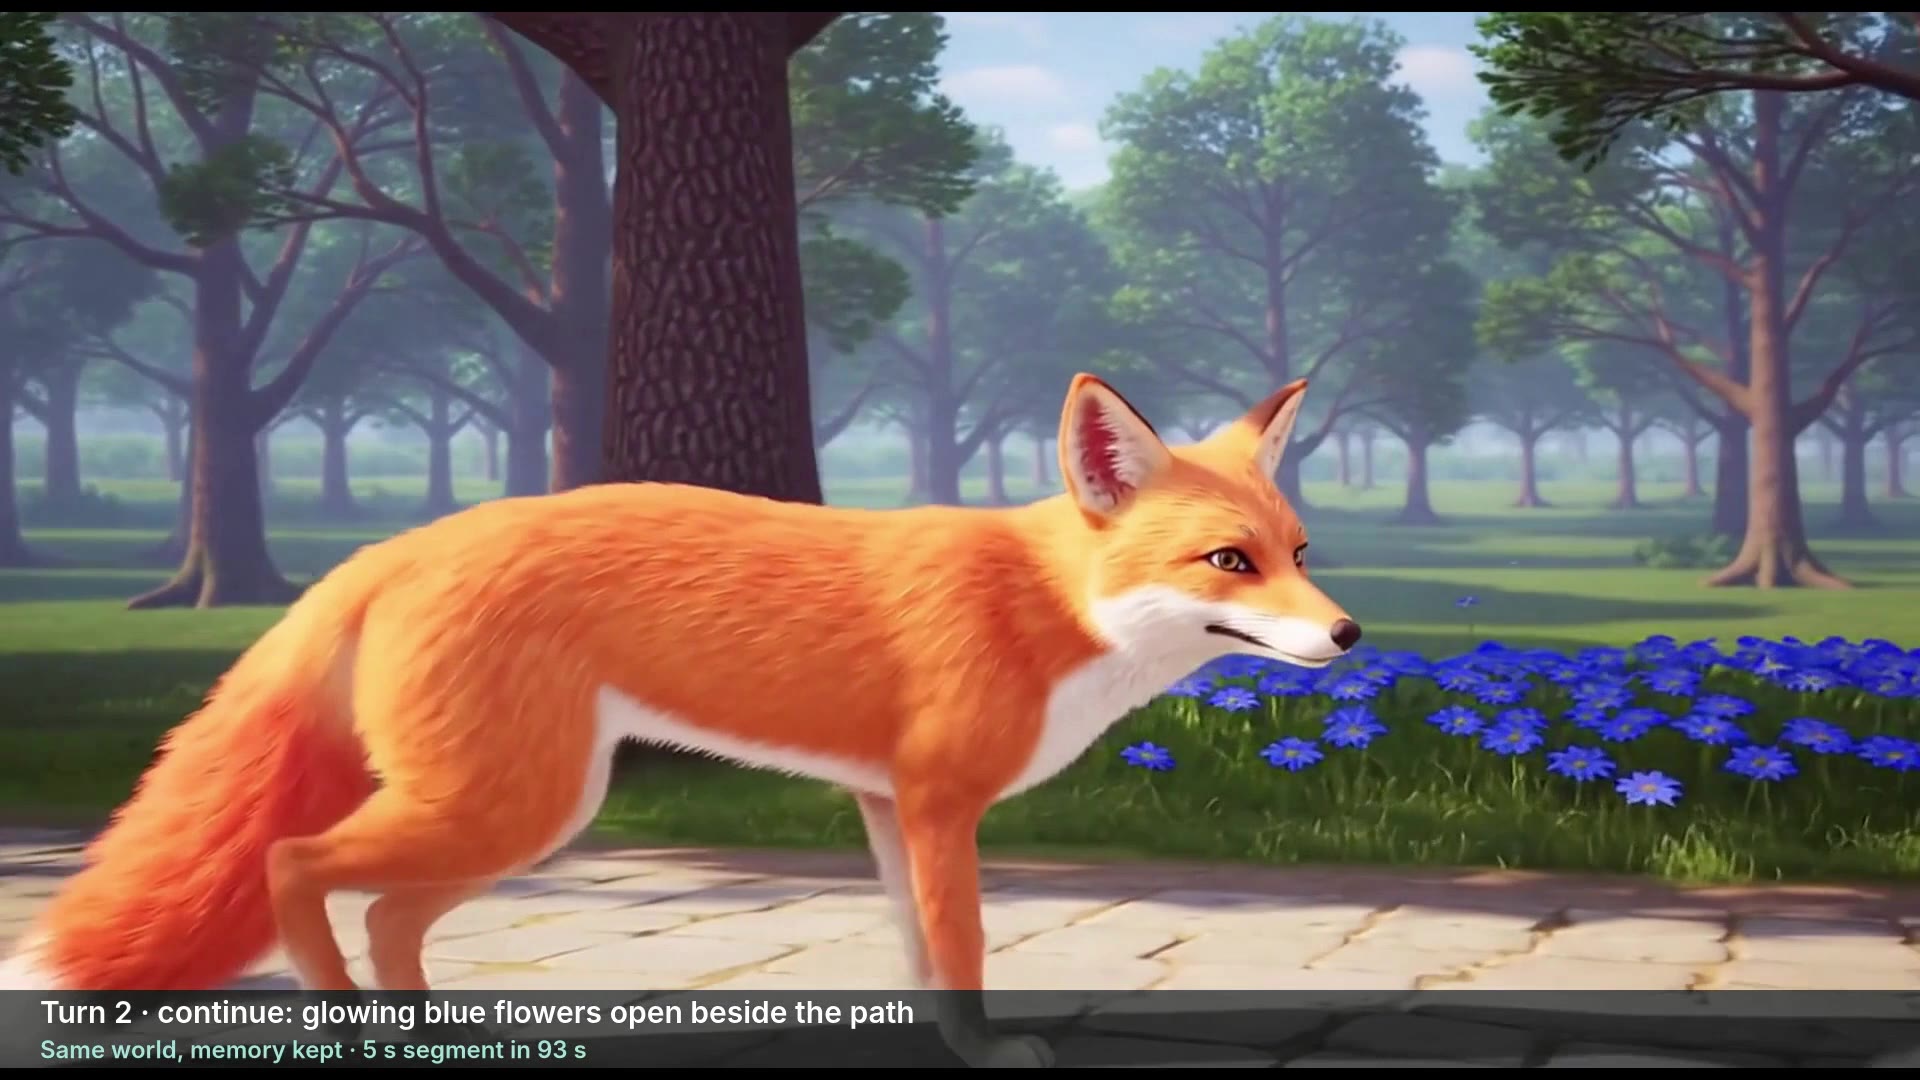
176 s, 1920x1080, sous-titres en anglais. Elle comprend les clips promotionnels des auteurs, crédités à l'écran, et leurs chiffres de benchmark signalés comme non reproduits par nous, puis nos mondes du renard et du gardien à travers l'endpoint.
Benchmark des auteurs (non reproduit)
Hy-Nomas-Bench : 280 cas répartis en quatre benchmarks, votes humains par paires. Bench-1, texte multi-tours : taux de victoire en suivi du prompt de 65,0 % contre Happy Oyster (Directing) et de 75,0 % contre LingBot-World v2 ; plausibilité physique 45,0 % et 68,3 %. Mémoire spatiale comparable à Happy Oyster, derrière Genie 3.
Sources
- Fiche du modèle : https://huggingface.co/tencent/Hy-Nomas
- Code : https://github.com/Tencent-Hunyuan/Hy-Nomas
- Papier : https://arxiv.org/abs/2610.36729
- Version Diffusers : https://huggingface.co/tencent/Hy-Nomas-Diffusers
- Encodeur de texte : https://huggingface.co/Qwen/Qwen2.5-VL-7B-Instruct
- Exemple du SDK : https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/hy-nomas-world-model-custom-backend-private-nvidia
- Où nous l'avons repéré : https://www.youtube.com/watch?v=EfyQOAJjx1A