Sage-A1.5 sur une carte de 24 GB : 136 tokens/s, et un mode de vérification qui double le travail sur les questions faciles
Agent de recherche 35B du Shanghai AI Lab sur une RTX 4090 : 136 tokens/s, une question juste 3 fois sur 3, vérification deux fois plus lente sur le facile.
Trente-cinq milliards de paramètres sur le disque, environ trois milliards au travail pour chaque mot. C'est cet écart qui permet à Sage-A1.5, un agent de recherche ouvert du Shanghai AI Laboratory, de tenir sur une seule carte gaming. Nous avons fait tourner le fichier compressé des auteurs eux-mêmes sur une RTX 4090, une carte gaming de 24 GB, sur notre cloud (InferenceKey Cloud), avec des logiciels open source standard. Sa mécanique d'agent y a fonctionné : il a distribué des tâches, a demandé à notre code de chercher, et a répondu. Il a écrit environ 136 tokens par seconde, une longue réponse en 11 secondes, et a répondu juste à notre unique question de recherche en trois parties dans les trois exécutions de test. Son nouveau Verification Mode, qui lui fait vérifier son propre travail, a donné les mêmes bonnes réponses sur des questions faciles, mais a pris 2,2 fois plus de temps et deux fois plus de tokens. Le modèle tourne sur un worker GPU que vous contrôlez, et les outils tournent dans votre propre code. Laissez le mode de vérification désactivé pour les recherches simples, et testez-le sur vos cas difficiles.
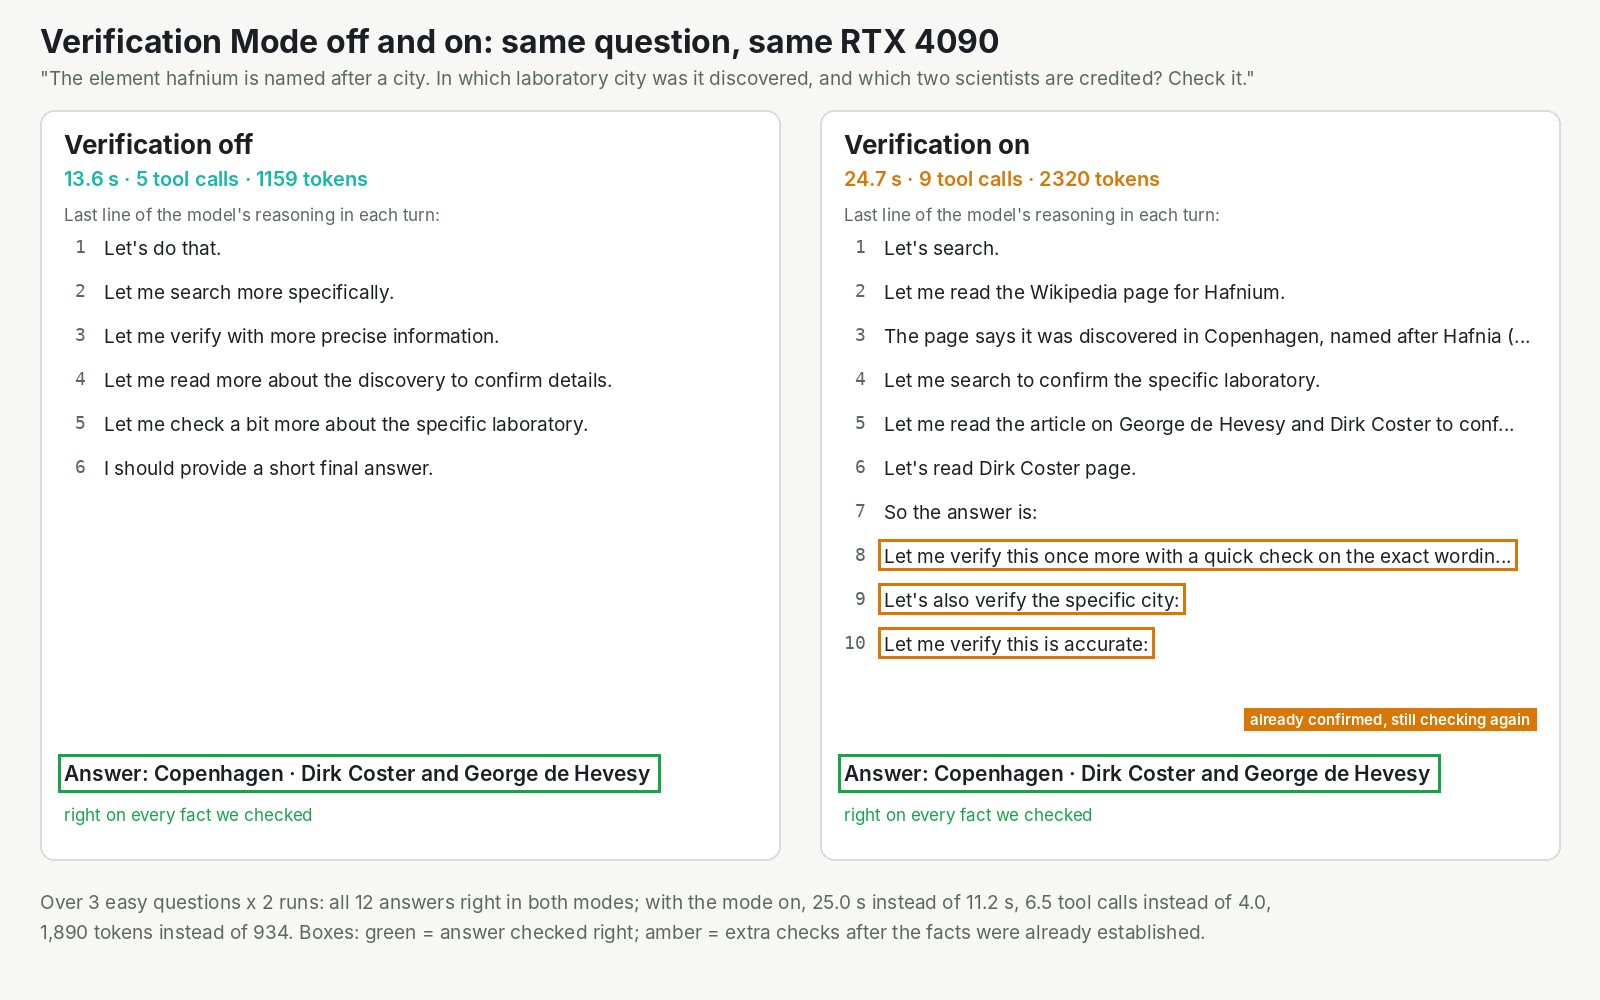
L'image montre une même question posée deux fois sur la même carte : dans quelle ville le hafnium a-t-il été découvert, et par qui. Les deux exécutions ont répondu juste, et celle avec le mode activé a continué de vérifier des faits qu'elle avait déjà lus.
| Ce que vous voulez savoir | Ce que nous avons mesuré |
|---|---|
| Plus petite carte qui l'a fait tourner à pleine vitesse | une RTX 4090, 24 GB |
| Verification Mode sur des questions faciles | mêmes réponses, 2,2 fois plus de temps, deux fois plus de tokens |
35 milliards de paramètres, 3 milliards éveillés pour chaque mot
Sage-A1.5 est gros sur le disque et petit en mouvement, et c'est pour cela qu'une seule carte gaming peut le servir. C'est un modèle mixture-of-experts. Imaginez une équipe de 256 spécialistes, plus un généraliste toujours présent dans la pièce. Pour chaque mot qu'il écrit, le modèle consulte 8 spécialistes. Les autres attendent. Ainsi, sur 35 milliards de paramètres, seuls environ 3 milliards travaillent à chaque étape, selon la page du projet. La vitesse suit les 3 milliards, et la facture mémoire suit les 35.
Le modèle est réentraîné à partir de deux autres : le modèle ouvert 35B de l'équipe Qwen et Agents-A1, l'agent précédent du laboratoire lui-même, publié en juin. Le papier, signé par Wenjie Lou et 98 co-auteurs, a été mis en ligne le 20 octobre. Le modèle complet et le fichier compressé, environ 22 GB, sont tous deux sous Apache-2.0 : utilisables commercialement et téléchargeables sans formulaire. Un petit fichier en plus permet au modèle de lire des images, et deux modes que vous activez vous-même en font un agent :
- Agentic Orchestration. Vous donnez au modèle un outil qui distribue des tâches. Le modèle découpe alors une question en tâches et confie chacune à un sous-agent, qui cherche et lit de son côté, puis fait son rapport. C'est un chercheur principal qui envoie trois assistants à la bibliothèque en même temps.
- Verification Mode. Une ligne ajoutée aux instructions du modèle lui dit de vérifier son propre travail avant de répondre. Les auteurs disent qu'il n'a besoin de rien d'autre d'installé.
Les scores des auteurs viennent du modèle non compressé et n'ont pas été reproduits ici
Sur BrowseComp, qui demande des faits difficiles à trouver sur le web, les auteurs annoncent 81,7 sur 100, contre 91,2 pour Kimi-K3, le meilleur modèle de leur tableau. Dans un test séparé, mode activé contre désactivé, sur les 1 266 questions de BrowseComp, Verification Mode a fait passer le score de 72,5 % à 82,9 %. Nous ne pouvons pas dire si le 81,7 inclut déjà ce gain. Leurs autres scores sont en annexe.
Notre test : une RTX 4090, le fichier des auteurs, nos propres questions
La limite d'abord : une poignée de questions faciles, appuyées sur Wikipédia, sur une seule carte, un agent à la fois. Cela vérifie la mécanique (appels d'outils, distribution des tâches, retour des réponses), pas l'étendue de ses capacités de recherche.
Nous avons servi le fichier compressé des auteurs avec llama.cpp, le logiciel ouvert qui fait tourner des modèles sur une seule machine, sur une RTX 4090 de notre cloud. Nous avons utilisé les réglages recommandés par les auteurs. Toutes les requêtes sont passées par notre plateforme, comme une application l'appellerait, et nous avons aussi vérifié la vitesse directement contre llama.cpp.
Les questions étaient les nôtres. Chacune demandait quelques faits tirés de Wikipédia : qui a découvert le rhénium et où, d'après quelle ville le hafnium a été nommé, quand le technétium a été trouvé. Le modèle cherchait et lisait des pages en direct au moyen de deux outils que nous avons écrits. Pour l'orchestration, nous avons posé une seule question, exécutée trois fois : combien d'années se sont écoulées entre les découvertes de trois éléments, de sorte que chaque sous-agent en prenne un.
Environ 136 tokens par seconde, et une question de recherche juste dans les trois exécutions
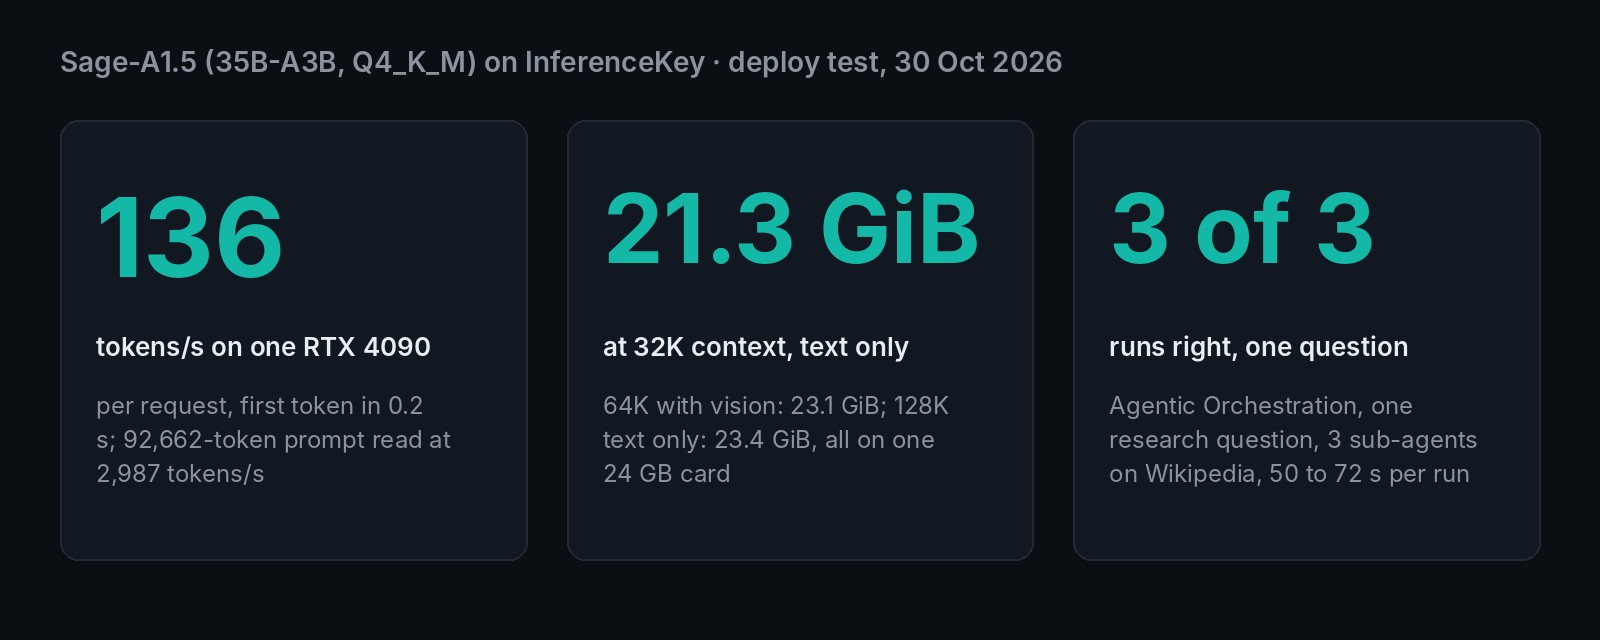
Sur une RTX 4090, le modèle a écrit environ 136 tokens par seconde pour une requête, et le premier token est arrivé en un quart de seconde environ. Passer par notre plateforme n'a ajouté aucun délai mesurable : llama.cpp seul a donné la même vitesse. Une réponse de 1 489 tokens a pris environ 11 secondes.
Il lit aussi vite les longs prompts. Nous avons caché une étiquette inventée, 7342-ORCHID, dans un prompt de 92 662 tokens, à peu près la longueur d'un roman. Le modèle a tout lu en 31 secondes et a trouvé l'étiquette.
La question de recherche est revenue juste à chaque fois que nous l'avons posée. Dans chacune des trois exécutions de test, le modèle a distribué trois tâches à la fois, une par élément. Les trois sous-agents ont cherché sur Wikipédia et ont renvoyé leurs résultats. Le modèle principal a ensuite écrit la réponse : hafnium en 1923, rhénium en 1925, technétium en 1937, 14 ans entre le premier et le dernier. Chaque appel d'outil est sorti exactement au format dont notre code avait besoin pour l'exécuter. Un test plus simple avec un seul appel de recherche est revenu propre 3 fois sur 3, en moins d'une seconde à chaque fois.
Le temps dépend de la possibilité pour les sous-agents de tourner côte à côte, et le réglage par défaut de notre plateforme les met en file d'attente. Après un déploiement, elle envoie au modèle une requête à la fois, donc les trois sous-agents ont attendu leur tour et l'exécution a pris 72,0 secondes. Un appel d'API a monté la limite à deux, et les exécutions ont alors pris 50 et 56 secondes. Statut : le réglage par défaut est toujours à un, et l'appel est en annexe.
La partie vision fonctionne aussi. Nous lui avons montré le propre graphique de benchmarks des auteurs et demandé une valeur. Il a lu 80,0 sur la bonne barre, et 50,0 comme le meilleur des modèles plus grands, les deux corrects.
Le piège, c'est le temps qu'il passe à réfléchir. Ce modèle raisonne longuement avant de répondre. Une définition en deux phrases a pris 14,4 secondes, parce qu'il a d'abord raisonné sur 1 905 tokens. Même 17 x 23 a demandé 336 tokens de raisonnement. À 136 tokens par seconde, cela convient à une tâche de recherche, et c'est lent pour une fenêtre de chat.
Verification Mode a doublé le travail sur les questions faciles et n'a changé aucune réponse
Sur nos questions faciles, Verification Mode n'a rien apporté de mesurable. Les 12 réponses étaient justes avec le mode désactivé comme avec le mode activé.
| Désactivé | Activé | |
|---|---|---|
| Réponses justes | 6 sur 6 | 6 sur 6 |
| Temps moyen | 11,2 s | 25,0 s |
| Appels d'outils en moyenne | 4,0 | 6,5 |
| Tokens écrits en moyenne | 934 | 1 890 |
Le travail en plus était surtout de la répétition. Avec le mode activé, le raisonnement s'est rempli de tours "Let me verify" alors que les faits étaient déjà confirmés. L'écart a varié : dans l'autre exécution sur le hafnium, le mode activé a fait un appel d'outil de moins que le mode désactivé. Une exécution a pris 52,7 secondes parce qu'une recherche Wikipédia a expiré et que le modèle a réessayé.
Cela ne contredit pas les auteurs. Leur gain est venu sur BrowseComp, où les faits sont difficiles à trouver et où une première piste fausse est fréquente.
Quel GPU : une vraie carte de 24 GB à pleine vitesse, environ un cinquième de la vitesse ou moins en dessous
La plus petite carte qui a fait tourner Sage-A1.5 à pleine vitesse était une vraie RTX 4090 de 24 GB. Avec les réglages de notre exemple, de la place pour 32 768 tokens de conversation et deux requêtes à la fois, il a utilisé 21,3 des 23,5 GiB de la carte. La configuration de la fiche du modèle, 64K tokens avec la vision, a culminé à 23,1 GiB. 128K tokens, texte seul, a culminé à 23,4 GiB, ce qui laisse la carte presque pleine. Toutes ces configurations ont tenu, sans perte de vitesse.
En dessous de 24 GB, le modèle ne tourne que si une partie passe dans la mémoire principale de l'ordinateur. Llama.cpp peut y garer certains spécialistes et laisser le processeur les exécuter, ce qui est beaucoup plus lent. Nous avons simulé des cartes plus petites sur la même 4090, en sortant des spécialistes jusqu'à ce que la mémoire de la carte reste sous chaque limite.
- 16 GB simulés : 14,4 GiB sur la carte, environ 5,6 fois plus lent, et la question de recherche est encore revenue juste en 98 secondes.
- 12 GB simulés : 10,8 GiB sur la carte, et la question est revenue juste en 93 secondes.
- 8 GB simulés : 3,0 GiB avec tous les spécialistes en mémoire principale. Une exécution de recherche sur deux a épuisé sa limite de 12 étapes au bout de 270 secondes sans réponse. La nouvelle tentative a été juste.
- Pas essayé : de vraies cartes de 16 et 12 GB, la RTX 3090, les cartes de 32 GB, le modèle non compressé.
Les vitesses simulées dépendent du processeur et de la mémoire de l'ordinateur, prenez-les donc comme une tendance, pas comme une promesse. Les réglages plus petits demandent aussi de la mémoire principale libre pour les spécialistes garés, jusqu'à environ 17 GB quand ils y passent tous.
Sur InferenceKey : prêt en 104 secondes, après une correction de la commande de la fiche du modèle
Un modèle d'agent 35B ne devrait pas avoir besoin d'un moteur sur mesure, et celui-ci n'en a pas eu besoin. Entre l'appel de déploiement et le service, il s'est écoulé 104,1 secondes, avec la version de llama.cpp que notre plateforme livre déjà : télécharger le fichier de 21,7 GB, le charger, répondre. Notre plateforme fait tourner un modèle sur un worker, une machine GPU que vous possédez ou louez et que vous y connectez, et son llama.cpp par défaut a chargé Sage-A1.5 sans modification. La première fois sur une machine neuve, llama.cpp doit aussi être compilé pour la carte, ce qui a pris dix minutes et demie. Ensuite, un redémarrage prend de 4 à 7 secondes.
Le seul problème sur lequel vous tomberez est dans la fiche du modèle elle-même. Sa commande llama.cpp utilise un réglage de raisonnement appelé deepthink, que llama.cpp n'a pas. Le serveur s'arrête au démarrage avec "Unknown reasoning format: deepthink". Nous avons aussi vérifié une version bien plus récente de llama.cpp, et il n'y existe toujours pas. La correction consiste à écrire deepseek à la place. Statut : corrigé dans notre exemple, toujours présent dans la fiche des auteurs.
Un second manque est de notre côté. Les auteurs activent Verification Mode avec un réglage que notre plateforme ne transmet pas encore au modèle. Notre exemple ajoute à la place la même ligne d'activation aux instructions du modèle. Nous avons vérifié que le modèle voit exactement le même prompt dans les deux cas. Statut : ouvert de notre côté, contourné dans l'exemple.
Faut-il l'essayer ? Oui sur une carte de 24 GB : la mécanique d'agent a fonctionné
- Si vous voulez un agent qui cherche, lit et rend compte sur votre propre matériel, essayez-le.
- Si la justesse sur les questions difficiles compte pour vous, testez Verification Mode sur vos propres cas difficiles.
- Si vous avez besoin de réponses de chat rapides, cherchez ailleurs. Il réfléchit sur des centaines ou des milliers de tokens avant des réponses courtes.
- Si votre carte a 16 GB ou moins, attendez-vous à une fraction de la vitesse, et seulement avec beaucoup de mémoire principale.
Pour poser à Sage-A1.5 la même question de recherche sur votre propre carte, avec des sous-agents et avec Verification Mode désactivé puis activé, lancez python main.py depuis l'exemple Sage-A1.5 du SDK. Il faut un projet InferenceKey avec un token SDK et une clé d'API, et un worker NVIDIA privé de 24 GB ou plus. Il supprime le déploiement quand il a fini.
Pour les ingénieurs
Crédits
- Sage-A1.5 : Shanghai AI Laboratory (l'organisation InternScience sur Hugging Face, publié sous le nom Alpha-Innovator sur la page du projet), papier de Wenjie Lou et 98 co-auteurs, arXiv 2610.28578. Ils ont entraîné le modèle, construit les deux modes, publié les poids BF16, le GGUF Q4_K_M officiel et le projecteur de vision sous Apache-2.0, et enregistré une démo llama.cpp sur Mac sur la page du projet.
- Modèles de base : Qwen3.6-35B-A3B de l'équipe Qwen, et Agents-A1, l'agent précédent des auteurs (open source depuis le 2026-06-26, 35B-A3B, Apache-2.0).
- Service : le projet llama.cpp.
- Données de nos questions : Wikipédia, via son API publique.
- Où nous l'avons repéré : la vidéo d'actualités d'AI Search du 2026-10-25 (segment Sage-A1.5 à 36:10).
- Notre part : le déploiement à travers la plateforme, les questions et les outils, les mesures, l'échelle de VRAM, l'exemple du SDK et la vidéo de démo.
Modèle et fichiers
InternScience/Sage-A1.5-Q4_K_M-GGUF, sha10b179b52f2c841030db327627e707d076b4c8cf, créé le 2026-10-21, dernière modification le 2026-10-22, Apache-2.0, sans accès restreint.Sage-A1.5-Q4_K_M.gguf: 21 713 463 520 B ("MoE weights + built-in MTP layer"), arch GGUFqwen35moe. Environ 5 bits par paramètre en moyenne pour environ 35B paramètres, à peu près un tiers de la taille du dépôt BF16.Sage-A1.5-mmproj.gguf: 899 282 880 B. Ensemble, environ 22,6 GB.
InternScience/Sage-A1.5(BF16), sha0e3205cf, créé le 2026-10-15, dernière modification le 2026-10-22 : 14 shards safetensors d'environ 5,37 GB plusmodel-mtp.safetensorsde 1,69 GB, environ 72 GB.Qwen3_5MoeForConditionalGeneration: 40 couches (30 à attention linéaire, 10 à attention complète), 256 experts, 8 par token plus un expert partagé, hidden 2048, 1 couche MTP, tour de vision de 27 couches,max_position_embeddings262 144. 35B au total, environ 3B actifs par token (page du projet).- Note mémoire de la fiche : "~20.2 GiB for the Q4_K_M weights plus ~0.84 GiB for the projector, plus the KV cache... A single 24 GB GPU comfortably serves the model at moderate context lengths".
- Échantillonnage recommandé : temperature 1.0, top_p 0.95, top_k 20, min_p 0.0, presence_penalty 1.5, repetition_penalty 1.0.
Benchmarks des auteurs (BF16, non reproduits)
| Benchmark | Sage-A1.5 | Autres modèles du tableau des auteurs |
|---|---|---|
| GAIA | 95,1 | Agents-A1 96,0, Kimi-K3 92,2, GLM-5.3 92,2, GPT-5.6-sol 88,3 |
| BrowseComp | 81,7 (82,8 avec orchestration) | Kimi-K3 91,2, GPT-5.6-sol 90,4, GLM-5.3 76,2, Agents-A1 75,5, Qwen3.6-35B-A3B 67,9 |
| SWE-bench Pro | 61,2 | GPT-5.6-sol 64,6, GLM-5.3 64,6, Kimi-K3 63,3, Ornith-1.5 59,6, Qwen3.6-35B-A3B 49,5, Agents-A1 43,6 |
| HLE avec outils | 55,1 | GPT-5.6-sol 64,5 |
| IFBench | 81,6 | |
| FrontierScience-Research | 48,3 | |
| CMT | 80,0 | meilleur modèle plus grand 50,0 |
La fiche dit que la quantification Q4_K_M "trades a small amount of accuracy". SWE-bench Pro a utilisé le harness mini-SWE-agent, température 1.0, top-p 0.95, contexte de 200K, hors ligne. Sur GAIA, le prédécesseur Agents-A1 (96,0) obtient un meilleur score que Sage-A1.5 (95,1) dans le propre tableau des auteurs. Les modèles phares actuels (Claude Opus 5.5, GPT-6.1 Sol) ne figurent pas dans le tableau.
Installation
- Une RTX 4090 24 GB (24 080 MiB) sur notre cloud (InferenceKey Cloud), limite de puissance de 203 W (450 W d'origine), AMD EPYC 7402, driver 580.142, une image de conteneur CUDA 13.
- Backend
llamacppintégré, tag llama.cppb9748(la version fixée par défaut du worker, sans surcharge). Il contient déjàLLM_ARCH_QWEN35MOE. - Un manager InferenceKey local (depuis
origin/main9e53fe57) a amorcé le worker. La production n'a pas été touchée. - Requêtes en streaming à travers l'endpoint compatible OpenAI sauf mention contraire. Vitesse recoupée directement contre llama-server.
Pas à pas avec l'exemple du SDK
- Clonez inferencekey-sdk et ouvrez
examples/sage-a1-5-research-agent-llamacpp-private-nvidia/(commit3c5cc178). - Compilez le binding Python en local avec maturin et installez
requests>=2.31(requirements.txt). - Copiez
.env.examplevers.envet renseignezINFERENCEKEY_SDK_TOKEN,INFERENCEKEY_API_KEY,INFERENCEKEY_PROJECTetIK_WORKER_ID(un worker NVIDIA privé de 24 GB ou plus). Optionnel :IK_KEEP_ALIVE=1garde le déploiement,SAGE_CONTEXTchange le contexte (32768 par défaut ; 65536 et 131072 tiennent sur 24 GB en texte seul). - Lancez
python main.py. Le déroulé :ensure()d'un workloadllamacppfixe sur votre worker,wait_until_ready(3600), une question simple avecgenerate_text()(max_tokens16 384), Agentic Orchestration, Verification Mode désactivé puis activé, réponses dansoutputs/answers.json, puisdelete()sauf siIK_KEEP_ALIVE=1. - Le script exécute les outils (
wiki_search,read_page) de votre côté contre l'API publique de Wikipédia, jusqu'à 5 sous-agents dans des threads parallèles. La machine qui le lance a besoin d'un accès à internet.
La commande que l'exemple déploie :
llama-server -hf InternScience/Sage-A1.5-Q4_K_M-GGUF --hf-file Sage-A1.5-Q4_K_M.gguf \
  --no-mmproj --alias sage-a1.5 -ngl 99 -fa on -c 32768 -np 2 --kv-unified \
  --jinja --reasoning-format deepseek \
  --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0 --presence-penalty 1.5
Pour des sous-agents en parallèle, montez le max_in_flight de l'affectation de 1 à 2 avec PATCH /api/projects/<pid>/assignments/<workload>/<worker>.
Verification Mode à travers notre endpoint (le déclencheur exact du template, "protocol" en minuscules) :
system = "You are a careful research assistant." + "\n\nVerification protocol: enabled"
Directement contre llama-server, l'interrupteur documenté fonctionne : chat_template_kwargs={"verification": true}, avec un message système non vide et un booléen JSON (sinon le template renvoie un HTTP 400).
Délais
- Compilation CUDA de llama.cpp
b9748(arch 89, 46 jobs) : 10 min 33 s. - De
ensure()à prêt, llama.cpp déjà compilé : 104,1 s (téléchargement de 21,7 GB et chargement). - Redémarrages à chaud de llama-server : 4 à 7 s.
Vitesse (streaming, une requête, échantillonnage des auteurs)
| Chemin | Prompt | Tokens | Premier token | Décodage |
|---|---|---|---|---|
| Endpoint | essai de 300 mots | 1 489 / 1 827 | 0,22 / 0,26 s | 137,5 / 135,0 tok/s |
| Endpoint | "capital of Australia, one word" | 118 / 125 | 0,32 / 0,24 s | 129,4 / 130,7 tok/s |
| llama-server en direct | essai | 1 525 / 3 297 | 0,27 / 0,36 s | 134,0 / 135,3 tok/s |
| En direct, config 128K | prompt aiguille de 92 662 tokens | 110 | prefill 2 987 tok/s (31,0 s), décodage 99,6 tok/s, "7342-ORCHID" trouvé | |
| En direct, 64K + mmproj | graphique des auteurs + question (2 124 tokens de prompt) | 1 628 | prefill 1,66 s, 131,7 tok/s, réponse juste |
Pendant le décodage : environ 66 % d'utilisation du GPU et environ 175 W sur le plafond de 203 W, donc la carte est restée sous son plafond. Une 4090 sans plafond n'a pas été mesurée.
Appels d'outils et modes
- Appel d'outil unique : 3 sur 3, un appel
wiki_searchavec des arguments JSON valides, de 0,87 à 0,98 s. Pas testé : beaucoup d'outils à la fois ni des schémas d'arguments imbriqués. - Orchestration (le modèle principal n'a que
spawn_subagent, les sous-agents ontwiki_searchetread_page, et renvoient{answer, status, evidence, unresolved_issues}), une question en trois parties (années entre les découvertes du hafnium, du rhénium et du technétium) : 3 exécutions de test sur 3 justes, plus la prise enregistrée pour la vidéo, juste aussi, donc 4 sur 4 au total. L'image de synthèse compte les 3 exécutions de test. Unspawn_subagentavec 3 tâches par exécution. 72,0 s avecmax_in_flightà 1 (tours des sous-agents 9/7/3), 49,7 s (4/4/7) et 55,7 s (3/6/11) avec 2, prise enregistrée 48,3 s. Un sous-agent a fait 9 appels d'outils pour le hafnium parce que les sources hésitent entre 1922 et 1923. - Vérification, 3 questions (rhénium, hafnium, technétium) x 2 exécutions x désactivé/activé :
| Mode | Exécutions | Moyenne s | Appels d'outils en moyenne | Tokens de complétion en moyenne | Caractères de raisonnement en moyenne | Justes |
|---|---|---|---|---|---|---|
| désactivé | 6 | 11,2 | 4,0 | 934 | 2 778 | 6/6 |
| activé | 6 | 25,0 | 6,5 | 1 890 | 5 662 | 6/6 |
Tours en moyenne : 5,0 désactivé, 7,5 activé. La dispersion est large : l'exécution sur le hafnium de l'image clé est passée de 5 à 9 appels d'outils (de 13,6 s à 24,7 s), tandis que l'autre exécution sur le hafnium a fait 6 appels d'outils activé contre 7 désactivé (15,9 s contre 15,5 s).
Nous n'avons pas vu la revue structurée "ce qui est établi, ce qui a échoué" du texte de démo des auteurs. Les tours en plus étaient de simples revérifications.
Échelle de VRAM
Pic de VRAM par nvidia-smi toutes les 1 s. Le texte principal les donne en GiB (21 760 MiB font environ 21,3 GiB ; 24 080 MiB sur la carte, 23,5 GiB, moins 23 920 MiB à 128K laissent 160 MiB). Plafonds émulés sur la même 4090 en déplaçant les experts de N couches vers la RAM système (--n-cpu-moe, 24 threads CPU). Vérification de l'agent : la question sur le rhénium, vérification désactivée, budget de 12 tours.
| GPU ou plafond | Config | Pic de VRAM | Vitesse | Sortie OK | Réel ou émulé |
|---|---|---|---|---|---|
| RTX 4090 24 GB | -c 32768 -np 2 --kv-unified, texte seul, à travers la plateforme | 21 760 MiB | 135 à 137 tok/s ; orchestration 48 à 56 s | oui | réel |
| RTX 4090 24 GB | -c 65536 --mmproj, -fit off | 23 684 MiB | 138 tok/s ; agent 22,3 s | oui, graphique bien lu | réel |
| RTX 4090 24 GB | -c 131072 texte seul, -fit off | 23 920 MiB | 137 à 139 tok/s ; agent 25,6 s | oui, aiguille de 92,7K trouvée | réel |
| Plafond de 16 GB | -c 32768 -np 2 --n-cpu-moe 16 | 14 708 MiB | 23,9 à 25,0 tok/s ; agent 98,0 s | oui (environ 5,6x plus lent) | émulé |
| Plafond de 12 GB | --n-cpu-moe 24 | 11 052 MiB | 12,9 à 18,1 tok/s ; agent 92,8 s | oui | émulé |
| Plafond de 8 GB | --cpu-moe | 3 048 MiB | 14,1 à 14,9 tok/s ; agent 270,2 s, pas de réponse, nouvelle tentative juste en 104,1 s | partiel, 1 sur 2 | émulé |
| RTX 4090 24 GB | --spec-type draft-mtp -md <same GGUF> | non : failed to allocate CUDA0 buffer of size 21416407552 | réel |
--cpu-moe demande environ 17 GB de poids en RAM système. Pas essayé : de vraies cartes de 16 et 12 GB (aucune en stock sur notre cloud : 4080, 4080 SUPER, 5080, A4000, 2000 Ada, 4070 Ti, 3080 Ti), la RTX 3090 (la seule machine obtenue n'avait pas de SSH direct et a été arrêtée), les cartes de 32 GB, les poids BF16 avec vLLM, d'autres quantifications.
Problèmes et statut
--reasoning-format deepthinkdans la fiche du modèle : llama-server s'arrête avec "Unknown reasoning format: deepthink". Les valeurs valides dansb9748sontnone|deepseek|deepseek-legacy|auto, etb12000(2026-10-30) n'a toujours pasdeepthink. Corrigé dans l'exemple avecdeepseek.- L'endpoint laisse tomber
chat_template_kwargs,top_ketmin_p.ChatCompletionRequestne les transporte pas. À travers l'endpoint,{"verification": "maybe"}et{"verification": true}sans message système renvoient tous deux 200, donc les kwargs n'atteignent jamais le template. Contournement : la ligne de déclenchement dans le message système, identique à l'octet près sur/apply-templateavec et sans outils. Ouvert. - L'endpoint sans streaming laisse tomber
reasoning_contentquandcontentest rempli. Avecmax_tokensà 4 096, la première question simple a renvoyé 4 096 tokens de "Thinking Process:" en 30,7 s. L'exemple demande 16 384 (alors 14,4 s, 1 905 tokens) et passe les boucles d'agent en streaming. - Compilation de llama.cpp sur le worker : "No CMAKE_CUDA_COMPILER could be found", parce que
nvcc(13.0.88,/usr/local/cuda/bin) n'est pas dans lePATHde l'image de conteneur du worker. Contourné avecCUDACXX,PATHetCMAKE_BUILD_PARALLEL_LEVELdans l'env du worker. Statut : ouvert dans le produit, pas encore suivi. wait_until_ready()reste bloqué sur un workload fixe qui sert déjà :worker_leasesest vide pour l'affectation fixe privée, et la vérification de disponibilité ne lit que les leases Ready actifs. Statut : bug produit ouvert, pas encore suivi.max_in_flightvaut 1 aprèsensure(), donc les sous-agents font la queue. Monté à 2 avec le PATCH ci-dessus. Statut : ouvert, le réglage par défaut est toujours à 1.- L'URL NATS locale valait
tls://par défaut alors que le nats-proxy local avait TLS désactivé. Corrigé avec un réglagenats://et une réinstallation du worker. Concerne uniquement l'installation de test locale. - MTP (la couche intégrée qui devine plusieurs tokens à la fois) depuis le même GGUF :
--spec-type draft-mtp -md <same GGUF>charge le fichier une seconde fois et manque de mémoire sur 24 GB avecb9748. - Une machine RTX 3090 a démarré sans SSH direct pendant 180 s et le manager l'a arrêtée.
- Incohérences de la fiche et de la page : les extraits de service de la page du projet nomment
Alpha-Innovator/Agents-A1.5(le dépôt estInternScience/Sage-A1.5), et elle écrit le déclencheur "Verification Protocol" alors que le template utilise "protocol". Nous avons utilisé la chaîne du template. La trace de la démo Mac des auteurs n'a aucun log de matériel, de quantification ni de débit, comme ils le disent eux-mêmes.
Vidéo de démo
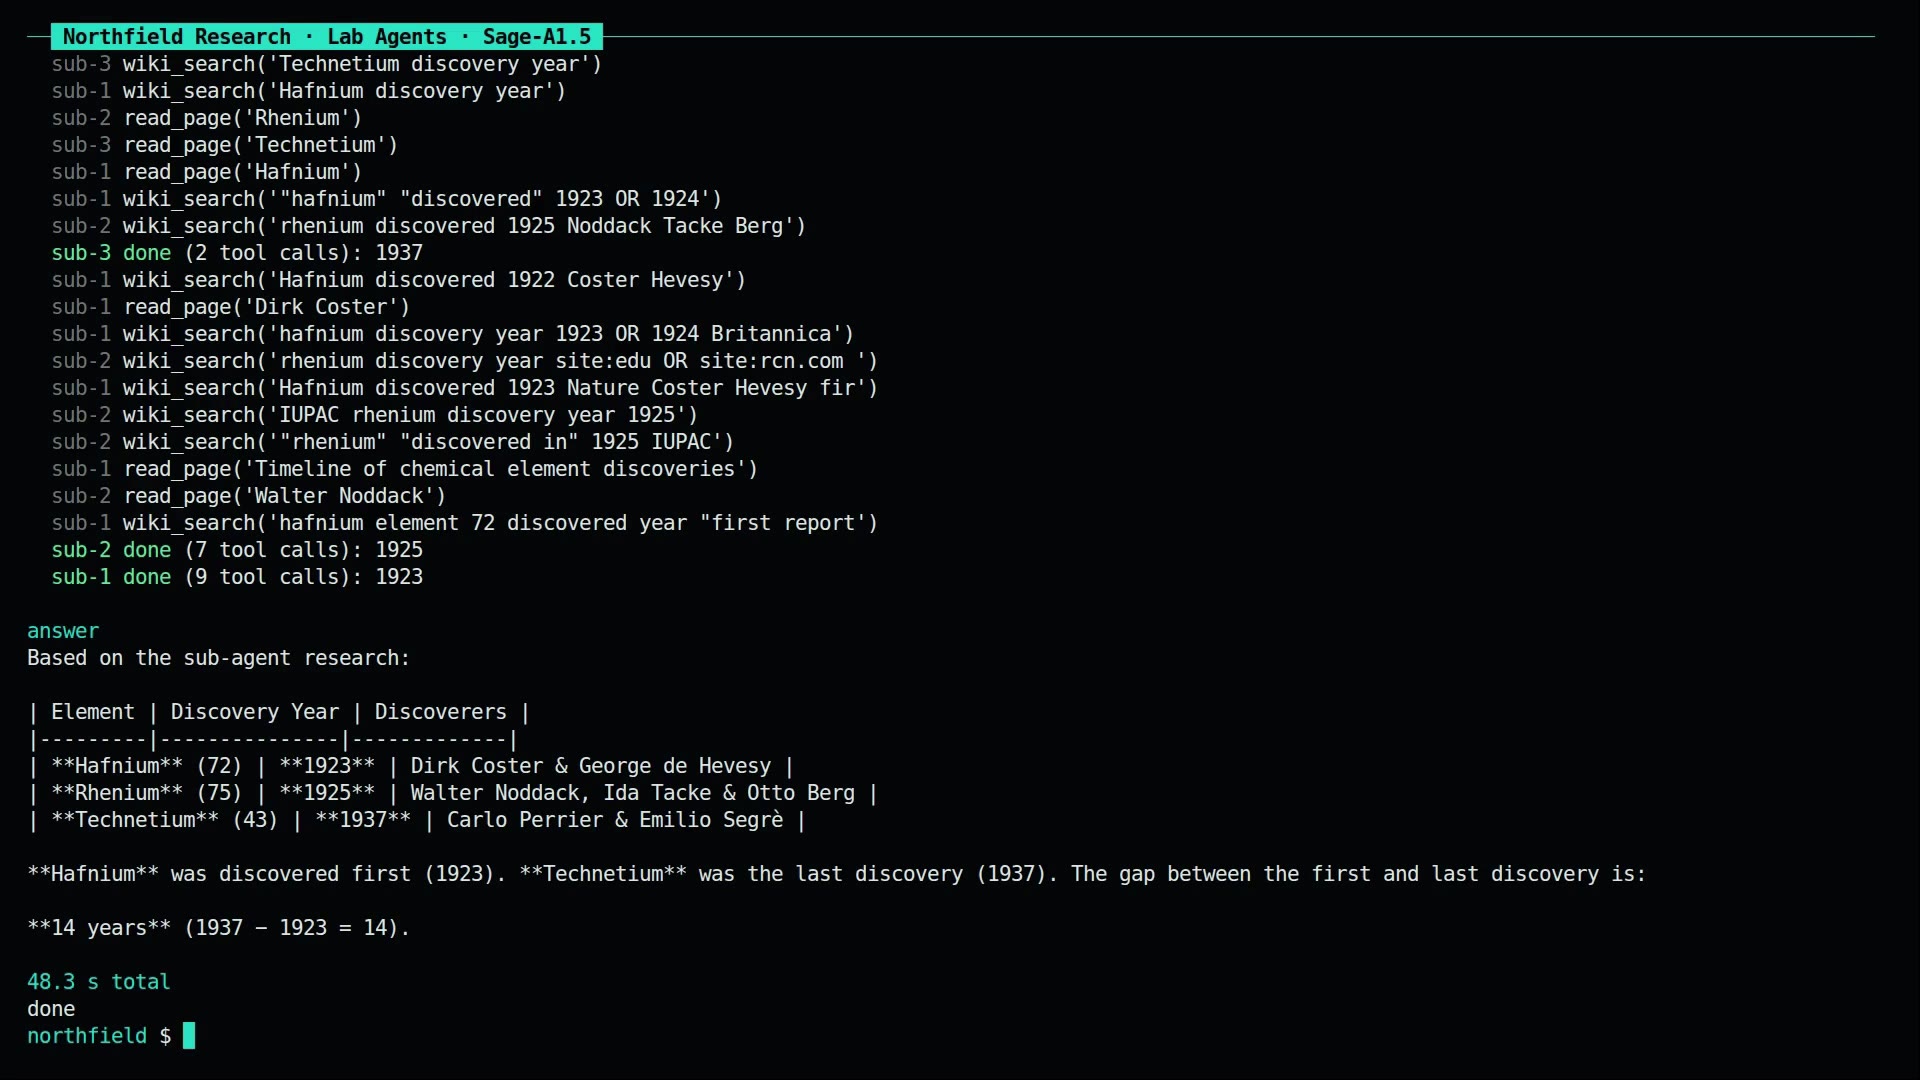
160,6 s, 1920x1080. Elle comprend un extrait de la démo llama.cpp sur Mac des auteurs, crédité à l'équipe Sage-A1.5, et leur tableau de benchmarks, attribué et signalé comme non reproduit par nous.
Sources
- Fiche du modèle, BF16 : https://huggingface.co/InternScience/Sage-A1.5
- Fiche du modèle, GGUF Q4_K_M : https://huggingface.co/InternScience/Sage-A1.5-Q4_K_M-GGUF
- Papier : https://arxiv.org/abs/2610.28578
- Page du projet : https://alpha-innovator.github.io/Sage-A1.5/
- Prédécesseur : https://github.com/InternScience/Agents-A1
- Exemple du SDK : https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/sage-a1-5-research-agent-llamacpp-private-nvidia
- Où nous l'avons repéré : https://www.youtube.com/watch?v=EfyQOAJjx1A