Sage-A1.5 auf einer 24-GB-Karte: 136 Tokens/s und ein Prüfmodus, der bei einfachen Fragen die Arbeit verdoppelt
35B-Rechercheagent des Shanghai AI Lab auf einer RTX 4090: 136 Tokens/s, Recherchefrage 3 von 3 Mal richtig, Prüfmodus bei leichten Fragen halb so schnell.
Fünfunddreißig Milliarden Parameter auf der Platte, etwa drei Milliarden davon arbeiten für jedes Wort. Diese Lücke ist der Grund, warum Sage-A1.5, ein offener Recherche-Agent vom Shanghai AI Laboratory, auf eine einzige Gaming-Karte passt. Wir haben die komprimierte Datei der Autoren auf einer RTX 4090 betrieben, einer Gaming-Karte mit 24 GB, in unserer Cloud (InferenceKey Cloud), mit unveränderter Open-Source-Software. Die Agent-Mechanik hat dort funktioniert: Das Modell hat Aufgaben verteilt, unseren Code um Suchen gebeten und geantwortet. Es schrieb etwa 136 Tokens pro Sekunde, eine lange Antwort in 11 Sekunden, und hat unsere eine dreiteilige Recherchefrage in allen drei Testläufen richtig beantwortet. Sein neuer Verification Mode, der es seine eigene Arbeit prüfen lässt, lieferte bei einfachen Fragen dieselben richtigen Antworten, brauchte aber das 2,2-Fache der Zeit und doppelt so viele Tokens. Das Modell läuft auf einem GPU-Worker, den du kontrollierst, und die Tools laufen in deinem eigenen Code. Lass den Prüfmodus bei einfachen Nachschlagefragen aus und teste ihn an deinen schweren Fällen.
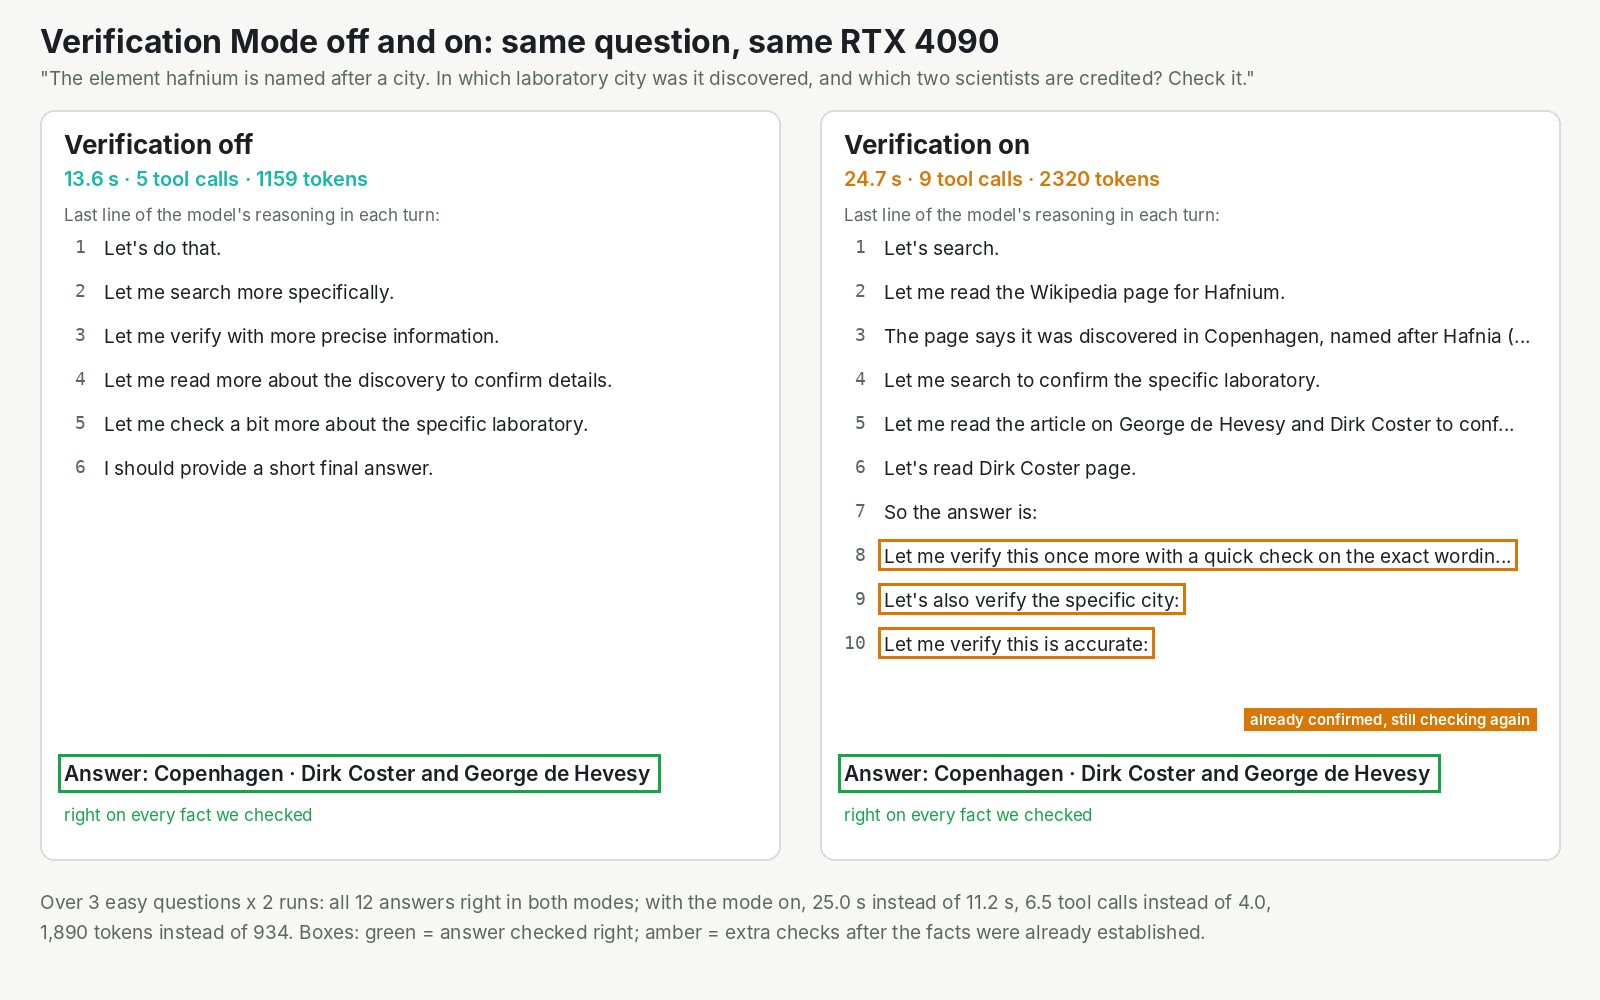
Das Bild zeigt eine Frage, zweimal auf derselben Karte gestellt: In welcher Stadt wurde Hafnium entdeckt, und von wem? Beide Läufe hatten sie richtig, und der Lauf mit eingeschaltetem Modus hat weiter Fakten geprüft, die er schon gelesen hatte.
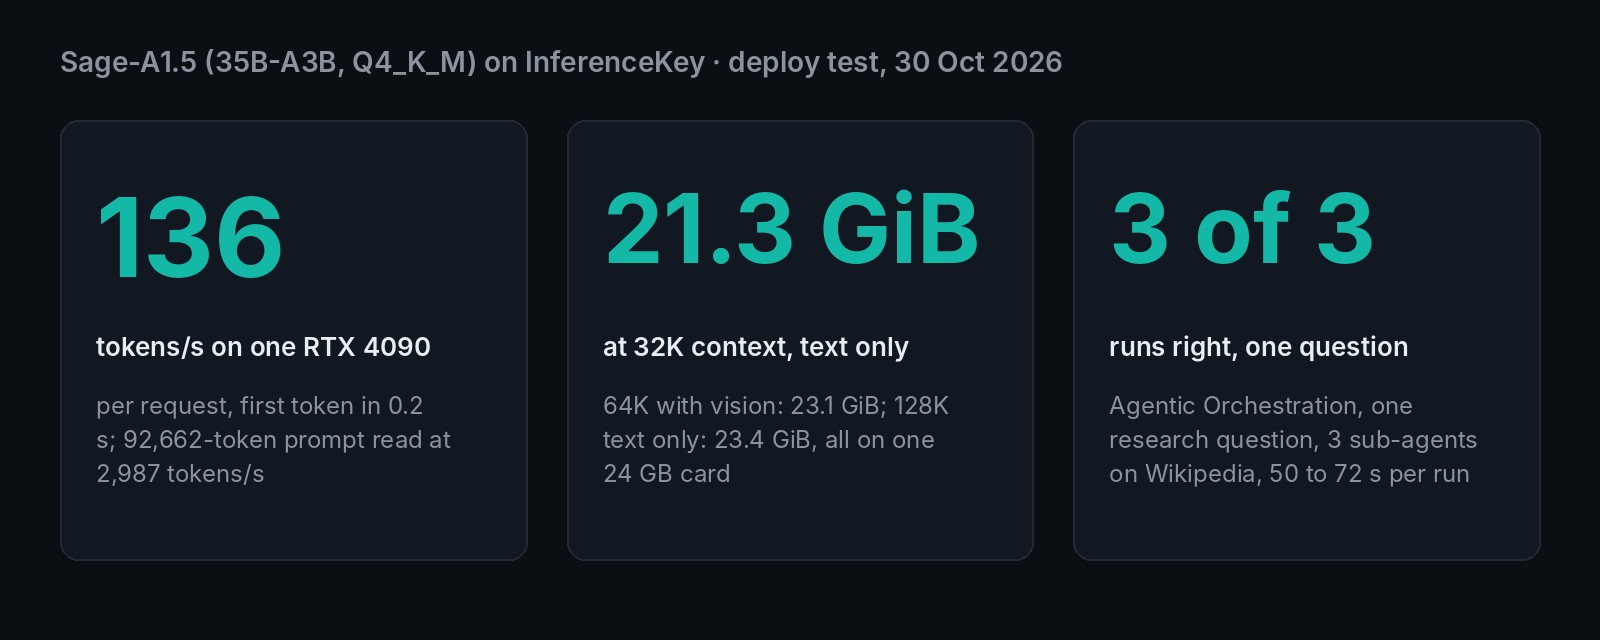
| Was du wissen willst | Was wir gemessen haben |
|---|---|
| Kleinste Karte, auf der es mit vollem Tempo lief | eine RTX 4090, 24 GB |
| Verification Mode bei einfachen Fragen | dieselben Antworten, das 2,2-Fache der Zeit, doppelt so viele Tokens |
35 Milliarden Parameter, 3 Milliarden wach für jedes Wort
Sage-A1.5 ist groß auf der Platte und klein in Bewegung, und deshalb kann eine Gaming-Karte es bedienen. Es ist ein Mixture-of-Experts-Modell. Stell dir ein Team aus 256 Spezialisten vor, dazu einen Generalisten, der immer im Raum ist. Für jedes Wort, das es schreibt, zieht das Modell 8 Spezialisten hinzu. Die anderen warten. Von 35 Milliarden Parametern arbeiten also bei jedem Schritt nur etwa 3 Milliarden, laut der Projektseite. Das Tempo richtet sich nach den 3 Milliarden, die Speicherrechnung nach den 35.
Das Modell ist aus zwei anderen nachtrainiert: dem offenen 35B-Modell des Qwen-Teams und Agents-A1, dem früheren Agenten des Labors selbst, im Juni veröffentlicht. Das Paper von Wenjie Lou und 98 Co-Autoren erschien am 20. Oktober. Das vollständige Modell und die komprimierte Datei mit etwa 22 GB stehen beide unter Apache-2.0: kommerziell frei nutzbar und ohne Formular herunterladbar. Eine kleine Zusatzdatei lässt das Modell Bilder lesen, und zwei Modi, die du selbst einschaltest, machen es zum Agenten:
- Agentic Orchestration. Du gibst dem Modell ein Tool, das Aufgaben verteilt. Das Modell zerlegt dann eine Frage in Aufgaben und gibt jede an einen Sub-Agenten, der selbstständig sucht und liest und dann berichtet. Wie eine leitende Forscherin, die drei Assistenten gleichzeitig in die Bibliothek schickt.
- Verification Mode. Eine Zeile in den Anweisungen an das Modell sagt ihm, dass es seine Arbeit prüfen soll, bevor es antwortet. Laut den Autoren muss dafür sonst nichts installiert werden.
Die Werte der Autoren stammen vom unkomprimierten Modell und wurden hier nicht nachgemessen
Bei BrowseComp, das nach schwer auffindbaren Fakten im Web fragt, melden die Autoren 81,7 von 100, gegen 91,2 für Kimi-K3, das beste Modell in ihrer Tabelle. In einem separaten Test mit Modus an und aus über alle 1.266 BrowseComp-Fragen hob der Verification Mode den Wert von 72,5 % auf 82,9 %. Ob die 81,7 diesen Gewinn schon enthalten, können wir nicht sagen. Ihre übrigen Werte stehen im Anhang.
Unser Test: eine RTX 4090, die Datei der Autoren, unsere eigenen Fragen
Zuerst die Grenze: eine Handvoll einfacher Fragen, die sich mit Wikipedia beantworten lassen, auf einer Karte, ein Agent nach dem anderen. Das prüft die Mechanik (Tool-Calls, Aufgaben verteilen, Antworten, die zurückkommen), nicht die Breite seiner Recherche.
Wir haben die komprimierte Datei der Autoren mit llama.cpp bereitgestellt, der offenen Software, die Modelle auf einer einzelnen Maschine laufen lässt, auf einer RTX 4090 in unserer Cloud. Wir haben die empfohlenen Einstellungen der Autoren verwendet. Alle Anfragen liefen über unsere Plattform, so wie eine Anwendung sie aufrufen würde, und das Tempo haben wir zusätzlich direkt gegen llama.cpp geprüft.
Die Fragen waren unsere. Jede brauchte ein paar Fakten aus Wikipedia: wer Rhenium entdeckt hat und wo, nach welcher Stadt Hafnium benannt ist, wann Technetium gefunden wurde. Das Modell hat über zwei Tools, die wir geschrieben haben, live Seiten gesucht und gelesen. Für die Orchestrierung haben wir eine Frage gestellt, dreimal ausgeführt: wie viele Jahre zwischen den Entdeckungen von drei Elementen lagen, sodass jeder Sub-Agent eines übernahm.
Etwa 136 Tokens pro Sekunde und eine Recherchefrage in allen drei Läufen richtig
Auf einer RTX 4090 schrieb das Modell bei einer Anfrage etwa 136 Tokens pro Sekunde, und das erste Token kam nach etwa einer Viertelsekunde. Der Weg über unsere Plattform fügte keine messbare Verzögerung hinzu: llama.cpp allein lieferte dasselbe Tempo. Eine Antwort mit 1.489 Tokens dauerte etwa 11 Sekunden.
Auch lange Prompts liest es schnell. Wir haben ein erfundenes Tag, 7342-ORCHID, in einem Prompt mit 92.662 Tokens versteckt, ungefähr die Länge eines Romans. Das Modell hat das Ganze in 31 Sekunden gelesen und das Tag gefunden.
Die Recherchefrage kam jedes Mal richtig zurück. In jedem der drei Testläufe hat das Modell drei Aufgaben gleichzeitig verteilt, eine pro Element. Die drei Sub-Agenten haben Wikipedia durchsucht und ihre Ergebnisse zurückgeschickt. Das leitende Modell hat dann die Antwort geschrieben: Hafnium 1923, Rhenium 1925, Technetium 1937, 14 Jahre vom ersten bis zum letzten. Jeder Tool-Call kam genau in dem Format heraus, das unser Code zum Ausführen brauchte. Ein einfacherer Test mit einem Suchaufruf kam 3 von 3 Mal sauber zurück, jeweils in unter einer Sekunde.
Die Zeit hängt davon ab, ob die Sub-Agenten nebeneinander laufen, und die Standardeinstellung unserer Plattform lässt sie anstehen. Nach einem Deploy schickt sie dem Modell eine Anfrage nach der anderen, also haben die drei Sub-Agenten in der Schlange gewartet, und der Lauf dauerte 72,0 Sekunden. Ein API-Aufruf hob das Limit auf zwei, und die Läufe dauerten dann 50 und 56 Sekunden. Status: Der Standard ist weiterhin eins, der Aufruf steht im Anhang.
Auch der Bildteil funktioniert. Wir haben ihm das Benchmark-Diagramm der Autoren gezeigt und nach einem Wert gefragt. Es hat 80,0 vom richtigen Balken abgelesen und 50,0 als bestes der größeren Modelle, beides korrekt.
Der Haken ist, wie lange es nachdenkt. Dieses Modell überlegt ausführlich, bevor es antwortet. Eine Definition in zwei Sätzen dauerte 14,4 Sekunden, weil es vorher 1.905 Tokens lang nachgedacht hat. Selbst 17 x 23 kostete 336 Tokens Nachdenken. Bei 136 Tokens pro Sekunde ist das für eine Rechercheaufgabe in Ordnung und für ein Chatfenster langsam.
Der Verification Mode hat bei einfachen Fragen die Arbeit verdoppelt und keine Antwort geändert
Bei unseren einfachen Fragen hat der Verification Mode nichts gebracht, was wir messen konnten. Alle 12 Antworten waren richtig, mit Modus aus und mit Modus an.
| Aus | An | |
|---|---|---|
| Richtige Antworten | 6 von 6 | 6 von 6 |
| Durchschnittliche Zeit | 11,2 s | 25,0 s |
| Durchschnittliche Tool-Calls | 4,0 | 6,5 |
| Durchschnittlich geschriebene Tokens | 934 | 1.890 |
Die zusätzliche Arbeit war vor allem Wiederholung. Mit eingeschaltetem Modus füllte sich das Nachdenken mit „Let me verify“-Turns, nachdem die Fakten schon bestätigt waren. Der Abstand schwankte: Im anderen Hafnium-Lauf machte der Modus an einen Tool-Call weniger als der Modus aus. Ein Lauf dauerte 52,7 Sekunden, weil eine Wikipedia-Suche in ein Timeout lief und das Modell es erneut versuchte.
Das widerspricht den Autoren nicht. Ihr Gewinn kam bei BrowseComp, wo Fakten schwer zu finden sind und eine falsche erste Spur häufig ist.
Welche GPU: eine echte 24-GB-Karte mit vollem Tempo, darunter etwa ein Fünftel des Tempos oder weniger
Die kleinste Karte, auf der Sage-A1.5 mit vollem Tempo lief, war eine echte RTX 4090 mit 24 GB. Mit den Einstellungen unseres Beispiels, Platz für 32.768 Tokens Unterhaltung und zwei Anfragen gleichzeitig, belegte es 21,3 der 23,5 GiB der Karte. Die Konfiguration aus der Model Card selbst, 64K Tokens mit Bildverarbeitung, erreichte eine Spitze von 23,1 GiB. 128K Tokens, nur Text, erreichten 23,4 GiB, die Karte war damit fast voll. Alles davon passte, ohne Tempoverlust.
Unter 24 GB läuft das Modell nur, wenn ein Teil davon in den Hauptspeicher des Rechners wandert. Llama.cpp kann einige Spezialisten dort parken und vom Prozessor ausführen lassen, was viel langsamer ist. Wir haben kleinere Karten auf derselben 4090 simuliert, indem wir so viele Spezialisten ausgelagert haben, bis der Speicher der Karte unter der jeweiligen Grenze blieb.
- Simulierte 16 GB: 14,4 GiB auf der Karte, etwa 5,6-mal langsamer, und die Recherchefrage kam trotzdem in 98 Sekunden richtig zurück.
- Simulierte 12 GB: 10,8 GiB auf der Karte, und die Frage kam in 93 Sekunden richtig zurück.
- Simulierte 8 GB: 3,0 GiB, mit jedem Spezialisten im Hauptspeicher. Einer von zwei Rechercheläufen hat sein Limit von 12 Schritten nach 270 Sekunden ohne Antwort aufgebraucht. Der zweite Versuch war richtig.
- Nicht ausprobiert: echte Karten mit 16 und 12 GB, die RTX 3090, Karten mit 32 GB, das unkomprimierte Modell.
Die simulierten Geschwindigkeiten hängen vom Prozessor und Speicher des Rechners ab, nimm sie also als Richtung, nicht als Versprechen. Die kleineren Einstellungen brauchen außerdem freien Hauptspeicher für die geparkten Spezialisten, bis zu etwa 17 GB, wenn alle dorthin wandern.
Auf InferenceKey: bereit in 104 Sekunden, nach einem Fix am Befehl aus der Model Card
Ein 35B-Agentenmodell sollte keine eigene Engine brauchen, und dieses brauchte keine. Vom Deploy-Aufruf bis zum Serving vergingen 104,1 Sekunden, auf der llama.cpp-Version, die unsere Plattform schon mitliefert: die Datei mit 21,7 GB herunterladen, laden, antworten. Unsere Plattform betreibt ein Modell auf einem Worker, einer GPU-Maschine, die du besitzt oder mietest und mit ihr verbindest, und ihr Standard-llama.cpp hat Sage-A1.5 ohne Änderungen geladen. Beim ersten Mal auf einer frischen Maschine muss llama.cpp außerdem für die Karte gebaut werden, was zehneinhalb Minuten dauerte. Danach braucht ein Neustart 4 bis 7 Sekunden.
Das eine Problem, auf das du stoßen wirst, steckt in der Model Card selbst. Ihr llama.cpp-Befehl nutzt eine Reasoning-Einstellung namens deepthink, die llama.cpp nicht kennt. Der Server beendet sich beim Start mit „Unknown reasoning format: deepthink“. Wir haben auch ein viel neueres llama.cpp-Release geprüft, und dort gibt es sie ebenfalls nicht. Der Fix: stattdessen deepseek schreiben. Status: in unserem Beispiel behoben, in der Card der Autoren weiterhin drin.
Eine zweite Lücke liegt bei uns. Die Autoren schalten den Verification Mode mit einer Einstellung ein, die unsere Plattform noch nicht an das Modell weitergibt. Unser Beispiel fügt stattdessen dieselbe Schaltzeile in die Anweisungen an das Modell ein. Wir haben geprüft, dass das Modell auf beiden Wegen genau denselben Prompt sieht. Status: auf unserer Seite offen, im Beispiel umgangen.
Solltest du es ausprobieren? Ja auf einer 24-GB-Karte: Die Agent-Mechanik hat funktioniert
- Wenn du einen Agenten willst, der auf deiner eigenen Hardware sucht, liest und berichtet, probier es aus.
- Wenn dir Genauigkeit bei schweren Fragen wichtig ist, teste den Verification Mode an deinen eigenen schweren Fällen.
- Wenn du schnelle Chat-Antworten brauchst, such woanders. Es denkt vor kurzen Antworten Hunderte oder Tausende Tokens lang nach.
- Wenn deine Karte 16 GB oder weniger hat, rechne mit einem Bruchteil des Tempos, und nur mit reichlich Hauptspeicher.
Um Sage-A1.5 dieselbe Recherchefrage auf deiner eigenen Karte zu stellen, mit Sub-Agenten und mit Verification Mode aus und an, führ python main.py aus dem Sage-A1.5-SDK-Beispiel aus. Es braucht ein InferenceKey-Projekt mit einem SDK-Token und einem API-Key sowie einen privaten NVIDIA-Worker mit 24 GB oder mehr. Am Ende löscht es das Deployment.
Für Ingenieure
Credits
- Sage-A1.5: Shanghai AI Laboratory (auf Hugging Face die Organisation InternScience, auf der Projektseite als Alpha-Innovator veröffentlicht), Paper von Wenjie Lou und 98 Co-Autoren, arXiv 2610.28578. Sie haben das Modell trainiert, beide Modi gebaut, die BF16-Gewichte, das offizielle Q4_K_M-GGUF und den Vision-Projektor unter Apache-2.0 veröffentlicht und eine Mac-Demo mit llama.cpp auf der Projektseite aufgezeichnet.
- Basismodelle: Qwen3.6-35B-A3B vom Qwen-Team und Agents-A1, der frühere Agent der Autoren (Open Source seit 2026-06-26, 35B-A3B, Apache-2.0).
- Serving: das llama.cpp-Projekt.
- Daten für unsere Fragen: Wikipedia, über die öffentliche API.
- Wo es uns aufgefallen ist: das News-Video von AI Search vom 2026-10-25 (Abschnitt zu Sage-A1.5 bei 36:10).
- Unser Teil: das Deployment über die Plattform, die Fragen und Tools, die Messungen, die VRAM-Stufen, das SDK-Beispiel und das Demovideo.
Modell und Dateien
InternScience/Sage-A1.5-Q4_K_M-GGUF, sha10b179b52f2c841030db327627e707d076b4c8cf, erstellt 2026-10-21, zuletzt geändert 2026-10-22, Apache-2.0, nicht gated.Sage-A1.5-Q4_K_M.gguf: 21.713.463.520 B („MoE weights + built-in MTP layer“), GGUF-Architekturqwen35moe. Im Schnitt etwa 5 Bit pro Parameter bei etwa 35B Parametern, ungefähr ein Drittel der Größe des BF16-Repos.Sage-A1.5-mmproj.gguf: 899.282.880 B. Zusammen etwa 22,6 GB.
InternScience/Sage-A1.5(BF16), sha0e3205cf, erstellt 2026-10-15, zuletzt geändert 2026-10-22: 14 Safetensors-Shards zu je etwa 5,37 GB plusmodel-mtp.safetensorsmit 1,69 GB, etwa 72 GB.Qwen3_5MoeForConditionalGeneration: 40 Layer (30 mit linearer Attention, 10 mit voller Attention), 256 Experten, 8 pro Token plus ein geteilter Experte, Hidden 2048, 1 MTP-Layer, Vision-Tower mit 27 Layern,max_position_embeddings262.144. 35B gesamt, etwa 3B aktiv pro Token (Projektseite).- Speicherhinweis der Card: „~20.2 GiB for the Q4_K_M weights plus ~0.84 GiB for the projector, plus the KV cache... A single 24 GB GPU comfortably serves the model at moderate context lengths“.
- Empfohlenes Sampling: Temperatur 1,0, top_p 0,95, top_k 20, min_p 0,0, presence_penalty 1,5, repetition_penalty 1,0.
Benchmarks der Autoren (BF16, nicht von uns nachgemessen)
| Benchmark | Sage-A1.5 | Andere in der Tabelle der Autoren |
|---|---|---|
| GAIA | 95,1 | Agents-A1 96,0, Kimi-K3 92,2, GLM-5.3 92,2, GPT-5.6-sol 88,3 |
| BrowseComp | 81,7 (82,8 mit Orchestrierung) | Kimi-K3 91,2, GPT-5.6-sol 90,4, GLM-5.3 76,2, Agents-A1 75,5, Qwen3.6-35B-A3B 67,9 |
| SWE-bench Pro | 61,2 | GPT-5.6-sol 64,6, GLM-5.3 64,6, Kimi-K3 63,3, Ornith-1.5 59,6, Qwen3.6-35B-A3B 49,5, Agents-A1 43,6 |
| HLE mit Tools | 55,1 | GPT-5.6-sol 64,5 |
| IFBench | 81,6 | |
| FrontierScience-Research | 48,3 | |
| CMT | 80,0 | bestes größeres Modell 50,0 |
Die Card sagt, die Q4_K_M-Quantisierung „trades a small amount of accuracy“. SWE-bench Pro lief mit dem Harness mini-SWE-agent, Temperatur 1,0, top-p 0,95, 200K Kontext, offline. Bei GAIA liegt der Vorgänger Agents-A1 (96,0) in der eigenen Tabelle der Autoren vor Sage-A1.5 (95,1). Aktuelle Flaggschiffe (Claude Opus 5.5, GPT-6.1 Sol) stehen nicht in der Tabelle.
Setup
- Eine RTX 4090 24 GB (24.080 MiB) in unserer Cloud (InferenceKey Cloud), Power-Limit 203 W (ab Werk 450 W), AMD EPYC 7402, Treiber 580.142, ein Container-Image mit CUDA 13.
- Unverändertes
llamacpp-Backend, llama.cpp-Tagb9748(der Standard-Pin des Workers, kein Override). Es enthält bereitsLLM_ARCH_QWEN35MOE. - Ein lokaler InferenceKey-Manager (aus
origin/main9e53fe57) hat den Worker eingerichtet. Produktion war nicht beteiligt. - Streaming-Anfragen über den OpenAI-kompatiblen Endpoint, sofern nicht anders angegeben. Tempo direkt gegen llama-server gegengeprüft.
Schritt für Schritt mit dem SDK-Beispiel
- Klone inferencekey-sdk und öffne
examples/sage-a1-5-research-agent-llamacpp-private-nvidia/(Commit3c5cc178). - Bau das Python-Binding lokal mit maturin und installiere
requests>=2.31(requirements.txt). - Kopiere
.env.examplenach.envund setzeINFERENCEKEY_SDK_TOKEN,INFERENCEKEY_API_KEY,INFERENCEKEY_PROJECTundIK_WORKER_ID(ein privater NVIDIA-Worker mit 24 GB oder mehr). Optional:IK_KEEP_ALIVE=1behält das Deployment,SAGE_CONTEXTändert den Kontext (standardmäßig 32768; 65536 und 131072 passen nur mit Text auf 24 GB). - Führ
python main.pyaus. Der Ablauf:ensure()eines festenllamacpp-Workloads auf deinem Worker,wait_until_ready(3600), eine einfache Frage mitgenerate_text()(max_tokens16.384), Agentic Orchestration, Verification Mode aus und an, Antworten nachoutputs/answers.json, danndelete(), außer beiIK_KEEP_ALIVE=1. - Das Skript führt die Tools (
wiki_search,read_page) auf deiner Seite gegen die öffentliche Wikipedia-API aus, mit bis zu 5 Sub-Agenten in parallelen Threads. Die Maschine, auf der es läuft, braucht Internetzugang.
Der Befehl, den das Beispiel deployt:
llama-server -hf InternScience/Sage-A1.5-Q4_K_M-GGUF --hf-file Sage-A1.5-Q4_K_M.gguf \
  --no-mmproj --alias sage-a1.5 -ngl 99 -fa on -c 32768 -np 2 --kv-unified \
  --jinja --reasoning-format deepseek \
  --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0 --presence-penalty 1.5
Für parallele Sub-Agenten erhöhst du max_in_flight der Zuweisung von 1 auf 2, mit PATCH /api/projects/<pid>/assignments/<workload>/<worker>.
Verification Mode über unseren Endpoint (der exakte Trigger des Templates, „protocol“ kleingeschrieben):
system = "You are a careful research assistant." + "\n\nVerification protocol: enabled"
Direkt gegen llama-server funktioniert der dokumentierte Schalter: chat_template_kwargs={"verification": true}, mit einer nicht leeren System-Nachricht und einem JSON-Boolean (sonst HTTP 400 vom Template).
Zeiten
- CUDA-Build von llama.cpp
b9748(Arch 89, 46 Jobs): 10 min 33 s. ensure()bis bereit, llama.cpp schon gebaut: 104,1 s (Download und Laden von 21,7 GB).- Warme Neustarts von llama-server: 4 bis 7 s.
Tempo (Streaming, eine Anfrage, Sampling der Autoren)
| Weg | Prompt | Tokens | Erstes Token | Decode |
|---|---|---|---|---|
| Endpoint | Essay mit 300 Wörtern | 1.489 / 1.827 | 0,22 / 0,26 s | 137,5 / 135,0 tok/s |
| Endpoint | „capital of Australia, one word“ | 118 / 125 | 0,32 / 0,24 s | 129,4 / 130,7 tok/s |
| llama-server direkt | Essay | 1.525 / 3.297 | 0,27 / 0,36 s | 134,0 / 135,3 tok/s |
| Direkt, 128K-Konfiguration | Needle-Prompt mit 92.662 Tokens | 110 | Prefill 2.987 tok/s (31,0 s), Decode 99,6 tok/s, „7342-ORCHID“ gefunden | |
| Direkt, 64K + mmproj | Diagramm der Autoren + Frage (2.124 Prompt-Tokens) | 1.628 | Prefill 1,66 s, 131,7 tok/s, Antwort richtig |
Beim Decode: etwa 66 % GPU-Auslastung und etwa 175 W von der 203-W-Grenze, die Karte blieb also unter ihrem Limit. Eine 4090 ohne Limit haben wir nicht gemessen.
Tool-Calls und Modi
- Einzelner Tool-Call: 3 von 3 mit genau einem
wiki_search-Aufruf mit gültigen JSON-Argumenten, 0,87 bis 0,98 s. Nicht getestet: viele Tools gleichzeitig oder verschachtelte Argument-Schemas. - Orchestrierung (das leitende Modell hat nur
spawn_subagent, die Sub-Agenten habenwiki_searchundread_pageund geben{answer, status, evidence, unresolved_issues}zurück), eine dreiteilige Frage (Jahre zwischen den Entdeckungen von Hafnium, Rhenium und Technetium): 3 von 3 Testläufen richtig, dazu die aufgezeichnete Aufnahme für das Video, ebenfalls richtig, also 4 von 4 insgesamt. Das Übersichtsbild zählt die 3 Testläufe. Einspawn_subagentmit 3 Aufgaben pro Lauf. 72,0 s mitmax_in_flight1 (Sub-Agent-Turns 9/7/3), 49,7 s (4/4/7) und 55,7 s (3/6/11) mit 2, aufgezeichnete Aufnahme 48,3 s. Ein Sub-Agent brauchte für Hafnium 9 Tool-Calls, weil die Quellen sich zwischen 1922 und 1923 uneinig sind. - Verification, 3 Fragen (Rhenium, Hafnium, Technetium) x 2 Läufe x aus/an:
| Modus | Läufe | Mittel s | Mittel Tool-Calls | Mittel Completion-Tokens | Mittel Reasoning-Zeichen | Richtig |
|---|---|---|---|---|---|---|
| aus | 6 | 11,2 | 4,0 | 934 | 2.778 | 6/6 |
| an | 6 | 25,0 | 6,5 | 1.890 | 5.662 | 6/6 |
Mittlere Turns: 5,0 aus, 7,5 an. Die Streuung ist groß: Der Hafnium-Lauf im Kernbild ging von 5 auf 9 Tool-Calls (13,6 s auf 24,7 s), während der andere Hafnium-Lauf mit Modus an 6 Tool-Calls machte, gegen 7 mit Modus aus (15,9 s gegen 15,5 s).
Die strukturierte Prüfung „was steht fest, was ist gescheitert“ aus dem Demotext der Autoren haben wir nicht gesehen. Die zusätzlichen Turns waren schlichte Nachprüfungen.
VRAM-Stufen
VRAM-Spitze per nvidia-smi jede Sekunde. Der Fließtext nennt diese Werte in GiB (21.760 MiB sind etwa 21,3 GiB; 24.080 MiB auf der Karte, 23,5 GiB, minus 23.920 MiB bei 128K lässt 160 MiB übrig). Grenzen emuliert auf derselben 4090, indem die Experten von N Layern in den System-RAM verschoben wurden (--n-cpu-moe, 24 CPU-Threads). Agent-Prüfung: die Rhenium-Frage, Verification aus, Budget von 12 Turns.
| GPU oder Grenze | Konfiguration | VRAM-Spitze | Tempo | Ausgabe OK | Echt oder emuliert |
|---|---|---|---|---|---|
| RTX 4090 24 GB | -c 32768 -np 2 --kv-unified, nur Text, über die Plattform | 21.760 MiB | 135 bis 137 tok/s; Orchestrierung 48 bis 56 s | ja | echt |
| RTX 4090 24 GB | -c 65536 --mmproj, -fit off | 23.684 MiB | 138 tok/s; Agent 22,3 s | ja, Diagramm richtig gelesen | echt |
| RTX 4090 24 GB | -c 131072 nur Text, -fit off | 23.920 MiB | 137 bis 139 tok/s; Agent 25,6 s | ja, 92,7K-Needle gefunden | echt |
| 16-GB-Grenze | -c 32768 -np 2 --n-cpu-moe 16 | 14.708 MiB | 23,9 bis 25,0 tok/s; Agent 98,0 s | ja (etwa 5,6-mal langsamer) | emuliert |
| 12-GB-Grenze | --n-cpu-moe 24 | 11.052 MiB | 12,9 bis 18,1 tok/s; Agent 92,8 s | ja | emuliert |
| 8-GB-Grenze | --cpu-moe | 3.048 MiB | 14,1 bis 14,9 tok/s; Agent 270,2 s, keine Antwort, zweiter Versuch richtig in 104,1 s | teilweise, 1 von 2 | emuliert |
| RTX 4090 24 GB | --spec-type draft-mtp -md <same GGUF> | nein: failed to allocate CUDA0 buffer of size 21416407552 | echt |
--cpu-moe braucht etwa 17 GB Gewichte im System-RAM. Nicht ausprobiert: echte Karten mit 16 und 12 GB (keine auf Lager in unserer Cloud: 4080, 4080 SUPER, 5080, A4000, 2000 Ada, 4070 Ti, 3080 Ti), RTX 3090 (die einzige Maschine, die wir bekamen, hatte kein direktes SSH und wurde beendet), Karten mit 32 GB, BF16-Gewichte mit vLLM, andere Quantisierungen.
Probleme und Status
--reasoning-format deepthinkin der Model Card: llama-server beendet sich mit „Unknown reasoning format: deepthink“. Gültige Werte inb9748sindnone|deepseek|deepseek-legacy|auto, undb12000(2026-10-30) hat weiterhin keindeepthink. Im Beispiel mitdeepseekbehoben.- Der Endpoint verwirft
chat_template_kwargs,top_kundmin_p.ChatCompletionRequesttransportiert sie nicht. Über den Endpoint geben{"verification": "maybe"}und{"verification": true}ohne System-Nachricht beide 200 zurück, die Kwargs erreichen das Template also nie. Workaround: die Trigger-Zeile in der System-Nachricht, byte-identisch auf/apply-templatemit und ohne Tools. Offen. - Der Non-Stream-Endpoint verwirft
reasoning_content, wenncontentgesetzt ist. Mitmax_tokens4.096 lieferte die erste einfache Frage 4.096 Tokens „Thinking Process:“ in 30,7 s. Das Beispiel fordert 16.384 an (dann 14,4 s, 1.905 Tokens) und streamt die Agent-Schleifen. - llama.cpp-Build auf dem Worker: „No CMAKE_CUDA_COMPILER could be found“, weil
nvcc(13.0.88,/usr/local/cuda/bin) im Container-Image des Workers nicht imPATHliegt. Umgangen mitCUDACXX,PATHundCMAKE_BUILD_PARALLEL_LEVELim Env des Workers. Status: offen im Produkt, noch nicht erfasst. wait_until_ready()hängt bei einem festen Workload, der schon bedient:worker_leasesist für die private feste Zuweisung leer, und die Bereitschaftsprüfung liest nur aktive Ready-Leases. Status: offener Produktbug, noch nicht erfasst.max_in_flightist nachensure()1, also stehen die Sub-Agenten an. Mit dem PATCH oben auf 2 erhöht. Status: offen, der Standard ist weiterhin 1.- Die lokale NATS-URL stand standardmäßig auf
tls://, während beim lokalen nats-proxy TLS abgeschaltet war. Behoben mit einernats://-Einstellung und einer Neuinstallation des Workers. Betrifft nur das lokale Test-Setup. - MTP (der eingebaute Layer, der mehrere Tokens auf einmal rät) aus demselben GGUF:
--spec-type draft-mtp -md <same GGUF>lädt die Datei ein zweites Mal und läuft mitb9748auf 24 GB aus dem Speicher. - Eine RTX-3090-Maschine kam 180 s lang ohne direktes SSH hoch, und der Manager hat sie beendet.
- Widersprüche zwischen Card und Seite: Die Serving-Snippets der Projektseite nennen
Alpha-Innovator/Agents-A1.5(das Repo istInternScience/Sage-A1.5), und sie schreibt den Trigger als „Verification Protocol“, während das Template „protocol“ verwendet. Wir haben den String des Templates genommen. Der Mac-Demo-Trace der Autoren enthält kein Log zu Hardware, Quantisierung oder Durchsatz, wie sie selbst sagen.
Demovideo
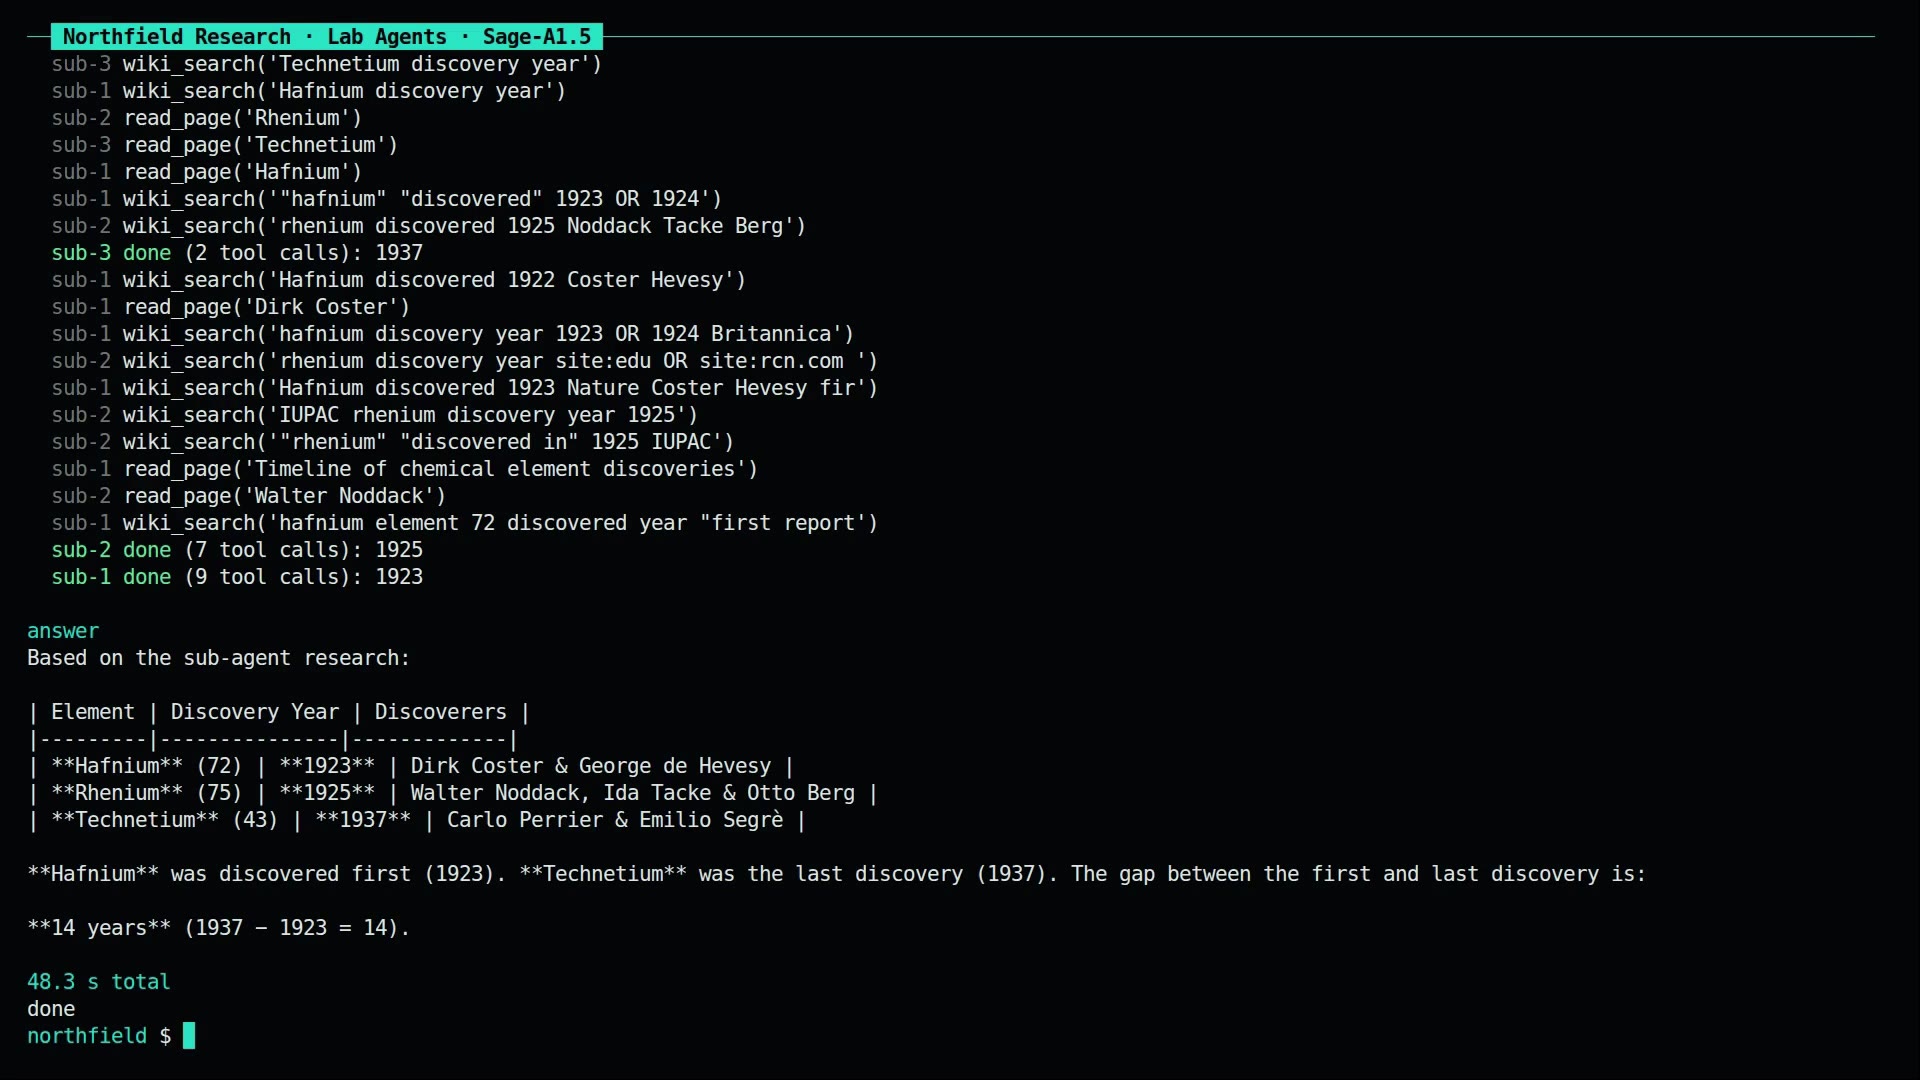
160,6 s, 1920x1080. Es enthält einen Ausschnitt aus der Mac-Demo der Autoren mit llama.cpp, dem Sage-A1.5-Team zugeschrieben, und ihre Benchmark-Tabelle, mit Quellenangabe und als nicht von uns nachgemessen gekennzeichnet.
Quellen
- Model Card, BF16: https://huggingface.co/InternScience/Sage-A1.5
- Model Card, Q4_K_M-GGUF: https://huggingface.co/InternScience/Sage-A1.5-Q4_K_M-GGUF
- Paper: https://arxiv.org/abs/2610.28578
- Projektseite: https://alpha-innovator.github.io/Sage-A1.5/
- Vorgänger: https://github.com/InternScience/Agents-A1
- SDK-Beispiel: https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/sage-a1-5-research-agent-llamacpp-private-nvidia
- Wo es uns aufgefallen ist: https://www.youtube.com/watch?v=EfyQOAJjx1A