Carbon-X liest DNA auf einer 24-GB-Karte: 3 von 4 Labels richtig, die Begründungen nicht
Das DNA-Chatmodell von Hugging Face auf Standard-vLLM und einer RTX 4090 mit 24 GB in FP8: 75 % bei 40 ClinVar-Varianten, 50 Tokens/s, oft falsche Erklärungen.
Carbon-X hat 55 Buchstaben eines menschlichen Gens gelesen, das genau die eine Veränderung trägt, die hinter der Sichelzellanämie steckt, und sie als pathogen eingestuft. Auf einer unserer beiden Karten hat es seine Antwort danach mit dem falschen Buchstaben begründet.
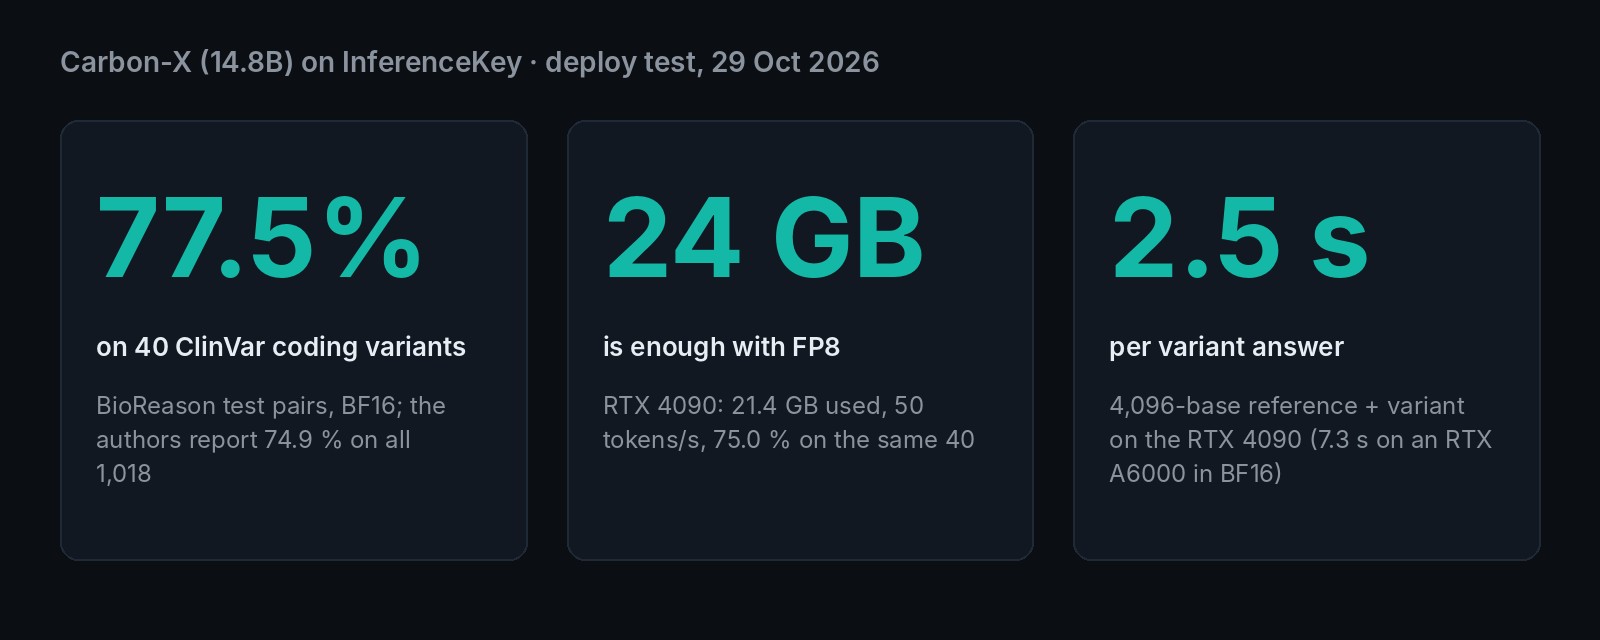
Carbon-X ist das neue offene Modell von Hugging Face, das rohe DNA mitten in einem normalen Chat liest und auf Englisch antwortet. Wir haben es mit unveränderter Open-Source-Software auf einer RTX 4090 betrieben, einer Gaming-Karte mit 24 GB, in unserer Cloud. Auf dieser Karte hat es 75 % von 40 bekannten DNA-Veränderungen aus ClinVar, einer öffentlichen Gendatenbank, richtig als schädlich oder harmlos eingestuft (Autoren: 74,9 %). Ein Paar von Sequenzen mit je 4.096 Buchstaben hat es in etwa 2,5 Sekunden beantwortet. Wenn du eigene GPUs betreibst, ist das ein DNA-Spezialist, der unveröffentlichte Sequenzen auf deiner Maschine lässt und mit einem einzigen Befehl auf Standard-Serving-Software aus der Open-Source-Welt läuft. Nimm seine Labels schädlich oder harmlos als erste Sichtung. Seinen Erklärungen solltest du nicht trauen.
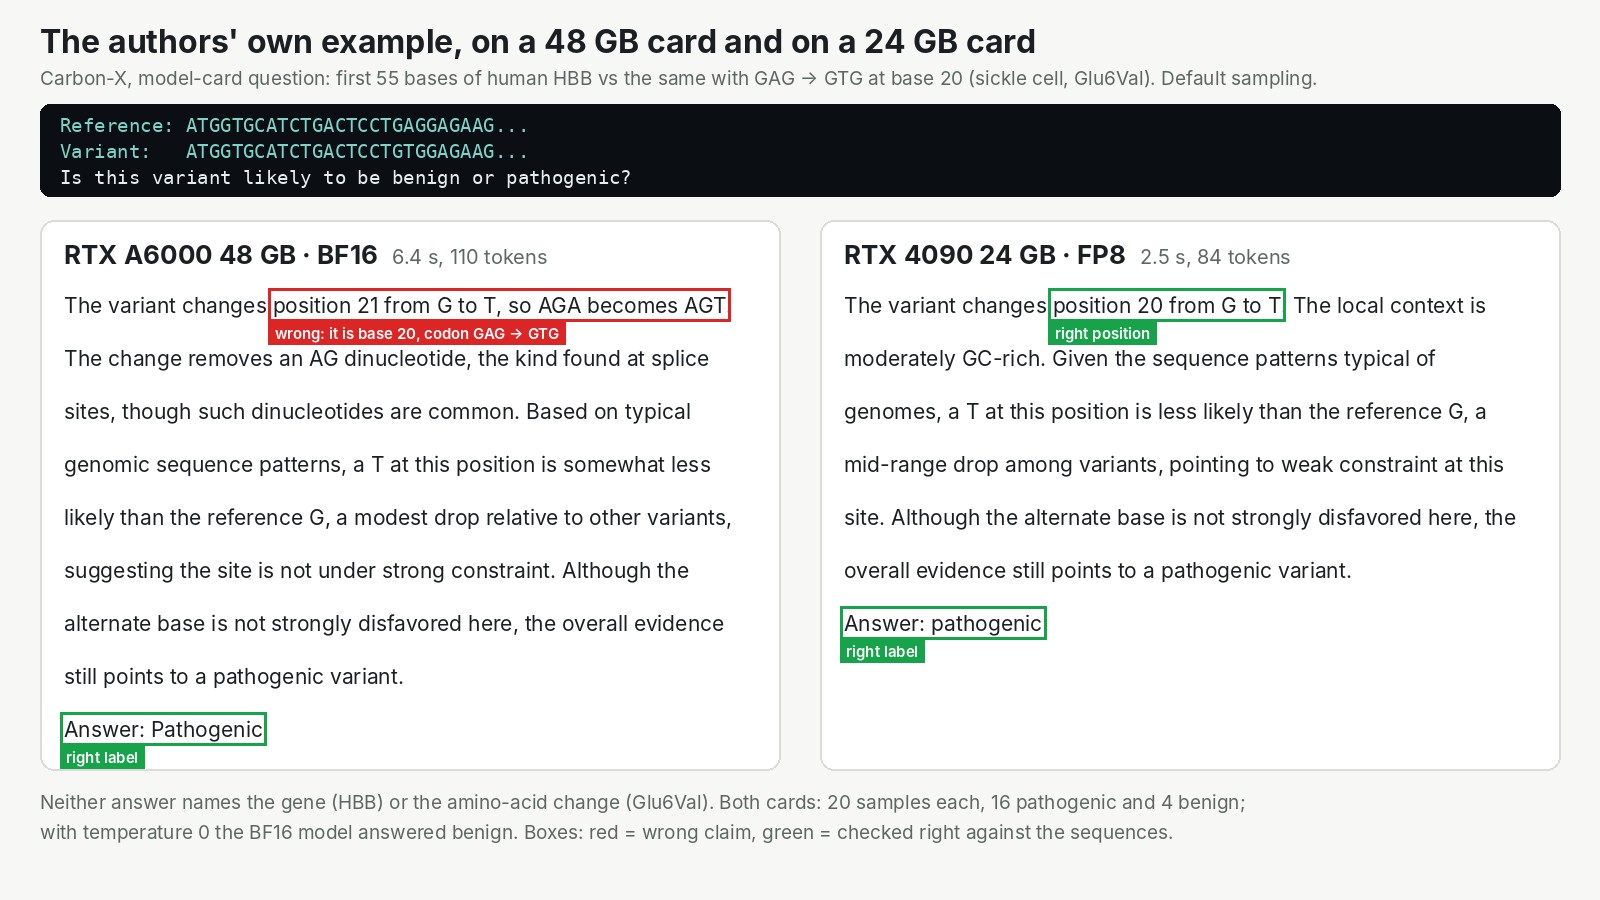
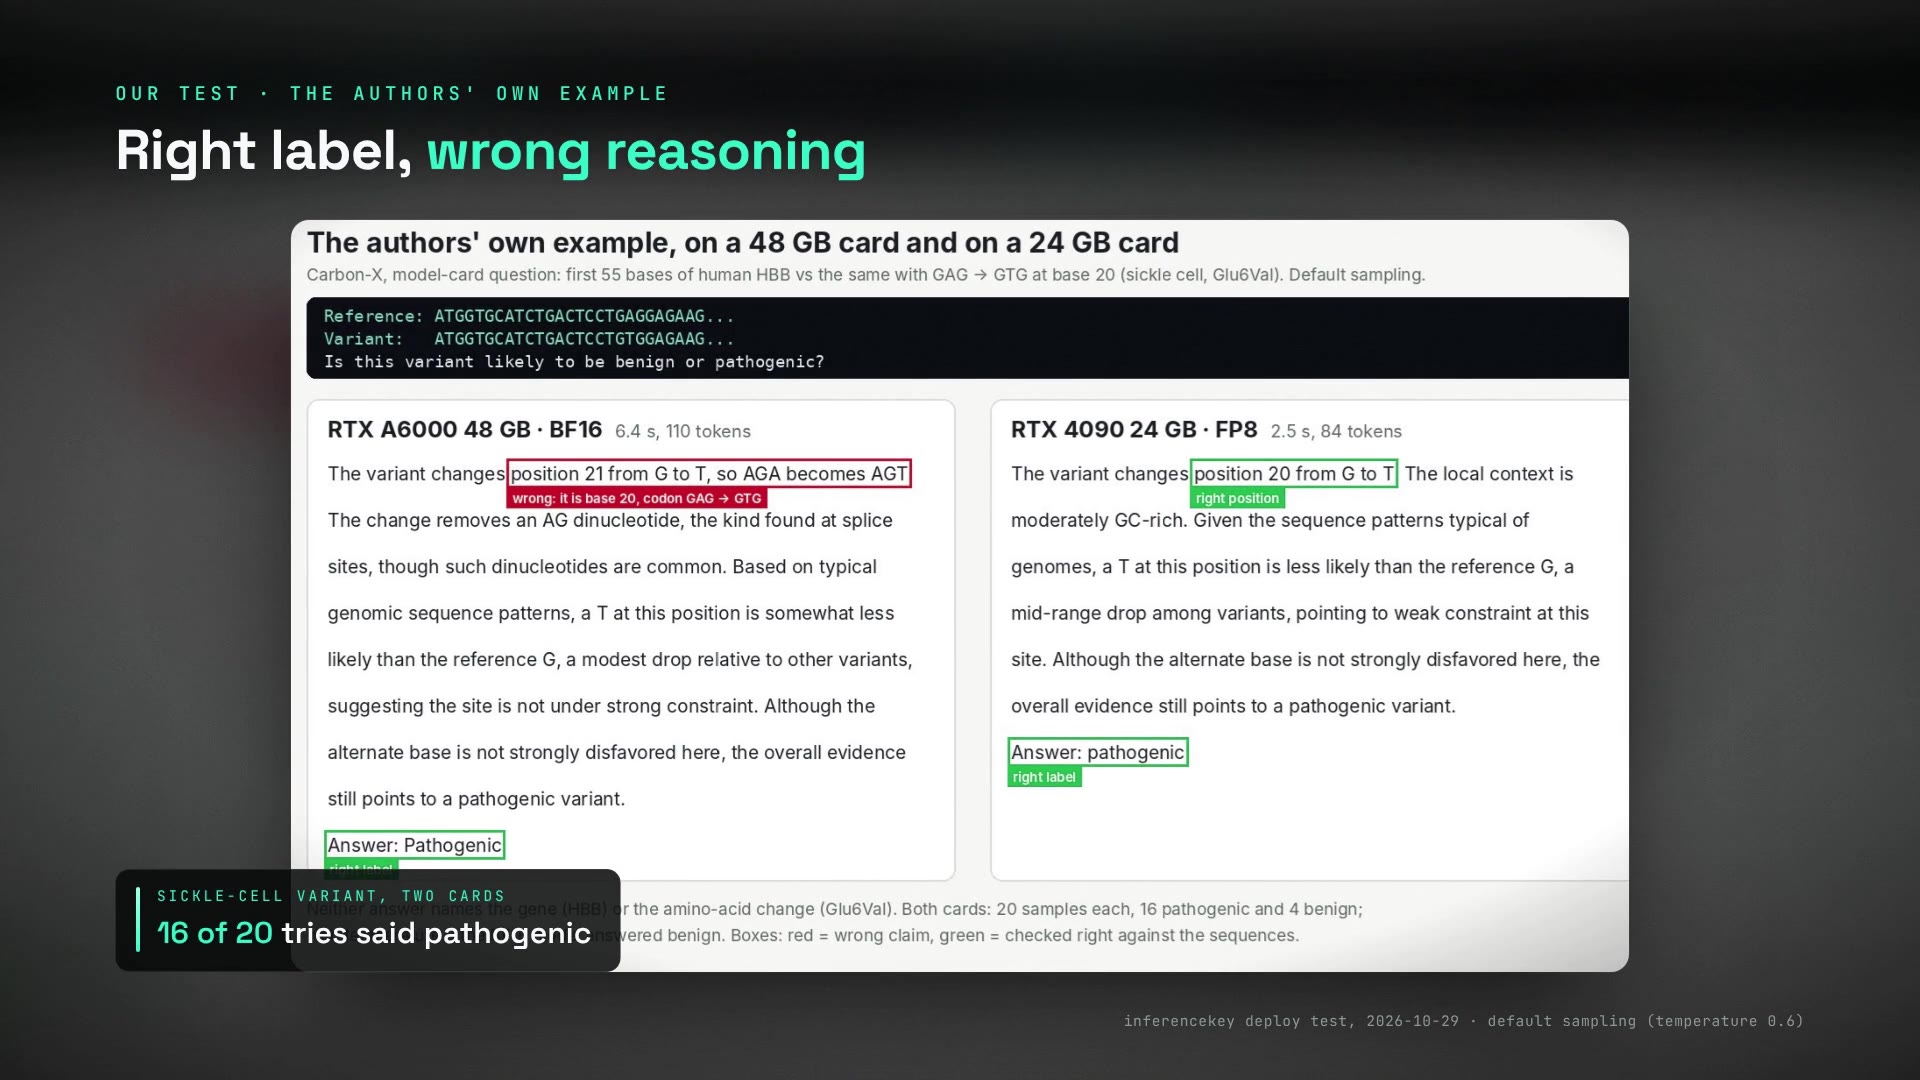
Das Bild zeigt einen einzelnen Lauf pro Karte. Beide hatten das Label richtig, und keine hat das Gen oder die Proteinveränderung genannt. Bei 20 Versuchen pro Karte lautete die Antwort 16-mal pathogen und 4-mal benign. Die 48-GB-Karte nannte in 12 von 20 Versuchen die falsche Base. Die Läufe mit geschrumpften Gewichten lagen in 16 und 18 von 20 richtig. Als wir den eingebauten Zufall des Modells abgeschaltet haben, sagte die 48-GB-Karte benign.
Ein Chatmodell, das DNA sechs Buchstaben auf einmal liest
Carbon-X ist keine neue Art von Modell, und genau deshalb war es leicht zu betreiben. Unter der Haube steckt Qwen3-14B, das offene Chatmodell mit 14.8B Parametern vom Qwen-Team, nachtrainiert auf DNA und biologischen Texten. Hugging Face hat auf dem Weg hinein eine Sache ergänzt: eine neue Art, DNA in Stücke zu schneiden, bevor das Modell sie liest.
Sprachmodelle lesen Text als Tokens, Stücke aus jeweils ein paar Buchstaben. Der übliche Schneideschritt von Qwen zerhackt DNA in seltsame Fragmente, lange Sequenzen kosten also viele Tokens. Carbon-X fügt den Tokens, die Qwen schon kennt, 5.515 DNA-Tokens hinzu. Die meisten davon (4.096) sind Blöcke aus sechs Buchstaben A, C, G und T, ein Token deckt also sechs Basen ab. Stell dir einen Gitarristen vor, der einen Lauf aus sechs Tönen als eine Griffform liest statt als sechs einzelne Noten.
Sechs Buchstaben pro Token sind der Grund, warum lange DNA hineinpasst. In unserem Test kamen zwei Sequenzen mit je 4.096 Buchstaben plus die Frage auf 1.445 Tokens. Die eigene Abbildung der Autoren zeigt eine kurze Frage mit einer Sequenz von 27 Buchstaben, die mit dem Qwen3-Tokenizer 20 Tokens braucht und mit dem von Carbon-X 13.
Du musst die DNA nicht selbst markieren. Jede Folge von sechs oder mehr Buchstaben A, C, G und T in deiner Nachricht wird automatisch als DNA markiert. Füg eine Sequenz in einen Satz ein und frag: Ist diese Variante schädlich, was macht diese Region, welche Basen kommen als Nächstes.
Der Haken beim Betrieb: Dieser Schneideschritt ist eigener Python-Code, der mit dem Modell ausgeliefert wird. Du musst der Serving-Software erlauben, Python aus dem Modell-Repository auf deiner eigenen Maschine auszuführen. Wir haben diese Datei zuerst gelesen: Sie nutzt nur gängige, weit verbreitete Python-Bibliotheken. Beim ersten Laden holt sie außerdem das Basisvokabular von Qwen von Hugging Face, die Maschine braucht dann also Internetzugang. Der Rest ist ein gewöhnliches 14B-Modell.
Hugging Face nennt 66,7 %, nah an GPT-6.1 Sol zu einem Bruchteil der Kosten
Die Kernaussage der Autoren, in ihrem Release-Blog und auf der Model Card, ist ein Durchschnitt von 66,7 % über fünf DNA-Benchmarks. GPT-6.1 Sol erreicht in derselben Tabelle 67,5 % und Opus 5.5 60,9 %. Hugging Face hat das eigene Modell mit 5 Dollar pro GPU-Stunde angesetzt, die anderen mit den regulären API-Preisen: Auf je 1.800 Dollar, die Sol kostet, kommt Carbon-X auf etwa einen. Der Untertitel des Blogs spricht stattdessen von 1.000x.
Die konkreteste Aussage betrifft ClinVar, die öffentliche Datenbank, in der Labore genetische Varianten einreichen und angeben, was jede davon ihrer Meinung nach bewirkt. Rund 2,4 Millionen ihrer Varianten haben noch eine unklare Bedeutung. Die Autoren schätzen, dass es etwa 300 Dollar kosten würde, sie alle einmal mit Carbon-X zu bewerten (ihr Diagramm zeigt 271), gegenüber 32.000 Dollar bis 4 Millionen mit Frontier-Modellen. Wir haben weder diese Schätzung noch die 66,7 % nachgemessen: Ihre Evaluationsdaten sind nicht öffentlich, also haben wir unser eigenes Set aus öffentlichen Quellen gebaut.
Aufgefallen ist uns Carbon-X in der AI-NEWS-Übersicht von AI Search vom 25. Oktober. Das Video sagt, Carbon-X schlage GPT-6.1 im Durchschnitt. Die eigene Tabelle der Autoren sieht es 0,8 Punkte hinter Sol. Die Model Card sagt, llama.cpp und GGUF-Runtimes würden nicht unterstützt, und doch läuft in der Blog-Demo der Autoren ein 8-Bit-GGUF auf einem MacBook mit 34 Tokens pro Sekunde. Den Weg über den Laptop haben wir nicht getestet.
Unser Test: zwei echte Karten, 120 öffentliche Fragen, die Einstellungen der Autoren
Wir haben Carbon-X auf zwei Karten in unserer Cloud betrieben. Ein Modell besteht vor allem aus seinen Gewichten, den 14,8 Milliarden Zahlen, die es gelernt hat. Der Hauptlauf nutzte eine RTX A6000 mit 48 GB und behielt jedes Gewicht in 16 Bit, dem nativen Format des Modells. Der zweite Lauf nutzte eine RTX 4090 mit 24 GB und schrumpfte jedes Gewicht beim Laden auf 8 Bit, was den Speicherbedarf fast halbiert. Beide Läufe gingen über unsere Plattform, so wie eine Anwendung sie aufrufen würde.
Das Fragenset hatte 120 Einträge, alle aus öffentlichen Daten. Vierzig waren echte ClinVar-Varianten in proteinkodierenden Genen, 20 harmlose und 20 schädliche, aus demselben Testset, das die Autoren nutzen. Das Modell sah nur die Referenzsequenz, die veränderte und unsere Frage, nie den Gennamen. Sechzig waren Multiple-Choice-Fragen aus GenomeQA dazu, was eine DNA-Region macht, zehn pro Aufgabe. Zwanzig fragten nach den nächsten 24 Basen eines menschlichen Gens.
Wir haben die Einstellungen der Autoren genutzt: kein schrittweises Nachdenken vor der Antwort und ein wenig Zufall in jeder Antwort. Zusätzlich sind wir mit abgeschaltetem Zufall gelaufen.
Eine Grenze vorweg: 40 und 60 Fragen sind kleine Stichproben. Bei 40 Varianten könnte ein Ergebnis von 77,5 % ehrlicherweise irgendwo zwischen etwa 64 % und 90 % liegen. Lies unsere Zahlen als „passt zu den Autoren oder nicht“, nicht als Rangliste.
Ergebnisse: Bei echten ClinVar-Varianten passen die Labels zu den Autoren
Carbon-X hat 77,5 % unserer 40 ClinVar-Varianten auf der 48-GB-Karte mit den Einstellungen der Autoren richtig eingestuft. Die Autoren melden 74,9 % bei allen 1.018 Varianten dieses Tests. Bei GenomeQA kam es auf 65,0 %, gegenüber 63,6 % bei den Autoren.
| ClinVar-Varianten (40) | GenomeQA (60) | Tempo, eine Anfrage | |
|---|---|---|---|
| RTX A6000 48 GB, 16 Bit, Einstellungen der Autoren | 77,5 % | 65,0 % | |
| RTX A6000 48 GB, 16 Bit, Zufall aus | 80,0 % | 65,0 % | 19,5 tokens/s |
| RTX 4090 24 GB, 8 Bit, Zufall aus | 75,0 % | 66,7 % | 50,5 tokens/s |
| Autoren (volle Sets) | 74,9 % | 63,6 % |
Im direkten Vergleich, mit abgeschaltetem Zufall, kam die 4090 auf 75,0 % gegenüber 80,0 %: zwei Varianten von 40, innerhalb des Rauschens. Ihre Antworten stimmten bei 36 von 40 Varianten und 57 von 60 Fragen mit denen der 48-GB-Karte überein. Den Zufall abzuschalten hat eine Antwort von 40 verändert. Was diese Zahlen begrenzt, ist die kleine Stichprobe.
Die Fehler gehen in eine Richtung. Auf der 48-GB-Karte hat das Modell 19 der 20 schädlichen Varianten erkannt, aber nur 12 der 20 harmlosen. Es hat also 8 von 20 harmlosen Varianten als schädlich markiert. Auf einer langen, echten Liste sind das viele harmlose Fälle, die ein Mensch prüfen muss.
Auf der 4090 kommt eine vollständige Variantenfrage zu zwei Sequenzen mit je 4.096 Buchstaben in 2,4 bis 2,6 Sekunden zurück, gegenüber 7,1 bis 7,5 auf der 48-GB-Karte in 16 Bit. Der größte Teil des Gewinns kommt von den 8-Bit-Gewichten: Mit ihnen hat sogar die 48-GB-Karte dieselbe Frage in etwa 4 Sekunden beantwortet.
Wo es bricht: Das Label hält, die Begründung nicht
Die Urteile sind brauchbar, aber die Erklärungen drumherum sind oft falsch, selbst wenn das Urteil stimmt. Das zählt, weil eine Chat-Antwort in flüssigem Englisch dazu einlädt, der Begründung zu vertrauen.
Bei einer echten ClinVar-Variante, in der ein T zu einem C wurde, gab es das richtige Label mit der Begründung „The variant changes C to C“. Mit 93 Basen des Beta-Globin-Gens hat es diese korrekt in Protein übersetzt und dann gesagt, das Gen sei PKM2, ein anderes Gen. Genau davor warnen die Autoren: Das Modell „can miscount bases, confuse coordinates“ und kann die Identität einer Sequenz erfinden.
Manche Aufgaben sind auch schwach. Bei zwei der sechs GenomeQA-Aufgaben kam es auf jeweils 3 von 10, etwa so schwach, wie die Autoren melden (29,8 % und 34,6 %). Nach den nächsten 24 Basen eines menschlichen Gens gefragt, traf es etwa 29 % der Basen, wo reines Raten auf 25 % kommt. Dieses Set ist unseres, nicht der NextBase-Benchmark der Autoren (39,4 %), die beiden sind also nicht direkt vergleichbar.
Es ist kein klinisches Werkzeug, und das sagen die Autoren selbst.
Welche GPU: eine RTX 4090 mit 24 GB und 8-Bit-Gewichten, nicht die 80-GB-Karte von der Modellseite
Die kleinste Karte, die funktioniert hat, war eine echte RTX 4090 mit 24 GB, mit auf 8 Bit geschrumpften Gewichten und Platz für 8.192 Tokens pro Unterhaltung. Sie kam in der Spitze auf 21,4 GB und antwortete schneller als die 48-GB-Karte (siehe Ergebnisse).
In voller 16-Bit-Präzision brauchst du eine 48-GB-Karte. Unsere RTX A6000 zeigte 40,6 GB belegt, und das meiste davon jenseits der Gewichte ist Platz, der für den Text laufender Unterhaltungen reserviert ist. Die 80 GB auf der Model Card, für eine Datei mit 29,6 GB, sind großzügig bemessen.
Das lief auf echter Hardware und das nicht:
- Echte Karten: RTX A6000 48 GB in 16 Bit (bestanden) und RTX 4090 24 GB in 8 Bit (bestanden).
- Simuliert durch Begrenzen des Speichers auf der 48-GB-Karte: Eine Grenze von 24 GB in 8 Bit hat bestanden (77,5 % und 65,0 %). Drei Versuche mit 16 GB sind gescheitert: Zwei starteten nicht, und einer schaffte ungefähr ein Token alle fünf Sekunden.
- Nicht ausprobiert: Karten mit 32 GB und 80 GB sowie mehrere andere Modelle mit 24 und 48 GB (Liste im Anhang).
Die Grenze von 8.192 Tokens auf der 4090 ist die Hälfte dessen, was wir auf der 48-GB-Karte genutzt haben. Das Tempo bei Prompts, die länger sind als unser Variantenpaar, haben wir nicht gemessen, und auch nicht in der Nähe der Grenze des Modells von 40.960 Tokens.
Auf InferenceKey: eine Befehlszeile, bereit in sechs Minuten auf einer kalten Karte
Von einem kalten 48-GB-Worker ohne vLLM und ohne Gewichte lief Carbon-X nach 356 Sekunden auf Standard-vLLM, der Open-Source-Serving-Software, mit einer einzigen Befehlszeile. Ein Fachmodell sollte keine eigene Engine brauchen, und dieses brauchte keine. Den Großteil der Wartezeit machten die Installation von vLLM (138 Sekunden) und das Aufwärmen der Engine (136 Sekunden) aus. Das Herunterladen von 30 GB Gewichten dauerte 22 Sekunden, das Laden 30. Die 4090 war nach 262,5 Sekunden bereit. Unser SDK-Beispiel deployt das Modell auf deiner GPU-Maschine, wartet darauf, stellt zwei Fragen von der Model Card und entfernt es wieder.
Zwei Einstellungen haben die Arbeit gemacht: eine feste vLLM-Version, mit der der Tokenizer nachweislich funktioniert, und schrittweises Nachdenken, das auf dem Server abgeschaltet ist, so wie die Autoren es trainiert haben.
Ein Problem zeigt sich in der Ausgabe. Antworten, die DNA enthalten, kommen in die wörtlichen Markierungen <dna> und </dna> gehüllt zurück, und die Aufräum-Option von vLLM entfernt sie nicht. Status: offen. Die README des Beispiels sagt dir, die Tags in deinem Parser zu entfernen.
Solltest du es nutzen? Ja für die Sichtung auf deiner eigenen Karte, nein für seine Erklärungen
- Wenn du viele Varianten nach wahrscheinlicher Schädlichkeit sortieren musst, setz es ein, aber nimm keine einzelne Antwort als endgültig. Das Sichelzellen-Urteil kippte mit abgeschaltetem Zufall zu benign. Auf der 4090 dauerten 120 Fragen, jeweils 8 gleichzeitig geschickt, 45,9 Sekunden, im Median 3,3 Sekunden pro Frage. Tokens pro Sekunde unter Last haben wir nicht gemessen.
- Wenn du wissen musst, warum, verlass dich nicht auf sein Wort. Positionen, Basen und Gennamen in seinen Erklärungen waren zu oft falsch. Berechne Positionen im Code.
- Wenn deine Sequenzen das Haus nicht verlassen dürfen, ist es Apache-2.0, nicht gated und läuft auf einer einzigen 24-GB-Karte, die du kontrollierst.
- Wenn deine Karte 16 GB hat, lass es vorerst. Kein vLLM-Setup, das wir probiert haben, hat funktioniert.
Um Carbon-X die beiden DNA-Fragen der Autoren auf deiner eigenen NVIDIA-Karte zu stellen, starte python main.py aus dem Carbon-X-SDK-Beispiel. Du brauchst ein InferenceKey-Projekt mit einem SDK-Token und einem API-Key. Außerdem brauchst du eine NVIDIA-Maschine mit einem CUDA-13-Treiber (580 oder neuer) und 48 GB, oder 24 GB mit CARBON_FP8=1, dazu Zugriff auf Hugging Face beim ersten Laden. Am Ende löscht es das Deployment.
Für Ingenieure
Credits
- Carbon-X: Loubna Ben Allal, Lewis Tunstall, Dana Aubakirova, Maurizio Fiusco, Edward Beeching, Kashif Rasul, Leandro von Werra, Qiuyi Li und Diego di Bernardo, eine Zusammenarbeit von Hugging Face, Zhongguancun Academy und TIGEM / Universität Neapel Federico II. Sie haben das Modell trainiert, den Tokenizer geschrieben, die Gewichte unter Apache-2.0 veröffentlicht und ihre Trainings- und Eval-Rezepte in huggingface/carbon freigegeben.
- Basismodell: Qwen3-14B vom Qwen-Team.
- Serving: das vLLM-Projekt.
- Eval-Daten: das BioReason-Varianten-Set wanglab/variant_effect_coding vom Wang Lab und HuggingFaceBio/genomeqa.
- Wo es uns aufgefallen ist: das AI-NEWS-Video von AI Search vom 2026-10-25 (Carbon-X-Abschnitt 07:37 bis 09:27) und ein Post in r/LocalLLaMA vom 2026-10-22.
- Unser Teil: das Deployment über die Plattform, das öffentliche Eval-Set, die Messungen, die VRAM-Stufen und das SDK-Beispiel.
Modell und Dateien
HuggingFaceBio/Carbon-X, shaa5f4e199957aa2ca3e0345eb28bd1254604db2b2, Repo erstellt 2026-10-21, zuletzt geändert 2026-10-28, Apache-2.0, nicht gated.Qwen3ForCausalLM, 14.822.046.720 Parameter in BF16. 40 Layer, Hidden 5120, FFN 17408, 40 Heads mit 8 KV-Heads (GQA), Head-Dim 128, SwiGLU, RMSNorm mit QK-Norm, ungebundene Embeddings, RoPE-Basis 1e6,max_position_embeddings40.960.- Zwei Safetensors-Shards: 24.956.844.000 B + 4.687.301.152 B = 29,64 GB.
- Vokabular 157.184 = 151.669 BPE + 5.515 DNA-Tokens (4.096 6-mere, 1.364 Rest-Tokens für Längen, die kein Vielfaches von 6 sind,
<dna>,</dna>,<oov>, aufgefüllt auf ein Vielfaches von 128). - Auto-Tagging: Folgen von 6 oder mehr A/C/G/T werden in
<dna>...</dna>gehüllt. Folgen von 12 oder mehr mit bis zu 20 % IUPAC-Mehrdeutigkeitscodes werden ebenfalls getaggt. 6-mere, die nicht aus ACGT bestehen, werden zu einem<oov>.auto_dna_tags=Falseschaltet es ab. tokenizer.py(KlasseHybridDNATokenizer, überauto_map) importiert nur transformers und die stdlib. Beim ersten Laden holt sie das BPE vonQwen/Qwen3-4B-Basein einer gepinnten Revision vom Hub, der Serving-Host braucht also Hub-Zugriff. Wir haben sie gelesen, bevor wir sie ausgeführt haben.- Die Card: „Carbon-X requires Transformers v5 or later“. Die Laptop-Demo im Release-Blog ist ein 8-Bit-GGUF in llama.cpp; die Card sagt, GGUF-Runtimes würden nicht unterstützt (siehe Probleme). Nachtrainiert und evaluiert mit
enable_thinking=False.generation_config.json: temperature 0,6, top_p 0,95, top_k 20, verwendet für jedes gemeldete Ergebnis. - Training (Autoren): Vokabularerweiterung mit etwa 10B Tokens bei eingefrorenem Rumpf, Mid-Training auf 302B Tokens bei Sequenzlänge 8.192 (55 % rohe DNA, 20 % Englisch, 15 % Biologietext, 10 % Instruktionen), SFT über 3 Epochen, zwei Runden asynchrones GRPO mit abgeschaltetem Thinking.
Benchmarks der Autoren (nicht von uns nachgemessen)
Thinking aus, Standard-Sampling, eine Probe pro Aufgabe. Leaderboard-Stand 2026-10-21T13:31:46Z.
| Benchmark | Carbon-X | GPT-6.1 Sol Max | Opus 5.5 Max | Gemini 4 Argon Low |
|---|---|---|---|---|
| BioReason Coding (1.018) | 74,9 | 71,0 | 70,3 | 6,5 |
| BioReason Non-SNV (873) | 85,1 | 91,7 | 94,8 | 90,3 |
| GenomeQA (2.600) | 63,6 | 67,2 | 62,2 | 63,1 |
| NextBase (600) | 39,4 | 32,9 | 1,1 | 31,2 |
| FrontierVEP (1.000) | 70,4 | 74,9 | 76,2 | 58,0 |
| Durchschnitt | 66,7 | 67,5 | 60,9 | 49,8 |
Weitere Durchschnitte in derselben Tabelle: GLM-5.3 39,8, Kimi K3 50,4, DeepSeek V4.1 Flash 47,1. GenomeQA pro Aufgabe: Enhancer/Promoter 70,0, Splice 29,8, Eukaryote 93,2, Histone 34,6, TFBS 64,0, Motif 90,0. IFEval 79,3 % prompt-strict. Als Sub-Agent hat Carbon-X den DNA-Index von Kimi K3 von 49,4 % auf 60,5 % gehoben (100 Fragen pro Benchmark). Die Kostenangaben nutzen API-Listenpreise für die Vergleichsmodelle und den gemessenen Durchsatz von Carbon-X pro H200-Stunde zu 5 USD. Die Balken des ClinVar-Diagramms zeigen 271, 32.380, 110.724, 658.632 und 4.027.185 USD. Wir haben die Frontier-Balken den Modellen nach ihrer Reihenfolge im SVG zugeordnet, diese Zuordnung ist also nicht bestätigt.
Setup
- Lokaler InferenceKey-Manager und nats-proxy, gebaut aus
main, Worker in unserer Cloud, die Produktion wurde nie angefasst. - Backend: eingebautes
vllmmitvllm_version="0.32.0"(2026-10-18). Es pinnttransformers<5.20.0,>=5.16.1(5.19.0 installiert) undtorch==2.13.0. Das sind cu13-Wheels, der Worker braucht also einen CUDA-13-Treiber (580 oder neuer). Der Standard des Workers, vLLM 0.20.0, hat keine Obergrenze für transformers, deshalb haben wir gepinnt. - Hauptlauf: RTX A6000 48 GB, Treiber 595.91.07, CUDA 13.2. Lauf für die Stufen: RTX 4090 24 GB, gleicher Treiber.
# 48 GB card, BF16 (main run)
vllm serve HuggingFaceBio/Carbon-X --trust-remote-code --dtype bfloat16 \
  --max-model-len 16384 \
  --default-chat-template-kwargs '{"enable_thinking": false}'

# 24 GB card, FP8 at load (what CARBON_FP8=1 sends)
vllm serve HuggingFaceBio/Carbon-X --trust-remote-code --dtype bfloat16 \
  --max-model-len 8192 --quantization fp8 \
  --default-chat-template-kwargs '{"enable_thinking": false}'
Wenn du vLLM direkt aufrufst und lieber pro Anfrage steuerst, lautet die Form der Card extra_body={"chat_template_kwargs": {"enable_thinking": False}}. Die Qualität mit eingeschaltetem Thinking haben wir nicht getestet.
Schritt für Schritt mit dem SDK-Beispiel
Das Beispiel liegt unter examples/carbon-x-dna-chat-vllm-private-nvidia (Commit 4ccd5764 auf main). Das Python-SDK ist noch nicht auf PyPI, es wird also lokal mit maturin gebaut.
git clone https://github.com/inferencekey/inferencekey-sdk.git
cd inferencekey-sdk/examples/carbon-x-dna-chat-vllm-private-nvidia
cp .env.example .env        # INFERENCEKEY_SDK_TOKEN (ik_sdk_), INFERENCEKEY_API_KEY (ik_live_),
                            # INFERENCEKEY_PROJECT, IK_WORKER_ID, optional INFERENCEKEY_BASE_URL
python -m venv .venv && . .venv/bin/activate
pip install maturin
( cd ../../bindings/python && maturin develop --release )
set -a; . ./.env; set +a
python main.py                  # 48 GB card, BF16
CARBON_FP8=1 python main.py     # 24 GB card, FP8
Was main.py macht:
ensure()für einen festenvllm-Workload (task_type="text2text", eine Replika), gepinnt aufIK_WORKER_ID, mit dem Befehl oben.wait_until_ready(timeout=2400). Ein kalter Worker installiert zuerst vLLM und lädt 29,6 GB herunter.- Stellt die beiden Fragen der Model Card (die Sichelzellen-Variante in HBB und „What does this sequence encode?“) mit
max_tokens=1024, gibt Antworten, Sekunden und Tokens aus und speichertoutputs/answers.md. delete()des Workloads, außer beiIK_KEEP_ALIVE=1.
Der Worker braucht etwa 40 GB freien Plattenplatz und Hub-Zugriff für den Tokenizer.
Zeit bis bereit
| Schritt | RTX A6000, BF16, kalt | RTX 4090, FP8, kalt |
|---|---|---|
pip install vllm==0.32.0 | 138 s | 106 s |
| Download 29,6 GB | 22,0 s | 20,3 s |
| Gewichte laden | 29,5 s (27,62 GiB) | 27,9 s (15,97 GiB) |
| Engine-Init (Profiling, KV-Cache, Aufwärmen) | 135,6 s (Kompilieren 34,1 s) | 89,2 s (Kompilieren 29,5 s) |
SDK ready after | 356,0 s | 262,5 s |
Auf einer warmen A6000 (gleiches venv und gleiche Gewichte, direktes vllm serve) war die FP8-Variante mit 24-GB-Grenze nach 95 s bereit.
Tempo, eine Anfrage (Temperatur 0, Streaming)
| Karte / Konfiguration | Antwort mit 300 Wörtern | Variantenpaar 4 kbp + 4 kbp (1.445 Prompt-Tokens) |
|---|---|---|
| RTX A6000, BF16 | 19,5 tok/s, TTFT 0,17 bis 0,18 s | 135 Tokens in 7,1 bis 7,5 s |
| RTX A6000, FP8, 24-GB-Grenze | 38,4 bis 38,5 tok/s, TTFT 0,26 bis 0,31 s | 118 bis 151 Tokens in 4,0 bis 4,3 s |
| RTX 4090, FP8 | 50,5 bis 50,6 tok/s, TTFT 0,14 bis 0,15 s | 116 bis 117 Tokens in 2,4 bis 2,6 s |
| RTX A6000, BF16 + 16 GB CPU-Offload, eager | 40 Tokens in 189,1 s (0,21 tok/s) | nicht gelaufen |
Unsere Variantenfrage (8.192 Basen DNA) nutzte 1.445 Prompt-Tokens. Nebenläufigkeit wurde nicht als Tokens pro Sekunde gemessen. Die Eval-Läufe mit 8 gleichzeitigen Anfragen hatten eine mediane Latenz von 7,56 s auf der A6000 und 3,30 s auf der 4090. Das Tempo nahe dem Kontext von 40.960 Tokens ist ungemessen.
GPU-Speicher
- A6000 BF16: Gewichte 27,62 GiB, KV-Cache 10,96 GiB (71.824 Tokens bei 16.384 Kontext), vLLM reserviert vorab 0,92 der Karte,
nvidia-smi40.639 MiB. - A6000 FP8 mit 24-GB-Grenze: 22.477 MiB (Gewichte 15,81 GiB, KV 4,95 GiB = 32.432 Tokens).
- RTX 4090 FP8: Gewichte 15,97 GiB, KV 3,18 GiB (20.800 Tokens), Spitze 21.418 MiB von 24.564.
- KV-Rechnung: 40 Layer x 8 KV-Heads x 128 x 2 (K und V) x 2 B = 160 KiB pro Token, 16K Kontext sind also 2,5 GiB.
VRAM-Stufen
| GPU oder Grenze | Konfiguration | VRAM-Spitze | Zeit pro Ausgabe | Ausgabe OK | Echt oder emuliert |
|---|---|---|---|---|---|
| RTX A6000 48 GB | BF16, --max-model-len 16384, 0,92 Vorabreservierung | 40,6 GB | 7,3 s pro Variantenpaar | ja (77,5 % / 65,0 %) | echt |
| 24-GB-Grenze auf der A6000 | --quantization fp8 --gpu-memory-utilization 0.52 --max-model-len 8192 | 22,5 GB | 4,1 s | ja (77,5 % / 65,0 %, Sichelzelle 16/20) | emuliert |
| RTX 4090 24 GB | CARBON_FP8=1 über SDK ensure() | 21,4 GB | 2,5 s | ja (75,0 % / 66,7 %, Sichelzelle 16/20) | echt |
| 16-GB-Grenze auf der A6000 | --quantization bitsandbytes, 0,34 | nein: Unknown quantization method: bitsandbytes (entfernt in vLLM 0.32) | emuliert | ||
| 16-GB-Grenze auf der A6000 | FP8 + --cpu-offload-gb 6, 0,34 | nein: NotImplementedError: Cannot copy out of meta tensor; no data! | emuliert | ||
| 16-GB-Grenze auf der A6000 | BF16 + --cpu-offload-gb 16 --enforce-eager, 0,34 | 15,5 GB | 189,1 s für 40 Tokens | nein: 0,21 tok/s; mit CUDA Graphs mehr als 10 min Graph-Capture | emuliert |
Nicht ausprobiert: int8 nur für Gewichte, torchao int4, Community-GGUF, RTX 3090, L4, L40S, RTX 6000 Ada, Karten mit 32 GB in BF16 (rechnerisch kein nützlicher Platz für KV), Karten mit 80 GB, A40 (die Maschine scheiterte an SSH, nicht am Modell). Docstring und README des Beispiels führen einige davon als passend auf; gelaufen sind nur die A6000 und die 4090.
Eval-Läufe
120 Einträge, 8 gleichzeitig, über /v1/chat/completions des Managers. 109.236 Prompt-Tokens pro Lauf. 0 HTTP-Fehler, jede Antwort parsebar, kein Absturz, kein NaN und keine leere Antwort in etwa 600 Anfragen.
| Lauf | Gesamtzeit | ClinVar (40) | Recall benign / pathogen | GenomeQA (60) | Nächste 24 Basen, pro Base |
|---|---|---|---|---|---|
| A6000 BF16, Standard-Sampling | 101,2 s | 77,5 % | 60 / 95 % | 65,0 % | 29,2 % |
| A6000 BF16, Temperatur 0 | 118,9 s | 80,0 % | 65 / 95 % | 65,0 % | 27,9 % |
| A6000 FP8, 24-GB-Grenze, Temperatur 0 | 80,1 s | 77,5 % | 55 / 100 % | 65,0 % | 30,6 % |
| RTX 4090 FP8, Temperatur 0 | 45,9 s | 75,0 % | 55 / 95 % | 66,7 % | 29,6 % |
- Daten:
wanglab/variant_effect_codingv1 test (1.233 Zeilen, 1.018 eindeutige Paare, 20 + 20 gezogen, nur Sequenz, unsere feste Frage mit Ende<answer>benign|pathogenic</answer>).HuggingFaceBio/genomeqamcq_carbon_600, 10 pro Unteraufgabe, Templatemultiple_choice(cot=True)von Inspect. 20 menschliche RefSeq-mRNAs mit 300 Basen Kontext an einem zufälligen Offset. DasHuggingFaceBio/DNAIntelligenceIndexder Autoren antwortete mit HTTP 401. - GenomeQA pro Unteraufgabe, BF16 Standard (je 10): Enhancer/Promoter 60, Splice 30, Histone 30, TFBS 70, Motif 100, Eukaryote 100. Greedy: Splice 20, Histone 40.
- Übereinstimmung mit den Greedy-Antworten in BF16: Standard-Sampling 39/40 und 57/60, FP8 mit Grenze 37/40 und 56/60, 4090 36/40 und 57/60.
- Ein 95-%-Intervall um 77,5 % von 40 beträgt grob plus oder minus 13 Punkte.
Details zur Qualität
- Sichelzellen-Beispiel (erste 55 Basen von HBB, GAG zu GTG an Base 20, Glu6Val, Gen nicht angegeben), 20 Proben mit Standard-Sampling: 16 pathogen / 4 benign auf A6000 BF16, FP8 mit Grenze und 4090. Temperatur 0 in BF16: „Answer: Benign“. BF16 nennt in 12 von 20 „position 21“, die FP8-Läufe nennen in 16 und 18 von 20 die 20. „GAG“ / „GTG“ tauchen in 6 bis 9 von 20 auf. Keine Probe erwähnt Glutamat, Valin oder Sichelzellen.
- „What does this sequence encode?“ (36 Basen von HBB): MVHLTPEEKSAV auf beiden Karten korrekt. Die A6000 fügte „has a stop codon at the end“ hinzu (falsch). Keine nannte Beta-Globin. Mit 93 Basen bei Temperatur 0: korrekte Übersetzung, dann „PKM2 (pyruvate kinase M2)“.
- Echtes Paar
Task1_test_581(DNAAF11, ClinVar pathogen,CATGGCzuCACGGC): jedes Mal als pathogen eingestuft, Begründungen „a C>A transversion, changing ATG to AAG“ und „The variant changes C to C, so ATG becomes ACG“. - Die Next-Base-Antworten waren immer genau 24 Basen innerhalb von
<dna>-Tags, mehrere mit geringer Komplexität (AAAAAAAAAAAAAAAAAAAAAAAA). Bewertet mit dem Extraktor der Autoren (seqrecqa.py).
Probleme
<dna>-Tags in der Ausgabe. Antworten mit DNA kommen in wörtliche<dna>...</dna>gehüllt zurück, undskip_special_tokensentfernt sie nicht. Status: offen. In der README des Beispiels dokumentiert; um sie herum parsen.- Unzuverlässige Erklärungen. Eine Grenze des Modells, die die Autoren dokumentieren. Status: offen, kein Fix auf unserer Seite außer mehrfachem Sampling und dem Berechnen von Positionen im Code.
- Kein Weg mit 16 GB in vLLM 0.32. Siehe die Stufen. Status: offen; int8 nur für Gewichte, torchao int4 und GGUF nicht ausprobiert.
ensure()legt die Zuweisung mitmax_in_flight1 an. Bekannt seit 2026-10-15. Wir haben es pro Lauf mitPATCH /api/projects/<pid>/assignments/<workload>/<worker>auf 8 erhöht. Status: offen auf der Plattform.- A40-Maschine ohne SSH. Sie lief 180 s, ohne direktes SSH bereitzustellen, und der Manager hat sie nach 3,1 Minuten beendet. Wir sind auf die RTX A6000 gewechselt (gleiche Chipfamilie, gleiche 48 GB). Status: durch die Prüfung des Managers abgefangen.
- Gateway-Streams enthalten kein
usage. Die Token-Zahlen stammen aus den Stream-Chunks. Status: offen. - Warnung „Using a slow tokenizer“ vom Python-DNA-Tokenizer. Kein sichtbarer Effekt auf den Durchsatz.
- Card und Blog widersprechen sich bei GGUF. Die Card sagt, llama.cpp und GGUF-Runtimes würden nicht unterstützt. Die 16-s-Demo des Release-Blogs führt
llama-cli -m models/Carbon-X/carbon-x-q8_0.ggufauf einem Apple M5 Max mit 34,1 t/s auf dem Bildschirm aus, und ihr eigenes gekürztes Peptid „MVHLP ... (MVHLPEEKSV)“ ist falsch. Die README unseres Beispiels wiederholt die Card. Ob es ein öffentliches GGUF-Repo gibt, haben wir nicht geprüft. - Unsere Ausrutscher, ohne Einfluss auf die Ergebnisse. Ein Regex in einer Warteschleife hat die Bootstrap-Zeile der 4090 verpasst, sie stand also etwa 6 Minuten untätig. Eine leere
IK_WORKER_IDließ das ersteensure()auf der 4090 mit 422 scheitern. Unser erster Next-Base-Regex hat die Tags nicht erwartet und 0 % gewertet.
Demovideo
Das vertonte Video von 154,5 s behandelt das Modell, die Beispiele und die Benchmark-Tabelle der Autoren, unseren Test und die GPU-Stufen.
Quellen
- Model Card: huggingface.co/HuggingFaceBio/Carbon-X
- Release-Blog: HuggingFaceBio/Carbon-X-Release (gelesen aus der rohen
index.htmldes Space und den Abbildungsdateien) - Code und Rezepte: github.com/huggingface/carbon
- Wo es uns aufgefallen ist: AI Search, AI NEWS, 2026-10-25
- SDK-Beispiel: carbon-x-dna-chat-vllm-private-nvidia