Ming-3.0-tts klont eine Stimme in etwa 3 GB GPU-Speicher, spricht aber langsamer als in Echtzeit
Das MIT-Sprachmodell von inclusionAI auf einer 16-GB-Karte: 2,9 GB Spitze, 17 von 19 Zeilen wortgenau, stabile Klone, etwa 0,65x Echtzeit.
Wir wollten wissen, ob ein Sprachmodell mit 3 GB wirklich auf einer kleinen Grafikkarte läuft. Ming-3.0-tts-0.5B ist ein Modell unter MIT-Lizenz von inclusionAI, dem KI-Labor der Ant Group, und die Autoren nennen nur Tests auf Rechenzentrumskarten mit 80 GB und 96 GB Speicher. Auf einer RTX 2000 Ada mit 16 GB brauchte es in der Spitze 2,9 GB, und mit nur 3 GB erlaubtem Speicher, wie auf einer kleinen Karte, erzeugte es exakt dasselbe Audio. Wir haben ein Lachen und ein Seufzen in eine Textzeile geschrieben: Jedes Wort kam richtig heraus, und die Wellenform zeigt Ausschläge genau dort, wo das Lach-Tag stand. Wenn du eigene GPUs betreibst, heißt das: Eine kleine Karte kann eine Stimme klonen, aus einem Satz eine neue erfinden und Spanisch genauso sprechen wie Englisch. Der Haken ist das Tempo: etwa 1,5 Sekunden Arbeit für jede Sekunde Sprache. Es passt also zu aufgenommener Sprecherstimme, nicht zu einem Live-Voice-Agent. Unser SDK-Beispiel deployt es in etwa einer Minute auf deiner eigenen GPU.
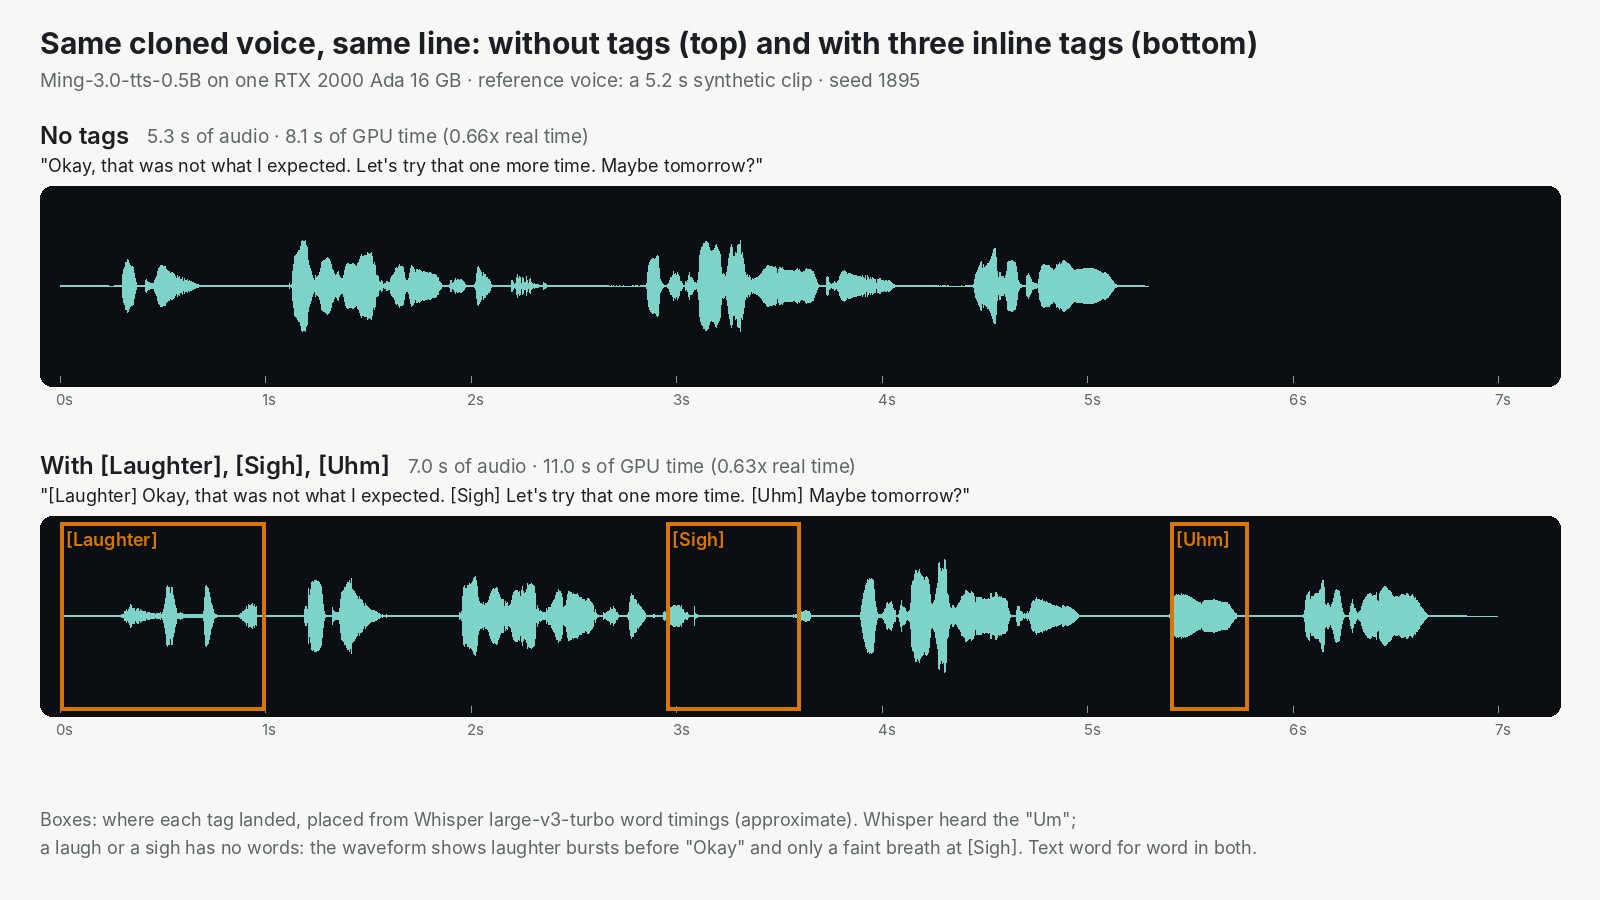
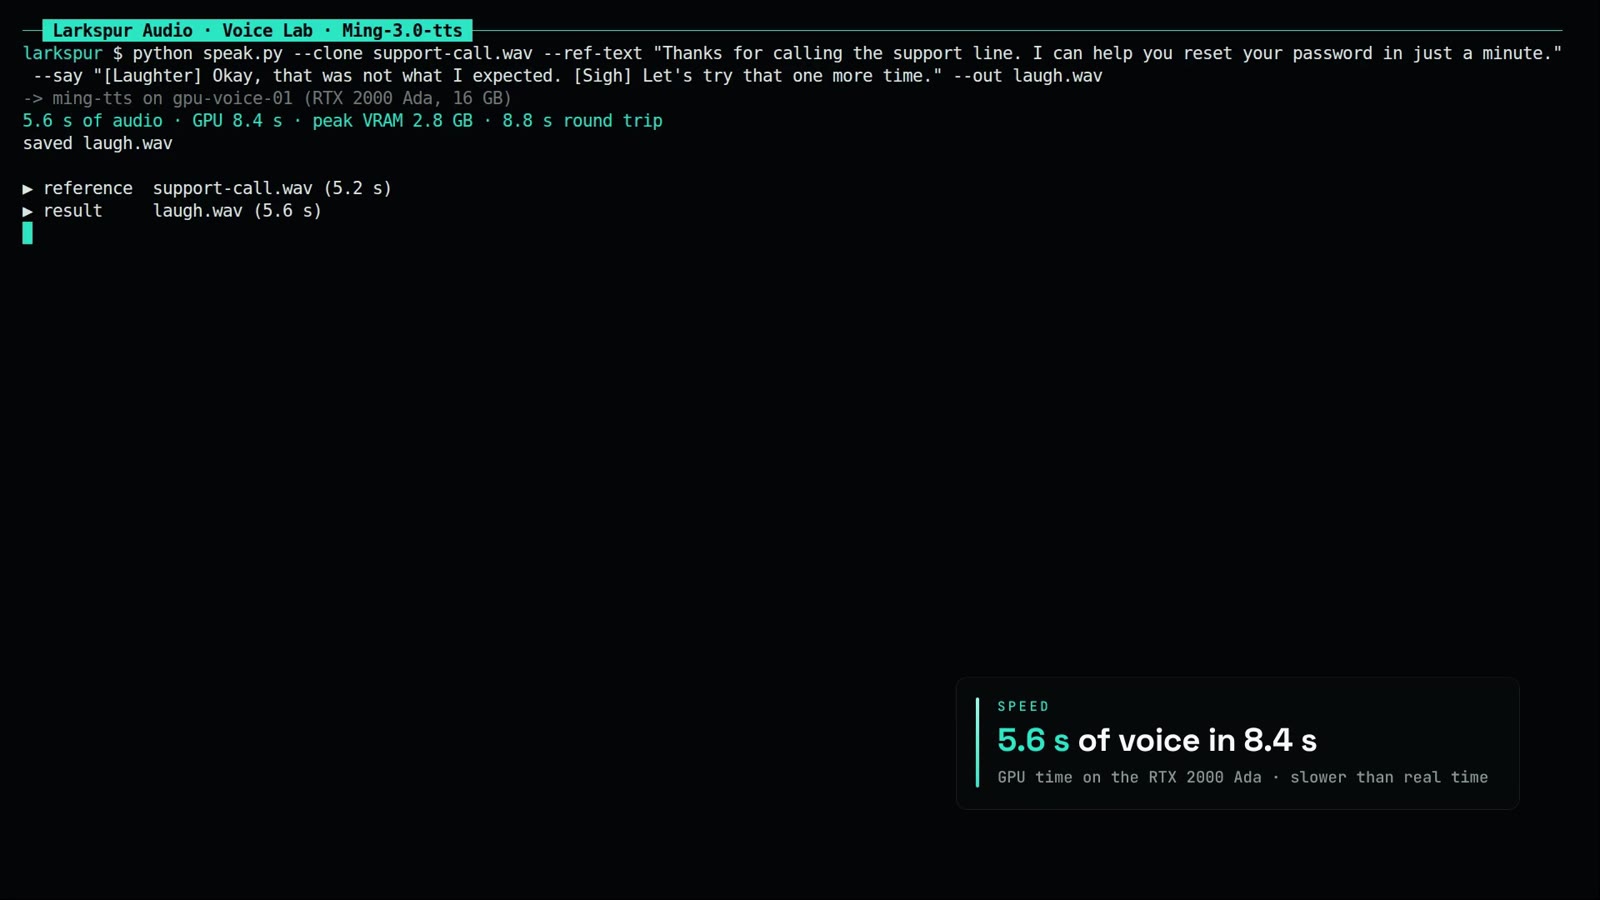
Gleiche Stimme, gleiche Zeile, gleiche Karte. Die drei Tags in eckigen Klammern brachten 1,7 Sekunden Klang dazu. Die Wörter kamen beide Male richtig heraus.
- Ohne Tags (5,3 s)
- Mit [Laughter], [Sigh] und [Uhm] (7,0 s)
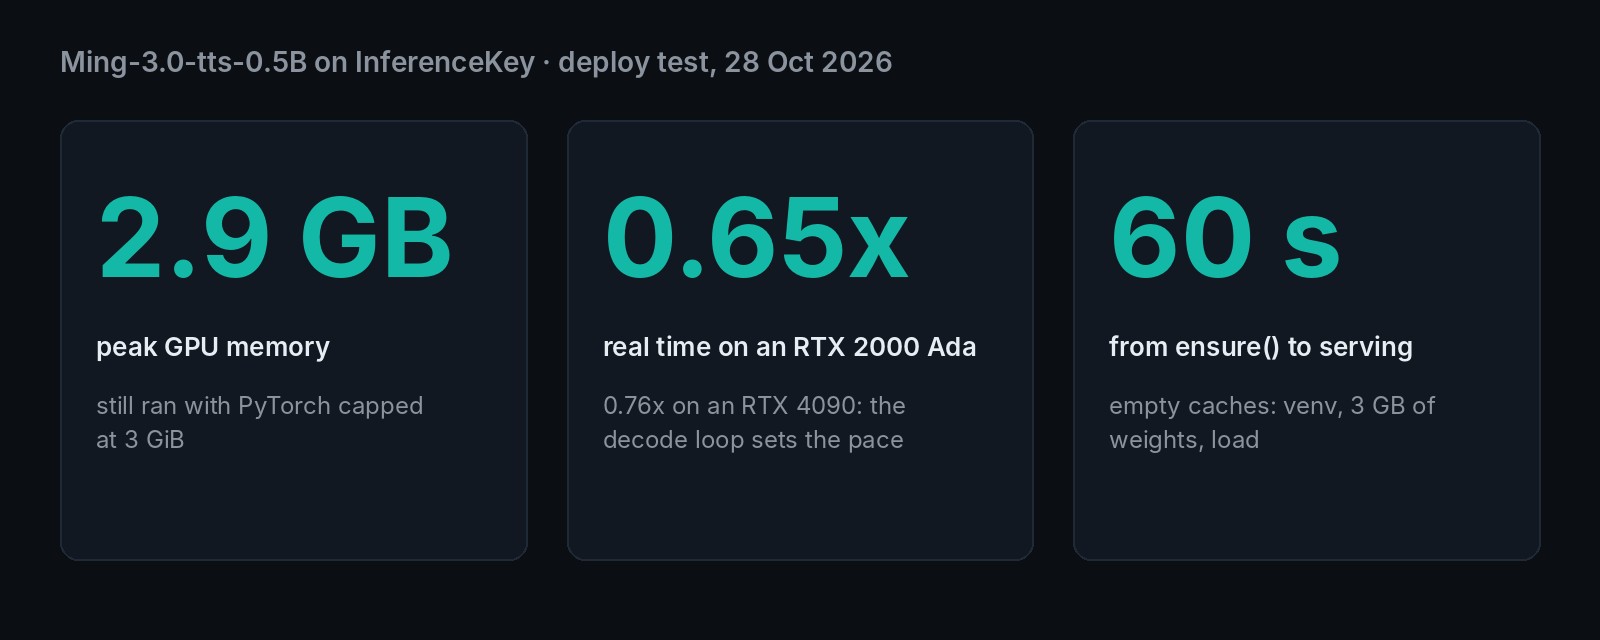
Was die Modellseite verspricht: fünf Wege, eine Stimme zu formen, in einem Download von 3 GB
Die Modellseite nennt fünf Wege, eine Stimme zu formen. Es klont eine Stimme aus einem kurzen Clip. Es baut eine neue Stimme aus einer schriftlichen Beschreibung („voice design“). Es folgt frei formulierten Anweisungen, wie eine Zeile gesprochen werden soll. Es bringt fertige englische und chinesische Stimmen mit. Und es versteht 14 Inline-Tags, Wörter in eckigen Klammern wie [Laughter], [Sigh], [Cough] oder [Uhm], die mitten im Satz zu Geräuschen werden.
Die Seite nennt Chinesisch, Englisch, Deutsch, Spanisch, Französisch, Koreanisch und Japanisch, dazu zwei chinesische Dialekte.
Das Verdienst für das Modell gehört dem inclusionAI-Team der Ant Group. Es hat die Gewichte und den Code unter MIT veröffentlicht, was kommerzielle Nutzung erlaubt, mit eigenen Benchmarks und einem ehrlichen Abschnitt zu den Grenzen. In ihren Tests liegt Ming bei etwa 1,6 falschen englischen Wörtern von 100, zwischen zwei konkurrierenden offenen Modellen (1,45 und 1,83). Auf Spanisch sind es etwa 1,1 von 100. Beim Treffen einer schriftlichen Stimmbeschreibung auf Chinesisch erreicht es 72,3 % gegenüber 77,1 % bei Qwen3-TTS. Nichts davon haben wir selbst nachgemessen.
Entdeckt haben wir es im News-Video von AI Search vom 25. Oktober. Der Moderator sagte, das kleine Modell sei „only around three gigabytes, so you should be able to run it on many consumer GPUs.“
Die Modellseite sagt etwas Engeres: „Tested on NVIDIA H800-80GB and H20-96G with CUDA 12.4.“ Das sind Rechenzentrumskarten, und die Autoren nennen weder einen Speicherbedarf noch eine kleinere GPU. Unser Teil war der Rest: ihren Code verpacken, ihn auf einer kleineren Karte laufen lassen und die Ausgabe prüfen.
Der Test: eine 16-GB-Karte, 19 Zeilen in drei Sprachen, maschinell geprüft
Wir haben den Code der Autoren unverändert auf einer RTX 2000 Ada mit 16 GB laufen lassen. Das ist eine kleine Workstation-Karte mit einem Power-Limit von 70 Watt. Wir haben 19 Testzeilen auf Englisch, Spanisch und Chinesisch geschickt, dazu drei Kontrollen: zwei Zeilen ohne ihre Tags und eine mit ausgeschriebenen Zahlen. Abgedeckt waren Klonen, Voice Design, freie Anweisungen, fertige Stimmen und Tags, dazu Zahlen und Absätze bis 21 Sekunden. Dann haben wir fünf davon auf einer RTX 4090 wiederholt, um zu sehen, ob eine schnellere Karte es beschleunigt.
Zum Klonen brauchten wir eine Stimme, die niemandem gehört. Die Referenz war deshalb eine synthetische Support-Hotline-Zeile von 5,2 Sekunden aus einer Standardstimme von Pocket TTS, einem kleinen Sprachmodell von Kyutai, das wir ebenfalls betreiben. Das folgt der eigenen Regel der Autoren: niemanden ohne Zustimmung imitieren und synthetische Sprache als synthetisch kennzeichnen.
- Referenzstimme: synthetisch (5,2 s)
Geprüft hat eine Maschine. Whisper, das Spracherkennungsmodell von OpenAI, hat jeden Clip transkribiert. Ein Sprechererkennungsmodell hat bewertet, wie nah jeder Klon an der Referenz klingt, von 0 (keine Verwandtschaft) bis 1 (identisch). Bei uns hat niemand die Clips angehört. Wir können dir also sagen, dass die Wörter stimmten und die Stimme passte, aber nicht, wie natürlich es klingt. Die Referenz war außerdem der einfache Fall: ein sauberer synthetischer Clip, keine echte Stimme aus einem Laptop-Mikrofon oder einer Telefonleitung. Jede Zeile lief nur einmal.
Ergebnisse: 17 von 19 Zeilen Wort für Wort, und Klone, die die Stimme auch auf Spanisch halten
Der Text war fast immer exakt. Von 19 Zeilen kamen 17 Wort für Wort zurück, auf Englisch, Spanisch und Chinesisch, einschließlich Absätzen von 18 bis 21 Sekunden. Beide Fehler betrafen Zahlen, dazu mehr im nächsten Abschnitt.
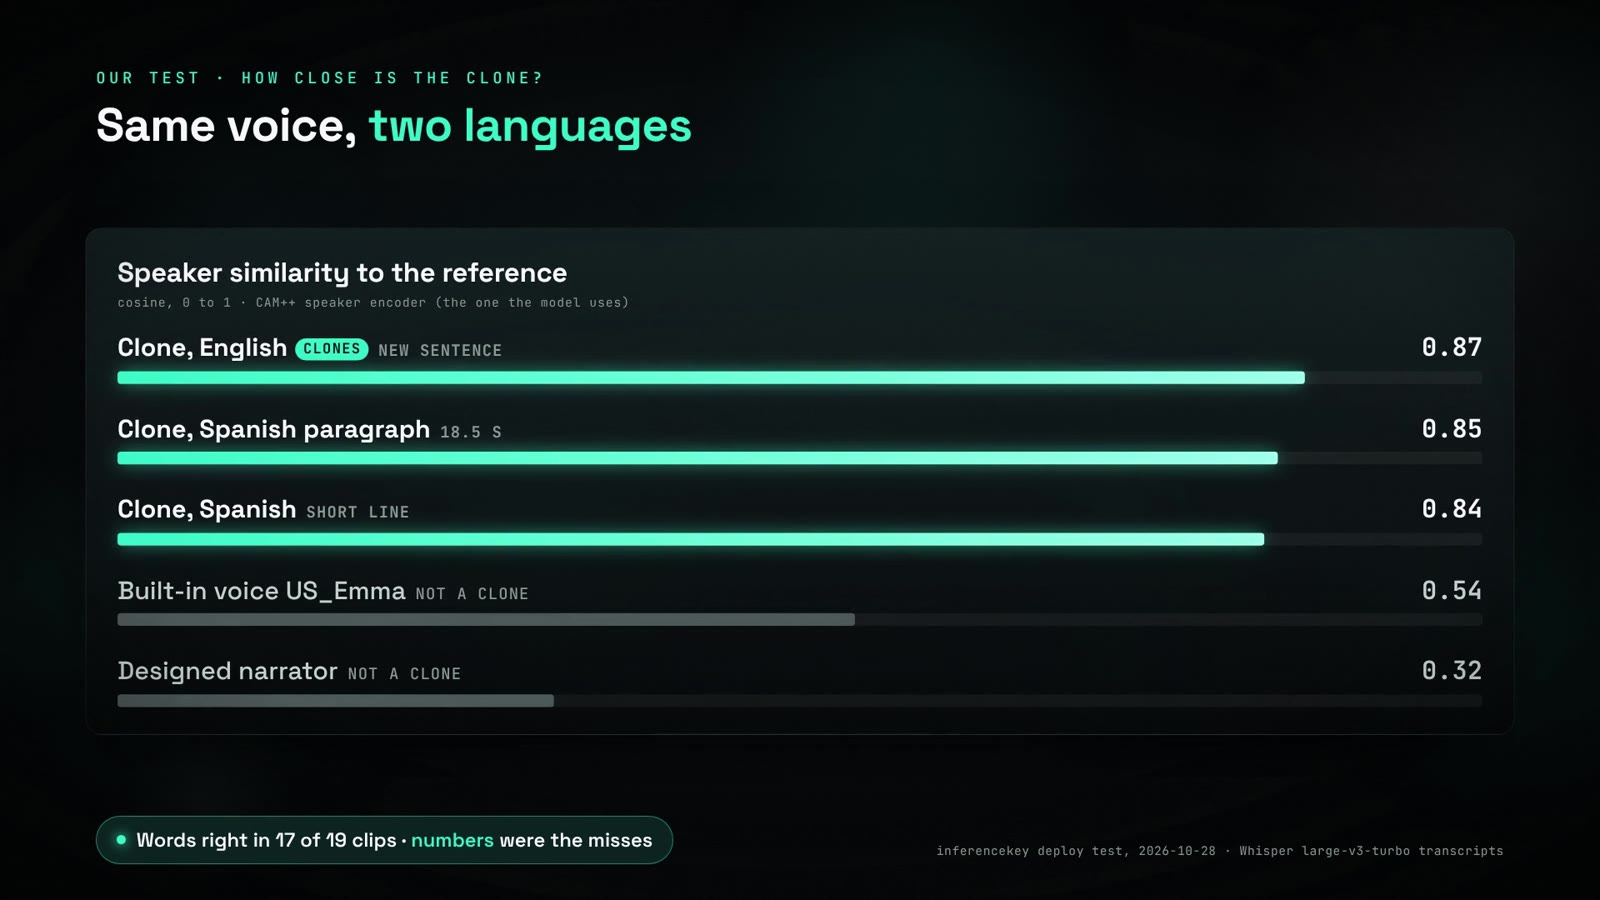
Die Klone hielten, sogar über Sprachen hinweg: Aus einer englischen Referenz behielt der spanische Klon die Stimme so gut wie der englische.
| Clip | Dieselbe Stimme wie die Referenz? (0 bis 1) |
|---|---|
| Englischer Klon | 0,87 |
| Englischer Klon mit Tags | 0,85 |
| Spanischer Klon, aus der englischen Referenz | 0,84 |
| Fertige Stimme US_Emma (kein Klon) | 0,54 |
| Entworfene Erzählerstimme (kein Klon) | 0,32 |
Eine Einschränkung: Unser Bewertungsmodell ist dasselbe, mit dem Ming selbst eine Stimme erfasst, es neigt also zu Mings Gunsten. Ein zweiter, unabhängiger Prüfer stimmte zu, ist aber nachsichtig: Er bewertete auch eine andere Frauenstimme als nah an unserer weiblichen Referenz.
- Klon auf Englisch (4,6 s)
- Derselbe Klon auf Spanisch (7,0 s)
Die Tags erzeugten echte Geräusche, aber nur einige lassen sich prüfen. Clips mit Tags waren 1,3 bis 1,7 Sekunden länger als dieselben Zeilen ohne. Whisper schrieb „Um“ dort, wo [Uhm] stand, und „Huh?“ für [Question-huh]. Lachen hat keine Wörter, aber die Wellenform zeigt es. Das Seufzen ist kaum zu sehen. Tags haben wir nur auf Englisch getestet. Die Autoren dokumentieren sie für englischen und chinesischen Text, Tags in spanischem Text sind also ungetestet.
Voice Design brachte jedes Wort richtig. Wir haben unter anderem nach „a gravelly old sea captain in his seventies, amused and a little hoarse“ gefragt, und jede entworfene Zeile kam Wort für Wort zurück. Die entworfenen Stimmen unterscheiden sich deutlich von unserer Referenz (0,25 bis 0,32). Ob jede Stimme zu ihrer Beschreibung passt, haben wir nicht gemessen.
- Entworfene Stimme: ein alter Seekapitän (6,4 s)
Wo es bricht: Zahlen, und Sprache, die langsamer entsteht, als sie abläuft
Zahlen sind unzuverlässig, und das Modell ist auf jeder Karte, die wir probiert haben, langsamer als Echtzeit.
Zahlen. Die beiden Fehler kamen aus dem Schritt, der geschriebenen Text in zu sprechende Wörter verwandelt. Auf Englisch wurde 4521 als „four thousand five hundred twenty, one“ gelesen, mit einer Pause. Eine Telefonnummer, 555-0142, wurde als „five hundred fifty-five minus one hundred forty-two“ gelesen. Spanisch überspringt diesen Schritt ganz. Deshalb kam „1.249,99 euros, un 12,5 %“ verstümmelt heraus. Die Zahlen als Wörter zu schreiben, hat den englischen Fall nicht behoben. Wenn ein Preis oder eine Bestellnummer wichtig ist, prüf das Audio.
- Falsch gelesene Zahlen (16,1 s)
Tempo. „Echtzeit“ heißt: eine Sekunde Audio in einer Sekunde erzeugt. Auf der RTX 2000 Ada brauchte ein englischer Absatz von 20,7 Sekunden 31 bis 32 Sekunden, und jede Zeile außer einem chinesischen Ausreißer lief in diesem Tempo. Die RTX 4090, eine weit schnellere Karte, machte einen Absatz von 20,9 Sekunden in 27 Sekunden. Das sind etwa 17 % schneller, und ein Teil davon kann vom anderen Prozessor der 4090-Maschine kommen.
Die Karte war nicht der Engpass. Die kleine Karte war weniger als ein Drittel der Zeit beschäftigt, die 4090 höchstens ein Fünftel. Ming schreibt Audio in Scheiben von 80 Millisekunden, eine nach der anderen. Zwischen den Scheiben erledigt eine in Python geschriebene Schleife ihre Buchhaltung und reicht die nächste Scheibe an die Karte weiter. In der Zeit, in der 12,5 Scheiben ablaufen, macht sie etwa 8,5: zwei Drittel des Tempos. Stell dir einen Session-Gitarristen vor, der darauf wartet, dass der Bandleader jeden Akkord ansagt: Engagierst du einen schnelleren Gitarristen, läuft der Song trotzdem im Tempo des Bandleaders.
Die Roadmap der Autoren markiert die Unterstützung für eine schnellere Serving-Engine, vLLM-Omni, als erledigt. Diesen Weg haben wir nicht probiert, ob er das Tempo behebt, ist also offen.
Eine Anfrage war viel langsamer: Das eigene chinesische Voice-Design-Beispiel der Autoren brauchte 50 Sekunden für 5 Sekunden Audio, weil das Modell nie entschied, dass ein Textstück fertig war. Auf Englisch oder Spanisch haben wir das nicht gesehen.
Welche GPU: auf 3 GB begrenzt, war das Audio identisch
Das kleinste Setup, das funktionierte: unsere 16-GB-Karte, auf der das Modell nur 3 GB ihres Speichers nutzen durfte, mit Standardeinstellungen. Das Audio war Byte für Byte identisch mit dem unbegrenzten Lauf, bei gleichem Tempo.
Der Treiber braucht etwa 0,4 GB obendrauf, daher schätzen wir, dass eine 4-GB-Karte reicht, ungetestet.
Keine echte Karte unter 16 GB lief. Wir haben zweimal eine RTX 3080 Ti mit 12 GB probiert, und beide Maschinen kamen ohne den Fernzugang hoch, den unser Setup braucht, also hat keine von beiden das Modell je ausgeführt. 8-GB-Karten waren nicht verfügbar. Ein kleinerer Chip könnte außerdem langsamer sein als unserer, und dafür haben wir keine Zahl.
Auf InferenceKey: bereit in 60 Sekunden, mit dem eigenen Code der Autoren hinter einer API
Auf deiner eigenen GPU kannst du den Code der Autoren so laufen lassen, wie er ist, ohne darauf zu warten, dass ihn jemand verpackt, und unserer bediente nach 60,3 Sekunden Anfragen. InferenceKey hat keine fertige Unterstützung für Ming, und die Autoren liefern es als Python-Code aus, also haben wir diesen Code hinter eine API gestellt. Unser eigenes Backend ist eine kurze Python-Datei, die InferenceKey auf deiner GPU-Maschine installiert und ausführt. Sie holt den Code der Autoren in einer festen Version, lädt die Gewichte herunter und lädt das Modell einmal. Deine App ruft es dann so auf wie die Chat-API von OpenAI und bekommt das WAV in der Antwort zurück.
Von einer sauberen Maschine aus ging etwa die Hälfte dieser Zeit für die Installation der Python-Bibliotheken drauf. Die 3 GB Gewichte brauchten 7 Sekunden zum Herunterladen und unter 3 Sekunden zum Laden. Mit allem schon auf der Platte dauerte ein Neustart etwa 13 Sekunden. Das Backend beantwortet eine Anfrage nach der anderen, mehrere gleichzeitig haben wir nicht getestet.
Eine Ecke, an der du auch hängen bleiben wirst:
- Apps, die für OpenAI gebaut sind, fragen Sprache an einer eigenen Adresse an, und diese Adresse kann das Audio eines eigenen Backends noch nicht zurückgeben. Das Beispiel nutzt deshalb die Chat-Adresse und liest das Audio aus dem Text der Antwort. Status: offen, verfolgt als IK-531.
Solltest du es nutzen? Ja für aufgenommene Sprecherstimme auf einer kleinen Karte, nein für Live-Stimme
- Wenn du Voice-overs, Hörbuchproben oder vertonte Demos machst, lohnt es sich. Eine kleine Karte gibt dir Klonen, entworfene Stimmen und Tags, und die Lizenz erlaubt kommerzielle Nutzung. Die Wörter und die Stimmähnlichkeit hielten den maschinellen Prüfungen stand. Hör dir die Proben oben an, bevor du dich festlegst.
- Wenn du einen Voice-Agent brauchst, der in Echtzeit antwortet, such vorerst woanders. Es erzeugt Sprache langsamer, als sie abläuft, und eine größere Karte hilft kaum.
- Wenn dein Text Preise, Telefonnummern oder Daten enthält, prüf jede einzelne im Audio.
- Wenn du Spanisch brauchst, ist es für geklonte Sprecherstimme brauchbar, mit von Hand geprüften Zahlen. Unsere frühere spanische Pocket-TTS-Stimme lief auf einer Desktop-CPU schneller als Echtzeit (1,05x), Ming mit 0,61 bis 0,77x auf einer GPU. Ihre Qualität haben wir nicht verglichen.
- Wenn deine Karte klein ist, schätzen wir, dass etwa 4 GB Speicher reichen, ungetestet (siehe den Abschnitt zur GPU).
Um vier Zeilen auf deiner eigenen NVIDIA-GPU zu hören, veröffentlichst du das Backend mit python publish.py und startest python main.py aus dem SDK-Beispiel. Du bekommst eine fertige Stimme, eine entworfene Stimme, einen Klon mit einem Lachen und einem Seufzen und denselben Klon auf Spanisch. Du brauchst ein InferenceKey-Projekt mit einem SDK-Token und einem API-Key. Deine GPU-Maschine braucht einen aktuellen NVIDIA-Treiber (CUDA 12.4 oder neuer) und etwa 3 GB freien GPU-Speicher.
Für Ingenieure
Modell und Dateien
Model Card, GitHub (inclusionAI/Ming-3.0-tts), Benchmarks der Autoren. Repo inclusionAI/Ming-3.0-tts-0.5B, erstellt 2026-09-22, lastModified 2026-10-27T12:07:15Z, sha 7247f4c94a5b2e987404ed28a5cfec41b1a4ca61, Lizenz MIT, nicht gated, Pipeline text-to-speech, 5.546 Downloads und 156 Likes am 28.10.2026.
model.safetensors: 2.959.055.504 B. Safetensors-Metadaten: 1.479.454.868 Parameter (1.479.454.804 BF16 plus 64 F32).campplus.onnx(Speaker-Encoder): 28.303.423 B. Das ganze Repo etwa 3,0 GB, einschließlich eines PDFs mit 390.569 B (Ming-3.0-tts-0.5B-TDS2026.pdf) und Abbildungen.- Tabelle der Model Card: dense, Backbone Qwen2.5-0.5B, 0.5B Parameter. Die Gewichtsdatei speichert insgesamt etwa 1.48B; wo der Rest sitzt, schlüsseln die Autoren nicht auf. Ebenfalls auf der Card: Sprachen zh, en, de, es, fr, ko, ja, Dialekte Sichuanisch und Kantonesisch, Python-API
ming_tts.MingTTS, CLIinfer.py, 44,1 kHz. - Die 14 Tags:
[Breathing],[Cough],[Sigh],[Laughter],[Surprise-ah],[Surprise-oh],[Dissatisfaction-hnn],[Uhm],[Confirmation-en],[Question-ei],[Question-ah],[Question-en],[Question-oh],[Question-huh]. Dokumentiert für chinesischen oder englischen Text, case-sensitive, an der Textnormalisierung vorbeigeleitet (cookbooks/instruction_en.md,frontend/toolkit.py). - Tasks:
TTS,FREEFORM,VOICE_DESIGN,MULTILINGUAL,BASIC,EMOTION,DIALECT,IP. - Angabe zur Hardware: „Tested on NVIDIA H800-80GB and H20-96G with CUDA 12.4. flash-attn is optional; inference falls back to PyTorch SDPA.“ Keine kleinere GPU und keine VRAM-Angabe.
- Code auf Commit
9332fb9443325d4726ce02cefd4ec1c211df4079(2026-10-27, „docs: align recommended voices, catalogs and examples“), der Commit, den unser Backend pinnt. Davor:028c1eac(2026-10-21, Fix für das Aufteilen langer Texte),e999c39f(2026-10-19, „mark vLLM-Omni support“).requirements.txtpinnt torch 2.6.0, torchaudio 2.6.0, transformers 4.46.3, accelerate 1.3.0, x_transformers 2.9.2, diffusers 0.33.0, soundfile 0.12.1, dazu onnxruntime, inflect, einops. pynini 2.1.6 (Textnormalisierung) und flash_attn 2.7.4.post1 sind optional. Ein Docker-Image wird angeboten (torch 2.6, CUDA 12.4, transformers 4.46.3). MingTTSlädt intorch.bfloat16(fest einprogrammiert) aufcuda:0. Standardwerte vonsynthesize():cfg=2.0,sigma=0.25,temperature=0.0,max_length=24(Fragment-Aufteilung),max_decode_steps=1000. Text mit einerlanguage_idaußer zh/en umgeht den FST-Normalizer („Non-zh/en text is passed through unchanged“).- Decode-Schleife (
modeling_bailingmm.py): pro Schritt ein LLM-Forward plus ein Flow-Matching-Head (FlowLoss.sample, standardmäßig 10 Schritte, mit CFG), bis ein Stop-Head auslöst. Der statische KV-Cache mit 512 Positionen begrenzt das Budget auf 512 minus die Prompt-Länge. Das Audio-VAE nutzt Hop 882 bei 44.100 Hz mit patch_size 4, ein Schritt sind also 80 ms Audio, und Echtzeit braucht 12,5 Schritte/s. Wir haben etwa 8,3 bis 8,9 Schritte/s gemessen. - Das Schwestermodell, Ming-3.0-tts-tiny, ist ein MoE auf Ling V3 (7.9B gesamt, 1.3B aktiv), braucht eine eigene Umgebung (Python 3.10.15, torch 2.7.1+cu118), empfiehlt eine H800 und ist das einzige mit Podcast-Dialog mehrerer Sprecher. Wir haben es nicht laufen lassen.
- Ranglisten, die die GitHub-README beansprucht (Artificial Analysis, Oktober 2026): Platz 1 unter offenen Gewichten bei Controlled Voice (Elo 1069, Platz 13 insgesamt), Platz 1 insgesamt bei Pronunciation Robustness (93,2 %), Platz 3 unter offenen Gewichten bei Provider Voice (Elo 1188, Platz 17 insgesamt). Die README sagt nicht, ob das für 0.5b oder tiny gilt. Wir haben artificialanalysis.ai nicht geprüft.
Benchmarks der Autoren (nicht von uns nachgemessen)
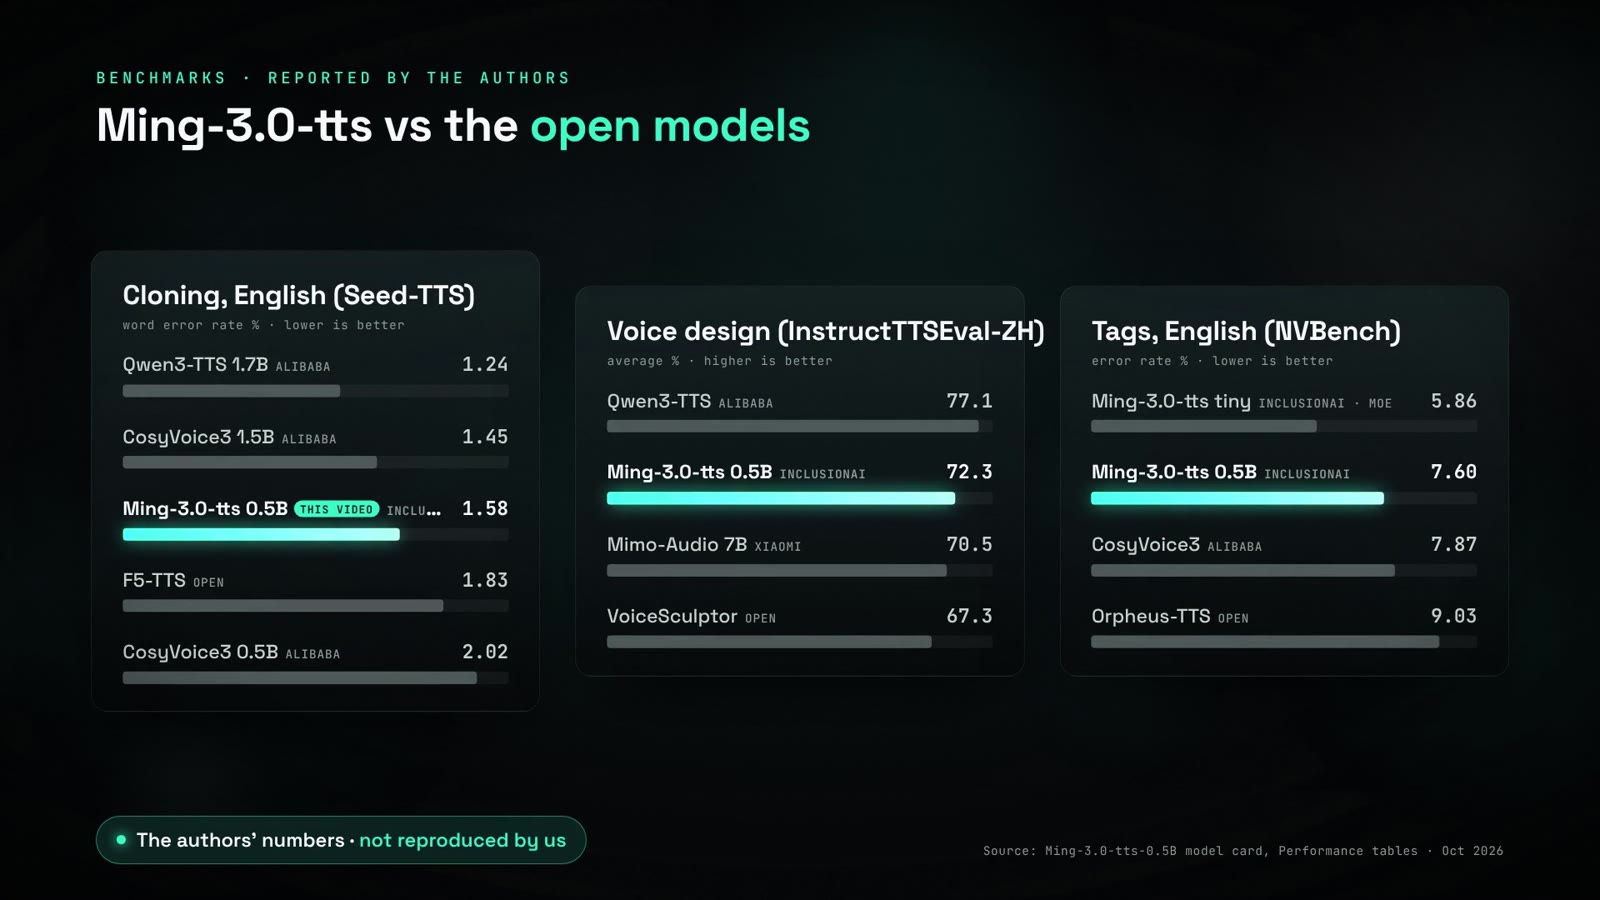
| Test | Ming-3.0-tts-0.5B | Andere in der Tabelle der Autoren |
|---|---|---|
| Seed-TTS EN WER (niedriger ist besser) | 1,584 % (SIM 0,691) | Qwen3-TTS-12Hz-1.7B 1,24, CosyVoice3-1.5B 1,45, F5-TTS 1,83, CosyVoice3-0.5B 2,02 |
| Seed-TTS ZH WER | 0,800 % | |
| MiniMax mehrsprachige WER | Deutsch 0,365 %, Spanisch 1,099 % (SIM 0,763), Französisch 4,264 % (SIM 0,675) | |
| InstructTTSEval-ZH Voice Design, Durchschnitt | 72,29 % | Qwen3-TTS 77,13, Ming tiny 75,37, Mimo-Audio-7B-Instruct 70,50, VoiceSculptor 67,30 |
| NVBench English Single CER | 7,60 | Ming tiny 5,86, CosyVoice3 7,87 |
Grenzen laut den Autoren: Die Sprecherähnlichkeit ist schwächer als die inhaltliche Genauigkeit (Französisch-SIM ist die deutlichste Lücke). NVBench Multi liegt hinter Single, die Stabilität bei mehreren Tags pro Satz wird also noch besser. Emotion ist schwieriger, wenn die Wörter kein emotionales Signal tragen. Die Tonhöhe ist weniger genau, und offenes Voice Design reicht noch nicht an das stärkste bewertete System heran. Der Nutzungshinweis verbietet, eine reale Person ohne Zustimmung zu imitieren, und verlangt, synthetische Sprache als synthetisch zu kennzeichnen.
Setup
- Eine RTX 2000 Ada 16 GB in unserer Cloud (Treiber 595.91.07, Compute Capability 8.9, Limit 70 W, Host AMD EPYC 7352 mit 6 vCPUs), als Worker bei einem lokalen InferenceKey-Manager registriert. Die Produktion wurde nie angefasst. Eine RTX A4000 und eine RTX 4000 Ada waren nicht verfügbar.
- Tempo-Check: eine RTX 4090 24 GB (450 W, Host AMD EPYC 75F3), 5 Fälle.
- Eigenes Backend
ming-3-tts-05b0.1.0 (Paket mit 7.215 Byte).setup()holt das Ming-Quell-Tarball auf dem gepinnten Commit (ohneming_tiny, Abbildungen, Docker, Cookbooks), führtsnapshot_downloadder gepinnten Revision aus (ohne PDF und Abbildungen), bautMingTTS(model_dir, device, text_normalization=True)mit dem Wheel pynini 2.1.6.post1, wendet ein optionalesMING_VRAM_LIMIT_GIBübertorch.cuda.set_per_process_memory_fractionan und wärmt mit der fertigen Stimme US_Emma auf. bf16, SDPA, Standardwerte der Autoren, Seed 1895. - Referenzstimme: synthetischer englischer Clip von 5,22 s aus unserer lokalen Pocket-TTS-Standardstimme „anna“: „Thanks for calling the support line. I can help you reset your password in just a minute.“ Spanische Klon-Zeile: „Gracias por llamar. Su nueva contraseña ya está lista; por favor, vuelva a iniciar sesión en todos sus dispositivos.“
- Prüfungen auf dem Pod:
openai/whisper-large-v3-turbomit pro Fall erzwungener Sprache, CAM++ (campplus.onnx, der Encoder, auf den Ming konditioniert) undmicrosoft/wavlm-base-plus-sv(unabhängig).
Zeit bis bereit
| Phase | Zeit |
|---|---|
ensure() bis bereit, leere Caches, RTX 2000 Ada | 60,3 s |
| davon: Worker baut das Backend-venv | etwa 32 s |
| davon: Backend-Setup | 26,4 s (Quellcode 0,9 s, Gewichte 7,1 s, Laden 2,7 s, Aufwärmen 3,7 s) |
| Warme Neustarts (venv und Gewichte im Cache) | 13,1, 12,9, 12,7, 13,2 s |
ensure() bis bereit, leere Caches, RTX 4090 | 47,3 s |
Pro Anfrage, RTX 2000 Ada
Nicht-streamendes POST /endpoint/<project>/ming-tts/v1/chat/completions. GPU s ist die synchronisierte Zeit des Backends um synthesize(). Round Trip auf dem Client gemessen, durch einen Tunnel.
| Fall | Task | Audio s | GPU s | x Echtzeit | Spitze alloc MiB | Round Trip s | Whisper hörte |
|---|---|---|---|---|---|---|---|
| en-ip-george | IP UK_George | 5,3 | 8,39 | 0,63 | 2.919 | 8,52 | exakt |
| en-ip-emma | IP US_Emma | 8,2 | 12,95 | 0,63 | 2.924 | 13,18 | exakt („I am“ für „I'm“) |
| en-freeform-coach | FREEFORM | 4,9 | 7,79 | 0,63 | 2.890 | 8,01 | exakt |
| en-freeform-whisper | FREEFORM („Whisper, tense and frightened“) | 2,9 | 4,79 | 0,61 | 2.888 | 4,96 | exakt |
| en-design-narrator | VOICE_DESIGN | 4,2 | 6,71 | 0,63 | 2.926 | 6,91 | exakt |
| en-design-captain | VOICE_DESIGN | 6,4 | 10,03 | 0,64 | 2.927 | 10,24 | exakt |
| en-design-girl | VOICE_DESIGN | 3,5 | 5,66 | 0,62 | 2.922 | 5,84 | exakt |
| en-clone | TTS + Referenz | 4,5 | 7,07 | 0,64 | 2.916 | 7,53 | exakt |
| en-clone-tags | TTS + Referenz, [Laughter] [Sigh] [Uhm] | 7,0 | 11,02 | 0,63 | 2.922 | 11,49 | exakt + „Um,“ |
| en-clone-notags (Kontrolle) | gleicher Text, ohne Tags | 5,3 | 8,05 | 0,66 | 2.917 | 8,62 | exakt |
| en-ip-tags | IP, [Breathing] [Cough] [Question-huh] | 5,5 | 8,71 | 0,63 | 2.924 | 8,92 | Text + „Huh?“ |
| en-ip-notags (Kontrolle) | gleicher Text, ohne Tags | 4,2 | 6,40 | 0,66 | 2.920 | 6,58 | exakt |
| en-numbers | IP US_Emma | 16,1 | 25,04 | 0,64 | 2.936 | 25,32 | Zahlen falsch |
| en-numbers-words (Kontrolle) | Zahlen als Wörter ausgeschrieben | 5,9 | 8,92 | 0,66 | 2.920 | 9,12 | „Order Number 40, 520, 1 ... 2020, 6.“ |
| en-long | IP UK_George, 61 Wörter | 20,7 | 32,41 | 0,64 | 2.923 | 32,96 | exakt |
| es-clone | MULTILINGUAL es + englische Referenz | 6,9 | 10,48 | 0,66 | 2.920 | 10,85 | exakt |
| es-ip-emma | IP US_Emma + language_id es | 7,6 | 11,60 | 0,66 | 2.927 | 11,79 | exakt |
| es-design | VOICE_DESIGN + es | 4,9 | 7,64 | 0,64 | 2.930 | 7,82 | exakt |
| es-freeform | FREEFORM + es | 5,7 | 8,62 | 0,66 | 2.894 | 8,83 | exakt |
| es-long | MULTILINGUAL es, 52 Wörter | 18,5 | 28,01 | 0,66 | 2.922 | 28,61 | exakt |
| es-numbers | MULTILINGUAL es | 11,4 | 17,08 | 0,67 | 2.927 | 17,99 | Zahlen falsch |
| zh-design-authors | VOICE_DESIGN, das chinesische Beispiel der Autoren | 5,0 | 49,84 | 0,10 | 2.988 | 50,00 | exakt |
- Round Trip minus GPU-Zeit: 0,13 bis 0,9 s (base64-WAV durch den Tunnel und den Message-Bus, ein Clip von 20 s ist roh etwa 1,8 MB). Über mehrere Läufe brauchte der Absatz von 20,7 s 31,0 bis 32,4 s GPU-Zeit.
zh-design-authors: Der Text wurde in zwei Fragmente geteilt, und das erste lief das ganze Decode-Budget durch (343 Schritte, 41 s, der Stop-Head löste nie aus), bevor die Stille am Ende abgeschnitten wurde.- GPU-Speicher: 2.846 MiB allokiert nach dem Laden, 2.888 bis 2.936 MiB Spitze allokiert pro Anfrage (2.988 MiB beim chinesischen Ausreißer). nvidia-smi-Spitze der Karte 3.336 MiB, einschließlich des CUDA-Kontexts. GPU-Auslastung 23 bis 31 %, etwa 24 W von 70 W.
- Das Backend bedient eine Anfrage nach der anderen (ein Lock plus Workload-Concurrency 1). Kein Paralleltest.
- Mit demselben Seed sind die Ausgaben pro Karte deterministisch, unterscheiden sich aber leicht zwischen Karten (5,2 gegenüber 5,3 s bei en-ip-george, 7,0 gegenüber 6,4 s beim Kapitän).
Tempo-Check auf der RTX 4090
| Fall | Audio s | GPU s | x Echtzeit | Round Trip s |
|---|---|---|---|---|
| en-ip-george | 5,2 | 6,85 | 0,76 | 8,44 |
| en-design-captain | 7,0 | 9,05 | 0,77 | 9,62 |
| en-clone-tags | 6,9 | 8,94 | 0,77 | 9,80 |
| en-long | 20,9 | 27,11 / 27,79 | 0,77 / 0,75 | 27,94 / 28,49 |
| es-clone | 6,9 | 9,23 | 0,75 | 9,93 |
nvidia-smi während en-long: 3.562 MiB, 14 bis 20 % Auslastung, etwa 81 W von 450 W. Die Schrittschleife ist durch Kernel-Launches und die CPU begrenzt. Wie viel der etwa 17 % Gewinn von der schnelleren Host-CPU kommt, haben wir nicht getrennt.
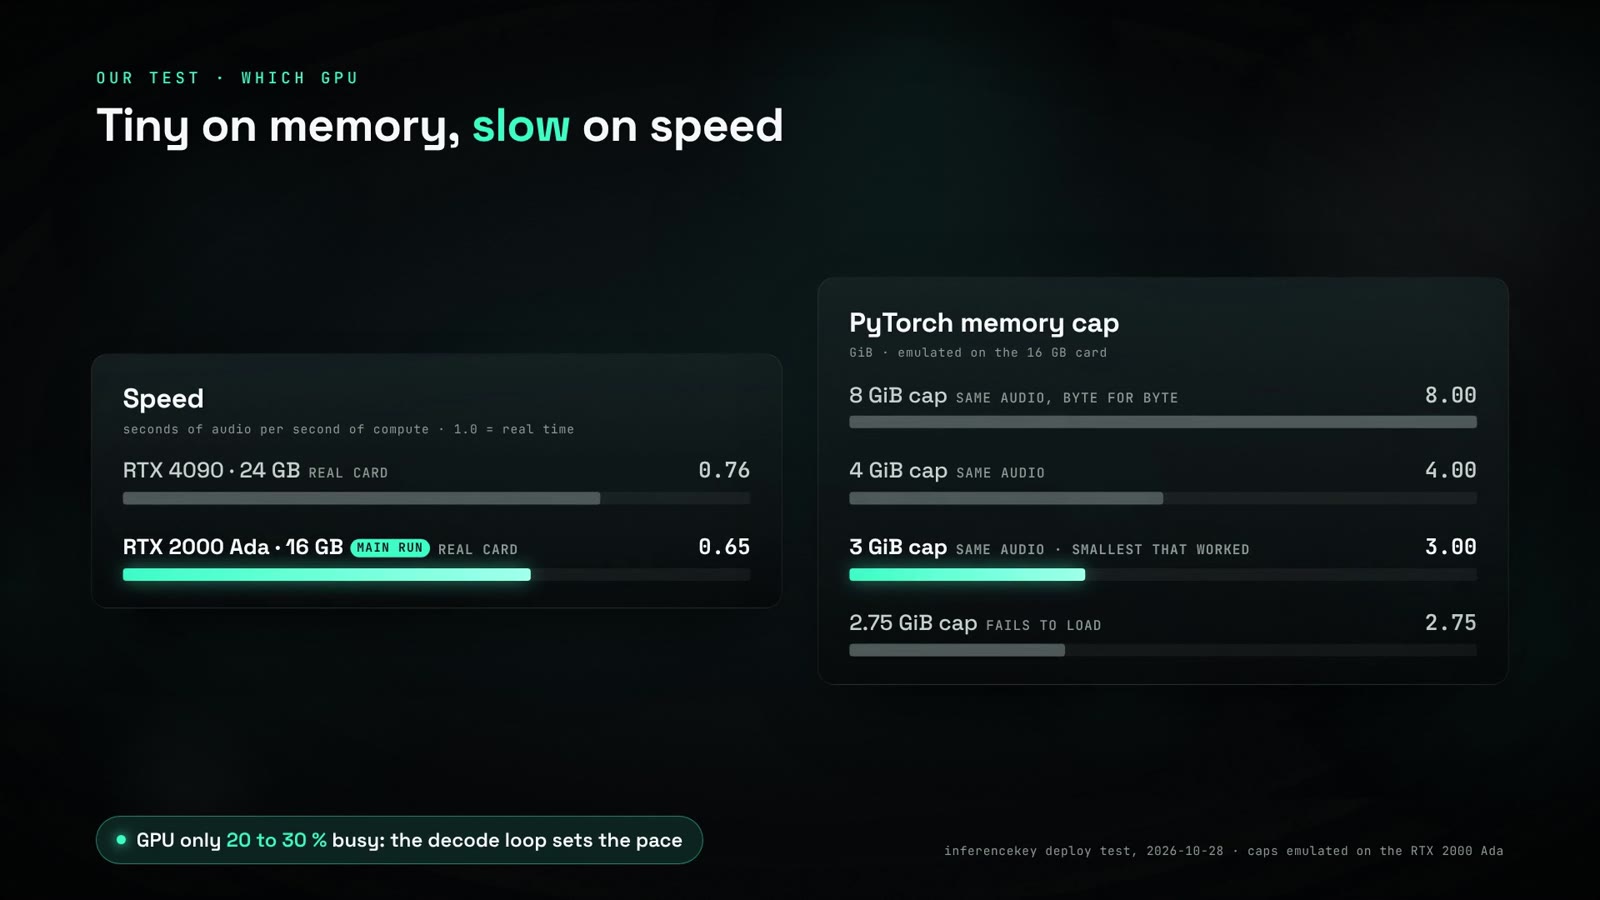
VRAM-Stufen
Der Haupttext rundet diese Grenzen auf GB; die genauen Werte sind GiB. Grenzen gesetzt mit MING_VRAM_LIMIT_GIB (torch.cuda.set_per_process_memory_fraction) auf der RTX 2000 Ada, jede mit einem frischen ensure() bei warmen Caches. WAVs von en-clone-tags, en-ip-george, en-long und es-clone per md5 mit dem unbegrenzten Lauf verglichen.
| Stufe | Konfiguration | Spitze alloc | Tempo | Ausgabe | Echt oder emuliert |
|---|---|---|---|---|---|
| RTX 4090 24 GB | bf16, SDPA, Standard | 2.923 MiB (3.562 MiB Karte) | 0,75 bis 0,77x | Text exakt in der Teilmenge | echt |
| RTX 2000 Ada 16 GB | bf16, SDPA, Standard (Hauptlauf) | 2.936 MiB (3.336 MiB Karte) | 0,61 bis 0,68x | Referenz | echt |
| Grenze 8 GiB | MING_VRAM_LIMIT_GIB=8 | 2.923 MiB | 0,66 bis 0,67x | byte-identisch | emuliert |
| Grenze 4 GiB | MING_VRAM_LIMIT_GIB=4 | 2.923 MiB | 0,64 bis 0,66x | byte-identisch | emuliert |
| Grenze 3 GiB | MING_VRAM_LIMIT_GIB=3 | 2.923 MiB | 0,65 bis 0,68x | byte-identisch | emuliert |
| Grenze 2,75 GiB | MING_VRAM_LIMIT_GIB=2.75 | setup() failed: CUDA out of memory. Tried to allocate 20.00 MiB ... this process has 2.83 GiB memory in use. 2.75 GiB allowed | emuliert | ||
| RTX 3080 Ti 12 GB | zwei Versuche | die Maschine kam ohne direktes SSH hoch (kein Mapping für Port 22), und der Manager beendete sie nach 180 s, zweimal | echt, nie gelaufen |
Nicht probiert: jede echte Karte unter 16 GB, fp16 auf Karten vor Ampere, flash-attn, vLLM-Omni, CPU.
Details zur Qualität
- Wörter: 17 von 19 Bench-Clips Wort für Wort. Die Teilmengen der Stufen und der 4090 gaben identischen Text.
- Englische Zahlen. Die Ausgabe des Normalizers im Backend-Log war
Order number four thousand, five hundred twenty,one ships on March three , two thousand twenty,six and costs one thousand, two hundred forty,nine point nine nine dollars , about twelve point five percent less than last year. Call five hundred fifty,five minus one hundred forty,two .Der Bindestrich wird zu einem Komma voller Breite (eine Pause), und die Telefonnummer 555-0142 wird als Subtraktion gelesen. Whisper hörte „Order number 4520. One ships ... costs $1,240, $9.99 ... Call 550-5-142“. Die Zahlen als Wörter zu schreiben, hat es nicht vermieden („forty-five twenty-one“ wurde zu „40, 520, 1“). - Spanische Zahlen überspringen den Normalizer: „1.249,99 euros, un 12,5 %“ wurde als „1.1249.99 euros, un 2,5%“ gehört.
- Sprecherähnlichkeit, CAM++-Kosinus gegen die Referenz: en-clone 0,865, en-clone-tags 0,849, es-clone 0,838, es-long 0,853, es-numbers 0,836. Nicht-Klone 0,162 (Chinesisch) bis 0,540 (US_Emma). Entworfene Stimmen 0,25 bis 0,32. WavLM-SV: Klone 0,924 bis 0,970, aber auch die fertige Stimme US_Emma (eine Frauenstimme wie die Referenz) 0,84 bis 0,86, WavLM trennt also schwächer. Sprachübergreifendes Klonen (englische Referenz, spanische Ausgabe) behielt die Stimme nach beiden Maßen so gut wie Klonen in derselben Sprache.
- Tags: 7,0 gegenüber 5,3 s (Klon,
[Laughter][Sigh][Uhm]) und 5,5 gegenüber 4,2 s (fertige Stimme,[Breathing][Cough][Question-huh]). Die Tag-Kästen im Titelbild stammen aus den Wort-Zeitstempeln von Whisper und sind ungefähr. Kein Hörtest durch Menschen. - Voice Design und freie Anweisungen auf Englisch und Spanisch gaben exakten Text. Zu den Prompts gehörten „A gravelly old sea captain in his seventies, amused and a little hoarse...“ und „Whisper, tense and frightened, very quietly and slowly.“ Ob die Stimme zur Beschreibung passt, wurde nicht gemessen.
- Kein Absturz, kein NaN und keine leere Ausgabe in etwa 60 Anfragen.
- Kein direkter Vergleich auf Spanisch mit unserem früheren spanischen Pocket-TTS-Fine-Tune: kein gleicher Text, kein gemeinsamer Prüfer, kein Hören. Der einzige Kontrast ist das Tempo, auf unterschiedlicher Hardware: Dieser Fine-Tune lief mit 1,05x Echtzeit auf einer Desktop-CPU, Ming mit 0,61 bis 0,77x auf GPU.
Schritt für Schritt mit dem SDK-Beispiel
Das SDK-Beispiel ist Commit b038dd7529651076b5055604584c1fd1b51f517c auf inferencekey-sdk main: backend.py, publish.py, main.py, requirements.txt, README.md, .env.example, .gitignore.
Du brauchst ein SDK-Token (ik_sdk_), einen API-Key (ik_live_), einen Projekt-Slug und einen registrierten NVIDIA-Worker (IK_WORKER_ID) mit einem Treiber für CUDA 12.4 oder neuer und etwa 3 GB freiem VRAM. INFERENCEKEY_TENANT_ID und INFERENCEKEY_USER_TOKEN sind optional. Ohne sie lädst du dist/*.tar.gz unter Dashboard, Custom backends hoch und schaltest Chat in den Endpoint-Einstellungen des Workloads von Hand ein.
cp .env.example .env        # fill in real values
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )
python publish.py           # once: packages backend.py and uploads it
python main.py              # ensure -> wait until ready -> 4 WAV files in ./outputs
main.py deployt den Workload (ensure(), Policy fixed, eine Replica), schaltet die Chat-Route ein, wartet, bis er bereit ist, schreibt vier WAVs und löscht den Workload beim Beenden (IK_KEEP_ALIVE=1 lässt ihn stehen). Unser Lauf mit IK_KEEP_ALIVE=1:
| Ausgabe | Audio | GPU-Zeit | x Echtzeit |
|---|---|---|---|
| 1-built-in-voice (UK_George) | 5,3 s | 7,899 s | 0,67 |
| 2-voice-design (narrator) | 4,2 s | 6,12 s | 0,69 |
3-clone-with-tags ([Laughter], [Sigh]) | 6,0 s | 9,124 s | 0,66 |
| 4-clone-spanish | 4,3 s | 7,201 s | 0,60 |
VRAM-Spitze 2.912 bis 2.926 MiB. Bereit nach 60,3 s.
Form der Anfrage. Der Text ist die letzte User-Nachricht, eine Referenz geht als input_audio-Teil mit, und Optionen kommen in extra_body (task, language_id, style, instruction, voice, prompt_text, seed, cfg, sigma). Der Message-Content der Antwort ist ein JSON-String mit audio_b64 (16-Bit-WAV, 44,1 kHz), seconds, task und timings (gpu_s, total_s, realtime_factor, peak_vram_mib). Grenzen: 600 Zeichen Text und 30 s Referenz pro Anfrage.
import base64, json, os, requests

base = os.environ.get("INFERENCEKEY_BASE_URL", "https://cloud.inferencekey.com").rstrip("/")
project = os.environ["INFERENCEKEY_PROJECT"]
api_key = os.environ["INFERENCEKEY_API_KEY"]
slug = os.environ.get("MING_WORKLOAD_SLUG", "ming-tts")
ref_b64 = base64.b64encode(open("reference.wav", "rb").read()).decode()
REFERENCE_TRANSCRIPT = "Thanks for calling the support line. I can help you reset your password in just a minute."

body = {
    "model": "default",
    "messages": [{"role": "user", "content": [
        {"type": "text", "text": "[Laughter] I did not expect that at all. [Sigh] Well, let's try one more time."},
        {"type": "input_audio", "input_audio": {"data": ref_b64, "format": "wav"}},
    ]}],
    "extra_body": {"task": "TTS", "prompt_text": REFERENCE_TRANSCRIPT, "language_id": "en", "seed": 1895},
}
r = requests.post(f"{base}/endpoint/{project}/{slug}/v1/chat/completions",
                  headers={"Authorization": f"Bearer {api_key}"}, json=body, timeout=600)
out = json.loads(r.json()["choices"][0]["message"]["content"])  # IK-531 workaround
open("clone.wav", "wb").write(base64.b64decode(out["audio_b64"]))
Für Spanisch, Deutsch, Französisch, Koreanisch oder Japanisch nimm "task": "MULTILINGUAL" mit "language_id": "es" (und so weiter). Für eine entworfene Stimme nimm "task": "VOICE_DESIGN" mit "style". Für eine fertige Stimme nimm "task": "IP" mit "voice": "UK_George".
Probleme
- Langsamer als Echtzeit auf beiden Karten (0,61 bis 0,77x), bei 14 bis 31 % GPU-Auslastung. Die Python-Schrittschleife der Autoren gibt das Tempo vor. Die Unterstützung für vLLM-Omni ist in ihrer Roadmap als erledigt markiert. Diesen Weg haben wir nicht probiert.
- Zahlen: Englische Zahlwörter mit Bindestrich bekommen eine Pause, und Telefonnummern werden zu Subtraktionen. Spanische Zahlen überspringen den Normalizer und kommen verstümmelt heraus. Status: Verhalten upstream, offen. Prüf Zahlen in der Ausgabe.
- Das chinesische Voice-Design-Beispiel lief einmal ans Decode-Limit: 49,8 s für 5 s Audio. Auf Englisch oder Spanisch nicht gesehen.
/v1/audio/speechkann die Ausgabe eines eigenen Backends nicht transportieren: Das Beispiel nutzt die Chat-Route undjson.loadsauf den Message-Content. Offen, IK-531.- Backend-Upload auf unserer Entwicklungsmaschine abgelehnt (
XMinioStorageFull, Platte zu etwa 99 % voll). Für den Lauf behoben, indem wir eigene Dateien gelöscht haben. Ein Problem der Testumgebung, das du nicht sehen wirst. - RTX-3080-Ti-Maschinen ohne direktes SSH (zweimal): Der Worker ließ sich nicht installieren, und der Manager beendete jede nach 180 s.
- Kosmetisch: Das Panel zeigte bei Access ein Badge „No access“, während ein Wildcard-Key funktionierte.
- Warnungen upstream beim Laden, bei korrekter Ausgabe:
You are using a model of type dense to instantiate a model of type bailingmm,Sliding Window Attention is enabled but not implemented for sdpaund eine Deprecation vonpast_key_valuesin transformers.
Weitere Proben
- Spanischer Absatz, geklonte Stimme, 52 Wörter (18,6 s)
- Fertige Stimme UK_George (5,3 s)
- Entworfene Stimme: ein junges Mädchen (3,5 s)
- Entworfene Stimme: ein ruhiger Erzähler (4,2 s)
- Freie Anweisung: „Whisper, tense and frightened“ (3,0 s)
Demovideo
Ein Rundgang von 191 Sekunden: die eigenen Demo-Clips der Autoren (mit Nennung von inclusionAI, Ant Group), ihre Benchmarks, unser Test als Fragen und Antworten und die Frage nach der GPU. Englische Untertitel.
Quellen
- Model Card: https://huggingface.co/inclusionAI/Ming-3.0-tts-0.5B (HF-API abgerufen am 2026-10-28)
- Code: https://github.com/inclusionAI/Ming-3.0-tts auf Commit
9332fb94, einschließlichrequirements.txt,ming_tts.py,modeling_bailingmm.py,fm/flowloss.py,cookbooks/instruction_en.md - Benchmarks und Ranglisten-Angaben der Autoren: https://github.com/inclusionAI/Ming-3.0-tts#performance
- Wo wir es entdeckt haben: News-Video von AI Search vom 2026-10-25, Kapitel bei 13:33, https://www.youtube.com/watch?v=EfyQOAJjx1A
- Unser SDK-Beispiel: https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/ming-3-tts-05b-speech-custom-backend-private-nvidia
- Unsere Messungen: Deploy-Test vom 2026-10-28 (Logs von Bench, Stufen und 4090, Zusammenfassungen pro Fall, Ergebnisse von Whisper und Sprecherähnlichkeit, nvidia-smi-Samples)