Ming-3.0-tts clone une voix avec environ 3 GB de mémoire GPU, mais parle plus lentement que le temps réel
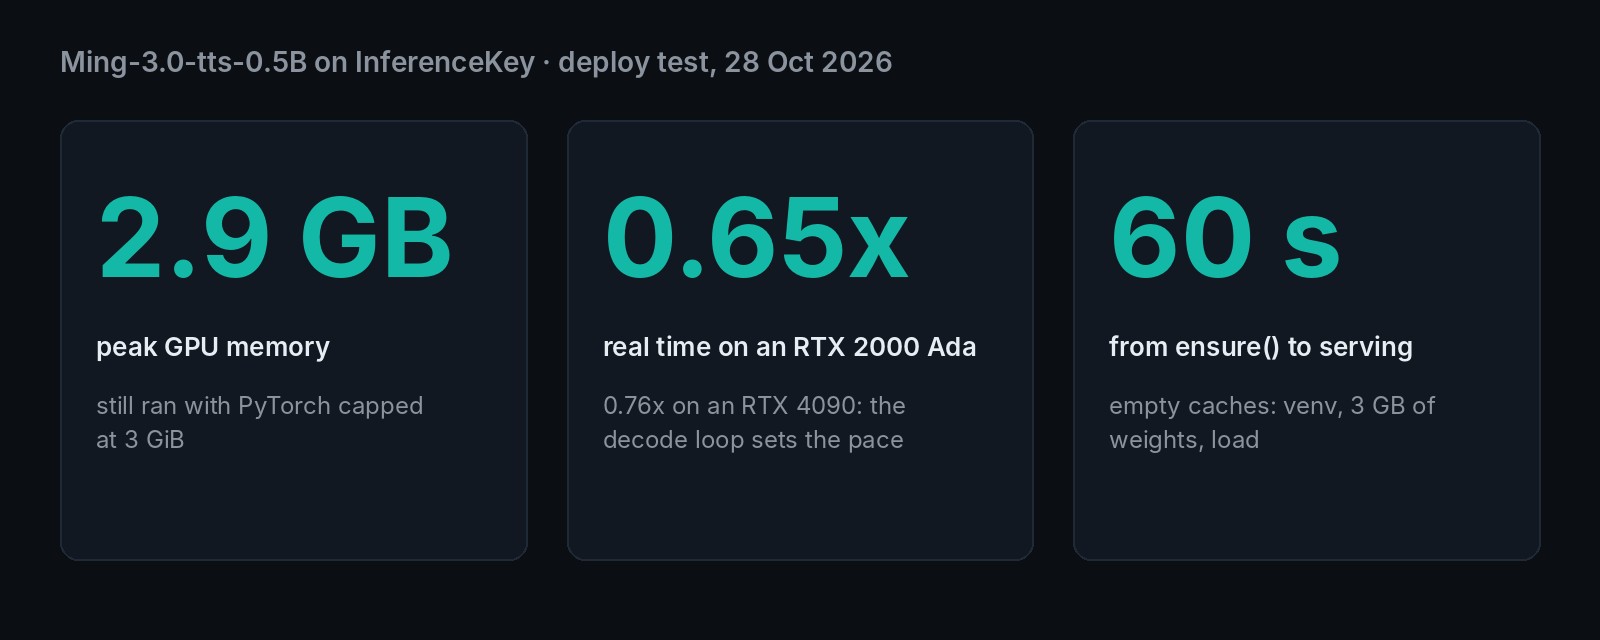
Le modèle vocal MIT d'inclusionAI sur une carte de 16 GB : 2,9 GB au pic, 17 phrases sur 19 mot pour mot, des clones fidèles, environ 0,65x le temps réel.
Nous voulions savoir si un modèle vocal de 3 GB tourne vraiment sur une petite carte graphique. Ming-3.0-tts-0.5B est un modèle sous licence MIT d'inclusionAI, le laboratoire d'IA d'Ant Group, et ses auteurs ne citent que des tests sur des cartes de data center de 80 GB et 96 GB de mémoire. Sur une RTX 2000 Ada de 16 GB, il lui a fallu 2,9 GB au pic, et il a produit exactement le même audio quand on ne lui laissait que 3 GB, comme sur une petite carte. Nous avons glissé un rire et un soupir dans une ligne de texte : chaque mot est sorti juste, et la forme d'onde montre des salves là où se trouvait la balise du rire. Si vous faites tourner vos propres GPU, cela veut dire qu'une seule petite carte peut cloner une voix, en inventer une nouvelle à partir d'une phrase et parler espagnol aussi bien qu'anglais. Le problème, c'est la vitesse : environ 1,5 seconde de travail pour chaque seconde de parole. Il convient donc à la narration enregistrée, pas à un agent vocal en direct. Notre exemple du SDK le déploie sur votre propre GPU en une minute environ.
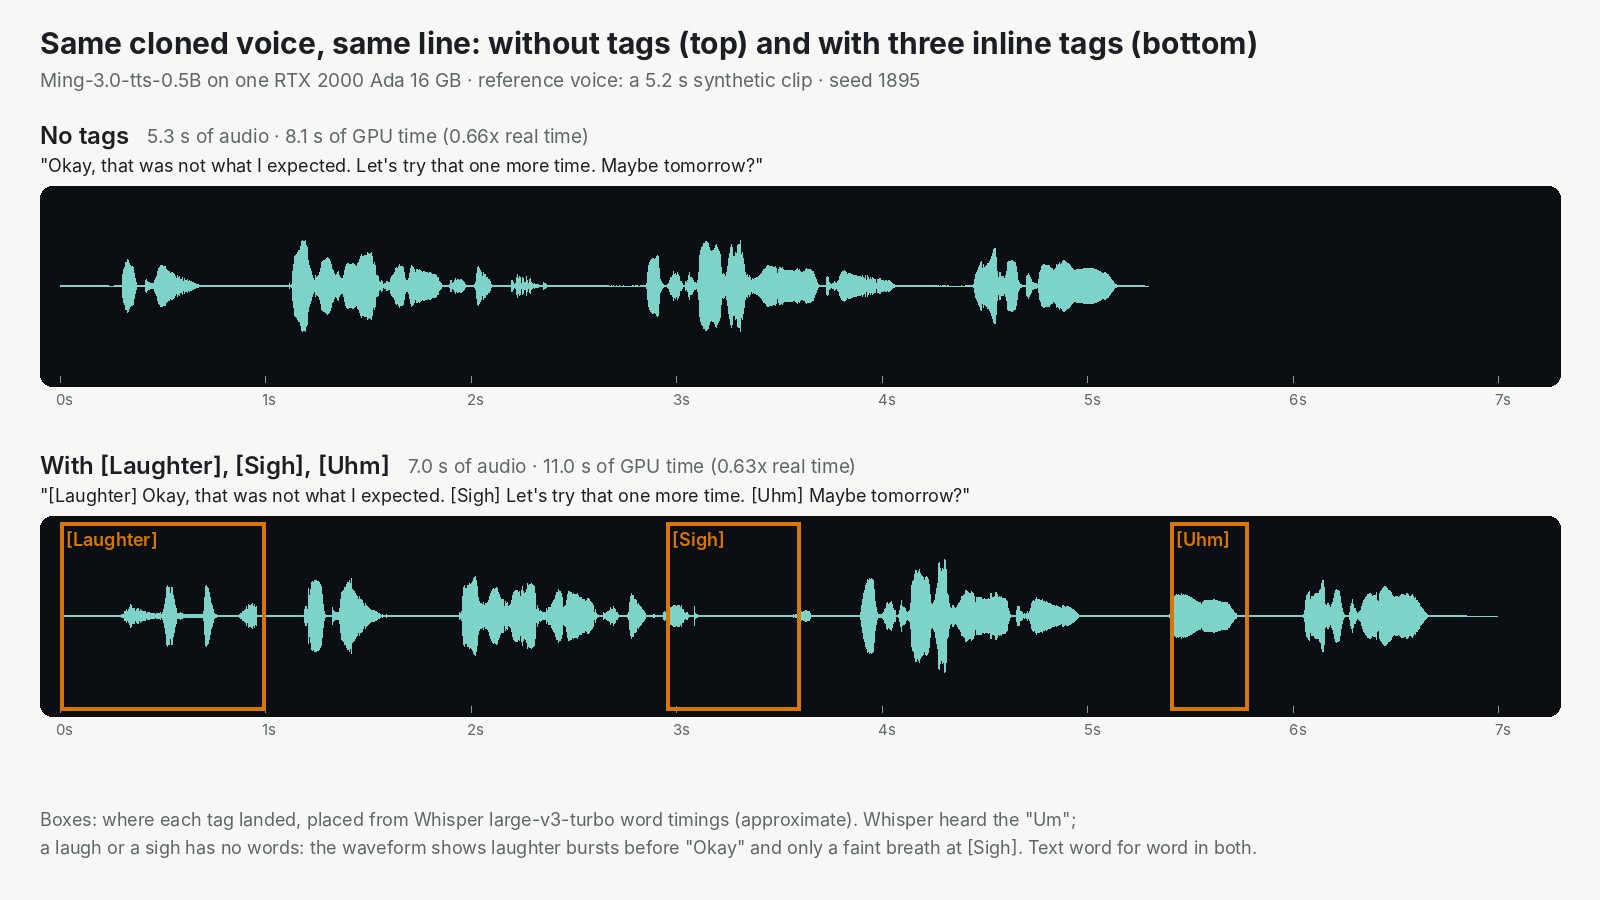
Même voix, même ligne, même carte. Les trois balises entre crochets ont ajouté 1,7 seconde de son. Les mots sont sortis justes les deux fois.
- Sans balises (5,3 s)
- Avec [Laughter], [Sigh] et [Uhm] (7,0 s)
Ce que promet la fiche du modèle : cinq façons de façonner une voix dans un téléchargement de 3 GB
La fiche du modèle liste cinq façons de façonner une voix. Il clone une voix à partir d'un court extrait. Il crée une nouvelle voix à partir d'une description écrite ("voice design"). Il suit des consignes libres sur la façon de dire une ligne. Il est livré avec des voix intégrées en anglais et en chinois. Et il accepte 14 balises en ligne, des mots entre crochets comme [Laughter], [Sigh], [Cough] ou [Uhm], qui deviennent des sons au milieu d'une phrase.
La fiche liste le chinois, l'anglais, l'allemand, l'espagnol, le français, le coréen et le japonais, plus deux dialectes chinois.
Le mérite du modèle revient à l'équipe inclusionAI d'Ant Group. Elle a publié les poids et le code sous MIT, qui autorise l'usage commercial, avec ses propres benchmarks et une section honnête sur les limites. Sur leurs tests, Ming se trompe sur environ 1,6 mot anglais sur 100, entre deux modèles ouverts concurrents (1,45 et 1,83). En espagnol, c'est environ 1,1 sur 100. Pour respecter une description de voix écrite en chinois, il obtient 72,3 % contre 77,1 % pour Qwen3-TTS. Nous n'avons refait aucun de ces tests.
Nous l'avons repéré dans la vidéo d'actualité d'AI Search du 25 octobre. Le présentateur y disait que le petit modèle "only around three gigabytes, so you should be able to run it on many consumer GPUs."
La fiche du modèle dit quelque chose de plus restreint : "Tested on NVIDIA H800-80GB and H20-96G with CUDA 12.4." Ce sont des cartes de data center, et les auteurs ne donnent ni chiffre de mémoire ni GPU plus petit. Notre part, c'était le reste : empaqueter leur code, le faire tourner sur une carte plus petite et vérifier la sortie.
Le test : une carte de 16 GB, 19 lignes en trois langues, vérifiées par machine
Nous avons fait tourner le code des auteurs, sans modification, sur une RTX 2000 Ada de 16 GB. C'est une petite carte de station de travail limitée à 70 watts. Nous avons envoyé 19 lignes de test en anglais, en espagnol et en chinois, plus trois contrôles : deux lignes sans leurs balises et une avec les nombres écrits en toutes lettres. Elles couvraient le clonage, le voice design, les consignes libres, les voix intégrées et les balises, plus des nombres et des paragraphes allant jusqu'à 21 secondes. Puis nous en avons refait cinq sur une RTX 4090 pour voir si une carte plus rapide accélère les choses.
Pour le clonage, il nous fallait une voix qui n'appartient à personne. La référence était donc une ligne synthétique de 5,2 secondes de service client, faite avec une voix de série de Pocket TTS, un petit modèle vocal de Kyutai que nous faisons aussi tourner. Cela suit la règle des auteurs eux-mêmes : ne se faire passer pour personne sans son consentement, et signaler la parole synthétique comme synthétique.
- Voix de référence : synthétique (5,2 s)
Les vérifications ont été faites par machine. Whisper, le modèle de transcription d'OpenAI, a transcrit chaque extrait. Un modèle de reconnaissance du locuteur a noté à quel point chaque clone ressemble à la référence, de 0 (sans rapport) à 1 (identique). Personne chez nous n'a écouté les extraits, donc nous pouvons vous dire que les mots étaient justes et que la voix correspondait, pas à quel point elle sonne naturelle. La référence était aussi le cas facile : un extrait synthétique propre, pas une vraie voix captée par le micro d'un portable ou une ligne téléphonique. Chaque ligne n'a tourné qu'une fois.
Résultats : 17 lignes sur 19 mot pour mot, et des clones qui gardent la voix en espagnol
Le texte était presque toujours exact. Sur 19 lignes, 17 sont revenues mot pour mot en anglais, en espagnol et en chinois, y compris des paragraphes de 18 à 21 secondes. Les deux ratés étaient des nombres, traités dans la section suivante.
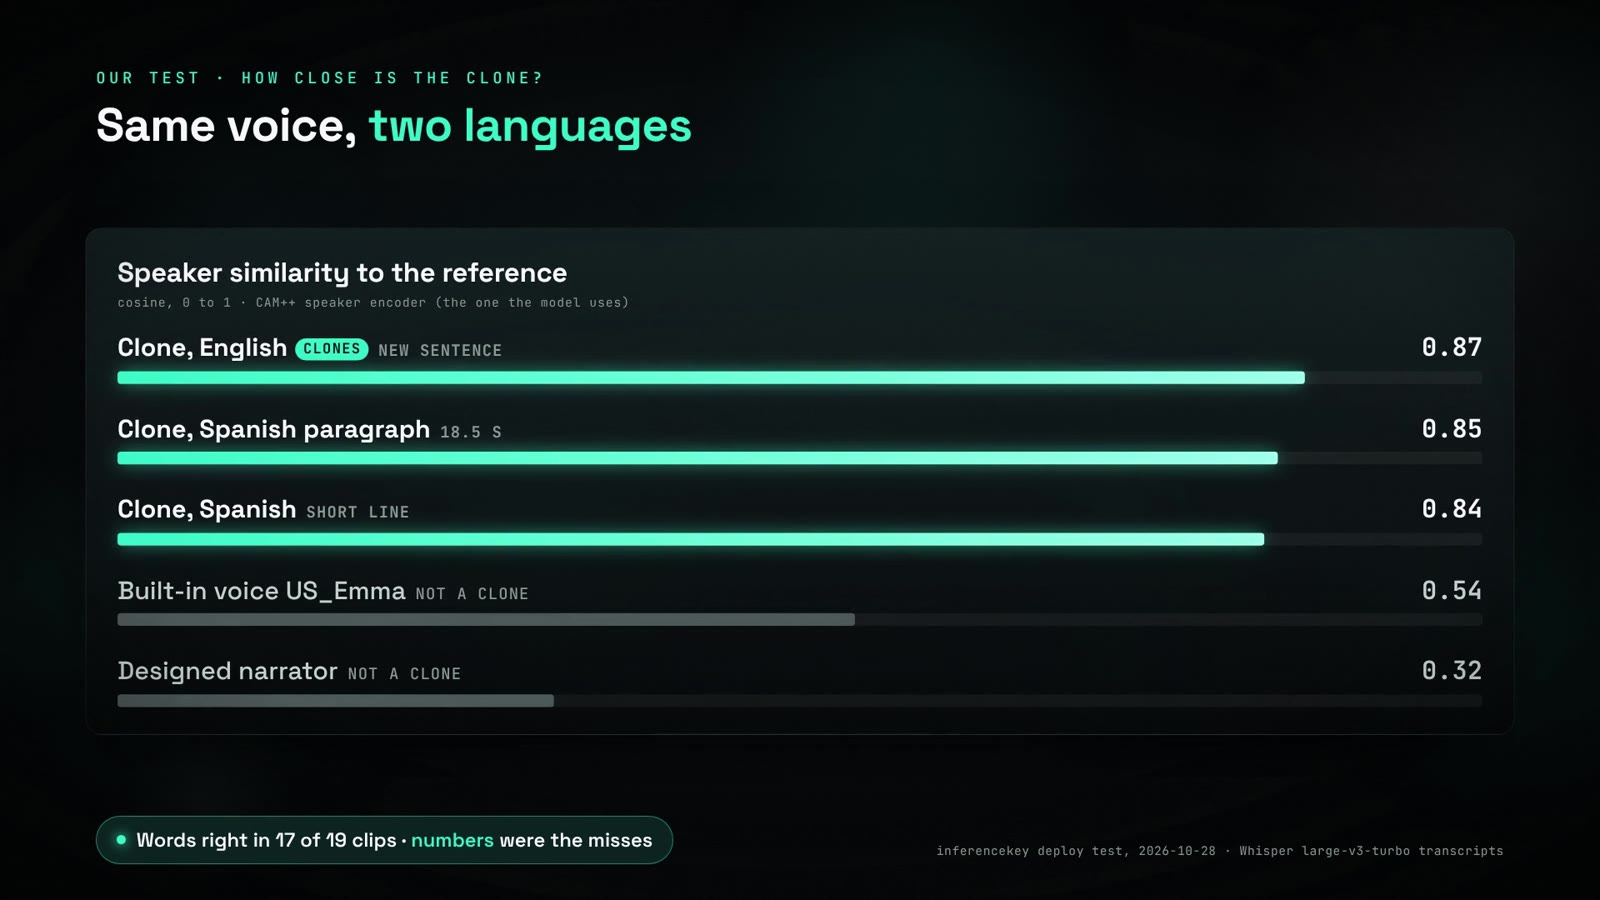
Les clones ont tenu, même d'une langue à l'autre : à partir d'une référence anglaise, le clone espagnol a gardé la voix aussi bien que le clone anglais.
| Extrait | Même voix que la référence ? (de 0 à 1) |
|---|---|
| Clone anglais | 0,87 |
| Clone anglais avec balises | 0,85 |
| Clone espagnol, à partir de la référence anglaise | 0,84 |
| Voix intégrée US_Emma (pas un clone) | 0,54 |
| Voix de narrateur conçue (pas un clone) | 0,32 |
Une réserve : notre modèle de notation est celui que Ming utilise lui-même pour apprendre une voix, il penche donc en faveur de Ming. Un second vérificateur, indépendant, était d'accord, mais il est indulgent : il a aussi jugé proche de notre référence féminine une autre voix féminine.
- Clone en anglais (4,6 s)
- Le même clone en espagnol (7,0 s)
Les balises ont produit de vrais sons, mais seules certaines se vérifient. Les extraits balisés duraient 1,3 à 1,7 seconde de plus que les mêmes lignes sans balises. Whisper a écrit "Um" là où se trouvait [Uhm] et "Huh?" pour [Question-huh]. Les rires n'ont pas de mots, mais la forme d'onde les montre. Le soupir se voit à peine. Nous n'avons testé les balises qu'en anglais. Les auteurs les documentent pour du texte anglais et chinois, donc les balises dans de l'espagnol ne sont pas testées.
Le voice design a sorti chaque mot juste. Nous avons demandé entre autres "a gravelly old sea captain in his seventies, amused and a little hoarse", et chaque ligne avec une voix conçue est revenue mot pour mot. Les voix conçues sont nettement différentes de notre référence (de 0,25 à 0,32). Nous n'avons pas mesuré si chaque voix correspond à sa description.
- Voix conçue : un vieux capitaine au long cours (6,4 s)
Là où il casse : les nombres, et une parole produite plus lentement qu'elle ne se joue
Les nombres ne sont pas fiables, et le modèle est plus lent que le temps réel sur toutes les cartes que nous avons essayées.
Les nombres. Les deux ratés venaient de l'étape qui transforme le texte écrit en mots à prononcer. En anglais, 4521 a été lu "four thousand five hundred twenty, one", avec une pause. Un numéro de téléphone, 555-0142, a été lu "five hundred fifty-five minus one hundred forty-two". L'espagnol saute complètement cette étape. Du coup, "1.249,99 euros, un 12,5 %" est sorti brouillé. Écrire les nombres en toutes lettres n'a pas réglé le cas anglais. Si un prix ou un numéro de commande compte, vérifiez l'audio.
- Nombres mal lus (16,1 s)
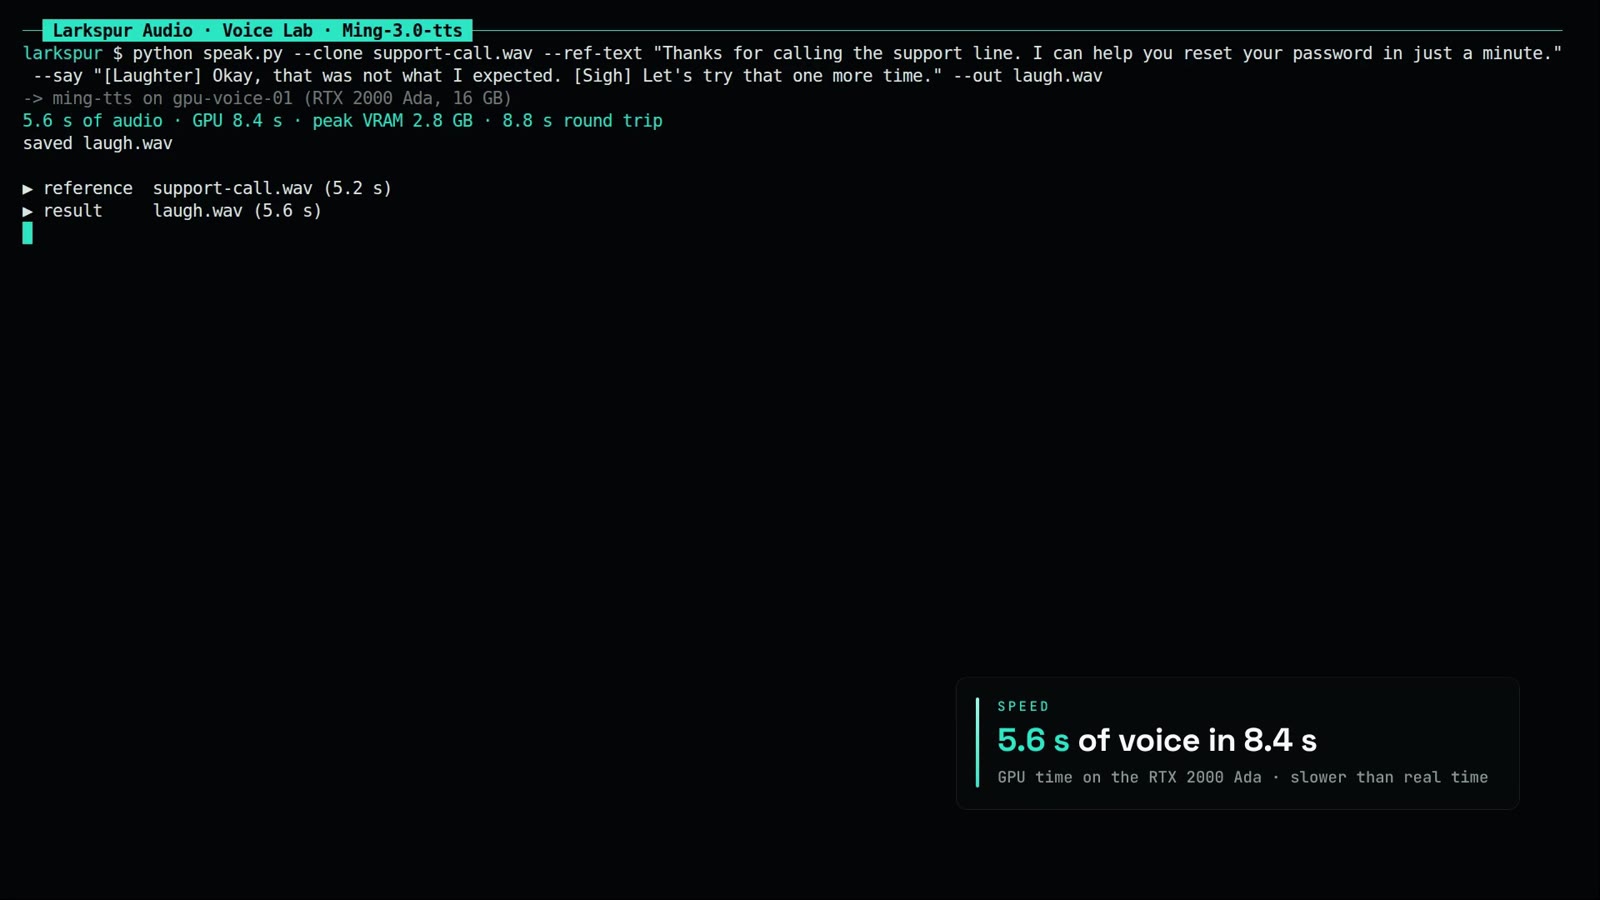
La vitesse. "Temps réel" veut dire une seconde d'audio produite en une seconde. Sur la RTX 2000 Ada, un paragraphe anglais de 20,7 secondes a pris 31 à 32 secondes à produire, et toutes les lignes sauf une exception en chinois ont tourné à ce rythme. La RTX 4090, une carte bien plus rapide, a produit un paragraphe de 20,9 secondes en 27 secondes. C'est environ 17 % plus rapide, et une partie de l'écart peut venir du processeur différent de la machine de la 4090.
La carte n'était pas le goulot d'étranglement. La petite carte était occupée moins d'un tiers du temps, la 4090 un cinquième au plus. Ming écrit l'audio par tranches de 80 millisecondes, l'une après l'autre. Entre deux tranches, une boucle écrite en Python fait sa comptabilité et passe la tranche suivante à la carte. Dans le temps où 12,5 tranches se jouent, elle en produit environ 8,5 : deux tiers du rythme. Imaginez un guitariste de studio qui attend que le chef d'orchestre annonce chaque accord : engagez un guitariste plus rapide, et le morceau avance toujours au rythme du chef.
La feuille de route des auteurs marque comme fait le support d'un moteur de service plus rapide, vLLM-Omni. Nous n'avons pas essayé cette voie, donc la question de savoir si elle règle la vitesse reste ouverte.
Une requête a été beaucoup plus lente : l'exemple de voice design en chinois des auteurs eux-mêmes a pris 50 secondes pour 5 secondes d'audio, parce que le modèle n'a jamais décidé qu'un morceau de texte était terminé. Nous ne l'avons pas vu en anglais ni en espagnol.
Quel GPU : plafonné à 3 GB, l'audio était identique
La plus petite configuration qui a fonctionné : notre carte de 16 GB, avec le modèle autorisé à n'utiliser que 3 GB de sa mémoire, réglages par défaut. L'audio était identique octet pour octet à celui de l'exécution sans plafond, à la même vitesse.
Le driver a besoin d'environ 0,4 GB en plus, donc nous estimons qu'une carte de 4 GB suffit, sans l'avoir testé.
Aucune vraie carte de moins de 16 GB n'a tourné. Nous avons essayé deux fois une RTX 3080 Ti de 12 GB, et les deux machines ont démarré sans l'accès à distance dont notre installation a besoin, donc aucune n'a jamais fait tourner le modèle. Les cartes de 8 GB étaient en rupture de stock. Une puce plus petite pourrait aussi être plus lente que la nôtre, et nous n'avons pas de chiffre pour elle.
Sur InferenceKey : prêt en 60 secondes, avec le code des auteurs derrière une API
Sur votre propre GPU, vous pouvez faire tourner le code des auteurs tel quel, sans attendre que quelqu'un l'empaquette, et le nôtre servait des requêtes au bout de 60,3 secondes. InferenceKey n'a pas de support tout prêt pour Ming, et les auteurs le livrent sous forme de code Python, donc nous avons mis ce code derrière une API. Notre backend personnalisé est un court fichier Python qu'InferenceKey installe et lance sur votre machine GPU. Il récupère le code des auteurs à une version fixe, télécharge les poids et charge le modèle une fois. Votre application l'appelle ensuite comme elle appelle l'API de chat d'OpenAI, et reçoit le WAV dans la réponse.
Depuis une machine vierge, environ la moitié de ce temps est partie dans l'installation des bibliothèques Python. Les 3 GB de poids ont mis 7 secondes à se télécharger et moins de 3 secondes à se charger. Avec tout déjà sur le disque, un redémarrage a pris environ 13 secondes. Le backend répond à une requête à la fois, et nous n'en avons pas testé plusieurs en même temps.
Une aspérité que vous rencontrerez aussi :
- Les applications conçues pour OpenAI demandent la parole à une adresse séparée, et cette adresse ne peut pas encore renvoyer l'audio d'un backend personnalisé. L'exemple utilise donc l'adresse de chat et lit l'audio dans le texte de la réponse. Statut : ouvert, suivi sous IK-531.
Faut-il l'utiliser ? Oui pour de la narration enregistrée sur une petite carte, non pour la voix en direct
- Si vous faites des voix off, des extraits de livres audio ou des démos narrées, il vaut la peine de le faire tourner. Une seule petite carte vous donne le clonage, les voix conçues et les balises, et la licence autorise l'usage commercial. Les mots et la ressemblance de la voix ont tenu aux vérifications par machine. Écoutez les extraits ci-dessus avant de vous engager.
- S'il vous faut un agent vocal qui répond en temps réel, cherchez ailleurs pour l'instant. Il produit la parole plus lentement qu'elle ne se joue, et une carte plus grosse aide à peine.
- Si votre texte contient des prix, des numéros de téléphone ou des dates, vérifiez chacun d'eux dans l'audio.
- S'il vous faut de l'espagnol, il est utilisable pour de la narration clonée, en vérifiant les nombres à la main. Notre voix Pocket TTS en espagnol précédente tournait plus vite que le temps réel sur un CPU de bureau (1,05x), Ming à 0,61 à 0,77x sur un GPU. Nous n'avons pas comparé leur qualité.
- Si votre carte est petite, nous estimons qu'environ 4 GB suffisent pour la mémoire, sans l'avoir testé (voir la section sur le GPU).
Pour entendre quatre lignes sur votre propre GPU NVIDIA, publiez le backend avec python publish.py et lancez python main.py depuis l'exemple du SDK. Vous obtenez une voix intégrée, une voix conçue, un clone avec un rire et un soupir, et le même clone en espagnol. Il vous faut un projet InferenceKey avec un token SDK et une clé API. Votre machine GPU a besoin d'un driver NVIDIA à jour (CUDA 12.4 ou plus récent) et d'environ 3 GB de mémoire GPU libre.
Pour les ingénieurs
Modèle et fichiers
Fiche du modèle, GitHub (inclusionAI/Ming-3.0-tts), benchmarks des auteurs. Dépôt inclusionAI/Ming-3.0-tts-0.5B, créé le 2026-09-22, lastModified 2026-10-27T12:07:15Z, sha 7247f4c94a5b2e987404ed28a5cfec41b1a4ca61, licence MIT, sans accès restreint, pipeline text-to-speech, 5 546 téléchargements et 156 likes le 2026-10-28.
model.safetensors: 2 959 055 504 B. Métadonnées safetensors : 1 479 454 868 paramètres (1 479 454 804 en BF16 plus 64 en F32).campplus.onnx(encodeur de locuteur) : 28 303 423 B. Dépôt complet d'environ 3,0 GB, dont un PDF de 390 569 B (Ming-3.0-tts-0.5B-TDS2026.pdf) et des figures.- Tableau de la fiche : dense, backbone Qwen2.5-0.5B, 0.5B paramètres. Le fichier de poids en stocke environ 1,48 milliard au total ; les auteurs ne détaillent pas où se trouve le reste. Aussi sur la fiche : langues zh, en, de, es, fr, ko, ja, dialectes sichuanais et cantonais, API Python
ming_tts.MingTTS, CLIinfer.py, 44,1 kHz. - Les 14 balises :
[Breathing],[Cough],[Sigh],[Laughter],[Surprise-ah],[Surprise-oh],[Dissatisfaction-hnn],[Uhm],[Confirmation-en],[Question-ei],[Question-ah],[Question-en],[Question-oh],[Question-huh]. Documentées pour du texte chinois ou anglais, sensibles à la casse, contournant la normalisation du texte (cookbooks/instruction_en.md,frontend/toolkit.py). - Tâches :
TTS,FREEFORM,VOICE_DESIGN,MULTILINGUAL,BASIC,EMOTION,DIALECT,IP. - Déclaration matérielle : "Tested on NVIDIA H800-80GB and H20-96G with CUDA 12.4. flash-attn is optional; inference falls back to PyTorch SDPA." Aucun GPU plus petit et aucun chiffre de VRAM.
- Code au commit
9332fb9443325d4726ce02cefd4ec1c211df4079(2026-10-27, "docs: align recommended voices, catalogs and examples"), le commit que fixe notre backend. Avant :028c1eac(2026-10-21, correctif du découpage des textes longs),e999c39f(2026-10-19, "mark vLLM-Omni support").requirements.txtfixe torch 2.6.0, torchaudio 2.6.0, transformers 4.46.3, accelerate 1.3.0, x_transformers 2.9.2, diffusers 0.33.0, soundfile 0.12.1, plus onnxruntime, inflect, einops. pynini 2.1.6 (normalisation du texte) et flash_attn 2.7.4.post1 sont optionnels. Une image Docker est proposée (torch 2.6, CUDA 12.4, transformers 4.46.3). MingTTSse charge entorch.bfloat16(codé en dur) surcuda:0. Valeurs par défaut desynthesize():cfg=2.0,sigma=0.25,temperature=0.0,max_length=24(découpage en fragments),max_decode_steps=1000. Le texte avec unlanguage_idautre que zh/en contourne le normaliseur FST ("Non-zh/en text is passed through unchanged").- Boucle de décodage (
modeling_bailingmm.py) : une passe avant du LLM plus une tête de flow matching (FlowLoss.sample, 10 étapes par défaut, avec CFG) par pas, jusqu'à ce qu'une tête d'arrêt se déclenche. Le cache KV statique de 512 positions plafonne le budget à 512 moins la longueur du prompt. Le VAE audio utilise un hop de 882 à 44 100 Hz avec patch_size 4, donc un pas vaut 80 ms d'audio et le temps réel exige 12,5 pas/s. Nous avons mesuré environ 8,3 à 8,9 pas/s. - Le modèle frère, Ming-3.0-tts-tiny, est un MoE sur Ling V3 (7.9B au total, 1.3B actifs), a besoin de son propre environnement (Python 3.10.15, torch 2.7.1+cu118), recommande une H800 et est le seul à faire du dialogue de podcast à plusieurs voix. Nous ne l'avons pas fait tourner.
- Classements revendiqués dans le README GitHub (Artificial Analysis, octobre 2026) : 1er des modèles ouverts en Controlled Voice (Elo 1069, 13e au général), 1er au général en Pronunciation Robustness (93,2 %), 3e des modèles ouverts en Provider Voice (Elo 1188, 17e au général). Le README ne dit pas s'ils concernent 0.5b ou tiny. Nous n'avons pas vérifié sur artificialanalysis.ai.
Benchmarks des auteurs (non reproduits par nous)
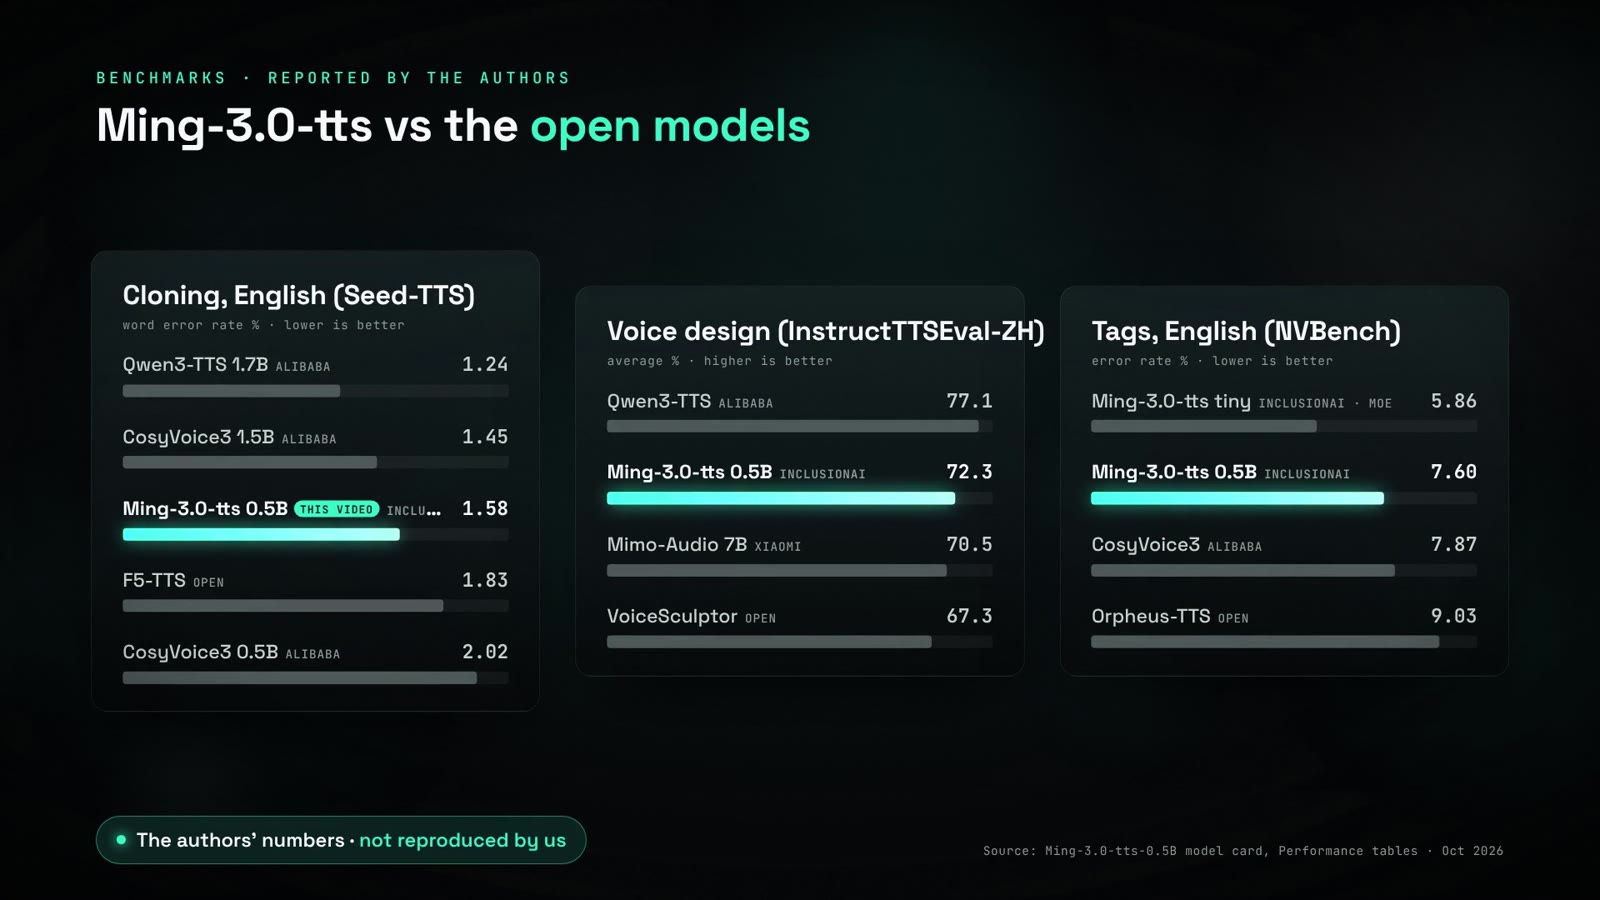
| Test | Ming-3.0-tts-0.5B | Autres modèles du tableau des auteurs |
|---|---|---|
| Seed-TTS EN WER (plus bas = mieux) | 1,584 % (SIM 0,691) | Qwen3-TTS-12Hz-1.7B 1,24, CosyVoice3-1.5B 1,45, F5-TTS 1,83, CosyVoice3-0.5B 2,02 |
| Seed-TTS ZH WER | 0,800 % | |
| WER multilingue MiniMax | allemand 0,365 %, espagnol 1,099 % (SIM 0,763), français 4,264 % (SIM 0,675) | |
| Moyenne voice design InstructTTSEval-ZH | 72,29 % | Qwen3-TTS 77,13, Ming tiny 75,37, Mimo-Audio-7B-Instruct 70,50, VoiceSculptor 67,30 |
| NVBench anglais, CER single | 7,60 | Ming tiny 5,86, CosyVoice3 7,87 |
Limites selon les auteurs : la ressemblance du locuteur est plus faible que l'exactitude du contenu (le SIM en français est l'écart le plus net). NVBench Multi est en retrait par rapport à Single, donc la stabilité avec plusieurs balises par phrase est encore en progrès. L'émotion est plus difficile quand les mots ne portent aucun signal émotionnel. La hauteur est moins précise, et le voice design ouvert n'égale pas encore le meilleur système évalué. L'avertissement d'usage interdit de se faire passer pour une personne réelle sans son consentement et demande que la parole synthétique soit signalée comme synthétique.
Installation
- Une RTX 2000 Ada de 16 GB sur notre cloud (driver 595.91.07, compute capability 8.9, limite de 70 W, hôte AMD EPYC 7352 avec 6 vCPU), enregistrée comme worker auprès d'un manager InferenceKey local. La production n'a jamais été touchée. Une RTX A4000 et une RTX 4000 Ada étaient en rupture de stock.
- Test de vitesse : une RTX 4090 de 24 GB (450 W, hôte AMD EPYC 75F3), 5 cas.
- Backend personnalisé
ming-3-tts-05b0.1.0 (paquet de 7 215 octets).setup()récupère le tarball des sources de Ming au commit fixé (en sautantming_tiny, les figures, docker, cookbooks), lancesnapshot_downloadde la révision fixée (sans PDF ni figures), construitMingTTS(model_dir, device, text_normalization=True)avec la wheel pynini 2.1.6.post1, applique unMING_VRAM_LIMIT_GIBoptionnel viatorch.cuda.set_per_process_memory_fraction, et fait un échauffement avec la voix intégrée US_Emma. bf16, SDPA, réglages par défaut des auteurs, seed 1895. - Voix de référence : extrait anglais synthétique de 5,22 s fait avec la voix de série "anna" de notre Pocket TTS local : "Thanks for calling the support line. I can help you reset your password in just a minute." Ligne du clone espagnol : "Gracias por llamar. Su nueva contraseña ya está lista; por favor, vuelva a iniciar sesión en todos sus dispositivos."
- Vérifications sur le pod :
openai/whisper-large-v3-turboavec la langue forcée pour chaque cas, CAM++ (campplus.onnx, l'encodeur sur lequel Ming se conditionne) etmicrosoft/wavlm-base-plus-sv(indépendant).
Délai de disponibilité
| Phase | Temps |
|---|---|
ensure() jusqu'à prêt, caches vides, RTX 2000 Ada | 60,3 s |
| dont : le worker construit le venv du backend | environ 32 s |
| dont : setup du backend | 26,4 s (sources 0,9 s, poids 7,1 s, chargement 2,7 s, échauffement 3,7 s) |
| Redémarrages à chaud (venv et poids en cache) | 13,1, 12,9, 12,7, 13,2 s |
ensure() jusqu'à prêt, caches vides, RTX 4090 | 47,3 s |
Par requête, RTX 2000 Ada
POST /endpoint/<project>/ming-tts/v1/chat/completions sans streaming. GPU s est le temps synchronisé du backend autour de synthesize(). Aller-retour mesuré côté client, à travers un tunnel.
| Cas | Tâche | Audio s | GPU s | x temps réel | Pic alloué MiB | Aller-retour s | Ce qu'a entendu Whisper |
|---|---|---|---|---|---|---|---|
| en-ip-george | IP UK_George | 5,3 | 8,39 | 0,63 | 2 919 | 8,52 | exact |
| en-ip-emma | IP US_Emma | 8,2 | 12,95 | 0,63 | 2 924 | 13,18 | exact ("I am" pour "I'm") |
| en-freeform-coach | FREEFORM | 4,9 | 7,79 | 0,63 | 2 890 | 8,01 | exact |
| en-freeform-whisper | FREEFORM ("Whisper, tense and frightened") | 2,9 | 4,79 | 0,61 | 2 888 | 4,96 | exact |
| en-design-narrator | VOICE_DESIGN | 4,2 | 6,71 | 0,63 | 2 926 | 6,91 | exact |
| en-design-captain | VOICE_DESIGN | 6,4 | 10,03 | 0,64 | 2 927 | 10,24 | exact |
| en-design-girl | VOICE_DESIGN | 3,5 | 5,66 | 0,62 | 2 922 | 5,84 | exact |
| en-clone | TTS + référence | 4,5 | 7,07 | 0,64 | 2 916 | 7,53 | exact |
| en-clone-tags | TTS + référence, [Laughter] [Sigh] [Uhm] | 7,0 | 11,02 | 0,63 | 2 922 | 11,49 | exact + "Um," |
| en-clone-notags (contrôle) | même texte, sans balises | 5,3 | 8,05 | 0,66 | 2 917 | 8,62 | exact |
| en-ip-tags | IP, [Breathing] [Cough] [Question-huh] | 5,5 | 8,71 | 0,63 | 2 924 | 8,92 | texte + "Huh?" |
| en-ip-notags (contrôle) | même texte, sans balises | 4,2 | 6,40 | 0,66 | 2 920 | 6,58 | exact |
| en-numbers | IP US_Emma | 16,1 | 25,04 | 0,64 | 2 936 | 25,32 | nombres faux |
| en-numbers-words (contrôle) | nombres écrits en toutes lettres | 5,9 | 8,92 | 0,66 | 2 920 | 9,12 | "Order Number 40, 520, 1 ... 2020, 6." |
| en-long | IP UK_George, 61 mots | 20,7 | 32,41 | 0,64 | 2 923 | 32,96 | exact |
| es-clone | MULTILINGUAL es + référence anglaise | 6,9 | 10,48 | 0,66 | 2 920 | 10,85 | exact |
| es-ip-emma | IP US_Emma + language_id es | 7,6 | 11,60 | 0,66 | 2 927 | 11,79 | exact |
| es-design | VOICE_DESIGN + es | 4,9 | 7,64 | 0,64 | 2 930 | 7,82 | exact |
| es-freeform | FREEFORM + es | 5,7 | 8,62 | 0,66 | 2 894 | 8,83 | exact |
| es-long | MULTILINGUAL es, 52 mots | 18,5 | 28,01 | 0,66 | 2 922 | 28,61 | exact |
| es-numbers | MULTILINGUAL es | 11,4 | 17,08 | 0,67 | 2 927 | 17,99 | nombres faux |
| zh-design-authors | VOICE_DESIGN, l'exemple chinois des auteurs | 5,0 | 49,84 | 0,10 | 2 988 | 50,00 | exact |
- Aller-retour moins temps GPU : 0,13 à 0,9 s (WAV en base64 à travers le tunnel et le bus de messages, un extrait de 20 s fait environ 1,8 MB brut). D'une exécution à l'autre, le paragraphe de 20,7 s a pris 31,0 à 32,4 s de temps GPU.
zh-design-authors: le texte a été découpé en deux fragments et le premier a épuisé tout le budget de décodage (343 pas, 41 s, la tête d'arrêt ne s'est jamais déclenchée) avant que le silence final ne soit coupé.- Mémoire GPU : 2 846 MiB alloués après chargement, 2 888 à 2 936 MiB de pic alloué par requête (2 988 MiB sur l'exception chinoise). Pic de la carte selon nvidia-smi 3 336 MiB, contexte CUDA compris. Utilisation du GPU 23 à 31 %, environ 24 W sur 70 W.
- Le backend sert une requête à la fois (un verrou plus une concurrence de workload de 1). Pas de test en parallèle.
- Avec la même seed, les sorties sont déterministes sur une même carte mais diffèrent légèrement d'une carte à l'autre (5,2 contre 5,3 s pour en-ip-george, 7,0 contre 6,4 s pour le capitaine).
Test de vitesse sur RTX 4090
| Cas | Audio s | GPU s | x temps réel | Aller-retour s |
|---|---|---|---|---|
| en-ip-george | 5,2 | 6,85 | 0,76 | 8,44 |
| en-design-captain | 7,0 | 9,05 | 0,77 | 9,62 |
| en-clone-tags | 6,9 | 8,94 | 0,77 | 9,80 |
| en-long | 20,9 | 27,11 / 27,79 | 0,77 / 0,75 | 27,94 / 28,49 |
| es-clone | 6,9 | 9,23 | 0,75 | 9,93 |
nvidia-smi pendant en-long : 3 562 MiB, 14 à 20 % d'utilisation, environ 81 W sur 450 W. La boucle de pas est limitée par les lancements et par le CPU. Nous n'avons pas isolé quelle part du gain d'environ 17 % vient du CPU plus rapide de l'hôte.
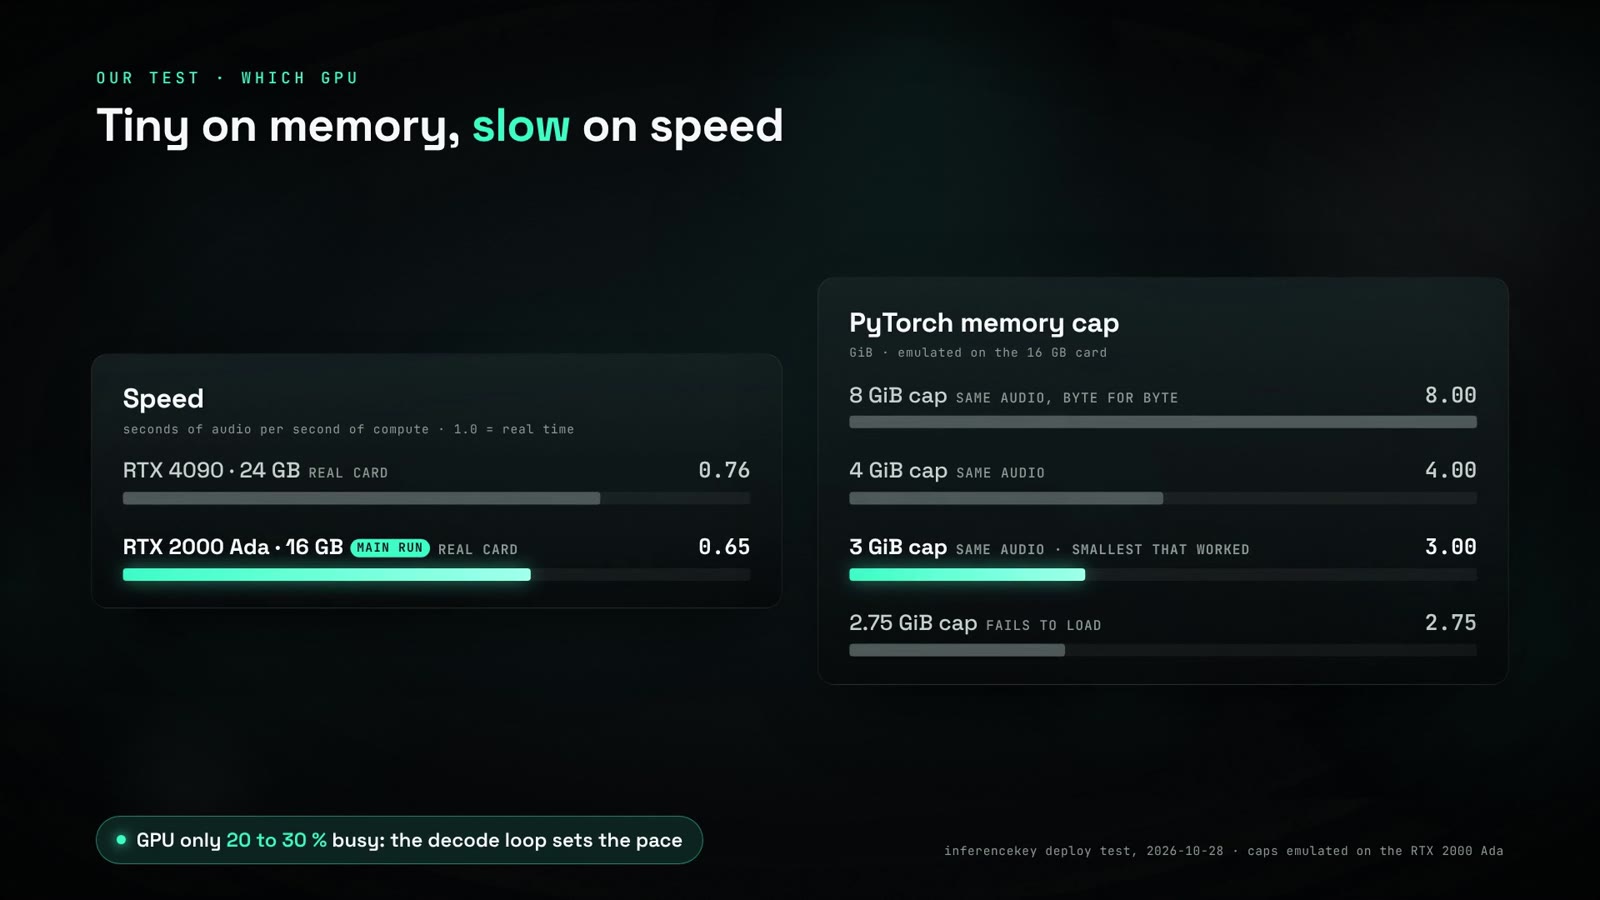
Échelle de VRAM
Le récit arrondit ces plafonds en GB ; les valeurs exactes sont en GiB. Plafonds fixés avec MING_VRAM_LIMIT_GIB (torch.cuda.set_per_process_memory_fraction) sur la RTX 2000 Ada, chacun avec un nouvel ensure() et des caches chauds. WAV de en-clone-tags, en-ip-george, en-long et es-clone comparés par md5 à l'exécution sans plafond.
| Échelon | Config | Pic alloué | Vitesse | Sortie | Réel ou émulé |
|---|---|---|---|---|---|
| RTX 4090 24 GB | bf16, SDPA, par défaut | 2 923 MiB (3 562 MiB carte) | 0,75 à 0,77x | texte exact sur le sous-ensemble | réel |
| RTX 2000 Ada 16 GB | bf16, SDPA, par défaut (exécution principale) | 2 936 MiB (3 336 MiB carte) | 0,61 à 0,68x | référence | réel |
| Plafond 8 GiB | MING_VRAM_LIMIT_GIB=8 | 2 923 MiB | 0,66 à 0,67x | identique octet pour octet | émulé |
| Plafond 4 GiB | MING_VRAM_LIMIT_GIB=4 | 2 923 MiB | 0,64 à 0,66x | identique octet pour octet | émulé |
| Plafond 3 GiB | MING_VRAM_LIMIT_GIB=3 | 2 923 MiB | 0,65 à 0,68x | identique octet pour octet | émulé |
| Plafond 2,75 GiB | MING_VRAM_LIMIT_GIB=2.75 | setup() failed: CUDA out of memory. Tried to allocate 20.00 MiB ... this process has 2.83 GiB memory in use. 2.75 GiB allowed | émulé | ||
| RTX 3080 Ti 12 GB | deux tentatives | la machine a démarré sans SSH direct (pas de mappage du port 22) et le manager l'a arrêtée au bout de 180 s, deux fois | réel, n'a jamais tourné |
Non essayé : toute vraie carte de moins de 16 GB, le fp16 sur des cartes antérieures à Ampere, flash-attn, vLLM-Omni, le CPU.
Détails de qualité
- Mots : 17 extraits de test sur 19 mot pour mot. Les sous-ensembles de l'échelle et de la 4090 ont donné un texte identique.
- Nombres en anglais. La sortie du normaliseur dans le log du backend était
Order number four thousand, five hundred twenty,one ships on March three , two thousand twenty,six and costs one thousand, two hundred forty,nine point nine nine dollars , about twelve point five percent less than last year. Call five hundred fifty,five minus one hundred forty,two .Le trait d'union devient une virgule pleine chasse (une pause), et le numéro de téléphone 555-0142 est lu comme une soustraction. Whisper a entendu "Order number 4520. One ships ... costs $1,240, $9.99 ... Call 550-5-142". Écrire les nombres en toutes lettres ne l'a pas évité ("forty-five twenty-one" est devenu "40, 520, 1"). - Les nombres en espagnol sautent le normaliseur : "1.249,99 euros, un 12,5 %" a été entendu comme "1.1249.99 euros, un 2,5%".
- Ressemblance du locuteur, cosinus CAM++ par rapport à la référence : en-clone 0,865, en-clone-tags 0,849, es-clone 0,838, es-long 0,853, es-numbers 0,836. Non-clones de 0,162 (chinois) à 0,540 (US_Emma). Voix conçues de 0,25 à 0,32. WavLM-SV : clones de 0,924 à 0,970, mais la voix intégrée US_Emma (une voix féminine comme la référence) aussi de 0,84 à 0,86, donc WavLM sépare moins bien. Le clonage d'une langue à l'autre (référence anglaise, sortie espagnole) a gardé la voix aussi bien que le clonage dans la même langue, selon les deux mesures.
- Balises : 7,0 contre 5,3 s (clone,
[Laughter][Sigh][Uhm]) et 5,5 contre 4,2 s (voix intégrée,[Breathing][Cough][Question-huh]). Les cadres des balises dans l'image principale viennent des horodatages de mots de Whisper et sont approximatifs. Aucun test d'écoute humaine. - Le voice design et les consignes libres en anglais et en espagnol ont donné un texte exact. Les prompts comprenaient "A gravelly old sea captain in his seventies, amused and a little hoarse..." et "Whisper, tense and frightened, very quietly and slowly." La correspondance entre la voix et la description n'a pas été mesurée.
- Aucun plantage, NaN ou sortie vide sur environ 60 requêtes.
- Pas de comparaison directe en espagnol avec notre précédent fine-tune espagnol de Pocket TTS : pas le même texte, pas de vérificateur commun, pas d'écoute. Le seul contraste est la vitesse, sur un matériel différent : ce fine-tune tournait à 1,05x le temps réel sur un CPU de bureau, Ming à 0,61 à 0,77x sur GPU.
Pas à pas avec l'exemple du SDK
L'exemple du SDK correspond au commit b038dd7529651076b5055604584c1fd1b51f517c sur la branche main d'inferencekey-sdk : backend.py, publish.py, main.py, requirements.txt, README.md, .env.example, .gitignore.
Il vous faut un token SDK (ik_sdk_), une clé API (ik_live_), un slug de projet et un worker NVIDIA enregistré (IK_WORKER_ID) avec un driver pour CUDA 12.4 ou plus récent et environ 3 GB de VRAM libre. INFERENCEKEY_TENANT_ID et INFERENCEKEY_USER_TOKEN sont optionnels. Sans eux, envoyez dist/*.tar.gz depuis Dashboard, Custom backends, et activez Chat à la main dans les réglages d'endpoint du workload.
cp .env.example .env        # fill in real values
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )
python publish.py           # once: packages backend.py and uploads it
python main.py              # ensure -> wait until ready -> 4 WAV files in ./outputs
main.py déploie le workload (ensure(), politique fixe, une réplique), active la route de chat, attend qu'il soit prêt, écrit quatre WAV et supprime le workload en sortant (IK_KEEP_ALIVE=1 le garde). Notre exécution avec IK_KEEP_ALIVE=1 :
| Sortie | Audio | Temps GPU | x temps réel |
|---|---|---|---|
| 1-built-in-voice (UK_George) | 5,3 s | 7,899 s | 0,67 |
| 2-voice-design (narrateur) | 4,2 s | 6,12 s | 0,69 |
3-clone-with-tags ([Laughter], [Sigh]) | 6,0 s | 9,124 s | 0,66 |
| 4-clone-spanish | 4,3 s | 7,201 s | 0,60 |
Pic de VRAM de 2 912 à 2 926 MiB. Prêt au bout de 60,3 s.
Forme de la requête. Le texte est le dernier message utilisateur, une référence part comme une partie input_audio, et les options vont dans extra_body (task, language_id, style, instruction, voice, prompt_text, seed, cfg, sigma). Le contenu du message de la réponse est une chaîne JSON avec audio_b64 (WAV 16 bits, 44,1 kHz), seconds, task et timings (gpu_s, total_s, realtime_factor, peak_vram_mib). Limites : 600 caractères de texte et 30 s de référence par requête.
import base64, json, os, requests

base = os.environ.get("INFERENCEKEY_BASE_URL", "https://cloud.inferencekey.com").rstrip("/")
project = os.environ["INFERENCEKEY_PROJECT"]
api_key = os.environ["INFERENCEKEY_API_KEY"]
slug = os.environ.get("MING_WORKLOAD_SLUG", "ming-tts")
ref_b64 = base64.b64encode(open("reference.wav", "rb").read()).decode()
REFERENCE_TRANSCRIPT = "Thanks for calling the support line. I can help you reset your password in just a minute."

body = {
    "model": "default",
    "messages": [{"role": "user", "content": [
        {"type": "text", "text": "[Laughter] I did not expect that at all. [Sigh] Well, let's try one more time."},
        {"type": "input_audio", "input_audio": {"data": ref_b64, "format": "wav"}},
    ]}],
    "extra_body": {"task": "TTS", "prompt_text": REFERENCE_TRANSCRIPT, "language_id": "en", "seed": 1895},
}
r = requests.post(f"{base}/endpoint/{project}/{slug}/v1/chat/completions",
                  headers={"Authorization": f"Bearer {api_key}"}, json=body, timeout=600)
out = json.loads(r.json()["choices"][0]["message"]["content"])  # IK-531 workaround
open("clone.wav", "wb").write(base64.b64decode(out["audio_b64"]))
Pour l'espagnol, l'allemand, le français, le coréen ou le japonais, utilisez "task": "MULTILINGUAL" avec "language_id": "es" (et ainsi de suite). Pour une voix conçue, utilisez "task": "VOICE_DESIGN" avec "style". Pour une voix intégrée, utilisez "task": "IP" avec "voice": "UK_George".
Problèmes
- Plus lent que le temps réel sur les deux cartes (de 0,61 à 0,77x), avec le GPU occupé de 14 à 31 %. C'est la boucle de pas en Python des auteurs qui donne le rythme. Le support de vLLM-Omni est marqué comme fait dans leur feuille de route. Nous n'avons pas essayé cette voie.
- Nombres : en anglais, les nombres écrits en toutes lettres avec trait d'union reçoivent une pause et les numéros de téléphone deviennent des soustractions. Les nombres en espagnol sautent le normaliseur et sortent brouillés. Statut : comportement en amont, ouvert. Vérifiez les nombres dans la sortie.
- L'exemple chinois de voice design a atteint une fois la limite de décodage : 49,8 s pour 5 s d'audio. Pas vu en anglais ni en espagnol.
/v1/audio/speechne peut pas transporter la sortie d'un backend personnalisé : l'exemple utilise la route de chat et unjson.loadsdu contenu du message. Ouvert, IK-531.- Envoi du backend refusé sur notre machine de dev (
XMinioStorageFull, disque plein à environ 99 %). Réglé pour l'exécution en libérant nos propres fichiers. Un problème de l'environnement de test, que vous ne verrez pas. - Machines RTX 3080 Ti sans SSH direct (deux fois) : le worker n'a pas pu être installé et le manager a arrêté chacune au bout de 180 s.
- Cosmétique : le panneau affichait un badge Access "No access" alors qu'une clé générique fonctionnait.
- Avertissements de chargement en amont, avec une sortie correcte :
You are using a model of type dense to instantiate a model of type bailingmm,Sliding Window Attention is enabled but not implemented for sdpa, et une dépréciation depast_key_valuesdans transformers.
Autres extraits
- Paragraphe en espagnol, voix clonée, 52 mots (18,6 s)
- Voix intégrée UK_George (5,3 s)
- Voix conçue : une petite fille (3,5 s)
- Voix conçue : un narrateur calme (4,2 s)
- Consigne libre : "Whisper, tense and frightened" (3,0 s)
Vidéo de démo
Une présentation de 191 secondes : les extraits de démo des auteurs eux-mêmes (crédités à inclusionAI, Ant Group), leurs benchmarks, notre test sous forme de questions et réponses, et quel GPU. Sous-titres en anglais.
Sources
- Fiche du modèle : https://huggingface.co/inclusionAI/Ming-3.0-tts-0.5B (API HF consultée le 2026-10-28)
- Code : https://github.com/inclusionAI/Ming-3.0-tts au commit
9332fb94, y comprisrequirements.txt,ming_tts.py,modeling_bailingmm.py,fm/flowloss.py,cookbooks/instruction_en.md - Benchmarks des auteurs et revendications de classement : https://github.com/inclusionAI/Ming-3.0-tts#performance
- Où nous l'avons repéré : vidéo d'actualité d'AI Search du 2026-10-25, chapitre à 13:33, https://www.youtube.com/watch?v=EfyQOAJjx1A
- Notre exemple du SDK : https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/ming-3-tts-05b-speech-custom-backend-private-nvidia
- Nos mesures : test de déploiement du 2026-10-28 (logs du banc, de l'échelle et de la 4090, résumés par cas, résultats de Whisper et de ressemblance du locuteur, échantillons nvidia-smi)