Ming-3.0-tts clona una voz en unos 3 GB de memoria de GPU, pero habla más lento que el tiempo real
El modelo de voz con licencia MIT de inclusionAI en una tarjeta de 16 GB: pico de 2,9 GB, 17 de 19 frases exactas, clones fieles y unas 0,65x tiempo real.
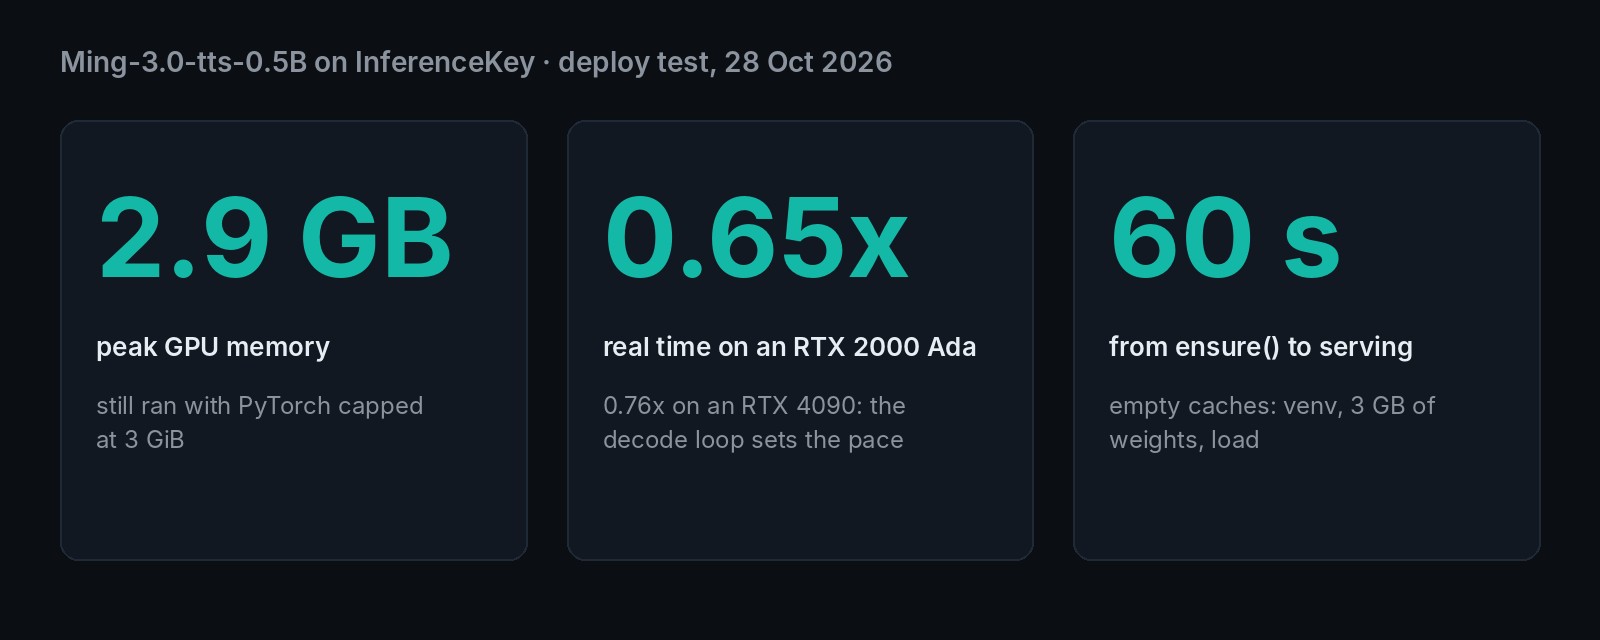
Queríamos saber si un modelo de voz de 3 GB funciona de verdad en una tarjeta gráfica pequeña. Ming-3.0-tts-0.5B es un modelo con licencia MIT de inclusionAI, el laboratorio de IA de Ant Group, y sus autores solo mencionan pruebas en tarjetas de centro de datos con 80 GB y 96 GB de memoria. En una RTX 2000 Ada de 16 GB necesitó 2,9 GB en su pico, y generó exactamente el mismo audio cuando solo le dejamos 3 GB, como en una tarjeta pequeña. Escribimos una risa y un suspiro dentro de una frase: todas las palabras salieron bien, y la forma de onda muestra ráfagas donde estaba la etiqueta de la risa. Si tienes tus propias GPU, eso significa que una tarjeta pequeña puede clonar una voz, inventar una nueva a partir de una frase y hablar español además de inglés. La pega es la velocidad: cerca de 1,5 segundos de trabajo por cada segundo de voz. Así que sirve para narración grabada, no para un agente de voz en directo. Nuestro ejemplo del SDK lo despliega en tu propia GPU en cerca de un minuto.
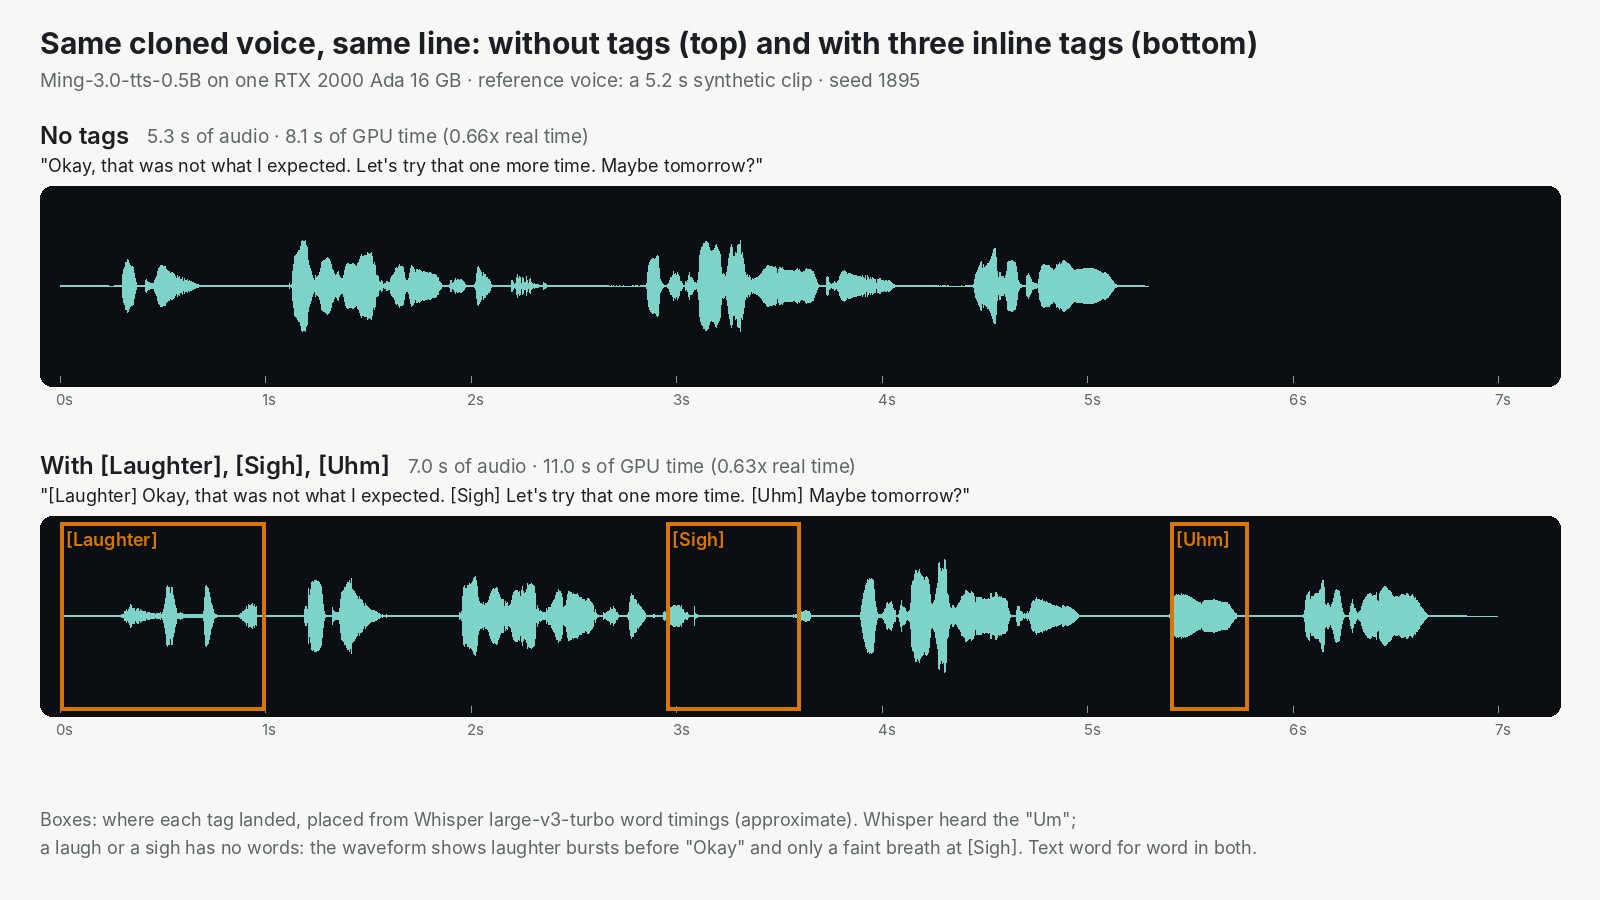
Misma voz, misma frase, misma tarjeta. Las tres etiquetas entre corchetes añadieron 1,7 segundos de sonido. Las palabras salieron bien las dos veces.
- Sin etiquetas (5,3 s)
- Con [Laughter], [Sigh] y [Uhm] (7,0 s)
Lo que promete la página del modelo: cinco formas de dar forma a una voz en una descarga de 3 GB
La página del modelo enumera cinco formas de dar forma a una voz. Clona una voz a partir de un clip corto. Crea una voz nueva a partir de una descripción escrita ("voice design", diseño de voz). Sigue indicaciones libres sobre cómo decir una frase. Trae voces integradas en inglés y chino. Y acepta 14 etiquetas en línea, palabras entre corchetes como [Laughter], [Sigh], [Cough] o [Uhm], que se convierten en sonidos en mitad de una frase.
La página enumera chino, inglés, alemán, español, francés, coreano y japonés, además de dos dialectos chinos.
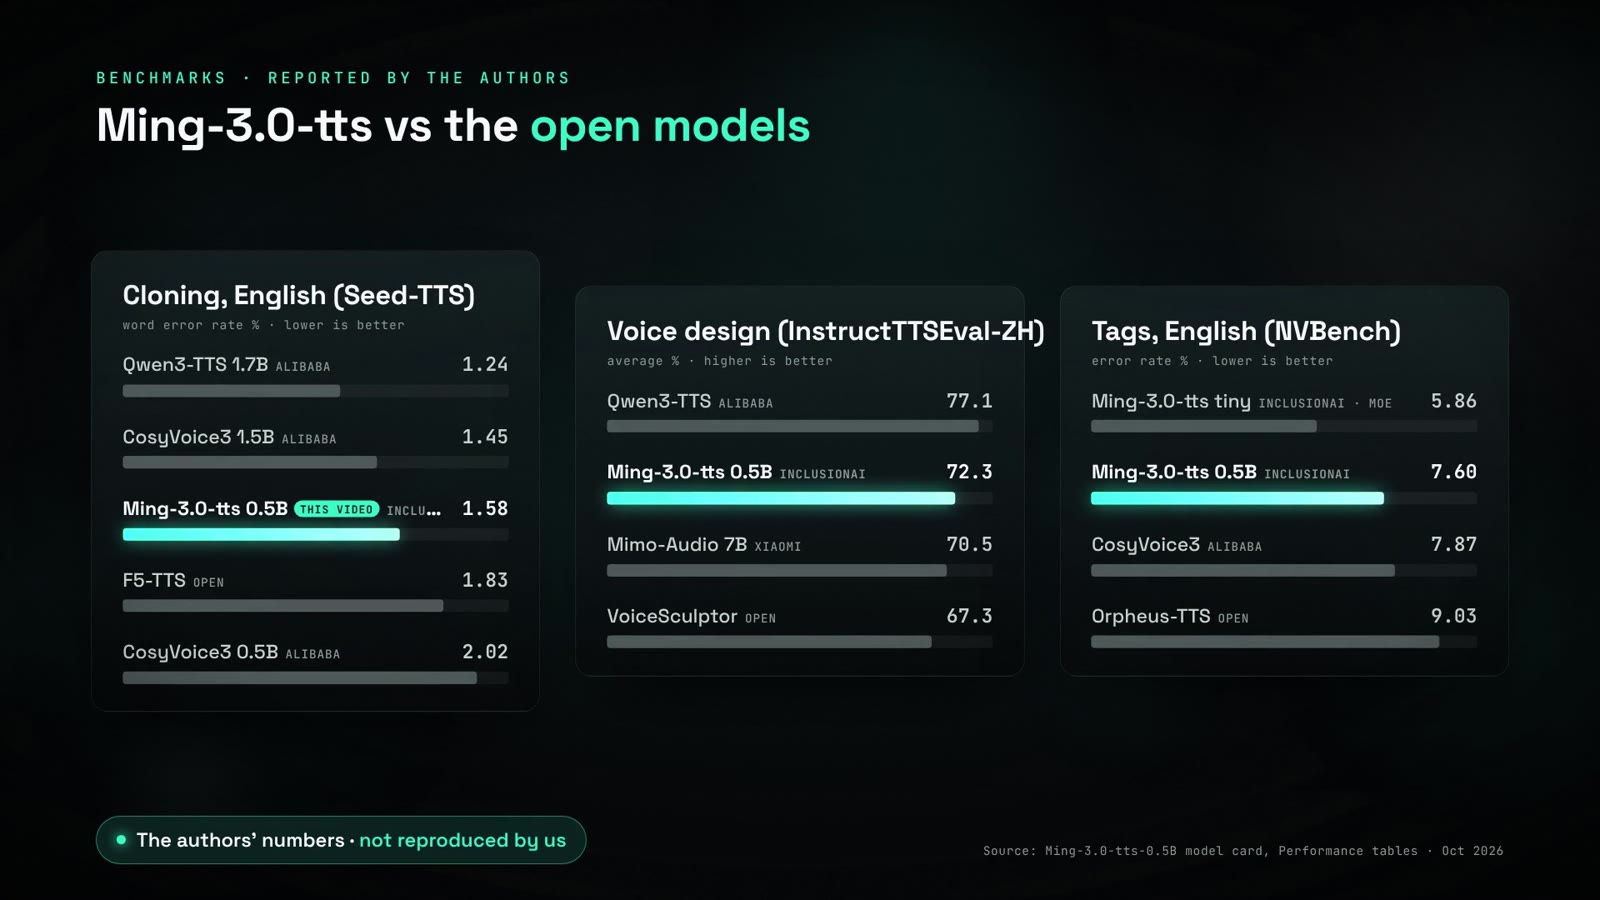
El mérito del modelo es del equipo de inclusionAI en Ant Group. Publicaron los pesos y el código con licencia MIT, que permite el uso comercial, con sus propios benchmarks y una sección de limitaciones honesta. En sus pruebas, Ming falla cerca de 1,6 de cada 100 palabras en inglés, entre dos modelos abiertos rivales (1,45 y 1,83). En español, cerca de 1,1 de cada 100. Al ajustarse a una descripción de voz escrita en chino, saca un 72,3 % frente al 77,1 % de Qwen3-TTS. No repetimos ninguna de estas pruebas.
Lo vimos en el vídeo de noticias de AI Search del 25 de octubre. El presentador dijo que el modelo pequeño ocupa "only around three gigabytes, so you should be able to run it on many consumer GPUs."
La página del modelo dice algo más limitado: "Tested on NVIDIA H800-80GB and H20-96G with CUDA 12.4." Son tarjetas de centro de datos, y los autores no dan ninguna cifra de memoria ni ninguna GPU más pequeña. Lo nuestro fue el resto: empaquetar su código, ejecutarlo en una tarjeta más pequeña y comprobar la salida.
La prueba: una tarjeta de 16 GB, 19 frases en tres idiomas, comprobadas a máquina
Ejecutamos el código de los propios autores, sin cambios, en una RTX 2000 Ada de 16 GB. Es una tarjeta pequeña de estación de trabajo con un límite de potencia de 70 vatios. Enviamos 19 frases de prueba en inglés, español y chino, más tres controles: dos frases sin sus etiquetas y una con los números escritos en letra. Cubrían clonación, diseño de voz, indicaciones libres, voces integradas y etiquetas, además de números y párrafos de hasta 21 segundos. Después repetimos cinco de ellas en una RTX 4090 para ver si una tarjeta más rápida lo acelera.
Para clonar, necesitábamos una voz que no fuera de nadie. Así que la referencia fue una frase sintética de 5,2 segundos de un servicio de atención al cliente, con una voz de serie de Pocket TTS, un modelo de voz pequeño de Kyutai que también usamos. Eso sigue la regla de los propios autores: no suplantar a nadie sin su consentimiento, y etiquetar la voz sintética como sintética.
- Voz de referencia: sintética (5,2 s)
Las comprobaciones las hizo una máquina. Whisper, el modelo de voz a texto de OpenAI, transcribió cada clip. Un modelo de reconocimiento de hablante puntuó cuánto se parece cada clon a la referencia, de 0 (sin relación) a 1 (idéntico). Nadie de nuestro lado escuchó los clips, así que podemos decirte que las palabras eran correctas y que la voz coincidía, no lo natural que suena. La referencia era además el caso fácil: un clip sintético limpio, no una voz real grabada con el micrófono de un portátil o por una línea telefónica. Cada frase se ejecutó una sola vez.
Resultados: 17 de 19 frases palabra por palabra, y clones que conservan la voz en español
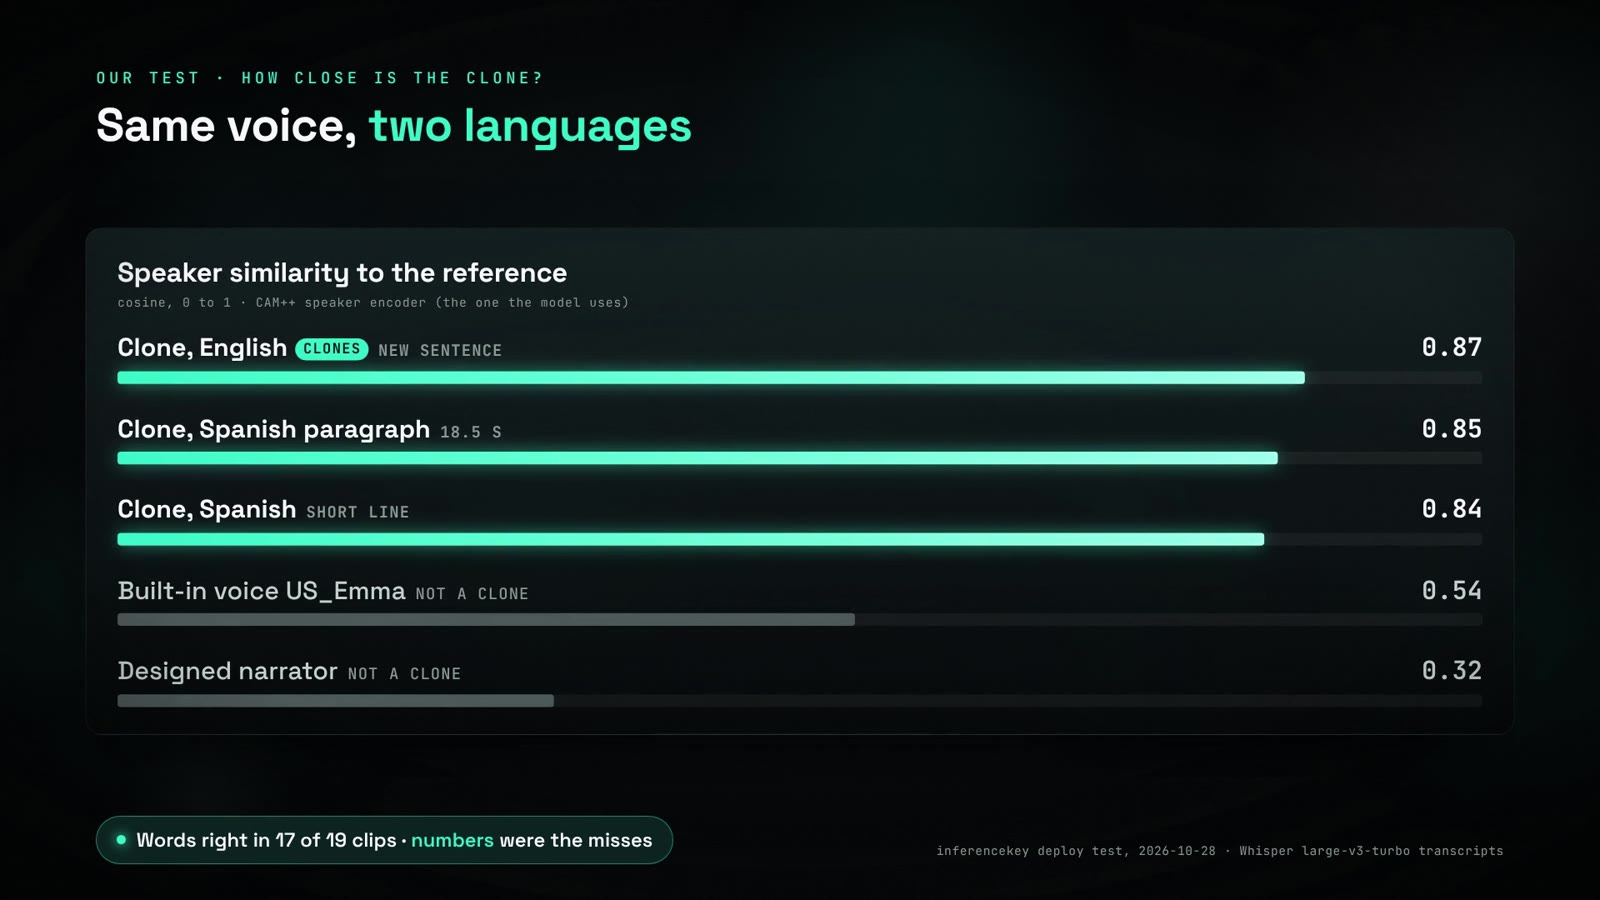
El texto salió exacto casi siempre. De 19 frases, 17 volvieron palabra por palabra en inglés, español y chino, incluidos párrafos de 18 a 21 segundos. Los dos fallos fueron números, que tratamos en la siguiente sección.
Los clones aguantaron, incluso entre idiomas: a partir de una referencia en inglés, el clon en español conservó la voz igual de bien que el inglés.
| Clip | ¿La misma voz que la referencia? (0 a 1) |
|---|---|
| Clon en inglés | 0,87 |
| Clon en inglés con etiquetas | 0,85 |
| Clon en español, a partir de la referencia en inglés | 0,84 |
| Voz integrada US_Emma (no es un clon) | 0,54 |
| Voz de narrador diseñada (no es un clon) | 0,32 |
Una advertencia: nuestro modelo de puntuación es el mismo que usa Ming para aprender una voz, así que se inclina a favor de Ming. Un segundo evaluador, independiente, coincidió, pero es indulgente: también puntuó como cercana a nuestra referencia femenina otra voz femenina distinta.
- Clon en inglés (4,6 s)
- El mismo clon en español (7,0 s)
Las etiquetas produjeron sonidos reales, pero solo algunas se pueden comprobar. Los clips con etiquetas duraron de 1,3 a 1,7 segundos más que las mismas frases sin ellas. Whisper escribió "Um" donde estaba [Uhm] y "Huh?" para [Question-huh]. Las risas no tienen palabras, pero la forma de onda las muestra. El suspiro apenas se nota. Probamos las etiquetas solo en inglés. Los autores las documentan para texto en inglés y en chino, así que las etiquetas dentro de un texto en español están sin probar.
El diseño de voz acertó todas las palabras. Pedimos, entre otras, "a gravelly old sea captain in his seventies, amused and a little hoarse" (un viejo capitán de barco de unos setenta años, de voz áspera, divertido y algo ronco), y cada frase diseñada volvió palabra por palabra. Las voces diseñadas son claramente distintas de nuestra referencia (de 0,25 a 0,32). Si cada voz encaja con su descripción, no lo medimos.
- Voz diseñada: un viejo capitán de barco (6,4 s)
Dónde falla: los números, y una voz que se genera más despacio de lo que se reproduce
Los números no son fiables, y el modelo va más lento que el tiempo real en todas las tarjetas que probamos.
Números. Los dos fallos vinieron del paso que convierte el texto escrito en palabras que pronunciar. En inglés, 4521 se leyó como "four thousand five hundred twenty, one", con una pausa. Un número de teléfono, 555-0142, se leyó como "five hundred fifty-five minus one hundred forty-two" (quinientos cincuenta y cinco menos ciento cuarenta y dos). El español se salta ese paso por completo. Así que "1.249,99 euros, un 12,5 %" salió deformado. Escribir los números en letra no arregló el caso en inglés. Si un precio o un número de pedido importa, comprueba el audio.
- Números mal leídos (16,1 s)
Velocidad. "Tiempo real" significa un segundo de audio generado en un segundo. En la RTX 2000 Ada, un párrafo en inglés de 20,7 segundos tardó de 31 a 32 segundos en generarse, y todas las frases menos un caso atípico en chino fueron a ese ritmo. La RTX 4090, una tarjeta muchísimo más rápida, generó un párrafo de 20,9 segundos en 27 segundos. Es cerca de un 17 % más rápido, y parte de esa mejora puede venir del procesador distinto de la máquina de la 4090.
El cuello de botella no era la tarjeta. La tarjeta pequeña estuvo ocupada menos de un tercio del tiempo, la 4090 como mucho una quinta parte. Ming escribe el audio en trozos de 80 milisegundos, uno detrás de otro. Entre trozo y trozo, un bucle escrito en Python lleva sus cuentas y le pasa el siguiente trozo a la tarjeta. En el tiempo que suenan 12,5 trozos, genera unos 8,5: dos tercios del ritmo. Imagina a un guitarrista de sesión que espera a que el director de la banda le cante cada acorde: contrata a un guitarrista más rápido y la canción sigue yendo al ritmo del director.
La hoja de ruta de los autores da por terminado el soporte de un motor de servicio más rápido, vLLM-Omni. No probamos esa vía, así que sigue abierto si arregla la velocidad.
Una petición fue mucho más lenta: el propio ejemplo de diseño de voz en chino de los autores tardó 50 segundos para 5 segundos de audio, porque el modelo nunca decidió que un trozo de texto había terminado. No lo vimos en inglés ni en español.
Qué GPU: limitado a 3 GB, el audio fue idéntico
La configuración más pequeña que funcionó: nuestra tarjeta de 16 GB con el modelo limitado a solo 3 GB de su memoria, con los ajustes por defecto. El audio fue idéntico byte a byte al de la ejecución sin límite, a la misma velocidad.
El driver necesita unos 0,4 GB más, así que estimamos que basta con una tarjeta de 4 GB, sin probarlo.
Ninguna tarjeta real de menos de 16 GB llegó a ejecutarlo. Probamos dos veces una RTX 3080 Ti de 12 GB, y las dos máquinas arrancaron sin el acceso remoto que necesita nuestro montaje, así que ninguna llegó a ejecutar el modelo. Las tarjetas de 8 GB estaban agotadas. Un chip más pequeño también podría ser más lento que el nuestro, y no tenemos cifra para eso.
En InferenceKey: listo en 60 segundos, con el código de los propios autores detrás de una API
En tu propia GPU puedes ejecutar el código de los autores tal cual, sin esperar a que alguien lo empaquete, y el nuestro estaba sirviendo en 60,3 segundos. InferenceKey no tiene soporte preparado para Ming, y los autores lo distribuyen como código Python, así que pusimos ese código detrás de una API. Nuestro backend a medida es un fichero corto de Python que InferenceKey instala y ejecuta en tu máquina con GPU. Descarga el código de los autores en una versión fija, baja los pesos y carga el modelo una vez. Tu aplicación lo llama igual que llama a la API de chat de OpenAI, y recibe el WAV dentro de la respuesta.
Desde una máquina limpia, cerca de la mitad de ese tiempo fue instalar las librerías de Python. Los 3 GB de pesos tardaron 7 segundos en descargarse y menos de 3 en cargarse. Con todo ya en disco, un reinicio tardó unos 13 segundos. El backend atiende una petición cada vez, y no probamos varias a la vez.
Una aspereza con la que tú también te vas a encontrar:
- Las aplicaciones hechas para OpenAI piden la voz en una dirección aparte, y esa dirección todavía no puede devolver el audio de un backend a medida. Así que el ejemplo usa la dirección de chat y saca el audio del texto de la respuesta. Estado: abierto, con seguimiento en IK-531.
¿Deberías usarlo? Sí para narración grabada en una tarjeta pequeña, no para voz en directo
- Si haces locuciones, muestras de audiolibros o demos narradas, merece la pena. Una tarjeta pequeña te da clonación, voces diseñadas y etiquetas, y la licencia permite el uso comercial. Las palabras y el parecido de la voz aguantaron las comprobaciones a máquina. Escucha las muestras de arriba antes de decidirte.
- Si necesitas un agente de voz que responda en tiempo real, de momento busca otra cosa. Genera la voz más despacio de lo que se reproduce, y una tarjeta más grande apenas ayuda.
- Si tu texto tiene precios, números de teléfono o fechas, comprueba cada uno en el audio.
- Si necesitas español, sirve para narración con voz clonada, revisando los números a mano. Nuestra voz de Pocket TTS en español anterior iba más rápida que el tiempo real en la CPU de un ordenador de sobremesa (1,05x), y Ming, de 0,61 a 0,77x en una GPU. No hemos comparado su calidad.
- Si tu tarjeta es pequeña, estimamos que unos 4 GB bastan en cuanto a memoria, sin probarlo (mira la sección de la GPU).
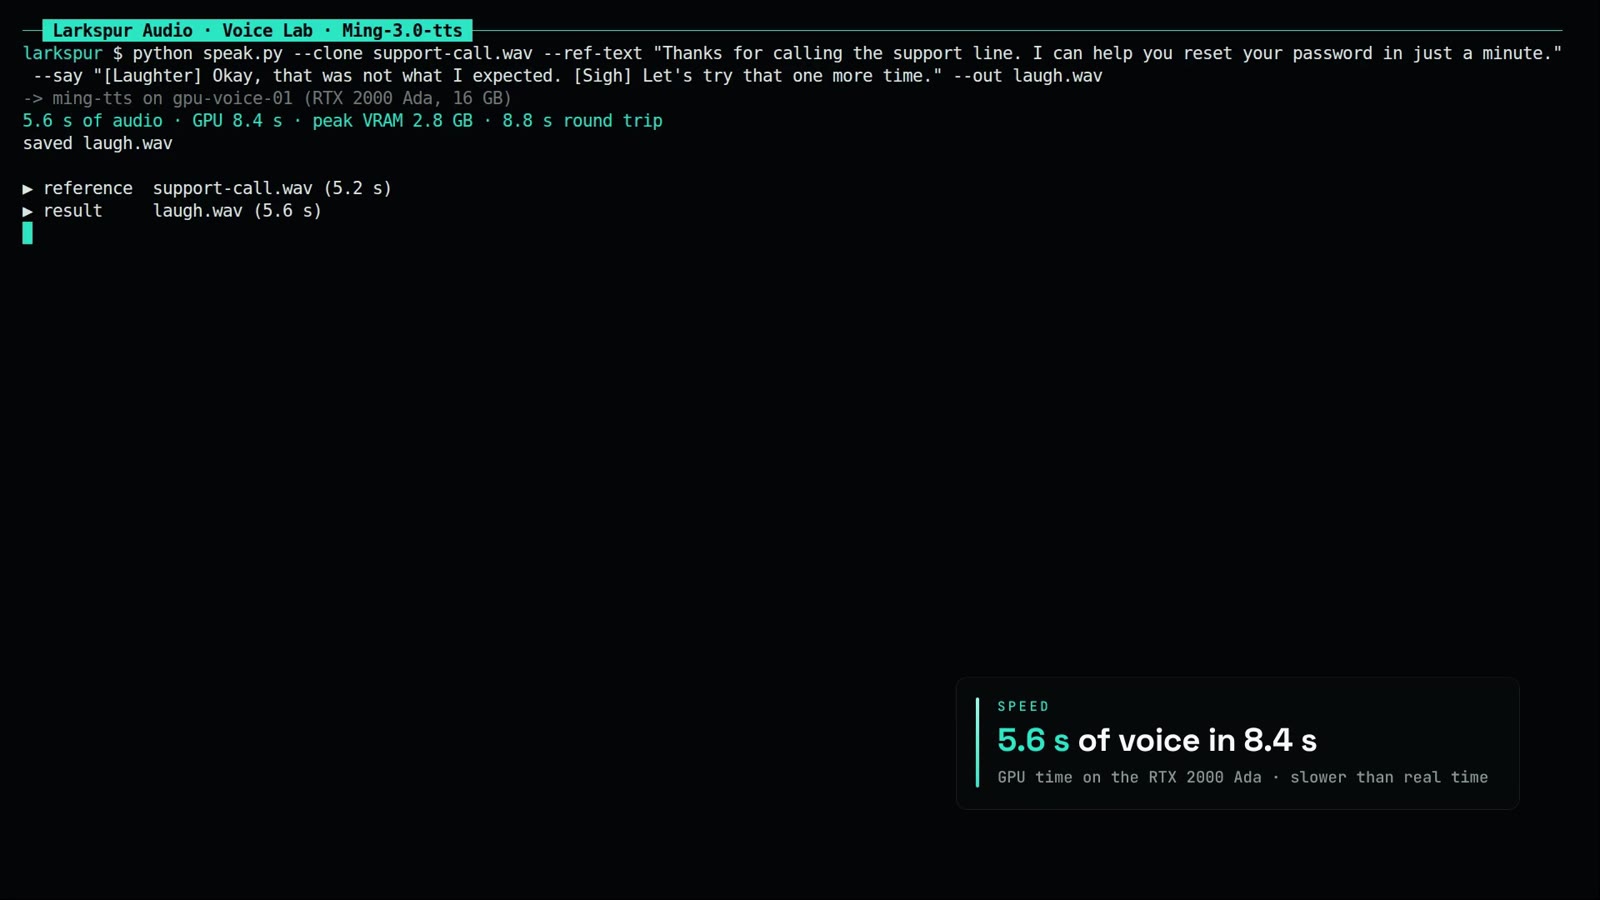
Para oír cuatro frases en tu propia GPU NVIDIA, publica el backend con python publish.py y ejecuta python main.py desde el ejemplo del SDK. Obtienes una voz integrada, una voz diseñada, un clon con una risa y un suspiro, y el mismo clon en español. Necesitas un proyecto de InferenceKey con un token del SDK y una API key. Tu máquina con GPU necesita un driver de NVIDIA al día (CUDA 12.4 o posterior) y unos 3 GB de memoria de GPU libres.
Para ingenieros
Modelo y ficheros
Ficha del modelo, GitHub (inclusionAI/Ming-3.0-tts), benchmarks de los autores. Repo inclusionAI/Ming-3.0-tts-0.5B, creado el 2026-09-22, lastModified 2026-10-27T12:07:15Z, sha 7247f4c94a5b2e987404ed28a5cfec41b1a4ca61, licencia MIT, sin acceso restringido, pipeline text-to-speech, 5.546 descargas y 156 likes el 2026-10-28.
model.safetensors: 2.959.055.504 B. Metadatos de safetensors: 1.479.454.868 parámetros (1.479.454.804 en BF16 más 64 en F32).campplus.onnx(codificador de hablante): 28.303.423 B. Repo completo de unos 3,0 GB, incluido un PDF de 390.569 B (Ming-3.0-tts-0.5B-TDS2026.pdf) y figuras.- Tabla de la ficha: denso, backbone Qwen2.5-0.5B, 0.5B parámetros. El fichero de pesos guarda unos 1,48B en total; los autores no desglosan dónde está el resto. También en la ficha: idiomas zh, en, de, es, fr, ko, ja, dialectos sichuanés y cantonés, API de Python
ming_tts.MingTTS, CLIinfer.py, 44,1 kHz. - Las 14 etiquetas:
[Breathing],[Cough],[Sigh],[Laughter],[Surprise-ah],[Surprise-oh],[Dissatisfaction-hnn],[Uhm],[Confirmation-en],[Question-ei],[Question-ah],[Question-en],[Question-oh],[Question-huh]. Documentadas para texto en chino o en inglés, distinguen mayúsculas y minúsculas, y se saltan la normalización del texto (cookbooks/instruction_en.md,frontend/toolkit.py). - Tareas:
TTS,FREEFORM,VOICE_DESIGN,MULTILINGUAL,BASIC,EMOTION,DIALECT,IP. - Declaración de hardware: "Tested on NVIDIA H800-80GB and H20-96G with CUDA 12.4. flash-attn is optional; inference falls back to PyTorch SDPA." Ninguna GPU más pequeña y ninguna cifra de VRAM.
- Código en el commit
9332fb9443325d4726ce02cefd4ec1c211df4079(2026-10-27, "docs: align recommended voices, catalogs and examples"), el commit que fija nuestro backend. Anteriores:028c1eac(2026-10-21, arreglo del troceado de textos largos),e999c39f(2026-10-19, "mark vLLM-Omni support").requirements.txtfija torch 2.6.0, torchaudio 2.6.0, transformers 4.46.3, accelerate 1.3.0, x_transformers 2.9.2, diffusers 0.33.0, soundfile 0.12.1, más onnxruntime, inflect, einops. pynini 2.1.6 (normalización del texto) y flash_attn 2.7.4.post1 son opcionales. Se ofrece una imagen de Docker (torch 2.6, CUDA 12.4, transformers 4.46.3). MingTTScarga entorch.bfloat16(fijo en el código) encuda:0. Valores por defecto desynthesize():cfg=2.0,sigma=0.25,temperature=0.0,max_length=24(troceado en fragmentos),max_decode_steps=1000. El texto con unlanguage_idque no sea zh/en se salta el normalizador FST ("Non-zh/en text is passed through unchanged").- Bucle de decodificación (
modeling_bailingmm.py): un forward del LLM más una cabeza de flow matching (FlowLoss.sample, 10 pasos por defecto, con CFG) por paso, hasta que salta una cabeza de parada. La caché KV estática de 512 posiciones limita el presupuesto a 512 menos la longitud del prompt. El VAE de audio usa un hop de 882 a 44.100 Hz con patch_size 4, así que un paso son 80 ms de audio y el tiempo real necesita 12,5 pasos/s. Medimos de 8,3 a 8,9 pasos/s. - El modelo hermano, Ming-3.0-tts-tiny, es un MoE sobre Ling V3 (7.9B en total, 1.3B activos), necesita su propio entorno (Python 3.10.15, torch 2.7.1+cu118), recomienda una H800 y es el único con diálogo de pódcast con varios hablantes. No lo ejecutamos.
- Clasificaciones que declara el README de GitHub (Artificial Analysis, octubre de 2026): 1.º entre los modelos de pesos abiertos en Controlled Voice (Elo 1069, 13.º en total), 1.º en total en Pronunciation Robustness (93,2 %), 3.º entre los de pesos abiertos en Provider Voice (Elo 1188, 17.º en total). El README no dice si son del 0.5b o del tiny. No lo comprobamos en artificialanalysis.ai.
Benchmarks de los autores (no reproducidos por nosotros)
| Prueba | Ming-3.0-tts-0.5B | Otros en la tabla de los autores |
|---|---|---|
| Seed-TTS EN WER (cuanto más bajo, mejor) | 1,584 % (SIM 0,691) | Qwen3-TTS-12Hz-1.7B 1,24, CosyVoice3-1.5B 1,45, F5-TTS 1,83, CosyVoice3-0.5B 2,02 |
| Seed-TTS ZH WER | 0,800 % | |
| MiniMax multilingual WER | alemán 0,365 %, español 1,099 % (SIM 0,763), francés 4,264 % (SIM 0,675) | |
| Media de diseño de voz en InstructTTSEval-ZH | 72,29 % | Qwen3-TTS 77,13, Ming tiny 75,37, Mimo-Audio-7B-Instruct 70,50, VoiceSculptor 67,30 |
| NVBench English single CER | 7,60 | Ming tiny 5,86, CosyVoice3 7,87 |
Limitaciones según los autores: el parecido del hablante es más flojo que la precisión del contenido (el SIM en francés es la diferencia más clara). NVBench Multi va por detrás de Single, así que la estabilidad con varias etiquetas por frase todavía está mejorando. La emoción cuesta más cuando las palabras no llevan ninguna señal emocional. El tono es menos preciso, y el diseño de voz abierto todavía no alcanza al mejor sistema evaluado. El aviso de uso prohíbe suplantar a una persona real sin su consentimiento y pide que la voz sintética se etiquete como sintética.
Nuestro montaje
- Una RTX 2000 Ada de 16 GB en nuestra nube (driver 595.91.07, compute capability 8.9, límite de 70 W, host AMD EPYC 7352 con 6 vCPU), registrada como worker en un manager local de InferenceKey. No se tocó producción en ningún momento. Una RTX A4000 y una RTX 4000 Ada estaban agotadas.
- Comprobación de velocidad: una RTX 4090 de 24 GB (450 W, host AMD EPYC 75F3), 5 casos.
- Backend a medida
ming-3-tts-05b0.1.0 (paquete de 7.215 bytes).setup()descarga el tarball del código de Ming en el commit fijado (se saltaming_tiny, figuras, docker, cookbooks), ejecutasnapshot_downloadde la revisión fijada (sin el PDF ni las figuras), construyeMingTTS(model_dir, device, text_normalization=True)con el wheel de pynini 2.1.6.post1, aplica unMING_VRAM_LIMIT_GIBopcional mediantetorch.cuda.set_per_process_memory_fractiony calienta con la voz integrada US_Emma. bf16, SDPA, valores por defecto de los autores, semilla 1895. - Voz de referencia: clip sintético en inglés de 5,22 s con la voz de serie "anna" de nuestro Pocket TTS local: "Thanks for calling the support line. I can help you reset your password in just a minute." Frase del clon en español: "Gracias por llamar. Su nueva contraseña ya está lista; por favor, vuelva a iniciar sesión en todos sus dispositivos."
- Comprobaciones en el pod:
openai/whisper-large-v3-turbocon el idioma forzado en cada caso, CAM++ (campplus.onnx, el codificador con el que se condiciona Ming) ymicrosoft/wavlm-base-plus-sv(independiente).
Tiempo hasta estar listo
| Fase | Tiempo |
|---|---|
De ensure() a listo, cachés vacías, RTX 2000 Ada | 60,3 s |
| de ellos: el worker construye el venv del backend | unos 32 s |
| de ellos: setup del backend | 26,4 s (código 0,9 s, pesos 7,1 s, carga 2,7 s, calentamiento 3,7 s) |
| Reinicios en caliente (venv y pesos en caché) | 13,1, 12,9, 12,7, 13,2 s |
De ensure() a listo, cachés vacías, RTX 4090 | 47,3 s |
Por petición, RTX 2000 Ada
POST /endpoint/<project>/ming-tts/v1/chat/completions sin streaming. GPU s es el tiempo sincronizado que mide el backend alrededor de synthesize(). La ida y vuelta se mide en el cliente, a través de un túnel.
| Caso | Tarea | Audio s | GPU s | x tiempo real | Pico asignado MiB | Ida y vuelta s | Lo que oyó Whisper |
|---|---|---|---|---|---|---|---|
| en-ip-george | IP UK_George | 5,3 | 8,39 | 0,63 | 2.919 | 8,52 | exacto |
| en-ip-emma | IP US_Emma | 8,2 | 12,95 | 0,63 | 2.924 | 13,18 | exacto ("I am" por "I'm") |
| en-freeform-coach | FREEFORM | 4,9 | 7,79 | 0,63 | 2.890 | 8,01 | exacto |
| en-freeform-whisper | FREEFORM ("Whisper, tense and frightened") | 2,9 | 4,79 | 0,61 | 2.888 | 4,96 | exacto |
| en-design-narrator | VOICE_DESIGN | 4,2 | 6,71 | 0,63 | 2.926 | 6,91 | exacto |
| en-design-captain | VOICE_DESIGN | 6,4 | 10,03 | 0,64 | 2.927 | 10,24 | exacto |
| en-design-girl | VOICE_DESIGN | 3,5 | 5,66 | 0,62 | 2.922 | 5,84 | exacto |
| en-clone | TTS + referencia | 4,5 | 7,07 | 0,64 | 2.916 | 7,53 | exacto |
| en-clone-tags | TTS + referencia, [Laughter] [Sigh] [Uhm] | 7,0 | 11,02 | 0,63 | 2.922 | 11,49 | exacto + "Um," |
| en-clone-notags (control) | mismo texto, sin etiquetas | 5,3 | 8,05 | 0,66 | 2.917 | 8,62 | exacto |
| en-ip-tags | IP, [Breathing] [Cough] [Question-huh] | 5,5 | 8,71 | 0,63 | 2.924 | 8,92 | texto + "Huh?" |
| en-ip-notags (control) | mismo texto, sin etiquetas | 4,2 | 6,40 | 0,66 | 2.920 | 6,58 | exacto |
| en-numbers | IP US_Emma | 16,1 | 25,04 | 0,64 | 2.936 | 25,32 | números mal |
| en-numbers-words (control) | números escritos en letra | 5,9 | 8,92 | 0,66 | 2.920 | 9,12 | "Order Number 40, 520, 1 ... 2020, 6." |
| en-long | IP UK_George, 61 palabras | 20,7 | 32,41 | 0,64 | 2.923 | 32,96 | exacto |
| es-clone | MULTILINGUAL es + referencia en inglés | 6,9 | 10,48 | 0,66 | 2.920 | 10,85 | exacto |
| es-ip-emma | IP US_Emma + language_id es | 7,6 | 11,60 | 0,66 | 2.927 | 11,79 | exacto |
| es-design | VOICE_DESIGN + es | 4,9 | 7,64 | 0,64 | 2.930 | 7,82 | exacto |
| es-freeform | FREEFORM + es | 5,7 | 8,62 | 0,66 | 2.894 | 8,83 | exacto |
| es-long | MULTILINGUAL es, 52 palabras | 18,5 | 28,01 | 0,66 | 2.922 | 28,61 | exacto |
| es-numbers | MULTILINGUAL es | 11,4 | 17,08 | 0,67 | 2.927 | 17,99 | números mal |
| zh-design-authors | VOICE_DESIGN, el ejemplo en chino de los autores | 5,0 | 49,84 | 0,10 | 2.988 | 50,00 | exacto |
- Ida y vuelta menos tiempo de GPU: de 0,13 a 0,9 s (WAV en base64 a través del túnel y del bus de mensajes; un clip de 20 s ocupa unos 1,8 MB en bruto). Entre ejecuciones, el párrafo de 20,7 s tardó de 31,0 a 32,4 s de tiempo de GPU.
zh-design-authors: el texto se partió en dos fragmentos y el primero agotó todo el presupuesto de decodificación (343 pasos, 41 s, la cabeza de parada nunca saltó) antes de recortar el silencio final.- Memoria de GPU: 2.846 MiB asignados tras la carga, de 2.888 a 2.936 MiB de pico asignado por petición (2.988 MiB en el caso atípico en chino). Pico de la tarjeta según nvidia-smi, 3.336 MiB, incluido el contexto de CUDA. Uso de la GPU del 23 al 31 %, unos 24 W de 70 W.
- El backend atiende una petición cada vez (un lock más concurrencia 1 en el workload). Sin prueba en paralelo.
- Con la misma semilla, las salidas son deterministas en cada tarjeta pero cambian un poco entre tarjetas (5,2 frente a 5,3 s en en-ip-george, 7,0 frente a 6,4 s en el capitán).
Comprobación de velocidad en la RTX 4090
| Caso | Audio s | GPU s | x tiempo real | Ida y vuelta s |
|---|---|---|---|---|
| en-ip-george | 5,2 | 6,85 | 0,76 | 8,44 |
| en-design-captain | 7,0 | 9,05 | 0,77 | 9,62 |
| en-clone-tags | 6,9 | 8,94 | 0,77 | 9,80 |
| en-long | 20,9 | 27,11 / 27,79 | 0,77 / 0,75 | 27,94 / 28,49 |
| es-clone | 6,9 | 9,23 | 0,75 | 9,93 |
nvidia-smi durante en-long: 3.562 MiB, del 14 al 20 % de uso, unos 81 W de 450 W. El bucle de pasos está limitado por los lanzamientos y por la CPU. No separamos qué parte de la mejora de cerca del 17 % viene de la CPU más rápida del host.
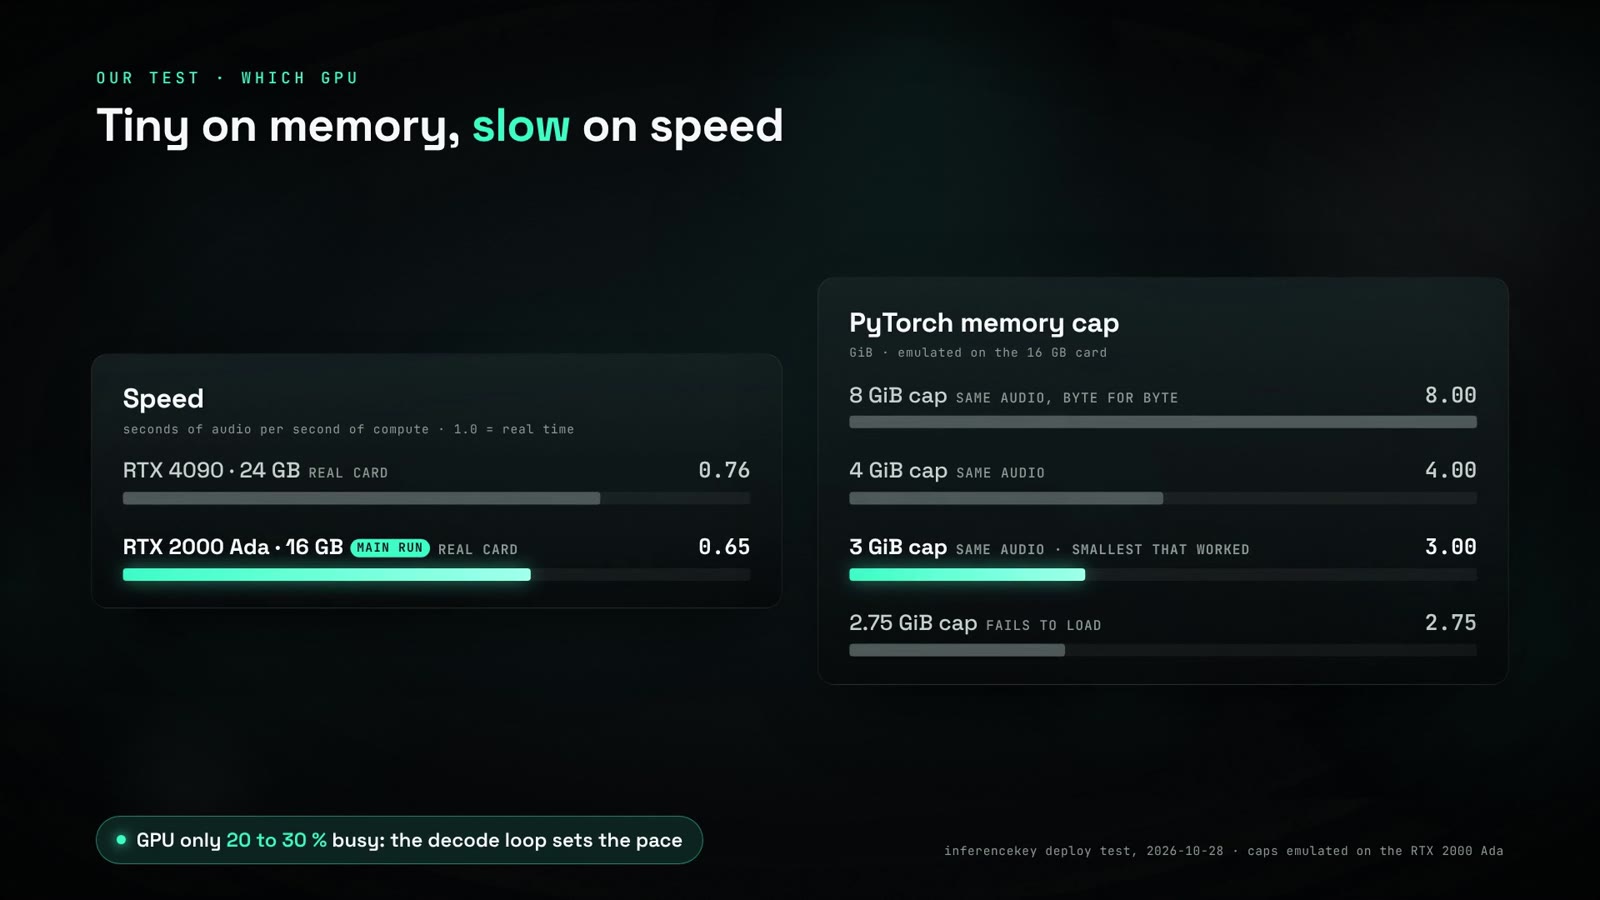
Escalera de VRAM
El texto principal redondea estos límites a GB; los valores exactos son GiB. Límites fijados con MING_VRAM_LIMIT_GIB (torch.cuda.set_per_process_memory_fraction) en la RTX 2000 Ada, cada uno con un ensure() nuevo y las cachés calientes. Los WAV de en-clone-tags, en-ip-george, en-long y es-clone se compararon por md5 con la ejecución sin límite.
| Peldaño | Configuración | Pico asignado | Velocidad | Salida | Real o emulado |
|---|---|---|---|---|---|
| RTX 4090 24 GB | bf16, SDPA, por defecto | 2.923 MiB (3.562 MiB de tarjeta) | de 0,75 a 0,77x | texto exacto en el subconjunto | real |
| RTX 2000 Ada 16 GB | bf16, SDPA, por defecto (ejecución principal) | 2.936 MiB (3.336 MiB de tarjeta) | de 0,61 a 0,68x | referencia | real |
| Límite de 8 GiB | MING_VRAM_LIMIT_GIB=8 | 2.923 MiB | de 0,66 a 0,67x | idéntico byte a byte | emulado |
| Límite de 4 GiB | MING_VRAM_LIMIT_GIB=4 | 2.923 MiB | de 0,64 a 0,66x | idéntico byte a byte | emulado |
| Límite de 3 GiB | MING_VRAM_LIMIT_GIB=3 | 2.923 MiB | de 0,65 a 0,68x | idéntico byte a byte | emulado |
| Límite de 2,75 GiB | MING_VRAM_LIMIT_GIB=2.75 | setup() failed: CUDA out of memory. Tried to allocate 20.00 MiB ... this process has 2.83 GiB memory in use. 2.75 GiB allowed | emulado | ||
| RTX 3080 Ti 12 GB | dos intentos | la máquina arrancó sin SSH directo (sin mapeo del puerto 22) y el manager la terminó a los 180 s, las dos veces | real, nunca se ejecutó |
Sin probar: ninguna tarjeta real de menos de 16 GB, fp16 en tarjetas anteriores a Ampere, flash-attn, vLLM-Omni, CPU.
Detalles de calidad
- Palabras: 17 de 19 clips de la batería, palabra por palabra. Los subconjuntos de la escalera y de la 4090 dieron un texto idéntico.
- Números en inglés. La salida del normalizador en el log del backend fue
Order number four thousand, five hundred twenty,one ships on March three , two thousand twenty,six and costs one thousand, two hundred forty,nine point nine nine dollars , about twelve point five percent less than last year. Call five hundred fifty,five minus one hundred forty,two .El guion se convierte en una coma de ancho completo (una pausa), y el número de teléfono 555-0142 se lee como una resta. Whisper oyó "Order number 4520. One ships ... costs $1,240, $9.99 ... Call 550-5-142". Escribir los números en letra no lo evitó ("forty-five twenty-one" se convirtió en "40, 520, 1"). - Los números en español se saltan el normalizador: "1.249,99 euros, un 12,5 %" se oyó como "1.1249.99 euros, un 2,5%".
- Parecido del hablante, coseno de CAM++ frente a la referencia: en-clone 0,865, en-clone-tags 0,849, es-clone 0,838, es-long 0,853, es-numbers 0,836. Lo que no son clones, de 0,162 (chino) a 0,540 (US_Emma). Voces diseñadas, de 0,25 a 0,32. WavLM-SV: clones de 0,924 a 0,970, pero la voz integrada US_Emma (una voz femenina, como la referencia) también de 0,84 a 0,86, así que WavLM separa menos. La clonación entre idiomas (referencia en inglés, salida en español) conservó la voz igual de bien que la clonación en el mismo idioma con las dos medidas.
- Etiquetas: 7,0 frente a 5,3 s (clon,
[Laughter][Sigh][Uhm]) y 5,5 frente a 4,2 s (voz integrada,[Breathing][Cough][Question-huh]). Las cajas de las etiquetas en la imagen principal salen de las marcas de tiempo por palabra de Whisper y son aproximadas. Sin prueba de escucha humana. - El diseño de voz y las indicaciones libres en inglés y en español dieron un texto exacto. Entre los prompts estaban "A gravelly old sea captain in his seventies, amused and a little hoarse..." y "Whisper, tense and frightened, very quietly and slowly." No se midió si la voz encaja con la descripción.
- Ningún cuelgue, NaN ni salida vacía en unas 60 peticiones.
- Sin comparación directa en español con nuestro fine-tune anterior de Pocket TTS en español: ni el mismo texto, ni un evaluador común, ni escucha. El único contraste es la velocidad, en hardware distinto: ese fine-tune iba a 1,05x tiempo real en la CPU de un ordenador de sobremesa, y Ming, de 0,61 a 0,77x en GPU.
Paso a paso con el ejemplo del SDK
El ejemplo del SDK es el commit b038dd7529651076b5055604584c1fd1b51f517c en la rama main de inferencekey-sdk: backend.py, publish.py, main.py, requirements.txt, README.md, .env.example, .gitignore.
Necesitas un token del SDK (ik_sdk_), una API key (ik_live_), el slug de un proyecto y un worker NVIDIA registrado (IK_WORKER_ID) con un driver para CUDA 12.4 o posterior y unos 3 GB de VRAM libres. INFERENCEKEY_TENANT_ID e INFERENCEKEY_USER_TOKEN son opcionales. Sin ellos, sube dist/*.tar.gz desde Dashboard, Custom backends, y activa Chat a mano en los ajustes del endpoint del workload.
cp .env.example .env        # fill in real values
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )
python publish.py           # once: packages backend.py and uploads it
python main.py              # ensure -> wait until ready -> 4 WAV files in ./outputs
main.py despliega el workload (ensure(), política fija, una réplica), activa la ruta de chat, espera a que esté listo, escribe cuatro WAV y borra el workload al salir (IK_KEEP_ALIVE=1 lo mantiene). Nuestra ejecución con IK_KEEP_ALIVE=1:
| Salida | Audio | Tiempo de GPU | x tiempo real |
|---|---|---|---|
| 1-built-in-voice (UK_George) | 5,3 s | 7,899 s | 0,67 |
| 2-voice-design (narrador) | 4,2 s | 6,12 s | 0,69 |
3-clone-with-tags ([Laughter], [Sigh]) | 6,0 s | 9,124 s | 0,66 |
| 4-clone-spanish | 4,3 s | 7,201 s | 0,60 |
Pico de VRAM de 2.912 a 2.926 MiB. Listo a los 60,3 s.
Forma de la petición. El texto es el último mensaje del usuario, una referencia va como una parte input_audio, y las opciones van en extra_body (task, language_id, style, instruction, voice, prompt_text, seed, cfg, sigma). El contenido del mensaje de respuesta es una cadena JSON con audio_b64 (WAV de 16 bits, 44,1 kHz), seconds, task y timings (gpu_s, total_s, realtime_factor, peak_vram_mib). Límites: 600 caracteres de texto y 30 s de referencia por petición.
import base64, json, os, requests

base = os.environ.get("INFERENCEKEY_BASE_URL", "https://cloud.inferencekey.com").rstrip("/")
project = os.environ["INFERENCEKEY_PROJECT"]
api_key = os.environ["INFERENCEKEY_API_KEY"]
slug = os.environ.get("MING_WORKLOAD_SLUG", "ming-tts")
ref_b64 = base64.b64encode(open("reference.wav", "rb").read()).decode()
REFERENCE_TRANSCRIPT = "Thanks for calling the support line. I can help you reset your password in just a minute."

body = {
    "model": "default",
    "messages": [{"role": "user", "content": [
        {"type": "text", "text": "[Laughter] I did not expect that at all. [Sigh] Well, let's try one more time."},
        {"type": "input_audio", "input_audio": {"data": ref_b64, "format": "wav"}},
    ]}],
    "extra_body": {"task": "TTS", "prompt_text": REFERENCE_TRANSCRIPT, "language_id": "en", "seed": 1895},
}
r = requests.post(f"{base}/endpoint/{project}/{slug}/v1/chat/completions",
                  headers={"Authorization": f"Bearer {api_key}"}, json=body, timeout=600)
out = json.loads(r.json()["choices"][0]["message"]["content"])  # IK-531 workaround
open("clone.wav", "wb").write(base64.b64decode(out["audio_b64"]))
Para español, alemán, francés, coreano o japonés usa "task": "MULTILINGUAL" con "language_id": "es" (y así con cada idioma). Para una voz diseñada usa "task": "VOICE_DESIGN" con "style". Para una voz integrada usa "task": "IP" con "voice": "UK_George".
Problemas encontrados
- Más lento que el tiempo real en las dos tarjetas (de 0,61 a 0,77x), con la GPU ocupada del 14 al 31 %. El bucle de pasos en Python de los autores marca el ritmo. El soporte de vLLM-Omni figura como terminado en su hoja de ruta. No probamos esa vía.
- Números: los números en inglés escritos con guion llevan una pausa y los números de teléfono se convierten en restas. Los números en español se saltan el normalizador y salen deformados. Estado: comportamiento del proyecto original, abierto. Comprueba los números en la salida.
- El ejemplo de diseño de voz en chino llegó una vez al límite de decodificación: 49,8 s para 5 s de audio. No se vio en inglés ni en español.
/v1/audio/speechno puede llevar la salida de un backend a medida: el ejemplo usa la ruta de chat y unjson.loadsdel contenido del mensaje. Abierto, IK-531.- Subida del backend rechazada en nuestra máquina de desarrollo (
XMinioStorageFull, disco lleno al 99 %, más o menos). Lo arreglamos para la ejecución liberando nuestros propios ficheros. Un problema del entorno de pruebas, no uno que vayas a ver tú. - Máquinas RTX 3080 Ti sin SSH directo (dos veces): no se pudo instalar el worker y el manager terminó cada una a los 180 s.
- Estético: el panel mostraba una insignia de Access "No access" mientras una clave comodín funcionaba.
- Avisos de carga del proyecto original, con salida correcta:
You are using a model of type dense to instantiate a model of type bailingmm,Sliding Window Attention is enabled but not implemented for sdpa, y un aviso de obsolescencia depast_key_valuesde transformers.
Resto de muestras
- Párrafo en español, voz clonada, 52 palabras (18,6 s)
- Voz integrada UK_George (5,3 s)
- Voz diseñada: una niña (3,5 s)
- Voz diseñada: un narrador tranquilo (4,2 s)
- Indicación libre: "Whisper, tense and frightened" (3,0 s)
Vídeo de la demo
Un recorrido de 191 segundos: los clips de demo de los propios autores (con el reconocimiento a inclusionAI, Ant Group), sus benchmarks, nuestra prueba en forma de preguntas y respuestas, y qué GPU. Subtítulos en inglés.
Fuentes
- Ficha del modelo: https://huggingface.co/inclusionAI/Ming-3.0-tts-0.5B (API de HF consultada el 2026-10-28)
- Código: https://github.com/inclusionAI/Ming-3.0-tts en el commit
9332fb94, incluidosrequirements.txt,ming_tts.py,modeling_bailingmm.py,fm/flowloss.py,cookbooks/instruction_en.md - Benchmarks de los autores y clasificaciones que declaran: https://github.com/inclusionAI/Ming-3.0-tts#performance
- Dónde lo vimos: vídeo de noticias de AI Search del 2026-10-25, capítulo en el 13:33, https://www.youtube.com/watch?v=EfyQOAJjx1A
- Nuestro ejemplo del SDK: https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/ming-3-tts-05b-speech-custom-backend-private-nvidia
- Nuestras mediciones: prueba de despliegue del 2026-10-28 (logs de la batería, de la escalera y de la 4090, resúmenes por caso, resultados de Whisper y de parecido del hablante, muestras de nvidia-smi)