Carbon-X lit l'ADN sur une carte de 24 GB : 3 étiquettes sur 4 justes, pas les raisons
Le modèle de chat ADN de Hugging Face, vLLM standard, RTX 4090 de 24 GB en FP8 : 75 % sur 40 variants ClinVar, 50 tokens/s, explications souvent fausses.
Carbon-X a lu 55 lettres d'un gène humain portant le seul changement à l'origine de la drépanocytose, et l'a signalé comme pathogène. Sur l'une de nos deux cartes, il a ensuite justifié sa réponse en désignant la mauvaise lettre.
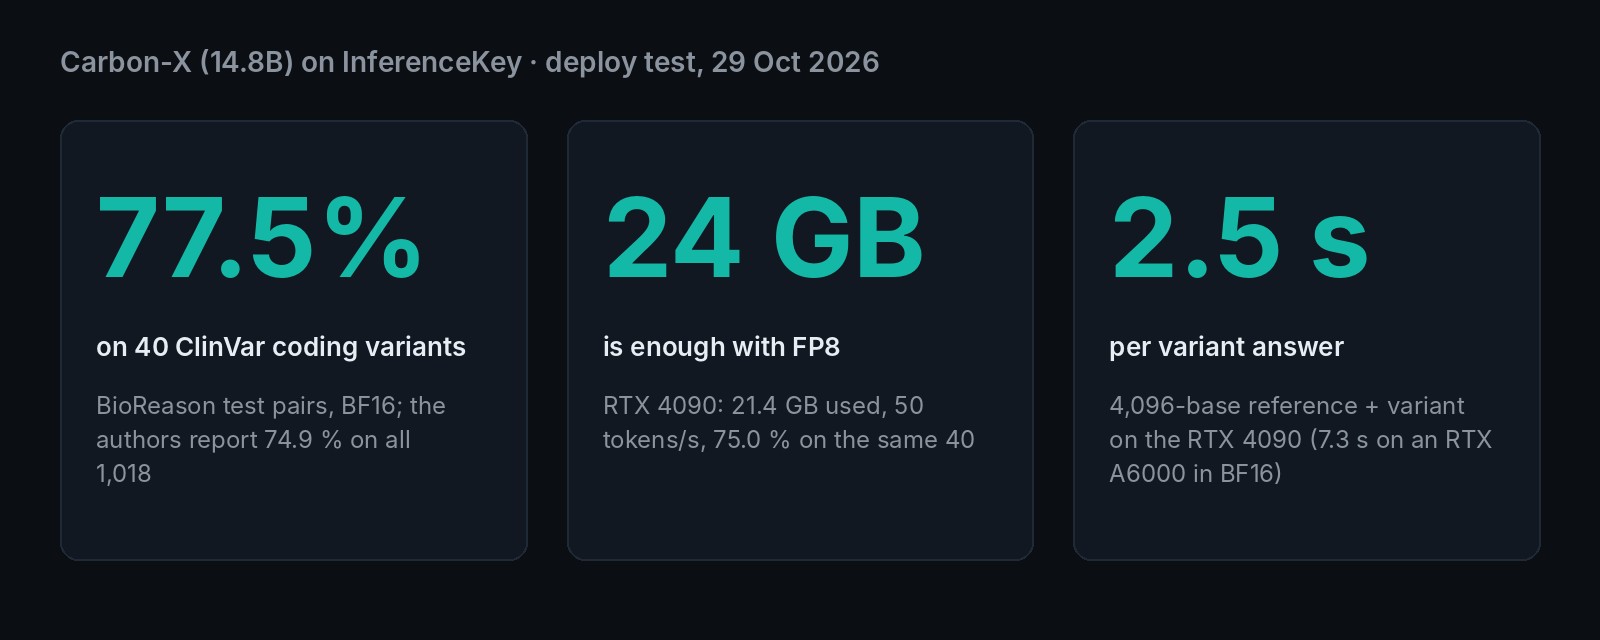
Carbon-X est le nouveau modèle ouvert de Hugging Face qui lit de l'ADN brut au milieu d'une conversation ordinaire et répond en anglais. Nous l'avons servi avec des logiciels ouverts non modifiés sur une RTX 4090, une carte gaming de 24 GB, sur notre cloud. Sur cette carte, il a classé correctement comme nocifs ou inoffensifs 75 % de 40 changements d'ADN connus tirés de ClinVar, une base publique de données génétiques (auteurs : 74,9 %). Il a répondu sur une paire de séquences de 4 096 lettres en 2,5 secondes environ. Si vous faites tourner vos propres GPU, c'est un spécialiste de l'ADN qui garde les séquences non publiées sur votre machine et tourne sur un logiciel de service ouvert standard avec une seule commande. Servez-vous de ses étiquettes nocif ou inoffensif comme premier tri. Ne vous fiez pas à ses explications.
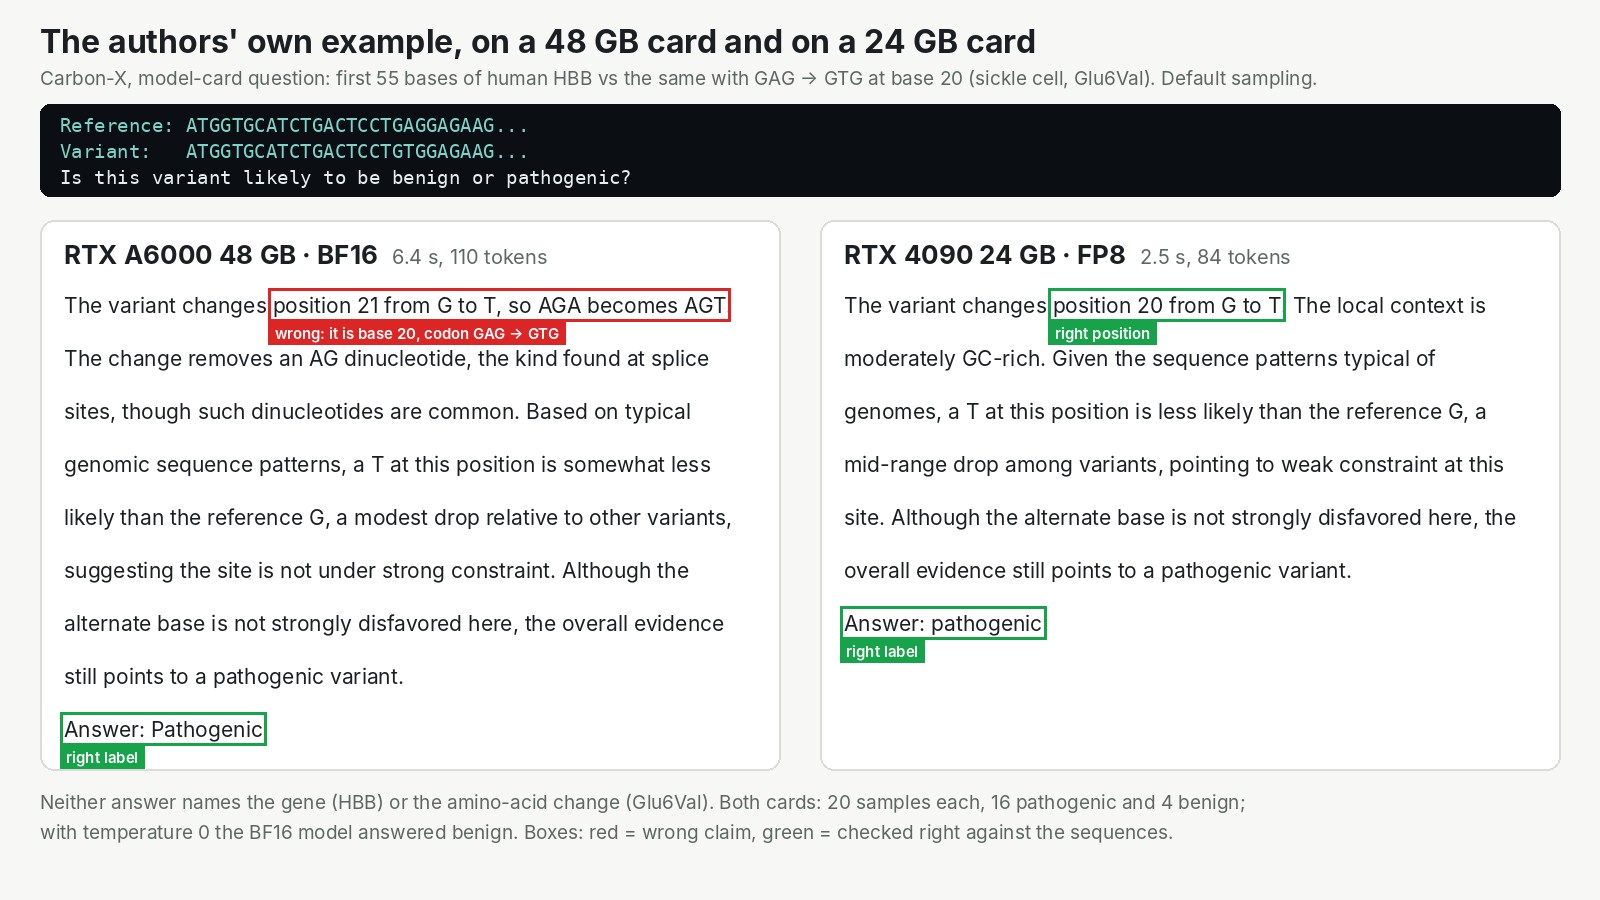
L'image montre une seule exécution sur chaque carte. Les deux ont donné la bonne étiquette, et aucune n'a nommé le gène ni le changement dans la protéine. Sur 20 essais par carte, la réponse a été pathogène 16 fois et bénigne 4 fois. La carte de 48 GB a cité la mauvaise base dans 12 essais sur 20. Les exécutions avec des poids réduits ont cité la bonne dans 16 et 18 essais sur 20. Quand nous avons retiré le hasard intégré au modèle, la carte de 48 GB a dit bénin.
Un modèle de chat qui lit l'ADN six lettres à la fois
Carbon-X n'est pas un nouveau type de modèle, et c'est pour cela qu'il a été facile à servir. Sous le capot, c'est Qwen3-14B, le modèle de chat ouvert de 14,8 milliards de paramètres de l'équipe Qwen, réentraîné sur de l'ADN et des textes de biologie. Hugging Face a ajouté une seule chose à l'entrée : une nouvelle façon de découper l'ADN en morceaux avant que le modèle ne le lise.
Les modèles de langage lisent le texte sous forme de tokens, des fragments de quelques lettres chacun. Le découpage habituel de Qwen hache l'ADN en morceaux bizarres, si bien que les longues séquences coûtent beaucoup de tokens. Carbon-X ajoute 5 515 tokens d'ADN à ceux que Qwen connaît déjà. La plupart (4 096) sont des blocs de six lettres faits de A, C, G et T, donc un token couvre six bases. Imaginez un guitariste qui lit un trait de six notes comme une seule forme plutôt que six notes séparées.
C'est grâce aux six lettres par token que l'ADN long tient. Dans notre test, deux séquences de 4 096 lettres plus la question ont fait 1 445 tokens. Une figure des auteurs montre une question courte avec une séquence de 27 lettres qui prend 20 tokens avec le tokenizer de Qwen3 et 13 avec celui de Carbon-X.
Vous n'avez pas à marquer l'ADN vous-même. Toute suite de six lettres A, C, G et T ou plus dans votre message est marquée comme ADN automatiquement. Collez une séquence dans une phrase et demandez : ce variant est-il nocif, à quoi sert cette région, quelles bases viennent ensuite.
Le piège, pour le service, c'est que ce découpage est du code Python sur mesure livré avec le modèle. Vous devez laisser le logiciel de service exécuter du Python venu du dépôt du modèle sur votre propre machine. Nous avons lu ce fichier d'abord : il n'utilise que des bibliothèques Python standard et très répandues. Au premier chargement, il télécharge aussi le vocabulaire de base de Qwen depuis Hugging Face, donc la machine a besoin d'un accès à internet à ce moment-là. Le reste est un modèle 14B standard.
Hugging Face annonce 66,7 %, proche de GPT-6.1 Sol pour une fraction du coût
Le chiffre phare des auteurs, dans leur blog de lancement et sur la fiche du modèle, est une moyenne de 66,7 % sur cinq benchmarks d'ADN. GPT-6.1 Sol obtient 67,5 % dans le même tableau et Opus 5.5 60,9 %. Hugging Face a chiffré son propre modèle à 5 dollars l'heure de GPU, et les autres aux prix publics de leurs API : pour 1 800 dollars dépensés avec Sol, Carbon-X en dépense environ un. Le sous-titre du blog dit 1 000x à la place.
L'affirmation la plus concrète porte sur ClinVar, la base publique où les laboratoires déposent des variants génétiques et ce qu'ils pensent de l'effet de chacun. Environ 2,4 millions de ses variants restent de signification incertaine. Les auteurs estiment que les noter tous une fois avec Carbon-X coûterait environ 300 dollars (leur graphique indique 271), contre 32 000 dollars à 4 millions avec les modèles de pointe. Nous n'avons reproduit ni cette estimation ni les 66,7 % : leurs données d'évaluation ne sont pas publiques, nous avons donc construit notre propre jeu à partir de sources publiques.
Nous avons repéré Carbon-X dans le récapitulatif AI NEWS d'AI Search du 25 octobre. Cette vidéo dit que Carbon-X dépasse GPT-6.1 en moyenne. Le propre tableau des auteurs le place 0,8 point derrière Sol. La fiche du modèle dit que llama.cpp et les runtimes GGUF ne sont pas pris en charge, et pourtant la démo du blog des auteurs fait tourner un GGUF 8 bits sur un MacBook à 34 tokens par seconde. Nous n'avons pas testé la voie du portable.
Notre test : deux vraies cartes, 120 questions publiques, les réglages des auteurs
Nous avons servi Carbon-X sur deux cartes de notre cloud. Un modèle, c'est surtout ses poids, les 14,8 milliards de nombres qu'il a appris. L'exécution principale a utilisé une RTX A6000 de 48 GB et gardé chaque poids sur 16 bits, le format natif du modèle. La seconde a utilisé une RTX 4090 de 24 GB et réduit chaque poids à 8 bits au chargement, ce qui divise presque par deux leur mémoire. Les deux exécutions sont passées par notre plateforme, comme une application l'appellerait.
Le jeu de questions comptait 120 éléments, tous issus de données publiques. Quarante étaient de vrais variants ClinVar dans des gènes codant des protéines, 20 inoffensifs et 20 nocifs, tirés du même jeu de test que celui des auteurs. Le modèle ne voyait que la séquence de référence, la séquence modifiée et notre question, jamais le nom du gène. Soixante étaient des questions à choix multiples de GenomeQA sur le rôle d'une région d'ADN, dix par tâche. Vingt demandaient les 24 bases suivantes d'un gène humain.
Nous avons utilisé les réglages des auteurs : pas de raisonnement pas à pas avant de répondre, et un peu de hasard dans chaque réponse. Nous avons aussi fait tourner le tout sans hasard.
Une limite dès le départ : 40 et 60 questions, ce sont de petits échantillons. Sur 40 variants, un score de 77,5 % pourrait honnêtement se situer n'importe où entre 64 % et 90 % environ. Lisez nos chiffres comme "conforme aux auteurs ou non", pas comme un classement.
Résultats : sur de vrais variants ClinVar, les étiquettes rejoignent celles des auteurs
Carbon-X a étiqueté correctement 77,5 % de nos 40 variants ClinVar sur la carte de 48 GB avec les réglages des auteurs. Les auteurs annoncent 74,9 % sur les 1 018 variants de ce test. Sur GenomeQA, il a obtenu 65,0 %, contre 63,6 % pour les auteurs.
| Variants ClinVar (40) | GenomeQA (60) | Vitesse, une requête | |
|---|---|---|---|
| RTX A6000 48 GB, 16 bits, réglages des auteurs | 77,5 % | 65,0 % | |
| RTX A6000 48 GB, 16 bits, sans hasard | 80,0 % | 65,0 % | 19,5 tokens/s |
| RTX 4090 24 GB, 8 bits, sans hasard | 75,0 % | 66,7 % | 50,5 tokens/s |
| Auteurs (jeux complets) | 74,9 % | 63,6 % |
À conditions égales, sans hasard, la 4090 a obtenu 75,0 % contre 80,0 % : deux variants sur 40, dans le bruit. Ses réponses ont coïncidé avec celles de la carte de 48 GB sur 36 variants sur 40 et 57 questions sur 60. Supprimer le hasard a changé une réponse sur 40. Ce qui limite ces chiffres, c'est la petite taille de l'échantillon.
Les erreurs penchent d'un côté. Sur la carte de 48 GB, le modèle a repéré 19 des 20 variants nocifs, mais seulement 12 des 20 inoffensifs. Il a donc signalé 8 variants inoffensifs sur 20. Sur une longue liste réelle, cela fait beaucoup de cas inoffensifs à revoir par un humain.
Sur la 4090, une question complète sur un variant avec deux séquences de 4 096 lettres revient en 2,4 à 2,6 secondes, contre 7,1 à 7,5 sur la carte de 48 GB en 16 bits. L'essentiel du gain vient des poids sur 8 bits : avec eux, même la carte de 48 GB a répondu à la même question en 4 secondes environ.
Là où il casse : l'étiquette tient, le raisonnement non
Les verdicts sont exploitables, mais les explications qui les entourent sont souvent fausses, même quand le verdict est juste. C'est important, parce qu'une réponse de chat dans un anglais fluide invite à faire confiance au raisonnement.
Sur un vrai variant ClinVar où un T était devenu un C, il a donné la bonne étiquette avec la justification "The variant changes C to C". Face à 93 bases du gène de la bêta-globine, il les a traduites correctement en protéine, puis a dit que le gène était PKM2, un autre gène. Les auteurs préviennent exactement de cela : le modèle "can miscount bases, confuse coordinates" et peut inventer l'identité d'une séquence.
Certaines tâches sont faibles aussi. Sur deux des six tâches de GenomeQA, il a obtenu 3 sur 10 à chaque fois, à peu près aussi faible que ce qu'annoncent les auteurs (29,8 % et 34,6 %). Quand on lui a demandé les 24 bases suivantes d'un gène humain, il a trouvé environ 29 % des bases, là où le hasard en trouve 25 %. Ce jeu est le nôtre, pas le benchmark NextBase des auteurs (39,4 %), donc les deux ne sont pas directement comparables.
Ce n'est pas un outil clinique, et les auteurs le disent.
Quel GPU : une RTX 4090 de 24 GB avec des poids sur 8 bits, pas la carte de 80 GB de la fiche du modèle
La plus petite carte qui a fonctionné est une vraie RTX 4090 de 24 GB, avec les poids réduits à 8 bits et de la place pour 8 192 tokens par conversation. Elle a culminé à 21,4 GB et a répondu plus vite que la carte de 48 GB (voir Résultats).
En pleine précision 16 bits, il faut une carte de 48 GB. Notre RTX A6000 affichait 40,6 GB utilisés, et l'essentiel de ce qui dépasse les poids est de la place réservée au texte des conversations en cours. Les 80 GB de la fiche du modèle, pour un fichier de 29,6 GB, sont généreux.
Voici ce qui a tourné sur du vrai matériel et ce qui n'a pas marché :
- Vraies cartes : RTX A6000 48 GB en 16 bits (réussi) et RTX 4090 24 GB en 8 bits (réussi).
- Simulé en plafonnant la mémoire de la carte de 48 GB : un plafond de 24 GB en 8 bits a réussi (77,5 % et 65,0 %). Trois tentatives à 16 GB ont échoué : deux n'ont pas démarré, et la troisième a péniblement sorti un token toutes les cinq secondes environ.
- Pas essayé : les cartes de 32 GB et de 80 GB, et plusieurs autres modèles de 24 et 48 GB (liste en annexe).
La limite de 8 192 tokens sur la 4090 est la moitié de ce que nous avons utilisé sur la carte de 48 GB. Nous n'avons pas mesuré la vitesse sur des prompts plus longs que notre paire de variants, ni à proximité de la limite de 40 960 tokens du modèle.
Sur InferenceKey : une ligne de commande, prêt en six minutes sur une carte froide
Depuis un worker de 48 GB froid, sans vLLM ni poids dessus, Carbon-X servait sur vLLM standard, le logiciel de service ouvert, en 356 secondes, avec une seule ligne de commande. Un modèle de domaine ne devrait pas avoir besoin d'un moteur sur mesure, et celui-ci n'en a pas eu besoin. L'essentiel de l'attente a été l'installation de vLLM (138 secondes) et la mise en chauffe du moteur (136 secondes). Télécharger 30 GB de poids a pris 22 secondes, et les charger 30. La 4090 était prête en 262,5 secondes. Notre exemple du SDK déploie le modèle sur votre machine GPU, attend qu'il soit prêt, pose deux questions de la fiche du modèle et le supprime.
Deux réglages ont fait le travail : une version de vLLM fixée avec laquelle le tokenizer fonctionne à coup sûr, et le raisonnement pas à pas désactivé côté serveur, comme les auteurs l'ont entraîné.
Un problème se voit dans la sortie. Les réponses qui contiennent de l'ADN reviennent entourées des marqueurs littéraux <dna> et </dna>, et l'option de nettoyage de vLLM ne les retire pas. Statut : ouvert. Le README de l'exemple vous dit de retirer les balises dans votre parseur.
Faut-il l'utiliser ? Oui pour du tri sur votre propre carte, non pour ses explications
- Si vous devez trier de nombreux variants selon leur nocivité probable, lancez-le, mais ne prenez pas une réponse unique pour définitive. Le verdict sur la drépanocytose a basculé en bénin sans hasard. Sur la 4090, 120 questions envoyées 8 à la fois ont pris 45,9 secondes, avec une médiane de 3,3 secondes chacune. Nous n'avons pas mesuré les tokens par seconde sous charge.
- Si vous devez savoir pourquoi, ne le croyez pas sur parole. Les positions, les bases et les noms de gènes dans ses explications étaient faux trop souvent. Calculez les positions dans du code.
- Si vos séquences ne peuvent pas quitter le bâtiment, il est sous Apache-2.0, sans accès restreint, et tourne sur une seule carte de 24 GB que vous contrôlez.
- Si votre carte a 16 GB, passez votre chemin pour l'instant. Aucune configuration de vLLM que nous avons essayée n'a marché.
Pour poser à Carbon-X les deux questions d'ADN des auteurs sur votre propre carte NVIDIA, lancez python main.py depuis l'exemple du SDK Carbon-X. Il faut un projet InferenceKey avec un token SDK et une clé API. Il faut aussi une machine NVIDIA avec un driver CUDA 13 (580 ou plus récent) et 48 GB, ou 24 GB avec CARBON_FP8=1, plus un accès à Hugging Face au premier chargement. Il supprime le déploiement quand il a fini.
Pour les ingénieurs
Crédits
- Carbon-X : Loubna Ben Allal, Lewis Tunstall, Dana Aubakirova, Maurizio Fiusco, Edward Beeching, Kashif Rasul, Leandro von Werra, Qiuyi Li et Diego di Bernardo, une collaboration entre Hugging Face, la Zhongguancun Academy et le TIGEM / Université de Naples Federico II. Ils ont entraîné le modèle, écrit le tokenizer, publié les poids sous Apache-2.0 et diffusé leurs recettes d'entraînement et d'évaluation dans huggingface/carbon.
- Modèle de base : Qwen3-14B de l'équipe Qwen.
- Service : le projet vLLM.
- Données d'évaluation : le jeu de variants BioReason wanglab/variant_effect_coding du laboratoire Wang, et HuggingFaceBio/genomeqa.
- Où nous l'avons repéré : la vidéo AI NEWS d'AI Search du 2026-10-25 (segment Carbon-X de 07:37 à 09:27), et un post de r/LocalLLaMA du 2026-10-22.
- Notre part : le déploiement à travers la plateforme, le jeu d'évaluation public, les mesures, l'échelle de VRAM et l'exemple du SDK.
Modèle et fichiers
HuggingFaceBio/Carbon-X, shaa5f4e199957aa2ca3e0345eb28bd1254604db2b2, dépôt créé le 2026-10-21, dernière modification le 2026-10-28, Apache-2.0, sans accès restreint.Qwen3ForCausalLM, 14 822 046 720 paramètres en BF16. 40 couches, hidden 5120, FFN 17408, 40 têtes dont 8 têtes KV (GQA), head dim 128, SwiGLU, RMSNorm avec QK-norm, embeddings non liés, base RoPE 1e6,max_position_embeddings40 960.- Deux shards safetensors : 24 956 844 000 B + 4 687 301 152 B = 29,64 GB.
- Vocabulaire de 157 184 = 151 669 BPE + 5 515 tokens d'ADN (4 096 6-mers, 1 364 tokens de queue pour les longueurs qui ne sont pas un multiple de 6,
<dna>,</dna>,<oov>, complété jusqu'à un multiple de 128). - Balisage automatique : les suites de 6 A/C/G/T ou plus sont entourées de
<dna>...</dna>. Les suites de 12 ou plus avec jusqu'à 20 % de codes d'ambiguïté IUPAC sont balisées aussi. Les 6-mers non ACGT deviennent un seul<oov>.auto_dna_tags=Falsele désactive. tokenizer.py(classeHybridDNATokenizer, viaauto_map) n'importe que transformers et la bibliothèque standard. Au premier chargement, il récupère le BPE deQwen/Qwen3-4B-Baseà une révision fixée depuis le Hub, donc l'hôte de service a besoin d'un accès au Hub. Nous l'avons lu avant de l'exécuter.- La fiche : "Carbon-X requires Transformers v5 or later". La démo sur portable du blog de lancement est un GGUF 8 bits dans llama.cpp ; la fiche dit que les runtimes GGUF ne sont pas pris en charge (voir Problèmes). Post-entraîné et évalué avec
enable_thinking=False.generation_config.json: temperature 0.6, top_p 0.95, top_k 20, utilisés pour tous les résultats publiés. - Entraînement (auteurs) : extension du vocabulaire avec environ 10B tokens et le corps gelé, mid-training sur 302B tokens à une longueur de séquence de 8 192 (55 % d'ADN brut, 20 % d'anglais, 15 % de textes de biologie, 10 % d'instructions), SFT sur 3 epochs, deux tours de GRPO asynchrone avec le thinking désactivé.
Benchmarks des auteurs (non reproduits par nous)
Thinking désactivé, échantillonnage par défaut, un échantillon par problème. Instantané du classement du 2026-10-21T13:31:46Z.
| Benchmark | Carbon-X | GPT-6.1 Sol Max | Opus 5.5 Max | Gemini 4 Argon Low |
|---|---|---|---|---|
| BioReason Coding (1 018) | 74,9 | 71,0 | 70,3 | 6,5 |
| BioReason Non-SNV (873) | 85,1 | 91,7 | 94,8 | 90,3 |
| GenomeQA (2 600) | 63,6 | 67,2 | 62,2 | 63,1 |
| NextBase (600) | 39,4 | 32,9 | 1,1 | 31,2 |
| FrontierVEP (1 000) | 70,4 | 74,9 | 76,2 | 58,0 |
| Moyenne | 66,7 | 67,5 | 60,9 | 49,8 |
Autres moyennes du même tableau : GLM-5.3 39,8, Kimi K3 50,4, DeepSeek V4.1 Flash 47,1. GenomeQA par tâche : enhancer/promoter 70,0, splice 29,8, eukaryote 93,2, histone 34,6, TFBS 64,0, motif 90,0. IFEval 79,3 % prompt-strict. Comme sous-agent, Carbon-X a fait passer l'indice ADN de Kimi K3 de 49,4 % à 60,5 % (100 questions par benchmark). Les affirmations de coût utilisent les prix publics des API pour les modèles comparés et le débit mesuré de Carbon-X par heure de H200 à 5 USD. Les barres du graphique ClinVar indiquent 271, 32 380, 110 724, 658 632 et 4 027 185 USD. Nous avons associé les barres des modèles de pointe aux modèles d'après leur ordre dans le SVG, donc cette correspondance n'est pas confirmée.
Installation
- Manager InferenceKey local et nats-proxy compilés depuis
main, workers sur notre cloud, production jamais touchée. - Backend :
vllmintégré avecvllm_version="0.32.0"(2026-10-18). Il fixetransformers<5.20.0,>=5.16.1(5.19.0 installé) ettorch==2.13.0. Ce sont des wheels cu13, donc le worker a besoin d'un driver CUDA 13 (580 ou plus récent). La version par défaut du worker, vLLM 0.20.0, ne met pas de borne supérieure à transformers, d'où notre version fixée. - Exécution principale : RTX A6000 48 GB, driver 595.91.07, CUDA 13.2. Exécution de l'échelle : RTX 4090 24 GB, même driver.
# 48 GB card, BF16 (main run)
vllm serve HuggingFaceBio/Carbon-X --trust-remote-code --dtype bfloat16 \
  --max-model-len 16384 \
  --default-chat-template-kwargs '{"enable_thinking": false}'

# 24 GB card, FP8 at load (what CARBON_FP8=1 sends)
vllm serve HuggingFaceBio/Carbon-X --trust-remote-code --dtype bfloat16 \
  --max-model-len 8192 --quantization fp8 \
  --default-chat-template-kwargs '{"enable_thinking": false}'
Si vous appelez vLLM directement et préférez un contrôle par requête, la forme de la fiche est extra_body={"chat_template_kwargs": {"enable_thinking": False}}. Nous n'avons pas testé la qualité avec le thinking activé.
Pas à pas avec l'exemple du SDK
L'exemple se trouve dans examples/carbon-x-dna-chat-vllm-private-nvidia (commit 4ccd5764 sur main). Le SDK Python n'est pas encore sur PyPI, il se compile donc localement avec maturin.
git clone https://github.com/inferencekey/inferencekey-sdk.git
cd inferencekey-sdk/examples/carbon-x-dna-chat-vllm-private-nvidia
cp .env.example .env        # INFERENCEKEY_SDK_TOKEN (ik_sdk_), INFERENCEKEY_API_KEY (ik_live_),
                            # INFERENCEKEY_PROJECT, IK_WORKER_ID, optional INFERENCEKEY_BASE_URL
python -m venv .venv && . .venv/bin/activate
pip install maturin
( cd ../../bindings/python && maturin develop --release )
set -a; . ./.env; set +a
python main.py                  # 48 GB card, BF16
CARBON_FP8=1 python main.py     # 24 GB card, FP8
Ce que fait main.py :
ensure()d'un workloadvllmfixe (task_type="text2text", une réplique) épinglé àIK_WORKER_ID, avec la commande ci-dessus.wait_until_ready(timeout=2400). Un worker froid installe d'abord vLLM et télécharge 29,6 GB.- Pose les deux questions de la fiche du modèle (le variant HBB de la drépanocytose, et "What does this sequence encode?") avec
max_tokens=1024, affiche les réponses, les secondes et les tokens, et enregistreoutputs/answers.md. delete()du workload, sauf siIK_KEEP_ALIVE=1.
Le worker a besoin d'environ 40 GB d'espace disque libre et d'un accès au Hub pour le tokenizer.
Délai de disponibilité
| Étape | RTX A6000, BF16, à froid | RTX 4090, FP8, à froid |
|---|---|---|
pip install vllm==0.32.0 | 138 s | 106 s |
| Téléchargement de 29,6 GB | 22,0 s | 20,3 s |
| Chargement des poids | 29,5 s (27,62 GiB) | 27,9 s (15,97 GiB) |
| Init du moteur (profilage, cache KV, échauffement) | 135,6 s (compilation 34,1 s) | 89,2 s (compilation 29,5 s) |
SDK ready after | 356,0 s | 262,5 s |
Sur une A6000 chaude (même venv et mêmes poids, vllm serve direct), le plafond de 24 GB en FP8 était prêt en 95 s.
Vitesse, une requête (température 0, streaming)
| Carte / config | Réponse de 300 mots | Paire de variants 4 kbp + 4 kbp (1 445 tokens de prompt) |
|---|---|---|
| RTX A6000, BF16 | 19,5 tok/s, TTFT 0,17 à 0,18 s | 135 tokens en 7,1 à 7,5 s |
| RTX A6000, FP8, plafond de 24 GB | 38,4 à 38,5 tok/s, TTFT 0,26 à 0,31 s | 118 à 151 tokens en 4,0 à 4,3 s |
| RTX 4090, FP8 | 50,5 à 50,6 tok/s, TTFT 0,14 à 0,15 s | 116 à 117 tokens en 2,4 à 2,6 s |
| RTX A6000, BF16 + offload CPU de 16 GB, eager | 40 tokens en 189,1 s (0,21 tok/s) | non lancé |
Notre question sur une paire de variants (8 192 bases d'ADN) a utilisé 1 445 tokens de prompt. La concurrence n'a pas été mesurée en tokens par seconde. Les exécutions de l'évaluation à 8 requêtes simultanées ont eu une latence médiane de 7,56 s sur l'A6000 et de 3,30 s sur la 4090. La vitesse près du contexte de 40 960 tokens n'est pas mesurée.
Mémoire GPU
- A6000 BF16 : poids 27,62 GiB, cache KV 10,96 GiB (71 824 tokens avec un contexte de 16 384), vLLM préalloue 0,92 de la carte,
nvidia-smi40 639 MiB. - A6000 FP8 avec un plafond de 24 GB : 22 477 MiB (poids 15,81 GiB, KV 4,95 GiB = 32 432 tokens).
- RTX 4090 FP8 : poids 15,97 GiB, KV 3,18 GiB (20 800 tokens), pic de 21 418 MiB sur 24 564.
- Calcul du KV : 40 couches x 8 têtes KV x 128 x 2 (K et V) x 2 B = 160 KiB par token, donc un contexte de 16K fait 2,5 GiB.
Échelle de VRAM
| GPU ou plafond | Config | Pic de VRAM | Temps par sortie | Sortie OK | Réel ou émulé |
|---|---|---|---|---|---|
| RTX A6000 48 GB | BF16, --max-model-len 16384, préallocation 0,92 | 40,6 GB | 7,3 s par paire de variants | oui (77,5 % / 65,0 %) | réel |
| Plafond de 24 GB sur l'A6000 | --quantization fp8 --gpu-memory-utilization 0.52 --max-model-len 8192 | 22,5 GB | 4,1 s | oui (77,5 % / 65,0 %, drépanocytose 16/20) | émulé |
| RTX 4090 24 GB | CARBON_FP8=1 via ensure() du SDK | 21,4 GB | 2,5 s | oui (75,0 % / 66,7 %, drépanocytose 16/20) | réel |
| Plafond de 16 GB sur l'A6000 | --quantization bitsandbytes, 0,34 | non : Unknown quantization method: bitsandbytes (retiré dans vLLM 0.32) | émulé | ||
| Plafond de 16 GB sur l'A6000 | FP8 + --cpu-offload-gb 6, 0,34 | non : NotImplementedError: Cannot copy out of meta tensor; no data! | émulé | ||
| Plafond de 16 GB sur l'A6000 | BF16 + --cpu-offload-gb 16 --enforce-eager, 0,34 | 15,5 GB | 189,1 s pour 40 tokens | non : 0,21 tok/s ; avec les CUDA graphs, plus de 10 min de capture de graphes | émulé |
Pas essayé : int8 weight-only, torchao int4, GGUF de la communauté, RTX 3090, L4, L40S, RTX 6000 Ada, cartes de 32 GB en BF16 (pas de place utile pour le KV d'après le calcul), cartes de 80 GB, A40 (la machine a échoué sur SSH, pas sur le modèle). La docstring et le README de l'exemple indiquent que certaines de ces cartes suffisent ; seules l'A6000 et la 4090 ont tourné.
Exécutions de l'évaluation
120 éléments, 8 simultanés, à travers le /v1/chat/completions du manager. 109 236 tokens de prompt par exécution. 0 erreur HTTP, toutes les réponses analysables, aucun crash, NaN ni réponse vide sur environ 600 requêtes.
| Exécution | Durée | ClinVar (40) | Rappel bénin / pathogène | GenomeQA (60) | 24 bases suivantes, par base |
|---|---|---|---|---|---|
| A6000 BF16, échantillonnage par défaut | 101,2 s | 77,5 % | 60 / 95 % | 65,0 % | 29,2 % |
| A6000 BF16, température 0 | 118,9 s | 80,0 % | 65 / 95 % | 65,0 % | 27,9 % |
| A6000 FP8, plafond de 24 GB, température 0 | 80,1 s | 77,5 % | 55 / 100 % | 65,0 % | 30,6 % |
| RTX 4090 FP8, température 0 | 45,9 s | 75,0 % | 55 / 95 % | 66,7 % | 29,6 % |
- Données : test v1 de
wanglab/variant_effect_coding(1 233 lignes, 1 018 paires uniques, 20 + 20 tirées au sort, séquence seule, notre question fixe se terminant par<answer>benign|pathogenic</answer>).HuggingFaceBio/genomeqamcq_carbon_600, 10 par sous-tâche, modèlemultiple_choice(cot=True)d'Inspect. 20 ARNm humains de RefSeq avec 300 bases de contexte à un décalage aléatoire. LeHuggingFaceBio/DNAIntelligenceIndexdes auteurs a renvoyé HTTP 401. - GenomeQA par sous-tâche, BF16 par défaut (10 chacune) : enhancer/promoter 60, splice 30, histone 30, TFBS 70, motif 100, eukaryote 100. Greedy : splice 20, histone 40.
- Concordance avec les réponses greedy en BF16 : échantillonnage par défaut 39/40 et 57/60, plafond FP8 37/40 et 56/60, 4090 36/40 et 57/60.
- Un intervalle à 95 % sur 77,5 % de 40 fait environ plus ou moins 13 points.
Détails de qualité
- Exemple de la drépanocytose (55 premières bases de HBB, GAG devient GTG à la base 20, Glu6Val, gène non fourni), 20 échantillons avec l'échantillonnage par défaut : 16 pathogène / 4 bénin sur l'A6000 BF16, le plafond FP8 et la 4090. Température 0 en BF16 : "Answer: Benign". BF16 cite "position 21" dans 12 sur 20, les exécutions FP8 citent 20 dans 16 et 18 sur 20. "GAG" / "GTG" apparaissent dans 6 à 9 sur 20. Aucun échantillon ne mentionne le glutamate, la valine ou la drépanocytose.
- "What does this sequence encode?" (36 bases de HBB) : MVHLTPEEKSAV juste sur les deux cartes. L'A6000 a ajouté "has a stop codon at the end" (faux). Aucune n'a nommé la bêta-globine. Avec 93 bases à température 0 : traduction juste, puis "PKM2 (pyruvate kinase M2)".
- Paire réelle
Task1_test_581(DNAAF11, pathogène selon ClinVar,CATGGCdevientCACGGC) : étiquetée pathogène à chaque fois, justifications "a C>A transversion, changing ATG to AAG" et "The variant changes C to C, so ATG becomes ACG". - Les réponses de bases suivantes faisaient toujours exactement 24 bases dans des balises
<dna>, plusieurs de faible complexité (AAAAAAAAAAAAAAAAAAAAAAAA). Notées avec l'extracteur des auteurs (seqrecqa.py).
Problèmes
- Balises
<dna>dans la sortie. Les réponses avec de l'ADN reviennent entourées de<dna>...</dna>littéraux, etskip_special_tokensne les retire pas. Statut : ouvert. Documenté dans le README de l'exemple ; parsez autour. - Explications peu fiables. Une limite du modèle que documentent les auteurs. Statut : ouvert, pas de correctif de notre côté au-delà d'échantillonner plusieurs fois et de calculer les positions dans du code.
- Pas de voie à 16 GB dans vLLM 0.32. Voir l'échelle. Statut : ouvert ; int8 weight-only, torchao int4 et GGUF pas essayés.
ensure()crée l'affectation avecmax_in_flightà 1. Connu depuis le 2026-10-15. Nous l'avons monté à 8 pour chaque exécution avecPATCH /api/projects/<pid>/assignments/<workload>/<worker>. Statut : ouvert sur la plateforme.- Machine A40 sans SSH. Elle a tourné 180 s sans exposer de SSH direct, et le manager l'a arrêtée au bout de 3,1 minutes. Nous sommes passés à la RTX A6000 (même famille de puces, mêmes 48 GB). Statut : géré par la vérification du manager.
- Les flux de la passerelle ne transportent pas
usage. Les comptes de tokens viennent des fragments du flux. Statut : ouvert. - Avertissement "Using a slow tokenizer" du tokenizer ADN en Python. Pas d'effet visible sur le débit.
- La fiche et le blog se contredisent sur GGUF. La fiche dit que llama.cpp et les runtimes GGUF ne sont pas pris en charge. La démo de 16 s du blog de lancement lance
llama-cli -m models/Carbon-X/carbon-x-q8_0.ggufsur un Apple M5 Max à 34,1 t/s à l'écran, et son propre peptide abrégé "MVHLP ... (MVHLPEEKSV)" est faux. Le README de notre exemple reprend la fiche. Nous n'avons pas vérifié s'il existe un dépôt GGUF public. - Nos erreurs, sans effet sur les résultats. Une regex de la boucle d'attente a raté la ligne d'amorçage de la 4090, qui est donc restée inactive environ 6 minutes. Un
IK_WORKER_IDvide a fait échouer le premierensure()de la 4090 avec un 422. Notre première regex de bases suivantes ne s'attendait pas aux balises et a noté 0 %.
Vidéo de démo
La vidéo narrée de 154,5 s couvre le modèle, les exemples et le tableau de benchmarks des auteurs, notre test et l'échelle de GPU.
Sources
- Fiche du modèle : huggingface.co/HuggingFaceBio/Carbon-X
- Blog de lancement : HuggingFaceBio/Carbon-X-Release (lu depuis le
index.htmlbrut du Space et les fichiers des figures) - Code et recettes : github.com/huggingface/carbon
- Où nous l'avons repéré : AI Search, AI NEWS, 2026-10-25
- Exemple du SDK : carbon-x-dna-chat-vllm-private-nvidia