Carbon-X lee ADN en una tarjeta de 24 GB: acierta 3 de cada 4 etiquetas, no los porqués
Modelo de ADN de Hugging Face con vLLM de serie en una RTX 4090 de 24 GB y FP8: 75 % en 40 variantes de ClinVar, 50 tokens/s, explicaciones a menudo erróneas.
Carbon-X leyó 55 letras de un gen humano con el único cambio que causa la anemia falciforme, y lo marcó como patógeno. En una de nuestras dos tarjetas, después justificó la respuesta señalando la letra equivocada.
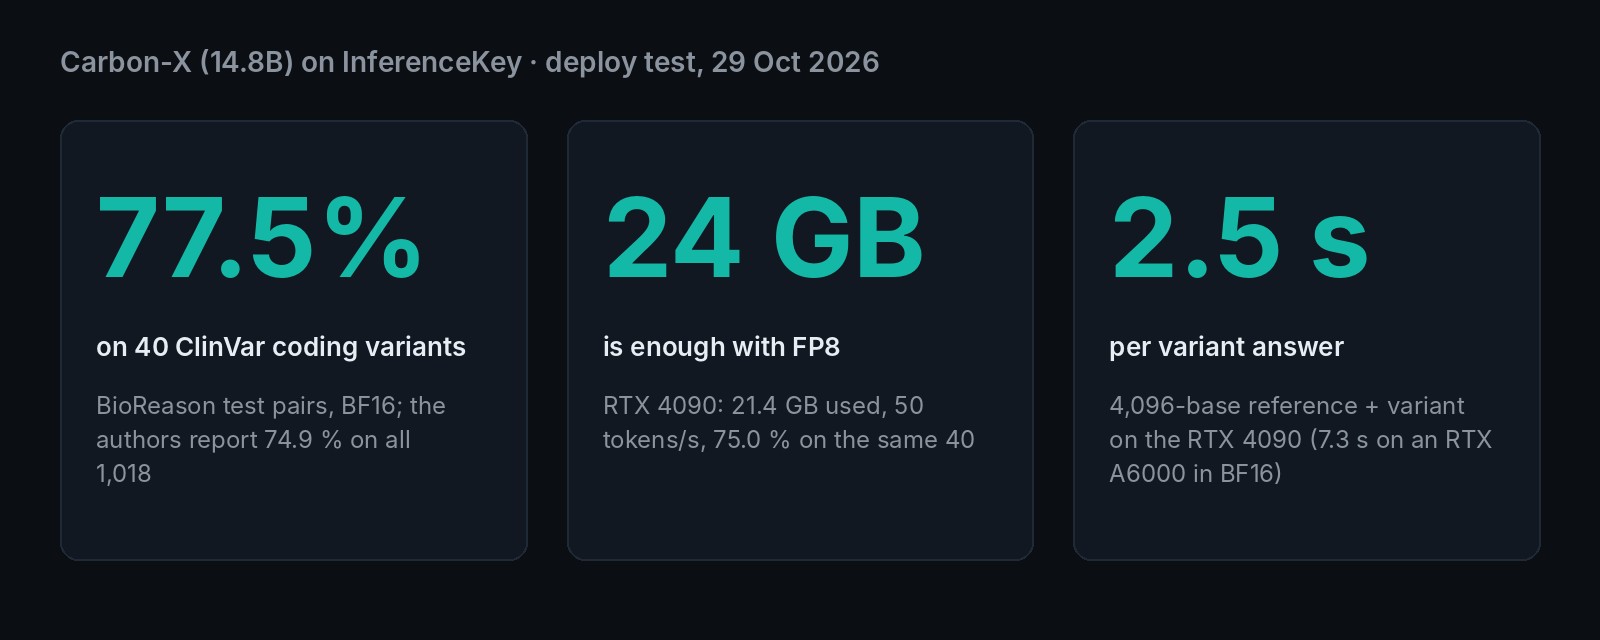
Carbon-X es el nuevo modelo abierto de Hugging Face que lee ADN en bruto dentro de un chat normal y responde en inglés. Lo servimos con software abierto sin modificar en una RTX 4090, una tarjeta gaming de 24 GB, en nuestra nube. En esa tarjeta clasificó bien, como dañinos o inofensivos, el 75 % de 40 cambios de ADN conocidos de ClinVar, una base de datos pública de genes (los autores: 74,9 %). Respondió sobre un par de secuencias de 4.096 letras en unos 2,5 segundos. Si tienes tus propias GPU, es un especialista en ADN que deja las secuencias inéditas en tu máquina y funciona con software abierto de serie y un solo comando. Usa sus etiquetas de dañino o inofensivo como primer filtro. No te fíes de sus explicaciones.
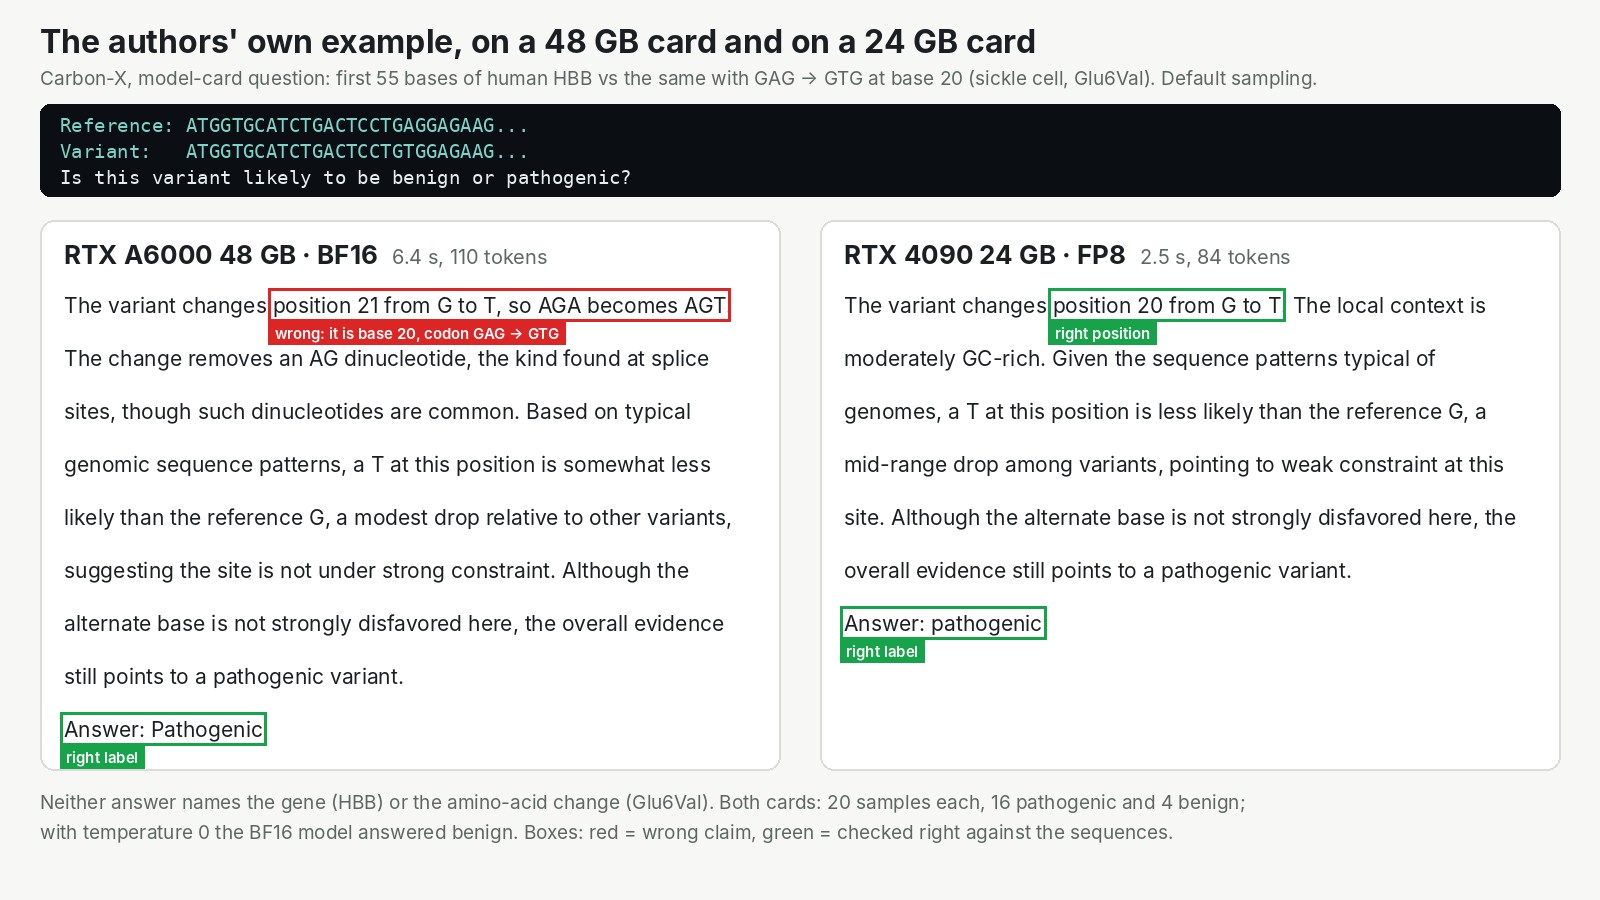
La imagen muestra una sola ejecución en cada tarjeta. Las dos acertaron la etiqueta y ninguna nombró el gen ni el cambio en la proteína. En 20 intentos por tarjeta, la respuesta fue patógeno 16 veces y benigno 4. La tarjeta de 48 GB dijo la base equivocada en 12 de 20 intentos. Las ejecuciones con los pesos reducidos acertaron en 16 y 18 de 20. Cuando quitamos la aleatoriedad que el modelo trae de serie, la tarjeta de 48 GB dijo benigno.
Un modelo de chat que lee el ADN de seis en seis letras
Carbon-X no es un tipo de modelo nuevo, y por eso fue fácil de servir. Por dentro es Qwen3-14B, el modelo de chat abierto de 14,8B parámetros del equipo de Qwen, reentrenado con ADN y textos de biología. Hugging Face añadió una sola cosa a la entrada: una forma nueva de trocear el ADN antes de que el modelo lo lea.
Los modelos de lenguaje leen el texto en tokens, trozos de unas pocas letras. El troceado habitual de Qwen parte el ADN en fragmentos raros, así que las secuencias largas gastan muchos tokens. Carbon-X añade 5.515 tokens de ADN a los que Qwen ya conoce. La mayoría (4.096) son bloques de seis letras de A, C, G y T, de modo que un token cubre seis bases. Imagina a un guitarrista que lee una escala de seis notas como una sola forma y no como seis notas sueltas.
Seis letras por token es lo que permite meter ADN largo. En nuestra prueba, dos secuencias de 4.096 letras más la pregunta sumaron 1.445 tokens. La propia figura de los autores muestra una pregunta corta con una secuencia de 27 letras que ocupa 20 tokens con el tokenizador de Qwen3 y 13 con el de Carbon-X.
No tienes que marcar el ADN tú. Cualquier tramo de seis o más letras A, C, G y T en tu mensaje se marca como ADN de forma automática. Pega una secuencia dentro de una frase y pregunta: si esta variante es dañina, qué hace esta región, qué bases vienen después.
La pega para servirlo es que ese troceado es código Python a medida que viene con el modelo. Tienes que dejar que el software de servicio ejecute Python del repositorio del modelo en tu propia máquina. Nosotros leímos antes ese fichero: solo usa librerías de Python estándar y muy extendidas. En la primera carga también descarga de Hugging Face el vocabulario base de Qwen, así que en ese momento la máquina necesita acceso a internet. El resto es un modelo de 14B de serie.
Hugging Face dice 66,7 %, cerca de GPT-6.1 Sol por una fracción del coste
El titular de los autores, en su blog de lanzamiento y en la ficha del modelo, es una media del 66,7 % en cinco benchmarks de ADN. GPT-6.1 Sol saca un 67,5 % en la misma tabla y Opus 5.5 un 60,9 %. Hugging Face calculó el precio de su modelo a 5 dólares por hora de GPU, y el de los demás a precio de API de lista: por cada 1.800 dólares gastados en Sol, Carbon-X gasta más o menos uno. El subtítulo del blog dice 1.000x.
La afirmación más concreta va sobre ClinVar, la base de datos pública donde los laboratorios registran variantes genéticas y lo que creen que hace cada una. Unos 2,4 millones de sus variantes siguen siendo de significado incierto. Los autores calculan que puntuarlas todas una vez con Carbon-X costaría unos 300 dólares (su gráfico marca 271), frente a entre 32.000 dólares y 4 millones con modelos punteros. No reprodujimos ni esa estimación ni el 66,7 %: sus datos de evaluación no son públicos, así que montamos nuestro propio conjunto con fuentes públicas.
Vimos Carbon-X en el resumen AI NEWS de AI Search del 25 de octubre. Ese vídeo dice que Carbon-X supera a GPT-6.1 de media. La propia tabla de los autores lo deja 0,8 puntos por detrás de Sol. La ficha del modelo dice que llama.cpp y los entornos GGUF no están soportados, pero la demo del blog de los propios autores ejecuta un GGUF de 8 bits en un MacBook a 34 tokens por segundo. No probamos la vía del portátil.
Nuestra prueba: dos tarjetas reales, 120 preguntas públicas, los ajustes de los autores
Servimos Carbon-X en dos tarjetas de nuestra nube. Un modelo son sobre todo sus pesos, los 14,8B números que aprendió. La ejecución principal usó una RTX A6000 de 48 GB y guardó cada peso en 16 bits, el formato nativo del modelo. La segunda usó una RTX 4090 de 24 GB y redujo cada peso a 8 bits al cargarlo, lo que casi divide por dos su memoria. Las dos pasaron por nuestra plataforma, igual que la llamaría una aplicación.
El conjunto de preguntas tenía 120 elementos, todos de datos públicos. Cuarenta eran variantes reales de ClinVar en genes que codifican proteínas, 20 inofensivas y 20 dañinas, del mismo conjunto de test que usan los autores. El modelo solo veía la secuencia de referencia, la modificada y nuestra pregunta, nunca el nombre del gen. Sesenta eran preguntas tipo test de GenomeQA sobre qué hace una región de ADN, diez por tarea. Veinte pedían las 24 bases siguientes de un gen humano.
Usamos los ajustes de los autores: sin razonamiento paso a paso antes de responder, y un poco de aleatoriedad en cada respuesta. También lo ejecutamos con la aleatoriedad desactivada.
Un límite por delante: 40 y 60 preguntas son muestras pequeñas. Con 40 variantes, un 77,5 % podría estar en realidad entre un 64 % y un 90 %. Lee nuestras cifras como "coincide con los autores o no", no como un ranking.
Resultados: en variantes reales de ClinVar, las etiquetas coinciden con los autores
Carbon-X etiquetó bien el 77,5 % de nuestras 40 variantes de ClinVar en la tarjeta de 48 GB con los ajustes de los autores. Los autores dan un 74,9 % sobre las 1.018 variantes de ese test. En GenomeQA sacó un 65,0 %, frente al 63,6 % de los autores.
| Variantes de ClinVar (40) | GenomeQA (60) | Velocidad, una petición | |
|---|---|---|---|
| RTX A6000 48 GB, 16 bits, ajustes de los autores | 77,5 % | 65,0 % | |
| RTX A6000 48 GB, 16 bits, sin aleatoriedad | 80,0 % | 65,0 % | 19,5 tokens/s |
| RTX 4090 24 GB, 8 bits, sin aleatoriedad | 75,0 % | 66,7 % | 50,5 tokens/s |
| Autores (conjuntos completos) | 74,9 % | 63,6 % |
En igualdad de condiciones, sin aleatoriedad, la 4090 sacó un 75,0 % frente a un 80,0 %: dos variantes de 40, dentro del ruido. Sus respuestas coincidieron con las de la tarjeta de 48 GB en 36 de 40 variantes y 57 de 60 preguntas. Desactivar la aleatoriedad cambió una respuesta de 40. Lo que limita estas cifras es lo pequeña que es la muestra.
Los errores tiran hacia un lado. En la tarjeta de 48 GB el modelo detectó 19 de las 20 variantes dañinas, pero solo 12 de las 20 inofensivas. O sea, marcó 8 de 20 variantes inofensivas. En una lista real y larga, eso son muchos casos inofensivos que tiene que revisar una persona.
En la 4090, una pregunta de variante completa sobre dos secuencias de 4.096 letras vuelve en 2,4 a 2,6 segundos, frente a 7,1 a 7,5 en la tarjeta de 48 GB en 16 bits. Casi toda la ganancia viene de los pesos de 8 bits: con ellos, hasta la tarjeta de 48 GB respondió la misma pregunta en unos 4 segundos.
Dónde falla: la etiqueta aguanta, el razonamiento no
Los veredictos sirven, pero las explicaciones que los acompañan suelen estar mal, incluso cuando el veredicto es correcto. Eso importa porque una respuesta de chat en un inglés fluido invita a fiarse del razonamiento.
En una variante real de ClinVar en la que una T pasó a C, dio la etiqueta correcta con la justificación "The variant changes C to C". Con 93 bases del gen de la beta-globina, las tradujo bien a proteína y luego dijo que el gen era PKM2, otro gen distinto. Los autores avisan justo de esto: el modelo "can miscount bases, confuse coordinates" y puede inventarse la identidad de una secuencia.
Algunas tareas también flojean. En dos de las seis tareas de GenomeQA acertó 3 de 10 en cada una, más o menos tan flojo como dicen los autores (29,8 % y 34,6 %). Al pedirle las 24 bases siguientes de un gen humano, acertó cerca del 29 % de las bases, cuando adivinar al azar da un 25 %. Ese conjunto es nuestro, no el benchmark NextBase de los autores (39,4 %), así que no se pueden comparar directamente.
No es una herramienta clínica, y los autores lo dicen.
Qué GPU: una RTX 4090 de 24 GB con pesos de 8 bits, no la tarjeta de 80 GB de la página del modelo
La tarjeta más pequeña que funcionó fue una RTX 4090 de 24 GB real, con los pesos reducidos a 8 bits y sitio para 8.192 tokens por conversación. Llegó a un pico de 21,4 GB y respondió más rápido que la tarjeta de 48 GB (ver Resultados).
Con precisión completa de 16 bits necesitas una tarjeta de 48 GB. Nuestra RTX A6000 mostró 40,6 GB en uso, y casi todo lo que pasa de los pesos es espacio reservado para el texto de las conversaciones en curso. Los 80 GB de la ficha del modelo, para un fichero de 29,6 GB, son generosos.
Esto es lo que funcionó en hardware real y lo que no:
- Tarjetas reales: RTX A6000 48 GB en 16 bits (superada) y RTX 4090 24 GB en 8 bits (superada).
- Simuladas limitando la memoria en la tarjeta de 48 GB: un límite de 24 GB en 8 bits pasó (77,5 % y 65,0 %). Tres intentos con 16 GB fallaron: dos no arrancaron y uno sacó más o menos un token cada cinco segundos.
- Sin probar: tarjetas de 32 GB y de 80 GB, y varios modelos más de 24 y 48 GB (lista en el apéndice).
El límite de 8.192 tokens en la 4090 es la mitad del que usamos en la tarjeta de 48 GB. No medimos la velocidad con prompts más largos que nuestro par de variantes, ni cerca del límite de 40.960 tokens del modelo.
En InferenceKey: una línea de comando, listo en seis minutos en una tarjeta en frío
Desde un worker de 48 GB en frío, sin vLLM ni pesos, Carbon-X estaba sirviendo en vLLM de serie, el software de servicio abierto, en 356 segundos, con una sola línea de comando. Un modelo de dominio no debería necesitar un motor a medida, y este no lo necesitó. Casi toda la espera fue instalar vLLM (138 segundos) y el calentamiento del motor (136 segundos). Descargar 30 GB de pesos llevó 22 segundos, y cargarlos 30. La 4090 estuvo lista en 262,5 segundos. Nuestro ejemplo del SDK despliega el modelo en tu máquina con GPU, espera a que esté listo, le hace dos preguntas de la ficha del modelo y lo elimina.
Dos ajustes hicieron el trabajo: una versión fija de vLLM con la que se sabe que el tokenizador funciona, y el razonamiento paso a paso desactivado en el servidor, tal como lo entrenaron los autores.
Hay un problema que se ve en la salida. Las respuestas que contienen ADN vuelven envueltas en las marcas literales <dna> y </dna>, y la opción de limpieza de vLLM no las quita. Estado: abierto. El README del ejemplo te dice que quites las etiquetas en tu parser.
¿Deberías usarlo? Sí para filtrar en tu propia tarjeta, no por sus explicaciones
- Si necesitas ordenar muchas variantes por su probable daño, úsalo, pero no tomes una sola respuesta como definitiva. El veredicto de la anemia falciforme pasó a benigno sin aleatoriedad. En la 4090, 120 preguntas enviadas de 8 en 8 tardaron 45,9 segundos, una mediana de 3,3 segundos cada una. No medimos tokens por segundo con carga.
- Si necesitas saber por qué, no te fíes de lo que dice. Las posiciones, bases y nombres de genes de sus explicaciones fallaron demasiadas veces. Calcula las posiciones con código.
- Si tus secuencias no pueden salir del edificio, es Apache-2.0, sin acceso restringido, y funciona en una tarjeta de 24 GB que controlas tú.
- Si tu tarjeta tiene 16 GB, olvídate de momento. Ninguna configuración de vLLM que probamos funcionó.
Para hacerle a Carbon-X las dos preguntas de ADN de los autores en tu propia tarjeta NVIDIA, ejecuta python main.py desde el ejemplo del SDK de Carbon-X. Necesita un proyecto de InferenceKey con un token del SDK y una API key. También necesita una máquina NVIDIA con un driver de CUDA 13 (580 o posterior) y 48 GB, o 24 GB con CARBON_FP8=1, además de acceso a Hugging Face en la primera carga. Al terminar, borra el despliegue.
Para ingenieros
Créditos
- Carbon-X: Loubna Ben Allal, Lewis Tunstall, Dana Aubakirova, Maurizio Fiusco, Edward Beeching, Kashif Rasul, Leandro von Werra, Qiuyi Li y Diego di Bernardo, una colaboración entre Hugging Face, la Zhongguancun Academy y TIGEM / Universidad de Nápoles Federico II. Entrenaron el modelo, escribieron el tokenizador, publicaron los pesos bajo Apache-2.0 y liberaron sus recetas de entrenamiento y evaluación en huggingface/carbon.
- Modelo base: Qwen3-14B, del equipo de Qwen.
- Servicio: el proyecto vLLM.
- Datos de evaluación: el conjunto de variantes de BioReason wanglab/variant_effect_coding, del laboratorio Wang, y HuggingFaceBio/genomeqa.
- Dónde lo vimos: el vídeo AI NEWS del 2026-10-25 de AI Search (segmento de Carbon-X de 07:37 a 09:27), y un post de r/LocalLLaMA del 2026-10-22.
- Nuestra parte: el despliegue a través de la plataforma, el conjunto de evaluación público, las mediciones, la escalera de VRAM y el ejemplo del SDK.
Modelo y ficheros
HuggingFaceBio/Carbon-X, shaa5f4e199957aa2ca3e0345eb28bd1254604db2b2, repo creado el 2026-10-21, última modificación el 2026-10-28, Apache-2.0, sin acceso restringido.Qwen3ForCausalLM, 14.822.046.720 parámetros en BF16. 40 capas, hidden 5120, FFN 17408, 40 cabezas con 8 cabezas KV (GQA), head dim 128, SwiGLU, RMSNorm con QK-norm, embeddings sin atar, base de RoPE 1e6,max_position_embeddings40.960.- Dos shards de safetensors: 24.956.844.000 B + 4.687.301.152 B = 29,64 GB.
- Vocabulario de 157.184 = 151.669 BPE + 5.515 tokens de ADN (4.096 6-meros, 1.364 tokens de cola para longitudes que no son múltiplo de 6,
<dna>,</dna>,<oov>, rellenado hasta un múltiplo de 128). - Etiquetado automático: los tramos de 6 o más A/C/G/T se envuelven en
<dna>...</dna>. También se etiquetan los tramos de 12 o más con hasta un 20 % de códigos de ambigüedad IUPAC. Los 6-meros que no son ACGT pasan a ser un<oov>.auto_dna_tags=Falselo desactiva. tokenizer.py(claseHybridDNATokenizer, víaauto_map) solo importa transformers y la librería estándar. En la primera carga baja del Hub el BPE deQwen/Qwen3-4B-Baseen una revisión fijada, así que el host que sirve necesita acceso al Hub. Lo leímos antes de ejecutarlo.- La ficha: "Carbon-X requires Transformers v5 or later". La demo en portátil del blog de lanzamiento es un GGUF de 8 bits en llama.cpp; la ficha dice que los entornos GGUF no están soportados (ver Problemas). Post-entrenado y evaluado con
enable_thinking=False.generation_config.json: temperatura 0,6, top_p 0,95, top_k 20, usados en todos los resultados publicados. - Entrenamiento (autores): ampliación del vocabulario con unos 10B tokens y el cuerpo congelado, mid-training con 302B tokens a una longitud de secuencia de 8.192 (55 % ADN en bruto, 20 % inglés, 15 % textos de biología, 10 % instrucciones), SFT durante 3 épocas, dos rondas de GRPO asíncrono con el razonamiento desactivado.
Benchmarks de los autores (no reproducidos por nosotros)
Razonamiento desactivado, muestreo por defecto, una muestra por problema. Captura del leaderboard del 2026-10-21T13:31:46Z.
| Benchmark | Carbon-X | GPT-6.1 Sol Max | Opus 5.5 Max | Gemini 4 Argon Low |
|---|---|---|---|---|
| BioReason Coding (1.018) | 74,9 | 71,0 | 70,3 | 6,5 |
| BioReason Non-SNV (873) | 85,1 | 91,7 | 94,8 | 90,3 |
| GenomeQA (2.600) | 63,6 | 67,2 | 62,2 | 63,1 |
| NextBase (600) | 39,4 | 32,9 | 1,1 | 31,2 |
| FrontierVEP (1.000) | 70,4 | 74,9 | 76,2 | 58,0 |
| Media | 66,7 | 67,5 | 60,9 | 49,8 |
Otras medias de la misma tabla: GLM-5.3 39,8, Kimi K3 50,4, DeepSeek V4.1 Flash 47,1. GenomeQA por tarea: enhancer/promoter 70,0, splice 29,8, eukaryote 93,2, histone 34,6, TFBS 64,0, motif 90,0. IFEval 79,3 % prompt-strict. Como subagente, Carbon-X subió el índice de ADN de Kimi K3 del 49,4 % al 60,5 % (100 preguntas por benchmark). Las cifras de coste usan precios de API de lista para los modelos comparados y el rendimiento medido de Carbon-X por hora de H200 a 5 dólares. Las barras del gráfico de ClinVar marcan 271, 32.380, 110.724, 658.632 y 4.027.185 dólares. Asignamos las barras de los modelos punteros a cada modelo por su orden en el SVG, así que esa correspondencia no está confirmada.
Nuestro montaje
- Manager local de InferenceKey y nats-proxy compilados desde
main, workers en nuestra nube, sin tocar producción en ningún momento. - Backend:
vllmintegrado convllm_version="0.32.0"(2026-10-18). Fijatransformers<5.20.0,>=5.16.1(instalada la 5.19.0) ytorch==2.13.0. Son wheels cu13, así que el worker necesita un driver de CUDA 13 (580 o posterior). La versión por defecto del worker, vLLM 0.20.0, no pone techo a transformers, y por eso la fijamos. - Ejecución principal: RTX A6000 48 GB, driver 595.91.07, CUDA 13.2. Ejecución de la escalera: RTX 4090 24 GB, mismo driver.
# 48 GB card, BF16 (main run)
vllm serve HuggingFaceBio/Carbon-X --trust-remote-code --dtype bfloat16 \
  --max-model-len 16384 \
  --default-chat-template-kwargs '{"enable_thinking": false}'

# 24 GB card, FP8 at load (what CARBON_FP8=1 sends)
vllm serve HuggingFaceBio/Carbon-X --trust-remote-code --dtype bfloat16 \
  --max-model-len 8192 --quantization fp8 \
  --default-chat-template-kwargs '{"enable_thinking": false}'
Si llamas a vLLM directamente y prefieres controlarlo por petición, la forma que da la ficha es extra_body={"chat_template_kwargs": {"enable_thinking": False}}. No probamos la calidad con el razonamiento activado.
Paso a paso con el ejemplo del SDK
El ejemplo está en examples/carbon-x-dna-chat-vllm-private-nvidia (commit 4ccd5764 en main). El SDK de Python todavía no está en PyPI, así que se compila en local con maturin.
git clone https://github.com/inferencekey/inferencekey-sdk.git
cd inferencekey-sdk/examples/carbon-x-dna-chat-vllm-private-nvidia
cp .env.example .env        # INFERENCEKEY_SDK_TOKEN (ik_sdk_), INFERENCEKEY_API_KEY (ik_live_),
                            # INFERENCEKEY_PROJECT, IK_WORKER_ID, optional INFERENCEKEY_BASE_URL
python -m venv .venv && . .venv/bin/activate
pip install maturin
( cd ../../bindings/python && maturin develop --release )
set -a; . ./.env; set +a
python main.py                  # 48 GB card, BF16
CARBON_FP8=1 python main.py     # 24 GB card, FP8
Lo que hace main.py:
ensure()de un workloadvllmfijo (task_type="text2text", una réplica) asignado aIK_WORKER_ID, con el comando de arriba.wait_until_ready(timeout=2400). Un worker en frío instala antes vLLM y descarga 29,6 GB.- Hace las dos preguntas de la ficha del modelo (la variante HBB de la anemia falciforme y "What does this sequence encode?") con
max_tokens=1024, imprime respuestas, segundos y tokens, y guardaoutputs/answers.md. delete()del workload, salvo conIK_KEEP_ALIVE=1.
El worker necesita unos 40 GB de disco libre y acceso al Hub para el tokenizador.
Tiempo hasta estar listo
| Paso | RTX A6000, BF16, en frío | RTX 4090, FP8, en frío |
|---|---|---|
pip install vllm==0.32.0 | 138 s | 106 s |
| Descarga de 29,6 GB | 22,0 s | 20,3 s |
| Carga de pesos | 29,5 s (27,62 GiB) | 27,9 s (15,97 GiB) |
| Inicio del motor (perfilado, caché KV, calentamiento) | 135,6 s (compilación 34,1 s) | 89,2 s (compilación 29,5 s) |
ready after del SDK | 356,0 s | 262,5 s |
En una A6000 en caliente (mismo venv y pesos, vllm serve directo), el límite de 24 GB con FP8 estuvo listo en 95 s.
Velocidad, una petición (temperatura 0, streaming)
| Tarjeta / configuración | Respuesta de 300 palabras | Par de variantes de 4 kbp + 4 kbp (1.445 tokens de prompt) |
|---|---|---|
| RTX A6000, BF16 | 19,5 tok/s, TTFT 0,17 a 0,18 s | 135 tokens en 7,1 a 7,5 s |
| RTX A6000, FP8, límite de 24 GB | 38,4 a 38,5 tok/s, TTFT 0,26 a 0,31 s | 118 a 151 tokens en 4,0 a 4,3 s |
| RTX 4090, FP8 | 50,5 a 50,6 tok/s, TTFT 0,14 a 0,15 s | 116 a 117 tokens en 2,4 a 2,6 s |
| RTX A6000, BF16 + 16 GB de CPU offload, eager | 40 tokens en 189,1 s (0,21 tok/s) | no ejecutado |
Nuestra pregunta del par de variantes (8.192 bases de ADN) usó 1.445 tokens de prompt. La concurrencia no se midió en tokens por segundo. Las evaluaciones con 8 peticiones concurrentes tuvieron una latencia mediana de 7,56 s en la A6000 y 3,30 s en la 4090. La velocidad cerca del contexto de 40.960 tokens está sin medir.
Memoria de GPU
- A6000 BF16: pesos 27,62 GiB, caché KV 10,96 GiB (71.824 tokens con contexto de 16.384), vLLM reserva de antemano 0,92 de la tarjeta,
nvidia-smi40.639 MiB. - A6000 FP8 con límite de 24 GB: 22.477 MiB (pesos 15,81 GiB, KV 4,95 GiB = 32.432 tokens).
- RTX 4090 FP8: pesos 15,97 GiB, KV 3,18 GiB (20.800 tokens), pico de 21.418 MiB de 24.564.
- Cuentas de la KV: 40 capas x 8 cabezas KV x 128 x 2 (K y V) x 2 B = 160 KiB por token, así que 16K de contexto son 2,5 GiB.
Escalera de VRAM
| GPU o límite | Configuración | VRAM pico | Tiempo por salida | Salida correcta | Real o emulada |
|---|---|---|---|---|---|
| RTX A6000 48 GB | BF16, --max-model-len 16384, reserva de 0,92 | 40,6 GB | 7,3 s por par de variantes | sí (77,5 % / 65,0 %) | real |
| Límite de 24 GB en la A6000 | --quantization fp8 --gpu-memory-utilization 0.52 --max-model-len 8192 | 22,5 GB | 4,1 s | sí (77,5 % / 65,0 %, falciforme 16/20) | emulada |
| RTX 4090 24 GB | CARBON_FP8=1 vía ensure() del SDK | 21,4 GB | 2,5 s | sí (75,0 % / 66,7 %, falciforme 16/20) | real |
| Límite de 16 GB en la A6000 | --quantization bitsandbytes, 0,34 | no: Unknown quantization method: bitsandbytes (eliminado en vLLM 0.32) | emulada | ||
| Límite de 16 GB en la A6000 | FP8 + --cpu-offload-gb 6, 0,34 | no: NotImplementedError: Cannot copy out of meta tensor; no data! | emulada | ||
| Límite de 16 GB en la A6000 | BF16 + --cpu-offload-gb 16 --enforce-eager, 0,34 | 15,5 GB | 189,1 s para 40 tokens | no: 0,21 tok/s; con CUDA graphs, más de 10 min de captura de grafos | emulada |
Sin probar: int8 solo en pesos, torchao int4, GGUF de la comunidad, RTX 3090, L4, L40S, RTX 6000 Ada, tarjetas de 32 GB en BF16 (sin espacio útil para la KV según las cuentas), tarjetas de 80 GB, A40 (la máquina falló por SSH, no por el modelo). El docstring y el README del ejemplo dan algunas de estas como válidas; solo se ejecutaron la A6000 y la 4090.
Evaluaciones
120 elementos, 8 concurrentes, a través del /v1/chat/completions del manager. 109.236 tokens de prompt por ejecución. 0 errores HTTP, todas las respuestas parseables, ningún cuelgue, NaN ni respuesta vacía en unas 600 peticiones.
| Ejecución | Tiempo total | ClinVar (40) | Recall benigno / patógeno | GenomeQA (60) | 24 bases siguientes, por base |
|---|---|---|---|---|---|
| A6000 BF16, muestreo por defecto | 101,2 s | 77,5 % | 60 / 95 % | 65,0 % | 29,2 % |
| A6000 BF16, temperatura 0 | 118,9 s | 80,0 % | 65 / 95 % | 65,0 % | 27,9 % |
| A6000 FP8, límite de 24 GB, temperatura 0 | 80,1 s | 77,5 % | 55 / 100 % | 65,0 % | 30,6 % |
| RTX 4090 FP8, temperatura 0 | 45,9 s | 75,0 % | 55 / 95 % | 66,7 % | 29,6 % |
- Datos: test v1 de
wanglab/variant_effect_coding(1.233 filas, 1.018 pares únicos, 20 + 20 muestreados, solo secuencia, nuestra pregunta fija terminada en<answer>benign|pathogenic</answer>).HuggingFaceBio/genomeqamcq_carbon_600, 10 por subtarea, plantillamultiple_choice(cot=True)de Inspect. 20 ARNm humanos de RefSeq con 300 bases de contexto en un desplazamiento aleatorio. ElHuggingFaceBio/DNAIntelligenceIndexde los autores devolvió HTTP 401. - GenomeQA por subtarea, BF16 por defecto (10 cada una): enhancer/promoter 60, splice 30, histone 30, TFBS 70, motif 100, eukaryote 100. Greedy: splice 20, histone 40.
- Coincidencia con las respuestas greedy de BF16: muestreo por defecto 39/40 y 57/60, límite FP8 37/40 y 56/60, 4090 36/40 y 57/60.
- Un intervalo del 95 % sobre un 77,5 % de 40 es de unos 13 puntos arriba o abajo.
Detalles de calidad
- Ejemplo de anemia falciforme (primeras 55 bases de HBB, GAG a GTG en la base 20, Glu6Val, sin dar el gen), 20 muestras con muestreo por defecto: 16 patógeno / 4 benigno en A6000 BF16, límite FP8 y 4090. Temperatura 0 en BF16: "Answer: Benign". BF16 dice "position 21" en 12 de 20, las ejecuciones FP8 dicen 20 en 16 y 18 de 20. "GAG" / "GTG" aparecen en 6 a 9 de 20. Ninguna muestra menciona glutamato, valina ni anemia falciforme.
- "What does this sequence encode?" (36 bases de HBB): MVHLTPEEKSAV correcto en las dos tarjetas. La A6000 añadió "has a stop codon at the end" (falso). Ninguna nombró la beta-globina. Con 93 bases a temperatura 0: traducción correcta, y luego "PKM2 (pyruvate kinase M2)".
- Par real
Task1_test_581(DNAAF11, patógeno en ClinVar,CATGGCaCACGGC): etiquetado patógeno siempre, con justificaciones "a C>A transversion, changing ATG to AAG" y "The variant changes C to C, so ATG becomes ACG". - Las respuestas de bases siguientes siempre fueron exactamente 24 bases dentro de etiquetas
<dna>, varias de baja complejidad (AAAAAAAAAAAAAAAAAAAAAAAA). Puntuadas con el extractor de los autores (seqrecqa.py).
Problemas
- Etiquetas
<dna>en la salida. Las respuestas con ADN vuelven envueltas en<dna>...</dna>literales, yskip_special_tokensno las quita. Estado: abierto. Documentado en el README del ejemplo; parsea saltándolas. - Explicaciones poco fiables. Una limitación del modelo que documentan los autores. Estado: abierto, sin arreglo por nuestra parte más allá de muestrear varias veces y calcular las posiciones con código.
- Sin vía de 16 GB en vLLM 0.32. Ver la escalera. Estado: abierto; int8 solo en pesos, torchao int4 y GGUF sin probar.
ensure()crea la asignación conmax_in_flight1. Conocido desde el 2026-10-15. Lo subimos a 8 en cada ejecución conPATCH /api/projects/<pid>/assignments/<workload>/<worker>. Estado: abierto en la plataforma.- Máquina A40 sin SSH. Estuvo 180 s sin exponer SSH directo, y el manager la terminó a los 3,1 minutos. Pasamos a la RTX A6000 (misma familia de chip, mismos 48 GB). Estado: lo resuelve la comprobación del manager.
- Los streams del gateway no traen
usage. Los recuentos de tokens salieron de los fragmentos del stream. Estado: abierto. - Aviso "Using a slow tokenizer" del tokenizador de ADN en Python. Sin efecto visible en el rendimiento.
- La ficha y el blog no coinciden sobre GGUF. La ficha dice que llama.cpp y los entornos GGUF no están soportados. La demo de 16 s del blog de lanzamiento ejecuta
llama-cli -m models/Carbon-X/carbon-x-q8_0.ggufen un Apple M5 Max a 34,1 t/s en pantalla, y su propio péptido abreviado "MVHLP ... (MVHLPEEKSV)" está mal. El README de nuestro ejemplo repite lo de la ficha. No comprobamos si existe un repo GGUF público. - Despistes nuestros, sin efecto en los resultados. Una regex del bucle de espera no detectó la línea de arranque de la 4090, así que estuvo parada unos 6 minutos. Un
IK_WORKER_IDvacío hizo que el primerensure()de la 4090 fallara con 422. Nuestra primera regex de bases siguientes no contaba con las etiquetas y puntuó un 0 %.
Vídeo de la demo
El vídeo narrado de 154,5 s cubre el modelo, los ejemplos y la tabla de benchmarks de los autores, nuestra prueba y la escalera de GPU.
Fuentes
- Ficha del modelo: huggingface.co/HuggingFaceBio/Carbon-X
- Blog de lanzamiento: HuggingFaceBio/Carbon-X-Release (leído desde el
index.htmlen bruto del Space y los ficheros de las figuras) - Código y recetas: github.com/huggingface/carbon
- Dónde lo vimos: AI Search, AI NEWS, 2026-10-25
- Ejemplo del SDK: carbon-x-dna-chat-vllm-private-nvidia