Sage-A1.5 en una tarjeta de 24 GB: 136 tokens/s y un modo de verificación que dobla el trabajo en preguntas fáciles
El agente de 35B de Shanghai AI Lab en una RTX 4090: 136 tokens/s, 3 de 3 aciertos en una pregunta de investigación y el doble de tiempo con verificación.
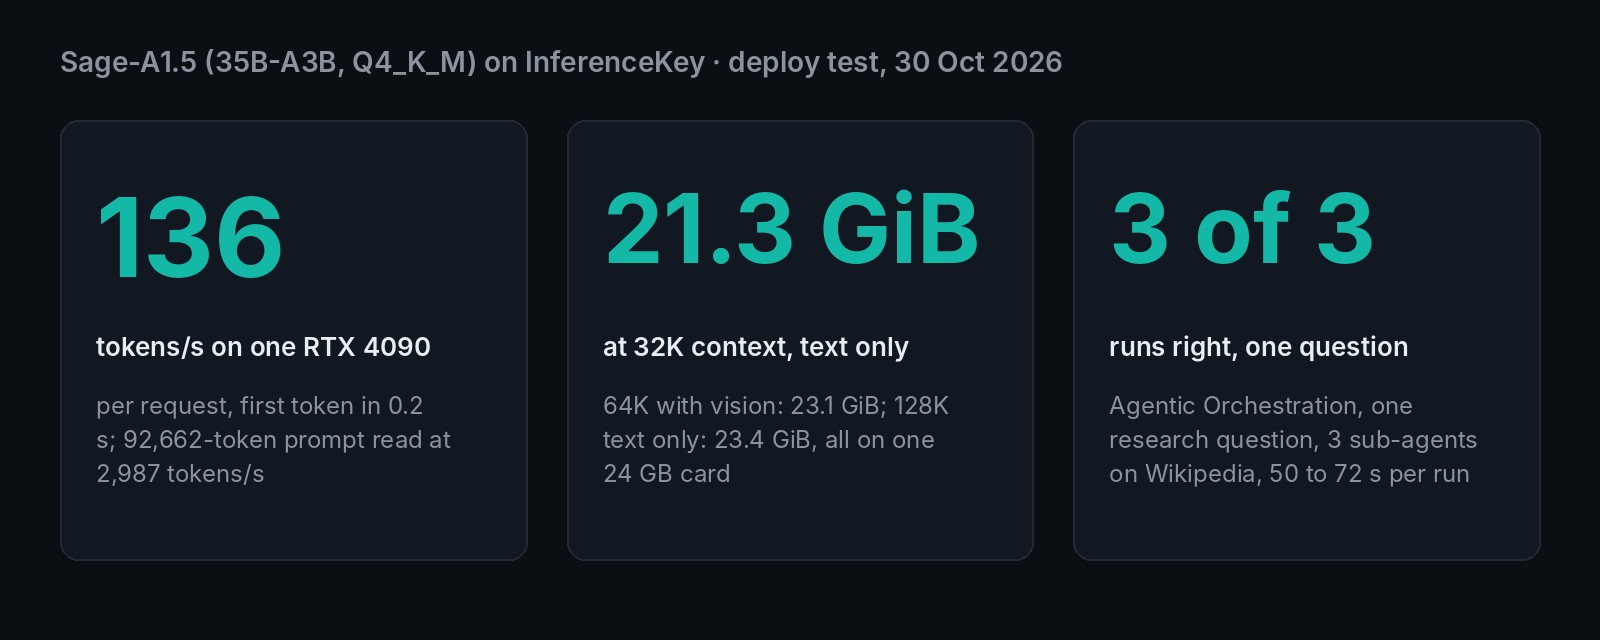
35B parámetros en disco, unos 3B trabajando en cada palabra. Esa diferencia es la razón por la que Sage-A1.5, un agente de investigación abierto del Shanghai AI Laboratory, entra en una sola tarjeta gaming. Ejecutamos el fichero comprimido de los propios autores en una RTX 4090, una tarjeta gaming de 24 GB, en nuestra nube (InferenceKey Cloud), con software abierto de serie. Su maquinaria de agente funcionó: repartió tareas, pidió a nuestro código que buscara y respondió. Escribió unos 136 tokens por segundo, una respuesta larga en 11 segundos, y acertó nuestra única pregunta de investigación en tres partes en las tres ejecuciones de prueba. Su nuevo Verification Mode, que le hace revisar su propio trabajo, dio las mismas respuestas correctas en preguntas fáciles, pero tardó 2,2 veces más y gastó el doble de tokens. El modelo corre en un worker de GPU que controlas tú, y las herramientas corren en tu propio código. Deja el modo de verificación apagado para consultas sencillas y pruébalo con tus casos difíciles.
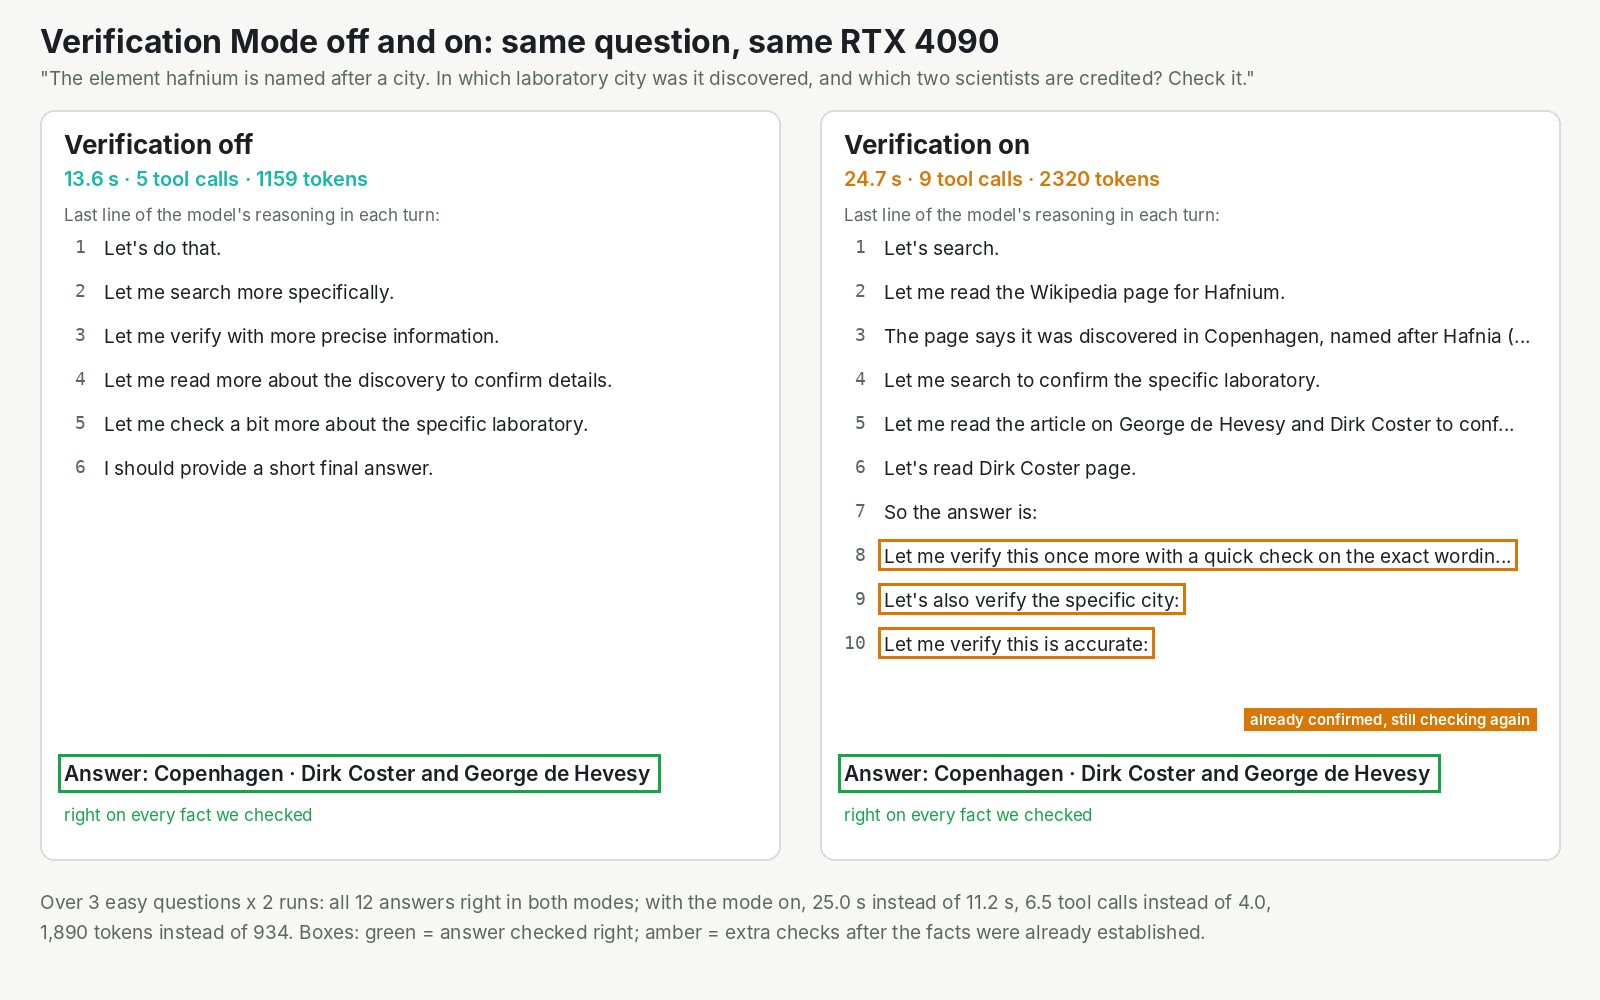
La imagen muestra una pregunta hecha dos veces en la misma tarjeta: en qué ciudad se descubrió el hafnio y quién lo descubrió. Las dos ejecuciones acertaron, y la que tenía el modo encendido siguió comprobando datos que ya había leído.
| Lo que quieres saber | Lo que medimos |
|---|---|
| La tarjeta más pequeña que lo movió a plena velocidad | una RTX 4090, 24 GB |
| Verification Mode en preguntas fáciles | mismas respuestas, 2,2 veces el tiempo, el doble de tokens |
35B parámetros, 3B despiertos en cada palabra
Sage-A1.5 es grande en disco y pequeño en movimiento, y por eso una tarjeta gaming puede servirlo. Es un modelo mixture-of-experts. Imagina un equipo de 256 especialistas, más un generalista que siempre está en la sala. Por cada palabra que escribe, el modelo consulta a 8 especialistas. El resto espera. Así que de 35B parámetros solo unos 3B trabajan en cada paso, según la página del proyecto. La velocidad depende de los 3B, y la factura de memoria, de los 35B.
El modelo está reentrenado a partir de otros dos: el modelo abierto de 35B del equipo de Qwen y Agents-A1, el agente anterior del propio laboratorio, publicado en junio. El paper, de Wenjie Lou y 98 coautores, salió el 20 de octubre. El modelo completo y el fichero comprimido, de unos 22 GB, son Apache-2.0: libres para uso comercial y descargables sin formulario. Un pequeño fichero extra permite al modelo leer imágenes, y dos modos que activas tú lo convierten en un agente:
- Agentic Orchestration. Le das al modelo una herramienta que reparte tareas. El modelo divide entonces una pregunta en tareas y entrega cada una a un subagente, que busca y lee por su cuenta y vuelve con lo que ha encontrado. Es un investigador principal que manda a tres ayudantes a la biblioteca a la vez.
- Verification Mode. Una línea añadida a las instrucciones del modelo le dice que revise su propio trabajo antes de responder. Los autores dicen que no hace falta instalar nada más.
Las puntuaciones de los autores son del modelo sin comprimir y no las reprodujimos
En BrowseComp, que pide datos difíciles de encontrar en la web, los autores dan 81,7 sobre 100, frente a 91,2 de Kimi-K3, el mejor modelo de su tabla. En una prueba aparte, con el modo encendido y apagado sobre las 1.266 preguntas de BrowseComp, Verification Mode subió la puntuación del 72,5 % al 82,9 %. No sabemos si el 81,7 ya incluye esa mejora. Sus otras puntuaciones están en el apéndice.
Nuestra prueba: una RTX 4090, el fichero de los autores, nuestras preguntas
Primero el límite: un puñado de preguntas fáciles, respaldadas por Wikipedia, en una tarjeta, con un agente cada vez. Eso comprueba la maquinaria (llamadas a herramientas, reparto de tareas, respuestas que vuelven), no la amplitud de su investigación.
Servimos el fichero comprimido de los autores con llama.cpp, el software abierto que ejecuta modelos en una sola máquina, en una RTX 4090 de nuestra nube. Usamos los ajustes recomendados por los autores. Todas las peticiones pasaron por nuestra plataforma, como las haría una aplicación, y además comprobamos la velocidad contra llama.cpp directamente.
Las preguntas eran nuestras. Cada una necesitaba unos pocos datos de Wikipedia: quién descubrió el renio y dónde, a qué ciudad debe su nombre el hafnio, cuándo se encontró el tecnecio. El modelo buscó y leyó páginas en vivo a través de dos herramientas que escribimos nosotros. Para la orquestación hicimos una sola pregunta, ejecutada tres veces: cuántos años pasaron entre los descubrimientos de tres elementos, de modo que cada subagente se encargó de uno.
Unos 136 tokens por segundo y una pregunta de investigación correcta en las tres ejecuciones
En una RTX 4090 el modelo escribió unos 136 tokens por segundo con una petición, y el primer token llegó en aproximadamente un cuarto de segundo. Pasar por nuestra plataforma no añadió ningún retraso medible: llama.cpp solo dio la misma velocidad. Una respuesta de 1.489 tokens tardó unos 11 segundos.
También lee rápido los prompts largos. Escondimos una etiqueta inventada, 7342-ORCHID, dentro de un prompt de 92.662 tokens, más o menos la longitud de una novela. El modelo lo leyó entero en 31 segundos y encontró la etiqueta.
La pregunta de investigación volvió correcta todas las veces. En cada una de las tres ejecuciones de prueba, el modelo repartió tres tareas a la vez, una por elemento. Los tres subagentes buscaron en Wikipedia y devolvieron lo que encontraron. Después el modelo principal escribió la respuesta: hafnio en 1923, renio en 1925, tecnecio en 1937, 14 años del primero al último. Todas las llamadas a herramientas salieron exactamente en el formato que nuestro código necesitaba para ejecutarlas. Una prueba más sencilla, con una sola llamada de búsqueda, salió limpia 3 de 3 veces, en menos de un segundo cada una.
El tiempo depende de si los subagentes corren en paralelo, y el valor por defecto de nuestra plataforma los pone en cola. Tras un despliegue, la plataforma manda al modelo una petición cada vez, así que los tres subagentes esperaron su turno y la ejecución tardó 72,0 segundos. Una llamada a la API subió el límite a dos, y entonces las ejecuciones tardaron 50 y 56 segundos. Estado: el valor por defecto sigue siendo uno, y la llamada está en el apéndice.
La parte de visión también funciona. Le enseñamos la gráfica de benchmarks de los propios autores y le pedimos un valor. Leyó 80,0 en la barra correcta, y 50,0 como el mejor de los modelos más grandes, las dos cosas bien.
La pega es cuánto piensa. Este modelo razona largo y tendido antes de responder. Una definición de dos frases tardó 14,4 segundos, porque antes razonó durante 1.905 tokens. Incluso 17 x 23 le costó 336 tokens de razonamiento. A 136 tokens por segundo eso vale para una tarea de investigación, y es lento para un chat.
Verification Mode dobló el trabajo en preguntas fáciles y no cambió ninguna respuesta
En nuestras preguntas fáciles, Verification Mode no aportó nada que pudiéramos medir. Las 12 respuestas fueron correctas con el modo apagado y con el modo encendido.
| Apagado | Encendido | |
|---|---|---|
| Respuestas correctas | 6 de 6 | 6 de 6 |
| Tiempo medio | 11,2 s | 25,0 s |
| Media de llamadas a herramientas | 4,0 | 6,5 |
| Media de tokens escritos | 934 | 1.890 |
El trabajo extra fue sobre todo repetición. Con el modo encendido, el razonamiento se llenó de turnos de "Let me verify" cuando los datos ya estaban confirmados. La diferencia varió: en la otra ejecución del hafnio, el modo encendido hizo una llamada a herramientas menos que el apagado. Una ejecución tardó 52,7 segundos porque una búsqueda en Wikipedia agotó el tiempo de espera y el modelo lo volvió a intentar.
Eso no contradice a los autores. Su mejora llegó en BrowseComp, donde los datos son difíciles de encontrar y es habitual que la primera pista sea falsa.
Qué GPU: una tarjeta real de 24 GB a plena velocidad, y por debajo una quinta parte de la velocidad o menos
La tarjeta más pequeña que movió Sage-A1.5 a plena velocidad fue una RTX 4090 real de 24 GB. Con los ajustes de nuestro ejemplo, espacio para 32.768 tokens de conversación y dos peticiones a la vez, usó 21,3 de los 23,5 GiB de la tarjeta. La configuración de la propia ficha del modelo, 64K tokens con visión, llegó a un pico de 23,1 GiB. Con 128K tokens, solo texto, el pico fue de 23,4 GiB, con la tarjeta casi llena. Todas entraron, sin perder velocidad.
Por debajo de 24 GB, el modelo solo funciona si parte de él pasa a la memoria principal del ordenador. Llama.cpp puede aparcar ahí algunos especialistas y dejar que los ejecute el procesador, que es mucho más lento. Simulamos tarjetas más pequeñas en la misma 4090, sacando especialistas hasta que la memoria de la tarjeta se quedó por debajo de cada límite.
- 16 GB simulados: 14,4 GiB en la tarjeta, unas 5,6 veces más lento, y la pregunta de investigación siguió saliendo bien, en 98 segundos.
- 12 GB simulados: 10,8 GiB en la tarjeta, y la pregunta salió bien en 93 segundos.
- 8 GB simulados: 3,0 GiB con todos los especialistas en memoria principal. Una de dos ejecuciones de investigación agotó su límite de 12 pasos tras 270 segundos sin respuesta. El reintento acertó.
- Sin probar: tarjetas reales de 16 y 12 GB, la RTX 3090, tarjetas de 32 GB, el modelo sin comprimir.
Las velocidades simuladas dependen del procesador y la memoria del ordenador, así que tómalas como una tendencia, no como una promesa. Los ajustes más pequeños también necesitan memoria principal libre para los especialistas aparcados, hasta unos 17 GB cuando se mueven todos.
En InferenceKey: listo en 104 segundos, tras un arreglo en el comando de la ficha del modelo
Un modelo de agente de 35B no debería necesitar un motor a medida, y este no lo necesitó. De la llamada de despliegue a estar sirviendo pasaron 104,1 segundos, con la versión de llama.cpp que nuestra plataforma ya trae: descargar el fichero de 21,7 GB, cargarlo, responder. Nuestra plataforma ejecuta un modelo en un worker, una máquina con GPU propia o alquilada que conectas a ella, y su llama.cpp por defecto cargó Sage-A1.5 sin cambios. La primera vez en una máquina nueva, además hay que compilar llama.cpp para la tarjeta, y eso tardó diez minutos y medio. Después, un reinicio tarda de 4 a 7 segundos.
El único problema con el que te vas a encontrar está en la propia ficha del modelo. Su comando de llama.cpp usa un ajuste de razonamiento llamado deepthink, que llama.cpp no tiene. El servidor se cierra al arrancar con "Unknown reasoning format: deepthink". Lo comprobamos también en una versión mucho más reciente de llama.cpp, y ahí tampoco existe. El arreglo es escribir deepseek en su lugar. Estado: arreglado en nuestro ejemplo, sigue en la ficha de los autores.
Un segundo hueco es nuestro. Los autores activan Verification Mode con un ajuste que nuestra plataforma todavía no le pasa al modelo. Nuestro ejemplo añade en su lugar la misma línea de activación a las instrucciones del modelo. Comprobamos que el modelo ve exactamente el mismo prompt por las dos vías. Estado: abierto por nuestra parte, resuelto con un apaño en el ejemplo.
¿Merece la pena probarlo? Sí, en una tarjeta de 24 GB: la maquinaria de agente funcionó
- Si quieres un agente que busque, lea e informe en tu propio hardware, pruébalo.
- Si te importa la precisión en preguntas difíciles, prueba Verification Mode con tus propios casos difíciles.
- Si necesitas respuestas rápidas de chat, busca otra cosa. Piensa durante cientos o miles de tokens antes de dar respuestas cortas.
- Si tu tarjeta tiene 16 GB o menos, cuenta con una fracción de la velocidad, y solo con mucha memoria principal.
Para hacerle a Sage-A1.5 la misma pregunta de investigación en tu propia tarjeta, con subagentes y con Verification Mode apagado y encendido, ejecuta python main.py desde el ejemplo del SDK de Sage-A1.5. Necesita un proyecto de InferenceKey con un token del SDK y una API key, y un worker NVIDIA privado con 24 GB o más. Al terminar, borra el despliegue.
Para ingenieros
Créditos
- Sage-A1.5: Shanghai AI Laboratory (la organización InternScience en Hugging Face, publicado como Alpha-Innovator en la página del proyecto), paper de Wenjie Lou y 98 coautores, arXiv 2610.28578. Entrenaron el modelo, crearon los dos modos, publicaron los pesos BF16, el GGUF Q4_K_M oficial y el proyector de visión bajo Apache-2.0, y grabaron una demo de llama.cpp en Mac en la página del proyecto.
- Modelos base: Qwen3.6-35B-A3B, del equipo de Qwen, y Agents-A1, el agente anterior de los autores (liberado el 2026-06-26, 35B-A3B, Apache-2.0).
- Servicio: el proyecto llama.cpp.
- Datos para nuestras preguntas: Wikipedia, a través de su API pública.
- Dónde lo vimos: el vídeo de noticias del 2026-10-25 de AI Search (segmento de Sage-A1.5 en el 36:10).
- Nuestra parte: el despliegue a través de la plataforma, las preguntas y las herramientas, las mediciones, la escalera de VRAM, el ejemplo del SDK y el vídeo de la demo.
Modelo y ficheros
InternScience/Sage-A1.5-Q4_K_M-GGUF, sha10b179b52f2c841030db327627e707d076b4c8cf, creado el 2026-10-21, última modificación el 2026-10-22, Apache-2.0, sin acceso restringido.Sage-A1.5-Q4_K_M.gguf: 21.713.463.520 B ("MoE weights + built-in MTP layer"), arquitectura GGUFqwen35moe. Unos 5 bits por parámetro de media para unos 35B parámetros, aproximadamente un tercio del tamaño del repo BF16.Sage-A1.5-mmproj.gguf: 899.282.880 B. En total, unos 22,6 GB.
InternScience/Sage-A1.5(BF16), sha0e3205cf, creado el 2026-10-15, última modificación el 2026-10-22: 14 shards de safetensors de unos 5,37 GB másmodel-mtp.safetensorsde 1,69 GB, unos 72 GB.Qwen3_5MoeForConditionalGeneration: 40 capas (30 de atención lineal, 10 de atención completa), 256 expertos, 8 por token más un experto compartido, hidden 2048, 1 capa MTP, torre de visión de 27 capas,max_position_embeddings262.144. 35B en total, unos 3B activos por token (página del proyecto).- Nota de memoria de la ficha: "~20.2 GiB for the Q4_K_M weights plus ~0.84 GiB for the projector, plus the KV cache... A single 24 GB GPU comfortably serves the model at moderate context lengths".
- Muestreo recomendado: temperatura 1,0, top_p 0,95, top_k 20, min_p 0,0, presence_penalty 1,5, repetition_penalty 1,0.
Benchmarks de los autores (BF16, no reproducidos)
| Benchmark | Sage-A1.5 | Otros en la tabla de los autores |
|---|---|---|
| GAIA | 95,1 | Agents-A1 96,0, Kimi-K3 92,2, GLM-5.3 92,2, GPT-5.6-sol 88,3 |
| BrowseComp | 81,7 (82,8 con orquestación) | Kimi-K3 91,2, GPT-5.6-sol 90,4, GLM-5.3 76,2, Agents-A1 75,5, Qwen3.6-35B-A3B 67,9 |
| SWE-bench Pro | 61,2 | GPT-5.6-sol 64,6, GLM-5.3 64,6, Kimi-K3 63,3, Ornith-1.5 59,6, Qwen3.6-35B-A3B 49,5, Agents-A1 43,6 |
| HLE con herramientas | 55,1 | GPT-5.6-sol 64,5 |
| IFBench | 81,6 | |
| FrontierScience-Research | 48,3 | |
| CMT | 80,0 | mejor modelo más grande 50,0 |
La ficha dice que la cuantización Q4_K_M "trades a small amount of accuracy". SWE-bench Pro usó el harness mini-SWE-agent, temperatura 1,0, top-p 0,95, 200K de contexto, offline. En GAIA, el predecesor Agents-A1 (96,0) puntúa más alto que Sage-A1.5 (95,1) en la propia tabla de los autores. Los modelos punteros actuales (Claude Opus 5.5, GPT-6.1 Sol) no están en la tabla.
Montaje
- Una RTX 4090 de 24 GB (24.080 MiB) en nuestra nube (InferenceKey Cloud), límite de potencia de 203 W (450 W de serie), AMD EPYC 7402, driver 580.142, una imagen de contenedor de CUDA 13.
- Backend
llamacppde serie, tag de llama.cppb9748(la versión fijada por defecto en el worker, sin cambiarla). Ya incluyeLLM_ARCH_QWEN35MOE. - Un manager local de InferenceKey (de
origin/main9e53fe57) puso en marcha el worker. Producción no intervino. - Peticiones en streaming a través del endpoint compatible con OpenAI salvo que se indique lo contrario. Velocidad contrastada con llama-server directamente.
Paso a paso con el ejemplo del SDK
- Clona inferencekey-sdk y abre
examples/sage-a1-5-research-agent-llamacpp-private-nvidia/(commit3c5cc178). - Compila el binding de Python en local con maturin e instala
requests>=2.31(requirements.txt). - Copia
.env.examplea.envy rellenaINFERENCEKEY_SDK_TOKEN,INFERENCEKEY_API_KEY,INFERENCEKEY_PROJECTeIK_WORKER_ID(un worker NVIDIA privado con 24 GB o más). Opcional:IK_KEEP_ALIVE=1conserva el despliegue,SAGE_CONTEXTcambia el contexto (32768 por defecto; 65536 y 131072 entran en 24 GB solo con texto). - Ejecuta
python main.py. El flujo:ensure()de un workloadllamacppfijo en tu worker,wait_until_ready(3600), una pregunta simple congenerate_text()(max_tokens16.384), Agentic Orchestration, Verification Mode apagado y encendido, respuestas aoutputs/answers.json, y despuésdelete()salvo conIK_KEEP_ALIVE=1. - El script ejecuta las herramientas (
wiki_search,read_page) en tu lado contra la API pública de Wikipedia, con hasta 5 subagentes en hilos paralelos. La máquina que lo ejecuta necesita acceso a internet.
El comando que despliega el ejemplo:
llama-server -hf InternScience/Sage-A1.5-Q4_K_M-GGUF --hf-file Sage-A1.5-Q4_K_M.gguf \
  --no-mmproj --alias sage-a1.5 -ngl 99 -fa on -c 32768 -np 2 --kv-unified \
  --jinja --reasoning-format deepseek \
  --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0 --presence-penalty 1.5
Para subagentes en paralelo, sube el max_in_flight de la asignación de 1 a 2 con PATCH /api/projects/<pid>/assignments/<workload>/<worker>.
Verification Mode a través de nuestro endpoint (el disparador exacto de la plantilla, "protocol" en minúscula):
system = "You are a careful research assistant." + "\n\nVerification protocol: enabled"
Directamente contra llama-server funciona el interruptor documentado: chat_template_kwargs={"verification": true}, con un mensaje de sistema no vacío y un booleano JSON (si no, la plantilla devuelve HTTP 400).
Tiempos
- Compilación CUDA de llama.cpp
b9748(arch 89, 46 jobs): 10 min 33 s. - De
ensure()a listo, con llama.cpp ya compilado: 104,1 s (descarga de 21,7 GB y carga). - Reinicios de llama-server en caliente: de 4 a 7 s.
Velocidad (streaming, una petición, muestreo de los autores)
| Vía | Prompt | Tokens | Primer token | Decode |
|---|---|---|---|---|
| Endpoint | redacción de 300 palabras | 1.489 / 1.827 | 0,22 / 0,26 s | 137,5 / 135,0 tok/s |
| Endpoint | "capital of Australia, one word" | 118 / 125 | 0,32 / 0,24 s | 129,4 / 130,7 tok/s |
| llama-server directo | redacción | 1.525 / 3.297 | 0,27 / 0,36 s | 134,0 / 135,3 tok/s |
| Directo, configuración de 128K | prompt de aguja de 92.662 tokens | 110 | prefill 2.987 tok/s (31,0 s), decode 99,6 tok/s, encontró "7342-ORCHID" | |
| Directo, 64K + mmproj | gráfica de los autores + pregunta (2.124 tokens de prompt) | 1.628 | prefill 1,66 s, 131,7 tok/s, respuesta correcta |
Durante el decode: en torno al 66 % de uso de GPU y unos 175 W del límite de 203 W, así que la tarjeta se quedó por debajo de su límite. No medimos una 4090 sin límite.
Llamadas a herramientas y modos
- Una sola llamada a herramientas: 3 de 3 con una llamada a
wiki_searchcon argumentos JSON válidos, de 0,87 a 0,98 s. Sin probar: muchas herramientas a la vez o esquemas de argumentos anidados. - Orquestación (el principal solo tiene
spawn_subagent, los subagentes tienenwiki_searchyread_pagey devuelven{answer, status, evidence, unresolved_issues}), una pregunta en tres partes (años entre los descubrimientos del hafnio, el renio y el tecnecio): 3 de 3 ejecuciones de prueba correctas, más la toma grabada para el vídeo, también correcta, así que 4 de 4 en total. La imagen resumen cuenta las 3 ejecuciones de prueba. Unspawn_subagentcon 3 tareas por ejecución. 72,0 s conmax_in_flight1 (turnos de los subagentes 9/7/3), 49,7 s (4/4/7) y 55,7 s (3/6/11) con 2, toma grabada 48,3 s. Un subagente hizo 9 llamadas a herramientas para el hafnio porque las fuentes no se ponen de acuerdo entre 1922 y 1923. - Verificación, 3 preguntas (renio, hafnio, tecnecio) x 2 ejecuciones x apagado/encendido:
| Modo | Ejecuciones | Media s | Media de llamadas a herramientas | Media de tokens de completion | Media de caracteres de razonamiento | Correctas |
|---|---|---|---|---|---|---|
| apagado | 6 | 11,2 | 4,0 | 934 | 2.778 | 6/6 |
| encendido | 6 | 25,0 | 6,5 | 1.890 | 5.662 | 6/6 |
Media de turnos: 5,0 apagado, 7,5 encendido. La dispersión es grande: la ejecución del hafnio de la imagen clave pasó de 5 a 9 llamadas a herramientas (de 13,6 s a 24,7 s), mientras que la otra ejecución del hafnio hizo 6 llamadas con el modo encendido frente a 7 apagado (15,9 s frente a 15,5 s).
No vimos la revisión estructurada de "qué está establecido, qué falló" del texto de la demo de los autores. Los turnos extra fueron simples recomprobaciones.
Escalera de VRAM
VRAM pico con nvidia-smi cada 1 s. El texto da estas cifras en GiB (21.760 MiB son unos 21,3 GiB; los 24.080 MiB de la tarjeta, 23,5 GiB, menos 23.920 MiB con 128K dejan 160 MiB). Límites emulados en la misma 4090 moviendo los expertos de N capas a la RAM del sistema (--n-cpu-moe, 24 hilos de CPU). Comprobación del agente: la pregunta del renio, verificación apagada, presupuesto de 12 turnos.
| GPU o límite | Configuración | VRAM pico | Velocidad | Salida correcta | Real o emulada |
|---|---|---|---|---|---|
| RTX 4090 24 GB | -c 32768 -np 2 --kv-unified, solo texto, a través de la plataforma | 21.760 MiB | 135 a 137 tok/s; orquestación 48 a 56 s | sí | real |
| RTX 4090 24 GB | -c 65536 --mmproj, -fit off | 23.684 MiB | 138 tok/s; agente 22,3 s | sí, gráfica bien leída | real |
| RTX 4090 24 GB | -c 131072 solo texto, -fit off | 23.920 MiB | 137 a 139 tok/s; agente 25,6 s | sí, aguja de 92,7K encontrada | real |
| Límite de 16 GB | -c 32768 -np 2 --n-cpu-moe 16 | 14.708 MiB | 23,9 a 25,0 tok/s; agente 98,0 s | sí (unas 5,6 veces más lento) | emulada |
| Límite de 12 GB | --n-cpu-moe 24 | 11.052 MiB | 12,9 a 18,1 tok/s; agente 92,8 s | sí | emulada |
| Límite de 8 GB | --cpu-moe | 3.048 MiB | 14,1 a 14,9 tok/s; agente 270,2 s, sin respuesta, reintento correcto en 104,1 s | parcial, 1 de 2 | emulada |
| RTX 4090 24 GB | --spec-type draft-mtp -md <same GGUF> | no: failed to allocate CUDA0 buffer of size 21416407552 | real |
--cpu-moe necesita unos 17 GB de pesos en la RAM del sistema. Sin probar: tarjetas reales de 16 y 12 GB (ninguna disponible en nuestra nube: 4080, 4080 SUPER, 5080, A4000, 2000 Ada, 4070 Ti, 3080 Ti), RTX 3090 (la única máquina que conseguimos no tenía SSH directo y se terminó), tarjetas de 32 GB, pesos BF16 con vLLM, otras cuantizaciones.
Problemas y estado
--reasoning-format deepthinken la ficha del modelo: llama-server se cierra con "Unknown reasoning format: deepthink". Los valores válidos enb9748sonnone|deepseek|deepseek-legacy|auto, yb12000(2026-10-30) sigue sindeepthink. Arreglado en el ejemplo condeepseek.- El endpoint descarta
chat_template_kwargs,top_kymin_p.ChatCompletionRequestno los transporta. A través del endpoint,{"verification": "maybe"}y{"verification": true}sin mensaje de sistema devuelven 200 los dos, así que los kwargs nunca llegan a la plantilla. Apaño: la línea de activación en el mensaje de sistema, idéntica byte a byte en/apply-templatecon y sin herramientas. Abierto. - El endpoint sin streaming descarta
reasoning_contentcuando haycontent. Conmax_tokens4.096, la primera pregunta simple devolvió 4.096 tokens de "Thinking Process:" en 30,7 s. El ejemplo pide 16.384 (entonces 14,4 s, 1.905 tokens) y usa streaming en los bucles del agente. - Compilación de llama.cpp en el worker: "No CMAKE_CUDA_COMPILER could be found", porque
nvcc(13.0.88,/usr/local/cuda/bin) no está en elPATHde la imagen de contenedor del worker. Resuelto conCUDACXX,PATHyCMAKE_BUILD_PARALLEL_LEVELen el entorno del worker. Estado: abierto en el producto, todavía sin ticket. wait_until_ready()se cuelga con un workload fijo que ya está sirviendo:worker_leasesestá vacío para la asignación fija privada, y la comprobación de disponibilidad solo lee leases Ready en vivo. Estado: bug abierto del producto, todavía sin ticket.max_in_flightvale 1 trasensure(), así que los subagentes hacen cola. Lo subimos a 2 con el PATCH de arriba. Estado: abierto, el valor por defecto sigue siendo 1.- La URL de NATS local usaba
tls://por defecto mientras el nats-proxy local tenía TLS desactivado. Arreglado con un ajustenats://y una reinstalación del worker. Solo afecta al montaje de pruebas local. - MTP (la capa integrada que adivina varios tokens a la vez) desde el mismo GGUF:
--spec-type draft-mtp -md <same GGUF>carga el fichero una segunda vez y se queda sin memoria en 24 GB conb9748. - Una máquina RTX 3090 arrancó sin SSH directo durante 180 s y el manager la terminó.
- Incoherencias de la ficha y la página: los fragmentos de servicio de la página del proyecto nombran
Alpha-Innovator/Agents-A1.5(el repo esInternScience/Sage-A1.5), y la página escribe el disparador como "Verification Protocol" mientras que la plantilla usa "protocol". Usamos la cadena de la plantilla. La traza de la demo en Mac de los autores no tiene registro de hardware, cuantización ni rendimiento, como ellos mismos dicen.
Vídeo de la demo
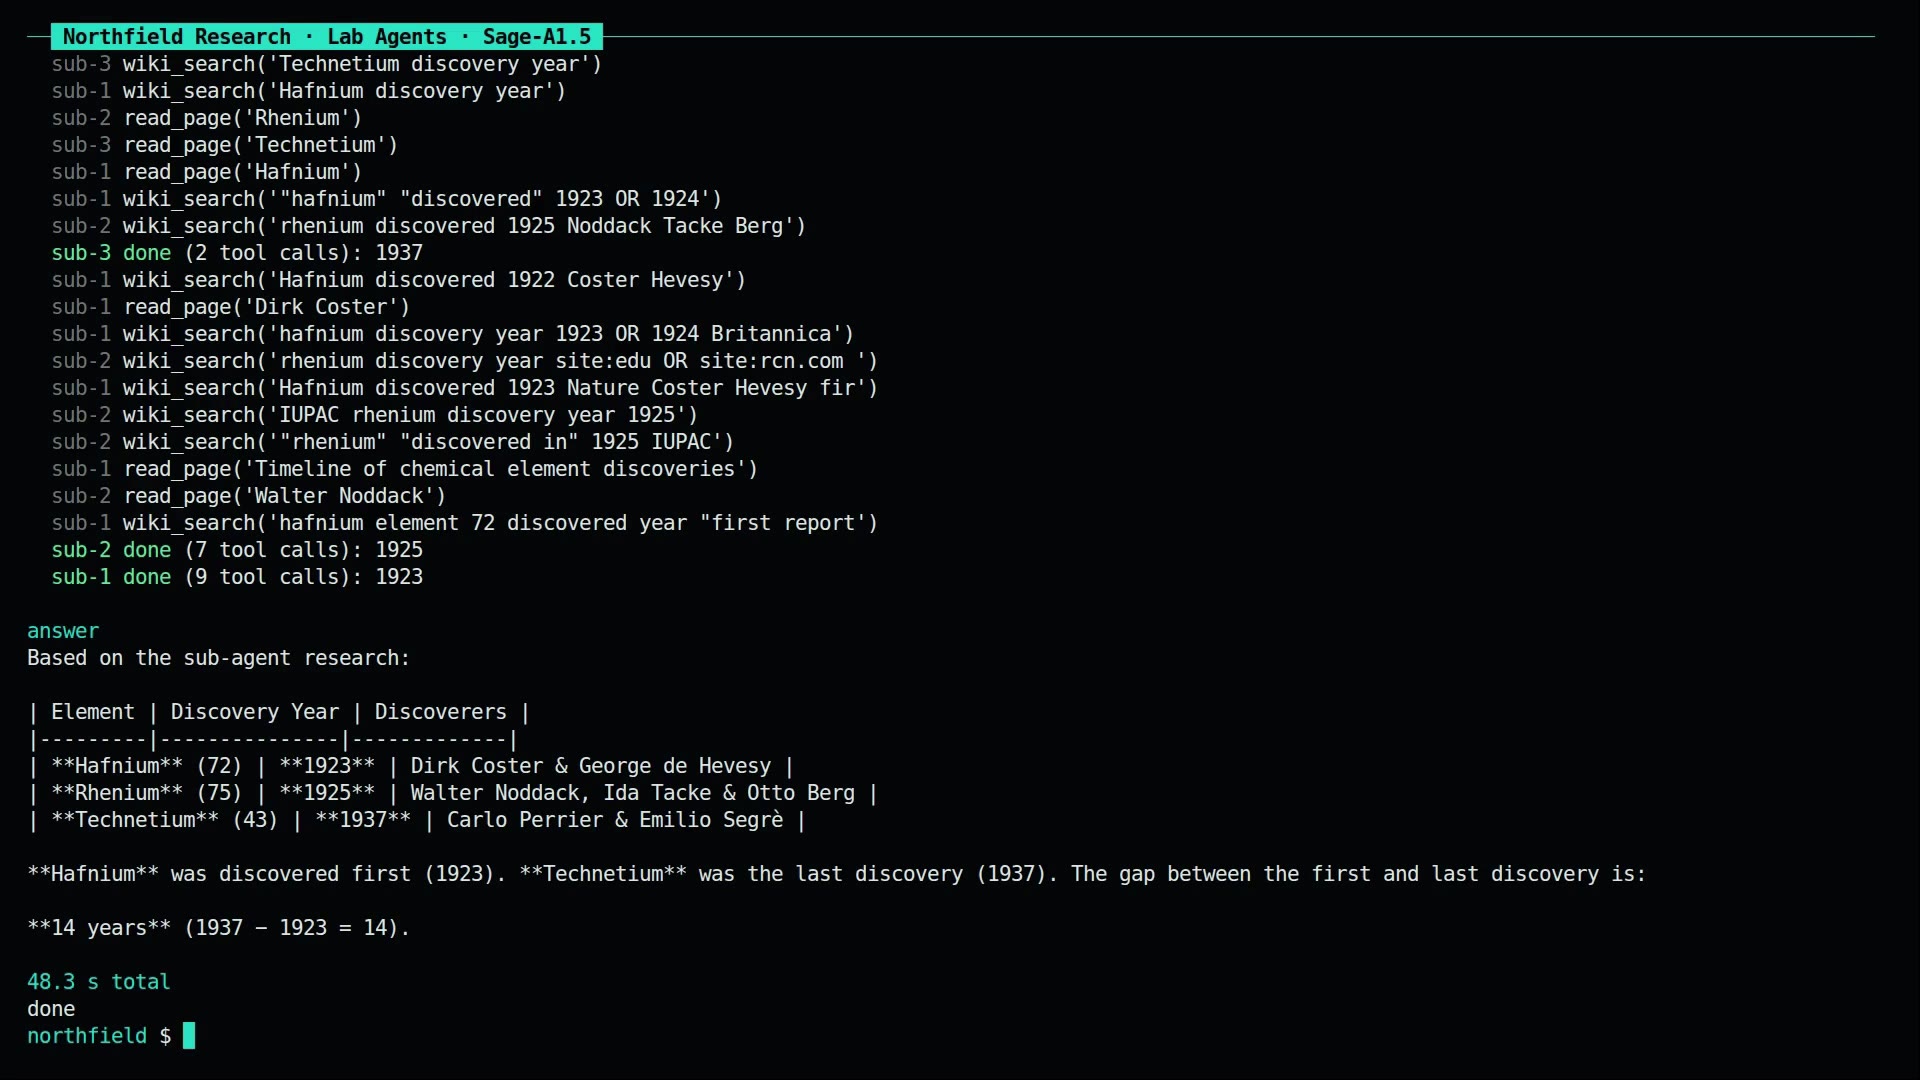
160,6 s, 1920x1080. Incluye un fragmento de la demo de llama.cpp en Mac de los autores, atribuida al equipo de Sage-A1.5, y su tabla de benchmarks, atribuida y marcada como no reproducida por nosotros.
Fuentes
- Ficha del modelo, BF16: https://huggingface.co/InternScience/Sage-A1.5
- Ficha del modelo, GGUF Q4_K_M: https://huggingface.co/InternScience/Sage-A1.5-Q4_K_M-GGUF
- Paper: https://arxiv.org/abs/2610.28578
- Página del proyecto: https://alpha-innovator.github.io/Sage-A1.5/
- Predecesor: https://github.com/InternScience/Agents-A1
- Ejemplo del SDK: https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/sage-a1-5-research-agent-llamacpp-private-nvidia
- Dónde lo vimos: https://www.youtube.com/watch?v=EfyQOAJjx1A