Hy-Nomas auf einer RTX 4090: eine Videowelt mit Gedächtnis, etwa 90 Sekunden pro 5-Sekunden-Turn
Tencents offenes Video-Weltmodell auf einer RTX 4090 mit 24 GB: 88 bis 94 s pro 5-s-Segment, 18,5 GiB Spitze, 1 von 4 Szenenwechseln umgesetzt.
Die meisten offenen Videomodelle geben dir einen Clip und vergessen ihn dann. Hy-Nomas, ein offenes Modell von Tencent Hunyuan, behält die Welt im Gedächtnis, und so hängt jede neue Anweisung fünf weitere Sekunden an dieselbe Szene. Die Frage für alle mit eigener Hardware: Funktioniert Tencents Rezept für eine Karte auch fern seiner Heimat mit acht GPUs? Auf einer einzelnen RTX 4090 mit 24 GB in unserer Cloud lief es, mit etwa anderthalb Minuten pro 5-Sekunden-Stück. Der Fuchs, der Steinpfad und das Licht blieben von Aufruf zu Aufruf erhalten. Einer von vier Szenenwechseln kam an: neue Blumen ja, Schnee und ein Sturm nein. Eine gemietete Gaming-Karte reicht also, um Szenen zu prototypen, die von Turn zu Turn konsistent bleiben, aber nicht für ein Live-Spiel. Die Fuchswelt mit drei Turns gibt es als SDK-Beispiel, das du auf deiner eigenen Karte nachspielen kannst.
| Was du wissen willst | Was wir gemessen haben |
|---|---|
| Zeit für je 5 s Video | 88 bis 94 s auf einer RTX 4090 |
| GPU-Speicher | 18,5 GiB Spitze, etwa vier Fünftel der Karte |
| Kleinstes Setup, das funktioniert hat | eine RTX 4090 mit 24 GB, und dieselbe Karte auf 20 GiB begrenzt für zwei Turns |
| Hält die Welt zusammen? | ja, über 3 Turns (15 s Video) |
| Folgt es Änderungen? | 1 von 4 Szenenwechseln (ein neues Objekt ja, Wetter nein), Aktionen ignoriert |
| Was du herunterlädst | etwa 35 GB aus einem Repository mit 196 GB |
Ein Modell, das sich Notizen zur bereits gemalten Welt macht
Hy-Nomas erzeugt Video in Turns, und jeder Turn baut auf dem vorherigen auf. Ein gewöhnliches Videomodell ist ein Maler, der einen Auftrag bekommt, malt und geht. Hy-Nomas ist ein Maler mit Notizbuch. Jedes Mal, wenn er fünf Sekunden fertig hat, schreibt er auf, wie die Szene aussieht. Wenn du die nächste Anweisung schickst, liest er zuerst im Notizbuch. Deshalb ist der Fuchs in Turn drei derselbe Fuchs wie in Turn eins.
Die Autoren nennen es ein Video-Weltmodell: Du steuerst es Turn für Turn, jedes 5-Sekunden-Segment mit einer neuen Textanweisung oder einem Kamerapfad. Die schnelle Version erzeugt laut Model Card 720p-Video mit 24 Bildern pro Sekunde. Das Paper, "Hy-Nomas: Towards Free-form Interactive World Generation", erschien am 27. Oktober mit 39 Autoren. Deine Anweisungen liest es mit einem geliehenen offenen Modell, Qwen2.5-VL-7B.
Gewichte und Code stehen unter Apache-2.0: kommerziell frei nutzbar, kein Formular auszufüllen. Das Code-Repository führt ein paar Fremdkomponenten unter ihren eigenen Lizenzen auf.
Der Download wirkt schlimmer, als er ist. Das ganze Hugging-Face-Repository hat 196 GB, weil es die Originale in voller Größe enthält, zwei Zusatzadapter (Kino-Look, Robotik) und einen großen Prompt-Umschreiber. Das Setup für eine Karte braucht nur drei Teile, zwei davon komprimiert: das Videomodell, den Decoder, der daraus Bilder macht, und den Textleser. Das sind etwa 35 GB, und unsere Maschine hat sie in etwa 20 Sekunden geladen.
Die Autoren betreiben es auf acht GPUs und veröffentlichen ein zweites Rezept für eine
Der Standardstart in der Model Card verteilt ein Video auf acht GPUs, die als Gruppe arbeiten. Daneben veröffentlichen die Autoren ein Rezept für eine einzelne RTX 4090. Es speichert die großen Teile in komprimierter Form und hält sie im Hauptspeicher des Rechners. Jeder Teil wandert nur für seine eigene Stufe auf die GPU: erst der Textleser, dann das Videomodell, dann der Decoder, der das Ergebnis in Bilder verwandelt. Nur die letzten paar Sekunden des Notizbuchs bleiben auf der GPU. Ältere Seiten wandern in den Hauptspeicher.
Die Model Card ist ehrlich, was den Preis angeht. Sie warnt, dass der Hauptspeicher die geparkten Modelle und das wachsende Archiv fassen muss und dass das Hin und Her zwischen Speicher und GPU Zeit kostet. Das Paper nennt kein Tempo für die 4090. Genau das war unsere Frage: Funktioniert das Rezept für eine Karte außerhalb von Tencents Setup, und wie langsam ist es?
Die Model Card fügt hinzu, dass die Angabe "eine GPU" für das Video gilt, nicht für den Prompt-Umschreiber, der jede Anweisung aufpoliert. Ihre Demo schreibt jede Anweisung mit Nomas-PE um, einem viel größeren Modell, dessen mitgelieferter Starter standardmäßig eine ganze Maschine mit 8 GPUs belegt.
Unser Test: eine RTX 4090, das Rezept der Autoren, drei Turns pro Welt
Zuerst die Grenzen. Wir haben zwei kurze Welten gebaut, die längste mit drei Turns, also 15 Sekunden Video. Die Prompts haben wir von Hand geschrieben, ohne den Umschreiber der Autoren, mit einer festen Zufallszahl (einem Seed) pro Welt. Kamerapfade haben wir nicht getestet. Das prüft, ob das Rezept läuft und eine Szene zusammenhält, nicht, wie weit eine Welt gehen kann.
Wir haben das Rezept der Autoren für eine Karte unverändert verwendet, auf einer RTX 4090 in unserer Cloud. Jede Anfrage lief über die API unserer Plattform, so wie eine Anwendung sie aufrufen würde. Die Karte lief in unserer Cloud. Unsere Plattformsoftware lief auf unserem eigenen Server, der gehostete Dienst selbst ist hier also nicht getestet.
Die erste Welt ist das Beispiel der Autoren: ein kleiner orangefarbener Fuchs, der auf einem Steinpfad durch einen Wald läuft. In Turn zwei baten wir darum, dass sich neben dem Pfad blaue Blumen öffnen. In Turn drei baten wir um Schnee, und darum, dass der Fuchs stehen bleibt und nach oben schaut. Eine zweite Welt, ein Leuchtturmwärter mit Laterne, versuchte es mit einem Sturm.
Etwa 90 Sekunden pro 5-Sekunden-Segment, und die Welt hielt zusammen
Auf einer RTX 4090 brauchte jedes 5-Sekunden-Segment 88 bis 94 Sekunden, sobald das Programm warm war. Das ist etwa 18-mal langsamer als Echtzeit. Bleibt es bei diesem Tempo, sind eine Minute Welt zwölf Turns und etwa 18 Minuten GPU-Arbeit. Der erste Aufruf nach einem frischen Start dauerte bis zu 138 Sekunden.
| Fuchswelt, eine RTX 4090 | GPU-Zeit | Spitze GPU-Speicher |
|---|---|---|
| Turn 1: Der Fuchs läuft den Pfad entlang | 88,4 s | 17,4 GiB |
| Turn 2: Blaue Blumen öffnen sich | 93,1 s | 17,6 GiB |
| Turn 3: Schnee, der Fuchs bleibt stehen | 88,2 s | 17,9 GiB |
Der Speicher stieg mit jedem Turn ein wenig, aus einem Grund, den wir nicht gefunden haben. Zählt man alles auf der Karte, lag die Spitze bei 18,5 GiB, etwa vier Fünftel der 24-GB-Karte. Von jeweils 90 Sekunden gehen etwa 35 ins Malen, etwa 9 ins Schreiben des Notizbuchs und der Rest in die Umwandlung in Bilder und eine MP4-Datei.
Die Welt hielt zusammen, und das ist der Teil, der am besten funktioniert. Der Fuchs behielt sein Fell, seine Größe und seinen Gang. Der Pfad, die Bäume und das Licht blieben, wo sie waren. In der Welt des Wärters blieben Regenmantel, Laterne und Leuchtturm zwischen den Aufrufen erhalten. Jeder Aufruf ist eine eigene Anfrage, anderthalb Minuten auseinander, und die Szene wirkte trotzdem wie eine einzige Einstellung.
Es ist auch reproduzierbar. Dieselben Turns mit demselben Seed ergaben über vier Läufe byte-identische Videodateien. Für ein Team heißt das: Ein Bugreport kann die exakten Eingaben enthalten, und jemand anderes mit demselben Setup bekommt genau denselben Clip. Das haben wir nur auf einer Maschine geprüft.
Einer von vier Szenenwechseln kam an: ein neues Objekt ja, Wetter und Aktionen nein
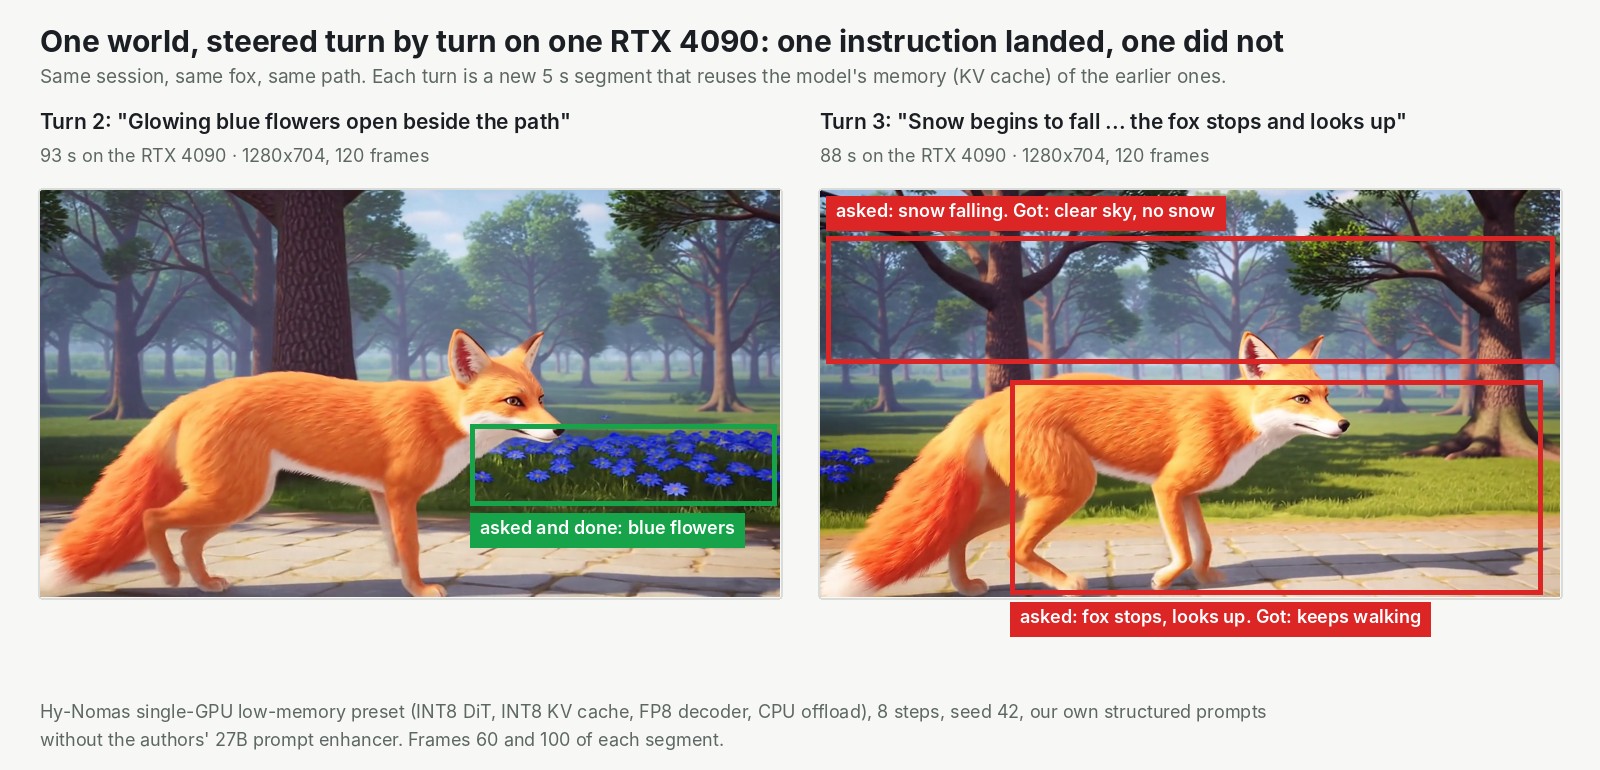
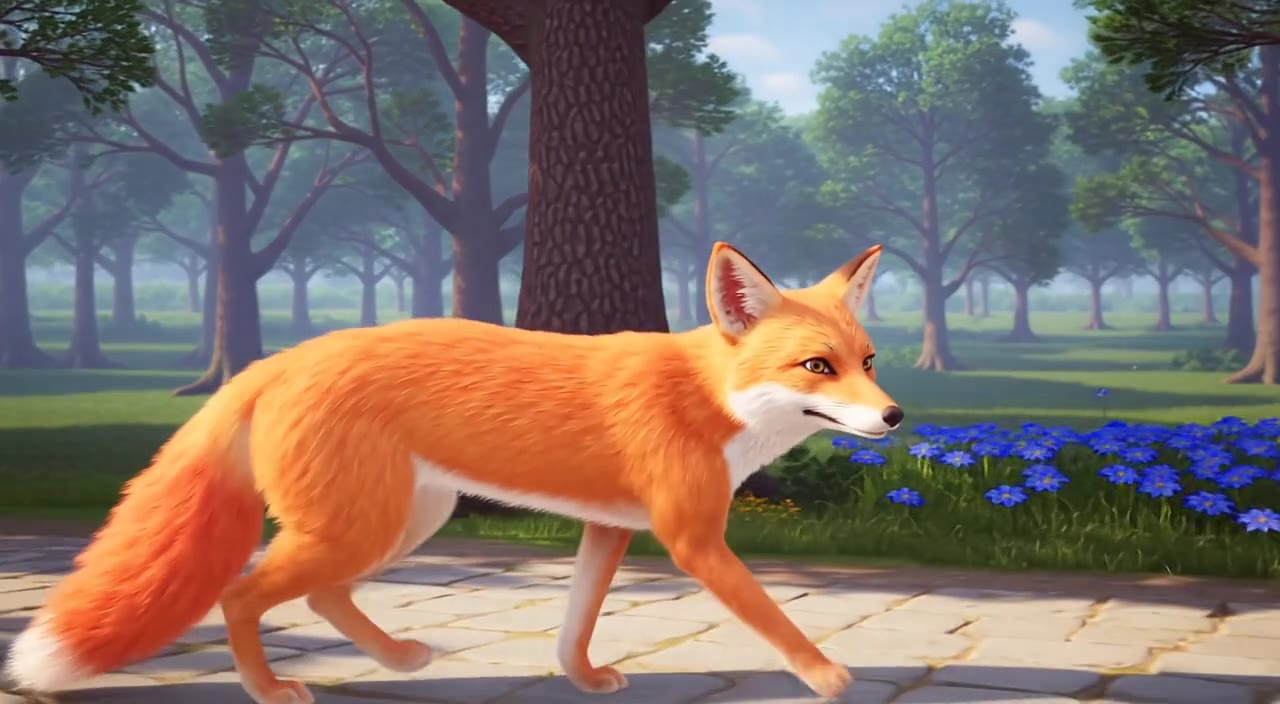
Hy-Nomas fügte das gewünschte Objekt ein, genau auf Stichwort. In Turn zwei tauchten neben dem Pfad blaue Blumen auf, als der Fuchs vorbeilief. Sie leuchteten nicht, wie es der Prompt verlangte, aber sie waren da, an der richtigen Stelle.
Änderungen an der ganzen Szene kamen nie. Turn drei verlangte Schnee, und der Himmel blieb sonnig. Wir haben es mit deutlicheren Worten noch einmal versucht, und wieder kein Schnee. In der Welt des Wärters kam auch kein Sturm mit Regen und Blitzen. Das macht einen von vier Szenenwechseln. Die Aktionen scheiterten ebenfalls: Der Fuchs lief weiter, statt stehen zu bleiben und nach oben zu schauen, und der Wärter hob seine Laterne nie. Selbst die Eröffnungsprompts kamen nur teilweise an. Der Wald hatte keine Glühwürmchen und kein Leuchten, nur Tageslicht und Nebel.
Es spielte wie eine Band, die drei Songs lang den Groove hält und den Tonartwechsel verpasst, den die Sängerin angesagt hat. Ein Verdächtiger ist der fehlende Umschreiber. Die Demo der Autoren macht aus jeder kurzen Anweisung einen strukturierten Generierungsprompt, bevor das Modell ihn sieht. Ob Nomas-PE Schnee und Stürme hinbekommt, haben wir nicht getestet, nimm das also als Vermutung. Das Paper fügt einen eigenen Vorbehalt hinzu: Die Abkürzungen für eine Karte "may introduce subtle differences that become more noticeable over successive segments".
Welche GPU: eine echte RTX 4090 mit 24 GB hat funktioniert, eine Grenze von 20 GiB darauf auch
Eine 24-GB-Karte funktioniert, eine Grenze von 20 GiB funktioniert, und 16 GiB scheitern. Die RTX 4090 war die einzige echte Karte, die wir getestet haben. Für die kleineren Größen haben wir der Software gesagt, weniger von derselben Karte zu nutzen.
- RTX 4090, 24 GB, echte Karte: funktioniert (siehe oben).
- Auf derselben Karte auf 20 GiB begrenzt: funktioniert, ohne Verlangsamung (90,5 Sekunden für den zweiten Turn) und mit byte-identischem Video, über zwei Turns.
- Auf 16 GiB begrenzt: scheitert, bevor überhaupt Video gemalt wird. Der Speicher geht aus, während der Textleser auf die GPU wandert. Eine niedrigere Auflösung würde nicht helfen, weil der Fehler vorher kommt.
Zwei Vorbehalte ändern die Einkaufsliste. Erstens läuft ein Teil des Rezepts nur auf NVIDIAs Ada-Generation, der Familie der RTX 4090. Eine neuere RTX 5090 oder eine ältere A40 sollte daran scheitern, aber wir haben sie nicht laufen lassen. Zweitens lag die Spitze im Lauf der Autoren auf einer Karte bei 20,53 GiB, mit längeren Segmenten als bei uns. Eine echte 20-GB-Karte ist also ein Glücksspiel, das wir nicht getestet haben.
Der Hauptspeicher zählt auch. Jede 5 Sekunden Welt legen dort etwa 5,9 GiB alter Notizbuchseiten ab. Unser Beispiel verlangt 64 GB, eine Wahl, die wir getroffen haben, kein gemessenes Minimum.
Auf InferenceKey: ein Aufruf pro Turn, die Welt bleibt zwischen den Aufrufen erhalten
Ein interaktives Modell braucht einen Server, der die Welt zwischen den Aufrufen im Speicher hält. Unsere Plattform hat sie mit einem kleinen eigenen Programm gehalten, das nur den Generierungsdienst und das Rezept für eine Karte der Autoren umhüllt. Es hält eine Welt zwischen den Aufrufen im GPU- und im Hauptspeicher, also bedient eine Karte eine Welt, und einen Nutzer, zur selben Zeit. Jeder Aufruf schickt einen Turn und bekommt ein MP4 mit fünf Sekunden zurück. Der nächste Aufruf setzt dieselbe Welt fort. Mit den Gewichten schon auf der Platte war das Deployment 19 bis 31 Sekunden nach dem Deploy-Aufruf bereit.
Das eine Problem, auf das du stößt, wenn du mit den Skripten der Autoren anfängst, ist der Speicher. Ihr Skript für die Live-Demo schaltet einen Modus ein, der das Video dekodiert, während das Videomodell noch auf der GPU liegt. Auf 24 GB geht dabei der Speicher aus. Wir haben den Modus abgeschaltet, sodass das Dekodieren erst nach dem Malen beginnt. Status: in unserem Beispiel umgangen (dieser Modus aus), den Autoren noch nicht gemeldet. Die anderen Probleme, die wir gefunden haben, und ihre Fixes stehen im Anhang.
Solltest du es nutzen? Ja für Szenen, die auf einer Karte konsistent bleiben, noch nicht für Live-Spiel
- Wenn du eine Szene willst, die von Turn zu Turn konsistent bleibt, probier es aus.
- Wenn es Änderungen an der ganzen Szene folgen soll, etwa Wetter oder einer plötzlichen Aktion, teste zuerst deine eigenen Prompts. Unsere sind größtenteils gescheitert.
- Wenn du Echtzeit brauchst, such woanders. Fünf Sekunden Video brauchen auf einer 4090 anderthalb Minuten.
- Wenn deine Karte keine Ada-Karte mit 24 GB ist, rechne damit, das Rezept umbauen zu müssen. Plane auch den Hauptspeicher ein, und mehr davon für längere Welten.
Um dieselbe Fuchswelt mit drei Turns auf deiner eigenen Karte zu spielen, führe das SDK-Beispiel zum Hy-Nomas-Weltmodell aus. Es braucht ein InferenceKey-Projekt mit einem SDK-Token und einem API-Key. Außerdem braucht es eine private NVIDIA-Maschine mit einer Ada-Karte mit 24 GB wie einer RTX 4090, 64 GB oder mehr Hauptspeicher und etwa 60 GB Platte. Die Schritte stehen im Anhang.
Für Ingenieure
Credits
- Hy-Nomas: Tencent Hunyuan, Paper von 39 Autoren, arXiv 2610.36729. Sie haben das Modell trainiert und das Single-GPU-Low-Memory-Preset, die INT8- und FP8-Gewichte und den residenten Generierungsdienst geschrieben, den unser Backend umhüllt, alles unter Apache-2.0.
- Diffusers-Konvertierung: von Tencent als Hy-Nomas-Diffusers veröffentlicht; sie hängt von einem Diffusers-Fork von jiaxiangc ab (
github.com/jiaxiangc/diffusers@hy-nomas). - Text-Encoder: der Sprachteil von Qwen2.5-VL-7B-Instruct, vom Qwen-Team (Apache-2.0).
- Decoder: von Tencent aus PixelUMM (Wei et al., 2026) feinjustiert, zitiert im Tech Report 6.2.
- FP8-Decoder-Kernel: auf NVIDIAs CUTLASS gebaut (Ada-Blockwise-GEMM-Beispiel).
- Clips im Demovideo: das Promo-Material der Autoren, auf dem Bildschirm genannt als "Source: Tencent Hunyuan, Hy-Nomas project page (promo video)".
- Wo es uns aufgefallen ist: das News-Video von AI Search vom 2026-10-25, Hy-Nomas-Abschnitt von 9:27 bis 11:14.
- Unser Teil: das eigene Backend um den Dienst der Autoren, das Deployment über die Plattform, die Prompts, die Messungen, die VRAM-Stufen, das SDK-Beispiel und das Demovideo.
Modell und Dateien
tencent/Hy-Nomas, Apache-2.0, nicht gated, zuletzt geändert 2026-10-28. Code:Tencent-Hunyuan/Hy-Nomasmaineffb8a49b83e6f1d35e26710db35194f2fd952a7(2026-10-30). Die API von GitHub zeigt die Lizenz als "Other/NOASSERTION", weil die LICENSE-Datei Apache-2.0 mit einer Liste von Fremdkomponenten umgibt.- Architektur (Model Card): dichtes MMDiT, 54 Double-Stream-Blöcke, 0 Single-Stream, Hidden 2048, 16 Heads x 128, FFN 8192, 3D RoPE, Flow-Velocity-Vorhersage mit Euler-ODE-Sampling. Das arXiv-Abstract nennt es ein "8B diffusion backbone". Text-Encoder: Sprachmodell von Qwen2.5-VL-7B (3584 Dimensionen, zweilagiger Token-Refiner). Latents: DCAE-V f32t4c32. Decoder: feinjustiertes PixelUMM, 36 Layer, Hidden 4096, ein Dekodierschritt. Die destillierte Konfiguration nutzt 8 Denoising-Schritte.
- Dateigrößen (HF-API, dezimale GB):
DiT/distilled_int89,06,VAE/PixelUMM_FT_FP89,13,VAE/DCAE-V4,28,DiT/distilledFP32 34,21,DiT/base_arFP32 34,21,PixelUMM_FT31,55, Cinematic-LoRA 6,12, Robotics-LoRA 12,24,PE/55,58 (18 Shards). Ganzes Repo 196,4 GB (182,9 GiB). Qwen2.5-VL-7B-Instruct: 16,6 GB, eigenes Repo. - Das Preset liest INT8-DiT + FP8-PixelUMM + Qwen2.5-VL-7B, etwa 34,8 GB dezimal (etwa 32,4 GiB). DCAE-V wird nicht gelesen, wenn PixelUMM der Decoder ist (
pipeline/base.py); zählt man es trotzdem mit, sind es etwa 39,1 GB. Das Log unseres Backends zeigt 33 GB, heruntergeladen in etwa 20 s (06:48:23 bis 06:48:43 UTC). tencent/Hy-Nomas-Diffusers: BF16 (nicht quantisiert, nicht die FP32-Originale), 45,2 GB,HyNomasModularPipeline, brauchtgithub.com/jiaxiangc/diffusers@hy-nomas. Sein Beispiel nutzt 4 Schritte bei 704x1280 und kein PE. Die Card sagt, die INT8/FP8-Konfiguration für die RTX 4090 sei ein separates natives Deployment. Hier nicht verwendet.- Code-Pins: Python >= 3.12,
torch==2.10.0+cu130,transformers==4.57.1,diffusers==0.36.0,nvidia-cutlass-dsl[cu13]==4.8.0, flash-attn undflash-attn-3==3.0.0.
Das Single-GPU-Preset
configs/experiment/single_gpu_low_mem_inference.yaml setzt seg_ar_attention_backend: flex ("for SM89 or below"), vae.cutlass_fp8: true, vae.cpu_offload: true, text_encoder_cpu_offload: true, dit_cpu_offload: true, dit_weight_quantization: int8, kv_cache_quantization: int8, Sliding Window past_frames: 18 (Latent-Frames; ein Segment mit 120 Frames sind 30 Latent-Frames, also sind 18 etwa 3 s Video), Sparse Attention triton_bf16, torch_compile: true, sp_size: 1. Gewichte und KV werden in INT8 gespeichert und in BF16 gerechnet. Der Tech Report (6.2) fügt Sparse Attention hinzu: dicht für die ersten zwei Schritte, dann 25 % der Kandidaten-Videoblöcke. Die Standardkonfiguration nutzt sp_size=8 und verteiltes PixelUMM-Dekodieren, ihr Standardstart braucht also acht GPUs in einer Gruppe.
Der CUTLASS-FP8-Decoder-Kernel wird mit -gencode=arch=compute_89,code=sm_89 kompiliert und wirft "CUTLASS FP8 backend requires SM89" auf jeder anderen Capability. Er braucht CUTLASS_PATH, das auf einen CUTLASS-Checkout mit dem Ada-GemmBlockwise-Beispiel 94 zeigt (hymm/models/vae/pixelumm_decoder/cutlass_fp8.py). So wie es geschrieben ist, braucht das Preset eine Ada-GPU. Unsere Logs führen den langsameren ersten Aufruf in einem frischen Prozess auf Kernel-Kompilierung und Caches zurück; ein solcher Aufruf (84,9 s) war nicht langsamer als die warmen Turns.
Setup
- Eine RTX 4090 24 GB (23,52 GiB laut PyTorch) in unserer Cloud (InferenceKey Cloud), Treiber 595.91.07 (CUDA 13.2), AMD EPYC 7513, 503 GB Host-RAM, 100 GB Platte. Maschine mit mindestens 64 GB RAM angefordert.
- Ein lokaler InferenceKey-Manager hat den Worker gebootstrapt. Die Produktion war nicht beteiligt.
- Eigenes Python-Backend
hy-nomas-world0.1.2:apps/seg_ar_web_server.GenerationService(rank=0, world_size=1, rollout_type="seg_ar")mit+experiment=single_gpu_low_mem_inference,preserve_kv_cache=Truezwischen den Anfragen, eine residente Welt. setup()holt das Quell-Tarball am gepinnten Commit und die Header von CUTLASS v4.8.1, führtsnapshot_downloadnur für die Dateien des Presets und Qwen2.5-VL-7B aus, legt dasbin/des venv und/usr/local/cuda/binauf denPATHund setztCUTLASS_PATH.- Steuer-Prompts: ein Seed pro Welt, 42 für die Fuchswelt und 7 für die Wärterwelt; die Schnee-Wiederholung reproduzierte Segment 1 Byte für Byte. Keine anderen Seeds probiert.
Schritt für Schritt mit dem SDK-Beispiel
- Klone inferencekey-sdk und öffne
examples/hy-nomas-world-model-custom-backend-private-nvidia/(Commit403c619b). Dateien:backend.py,publish.py,main.py,requirements.txt,README.md,.env.example. cp .env.example .envund setzeINFERENCEKEY_SDK_TOKEN(ik_sdk_),INFERENCEKEY_API_KEY(ik_live_),INFERENCEKEY_PROJECTundIK_WORKER_ID. Optional:INFERENCEKEY_TENANT_IDundINFERENCEKEY_USER_TOKEN, damitpublish.pydas Backend hochlädt undmain.pydie Chat-Route einschaltet (sonst beides im Dashboard erledigen).pip install requestsplus der lokale SDK-Build.python publish.pyeinmal: packtbackend.pyund lädt es hoch.python main.py:ensure()eines festen Workloads (ready_timeout_secs3600,request_timeout_secs600), Chat-Route einschalten,wait_until_ready(), drei Turns der Fuchswelt,outputs/segment-1.mp4bissegment-3.mp4, dannworld.mp4, bei dir mit ffmpeg zusammengefügt.IK_KEEP_ALIVE=1behält den Workload.
Anforderungen an den Worker: Ada (SM89) mit 24 GB, Treiber für CUDA 13.0+ (580+), nvcc unter /usr/local/cuda/bin (der FP8-Kernel wird beim ersten Gebrauch gebaut), 64 GB+ Host-RAM, etwa 60 GB Platte.
Ein Turn geht als JSON in der letzten User-Nachricht von /v1/chat/completions:
{"step": "start", "style": "Cinematic fantasy", "perspective": "Third-person view",
 "subjects": [{"subject_id": "fox", "display_name": "a small orange fox",
               "subject_attribute": "Orange fur, white chest, and a fluffy tail."}],
 "scene": "A small orange fox stands on a stone path in a luminous forest.",
 "action": "The fox walks slowly along the path.", "seed": 42}
{"step": "continue", "session_id": "w50f42932fa5e",
 "change": "Glowing blue flowers open beside the path as the fox continues forward.",
 "action": "The fox passes the flowers and looks around."}
Die Antwort enthält session_id, segment, video_b64 (das MP4 dieses Segments, 1,1 bis 2,2 MB in unseren Läufen), width, height, frames und timings (gpu_s, peak_vram_mib). Stellschrauben in der Env des Workloads: NOMAS_VRAM_LIMIT_GIB, NOMAS_HEIGHT, NOMAS_WIDTH, NOMAS_EXTRA_OVERRIDES (Hydra-Overrides, zum Beispiel inference.infer_steps_video=6).
Zeiten
| Messung | Wert |
|---|---|
setup() mit Gewichten auf der Platte | 18,0 bis 19,0 s (Laden der Pipeline 12,1 bis 13,1 s) |
ensure() bis bereit, venv und Gewichte im Cache | 31,1 s (Lauf 2), 19,2 s (Lauf 3), 19,5 s (Redeploy) |
| uv-venv, kalt | 42 s |
| Download der Gewichte | 33 GB in etwa 20 s |
| Erstes Segment in einem frischen Prozess | 84,9 bis 138,1 s |
| Jedes weitere Segment | 88,2 bis 96,1 s (88,2 bis 93,7 s über die Plattform; 96,1 s im Harness) |
| Denoise / Schreiben des KV-Cache | 30,8 bis 38,7 s / 7,9 bis 10,1 s |
| PixelUMM-Decode + MP4-Encode | etwa 30 bis 45 s (MP4-Encode 2,5 bis 3,4 s) |
Eine vollständig kalte Zeit bis bereit, Ende zu Ende über den Worker (frische Maschine, keine Caches), wurde nicht gemessen.
Pro Segment, Hauptlauf über die Plattform
1280x704, 120 Frames, 24 fps, 8 Schritte, Seed 42. Die Segment-MP4s haben 5,000 s, nur Video; world.mp4 hat 360 Frames, 15,000 s.
| Turn | Anweisung | GPU s | Round Trip s | PyTorch-Spitze MiB | Befolgt? |
|---|---|---|---|---|---|
| 1 start | kleiner orangefarbener Fuchs auf einem Steinpfad in einem leuchtenden Wald, blaue Glühwürmchen | 88,36 | 89,3 | 17.774 | Fuchs, Pfad, Wald ja; Leuchten und Glühwürmchen nein |
| 2 continue | leuchtende blaue Blumen öffnen sich neben dem Pfad; Fuchs schaut sich um | 93,05 | 93,6 | 18.056 | Blumen ja, leuchten nicht |
| 3 continue | Schnee fällt, der Boden wird weiß; Fuchs bleibt stehen und schaut nach oben | 88,21 | 88,5 | 18.336 | nein: sonnig, Fuchs läuft weiter |
Andere Läufe: Harness 84,9 / 96,1 s; Plattform-Lauf 2 138,1 s (erster Aufruf in einem frischen Prozess) / 93,7 s; Wärterwelt 87,4 / 90,5 s (Sturm nicht befolgt); Schnee-Wiederholung 85,6 / 91,3 s. Kartenspitze 18.952 MiB (nvidia-smi, Harness, zwei Turns).
Steuerungsbilanz: vier Anweisungen für Szenenwechsel (blaue Blumen, Schnee, Schnee-Wiederholung mit deutlicheren Worten, Sturm), eine befolgt. Dazu zwei Aktionen ("stop and look up", "raise the lantern"), keine befolgt.
GiB sind binär, etwas größer als die GB auf der Verpackung, deshalb zeigt eine 24-GB-Karte 23,5 GiB: 18.336 MiB sind 17,9 GiB; 18.952 MiB sind 18,5 GiB.
Determinismus per md5: Segment 1 (418955576ca2...) identisch über Harness, 20-GiB-Stufe, Schnee-Wiederholung, Plattform-Läufe 2 und 3; Segment 2 (0f87561f...) identisch über Harness, 20-GiB-Stufe, Plattform-Läufe 2 und 3.
System-RAM
CPU-KV-Archiv laut Backend-Logs: cpu_archive_gib=5.881 nach 1 Segment, 11,763 nach 2, 17,644 nach 3 (total_frames 30/60/90, 18 Latent-Frames auf der GPU behalten). Linear, etwa 5,88 GiB pro Segment. Keine Welt ging über 3 Segmente hinaus. Der RSS des Prozesses wurde nicht gemessen. Die 64 GB im Beispiel sind eine Wahl bei der Bereitstellung, kein gemessenes Minimum.
VRAM-Stufen
Grenzen auf derselben 4090 mit torch.cuda.set_per_process_memory_fraction emuliert (NOMAS_VRAM_LIMIT_GIB).
| GPU oder Grenze | Konfiguration | VRAM-Spitze | Zeit pro Segment | Ausgabe OK | Echt oder emuliert |
|---|---|---|---|---|---|
| RTX 4090 24 GB | Preset, 1280x704, 8 Schritte, über die Plattform | 18.336 MiB PyTorch; Karte 18.952 MiB | 88 bis 94 s (96,1 s im Harness) | ja | echt |
| Grenze 20 GiB | gleich, start + continue | 18.056 MiB | 137,6 s erstes / 90,5 s | ja, byte-identische MP4s | emuliert |
| Grenze 16 GiB | gleich | nein: torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 26.00 MiB ... 15.98 GiB is allocated by PyTorch ... 16.00 GiB allowed in _encode_prompt (bf16-Qwen2.5-VL-7B auf die GPU verschoben) | emuliert |
Nicht probiert: eine Grenze von 18 GiB, eine echte Ada-Karte mit 20 GB (RTX 4000 Ada), ein fp8- oder CPU-Text-Encoder, niedrigere Auflösung, weniger Schritte, Nicht-Ada-Karten (RTX 5090 sm_120, A40 sm_86, H100) und andere Ada-Karten. Die 20-GiB-Grenze deckte zwei Segmente ab. Die Spitze von 20,53 GiB im Tech Report gilt für längere Segmente (100 s in sieben Segmenten); der Report knüpft die Speicherspitze an die Segmentlänge, weil die GPU-Historie durch das Sliding Window begrenzt ist. Viele 5-s-Turns auf einer echten 20-GB-Karte sind nicht getestet.
Probleme und Status
- OOM mit den Decode-Flags des Online-Workers.
inference.seg_ar_segment_vae_decode=true+model.vae.stable_prefix_streaming=true(gesetzt vonrun_seg_ar_gpu_worker.sh) dekodieren, während das DiT resident ist:torch.OutOfMemoryError ... Tried to allocate 826.00 MiB ... 22.50 GiB is allocated by PyTorch. Beide Flags entfernt; das Dekodieren läuft nach dem Denoising. Im Beispiel umgangen, upstream nicht gemeldet. - torchvision passt nicht. timm zog torchvision 0.25.0 von PyPI (CUDA 12) neben torch cu130:
operator torchvision::nms does not exist. Behoben durch Pinnen des cu130-Wheels. Ninja is required to load C++ extensionsbeim JIT des FP8-Kernels: Dasbin/des venv liegt nicht auf demPATH. Im Backend behoben.- Nachrichtengrenze von 8 MB. Eine Antwort mit dem Segment plus dem MP4 der ganzen Welt wurde auf dem Worker fertig, kam aber nie beim Client an (NATS
max_payload8.388.608). Das Weltvideo wurde aus der Antwort entfernt; der Client fügt die Segmente zusammen. Längere Ausgaben brauchen Object Storage, kein Inline-Base64. Offen in der Plattform. - Kein eigener Backend-Typ
text2video. Der Packager lehnttask_type 'text2video'ab, und die Modalität des Workloads muss zum Backend passen. Das Beispiel nutzt für beidestext2imageund liefert MP4 auf der Chat-Route. Offen in der Plattform. - Seed pro Welt. Ein continue-Turn ohne Seed bekam
400 {"error": "interactive continuation changed seed: existing=7, requested=42"}. Behoben in Backend 0.1.2, das den Seed vom Start behält. - Synchrone Grenze von 300 s (
DEFAULT_TIMEOUT_MSdes Managers) erzwingt ein Segment pro Aufruf: Ein Segment mit 90 s passt, ein Render mit mehreren Segmenten in einem Aufruf nicht. Asynchrone Jobs liefern nur per Webhook. Offen in der Plattform. - Schwache Steuerung in unseren Läufen: Änderungen an der ganzen Szene und Aktionen nicht befolgt, Start-Prompts teilweise fehlend. Nicht getestet, ob Nomas-PE das behebt.
- Kamerapfade nicht getestet ("no camera_trajectory was provided"), und keine Welt ging über 3 Segmente hinaus.
Demovideo
Korrektur zum Video: Sein Speicher-Insert nennt "18.3 GiB" als Spitze. Es liest 18.336 MiB als Tausender; die richtigen Werte sind 17,9 GiB PyTorch-Spitze und 18,5 GiB Kartenspitze.
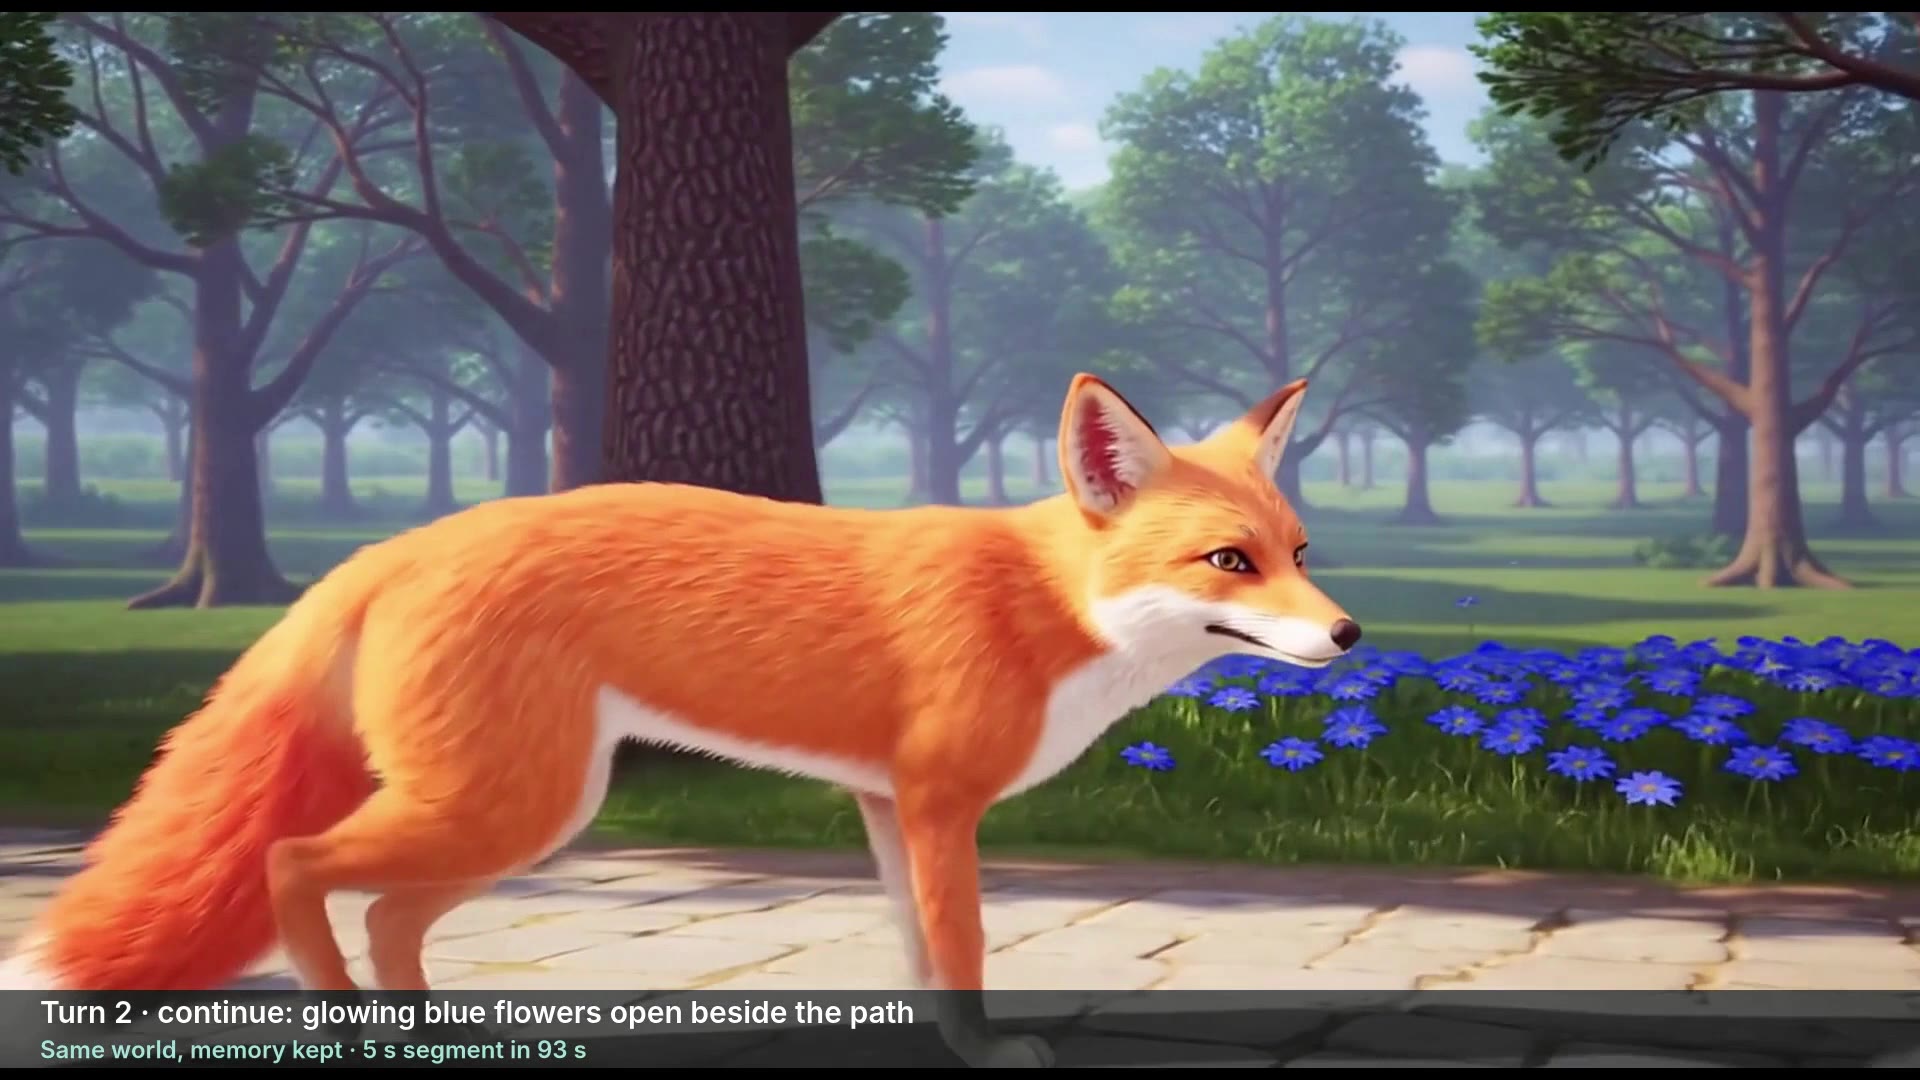
176 s, 1920x1080, englische Untertitel. Es enthält die Promo-Clips der Autoren, auf dem Bildschirm genannt, und ihre Benchmark-Werte, als nicht von uns nachgemessen markiert, dann unsere Fuchs- und Wärterwelt über den Endpoint.
Benchmark der Autoren (nicht nachgemessen)
Hy-Nomas-Bench: 280 Fälle in vier Benchmarks, paarweise menschliche Stimmen. Bench-1, Text über mehrere Turns: Gewinnrate beim Befolgen der Prompts 65,0 % gegen Happy Oyster (Directing) und 75,0 % gegen LingBot-World v2; physikalische Plausibilität 45,0 % und 68,3 %. Räumliches Gedächtnis vergleichbar mit Happy Oyster, hinter Genie 3.
Quellen
- Model Card: https://huggingface.co/tencent/Hy-Nomas
- Code: https://github.com/Tencent-Hunyuan/Hy-Nomas
- Paper: https://arxiv.org/abs/2610.36729
- Diffusers-Version: https://huggingface.co/tencent/Hy-Nomas-Diffusers
- Text-Encoder: https://huggingface.co/Qwen/Qwen2.5-VL-7B-Instruct
- SDK-Beispiel: https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/hy-nomas-world-model-custom-backend-private-nvidia
- Wo es uns aufgefallen ist: https://www.youtube.com/watch?v=EfyQOAJjx1A