Hy-Nomas en una RTX 4090: un mundo en vídeo que recuerda, unos 90 segundos por cada turno de 5 segundos
El modelo de mundo en vídeo abierto de Tencent en una RTX 4090 de 24 GB: 88 a 94 s por tramo de 5 s, pico de 18,5 GiB y 1 de 4 cambios de escena.
La mayoría de los modelos de vídeo abiertos te dan un clip y se olvidan de él. Hy-Nomas, un modelo abierto de Tencent Hunyuan, guarda el mundo en memoria, así que cada instrucción nueva añade cinco segundos más a la misma escena. La pregunta para quien tiene su propio hardware es si la receta de Tencent para una sola tarjeta funciona lejos de sus ocho GPU de casa. En una RTX 4090 de 24 GB en nuestra nube, funcionó, a un minuto y medio más o menos por cada trozo de 5 segundos. El zorro, el camino de piedra y la luz se mantuvieron de una llamada a otra. Uno de cada cuatro cambios de escena salió: flores nuevas sí, nieve y tormenta no. Así que una tarjeta gaming alquilada sirve para prototipar escenas que se mantienen coherentes turno a turno, no para mover un juego en directo. El mundo del zorro en tres turnos está empaquetado como ejemplo del SDK para que lo reproduzcas en tu propia tarjeta.
| Lo que quieres saber | Lo que medimos |
|---|---|
| Tiempo por cada 5 s de vídeo | de 88 a 94 s en una RTX 4090 |
| Memoria de GPU | pico de 18,5 GiB, unas cuatro quintas partes de la tarjeta |
| El montaje más pequeño que funcionó | una RTX 4090 de 24 GB, y la misma tarjeta limitada a 20 GiB durante dos turnos |
| ¿Se mantiene el mundo? | sí, durante 3 turnos (15 s de vídeo) |
| ¿Sigue los cambios? | 1 de 4 cambios de escena (un objeto nuevo sí, el tiempo no), acciones ignoradas |
| Lo que descargas | unos 35 GB de un repositorio de 196 GB |
Un modelo que toma notas del mundo que ya dibujó
Hy-Nomas hace vídeo por turnos, y cada turno parte de lo anterior. Un modelo de vídeo normal es un pintor que recibe un encargo, pinta y se va. Hy-Nomas es un pintor que lleva un cuaderno. Cada vez que termina cinco segundos, apunta cómo es la escena. Cuando le mandas la siguiente instrucción, primero lee el cuaderno. Por eso el zorro del turno tres es el mismo zorro del turno uno.
Los autores lo llaman modelo de mundo en vídeo: lo guías turno a turno, cada tramo de 5 segundos con una instrucción de texto nueva o una trayectoria de cámara. La versión rápida hace vídeo 720p a 24 fotogramas por segundo, según la ficha del modelo. El paper, "Hy-Nomas: Towards Free-form Interactive World Generation", se publicó el 27 de octubre con 39 autores. Lee tus instrucciones con un modelo abierto prestado, Qwen2.5-VL-7B.
Los pesos y el código son Apache-2.0: uso comercial libre, sin formulario que rellenar. El repositorio de código incluye algunas piezas de terceros con sus propias licencias.
La descarga asusta más de lo que es. El repositorio completo de Hugging Face pesa 196 GB, porque trae los originales a tamaño completo, dos adaptadores añadidos (estética cinematográfica, robótica) y un reescritor de prompts grande. El montaje de una tarjeta solo necesita tres piezas, dos de ellas comprimidas: el modelo de vídeo, el decodificador que lo convierte en fotogramas y el lector de texto. Son unos 35 GB, y nuestra máquina los bajó en unos 20 segundos.
Los autores lo ejecutan en ocho GPU, y publican una segunda receta para una
El arranque por defecto de la ficha del modelo reparte un vídeo entre ocho GPU que trabajan en grupo. Al lado, los autores publican una receta para una sola RTX 4090. Guarda las piezas grandes en forma comprimida y las mantiene en la memoria principal del ordenador. Cada pieza pasa a la GPU solo para su propia etapa: el lector de texto, luego el modelo de vídeo, luego el decodificador que convierte el resultado en fotogramas. Solo los últimos segundos del cuaderno se quedan en la GPU. Las páginas más antiguas pasan a la memoria principal.
La ficha del modelo es honesta con el precio que se paga. Avisa de que la memoria principal tiene que alojar los modelos aparcados y el archivo que va creciendo, y de que los movimientos entre memoria y GPU añaden tiempo. El paper no da ninguna velocidad para la 4090. Esa era la pregunta que traíamos: ¿funciona la receta de una tarjeta fuera del montaje de Tencent, y cómo de lenta es?
La ficha añade que lo de una sola GPU vale para el vídeo, no para el reescritor de prompts que pule cada instrucción. Su demo reescribe cada instrucción con Nomas-PE, un modelo mucho más grande cuyo lanzador usa por defecto una máquina entera de 8 GPU.
Nuestra prueba: una RTX 4090, la receta de los autores, tres turnos por mundo
Primero los límites. Montamos dos mundos cortos, el más largo de tres turnos, es decir, 15 segundos de vídeo. Escribimos los prompts a mano, sin el reescritor de los autores, y usamos un número aleatorio fijo (una semilla) por mundo. No probamos trayectorias de cámara. Esto comprueba si la receta funciona y mantiene una escena, no hasta dónde puede llegar un mundo.
Usamos la receta de una tarjeta de los autores sin cambios, en una RTX 4090 de nuestra nube. Todas las peticiones pasaron por la API de nuestra plataforma, igual que llamaría una aplicación. La tarjeta estaba en nuestra nube. El software de nuestra plataforma corría en un servidor nuestro, así que el servicio alojado en sí no se ha probado aquí.
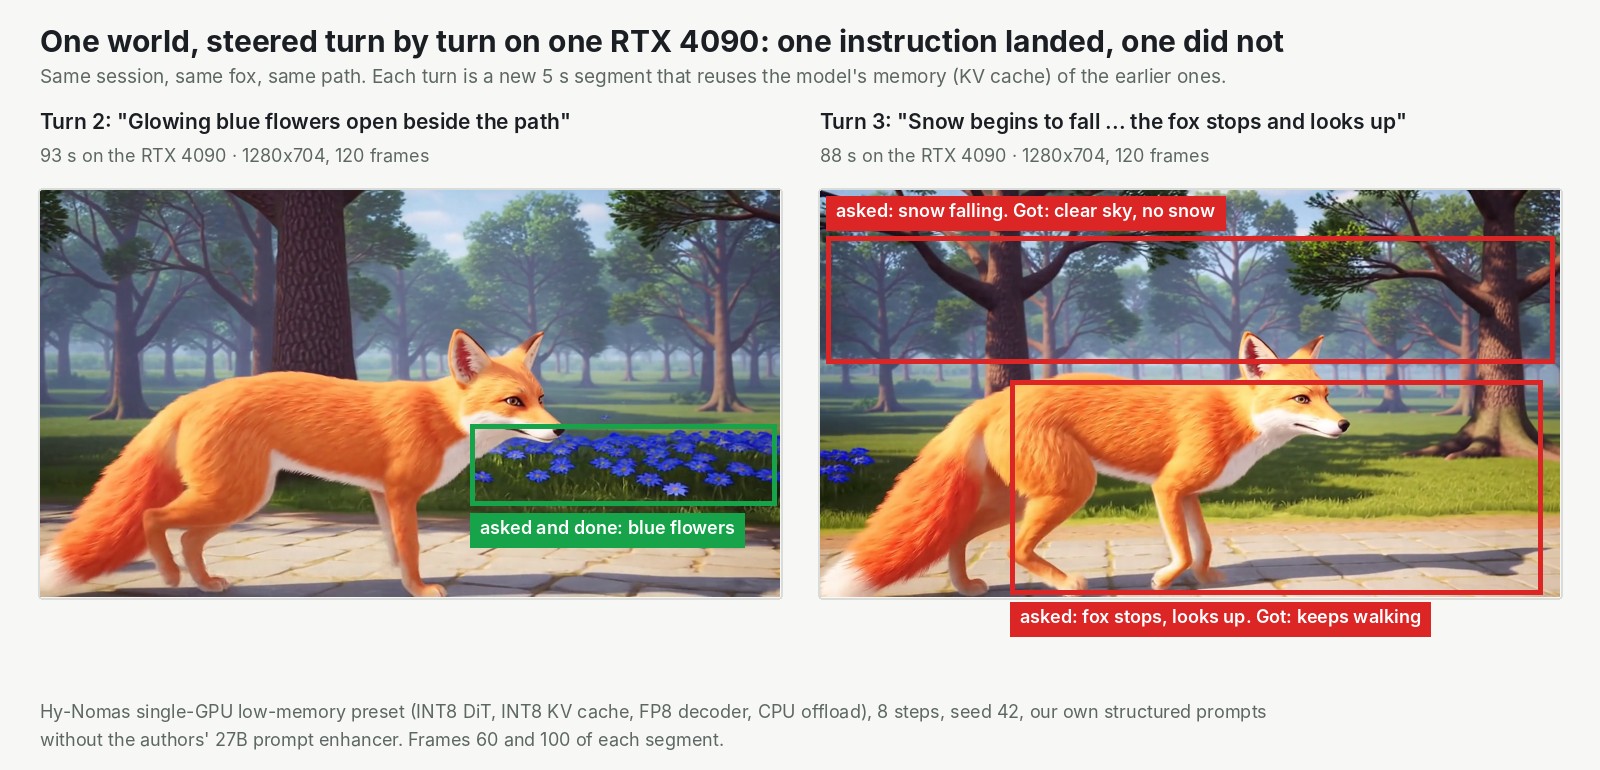
El primer mundo es el ejemplo de los propios autores: un zorro naranja pequeño que camina por un camino de piedra en un bosque. En el turno dos pedimos que se abrieran flores azules junto al camino. En el turno tres pedimos nieve, y que el zorro se parara a mirar arriba. Un segundo mundo, un farero con un farol, probó una tormenta.
Unos 90 segundos por tramo de 5 segundos, y el mundo se mantuvo
En una RTX 4090, cada tramo de 5 segundos tardó de 88 a 94 segundos con el programa ya en caliente. Eso es unas 18 veces más lento que el tiempo real. Si ese ritmo se mantiene, un mundo de un minuto son doce turnos y unos 18 minutos de trabajo de GPU. La primera llamada tras un arranque en limpio tardó hasta 138 segundos.
| Mundo del zorro, una RTX 4090 | Tiempo de GPU | Pico de memoria de GPU |
|---|---|---|
| Turno 1: el zorro recorre el camino | 88,4 s | 17,4 GiB |
| Turno 2: se abren flores azules | 93,1 s | 17,6 GiB |
| Turno 3: nieve, el zorro se para | 88,2 s | 17,9 GiB |
La memoria subió un poco en cada turno, por una razón que no encontramos. Contando todo lo que hay en la tarjeta, el pico fue de 18,5 GiB, unas cuatro quintas partes de la tarjeta de 24 GB. De cada 90 segundos, unos 35 se van en dibujar, unos 9 en escribir el cuaderno, y el resto en convertirlo en fotogramas y en un fichero MP4.
El mundo se mantuvo, y es lo que mejor funciona. El zorro conservó el pelaje, el tamaño y la forma de andar. El camino, los árboles y la luz no se movieron. En el mundo del farero, el impermeable, el farol y el faro se mantuvieron entre llamadas. Cada llamada es una petición aparte, separadas un minuto y medio, y aun así la escena parecía una sola toma.
También es repetible. Los mismos turnos con la misma semilla dieron ficheros de vídeo idénticos byte a byte en cuatro ejecuciones. Para un equipo, eso significa que un informe de fallo puede incluir las entradas exactas, y otra persona con el mismo montaje obtiene exactamente el mismo clip. Lo comprobamos solo en una máquina.
Salió uno de cada cuatro cambios de escena: un objeto nuevo sí, el tiempo y las acciones no
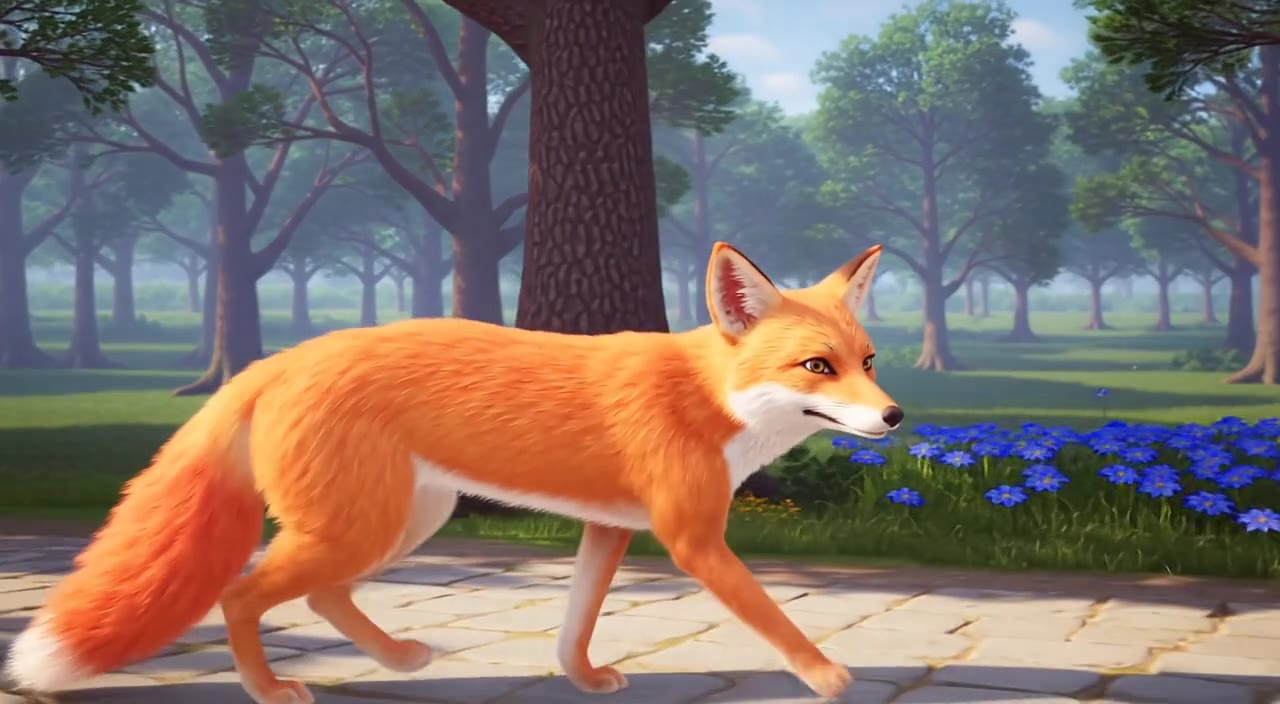
Hy-Nomas añadió el objeto que pedimos, en su momento. En el turno dos aparecieron flores azules junto al camino cuando pasaba el zorro. No brillaban, como decía el prompt, pero estaban ahí, en el sitio correcto.
Los cambios de la escena entera no aparecieron nunca. El turno tres pedía nieve, y el cielo siguió soleado. Lo repetimos con una redacción más contundente, y seguía sin nevar. En el mundo del farero, tampoco llegó una tormenta con lluvia y rayos. Eso deja uno de cuatro cambios de escena. Las acciones también fallaron: el zorro siguió andando en vez de pararse a mirar arriba, y el farero nunca levantó el farol. Incluso los prompts iniciales salieron solo en parte. El bosque no tenía luciérnagas ni brillo, solo luz de día y niebla.
Sonó como un grupo que mantiene el ritmo tres canciones seguidas y falla el cambio de tono que pidió el cantante. Un sospechoso es el reescritor que falta. La demo de los autores convierte cada instrucción corta en un prompt de generación estructurado antes de que el modelo lo vea. No hemos probado si Nomas-PE arregla la nieve y las tormentas, así que tómalo como una suposición. El paper añade su propia advertencia: los atajos de una tarjeta "may introduce subtle differences that become more noticeable over successive segments".
Qué GPU: una RTX 4090 real de 24 GB funcionó, y un límite de 20 GiB en ella también
Una tarjeta de 24 GB funciona, un límite de 20 GiB funciona y 16 GiB falla. La RTX 4090 fue la única tarjeta real que probamos. Para los tamaños más pequeños, le dijimos al software que usara menos de esa misma tarjeta.
- RTX 4090, 24 GB, tarjeta real: funciona (ver arriba).
- Limitada a 20 GiB en la misma tarjeta: funciona, sin perder velocidad (90,5 segundos en el segundo turno) y con vídeo idéntico byte a byte, durante dos turnos.
- Limitada a 16 GiB: falla antes de dibujar ningún vídeo. Se queda sin memoria al pasar el lector de texto a la GPU. Bajar la resolución no ayudaría, porque el fallo llega antes.
Dos advertencias cambian la lista de la compra. Primero, una parte de la receta solo funciona en la generación Ada de NVIDIA, la familia de la RTX 4090. Una RTX 5090 más nueva o una A40 más antigua deberían fallar, pero no las probamos. Segundo, la propia ejecución de una tarjeta de los autores llegó a un pico de 20,53 GiB, con tramos más largos que los nuestros. Así que una tarjeta real de 20 GB es una apuesta que no probamos.
La memoria principal también cuenta. Cada 5 segundos de mundo añaden unos 5,9 GiB de páginas viejas del cuaderno ahí. Nuestro ejemplo pide 64 GB, una elección nuestra, no un mínimo medido.
En InferenceKey: una llamada por turno, el mundo guardado entre llamadas
Un modelo interactivo necesita un servidor que guarde el mundo en memoria entre llamadas. Nuestra plataforma lo guardó con un pequeño programa a medida, que solo envuelve el servicio de generación y la receta de una tarjeta de los autores. Mantiene un mundo en la memoria de la GPU y en la principal entre llamadas, así que una tarjeta sirve un mundo, y a un usuario, cada vez. Cada llamada envía un turno y recibe un MP4 de cinco segundos. La siguiente llamada continúa el mismo mundo. Con los pesos ya en disco, el despliegue estuvo listo de 19 a 31 segundos después de la llamada de despliegue.
El único problema con el que te vas a encontrar si partes de los scripts de los propios autores es la memoria. Su script de demo en directo activa un modo que decodifica el vídeo mientras el modelo de vídeo sigue en la GPU. Con 24 GB, se queda sin memoria. Desactivamos ese modo, así que la decodificación empieza cuando termina el dibujo. Estado: resuelto con un rodeo en nuestro ejemplo (ese modo desactivado), todavía sin comunicar a los autores. Los demás problemas que encontramos, y sus arreglos, están en el apéndice.
¿Merece la pena usarlo? Sí para escenas que se mantienen coherentes en una tarjeta, todavía no para jugar en directo
- Si quieres una escena que se mantenga coherente de un turno a otro, pruébalo.
- Si necesitas que siga cambios de toda la escena, como el tiempo o una acción repentina, prueba antes tus propios prompts. Los nuestros fallaron casi siempre.
- Si necesitas tiempo real, busca otra cosa. Cinco segundos de vídeo tardan un minuto y medio en una 4090.
- Si tu tarjeta no es una Ada de 24 GB, cuenta con rehacer la receta. Planifica también la memoria principal, y más cuanto más largo sea el mundo.
Para jugar el mismo mundo del zorro en tres turnos en tu propia tarjeta, ejecuta el ejemplo del SDK del modelo de mundo Hy-Nomas. Necesita un proyecto de InferenceKey con un token del SDK y una API key. También necesita una máquina NVIDIA privada con una tarjeta Ada de 24 GB, como una RTX 4090, 64 GB o más de memoria principal y unos 60 GB de disco. Los pasos están en el apéndice.
Para ingenieros
Créditos
- Hy-Nomas: Tencent Hunyuan, paper de 39 autores, arXiv 2610.36729. Entrenaron el modelo y escribieron el preset de una GPU con poca memoria, los pesos INT8 y FP8 y el servicio de generación residente que envuelve nuestro backend, todo bajo Apache-2.0.
- Conversión a Diffusers: publicada por Tencent como Hy-Nomas-Diffusers; depende de un fork de Diffusers de jiaxiangc (
github.com/jiaxiangc/diffusers@hy-nomas). - Codificador de texto: la parte de lenguaje de Qwen2.5-VL-7B-Instruct, del equipo de Qwen (Apache-2.0).
- Decodificador: ajustado por Tencent a partir de PixelUMM (Wei et al., 2026), citado en el informe técnico 6.2.
- Kernel FP8 del decodificador: construido sobre CUTLASS de NVIDIA (ejemplo de GEMM blockwise para Ada).
- Clips de la demo: el material promocional de los autores, acreditado en pantalla como "Source: Tencent Hunyuan, Hy-Nomas project page (promo video)".
- Dónde lo vimos: el vídeo de noticias del 2026-10-25 de AI Search, capítulo de Hy-Nomas del 9:27 al 11:14.
- Nuestra parte: el backend a medida alrededor del servicio de los autores, el despliegue a través de la plataforma, los prompts, las mediciones, la escalera de VRAM, el ejemplo del SDK y el vídeo de la demo.
Modelo y ficheros
tencent/Hy-Nomas, Apache-2.0, sin acceso restringido, última modificación el 2026-10-28. Código:Tencent-Hunyuan/Hy-Nomasmaineffb8a49b83e6f1d35e26710db35194f2fd952a7(2026-10-30). La API de GitHub muestra la licencia como "Other/NOASSERTION" porque el fichero LICENSE envuelve Apache-2.0 con una lista de componentes de terceros.- Arquitectura (ficha del modelo): MMDiT denso, 54 bloques double-stream, 0 single-stream, hidden 2048, 16 heads x 128, FFN 8192, 3D RoPE, predicción de flow-velocity con muestreo por ODE de Euler. El abstract de arXiv lo llama "8B diffusion backbone". Codificador de texto: modelo de lenguaje de Qwen2.5-VL-7B (3584 dimensiones, token refiner de dos capas). Latentes: DCAE-V f32t4c32. Decodificador: PixelUMM ajustado, 36 capas, hidden 4096, un paso de decodificación. La config destilada usa 8 pasos de denoising.
- Tamaños de fichero (API de HF, GB decimales):
DiT/distilled_int89,06,VAE/PixelUMM_FT_FP89,13,VAE/DCAE-V4,28,DiT/distilledFP32 34,21,DiT/base_arFP32 34,21,PixelUMM_FT31,55, LoRA cinematográfica 6,12, LoRA de robótica 12,24,PE/55,58 (18 shards). Repo completo 196,4 GB (182,9 GiB). Qwen2.5-VL-7B-Instruct: 16,6 GB, repo aparte. - El preset lee DiT INT8 + PixelUMM FP8 + Qwen2.5-VL-7B, unos 34,8 GB decimales (unos 32,4 GiB). DCAE-V no se lee cuando PixelUMM es el decodificador (
pipeline/base.py); si se cuenta igualmente, salen unos 39,1 GB. El log de nuestro backend muestra 33 GB descargados en unos 20 s (de 06:48:23 a 06:48:43 UTC). tencent/Hy-Nomas-Diffusers: BF16 (sin cuantizar, no los originales FP32), 45,2 GB,HyNomasModularPipeline, necesitagithub.com/jiaxiangc/diffusers@hy-nomas. Su ejemplo usa 4 pasos a 704x1280 y sin PE. La ficha dice que la config INT8/FP8 para RTX 4090 es un despliegue nativo aparte. No se usó aquí.- Versiones fijadas en el código: Python >= 3.12,
torch==2.10.0+cu130,transformers==4.57.1,diffusers==0.36.0,nvidia-cutlass-dsl[cu13]==4.8.0, flash-attn yflash-attn-3==3.0.0.
El preset de una GPU
configs/experiment/single_gpu_low_mem_inference.yaml fija seg_ar_attention_backend: flex ("for SM89 or below"), vae.cutlass_fp8: true, vae.cpu_offload: true, text_encoder_cpu_offload: true, dit_cpu_offload: true, dit_weight_quantization: int8, kv_cache_quantization: int8, ventana deslizante past_frames: 18 (fotogramas latentes; un tramo de 120 fotogramas son 30 fotogramas latentes, así que 18 son unos 3 s de vídeo), atención dispersa triton_bf16, torch_compile: true, sp_size: 1. Los pesos y la KV se guardan en INT8 y se calculan en BF16. El informe técnico (6.2) añade atención dispersa: densa en los dos primeros pasos y luego el 25 % de los bloques de vídeo candidatos. La config estándar usa sp_size=8 y decodificación PixelUMM distribuida, así que su arranque por defecto necesita ocho GPU en un grupo.
El kernel FP8 de CUTLASS del decodificador se compila con -gencode=arch=compute_89,code=sm_89 y lanza "CUTLASS FP8 backend requires SM89" con cualquier otra capability. Necesita CUTLASS_PATH apuntando a un checkout de CUTLASS con el ejemplo 94 de GemmBlockwise para Ada (hymm/models/vae/pixelumm_decoder/cutlass_fp8.py). Tal como está escrito, el preset necesita una GPU Ada. Nuestros logs atribuyen la primera llamada más lenta en un proceso nuevo a la compilación de kernels y a las cachés; una de esas llamadas (84,9 s) no fue más lenta que los turnos en caliente.
Montaje
- Una RTX 4090 de 24 GB (23,52 GiB según PyTorch) en nuestra nube (InferenceKey Cloud), driver 595.91.07 (CUDA 13.2), AMD EPYC 7513, 503 GB de RAM del host, 100 GB de disco. Máquina pedida con al menos 64 GB de RAM.
- Un manager local de InferenceKey puso en marcha el worker. Producción no intervino.
- Backend de Python a medida
hy-nomas-world0.1.2:apps/seg_ar_web_server.GenerationService(rank=0, world_size=1, rollout_type="seg_ar")con+experiment=single_gpu_low_mem_inference,preserve_kv_cache=Trueentre peticiones, un mundo residente. setup()descarga el tarball del código en el commit fijado y las cabeceras de CUTLASS v4.8.1, ejecutasnapshot_downloadsolo para los ficheros del preset y Qwen2.5-VL-7B, pone elbin/del venv y/usr/local/cuda/binen elPATHy fijaCUTLASS_PATH.- Prompts de guiado: una semilla por mundo, 42 para el mundo del zorro y 7 para el del farero; la repetición de la nieve reprodujo el tramo 1 byte a byte. No probamos otras semillas.
Paso a paso con el ejemplo del SDK
- Clona inferencekey-sdk y abre
examples/hy-nomas-world-model-custom-backend-private-nvidia/(commit403c619b). Ficheros:backend.py,publish.py,main.py,requirements.txt,README.md,.env.example. cp .env.example .envy rellenaINFERENCEKEY_SDK_TOKEN(ik_sdk_),INFERENCEKEY_API_KEY(ik_live_),INFERENCEKEY_PROJECTeIK_WORKER_ID. Opcional:INFERENCEKEY_TENANT_IDeINFERENCEKEY_USER_TOKENpara quepublish.pysuba el backend ymain.pyactive la ruta de chat (si no, haz las dos cosas en el panel).pip install requestsmás la build local del SDK.python publish.pyuna vez: empaquetabackend.pyy lo sube.python main.py:ensure()de un workload fijo (ready_timeout_secs3600,request_timeout_secs600), activa la ruta de chat,wait_until_ready(), tres turnos del mundo del zorro, deoutputs/segment-1.mp4asegment-3.mp4, y luegoworld.mp4unido con ffmpeg en tu lado.IK_KEEP_ALIVE=1conserva el workload.
Requisitos del worker: Ada (SM89) con 24 GB, driver para CUDA 13.0+ (580+), nvcc en /usr/local/cuda/bin (el kernel FP8 se compila en el primer uso), 64 GB+ de RAM del host, unos 60 GB de disco.
Un turno va como JSON en el último mensaje de usuario de /v1/chat/completions:
{"step": "start", "style": "Cinematic fantasy", "perspective": "Third-person view",
 "subjects": [{"subject_id": "fox", "display_name": "a small orange fox",
               "subject_attribute": "Orange fur, white chest, and a fluffy tail."}],
 "scene": "A small orange fox stands on a stone path in a luminous forest.",
 "action": "The fox walks slowly along the path.", "seed": 42}
{"step": "continue", "session_id": "w50f42932fa5e",
 "change": "Glowing blue flowers open beside the path as the fox continues forward.",
 "action": "The fox passes the flowers and looks around."}
La respuesta lleva session_id, segment, video_b64 (el MP4 de este tramo, de 1,1 a 2,2 MB en nuestras ejecuciones), width, height, frames y timings (gpu_s, peak_vram_mib). Ajustes en el env del workload: NOMAS_VRAM_LIMIT_GIB, NOMAS_HEIGHT, NOMAS_WIDTH, NOMAS_EXTRA_OVERRIDES (overrides de Hydra, por ejemplo inference.infer_steps_video=6).
Tiempos
| Medición | Valor |
|---|---|
setup() con los pesos en disco | de 18,0 a 19,0 s (carga del pipeline de 12,1 a 13,1 s) |
De ensure() a listo, con venv y pesos en caché | 31,1 s (ejecución 2), 19,2 s (ejecución 3), 19,5 s (redespliegue) |
| venv de uv, en frío | 42 s |
| Descarga de pesos | 33 GB en unos 20 s |
| Primer tramo en un proceso nuevo | de 84,9 a 138,1 s |
| Cada tramo siguiente | de 88,2 a 96,1 s (de 88,2 a 93,7 s a través de la plataforma; 96,1 s en el harness) |
| Denoise / escritura de la caché KV | de 30,8 a 38,7 s / de 7,9 a 10,1 s |
| Decodificación PixelUMM + codificación MP4 | unos 30 a 45 s (codificación MP4 de 2,5 a 3,4 s) |
No medimos un tiempo hasta listo totalmente en frío de principio a fin a través del worker (máquina nueva, sin cachés).
Por tramo, ejecución principal a través de la plataforma
1280x704, 120 fotogramas, 24 fps, 8 pasos, semilla 42. Los MP4 de cada tramo duran 5,000 s, solo vídeo; world.mp4 son 360 fotogramas, 15,000 s.
| Turno | Instrucción | GPU s | Ida y vuelta s | Pico PyTorch MiB | ¿La siguió? |
|---|---|---|---|---|---|
| 1 start | zorro naranja pequeño en un camino de piedra en un bosque luminoso, luciérnagas azules | 88,36 | 89,3 | 17.774 | zorro, camino, bosque sí; brillo y luciérnagas no |
| 2 continue | se abren flores azules brillantes junto al camino; el zorro mira alrededor | 93,05 | 93,6 | 18.056 | flores sí, sin brillo |
| 3 continue | empieza a nevar, el suelo se vuelve blanco; el zorro se para y mira arriba | 88,21 | 88,5 | 18.336 | no: soleado, el zorro sigue andando |
Otras ejecuciones: harness 84,9 / 96,1 s; ejecución 2 de la plataforma 138,1 s (primera llamada en un proceso nuevo) / 93,7 s; mundo del farero 87,4 / 90,5 s (tormenta no seguida); repetición de la nieve 85,6 / 91,3 s. Pico de la tarjeta 18.952 MiB (nvidia-smi, harness, dos turnos).
Recuento de guiado: cuatro instrucciones de cambio de escena (flores azules, nieve, repetición de la nieve con redacción más contundente, tormenta), una seguida. Además de esas, dos acciones ("stop and look up", "raise the lantern"), ninguna seguida.
Los GiB son binarios, algo más grandes que los GB de la caja, así que una tarjeta de 24 GB muestra 23,5 GiB: 18.336 MiB son 17,9 GiB; 18.952 MiB son 18,5 GiB.
Determinismo por md5: el tramo 1 (418955576ca2...) idéntico en el harness, el escalón de 20 GiB, la repetición de la nieve y las ejecuciones 2 y 3 de la plataforma; el tramo 2 (0f87561f...) idéntico en el harness, el escalón de 20 GiB y las ejecuciones 2 y 3 de la plataforma.
RAM del sistema
Archivo KV en CPU según los logs del backend: cpu_archive_gib=5.881 tras 1 tramo, 11,763 tras 2, 17,644 tras 3 (total_frames 30/60/90, 18 fotogramas latentes guardados en la GPU). Lineal, unos 5,88 GiB por tramo. Ningún mundo pasó de 3 tramos. No medimos el RSS del proceso. Los 64 GB del ejemplo son una elección de aprovisionamiento, no un mínimo medido.
Escalera de VRAM
Límites emulados en la misma 4090 con torch.cuda.set_per_process_memory_fraction (NOMAS_VRAM_LIMIT_GIB).
| GPU o límite | Config | Pico de VRAM | Tiempo por tramo | Salida correcta | Real o emulado |
|---|---|---|---|---|---|
| RTX 4090 24 GB | preset, 1280x704, 8 pasos, a través de la plataforma | 18.336 MiB PyTorch; tarjeta 18.952 MiB | de 88 a 94 s (96,1 s en el harness) | sí | real |
| Límite de 20 GiB | igual, start + continue | 18.056 MiB | 137,6 s el primero / 90,5 s | sí, MP4 idénticos byte a byte | emulado |
| Límite de 16 GiB | igual | no: torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 26.00 MiB ... 15.98 GiB is allocated by PyTorch ... 16.00 GiB allowed en _encode_prompt (Qwen2.5-VL-7B en bf16 pasado a la GPU) | emulado |
Sin probar: un límite de 18 GiB, una tarjeta Ada real de 20 GB (RTX 4000 Ada), un codificador de texto en fp8 o en CPU, menos resolución, menos pasos, tarjetas que no son Ada (RTX 5090 sm_120, A40 sm_86, H100) y otras tarjetas Ada. El límite de 20 GiB cubrió dos tramos. El pico de 20,53 GiB del informe técnico es con tramos más largos (100 s en siete tramos); el informe relaciona el pico de memoria con la longitud del tramo, ya que la ventana deslizante acota el historial en GPU. Muchos turnos de 5 s en una tarjeta real de 20 GB están sin probar.
Problemas y estado
- OOM con los flags de decodificación del worker online.
inference.seg_ar_segment_vae_decode=true+model.vae.stable_prefix_streaming=true(los fijarun_seg_ar_gpu_worker.sh) decodifican con el DiT residente:torch.OutOfMemoryError ... Tried to allocate 826.00 MiB ... 22.50 GiB is allocated by PyTorch. Quitamos los dos flags; la decodificación va después del denoising. Resuelto con un rodeo en el ejemplo, sin comunicar aguas arriba. - torchvision que no cuadra. timm trajo torchvision 0.25.0 de PyPI (CUDA 12) junto a torch cu130:
operator torchvision::nms does not exist. Arreglado fijando la wheel cu130. Ninja is required to load C++ extensionsdurante la compilación JIT del kernel FP8: elbin/del venv no está en elPATH. Arreglado en el backend.- Límite de mensaje de 8 MB. Una respuesta con el tramo más el MP4 del mundo entero terminó en el worker pero nunca llegó al cliente (NATS
max_payload8.388.608). Quitamos el vídeo del mundo de la respuesta; el cliente une los tramos. Las salidas más largas necesitan almacenamiento de objetos, no base64 en línea. Abierto en la plataforma. - No hay tipo de backend a medida
text2video. El empaquetador rechazatask_type 'text2video', y la modalidad del workload tiene que coincidir con la del backend. El ejemplo usatext2imageen los dos y devuelve MP4 por la ruta de chat. Abierto en la plataforma. - Semilla por mundo. Un turno continue sin semilla recibió
400 {"error": "interactive continuation changed seed: existing=7, requested=42"}. Arreglado en el backend 0.1.2, que conserva la semilla del inicio. - Límite síncrono de 300 s (
DEFAULT_TIMEOUT_MSdel manager): obliga a un tramo por llamada; un tramo de 90 s entra, un render de varios tramos en una llamada no. Los jobs asíncronos entregan solo por webhook. Abierto en la plataforma. - Guiado débil en nuestras ejecuciones: cambios de toda la escena y acciones no seguidos, prompts iniciales en parte ausentes. Sin probar si Nomas-PE lo arregla.
- Trayectorias de cámara sin probar ("no camera_trajectory was provided"), y ningún mundo pasó de 3 tramos.
Vídeo de la demo
Corrección para el vídeo: su inserto de memoria dice "18.3 GiB" de pico. Lee 18.336 MiB como miles; las cifras correctas son 17,9 GiB de pico en PyTorch y 18,5 GiB de pico en la tarjeta.
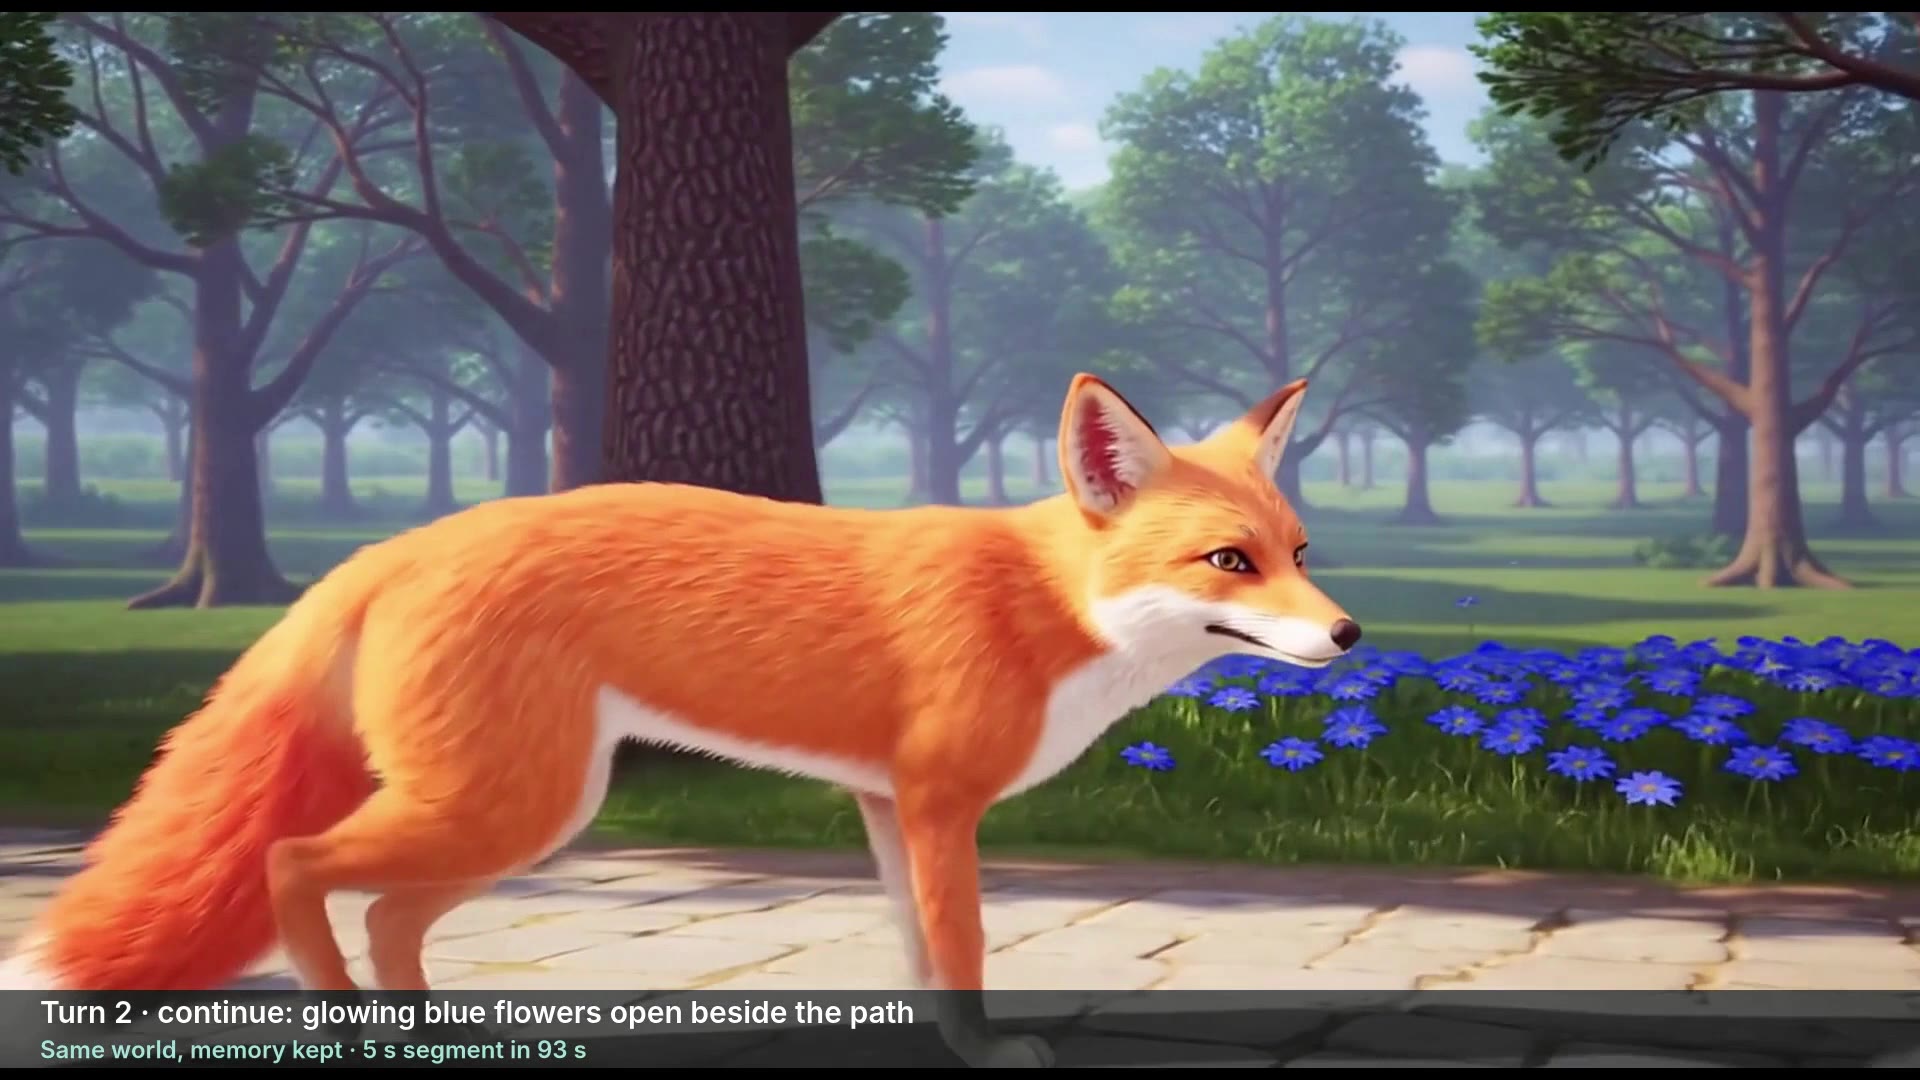
176 s, 1920x1080, subtítulos en inglés. Incluye los clips promocionales de los autores, acreditados en pantalla, y sus cifras de benchmark marcadas como no reproducidas por nosotros, y después nuestros mundos del zorro y del farero a través del endpoint.
Benchmark de los autores (no reproducido)
Hy-Nomas-Bench: 280 casos en cuatro benchmarks, votos humanos por pares. Bench-1, texto en varios turnos: tasa de victorias en seguimiento del prompt del 65,0 % frente a Happy Oyster (Directing) y del 75,0 % frente a LingBot-World v2; plausibilidad física del 45,0 % y del 68,3 %. Memoria espacial comparable a Happy Oyster, por detrás de Genie 3.
Fuentes
- Ficha del modelo: https://huggingface.co/tencent/Hy-Nomas
- Código: https://github.com/Tencent-Hunyuan/Hy-Nomas
- Paper: https://arxiv.org/abs/2610.36729
- Versión para Diffusers: https://huggingface.co/tencent/Hy-Nomas-Diffusers
- Codificador de texto: https://huggingface.co/Qwen/Qwen2.5-VL-7B-Instruct
- Ejemplo del SDK: https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/hy-nomas-world-model-custom-backend-private-nvidia
- Dónde lo vimos: https://www.youtube.com/watch?v=EfyQOAJjx1A