Groot-19B-A3B passt mit vollem 256K-Kontext auf eine RTX 5090 mit 32 GB, und eine Grenze von 24 GB reicht nicht
GrootTeams 19B-Agentenmodell in FP8 auf einer RTX 5090: volles Fenster mit 262.144 Tokens, 262 bis 304 Tokens/s, Prompt mit 205K Tokens richtig beantwortet.
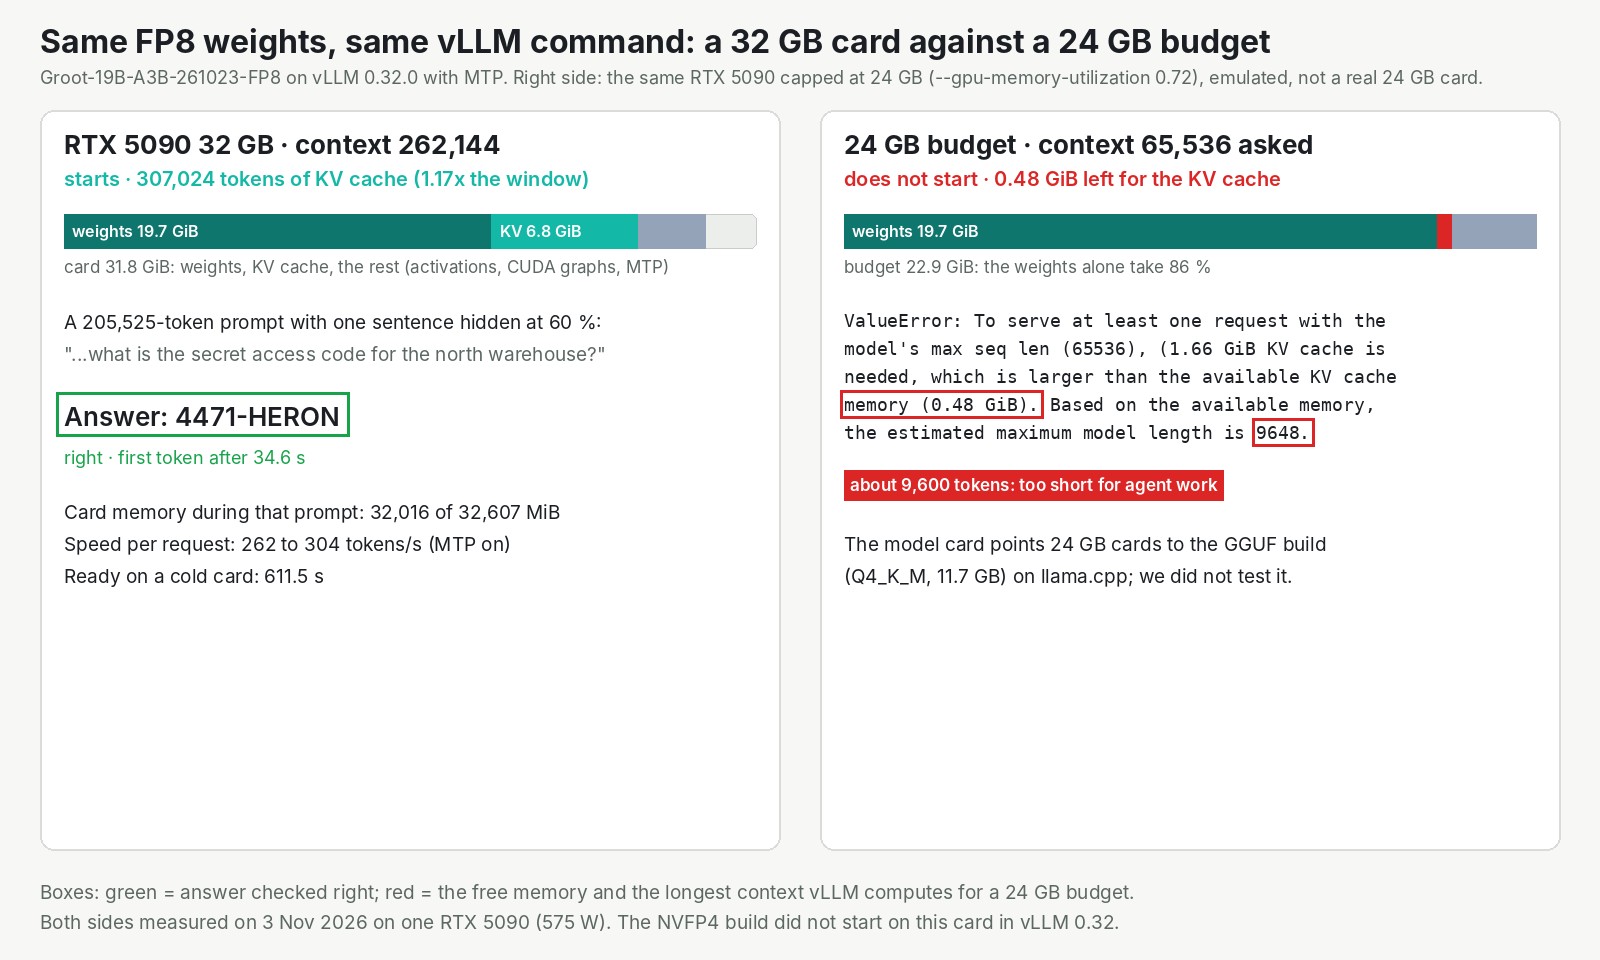
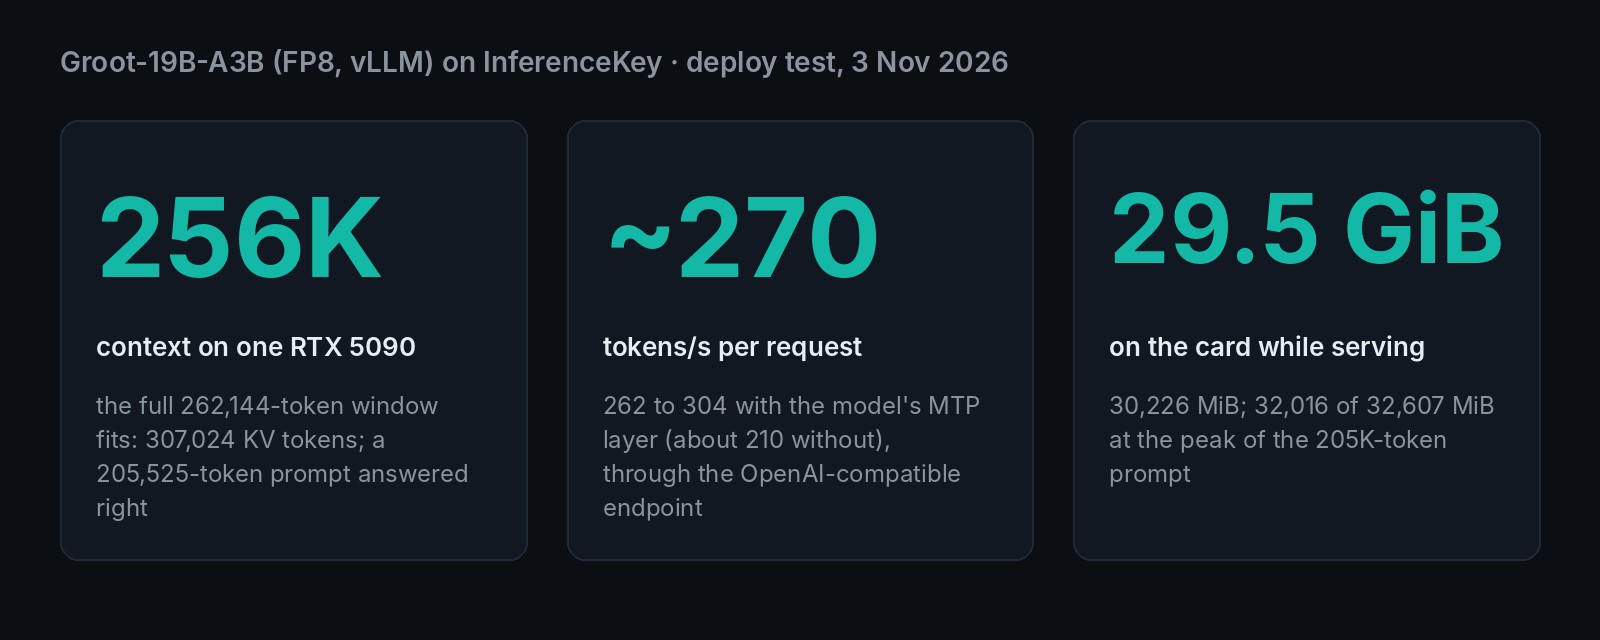
Die Autoren von Groot-19B-A3B sagen, dass sein voller 256K-Kontext auf eine einzige RTX 5090 mit 32 GB passt. Wir haben es in unserer Cloud geprüft, und es stimmt: Alle 262.144 Tokens (die „256K“) sind gestartet, und ein Prompt mit 205.525 Tokens kam richtig zurück. Mit einer Grenze von 24 GB ließ dieselbe Datei Platz für etwa 9.600 Tokens, zu wenig für Agentenarbeit. Plane für diesen Build also 32 GB ein. Wir haben den komprimierten Build mit 20,9 GB (FP8) verwendet, dazu vLLM, den Open-Source-Server, den unsere Plattform mitliefert, und die Einstellungen der Autoren. Für ein Team mit eigener Hardware ist das ein Fenster von 256K Tokens auf einer einzigen Karte der Gaming-Klasse.
| Was du wissen willst | Was wir gemessen haben |
|---|---|
| Kleinste GPU, auf der es lief | eine echte RTX 5090, 32 GB, volles Fenster mit 262.144 Tokens |
| Schreibtempo, eine Anfrage | 262 bis 304 Tokens/s, 170 bis 211 ohne seinen Beschleunigungs-Layer |
| Tool-Calls | gültiges JSON, zwei Aufrufe in einem Turn plus die Antwort in 1,8 s |
| 24 GB Speicher (auf derselben Karte simuliert) | startet nicht mit 64K Tokens, höchstens 9.600 |
Ein 19B-Modell, das seine Autoren vor sein eigenes 35B-Ausgangsmodell stellen
Groot-19B-A3B ist aus einem größeren Modell gebaut und für Agenten nachtrainiert. Seine Autoren berichten, dass es das Original schlägt. GrootTeam hat mit Qwen3.6-35B-A3B angefangen, dem offenen 35B-Modell des Qwen-Teams, und es auf 19B verkleinert. Wie, sagt die Seite der Autoren nicht. Nachtrainiert haben sie es mit einer kleinen Menge offener Daten, weniger als 0,1 Milliarden Tokens, laut der Modellseite. Veröffentlicht haben sie es am 23. Oktober in vier Builds, und uns ist es im News-Video von AI Search vom 1. November aufgefallen.
Es arbeitet wie ein großes Team, in dem sich nur wenige Spezialisten um jedes Wort kümmern. Etwa 3 Milliarden seiner 19 Milliarden Parameter arbeiten an jedem Wort. Es schreibt also schnell, aber die GPU muss alle 19 Milliarden halten.
In der Tabelle der Autoren schlägt es sowohl Qwen3.6-35B-A3B als auch Gemma-4-26B-A4B bei 12 von 16 Benchmarks. Zwei davon zählen für Agentenarbeit am meisten:
- Terminal-Bench 2.1, bei dem ein Agent in einer Kommandozeile arbeitet: 52,1 gegen 43,8 für Qwen3.6 und 26,5 für Gemma-4.
- NL2Repo, bei dem ein Agent aus einer Beschreibung ein ganzes Code-Repository baut: 35,7 gegen 28,8 und 16,6.
Die Autoren sagen außerdem, seine Antworten seien die kürzesten von 12 Modellen gewesen: 23,1 % kürzer als bei Qwen3.6, 65,6 % kürzer als bei Gemma-4. Ihre Seite bittet darum, das zusammen mit der Genauigkeit zu lesen, was fair ist. Verglichen wird es nur mit offenen Modellen seiner Größe, nicht mit den aktuellen geschlossenen Flaggschiffen.
Es liest auch Bilder: Gebeten, das Diagramm der Autoren abzulesen, nannte es etwa 42, gegen 41,44 auf ihrer Seite. Das Lizenz-Tag aller vier Repos lautet Apache-2.0, was kommerzielle Nutzung erlaubt, allerdings fehlt die LICENSE-Datei, auf die die Seite verlinkt. Neben der vollen Datei mit 38,9 GB gibt es komprimierte Builds mit 20,9 GB (den haben wir getestet), 13,5 GB und 11,7 GB.
„256K auf einer Karte“ ist ein Versprechen über Speicher, und Groots kleinere Gewichte schaffen den Platz
Das Versprechen betrifft den Speicher. Stell es dir als Notizblock vor. Ein Modell auf einer GPU braucht Speicher für zwei Dinge: seine eigenen Gewichte und einen Notizblock, der das bisherige Gespräch festhält. Die Gewichte sind feste Kosten. Der Notizblock wächst mit jedem Token Kontext, den du erlaubst. Groot behält den Aufbau von Qwen3.6-35B-A3B: Ein Viertel des Modells macht sich zu jedem Wort vollständige Notizen, der Rest führt eine kurze Zusammenfassung. Der Notizblock ist also so klein wie bei Qwen3.6. Was den Platz freimacht, sind die Gewichte, 19B statt 35B.
Die Seite der Autoren sagt, die Builds mit 20,9 GB und 13,5 GB „run the full 256K context on one RTX 5090“, und fügt hinzu, dass das eine Schätzung anhand der Speichergrößen ist. Also sind wir direkt auf diese Karte gegangen.
Die Grenzen: eine GPU, eine Anfrage nach der anderen, unsere eigenen Prompts, jeweils ein paar Läufe. Das prüft, ob das Modell passt und wie schnell es antwortet. Seine Fähigkeiten als Agent stammen aus den Benchmarks der Autoren: Über einen Tool-Test mit zwei Aufrufen hinaus haben wir sie nicht getestet, und keine mehrstufige Agentensitzung lief.
Das volle Fenster passt: ein Prompt mit 205.525 Tokens richtig beantwortet, erstes Wort nach 35 Sekunden
Das volle Fenster mit 262.144 Tokens ist auf der 32-GB-Karte gestartet. Nach dem Laden der Gewichte blieben vLLM 6,8 GiB für den Notizblock, genug für 307.024 Tokens: das volle Fenster plus etwa 45.000 Tokens Reserve. Ein Agent bekommt also das volle Fenster. Mehrere Agenten gleichzeitig müssen sich jeweils mit einem kürzeren begnügen.
Wir haben einen Satz bei 60 % eines Prompts mit 205.525 Tokens versteckt: den Zugangscode für ein Lagerhaus. Das Modell hat ihn gefunden und den Code zurückgegeben. Das erste Wort der Antwort kam nach 34,6 Sekunden, die vollständige Antwort nach 40,3. Eine richtige Antwort zeigt, dass das Fenster funktioniert. Schlussfolgern über lange Dokumente hinweg testet sie nicht.
Die GPU war dabei fast voll. Im normalen Betrieb belegte sie etwa 93 % des Kartenspeichers. Der lange Prompt ließ weniger als 2 % frei. Wie ein Tourbus, der so voll gepackt ist, dass der Verstärker gegen die Tür klemmt: Er fährt, aber nichts passt mehr hinein.
Etwa 270 Tokens pro Sekunde, und der Beschleunigungs-Layer bringt etwa ein Viertel dazu
Eine Antwort mit 4.457 Tokens dauerte über unsere API etwa 17 Sekunden, 262 bis 304 Tokens pro Sekunde. Kurze Antworten lagen am oberen Ende dieses Bereichs, Antworten mit 4.500 bis 5.200 Tokens am unteren. Die Antwort begann in weniger als einer Sekunde (0,26 bis 0,61 s).
Ein Teil dieses Tempos kommt von einem kleinen zusätzlichen Layer, den die Autoren mit dem Modell ausliefern. Er rät die nächsten zwei Tokens, und das Hauptmodell prüft die Vermutung im selben Schritt, den es sonst für ein einziges gebraucht hätte. Wenn die Vermutungen stimmen, kommen mehrere Tokens zum Preis von einem heraus. Mit abgeschaltetem Layer schrieb vLLM 170 bis 211 Tokens pro Sekunde. Bei langen Antworten brachte der Layer grob etwa 25 %: Ein Lauf ging über unsere API, der andere direkt an vLLM.
Tool-Calls kamen sauber zurück, und jede Antwort beginnt mit langem Nachdenken
Tool-Calling hat beim ersten Mal funktioniert. Wir haben das Beispiel der Autoren selbst genommen, das Wetter in Paris. Das Modell bat unseren Code in 0,9 Sekunden um get_weather mit der Stadt in gültigem JSON. Mit dem Ergebnis antwortete es in weniger als einer weiteren Sekunde.
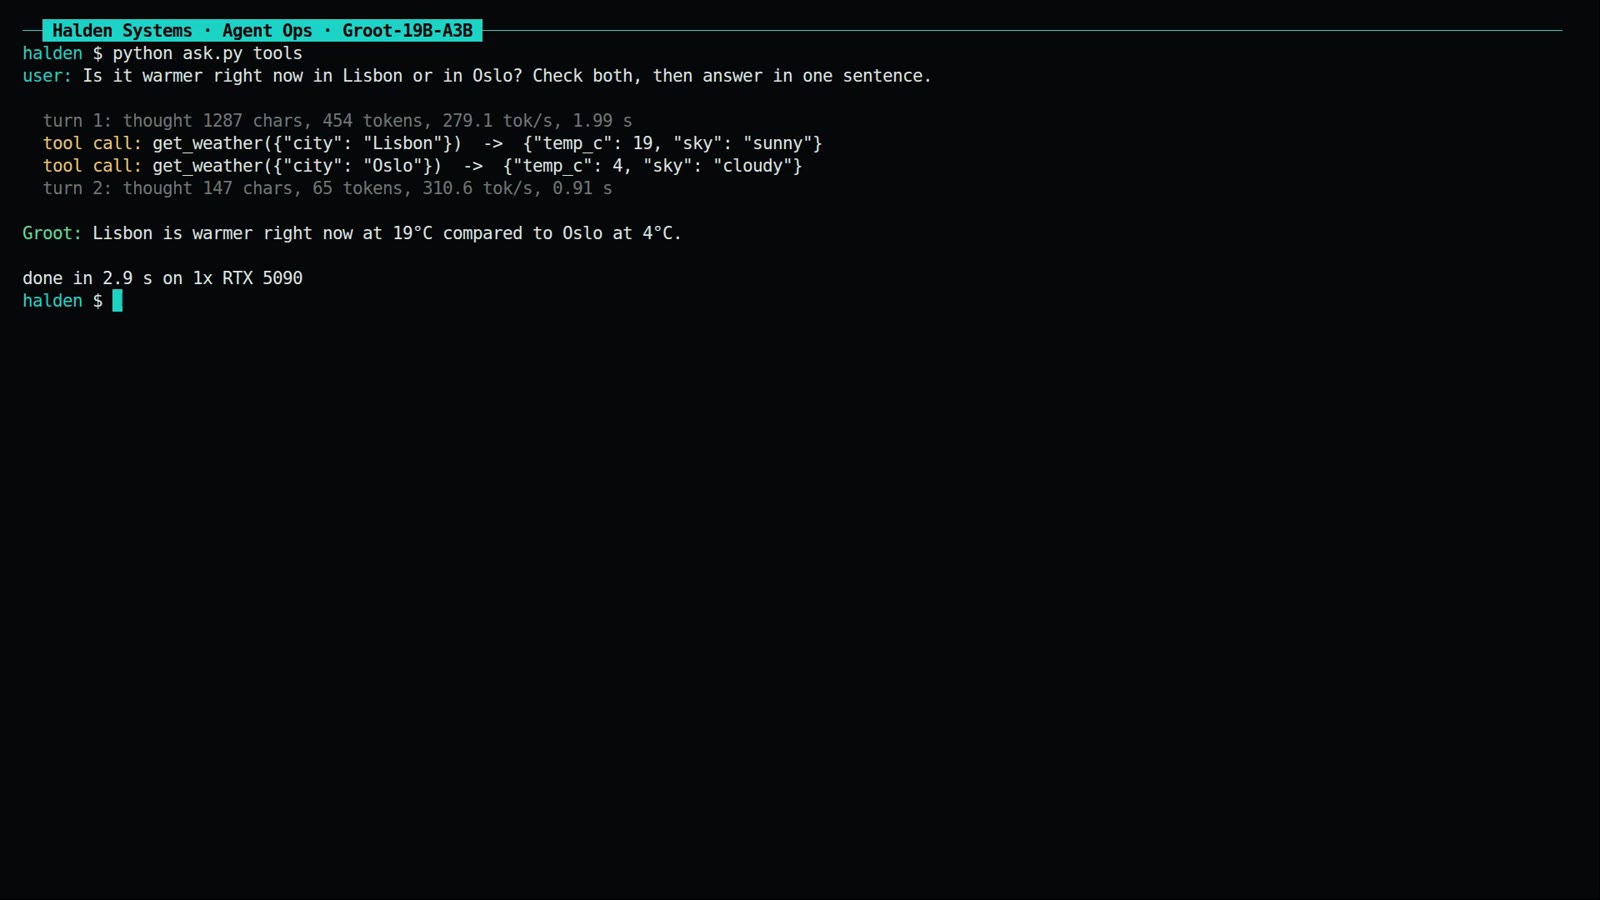
Dann haben wir ihm zwei Städte gegeben: Ist es gerade in Lissabon oder in Oslo wärmer? In einem Turn fragte es beide Städte gleichzeitig ab, zwei Aufrufe nebeneinander. Nachdem unser vorgetäuschter Wetterdienst geantwortet hatte, schrieb es „Lisbon is warmer right now with 19°C compared to Oslo's 4°C“. Der ganze Austausch dauerte 1,81 Sekunden. Genau diese Form erwartet ein Agenten-Framework.
Rechne auch bei kurzen Fragen mit langem Nachdenken: Groot denkt vor jeder Antwort nach, und das Nachdenken zählt als Ausgabe. „Die Hauptstadt Australiens, in einem Wort“ brauchte 111 bis 131 Tokens, fast alles Nachdenken, vor „Canberra“. Die Bitte um einen Essay mit 300 Wörtern ergab über vier Läufe 2.383 bis 7.156 Tokens. In den zwei Läufen, die wir gezählt haben, waren 2.043 und 6.785 dieser Tokens Nachdenken. Qwen3.6 haben wir nicht mit denselben Prompts laufen lassen, die 23,1 % der Autoren können wir also weder bestätigen noch widerlegen. Setz ein großzügiges Token-Limit.
Welche GPU: eine echte RTX 5090 mit 32 GB bei vollem Kontext, nichts Kleineres ist gestartet
Nur die echte 32-GB-Karte ist gestartet. Unter 32 GB ist nichts gestartet, was wir ausprobiert haben. Kleinere Karten hatten wir für diesen Test nicht, also haben wir vLLM auf derselben 5090 angewiesen, nur einen Teil ihres Speichers zu nutzen. Das emuliert das Budget einer kleineren Karte, ist aber keine echte kleinere Karte.
- Budget von 24 GB, FP8, 65.536 Tokens angefordert: nicht gestartet. Allein die Gewichte belegen 86 % dieses Budgets, was 0,48 GiB für den Notizblock ließ. vLLM berechnete ein Maximum von 9.648 Tokens, zu kurz für einen Agenten, der Dateien und Tool-Ergebnisse liest. Die Seite der Autoren empfiehlt, mindestens 128K beizubehalten.
- Budget von 16 GB, der Build mit 13,5 GB, 32.768 Tokens angefordert: nicht gestartet. Er ist beim Start abgestürzt, ein Softwarefehler statt Speichermangel, also konnten wir die Angabe der Autoren für diesen Build nicht prüfen.
Der Anhang listet jede Stufe auf, die wir ausgelassen haben.
Auf InferenceKey: das unveränderte vLLM-Backend und das Rezept der Autoren, bereit in etwa 10 Minuten
Ein neues Modell sollte keine eigene Engine brauchen, und dieses brauchte keine. Unsere Plattform betreibt ein Modell auf einem Worker, einer GPU-Maschine, die du besitzt oder mietest und mit ihr verbindest. Wir haben den Worker mit vLLM und den Einstellungen der Autoren auf den FP8-Build gerichtet, und er hat bedient. Vom Deploy-Aufruf bis zum bereiten Server vergingen auf einer frischen Maschine 611,5 Sekunden. Etwa 3 Minuten gingen in die Installation von vLLM, 28 Sekunden in den Download von 20,9 GB und 5 Minuten darauf, dass vLLM die Engine und ihren Beschleunigungs-Layer aufwärmt. Bei einem Neustart, mit dieser Arbeit auf der Platte gespeichert, dauerte das Aufwärmen 87 Sekunden statt fünf Minuten. Ein Teil dieses langsamen Starts liegt bei uns: Unser Worker lässt einen fertig gebauten Teil weg, also baut vLLM ihn selbst. Status: offen.
Das Problem, auf das du zuerst stoßen wirst, ist der Schalter fürs Nachdenken. Die Seite der Autoren schaltet das Nachdenken mit einer Einstellung pro Anfrage ab. Unsere API gibt diese Einstellung noch nicht an das Modell weiter, also denkt die Anfrage trotzdem nach. Mit abgeschaltetem Nachdenken gefragt, hat es trotzdem überlegt, bevor es „The Eiffel Tower is located in Paris, France.“ sagte. Status: auf unserer Seite offen. Der Workaround ist, den Server standardmäßig ohne Nachdenken zu starten, und das README unseres Beispiels zeigt das einzeilige Flag. Der Rest unserer Funde, darunter zwei kleine Fehler auf der Seite der Autoren, steht im Anhang.
Solltest du es nutzen? Ja, wenn du ein 256K-Fenster auf einer 32-GB-Karte brauchst
- Wenn du langen Kontext auf eigener Hardware willst, ist es bei Passform und Tempo ein starker Kandidat.
- Wenn deine Karte 24 GB hat, lass den Build mit 20,9 GB weg. Die Autoren empfehlen ihren mit 11,7 GB, den wir nicht getestet haben.
- Wenn du schnelle Chat-Antworten brauchst, plane das Nachdenken vor jeder Antwort mit ein.
- Wenn du den kleineren Build mit 13,5 GB brauchst, teste ihn selbst auf einer anderen Serverversion: In unserem Setup ist er nicht gestartet.
Um dasselbe Deployment, einen Tool-Call und das Diagramm der Autoren auf deiner eigenen GPU laufen zu lassen, führ python main.py aus dem Groot-19B-A3B-SDK-Beispiel aus. Es braucht ein InferenceKey-Projekt mit einem SDK-Token und einem API-Key sowie einen privaten NVIDIA-Worker mit 32 GB oder mehr. Am Ende löscht es das Deployment.
Für Ingenieure
Credits
- Groot-19B-A3B-261023: GrootTeam. Sie haben das Modell nachtrainiert, die Builds BF16, FP8, NVFP4 und GGUF veröffentlicht (erstellt 2026-10-23, nicht gated, Tag
license:apache-2.0), dazu den MTP-Layer, die Rezepte für vLLM und SGLang, die Benchmark-Tabellen und die Diagramme, die wir als Vision-Tests verwendet haben. Repos: BF16, FP8, NVFP4, GGUF. - Basismodell: Qwen3.6-35B-A3B vom Qwen-Team.
- Serving: das vLLM-Projekt (0.32.0) und FlashInfer.
- Wo es uns aufgefallen ist: AI Search, "AI finally sleeps, Gemini 4 Carbon, ETH cracked, energy-based models, Anthropic IPO: AI NEWS", hochgeladen 2026-11-01, Abschnitt zu Groot bei 47:33. Das Video behandelt vier Groot-Varianten; dieser Beitrag geht nur um das 19B.
- Unser Teil: das Deployment über die Plattform, die Prompts und Tests, die Messungen, die VRAM-Stufen, das SDK-Beispiel und das Demovideo.
Modell und Dateien
- Ein Mixture-of-Experts-Modell (MoE), der Aufbau, den wir in unserem Beitrag zu Sage-A1.5 erklärt haben. Sein hybrider Aufbau stammt von Qwen3.6-35B-A3B.
- Architektur
Qwen3_5MoeForConditionalGeneration: etwa 19B Parameter gesamt plus ein MTP-Layer mit 0,4B, etwa 3B aktiv pro Token. 40 Layer, 10 mit voller Attention (full_attention_interval4) und 30 mit linearer Attention. Hidden 2048, 16 Attention-Heads, 2 KV-Heads, head_dim 256, Vokabular 248.320. 128 geroutete Experten plus 1 geteilter, 8 geroutete aktiv pro Token.max_position_embeddings262.144, laut der Seite der Autoren mit YaRN (Faktor 4,0) auf etwa 1M erweiterbar. - FP8: Blöcke 128x128, E4M3, dynamische Aktivierungen.
- Grobe KV-Schätzung für die Layer mit voller Attention: 10 Layer x 2 KV-Heads x 256 x 2 (K und V) x 2 B = 20 KiB pro Token, also etwa 5 GiB für 256K, plus der MTP-Layer und die Zustände der linearen Attention.
| Build | Größe auf der Seite | HF usedStorage | Repo-sha |
|---|---|---|---|
| BF16 | 38,9 GB | 38.883.686.769 B (kein mtp.safetensors gelistet) | d089dadf |
| FP8 (E4M3, dynamisch) | 20,9 GB | 20.946.032.529 B (6 Shards + mtp.safetensors 450.538.880 B) | 49137722 |
| NVFP4 (NVFP4-Experten, FP8-Attention) | 13,5 GB | 13.546.543.381 B (4 Shards + mtp.safetensors 883.452.968 B) | 8ff73aca |
| GGUF Q4_K_M | 11,7 GB | 11.657.618.560 B + mmproj BF16 902.822.016 B | 2fa1ec95 |
Angaben der Autoren (nicht nachgemessen)
| Benchmark | Groot-19B-A3B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B |
|---|---|---|---|
| Terminal-Bench 2.1 | 52,10 | 43,82 | 26,52 |
| NL2Repo-Bench | 35,65 | 28,77 | 16,55 |
| LongBench v2 | 62,03 | 48,12 | 47,99 |
| Ungewichteter Mittelwert über 16 Benchmarks | 41,44 | 38,08 | 30,05 |
- Vor beiden bei 12 von 16 Benchmarks. 45,7 % weniger Parameter gesamt als Qwen3.6-35B-A3B, 26,9 % weniger als Gemma-4-26B-A4B.
- Token-Budget: kürzeste mittlere Ausgabe der 12 gemessenen Modelle über die 16 Läufe, 23,1 % weniger Ausgabe-Tokens als Qwen3.6-35B-A3B und 65,6 % weniger als Gemma-4-26B-A4B.
- Eval-Einstellungen: Thinking-Modus mit Standard-Effort, Temperatur 1,0, top_p 0,95, top_k 20, 256K Kontext. Terminal-Bench 2.1 mit dem Claude-Code-Agenten (max_output_tokens 128K, max_turns 500, Timeout 12 h). NL2Repo-Bench mit dem Claude-Code-Agenten, max_turns 1000, 80K Kontext. HLE bewertet von gpt-5.5.
- „Wo es läuft“ (als Schätzung anhand der Speicherkapazität angegeben): BF16 auf einer GPU mit 48 oder 80 GB; FP8 und NVFP4 mit 256K auf einer RTX 5090; GGUF mit 128K auf einer RTX 4060 Ti mit 16 GB und mit 256K auf einer RTX 4090/3090 mit 24 GB; 256K auf Maschinen mit 128 GB Unified Memory. Gegen Qwen3.6-35B-A3B: Auf 16 GB läuft Groot mit 128K, während Qwen3.6 nicht lädt; auf einer RTX 5090 256K gegen 64K.
- Laufzeitanforderungen: Transformers >= 5.8.1, vLLM >= 0.19.1, SGLang >= 0.5.10. Thinking standardmäßig an, aus mit
chat_template_kwargs={"enable_thinking": False}, keine Schalter/thinkoder/nothink. Empfohlenes Sampling mit Thinking: Temperatur 1,0, top_p 0,95, top_k 20, min_p 0, presence_penalty 1,5. Coding: Temperatur 0,6, presence 0. Ohne Thinking: Temperatur 0,7, top_p 0,8.
Setup
- Eine RTX 5090, 32.607 MiB, 575 W, Treiber 595.91.07 (CUDA 13.2), Compute Capability 12.0, 100 GB Platte, in unserer Cloud (InferenceKey Cloud).
- Warum diese Karte: Der Testplan sah für den Hauptlauf eine L40S vor, aber die zentrale Angabe der Autoren nennt die RTX 5090, also ging der Hauptlauf direkt auf sie. Die Stufen mit weniger Speicher liefen auf derselben Maschine unter emulierten Speichergrenzen.
- Die Anfragen liefen über den OpenAI-kompatiblen Endpoint der Plattform (
/v1/chat/completions, Streaming); die Tempoläufe mit MTP aus gingen direkt an vLLM. - Unverändertes
vllm-Backend,vllm_version="0.32.0"(installiert Transformers 5.19 und torch 2.13 für CUDA 13). SGLang nicht verwendet. - Ein lokaler InferenceKey-Manager, gebaut aus
origin/maince3af2dc, hat den Worker eingerichtet. Produktion war nicht beteiligt. - Sampling für die Tempoläufe: Temperatur 1,0, top_p 0,95, presence_penalty 1,5, Streaming.
top_k=20kommt ausgeneration_config.json.
Schritt für Schritt mit dem SDK-Beispiel
- Klone inferencekey-sdk und öffne
examples/groot-19b-a3b-fp8-agent-vllm-private-nvidia/(Commit1c254204). - Bau das Python-SDK lokal mit maturin (siehe
examples/CONTRIBUTING.md, Abschnitt 4) und führpip install -r requirements.txtaus (requests>=2.31). cp .env.example .envund setzeINFERENCEKEY_SDK_TOKEN(ik_sdk_, Scopesworkload:readundworkload:write),INFERENCEKEY_API_KEY(ik_live_, mit dem Workload inallowed_endpoints),INFERENCEKEY_PROJECTundIK_WORKER_ID(ein privater NVIDIA-Worker mit 32 GB oder mehr und einem CUDA-13-Treiber, 580 oder neuer). Optional:GROOT_CONTEXT(standardmäßig 262144),GROOT_MTP(standardmäßig 1),IK_KEEP_ALIVE=1.python main.py. Der Ablauf:ensure()eines festenvllm-Workloads auf deinem Worker (ExecutionPolicy.FIXED),wait_until_ready(timeout=2400), eine einfache Frage mitgenerate_text(), der gestreamte Prompt „I love Groot backwards“ der Autoren, einget_weather-Tool-Call mit zurückgeschicktem Tool-Ergebnis, das Diagramm der Autoren als Bild, Antworten nachoutputs/answers.json, danndelete(), außer beiIK_KEEP_ALIVE=1.
Der Befehl, den das Beispiel deployt:
vllm serve GrootTeam/Groot-19B-A3B-261023-FP8 --max-model-len 262144 \
  --gpu-memory-utilization 0.92 --max-num-seqs 8 --enable-prefix-caching \
  --limit-mm-per-prompt '{"image": 2, "video": 0}' \
  --reasoning-parser qwen3 --enable-auto-tool-choice --tool-call-parser qwen3_coder \
  --speculative-config '{"method": "qwen3_next_mtp", "num_speculative_tokens": 2}'
Um ohne Thinking zu bedienen, füge hinzu:
--default-chat-template-kwargs '{"enable_thinking": false}'
Hauptausgabe des Beispiels: der Rückwärts-Prompt, 460 Tokens in 2,12 s mit 307,1 tok/s, beantwortet mit „toorG evol I“; die Frage zur MoE-Erklärung in 3,8 s.
Zeiten
ensure()bis bereit auf einem kalten Worker: 611,5 s. Installation von vLLM 0.32.0 etwa 170 s, Download der Gewichte 27,8 s, Laden 51,7 s (19,67 GiB), Aufwärmen der Engine 312,6 s (Kompilieren 37,5 s, zwei Captures von CUDA-Graphen und Speculator mit je etwa 2 min, FlashInfer-JIT).- Warmer Neustart (MTP aus, Caches auf der Platte): Aufwärmen der Engine 86,8 s (Kompilieren 37,1 s), Gewichte 19,24 GiB in 23,4 s.
Speicher
--gpu-memory-utilization 0.92, Kontext 262.144, MTP an: verfügbarer KV 6,77 GiB = 307.024 Tokens, maximale Parallelität 1,17x. CUDA-Graph-Pool 0,19 GiB.- Dasselbe mit MTP aus: 7,37 GiB = 376.253 Tokens, 1,44x.
- nvidia-smi jede Sekunde: 30.226 MiB im Betrieb, 32.016 von 32.607 MiB in der Spitze während des 205K-Prompts (530 bis 566 W).
Tempo (eine Anfrage, Streaming)
| Weg | Prompt | Completion-Tokens | Erstes Token | Decode |
|---|---|---|---|---|
| Endpoint, MTP an | „capital of Australia, one word“ | 111 / 115 | 0,26 / 0,60 s | 284,4 / 304,1 tok/s |
| Endpoint, MTP an | Essay mit 300 Wörtern | 5.159 / 4.457 | 0,61 / 0,61 s | 265,9 / 261,9 tok/s |
| vLLM direkt, MTP aus | kurz | 125 / 131 | 0,59 / 0,54 s | 170,5 / 187,1 tok/s |
| vLLM direkt, MTP aus | Essay | 2.383 / 7.156 | 0,79 / 0,68 s | 210,4 / 210,6 tok/s |
| Endpoint, MTP an | Needle-Prompt mit 205.525 Tokens | 119 | 34,62 s | Prefill etwa 5.900 tok/s inkl. Übertragung, gesamt 40,27 s, „4471-HERON“ richtig |
- Der MTP-Vergleich mischt zwei Wege (MTP an über das Gateway, MTP aus direkt). Der Overhead des Gateways war in unserem früheren Test von Sage-A1.5 nicht messbar und wurde hier nicht erneut gemessen.
- Reasoning-Tokens (
usage.completion_tokens_details.reasoning_tokens, direkte Läufe): 120 von 125 bei der kurzen Frage; 2.043 von 2.383 und 6.785 von 7.156 bei den Essays.reasoning_content9,6K bis 23,7K Zeichen bei den Essays.
Tools, Vision, Thinking
- Das
get_weather-Beispiel der Autoren:{"city": "Paris"}, gültiges JSON, 0,9 s; finale Antwort 0,96 s. - Zwei Städte: ein Turn mit zwei parallelen
get_weather-Aufrufen (Lissabon, Oslo; 101 Completion-Tokens, 0,93 s), dann die Antwort (50 Tokens, 0,88 s), 1,81 s gesamt. Aufgezeichnete Aufnahme: 2,9 s (Turn 1 mit 454 Tokens in 1,99 s, Turn 2 mit 65 Tokens in 0,91 s). Die Reasoning-Länge bei Tool-Turns wurde im Haupttest nicht zuverlässig erfasst (0 Zeichen aufgezeichnet, während die aufgezeichnete Aufnahme 1.287 und 147 Zeichen zeigt). - Streudiagramm (9.279 Prompt-Tokens): „Groot-19B-A3B ... approximately 42“ in 4,12 s. Balkendiagramm (16.329 Prompt-Tokens): „52.10 ... Gemma-4 (26.52) and Qwen3.6 (43.82)“ in 9,21 s, erstes Token nach 7,25 s.
chat_template_kwargs={"enable_thinking": false}über den Endpoint: hat trotzdem nachgedacht (571 Zeichen Reasoning, 157 Completion-Tokens).
VRAM-Stufen
| GPU oder Grenze | Konfiguration | VRAM-Spitze | Tempo | Ausgabe OK | Echt oder emuliert |
|---|---|---|---|---|---|
| RTX 5090 32 GB | FP8, 262.144 ctx, util 0.92, MTP an (das Beispiel, über den Endpoint) | 30.226 MiB im Betrieb, 32.016 MiB während des 205K-Prompts | 262 bis 304 tok/s | ja | echt |
| RTX 5090 32 GB | FP8, 262.144 ctx, util 0.92, MTP aus (vLLM direkt) | nicht separat gemessen | 170 bis 211 tok/s | ja | echt |
| 24-GB-Grenze | FP8, 65.536 ctx, util 0.72, MTP an | nicht gestartet | n/a | nein | emuliert |
| 16-GB-Grenze | NVFP4, 32.768 ctx, util 0.48, MTP an | nicht gestartet (Gewichte 12,66 GiB in 35,6 s geladen) | n/a | nein | emuliert |
Fehler bei der 24-GB-Grenze:
ValueError: To serve at least one request with the model's max seq len (65536), (1.66 GiB KV cache is needed, which is larger than the available KV cache memory (0.48 GiB). Based on the available memory, the estimated maximum model length is 9648.
16-GB-Grenze, NVFP4: vLLM meldet, dass die GPU kein natives FP4 unterstützt, und fällt auf reine Gewichtskompression in FP4 mit dem Marlin-Kernel zurück. Dann scheitert der JIT-Build von FlashInfer 0.7.0.post1 für gen_gemm_sm120_group_gemm_fp8_groupwise_e4m3_bf16_majorfalse_sm120 und seine Geschwister (nvcc 13.0.88), am Ende mit RuntimeError: Engine core initialization failed.
Nicht ausprobiert: eine FP8-Stufe mit 24 GB bei 9,6K oder weniger (nach vLLMs eigener Zahl würde sie starten, aber die Autoren empfehlen mindestens 128K), der GGUF-Build auf llama.cpp, NVFP4 auf einer anderen Version von vLLM oder FlashInfer oder auf SGLang, echte Karten mit 24 und 16 GB, die RTX PRO 4500 32 GB, die L40S, BF16. Die Kompatibilitätszeile im README des SDK nennt außerdem RTX PRO 4500/5000, L40S und Karten der A6000-Klasse; gemessen wurde nur die RTX 5090.
Offene Probleme
- Der Endpoint verwirft
chat_template_kwargs,top_kundmin_p. Die Seite der Autoren schaltet das Thinking pro Anfrage mitchat_template_kwargs={"enable_thinking": False}ab. DerChatCompletionRequestdes Managers hat solche Felder nicht, also gehen sie verloren. Thinking lässt sich pro Anfrage nicht abschalten. Workaround:--default-chat-template-kwargsauf dem Server. Status: offen, fehlende Funktion. - Langsamer erster Start. 611,5 s kalt, größtenteils Aufwärmen der Engine. Der Worker installiert mit vLLM 0.32 kein
flashinfer-cubin(Warnung „FlashInfer's precompiled kernels are missing“). Status: offen. - Volles Fenster am Rand der Karte. Weniger als 600 MiB frei während des 205K-Prompts. Halte andere Prozesse von der GPU fern oder setze
GROOT_CONTEXT=131072. - NVFP4 startet auf der RTX 5090 mit vLLM 0.32.0 nicht (siehe die Stufen): kein nativer FP4-Pfad auf sm_120, also nutzt vLLM den Marlin-Fallback nur für die Gewichte, dann scheitert der FlashInfer-JIT-Build. Das kann an unserem Worker-Image liegen, dem
flashinfer-cubinfehlt (Problem 2). Optionen: die vorkompilierten Kernel hinzufügen, eine andere Version von vLLM oder FlashInfer probieren oder SGLang probieren (nichts davon getestet). Für Karten mit 16 und 24 GB verweisen die Autoren auf den GGUF-Build auf llama.cpp (nicht getestet). Status: offen, möglicherweise unser Worker-Image. - Fehler auf der Modellseite. Die Serving-Befehle verwenden
Groot/Groot-19B-A3B-261023, das sich nicht auflösen lässt (HF API 401); das Repo istGrootTeam/Groot-19B-A3B-261023. Die Front Matter verlinkt eineLICENSE-Datei, die in allen vier Repos 404 zurückgibt; die Lizenz besteht nur aus dem Tagapache-2.0und den Metadaten. Status: hier gemeldet, weiterhin auf der Seite. - Deprecation. vLLM 0.32 meldet
qwen3_next_mtpals veralteten Alias vonmtp. Es funktioniert. - Scheduler-Grenze. Die Speculative-Einstellungen setzen
max_num_scheduled_tokensauf 2048.
Übersichtsbild
Demovideo
Die 143 Sekunden lange Demo mit Sprecherstimme: das Deployment im Panel, der Tool-Call mit zwei Städten auf der RTX 5090, das Diagramm der Autoren und die Speicherstufen. Das Vorschaubild zeigt unseren Demo-Tenant.
Quellen
- Modellseite und Repos: BF16, FP8, NVFP4, GGUF (README in allen vier identisch) und der LICENSE-Link (404 am 2026-11-03).
- Listings der vier Repos über die Hugging-Face-API, abgerufen am 2026-11-03.
- SDK-Beispiel, Commit
1c25420460d2277219490af8bcf0ec7c173aa423. - Video von AI Search, IGICYFyP_EI, in dem uns das Modell aufgefallen ist.
- Unsere eigenen Logs: die Logs von vLLM und Worker, nvidia-smi-Messungen jede Sekunde und die JSONL-Ausgaben der Tests zu Tempo, Needle, Tools, Diagrammen und Thinking.