Unlimited OCR 2 liest ein 59-seitiges PDF in einer Anfrage auf einer 16-GB-Karte, sobald die Seitenkacheln aus sind
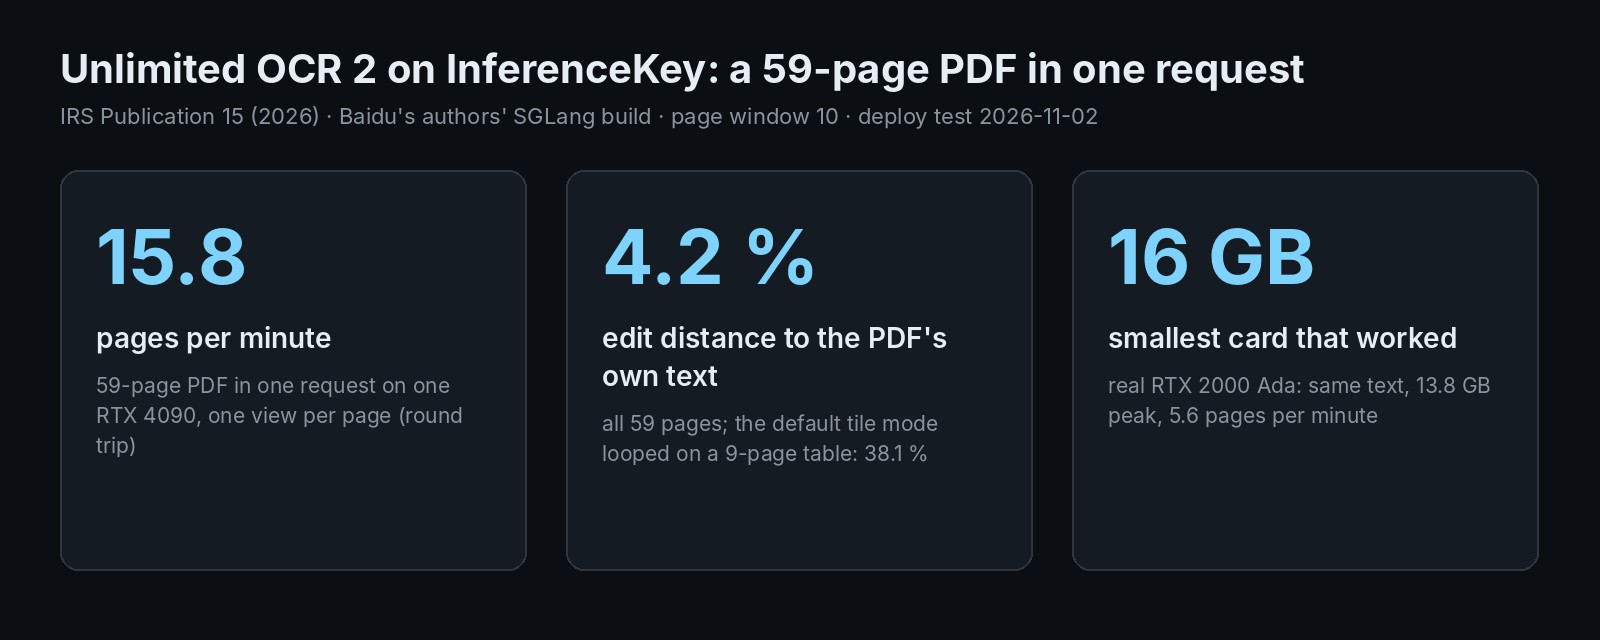
Baidus MIT-Dokumentparser liest einen 59-seitigen Leitfaden in einer Anfrage: 15,8 Seiten/min, 4,2 % Abweichung vom PDF-Text, gleiche Qualität mit 16 GB.
Seite 46 des Steuerleitfadens der US-Steuerbehörde IRS für Arbeitgeber beginnt eine Tabelle, die bis Seite 52 reicht. Eine Pipeline, die eine Seite nach der anderen liest, gibt sie in sieben unverbundenen Stücken zurück. Unlimited OCR 2, ein Dokumentparser von Baidu unter MIT-Lizenz, nimmt das ganze PDF in einer Anfrage. Wir haben alle 59 Seiten des Leitfadens auf einer RTX 4090 laufen lassen. Mit einer geänderten Bildeinstellung las es den ganzen Leitfaden in 3 min 44 s, mit 4,2 % Abweichung vom eigenen Text des PDFs. Auch hier kam die Tabelle zerteilt zurück, aber die meisten Übergänge waren markiert. Eine echte 16-GB-Karte lieferte dieselbe Qualität. Den Code, den wir verwendet haben, findest du am Ende.
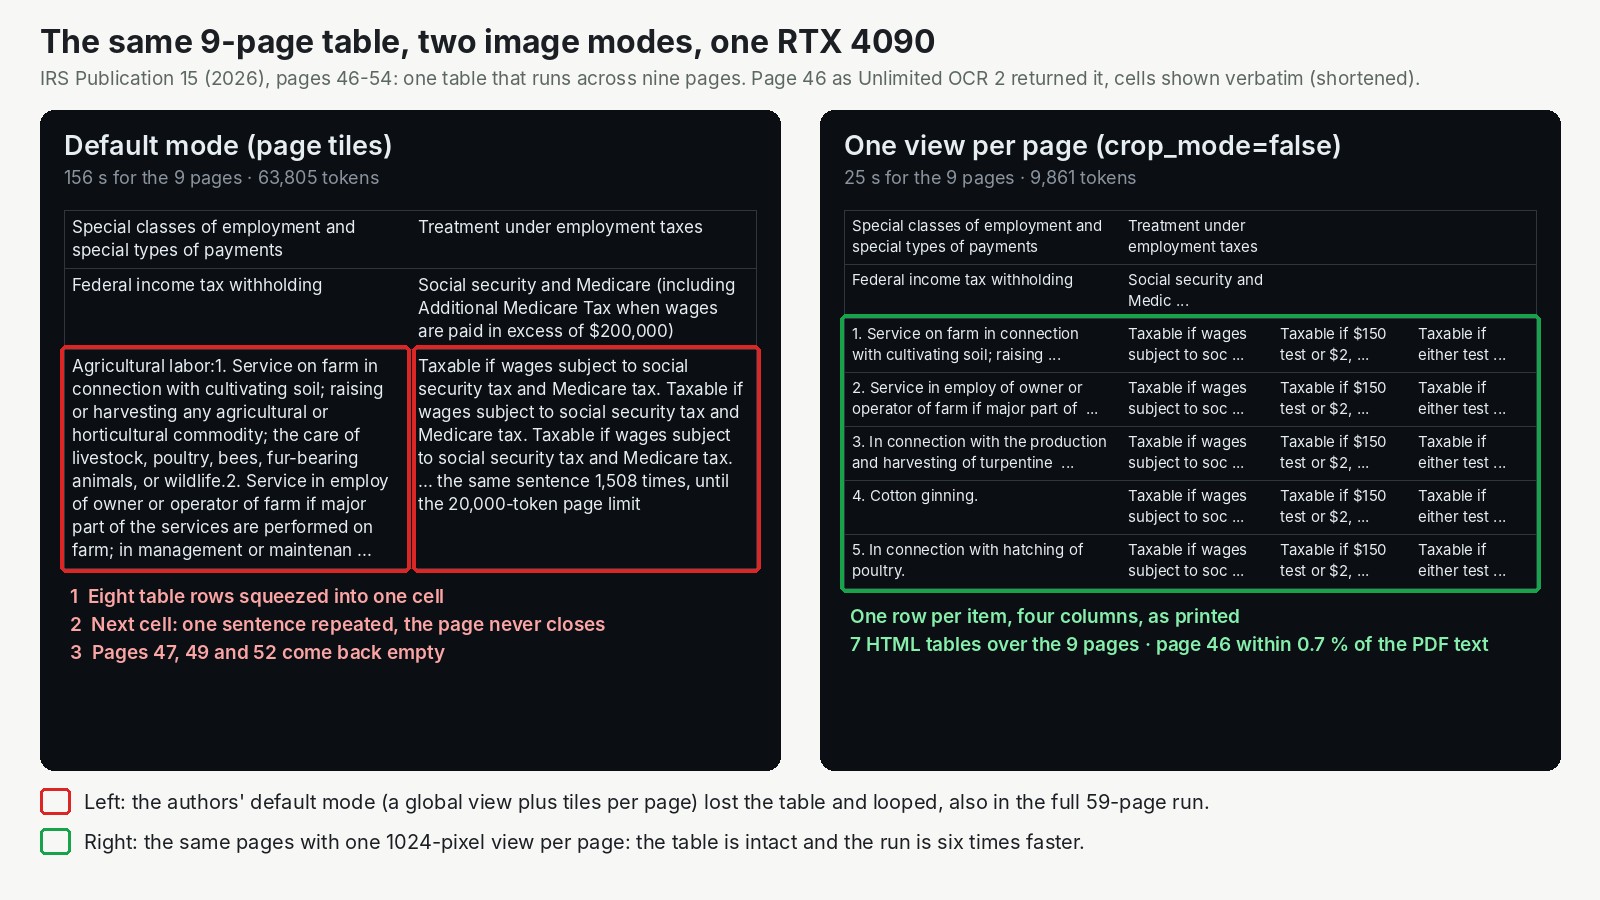
Die Seiten 46 bis 54 allein geschickt, dieselbe Karte, zwei Arten, dem Modell jede Seite zu zeigen. Links der Standard der Autoren. Rechts eine geänderte Einstellung: sechsmal schneller und kein wiederholter Satz.
Der Unterschied zwischen beiden Seiten liegt darin, wie jede Seite dem Modell gezeigt wird. Der Standard der Autoren schneidet jede Seite in Kacheln, vergrößerte Ausschnitte, zusätzlich zu einem Übersichtsbild, was dem Modell mehr Details für Kleingedrucktes gibt. Der andere Modus, eingeschaltet mit crop_mode=false, zeigt nur das Übersichtsbild. Fast jedes Ergebnis unten hängt an dieser Wahl.
Was Baidu gebaut hat: ein Leser, der nur wenige Seiten im Blick behält
So beschreiben es die Autoren: Unlimited OCR 2 liest ein langes Dokument so, wie ein Mensch ein Buch von Hand abschreibt. Es schaut auf die Seite, die es gerade abschreibt, nicht auf jede Seite davor. Deshalb kann es ein langes Dokument in einem Durchgang aufnehmen, ohne dass sein Speicher Seite für Seite wächst.
Das ist wichtig, weil eine seitenweise Pipeline ein PDF so behandelt: Sie teilt die Datei in Seiten, liest jede allein und klebt den Text wieder zusammen. Alles, was über einen Seitenumbruch geht, wird abgeschnitten. Eine Tabelle über zwei Seiten wird zu zwei Tabellen, und die zweite hat keinen Kopf. Der Kanal AI Search, in dessen Newsvideo vom 1. November wir das Modell entdeckt haben, sagt es deutlich: Seitenweise Systeme "lose context when the content continues onto the next page".
Mehrere Seiten zusammen zu lesen ist nicht neu. Baidus erste Version, Unlimited OCR, konnte das schon, bis zu 40 Seiten. Version 2 zielt auf Hunderte. Dem Modell alle Seiten auf einmal zu zeigen wird schnell teuer. Jede Seite ist ein Bild, und Bilder werden zu sehr viel Eingabe. Ohne einen Trick muss jedes neue Wort, das das Modell schreibt, auf all das zurückschauen. Die Model Card nennt Baidus Trick. Das Modell behält nur eine feste Zahl von Bildstücken im Blick, egal wie viele Seiten es sind (das Beispiel der Card sind 512). Laut den Autoren kostet jedes neue Wort daher auf Seite 3 etwa dieselbe Zeit und denselben Speicher wie auf Seite 300.
Dazu kommen die Seiten in Fenstern. Ein Seitenfenster ist die Gruppe von Seiten, die das Modell beim Schreiben im Blick behält, und der Speicher für Seiten außerhalb davon wird freigegeben. Das Serving-Rezept nimmt 10. Kleinere Fenster brauchen weniger Speicher, und laut den Notizen der Autoren können sie das Zusammenführen von Inhalten über Seiten hinweg verschlechtern. Das Modell selbst ist klein: 6,7 GB auf der Platte.
Die Anerkennung gebührt Baidus Team. Shu Wei, Jingjing Wu und Qunyi Xie führen das Paper als Hauptbeitragende an, mit elf weiteren Beitragenden. Sie haben auf ihrem ersten Unlimited OCR und auf DeepSeek-OCR aufgebaut, dessen Teile das Modell wiederverwendet. Ein Teil der Anerkennung geht also an das Team von DeepSeek-OCR. Baidu hat Gewichte und Code unter MIT veröffentlicht, was kommerzielle Nutzung erlaubt. Dazu kommt im Modell-Repository ein gepatchter Build von SGLang, dem offenen Serving-Framework, mit vollständigem Rezept. Die Anerkennung für den Server selbst geht an das SGLang-Projekt. Unser Teil war der Rest: diesen Server hinter eine API zu packen, ihn auf ein echtes Dokument loszulassen, die Ausgabe zu prüfen und zu prüfen, ob eine 16-GB-Karte die Arbeit schafft.
Der Test: ein 59-seitiger Steuerleitfaden mit einer Tabelle über sieben Seiten
Wir wollten ein Dokument, das seitenweises Lesen bestraft. IRS Publication 15 (2026), der US-amerikanische "Employer's Tax Guide", passt. Er hat 59 Seiten, ist gemeinfrei und hat auf den meisten Seiten Absätze, die über einen Seitenumbruch gehen. Abschnitt 15 enthält eine Tabelle, die von Seite 46 bis Seite 52 reicht.
Wir haben den SGLang-Build der Autoren unverändert auf einer RTX 4090 laufen lassen, einer Gaming-Karte mit 24 GB. Jeder Lauf schickte das ganze PDF in einer Anfrage und streamte die Antwort zurück.
Für die Bewertung brauchten wir eine Referenz, die niemand von Hand getippt hat. Das PDF bringt eine eigene Textebene mit, also haben wir den Text des Modells Zeichen für Zeichen damit verglichen. Der Wert ist der Anteil der Zeichen, die man ändern müsste, um das eine in das andere zu verwandeln: 0 % heißt identisch. Er ist streng bei der Lesereihenfolge, also kostet eine Randspalte, die vor ihrem Absatz gelesen wird, Punkte, auch wenn jedes Wort stimmt. Warum nicht einfach die Textebene auslesen? Sie liefert eine kostenlose, exakte Referenz für die Bewertung, aber keine Lesereihenfolge, keine Blockpositionen, keine HTML-Tabellen und keine Markierungen über Seitengrenzen. Die fügt das Modell hinzu.
Das war ein Dokument, auf Englisch, einmal pro Einstellung gelesen, eine Anfrage nach der anderen. Es hatte nur saubere digitale Seiten, Scans ohne Textebene sind also nicht getestet. Unser größtes Dokument hatte 59 Seiten, nicht die Hunderte, auf die die Autoren zielen. Alles, was wir über ein 300-seitiges Buch sagen, ist also ihre Angabe, nicht unsere Messung. Weitere nicht getestete Fälle stehen im Anhang.
Ergebnisse: 59 Seiten in unter 4 Minuten, 4,2 % vom PDF-Text entfernt, Kacheln aus
Eine Ansicht pro Seite gewann bei Geschwindigkeit und Genauigkeit.
| 59-seitiges PDF, eine Anfrage, RTX 4090 | Seitenkacheln (Standard der Autoren, Speicheranteil 0,7) | Eine Ansicht pro Seite (Speicheranteil 0,5) |
|---|---|---|
| Ganzes Dokument | 6 min 45 s, 8,7 Seiten/min | 3 min 44 s, 15,8 Seiten/min |
| Abstand zum eigenen Text des PDFs | 38,1 % (2,4 % ohne die Seiten 46 bis 54) | 4,2 % (2,45 % ohne die Seiten 46 bis 54) |
| Tabellenseiten 46 bis 52 | Schleifen auf den Seiten 46 und 51, Seiten 47, 50 und 52 leer | HTML-Tabellen, fünf Seiten 20 % bis 46 % daneben |
Der Lauf mit einer Ansicht pro Seite nutzte auch einen kleineren Anteil am Speicher der Karte. Im Kachelmodus machte der Anteil keinen Unterschied bei der Geschwindigkeit, in diesem Modus haben wir das aber nicht geprüft. Die Geschwindigkeit blieb von der ersten bis zur letzten Seite gleich.
Bei Fließtext waren beide Modi gut. Lässt man die Tabellenseiten weg, lagen beide etwa 2,4 % vom PDF-Text entfernt, zwei oder drei Zeichen von hundert. Die 4,2 % des schnelleren Modus kommen vor allem von den Tabellenseiten: Fünf seiner sieben Seiten mit mehr als 20 % Abweichung sind Tabellenseiten. Die anderen zwei sind das Deckblatt voller Links und eine Seite, die in falscher Reihenfolge gelesen wurde.
Das Modell markiert jeden Absatz, den ein Seitenumbruch trennt, als auf der nächsten Seite fortgesetzt, hier 31 bis 34 pro Lauf. Die Tabelle kam in sieben Stücken zurück, eines pro Seite, wie es ein seitenweiser Parser liefern würde. Der Unterschied sind die Markierungen: Fünf der sechs Übergänge tragen eine. Der Übergang auf Seite 49 hat keine. Diese Markierungen braucht ein Programm, um die Tabelle wieder zu einer zusammenzusetzen.
Wo es scheitert: Kacheln bei einer langen Tabelle und ein Fenster für das ganze Dokument
Der Standardmodus scheiterte an der einen Tabelle, auf die es ankam. Auf Seite 46 quetschte er acht Tabellenzeilen in eine einzige Zelle. In die nächste Zelle schrieb er einen Satz, "Taxable if wages subject to social security tax and Medicare tax", 1.508-mal. Wie ein Looper-Pedal, das niemand ausschaltet, gestoppt nur von der Grenze von 20.000 Tokens pro Seite (Tokens sind die Wortstücke, die ein Modell liest und schreibt). Die Seiten 47, 50 und 52 kamen leer zurück. Auf Seite 51 geriet er wieder in eine Schleife und schrieb "Exempt." 3.088-mal. Auf Seite 53, direkt nach der Tabelle, schrieb er 6.658 leere Tabellenzellen. Auf Seite 55 fing er sich wieder. Der eigene Schutz der Autoren gegen Wiederholungen war eingeschaltet. Wir haben die Seiten 46 bis 54 noch einmal allein geschickt und bekamen dieselbe Schleife auf Seite 46. So verhält sich das Modell also bei dieser Tabelle in diesem Modus, es ist kein Speicherunfall.
Im Kachelmodus passte ein Fenster für das ganze Dokument nicht. Das Serving-Rezept hat einen Schalter, der die Fenster abschaltet und dem Modell alle 59 Seiten auf einmal gibt. Mit Kacheln belegten allein die Seitenbilder etwa 89.000 der 131.072 Tokens, die das Modell auf einmal verarbeiten kann. Das ließ zu wenig Platz für die Antwort, und sie brach mitten auf Seite 27 ab. Der Server meldet hier keinen Fehler. Mit den Einstellungen des Rezepts kürzt er die Antwort stillschweigend, du merkst es also nur, wenn du die Seiten zählst. Auf den 26 Seiten, die es geschrieben hat, entsprach die Qualität dem Lauf mit Fenstern, 3,67 % Abweichung in beiden.
Eine weitere Grenze nennen die Autoren in ihrem Paper. Weil das Modell nur wenige Seiten auf einmal ansieht, hat es nicht das ganze Dokument im Kopf. Das begrenzt, wie gut es die Struktur des ganzen Dokuments versteht, etwa welche Überschrift unter welcher steht.
Welche GPU: eine echte 16-GB-Karte las den ganzen Leitfaden in etwa zehneinhalb Minuten
Eine echte 16-GB-Karte funktionierte: eine RTX 2000 Ada, eine kleine Workstation-Karte mit 70 Watt, mit einer Ansicht pro Seite. Ihre Qualität entsprach der der 4090.
Der Server reserviert einen festen Anteil der Karte, die er vorfindet, standardmäßig 70 %, und füllt ihn mit Arbeitsspeicher. Die 19,4 GB auf der 4090 sind also nicht das, was das Modell braucht. Auf einer größeren Karte reserviert er einfach mehr. Um eine 16-GB-Karte zu emulieren, haben wir den Server auf der 4090 angewiesen, die Hälfte zu reservieren. Der Anteil änderte die Geschwindigkeit nicht: Kacheln liefen sowohl bei 70 % als auch bei 50 % mit 8,7 Seiten pro Minute.
| Karte | Wie es lief | Spitzenspeicher | Geschwindigkeit | Ausgabe |
|---|---|---|---|---|
| RTX 4090 24 GB, echt | Kacheln, 70 % der Karte | 19,4 GB | 8,7 Seiten/min | Schleifen in der Tabelle, wie bei jedem Kachellauf, der sie abdeckte |
| 16-GB-Grenze auf der 4090, emuliert | Kacheln, 50 % der Karte | 14,7 GB | 8,7 Seiten/min | dieselbe Schleife, nahezu identischer Text |
| 16-GB-Grenze auf der 4090, emuliert | eine Ansicht pro Seite, 50 % der Karte | 15,2 GB | 15,8 Seiten/min | 4,18 % daneben |
| RTX 2000 Ada 16 GB, echt | eine Ansicht pro Seite, Standardwerte (70 %) | 13,8 GB | 5,6 Seiten/min | 4,23 % daneben |
| RTX 2000 Ada 16 GB, echt | Kacheln, nur Seiten 1 bis 10 | 13,8 GB | 5,0 Seiten/min Round Trip | identisch mit der 4090 auf diesen Seiten |
Die emulierten Zeilen zeigen, dass der Speicher reicht, nicht wie schnell eine kleine Karte ist.
Auf InferenceKey: der SGLang-Build der Autoren hinter einer API, bereit in 61 bis 143 Sekunden mit zwischengespeicherten Dateien
Auf deiner eigenen GPU kannst du genau den Server betreiben, den die Autoren verwenden, unverändert, hinter einer API, die deine App schon aufrufen kann. InferenceKey hat keine fertige Unterstützung für dieses Modell, weil es Baidus gepatchten SGLang-Build braucht statt des Standard-Builds. Deshalb haben wir ein eigenes Backend geschrieben: eine kurze Python-Datei, die InferenceKey auf deinem GPU-Rechner installiert und ausführt. Sie lädt die Gewichte in einer festen Version herunter und installiert den Server der Autoren aus dem Modell-Repository. Deine App ruft es so auf wie die Chat-API von OpenAI, mit einem Link auf das PDF in der Nachricht, und bekommt das Markdown zurück, während es geschrieben wird.
Ein Vorbereitungsschritt hatte die Gewichte schon heruntergeladen und den Server installiert. Von da an dauerte der erste Start 143 Sekunden, den Großteil davon bereitete sich der Server auf die Karte vor. Neustarts dauerten 61 bis 63 Sekunden, und die 16-GB-Karte war nach 96 bereit. Auf einem Rechner ohne Cache kommen etwa 70 Sekunden für Download und Installation dazu. Die Einstellungen, die den Speicher beeinflussen, das Seitenfenster und der Anteil der Karte, sind einfache Variablen im Beispiel. Optionen für ein einzelnes Dokument, etwa ein Seitenbereich oder crop_mode=false, kommen in den Text der Nachricht.
Zwei Ecken und Kanten, auf die du auch stoßen wirst:
- Das veröffentlichte Python-Paket von InferenceKey ist älter als diese Art von Backend. Auf dem üblichen Weg installiert, startet das Backend nicht. Die Umgehung ist, unsere Bibliothek direkt von GitHub auf dem GPU-Rechner zu installieren, wie das Beispiel erklärt. Status: offen, wartet auf das nächste Paket-Release.
- Ein PDF, das in der Anfrage mitgeschickt wird, erreicht den GPU-Rechner nie. Der Job landet in der Warteschlange, kommt aber nie an, und der Client gibt nach 180 Sekunden auf. Schick stattdessen einen Link auf das PDF, und das Backend lädt es herunter. Status: offen, Ursache noch nicht gefunden.
Solltest du es nutzen? Ja für PDFs wie dieses, auf einer 16-GB-Karte mit Kacheln aus
- Wenn du lange Berichte, Handbücher oder Verträge mit Tabellen und Absätzen über Seitengrenzen parst, lohnt es sich. Eine Anfrage pro Dokument liefert dir Text, Positionen und Markierungen über Seitenumbrüche hinweg, unter einer Lizenz, die kommerzielle Nutzung erlaubt.
- Wenn deine Dokumente lange Tabellen haben, setz
crop_mode=falseund prüf die Zahlen auf den Tabellenseiten. - Wenn du Kacheln eingeschaltet lässt, behalte die Standardfenster von 10 Seiten und zähl die Seiten, die zurückkommen.
- Wenn deine Karte klein ist, reicht eine 16-GB-Karte für ein Dokument wie unseres.
- Wenn du Hunderte Seiten brauchst, gibt ihm der Benchmark der Autoren mit 100 bis 300 Seiten 77 Punkte, dem nächsten Modell 34 (ihr Test, nicht unserer). Wir haben 59 Seiten getestet, also prüf selbst ein langes Dokument.
Um den IRS-Leitfaden auf deiner eigenen NVIDIA-GPU zu parsen, veröffentlichst du das Backend mit python publish.py und führst python main.py aus dem SDK-Beispiel aus. Du bekommst das ganze Dokument als Markdown mit Seitenmarken, HTML-Tabellen und Zeiten. Du brauchst ein InferenceKey-Projekt und eine NVIDIA-Karte mit 16 GB oder mehr. Die README des Beispiels listet die Schlüssel auf.
Für Ingenieure
Modell und Dateien
Model Card, GitHub (baidu/Unlimited-OCR), Paper (PDF im Modell-Repo), MarathonDocBench.
- Repo
baidu/Unlimited-OCR-2, Lizenz MIT, nicht gated, shac14071b549f4fcab10909f3c4acc6a2edb366947, lastModified 2026-10-29T09:18:46Z. HF createdAt 2026-10-26T03:57:46Z; die Release-Notiz der Card nennt 2026/10/27. - Safetensors-Metadaten: 3.343.978.240 BF16-Parameter. Paper: MoE-Decoder, 3B gesamt und 500M aktiviert pro Token (eine Abbildung nennt es "3B-MOE-A570M", Tabelle 3 "3B-A0.5B").
- Zwei Shards, 4.998.430.312 + 1.689.875.264 Bytes (etwa 6,7 GB). Das Repo enthält außerdem das SGLang-Wheel der Autoren
wheel/sglang-0.5.20.dev13+g75b9b06b02-py3-none-any.whl(15,3 MB) und ein 156 MB großesHarryPotter.gifals Wiedergabe eines ganzen Buchs, das in einer Anfrage geparst wurde. Gesamtspeicher des Repos 7,12 GB. Einen FP8- oder GGUF-Build haben wir nicht geprüft. - Anforderungen des Wheels: torch 2.13.0 (cu130), flashinfer 0.6.18 cu13, sglang-kernel 0.4.7, transformers 5.12.1, also ein Treiber für CUDA 13. Attention-Backend
unlimited_ocr_v2(Triton, PDL nur auf sm90+, Ada funktioniert also). - Inferenzwege laut Card: Transformers (
infer_multi, getestet mit Python 3.10, torch 2.13.0, transformers 4.52.1 auf einer A800-80GB) und SGLang (empfohlen für Serving) in einem mit uv gebauten Python-3.10-venv mitpymupdf==1.27.2.2undfastokens==0.3.2. - Das
infer.pyauf GitHub nutzt standardmäßig den Gundam-Modus (Kacheln) und fällt bei mehrseitigen Dokumenten, deren Token-Budget nicht reicht, auf den Base-Modus zurück. Es nutztmax_model_len131072 für MPDocBench und 786432 für MarathonDocBench.
Mechanismus (Paper, Abschnitte 3.3 und 3.4)
Model Card: SR-SWA "compresses text-visual attention interactions from ultra-long sequences down to a fixed-size set of working references (e.g., 512 tokens)", sodass Latenz und Speicher pro Decoding-Schritt unabhängig von der Dokumentlänge nahezu konstant bleiben.
SR-SWA (Sparse Reference Sliding Window Attention) = Page Gate (beschränkt die visuelle Attention auf Blöcke der Zielseiten, mit einer begrenzten, alternierenden 0-1-Seitenkoordinate plus einer Koordinate innerhalb der Seite) + Token Sieve (alpha-entmax-Router, der die Top-k-Blöcke behält, Ende-zu-Ende trainiert, ohne Distillation-Loss), plus ein festes lokales Fenster. Das Unlimited-Horizon Decoding Paradigm teilt das Dokument in überlappende Seitenblöcke, die sich eine Grenzseite teilen, deren KV wiederverwendet wird, und gibt den visuellen KV außerhalb des aktiven Blocks frei. Training: 25 x 8 H800-Knoten, globale Batch 1.600, maximale Sequenz 64K, initialisiert aus Unlimited OCR v1, DeepEncoder eingefroren, MS-Swift. Abschnitt 3.2: Das Modell übernimmt das Backbone von Unlimited OCR (v1, das mehrseitiges Parsen auf Dutzende Seiten brachte, mit einer Eingabegrenze von 40 Seiten) und nutzt DeepSeek-OCR als Grundlage (DeepEncoder plus ein MoE-Decoder).
Autorenliste (Paper, Abschnitt 8): Hauptbeitragende Shu Wei, Jingjing Wu, Qunyi Xie; Beitragende Lingshu Zhang, Xiangcheng Du, Yannian Fu, Mengjie Wang, Zuyi Wang, Zhichao Liu, Yangliu Xu, Youyang Yin, Huanhuan Liu, YY, Yi Yang (Baidu ERNIE Team).
Angaben der Autoren (von uns nicht nachgemessen)
- 7,0x und 5,6x Beschleunigung pro Schritt gegenüber Full Attention und R-SWA bei hundert Seiten (Latenz-Abbildung im Gundam-Modus, Batch 3, 1.024 Tokens pro Seite).
- Tabelle 4 (MarathonDocBench): Spitzen-KV-Speicher bei B=1 47,00 GB (Standard) gegenüber 1,77 GB (Unlimited-Horizon); Durchsatz bei B=16 360 gegenüber 1.315 TPS.
- MarathonDocBench, der eigene Benchmark der Autoren, mit dem Modell veröffentlicht, gesamt (100 Dokumente mit 100 bis 300 Seiten, etwa 18k Seiten, Chinesisch und Englisch gemischt): Unlimited OCR 2 77,06, Kimi-K3 33,74, Gemini-3.8-Flash 28,61, Qwen-3.8-Flash-Next 27,8, Gemini-3.1-Pro Preview 26,97, Qwen-3.8-Max 22,93, Minimax-M3 17,97, DeepSeek-4.1-Flash 12,34, GLM-5.3-Flash 7,51. Annotationen Apache-2.0, Bilder nur für Forschung.
- MPDocBench (bis zu 30 Seiten) gesamt: Unlimited-OCR 2 84,59, Qwen3.8-Max 78,30, Qwen-3.8-Flash-Next 77,36, Gemini-3.8-Flash 76,25, Gemini-3.1-Pro Preview 71,79, Unlimited-OCR v1 61,89. v1 ist wegen seiner Eingabegrenze von 40 Seiten nicht auf MarathonDocBench.
- Einschränkung (Paper, Abschnitt 6): Sparse Attention erhält keine globale Information über das Dokument, was Struktur auf Dokumentebene wie Überschriftenhierarchien begrenzt. Die Vielfalt der Trainingsdaten ist begrenzt.
Setup
- Eine RTX 4090 24 GB in unserer Cloud (Treiber 595.91.07, CUDA 13.2, 450 W, 100 GB Container-Platte) für die Hauptläufe und eine RTX 2000 Ada Generation 16 GB (70 W, sm 8.9, derselbe Treiber) für die Stufen. Beide als Worker bei einem lokalen InferenceKey-Manager registriert. Die Produktion wurde nie angefasst.
- Eigenes Backend
unlimited-ocr-2(finale Version 0.1.2):setup()lädt die gepinnte Revision herunter, baut mit uv und dem Wheel der Autoren eine Python-3.10-Umgebung (etwa 60 s; der Transformers-Fallback war nicht nötig), extrahiert denDeepseekOCRNoRepeatNGramLogitProcessorder Autoren und startetsglang.launch_servermit den Flags und der Umgebung der Card.chat_stream()nimmt einen PDF-Link im Text (oder einen OpenAI-file-Teil oder Bilder), rendert die Seiten mit PyMuPDF bei 300 dpi, baut"<PAGE><image>" * n + "Multi page parsing."und streamt eine Anfrage. - Anfrageparameter (aus der Card): Temperatur 0,
max_tokens = 8000 x pages, n-Gramm-Schutzngram_size 35,window_size 1024(mehrseitig),page_token_id 128827,eos_token_id 1,max_page_tokens 20000. - Server-Flags:
--mem-fraction-static 0.7,--max-running-requests 8(Card: 64),--max-prefill-tokens 2048,--enable-custom-logit-processor,--allow-auto-truncate,--disable-radix-cache, Prefill-Buckets der CUDA Graphs passend zumax_prefill_tokens. Umgebung:SGLANG_UOCR_EANABLE_DOC_LIMIT=1(Schreibweise der Autoren; 0 = ein Fenster für das ganze Dokument),SGLANG_UOCR_DOC_GUNDAM_PAGE_WINDOW=10,SGLANG_UOCR_DOC_BASE_PAGE_WINDOW=10,SGLANG_UOCR_MAX_PAGE_TOKENS=20000,SGLANG_OPT_UOCR_SAM_REL_POS_BIAS_MB=64(der Standardwert 512 "allows a single ~462 MiB allocation and can OOM"),SGLANG_UOCR_SHM_WRAP_MODEL_DATA=1,PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True. - Speicherhinweise der Card: 0,75 lässt bei 32+ gleichzeitigen Anfragen zu wenig Reserve, 0,7 ist stabil;
--max-prefill-tokensbestimmt einen temporären Tensor von etwa[tokens, context/32], also halbiert 4096 auf 2048 diese Spitze; der größte Prefill-Bucket der CUDA Graphs muss gleichmax-prefill-tokenssein. - Referenz: die Textebene des PDFs (PyMuPDF). NED = Levenshtein / maximale Länge, nach Kleinschreibung und Entfernen von Markup, Layout-Tags und Leerraum.
Zeit bis zur Bereitschaft
| Phase | Zeit |
|---|---|
| Erster Start auf der Plattform, RTX 4090 (Gewichte und Umgebung von einem Vorbereitungsschritt zwischengespeichert) | 143 s, davon SGLang-Start 105,1 s inkl. Erfassung der CUDA Graphs (Prefill-Graphs 23,5 s) |
| Download der Gewichte / uv-Umgebung mit dem Wheel | 10 s / 60 s (8 s / 51 s auf der RTX 2000 Ada) |
| Neustarts nach Redeploys, RTX 4090 | 61 bis 63 s |
| RTX 2000 Ada | 96 s (Scheduler 48,4 s, CUDA Graphs Prefill 18,8 s + Decode 16,6 s) |
| KV-Pool | 160.640 Tokens bei Anteil 0,7 und 83.840 bei 0,5 auf der 4090; 72.096 auf der RTX 2000 Ada |
| Rendern von 59 Seiten bei 300 dpi | 16,5 bis 17,0 s auf der CPU des GPU-Rechners |
Läufe auf der RTX 4090
Backend = die eigene done:-Zeile des Backends. Client = Round Trip über die Plattform. Die Zeiten bis zum ersten Token sind auf Backend-Seite gemessen; über die Plattform waren es 27,6 s (Kacheln), 21,2 s (eine Ansicht) und 71,2 s (ein Fenster).
| Lauf | Modus | Seiten | Backend s | Erster Text s | Seiten/min Backend / Client | Prompt- / Ausgabe-Tokens | Spitze MiB | Ergebnis |
|---|---|---|---|---|---|---|---|---|
| w10-full | Kacheln, Fenster 10, Anteil 0,7 | 59 | 387,87 | 10,53 | 9,1 / 8,7 (404,91 s) | 97.621 / 160.254 | 19.386 | Schleife auf 46, erneut auf 51 ('Exempt.' x3.088) und 53 (6.658 leere Zellen); 47, 50, 52, 54 leer, 48 ein Fragment von 412 Zeichen; NED 38,06 %, 2,38 % ohne 46-54 |
| base-w10-full | eine Ansicht, Fenster 10, Anteil 0,5 | 59 | 206,01 | 3,34 | 17,2 / 15,8 (223,83 s) | 18.277 / 89.477 | 15.212 | NED 4,18 %, 2,45 % ohne 46-54; Seiten über 20 %: 1 (30,0 %), 8 (77,6 %), 46 (45,2 %), 47 (23,0 %), 48 (26,9 %), 49 (45,5 %), 51 (20,4 %); 16 Tabellen, 34 cross_text, 5 append_table |
| whole-full | Kacheln, ein Fenster | 59 angefragt, 27 geschrieben | 147,46 | 50,28 | (168,37 s Client) | 89.331 / 41.739 | 18.058 | abgeschnitten mitten auf Seite 27 |
| cap16-w10 | Kacheln, Fenster 10, Anteil 0,5 | 59 | 386,56 | 9,86 | 9,2 / 8,7 (407,62 s) | 97.621 / 160.242 | 14.670 | wie w10-full |
| table-gundam | Kacheln | 46-54 | 156,14 | 8,27 | 3,5 / 3,4 | 13.631 / 63.805 | 14.670 | dieselbe Schleife auf 46, 47/49/52 leer |
| table-base | eine Ansicht | 46-54 | 25,04 | 2,84 | 21,6 / 18,7 | 2.471 / 9.861 | 15.150 | 7 Tabellen, Dokument-NED 11,0 %, Seite 46 0,68 %, Seiten 48/49/51 26-37 %; 5 append_table |
- Decode etwa 430 bis 435 tok/s im Kachelmodus und etwa 445 tok/s im Base-Modus bei Batch 1, gleichbleibend über das ganze Dokument. Die Freigabe der Fenster ist im SGLang-Log sichtbar (
#token29.248 auf 19.936 zwischen Fenstern). - Ganzes Dokument gegenüber Fenstern auf den Seiten 1-26 (Kachelmodus): NED 3,67 % für beide. 4 von 26 Seiten byte-identisch, der Rest unterscheidet sich in Anführungszeichen und kleinen Formulierungen.
- Ein Fenster, exakte Servermeldung:
Requested token count (89331 input + 472000 new) exceeds the model's context length (131072 tokens). Truncating max_new_tokens.Die Antwort endet ohne Fehler wegen--allow-auto-truncate. - Die
append_table-Markierungen wurden gezählt, nicht verfolgt: Die Tabelle kommt in 7 Stücken auf den Seiten 46-52 zurück, und nur 5 der 6 Übergänge sind markiert (Seiten 47, 48, 50, 51, 52; die Tabelle auf Seite 49 hat keine, in beiden Base-Läufen). Wir haben die Tabellenstücke nicht zu einer Tabelle zusammengesetzt und nicht geprüft, ob sie korrekt zusammenpassen. - Ausgabeformat:
<PAGE>pro Seite,<BLOCK>type[x1, y1, x2, y2]<FORK>textpro Block auf einem Raster von 1000 x 1000, Tabellen als HTML. Verknüpfungen über Seitengrenzen:cross_text/append_text(31 bis 34 in 59 Seiten),append_tablebei Tabellenfortsetzungen.
Seite 46, eine Ansicht pro Seite (erste Zeilen):
<BLOCK>title<LEVEL1>[66, 41, 895, 66]<FORK>15. Special Rules for Various Types of Services and Payments
<BLOCK>table[64, 104, 936, 884]<FORK><table><tr><td rowspan="2">Special classes of employment and special types of payments</td><td colspan="3">Treatment under employment taxes</td></tr>...<tr><td>1. Service on farm in connection with cultivating soil; ...</td><td>Taxable if wages subject to social security tax and Medicare tax.</td><td>Taxable if $150 test or $2,500 test in section 9 is met.</td><td>Taxable if either test in section 14 is met.</td></tr>
Dieselbe Seite im Kachelmodus:
<td>Agricultural labor:1. Service on farm ... 8. Handling or processing commodities ...</td><td>Taxable if wages subject to social security tax and Medicare tax.Taxable if wages subject to social security tax and Medicare tax. ... (x1,508)
VRAM-Stufen
| GPU oder Grenze | Konfiguration | Spitzen-VRAM | Zeit für das 59-seitige PDF | Ausgabe OK | Echt oder emuliert |
|---|---|---|---|---|---|
| RTX 4090 24 GB | Kacheln, Anteil 0,7, Fenster 10 | 19.386 MiB | 387,9 s Backend, 8,7 Seiten/min | ja (die Tabellenschleife ist Modellverhalten, gleich bei jedem Kachellauf, der die Seiten 46-54 abdeckte) | echt |
| RTX 4090 24 GB | Kacheln, ein Fenster | 18.058 MiB | 147,5 s, gestoppt auf Seite 27 | nein (Kontextgrenze) | echt |
| 16-GB-Grenze auf der 4090 | Kacheln, Anteil 0,5, Fenster 10 | 14.670 MiB | 386,6 s, 8,7 Seiten/min | ja, dieselbe Schleife; 13 Seiten byte-identisch, der Rest winzige Unterschiede | emuliert |
| 16-GB-Grenze auf der 4090 | eine Ansicht, Anteil 0,5, Fenster 10 | 15.212 MiB | 206,0 s, 15,8 Seiten/min | ja, 4,18 % | emuliert |
| RTX 2000 Ada 16 GB (70 W) | eine Ansicht, Standardwerte (Anteil 0,7, Fenster 10) | 13.819 MiB | 614,7 s Backend, 634,1 s Round Trip, 5,6 Seiten/min | ja, 4,23 % | echt |
| RTX 2000 Ada 16 GB | Kacheln, Standardwerte, Seiten 1-10 | 13.819 MiB | 116,7 s Backend (5,1 Seiten/min), 120,5 s Client (5,0) | ja, identisch mit der 4090 | echt |
Etwa 147 tok/s auf der RTX 2000 Ada gegenüber etwa 440 auf der 4090. Nicht ausprobiert: 12 GB oder weniger, Kacheln über alle 59 Seiten auf einer echten 16-GB-Karte, Concurrency über 1, ein seitenweiser Parser auf demselben Leitfaden, das Zusammensetzen der Tabellenstücke, Überschriftenebenen, der Transformers-Weg, FP8- oder GGUF-Builds, ein Dokument mit 100 Seiten, ein Fenster für das ganze Dokument mit crop_mode=false (sein 59-Seiten-Prompt hatte 18.277 Tokens gegenüber 89.331 mit Kacheln, er könnte also in den Kontext von 131.072 passen).
Schritt für Schritt mit dem SDK-Beispiel
Beispiel auf GitHub, Commit 944a21f auf main von inferencekey-sdk. Dateien: backend.py, publish.py (api="openai-chat"), main.py, requirements.txt, .env.example, README.md.
cp .env.example .env    # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY, INFERENCEKEY_PROJECT, IK_WORKER_ID,
                        # plus INFERENCEKEY_TENANT_ID and INFERENCEKEY_USER_TOKEN (dashboard session token) for the upload
pip install -r requirements.txt
python publish.py       # once: builds dist/*.tar.gz and uploads it (only if TENANT_ID and USER_TOKEN are set)
IK_PDF=https://www.irs.gov/pub/irs-pdf/p15.pdf python main.py
-
Ohne
INFERENCEKEY_TENANT_IDundINFERENCEKEY_USER_TOKENbautpublish.pynurdist/*.tar.gz. Lade es von Hand über Dashboard -> Custom backends hoch. -
Setz auf dem Worker vor dem Deploy
INFERENCEKEY_SDK_PYTHON_DIRauf einen Checkout vonbindings/python/pythonausmainvon inferencekey-sdk. Mit dem PyPI-Paket (0.260725.739) scheitert das Backend beim Import (siehe Probleme, 1). -
IK_WORKER_IDmuss ein NVIDIA-Worker mit 16 GB oder mehr und einem Treiber für CUDA 13 sein. Die Platzierung ist privat mit einerFIXED-Ausführungsrichtlinie. Wir haben eine 100-GB-Container-Platte verwendet. -
main.pystellt den Workload sicher, wartet bis er bereit ist, parstIK_PDF, speichertoutputs/<name>.mdundoutputs/<name>.json(Seiten, Sekunden, Seiten pro Minute, Zeit bis zum ersten Text) und löscht den Workload, außer beiIK_KEEP_ALIVE=1. -
main.pynutzt nach diesem Test standardmäßigIK_CROP_MODE=false. Das Backend selbst behält den Standard der Autoren (crop_mode=true). OptionalIK_PAGES=1-20. -
Stellschrauben des Backends:
UOCR_PAGE_WINDOW(10; 0 = ein Fenster),UOCR_MEM_FRACTION_STATIC(0,7),UOCR_MAX_RUNNING_REQUESTS(8),max_prefill_tokens2048,max_page_tokens20000, dpi 300. -
Endpunkt:
{base}/endpoint/{project}/{workload}/v1/chat/completions,"stream": true. Optionen im Nachrichtentext:"Parse this document: https://example.org/report.pdf pages 10-30 crop_mode=false dpi=200".
Probleme
- PyPI-SDK zu alt für eigene Chat-Backends. Mit
pip install inferencekeyinstalliert, scheitert das Backend beim Import.inferencekey0.260725.739 auf PyPI hat keinchat()/chat_stream()für eigene Backends:cannot import name 'chat_completion' from 'inferencekey.backend'. Umgehung: das SDK von GitHub im Pfad des Workers (INFERENCEKEY_SDK_PYTHON_DIR). Offen, braucht ein PyPI-Release. - Inline-PDF erreichte den Worker nicht. Ein 1,7 MB großes PDF inline (2,2 MB JSON) erreichte die Job-Warteschlange, aber nie den Worker, und der Client endete beim Timeout von 180 s für das erste Token. Die Route akzeptiert 8 MiB. Umgehung: einen Link schicken, das Backend lädt ihn herunter. Offen, nicht eingegrenzt.
- Eigene Chat-Felder auf oberster Ebene verworfen. Der Worker leitet nur Standard-Chat-Felder an ein eigenes Backend weiter (
build_vllm_chat_stream_bodyinworker/src/jobs.rs). Umgehung: Optionen im Nachrichtentext. Offen. - Manifest ohne
api="openai-chat". Das erstepublish.pyließ es weg, und gestreamte Anfragen wurden abgelehnt. Im Beispiel behoben (0.1.1). - SSE als Latin-1 dekodiert von
requests(kein Charset beitext/event-stream). Inmain.pybehoben mitresp.encoding = "utf-8". - Der Kachelmodus gerät in der 7-seitigen Tabelle (Seiten 46-52) in eine Schleife, mit eingeschaltetem n-Gramm-Schutz der Autoren. Modellverhalten, so berichtet, wie es ist.
- Ein Fenster für das ganze Dokument kürzt stillschweigend bei dieser Länge (siehe oben).
- Die Access-Pille im Panel zeigte "No access" für den Workload, während die Aufrufe funktionierten. Kosmetisch.
Demovideo
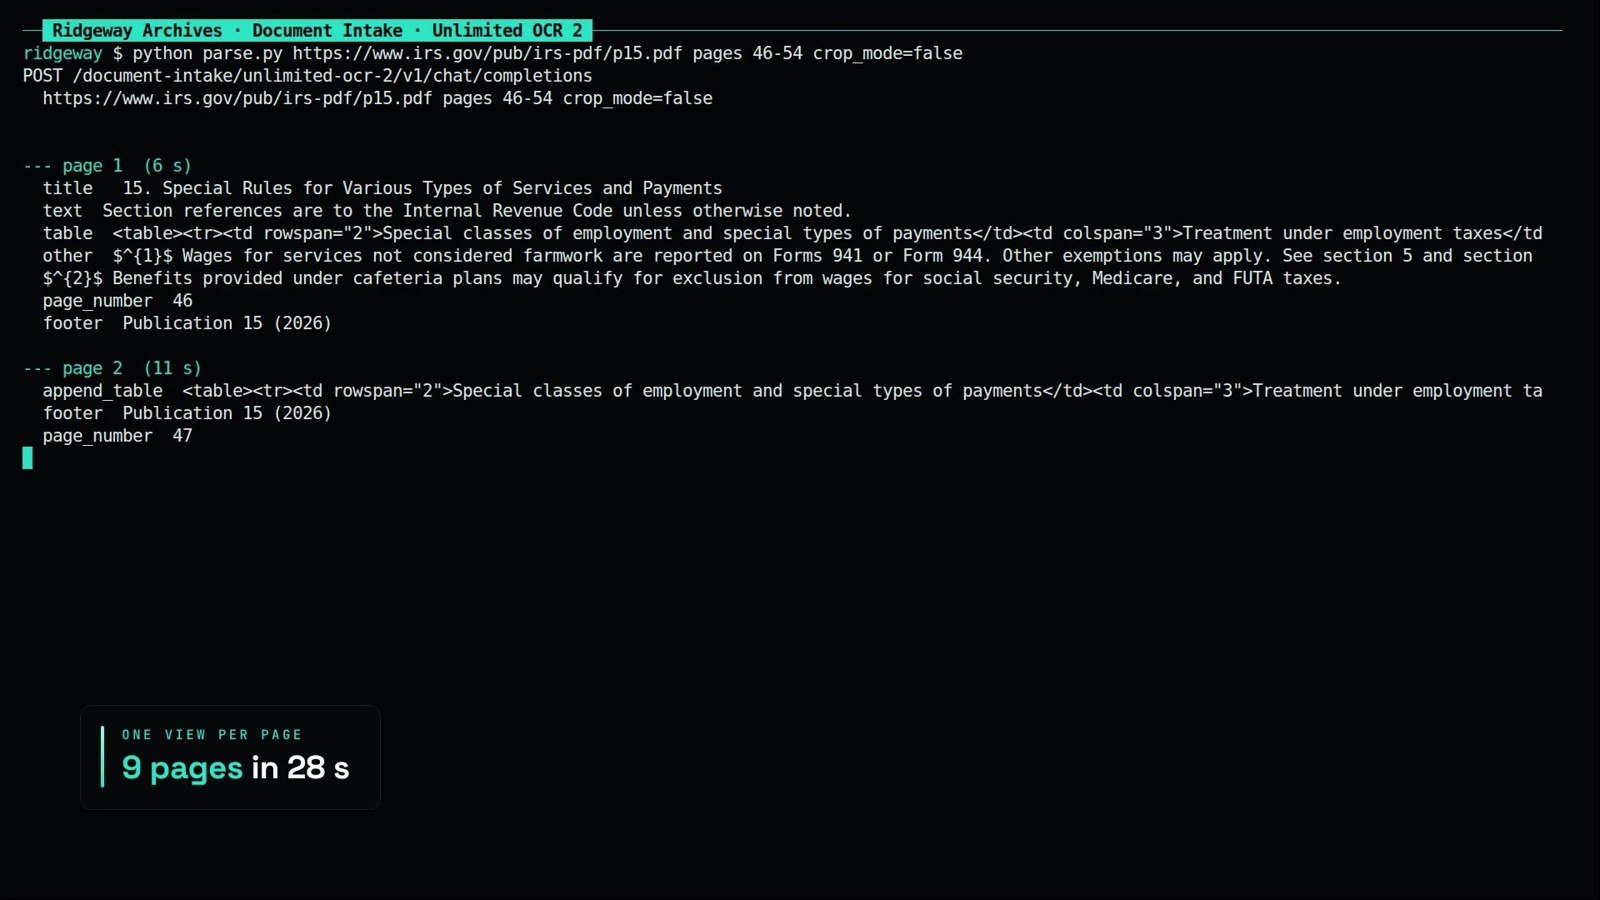
3 Minuten 10 Sekunden. Der Panel-Tester parst die Seiten 7 und 8 (erstes Token 3.268 ms, gesamt 10,02 s), dann parst das Terminal die Seiten 46 bis 54 mit einer Ansicht pro Seite (9 Seiten in 28 s, 19,3 Seiten/min). Außerdem zeigt es die Wiedergabe der Autoren eines ganzen Buchs, das in einer Anfrage geparst wurde, und ihre Benchmark-Zahlen, als ihre gekennzeichnet.
Quellen
- Model Card: https://huggingface.co/baidu/Unlimited-OCR-2
- Code: https://github.com/baidu/Unlimited-OCR
- Paper: https://huggingface.co/baidu/Unlimited-OCR-2/blob/main/Unlimited-OCR-2.pdf
- MarathonDocBench: https://huggingface.co/datasets/baidu/MarathonDocBench
- Testdokument: https://www.irs.gov/pub/irs-pdf/p15.pdf
- Wo wir es entdeckt haben: AI Search, 1. November 2026, Kapitel "Unlimited OCR 2" bei 05:48, https://www.youtube.com/watch?v=IGICYFyP_EI
- Unser SDK-Beispiel: https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/unlimited-ocr-2-pdf-parsing-custom-backend-private-nvidia