Unlimited OCR 2 lit un PDF de 59 pages en une requête sur une carte de 16 GB, une fois ses tuiles de page désactivées
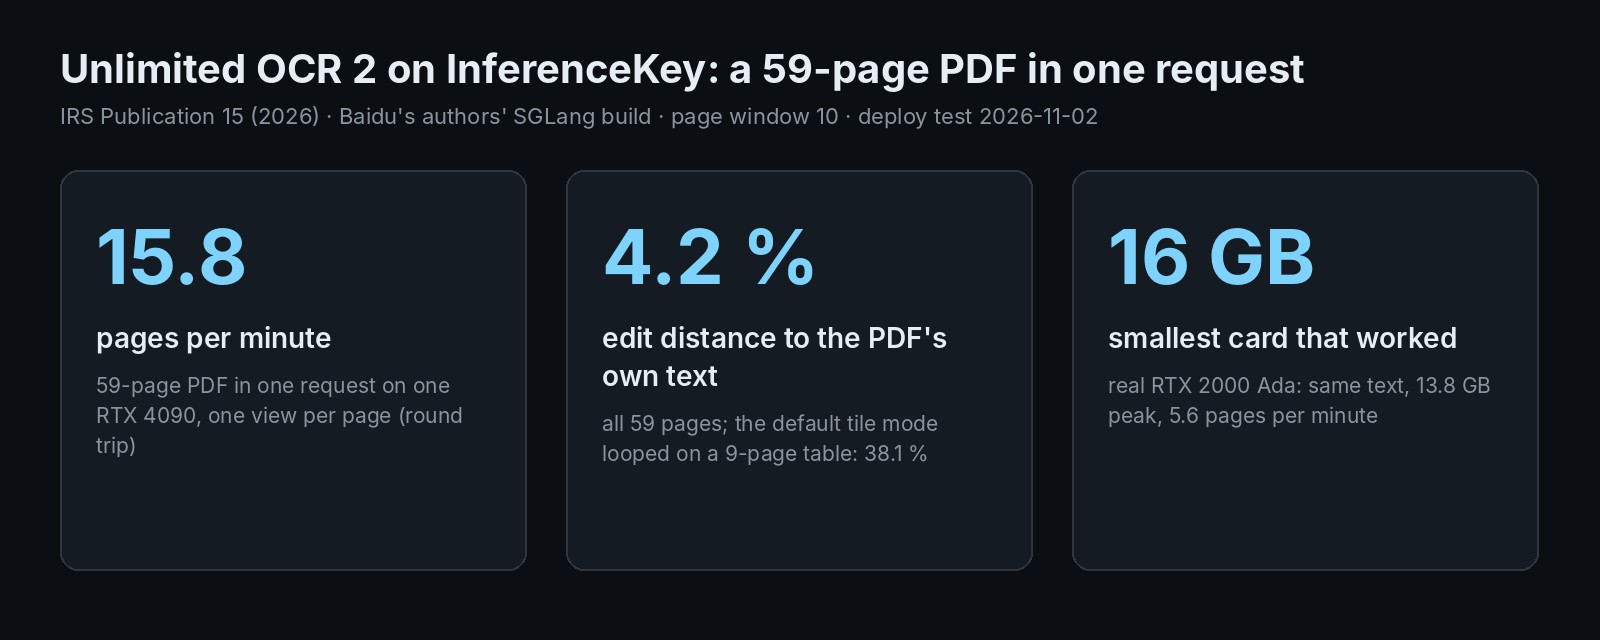
L'analyseur de documents sous MIT de Baidu sur un guide de 59 pages en une requête : 15,8 pages/min, 4,2 % d'écart au texte du PDF, même qualité sur 16 GB.
La page 46 du guide fiscal de l'IRS destiné aux employeurs ouvre un tableau qui court jusqu'à la page 52. Un pipeline qui lit une page à la fois le rend en sept morceaux sans lien entre eux. Unlimited OCR 2, un analyseur de documents de Baidu sous licence MIT, prend le PDF entier en une seule requête. Nous avons passé les 59 pages du guide sur une seule RTX 4090. Avec un seul réglage d'image changé, il a lu tout le guide en 3 min 44 s, à 4,2 % du texte propre au PDF. Il a lui aussi découpé le tableau, mais il a étiqueté la plupart des raccords. Une vraie carte de 16 GB a donné la même qualité. Le code utilisé est à la fin.
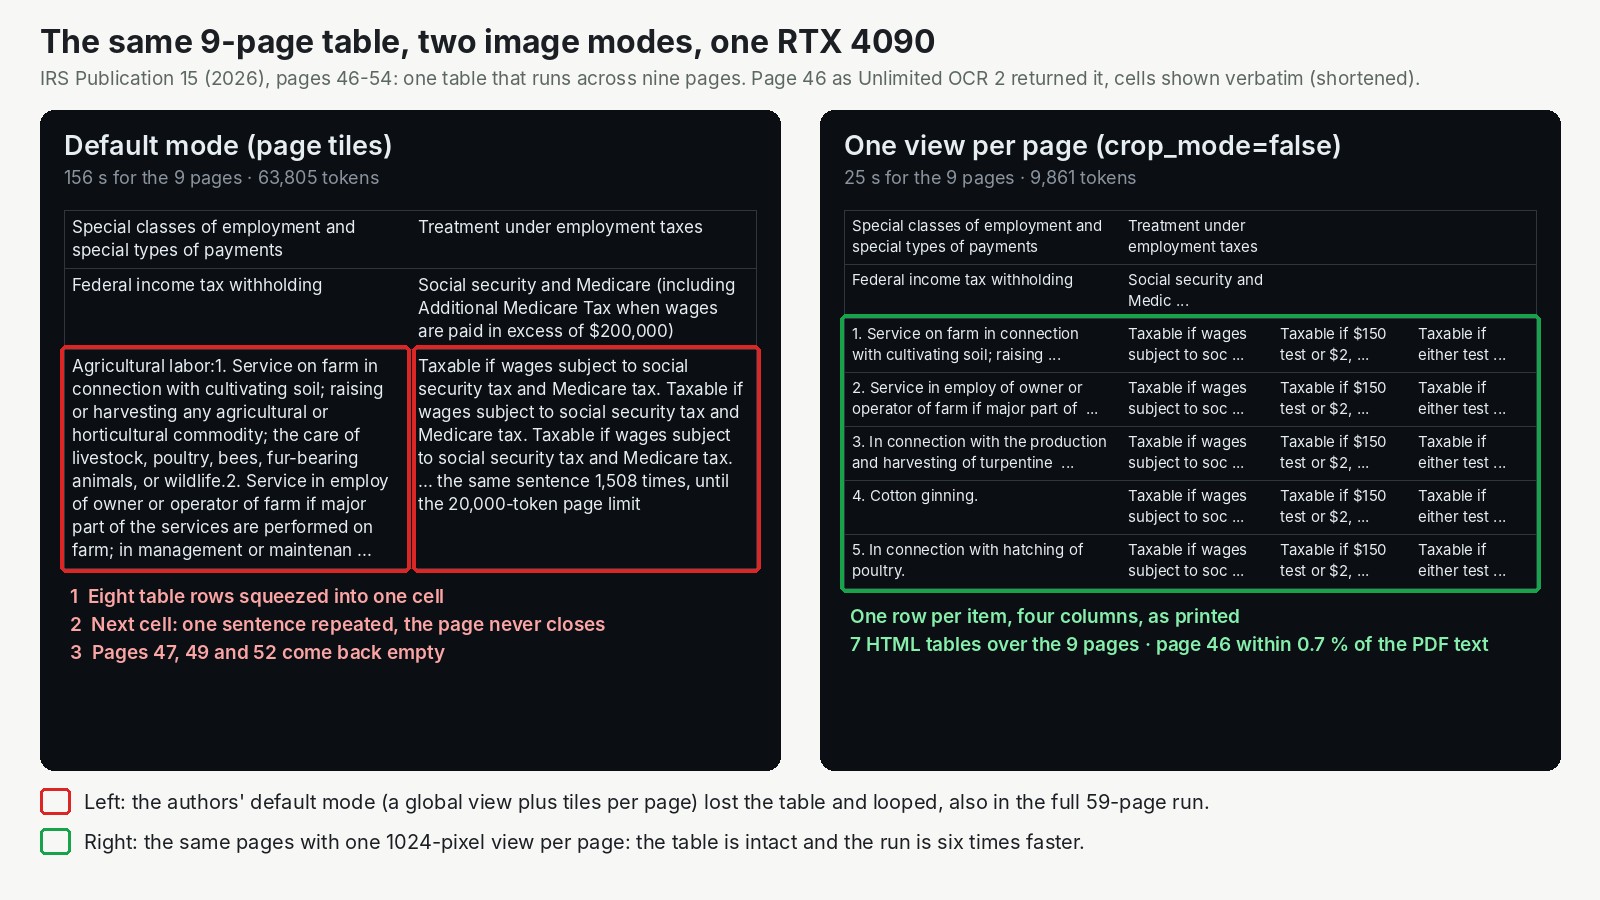
Les pages 46 à 54 envoyées seules, même carte, deux façons de montrer chaque page au modèle. À gauche, le réglage par défaut des auteurs. À droite, un seul réglage changé : six fois plus rapide, et plus de phrase répétée.
La différence entre les deux côtés tient à la façon dont chaque page est montrée au modèle. Par défaut, les auteurs découpent chaque page en tuiles, des morceaux agrandis, en plus d'une image d'ensemble, ce qui donne au modèle plus de détail pour les petits caractères. L'autre mode, activé avec crop_mode=false, ne montre que l'image d'ensemble. Presque tous les résultats qui suivent dépendent de ce choix.
Ce que Baidu a construit : un lecteur qui ne garde que quelques pages en vue
Comme le disent les auteurs, Unlimited OCR 2 lit un long document comme une personne recopie un livre à la main. Il regarde la page qu'il est en train de recopier, pas toutes les pages qui l'ont précédée. C'est ce qui lui permet d'avaler un long document d'un coup sans que sa mémoire grossisse page après page.
C'est important à cause de la façon dont un pipeline page par page traite un PDF. Il découpe le fichier en pages, lit chacune seule et recolle le texte. Tout ce qui franchit un saut de page est coupé. Un tableau sur deux pages devient deux tableaux, et le second n'a pas d'en-tête. La chaîne AI Search, où nous avons repéré le modèle dans sa vidéo d'actualité du 1er novembre, l'a dit sans détour : les systèmes par page "lose context when the content continues onto the next page".
Lire plusieurs pages ensemble n'est pas nouveau. La première version de Baidu, Unlimited OCR, le faisait déjà, jusqu'à 40 pages. La version 2 vise les centaines. Montrer toutes les pages au modèle d'un coup devient vite coûteux. Chaque page est une image, et les images se transforment en beaucoup d'entrée. Sans astuce, chaque nouveau mot que le modèle écrit doit relire tout cela. La fiche du modèle donne l'astuce de Baidu. Le modèle ne garde en vue qu'un nombre fixe de morceaux d'image, quel que soit le nombre de pages (l'exemple de la fiche est 512). Ainsi, selon les auteurs, chaque nouveau mot coûte à peu près le même temps et la même mémoire à la page 3 qu'à la page 300.
Par-dessus, les pages passent par fenêtres. Une fenêtre de pages est le groupe de pages que le modèle garde en vue pendant qu'il écrit, et la mémoire des pages hors de la fenêtre est libérée. La recette de service en utilise 10. Des fenêtres plus petites consomment moins de mémoire, et les notes des auteurs disent qu'elles peuvent nuire à la fusion du contenu d'une page à l'autre. Le modèle lui-même est petit : 6,7 GB sur disque.
Le mérite revient à l'équipe de Baidu. Shu Wei, Jingjing Wu et Qunyi Xie signent en tête l'article comme contributeurs principaux, avec onze autres contributeurs. Ils ont construit sur leur premier Unlimited OCR et sur DeepSeek-OCR, dont le modèle réutilise des pièces. Une part du mérite va donc à l'équipe de DeepSeek-OCR. Baidu a publié les poids et le code sous MIT, qui autorise l'usage commercial. Ils ont aussi livré une version modifiée de SGLang, le framework de service ouvert, avec une recette complète, dans le dépôt du modèle. Le mérite du serveur lui-même revient au projet SGLang. Notre part, c'est le reste : emballer ce serveur derrière une API, le faire tourner sur un vrai document, vérifier la sortie et vérifier qu'une carte de 16 GB fait le travail.
Le test : un guide fiscal de 59 pages avec un tableau qui court sur sept pages
Nous voulions un document qui punit la lecture page par page. L'IRS Publication 15 (2026), le "Employer's Tax Guide" américain, fait l'affaire. Il fait 59 pages, est dans le domaine public, et a des paragraphes qui franchissent un saut de page sur la plupart des pages. La section 15 contient un tableau qui va de la page 46 à la page 52.
Nous avons fait tourner la version de SGLang des auteurs, sans modification, sur une seule RTX 4090, une carte de jeu de 24 GB. Chaque exécution envoyait le PDF entier en une requête et recevait la réponse en streaming.
Pour noter la sortie, il nous fallait une référence que personne n'avait tapée à la main. Le PDF porte sa propre couche de texte, nous avons donc comparé le texte du modèle avec elle, caractère par caractère. Le score est la part des caractères qu'il faudrait changer pour passer de l'un à l'autre : 0 % veut dire identique. Il est strict sur l'ordre de lecture, donc un encadré lu avant son paragraphe coûte des points même quand tous les mots sont justes. Pourquoi ne pas simplement extraire cette couche de texte ? Elle donne une référence gratuite et exacte pour noter, mais ni ordre de lecture, ni position des blocs, ni tableaux HTML, ni étiquettes entre pages. C'est ce que le modèle ajoute.
C'était un seul document, en anglais, lu une fois par réglage, une requête à la fois. Il n'avait que des pages numériques propres, donc les scans, où la couche de texte manque, ne sont pas testés. Notre plus gros document faisait 59 pages, pas les centaines que visent les auteurs, donc tout ce que nous disons d'un livre de 300 pages est leur affirmation, pas notre mesure. Les autres cas non testés sont listés en annexe.
Résultats : 59 pages en moins de 4 minutes, à 4,2 % du texte du PDF, tuiles désactivées
Une seule vue par page a gagné, en vitesse comme en précision.
| PDF de 59 pages, une requête, RTX 4090 | Tuiles de page (défaut des auteurs, part de mémoire 0,7) | Une vue par page (part de mémoire 0,5) |
|---|---|---|
| Document entier | 6 min 45 s, 8,7 pages/min | 3 min 44 s, 15,8 pages/min |
| Distance au texte propre au PDF | 38,1 % (2,4 % sans les pages 46 à 54) | 4,2 % (2,45 % sans les pages 46 à 54) |
| Pages du tableau, 46 à 52 | boucles sur les pages 46 et 51, pages 47, 50 et 52 vides | tableaux HTML, cinq pages entre 20 % et 46 % d'écart |
L'exécution en vue unique a aussi utilisé une part plus petite de la mémoire de la carte. La part n'a rien changé à la vitesse en mode tuiles, mais nous ne l'avons pas vérifié dans ce mode-ci. La vitesse est restée stable de la première à la dernière page.
Sur le texte courant, les deux modes étaient bons. Sans les pages du tableau, tous deux étaient à environ 2,4 % du texte du PDF, deux ou trois caractères sur cent. Les 4,2 % du mode le plus rapide viennent surtout des pages du tableau : cinq de ses sept pages à plus de 20 % d'écart sont des pages du tableau. Les deux autres sont la couverture, pleine de liens, et une page lue dans le désordre.
Le modèle étiquette chaque paragraphe coupé par un saut de page comme continuant à la page suivante, 31 à 34 fois par exécution ici. Le tableau est revenu en sept morceaux, un par page, comme le donnerait un analyseur page par page. La différence, ce sont les étiquettes : cinq des six raccords en portent une. Le raccord de la page 49 n'en a pas. Ces étiquettes sont ce dont un programme a besoin pour recoudre le tableau en un seul.
Là où il casse : les tuiles sur un long tableau, et une seule fenêtre pour tout le document
Le mode par défaut a échoué sur le seul tableau qui comptait. Page 46, il a tassé huit lignes du tableau dans une seule cellule. Dans la cellule suivante, il a écrit une phrase, "Taxable if wages subject to social security tax and Medicare tax", 1 508 fois. Une pédale de boucle que personne n'a coupée, arrêtée seulement par le plafond de 20 000 tokens par page (les tokens sont les morceaux de mots qu'un modèle lit et écrit). Les pages 47, 50 et 52 sont revenues vides. Page 51, il a de nouveau bouclé, en écrivant "Exempt." 3 088 fois. Page 53, juste après le tableau, il a écrit 6 658 cellules de tableau vides. Il s'est rétabli à la page 55. La protection des auteurs contre la répétition était active. Nous avons renvoyé les pages 46 à 54 seules et obtenu la même boucle page 46. C'est donc le comportement du modèle sur ce tableau dans ce mode, pas un accident de mémoire.
En mode tuiles, une seule fenêtre pour tout le document ne rentrait pas. La recette de service a un interrupteur qui supprime les fenêtres et donne au modèle les 59 pages d'un coup. Avec les tuiles, les images des pages prenaient à elles seules environ 89 000 des 131 072 tokens que le modèle peut traiter à la fois. Il restait trop peu de place pour la réponse, et elle s'est arrêtée au milieu de la page 27. Le serveur ne lève pas d'erreur ici. Avec les réglages de la recette, il raccourcit la réponse sans rien dire, donc on ne s'en aperçoit qu'en comptant les pages. Sur les 26 pages qu'il a écrites, la qualité égalait celle de l'exécution par fenêtres, 3,67 % d'écart dans les deux cas.
Les auteurs citent une autre limite dans leur article. Comme le modèle ne regarde que quelques pages à la fois, il ne garde pas tout le document en tête. Cela limite sa compréhension de la structure à l'échelle du document, par exemple quel titre se trouve sous quel autre.
Quel GPU : une vraie carte de 16 GB a lu tout le guide en environ 10 minutes et demie
Une vraie carte de 16 GB a fonctionné : une RTX 2000 Ada, une petite carte de station de travail de 70 watts, avec une seule vue par page. Sa qualité a égalé celle de la 4090.
Le serveur réserve une part fixe de la carte qu'il trouve, 70 % par défaut, et la remplit de mémoire de travail. Les 19,4 GB sur la 4090 ne sont donc pas ce dont le modèle a besoin. Sur une carte plus grosse, il réserve simplement davantage. Pour émuler une carte de 16 GB, nous avons dit au serveur de réserver la moitié de la 4090. La part n'a pas changé la vitesse : les tuiles tournaient à 8,7 pages par minute à 70 % comme à 50 %.
| Carte | Comment il a tourné | Pic de mémoire | Vitesse | Sortie |
|---|---|---|---|---|
| RTX 4090 24 GB, réelle | tuiles, 70 % de la carte | 19,4 GB | 8,7 pages/min | boucles sur le tableau, comme chaque exécution en tuiles qui le couvrait |
| Limite de 16 GB sur la 4090, émulée | tuiles, 50 % de la carte | 14,7 GB | 8,7 pages/min | même boucle, texte quasi identique |
| Limite de 16 GB sur la 4090, émulée | une vue par page, 50 % de la carte | 15,2 GB | 15,8 pages/min | 4,18 % d'écart |
| RTX 2000 Ada 16 GB, réelle | une vue par page, réglages par défaut (70 %) | 13,8 GB | 5,6 pages/min | 4,23 % d'écart |
| RTX 2000 Ada 16 GB, réelle | tuiles, pages 1 à 10 seulement | 13,8 GB | 5,0 pages/min en aller-retour | identique à la 4090 sur ces pages |
Les lignes émulées montrent que la mémoire suffit, pas la vitesse d'une petite carte.
Sur InferenceKey : la version de SGLang des auteurs derrière une API, prête en 61 à 143 secondes avec les fichiers en cache
Sur votre propre GPU, vous pouvez faire tourner exactement le serveur qu'utilisent les auteurs, sans modification, derrière une API que votre application sait déjà appeler. InferenceKey n'a pas de support prêt à l'emploi pour ce modèle, parce qu'il a besoin de la version modifiée de SGLang de Baidu plutôt que de la version standard. Nous avons donc écrit un backend sur mesure : un court fichier Python qu'InferenceKey installe et lance sur votre machine GPU. Il télécharge les poids à une version fixée et installe le serveur des auteurs depuis le dépôt du modèle. Votre application l'appelle comme elle appelle l'API de chat d'OpenAI, avec un lien vers le PDF dans le message, et reçoit le Markdown au fil de l'écriture.
Une étape de préparation avait déjà téléchargé les poids et installé le serveur. À partir de là, le premier démarrage a pris 143 secondes, surtout le temps que le serveur se prépare pour la carte. Les redémarrages ont pris 61 à 63 secondes, et la carte de 16 GB était prête en 96. Sur une machine sans rien en cache, ajoutez environ 70 secondes pour le téléchargement et l'installation. Les réglages qui jouent sur la mémoire, la fenêtre de pages et la part de la carte, sont de simples variables dans l'exemple. Les options pour un seul document, comme une plage de pages ou crop_mode=false, vont dans le texte du message.
Deux aspérités sur lesquelles vous tomberez aussi :
- Le paquet Python d'InferenceKey publié est antérieur à ce type de backend. Installé de la façon habituelle, le backend ne démarre pas. Le contournement consiste à installer notre bibliothèque directement depuis GitHub sur la machine GPU, comme l'explique l'exemple. Statut : ouvert, en attente de la prochaine version du paquet.
- Un PDF envoyé dans la requête n'atteint jamais la machine GPU. Le job est mis en file mais n'arrive jamais, et le client abandonne au bout de 180 secondes. Envoyez plutôt un lien vers le PDF, et le backend le télécharge. Statut : ouvert, cause pas encore trouvée.
Faut-il l'utiliser ? Oui pour des PDF comme celui-ci, sur une carte de 16 GB avec les tuiles désactivées
- Si vous analysez de longs rapports, manuels ou contrats avec des tableaux et des paragraphes qui franchissent les pages, il vaut la peine d'être lancé. Une requête par document vous donne le texte, les positions et des étiquettes à travers les sauts de page, sous une licence qui autorise l'usage commercial.
- Si vos documents ont de longs tableaux, mettez
crop_mode=falseet vérifiez les chiffres sur les pages des tableaux. - Si vous gardez les tuiles, gardez les fenêtres de 10 pages par défaut et comptez les pages qui reviennent.
- Si votre carte est petite, une carte de 16 GB suffit pour un document comme le nôtre.
- S'il vous faut des centaines de pages, le benchmark des auteurs sur 100 à 300 pages lui donne 77, contre 34 pour le modèle suivant (leur test, pas le nôtre). Nous avons testé 59 pages, alors vérifiez vous-même sur un long document.
Pour analyser le guide de l'IRS sur votre propre GPU NVIDIA, publiez le backend avec python publish.py et lancez python main.py depuis l'exemple du SDK. Vous obtenez tout le document en Markdown avec des marqueurs de page, des tableaux HTML et les temps. Il vous faut un projet InferenceKey et une carte NVIDIA de 16 GB ou plus. Le README de l'exemple liste les clés.
Pour les ingénieurs
Modèle et fichiers
Fiche du modèle, GitHub (baidu/Unlimited-OCR), article (PDF dans le dépôt du modèle), MarathonDocBench.
- Dépôt
baidu/Unlimited-OCR-2, licence MIT, sans accès restreint, shac14071b549f4fcab10909f3c4acc6a2edb366947, lastModified 2026-10-29T09:18:46Z. createdAt HF 2026-10-26T03:57:46Z ; la note de version de la fiche indique 2026/10/27. - Métadonnées safetensors : 3 343 978 240 paramètres BF16. Article : décodeur MoE, 3B au total et 500M activés par token (une figure l'étiquette "3B-MOE-A570M", le tableau 3 "3B-A0.5B").
- Deux shards, 4 998 430 312 + 1 689 875 264 octets (environ 6,7 GB). Le dépôt fournit aussi la wheel SGLang des auteurs
wheel/sglang-0.5.20.dev13+g75b9b06b02-py3-none-any.whl(15,3 MB) et unHarryPotter.gifde 156 MB qui rejoue un livre complet analysé en une requête. Stockage total du dépôt 7,12 GB. Nous n'avons vérifié aucune version FP8 ou GGUF. - Dépendances de la wheel : torch 2.13.0 (cu130), flashinfer 0.6.18 cu13, sglang-kernel 0.4.7, transformers 5.12.1, donc un driver CUDA 13. Backend d'attention
unlimited_ocr_v2(Triton, PDL seulement sur sm90+, donc Ada fonctionne). - Chemins d'inférence de la fiche : Transformers (
infer_multi, testé avec Python 3.10, torch 2.13.0, transformers 4.52.1 sur une A800-80GB) et SGLang (recommandé pour le service) dans un venv Python 3.10 construit avec uv, avecpymupdf==1.27.2.2etfastokens==0.3.2. - Le
infer.pyde GitHub utilise par défaut le mode gundam (tuiles) et repasse en mode base pour les documents de plusieurs pages dont le budget de tokens est trop court. Il utilisemax_model_len131072 pour MPDocBench et 786432 pour MarathonDocBench.
Mécanisme (article, sections 3.3 et 3.4)
Fiche du modèle : SR-SWA "compresses text-visual attention interactions from ultra-long sequences down to a fixed-size set of working references (e.g., 512 tokens)", ce qui garde la latence et la mémoire de décodage par pas presque constantes quelle que soit la longueur du document.
SR-SWA (Sparse Reference Sliding Window Attention) = Page Gate (restreint l'attention visuelle aux blocs des pages cibles, avec une coordonnée de page bornée alternant 0-1 plus une coordonnée intra-page) + Token Sieve (routeur alpha-entmax qui garde les top-k blocs, entraîné de bout en bout, sans perte de distillation), plus une fenêtre locale fixe. L'Unlimited-Horizon Decoding Paradigm découpe le document en blocs de pages qui se chevauchent et partagent une page frontière dont le KV est réutilisé, et libère le KV visuel hors du bloc actif. Entraînement : 25 x 8 nœuds H800, batch global de 1 600, séquence max de 64K, initialisé depuis Unlimited OCR v1, DeepEncoder gelé, MS-Swift. Section 3.2 : le modèle hérite de l'ossature d'Unlimited OCR (v1, qui a poussé l'analyse multipage à quelques dizaines de pages avec une limite d'entrée de 40 pages) et repose sur DeepSeek-OCR (DeepEncoder plus un décodeur MoE).
Liste des auteurs (article, section 8) : contributeurs principaux Shu Wei, Jingjing Wu, Qunyi Xie ; contributeurs Lingshu Zhang, Xiangcheng Du, Yannian Fu, Mengjie Wang, Zuyi Wang, Zhichao Liu, Yangliu Xu, Youyang Yin, Huanhuan Liu, YY, Yi Yang (Baidu ERNIE Team).
Affirmations des auteurs (non reproduites par nous)
- Accélérations par pas de 7,0x et 5,6x face à Full Attention et R-SWA à l'échelle de la centaine de pages (figure de latence en mode Gundam, batch 3, 1 024 tokens par page).
- Tableau 4 (MarathonDocBench) : pic de mémoire KV à B=1 de 47,00 GB (standard) contre 1,77 GB (unlimited-horizon) ; débit à B=16 de 360 contre 1 315 TPS.
- MarathonDocBench, le benchmark propre aux auteurs publié avec le modèle, score global (100 documents de 100 à 300 pages, environ 18k pages, chinois et anglais mêlés) : Unlimited OCR 2 77,06, Kimi-K3 33,74, Gemini-3.8-Flash 28,61, Qwen-3.8-Flash-Next 27,8, Gemini-3.1-Pro Preview 26,97, Qwen-3.8-Max 22,93, Minimax-M3 17,97, DeepSeek-4.1-Flash 12,34, GLM-5.3-Flash 7,51. Annotations sous Apache-2.0, images réservées à la recherche.
- MPDocBench (jusqu'à 30 pages), score global : Unlimited-OCR 2 84,59, Qwen3.8-Max 78,30, Qwen-3.8-Flash-Next 77,36, Gemini-3.8-Flash 76,25, Gemini-3.1-Pro Preview 71,79, Unlimited-OCR v1 61,89. La v1 n'est pas sur MarathonDocBench à cause de sa limite d'entrée de 40 pages.
- Limite (article, section 6) : l'attention clairsemée ne préserve pas l'information globale du document, ce qui limite la structure au niveau du document, comme la hiérarchie des titres. La diversité des données d'entraînement est limitée.
Installation
- Une RTX 4090 24 GB sur notre cloud (driver 595.91.07, CUDA 13.2, 450 W, disque de conteneur de 100 GB) pour les exécutions principales, et une RTX 2000 Ada Generation 16 GB (70 W, sm 8.9, même driver) pour l'échelle. Les deux enregistrées comme workers auprès d'un manager InferenceKey local. La production n'a jamais été touchée.
- Backend sur mesure
unlimited-ocr-2(version finale 0.1.2) :setup()télécharge la révision fixée, construit un environnement Python 3.10 avec uv et la wheel des auteurs (environ 60 s ; le repli sur Transformers n'a pas été nécessaire), extrait leDeepseekOCRNoRepeatNGramLogitProcessordes auteurs et lancesglang.launch_serveravec les flags et l'env de la fiche.chat_stream()prend un lien vers un PDF dans le texte (ou une partiefileOpenAI, ou des images), rend les pages avec PyMuPDF à 300 dpi, construit"<PAGE><image>" * n + "Multi page parsing."et envoie une seule requête en streaming. - Paramètres de requête (de la fiche) : température 0,
max_tokens = 8000 x pages, garde n-gramngram_size 35,window_size 1024(multipage),page_token_id 128827,eos_token_id 1,max_page_tokens 20000. - Flags du serveur :
--mem-fraction-static 0.7,--max-running-requests 8(fiche : 64),--max-prefill-tokens 2048,--enable-custom-logit-processor,--allow-auto-truncate,--disable-radix-cache, buckets de CUDA graphs de prefill dimensionnés surmax_prefill_tokens. Env :SGLANG_UOCR_EANABLE_DOC_LIMIT=1(orthographe des auteurs ; 0 = une seule fenêtre pour tout le document),SGLANG_UOCR_DOC_GUNDAM_PAGE_WINDOW=10,SGLANG_UOCR_DOC_BASE_PAGE_WINDOW=10,SGLANG_UOCR_MAX_PAGE_TOKENS=20000,SGLANG_OPT_UOCR_SAM_REL_POS_BIAS_MB=64(la valeur par défaut de 512 "allows a single ~462 MiB allocation and can OOM"),SGLANG_UOCR_SHM_WRAP_MODEL_DATA=1,PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True. - Notes de la fiche sur la mémoire : 0,75 laisse trop peu de marge à 32 requêtes simultanées ou plus, 0,7 est stable ;
--max-prefill-tokenspilote un tenseur temporaire d'environ[tokens, context/32], donc passer de 4096 à 2048 divise ce pic par deux ; le plus grand bucket de CUDA graph de prefill doit être égal àmax-prefill-tokens. - Vérité de référence : la couche de texte du PDF (PyMuPDF). NED = Levenshtein / longueur max, après passage en minuscules et suppression du balisage, des étiquettes de mise en page et des espaces.
Temps jusqu'à prêt
| Phase | Temps |
|---|---|
| Premier démarrage sur la plateforme, RTX 4090 (poids et env en cache grâce à une étape de préparation) | 143 s, dont 105,1 s de démarrage de SGLang, capture des CUDA graphs comprise (graphs de prefill 23,5 s) |
| Téléchargement des poids / env uv avec la wheel | 10 s / 60 s (8 s / 51 s sur la RTX 2000 Ada) |
| Redémarrages après redéploiement, RTX 4090 | 61 à 63 s |
| RTX 2000 Ada | 96 s (scheduler 48,4 s, CUDA graphs prefill 18,8 s + decode 16,6 s) |
| Pool KV | 160 640 tokens à la part 0,7 et 83 840 à 0,5 sur la 4090 ; 72 096 sur la RTX 2000 Ada |
| Rendu de 59 pages à 300 dpi | 16,5 à 17,0 s sur le CPU de la machine GPU |
Exécutions sur la RTX 4090
Backend = la ligne done: du backend lui-même. Client = aller-retour à travers la plateforme. Les temps jusqu'au premier token sont côté backend ; à travers la plateforme, ils étaient de 27,6 s (tuiles), 21,2 s (vue unique) et 71,2 s (fenêtre unique).
| Exécution | Mode | Pages | Backend s | Premier texte s | Pages/min backend / client | Tokens prompt / sortie | Pic MiB | Résultat |
|---|---|---|---|---|---|---|---|---|
| w10-full | tuiles, fenêtre 10, part 0,7 | 59 | 387,87 | 10,53 | 9,1 / 8,7 (404,91 s) | 97 621 / 160 254 | 19 386 | boucle sur 46, de nouveau sur 51 ('Exempt.' x3 088) et 53 (6 658 cellules vides) ; 47, 50, 52, 54 vides, 48 un fragment de 412 caractères ; NED 38,06 %, 2,38 % sans 46-54 |
| base-w10-full | vue unique, fenêtre 10, part 0,5 | 59 | 206,01 | 3,34 | 17,2 / 15,8 (223,83 s) | 18 277 / 89 477 | 15 212 | NED 4,18 %, 2,45 % sans 46-54 ; pages au-dessus de 20 % : 1 (30,0 %), 8 (77,6 %), 46 (45,2 %), 47 (23,0 %), 48 (26,9 %), 49 (45,5 %), 51 (20,4 %) ; 16 tableaux, 34 cross_text, 5 append_table |
| whole-full | tuiles, fenêtre unique | 59 demandées, 27 écrites | 147,46 | 50,28 | (168,37 s client) | 89 331 / 41 739 | 18 058 | tronqué au milieu de la page 27 |
| cap16-w10 | tuiles, fenêtre 10, part 0,5 | 59 | 386,56 | 9,86 | 9,2 / 8,7 (407,62 s) | 97 621 / 160 242 | 14 670 | identique à w10-full |
| table-gundam | tuiles | 46-54 | 156,14 | 8,27 | 3,5 / 3,4 | 13 631 / 63 805 | 14 670 | même boucle sur 46, 47/49/52 vides |
| table-base | vue unique | 46-54 | 25,04 | 2,84 | 21,6 / 18,7 | 2 471 / 9 861 | 15 150 | 7 tableaux, NED du document 11,0 %, page 46 0,68 %, pages 48/49/51 26-37 % ; 5 append_table |
- Décodage à environ 430 à 435 tok/s en mode tuiles et environ 445 tok/s en mode base à batch 1, stable sur tout le document. La libération des fenêtres se voit dans le log de SGLang (
#tokende 29 248 à 19 936 entre deux fenêtres). - Document entier contre fenêtres sur les pages 1-26 (mode tuiles) : NED de 3,67 % dans les deux cas. 4 pages sur 26 identiques à l'octet près, les autres diffèrent par les guillemets et de petites tournures.
- Fenêtre unique, message exact du serveur :
Requested token count (89331 input + 472000 new) exceeds the model's context length (131072 tokens). Truncating max_new_tokens.La réponse s'arrête sans erreur à cause de--allow-auto-truncate. - Les étiquettes
append_tableont été comptées, pas suivies : le tableau revient en 7 morceaux sur les pages 46-52, et seuls 5 des 6 raccords sont étiquetés (pages 47, 48, 50, 51, 52 ; le tableau de la page 49 n'en a pas, dans les deux exécutions base). Nous n'avons pas recousu les morceaux en un seul tableau ni vérifié qu'ils se raccordent correctement. - Format de sortie :
<PAGE>par page,<BLOCK>type[x1, y1, x2, y2]<FORK>textpar bloc sur une grille de 1000 x 1000, tableaux en HTML. Liens entre pages :cross_text/append_text(31 à 34 sur 59 pages),append_tablesur les suites de tableau.
Page 46, une vue par page (premières lignes) :
<BLOCK>title<LEVEL1>[66, 41, 895, 66]<FORK>15. Special Rules for Various Types of Services and Payments
<BLOCK>table[64, 104, 936, 884]<FORK><table><tr><td rowspan="2">Special classes of employment and special types of payments</td><td colspan="3">Treatment under employment taxes</td></tr>...<tr><td>1. Service on farm in connection with cultivating soil; ...</td><td>Taxable if wages subject to social security tax and Medicare tax.</td><td>Taxable if $150 test or $2,500 test in section 9 is met.</td><td>Taxable if either test in section 14 is met.</td></tr>
La même page en mode tuiles :
<td>Agricultural labor:1. Service on farm ... 8. Handling or processing commodities ...</td><td>Taxable if wages subject to social security tax and Medicare tax.Taxable if wages subject to social security tax and Medicare tax. ... (x1,508)
Échelle de VRAM
| GPU ou limite | Config | Pic de VRAM | Temps pour le PDF de 59 pages | Sortie correcte | Réel ou émulé |
|---|---|---|---|---|---|
| RTX 4090 24 GB | tuiles, part 0,7, fenêtre 10 | 19 386 MiB | 387,9 s backend, 8,7 pages/min | oui (la boucle sur le tableau est un comportement du modèle, identique dans chaque exécution en tuiles qui couvrait les pages 46-54) | réel |
| RTX 4090 24 GB | tuiles, fenêtre unique | 18 058 MiB | 147,5 s, arrêt à la page 27 | non (limite de contexte) | réel |
| Limite de 16 GB sur la 4090 | tuiles, part 0,5, fenêtre 10 | 14 670 MiB | 386,6 s, 8,7 pages/min | oui, même boucle ; 13 pages identiques à l'octet près, le reste avec de minuscules différences | émulé |
| Limite de 16 GB sur la 4090 | vue unique, part 0,5, fenêtre 10 | 15 212 MiB | 206,0 s, 15,8 pages/min | oui, 4,18 % | émulé |
| RTX 2000 Ada 16 GB (70 W) | vue unique, réglages par défaut (part 0,7, fenêtre 10) | 13 819 MiB | 614,7 s backend, 634,1 s aller-retour, 5,6 pages/min | oui, 4,23 % | réel |
| RTX 2000 Ada 16 GB | tuiles, réglages par défaut, pages 1-10 | 13 819 MiB | 116,7 s backend (5,1 pages/min), 120,5 s client (5,0) | oui, identique à la 4090 | réel |
Environ 147 tok/s sur la RTX 2000 Ada contre environ 440 sur la 4090. Pas essayé : 12 GB ou moins, les tuiles sur les 59 pages sur une vraie carte de 16 GB, une concurrence supérieure à 1, un analyseur page par page sur le même guide, le recousage des morceaux du tableau, les niveaux de titres, le chemin Transformers, les versions FP8 ou GGUF, un document de 100 pages, une seule fenêtre pour tout le document avec crop_mode=false (son prompt de 59 pages faisait 18 277 tokens contre 89 331 avec les tuiles, il pourrait donc tenir dans le contexte de 131 072).
Pas à pas avec l'exemple du SDK
Exemple sur GitHub, commit 944a21f sur main d'inferencekey-sdk. Fichiers : backend.py, publish.py (api="openai-chat"), main.py, requirements.txt, .env.example, README.md.
cp .env.example .env    # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY, INFERENCEKEY_PROJECT, IK_WORKER_ID,
                        # plus INFERENCEKEY_TENANT_ID and INFERENCEKEY_USER_TOKEN (dashboard session token) for the upload
pip install -r requirements.txt
python publish.py       # once: builds dist/*.tar.gz and uploads it (only if TENANT_ID and USER_TOKEN are set)
IK_PDF=https://www.irs.gov/pub/irs-pdf/p15.pdf python main.py
-
Sans
INFERENCEKEY_TENANT_IDetINFERENCEKEY_USER_TOKEN,publish.pyse contente de construiredist/*.tar.gz. Téléversez-le à la main depuis Dashboard -> Custom backends. -
Sur le worker, faites pointer
INFERENCEKEY_SDK_PYTHON_DIRvers un checkout debindings/python/pythondepuismaind'inferencekey-sdk avant de déployer. Le paquet PyPI (0.260725.739) fait échouer le backend à l'import (voir Problèmes, 1). -
IK_WORKER_IDdoit être un worker NVIDIA avec 16 GB ou plus et un driver CUDA 13. Le placement est privé avec une politique d'exécutionFIXED. Nous avons utilisé un disque de conteneur de 100 GB. -
main.pys'assure que le workload existe, attend qu'il soit prêt, analyseIK_PDF, enregistreoutputs/<name>.mdetoutputs/<name>.json(pages, secondes, pages par minute, temps jusqu'au premier texte) et supprime le workload sauf siIK_KEEP_ALIVE=1. -
main.pyutiliseIK_CROP_MODE=falsepar défaut depuis ce test. Le backend lui-même garde le réglage par défaut des auteurs (crop_mode=true).IK_PAGES=1-20en option. -
Réglages du backend :
UOCR_PAGE_WINDOW(10 ; 0 = une seule fenêtre),UOCR_MEM_FRACTION_STATIC(0.7),UOCR_MAX_RUNNING_REQUESTS(8),max_prefill_tokens2048,max_page_tokens20000, dpi 300. -
Endpoint :
{base}/endpoint/{project}/{workload}/v1/chat/completions,"stream": true. Options dans le texte du message :"Parse this document: https://example.org/report.pdf pages 10-30 crop_mode=false dpi=200".
Problèmes
- SDK PyPI trop ancien pour les backends de chat sur mesure. Installé avec
pip install inferencekey, le backend échoue à l'import.inferencekey0.260725.739 sur PyPI n'a pas dechat()/chat_stream()pour les backends sur mesure :cannot import name 'chat_completion' from 'inferencekey.backend'. Contournement : le SDK depuis GitHub dans le chemin du worker (INFERENCEKEY_SDK_PYTHON_DIR). Ouvert, il faut une version PyPI. - Le PDF en ligne n'a pas atteint le worker. Un PDF de 1,7 MB envoyé dans la requête (2,2 MB de JSON) a atteint la file des jobs mais jamais le worker, et le client s'est arrêté au délai de 180 s pour le premier token. La route accepte 8 MiB. Contournement : envoyer un lien, le backend le télécharge. Ouvert, cause non isolée.
- Champs de chat personnalisés de premier niveau ignorés. Le worker ne transmet au backend sur mesure que les champs de chat standard (
build_vllm_chat_stream_bodydansworker/src/jobs.rs). Contournement : les options dans le texte du message. Ouvert. - Manifeste sans
api="openai-chat". Le premierpublish.pyl'omettait et les requêtes en streaming étaient refusées. Corrigé dans l'exemple (0.1.1). - SSE décodé en Latin-1 par
requests(pas de charset surtext/event-stream). Corrigé dansmain.pyavecresp.encoding = "utf-8". - Le mode tuiles boucle sur le tableau de 7 pages (pages 46-52) avec la garde n-gram des auteurs active. Comportement du modèle, rapporté tel quel.
- Une seule fenêtre pour tout le document tronque sans rien dire à cette longueur (voir plus haut).
- La pastille Access du panneau affichait "No access" pour le workload alors que les appels fonctionnaient. Cosmétique.
Vidéo de démo
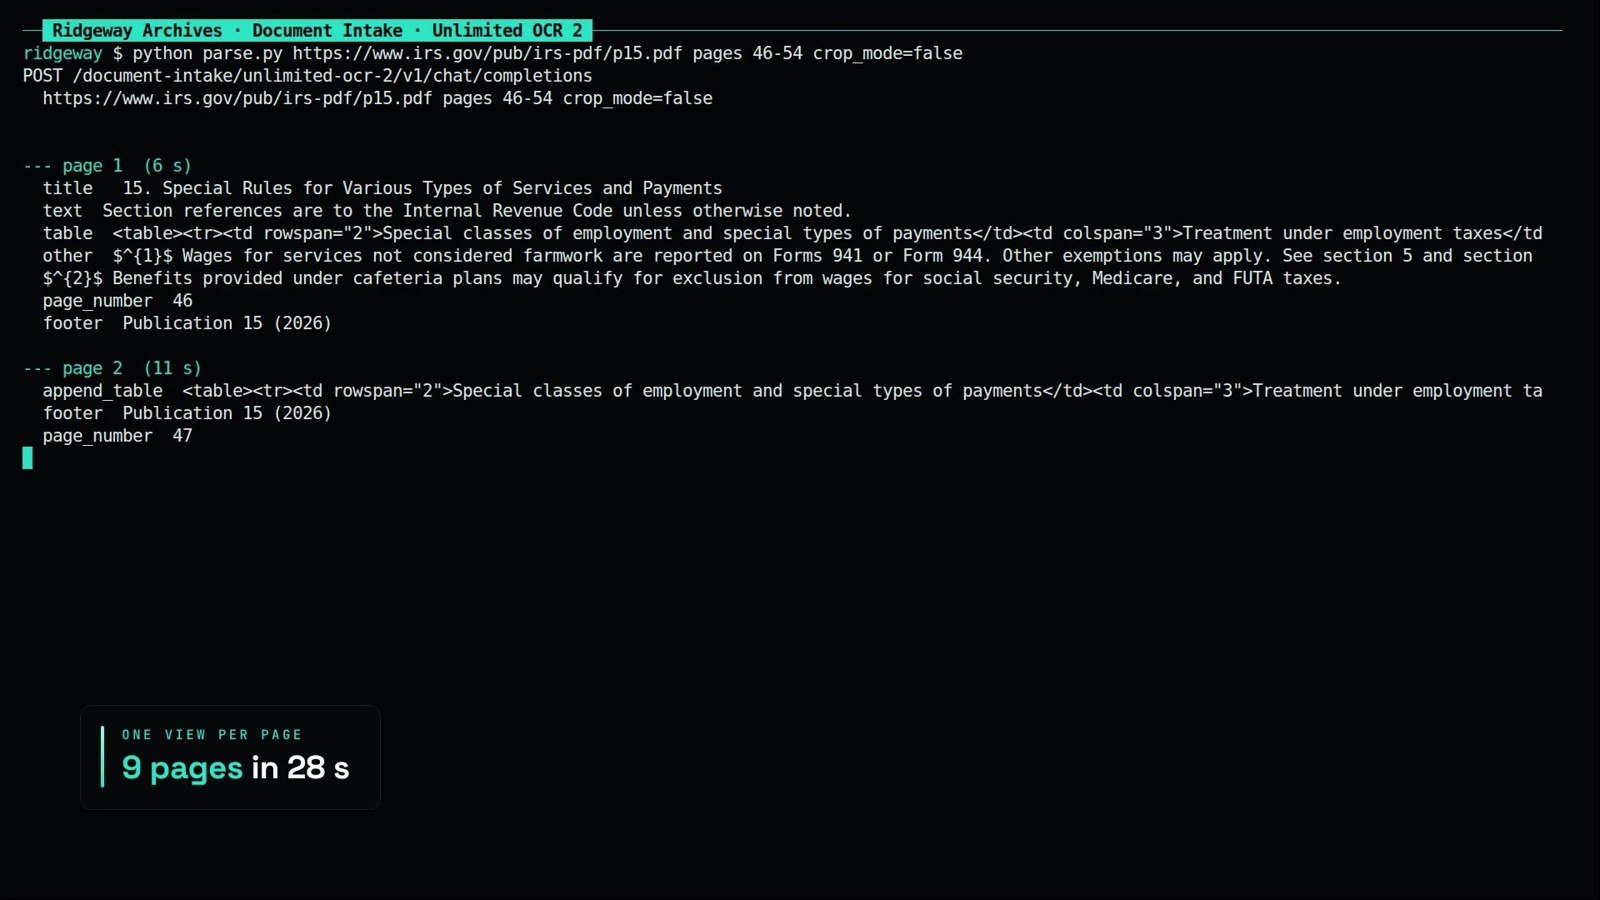
3 minutes 10 secondes. Le testeur du panneau analyse les pages 7 et 8 (premier token à 3 268 ms, total 10,02 s), puis le terminal analyse les pages 46 à 54 avec une vue par page (9 pages en 28 s, 19,3 pages/min). La vidéo montre aussi l'animation des auteurs qui rejoue un livre entier analysé en une requête et leurs chiffres de benchmark, présentés comme les leurs.
Sources
- Fiche du modèle : https://huggingface.co/baidu/Unlimited-OCR-2
- Code : https://github.com/baidu/Unlimited-OCR
- Article : https://huggingface.co/baidu/Unlimited-OCR-2/blob/main/Unlimited-OCR-2.pdf
- MarathonDocBench : https://huggingface.co/datasets/baidu/MarathonDocBench
- Document de test : https://www.irs.gov/pub/irs-pdf/p15.pdf
- Où nous l'avons repéré : AI Search, 1er novembre 2026, chapitre "Unlimited OCR 2" à 05:48, https://www.youtube.com/watch?v=IGICYFyP_EI
- Notre exemple du SDK : https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/unlimited-ocr-2-pdf-parsing-custom-backend-private-nvidia