Unlimited OCR 2 lee un PDF de 59 páginas en una sola petición en una tarjeta de 16 GB, si se le quitan los recortes de página
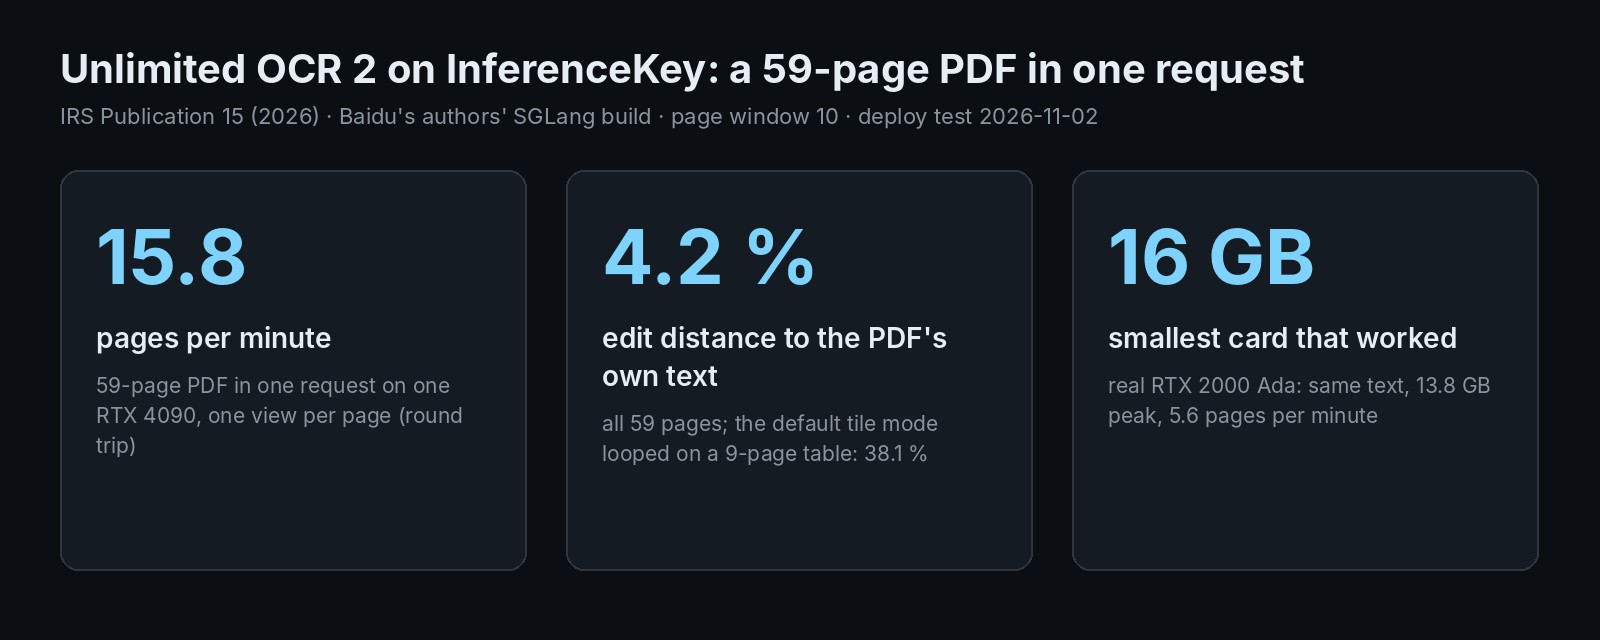
El parser de documentos MIT de Baidu leyó una guía de 59 páginas en una petición: 15,8 páginas/min, un 4,2 % lejos del texto del PDF, igual en 16 GB.
En la página 46 de la guía fiscal del IRS para empleadores empieza una tabla que llega hasta la página 52. Un pipeline que lee página a página la devuelve en siete trozos sin conexión entre sí. Unlimited OCR 2, un parser de documentos de Baidu con licencia MIT, recibe el PDF entero en una sola petición. Pasamos las 59 páginas de la guía por una RTX 4090. Cambiando un solo ajuste de imagen, leyó la guía completa en 3 min 44 s, a un 4,2 % del texto del propio PDF. También partió la tabla, pero marcó la mayoría de las uniones. Una tarjeta real de 16 GB dio la misma calidad. El código que usamos está al final.
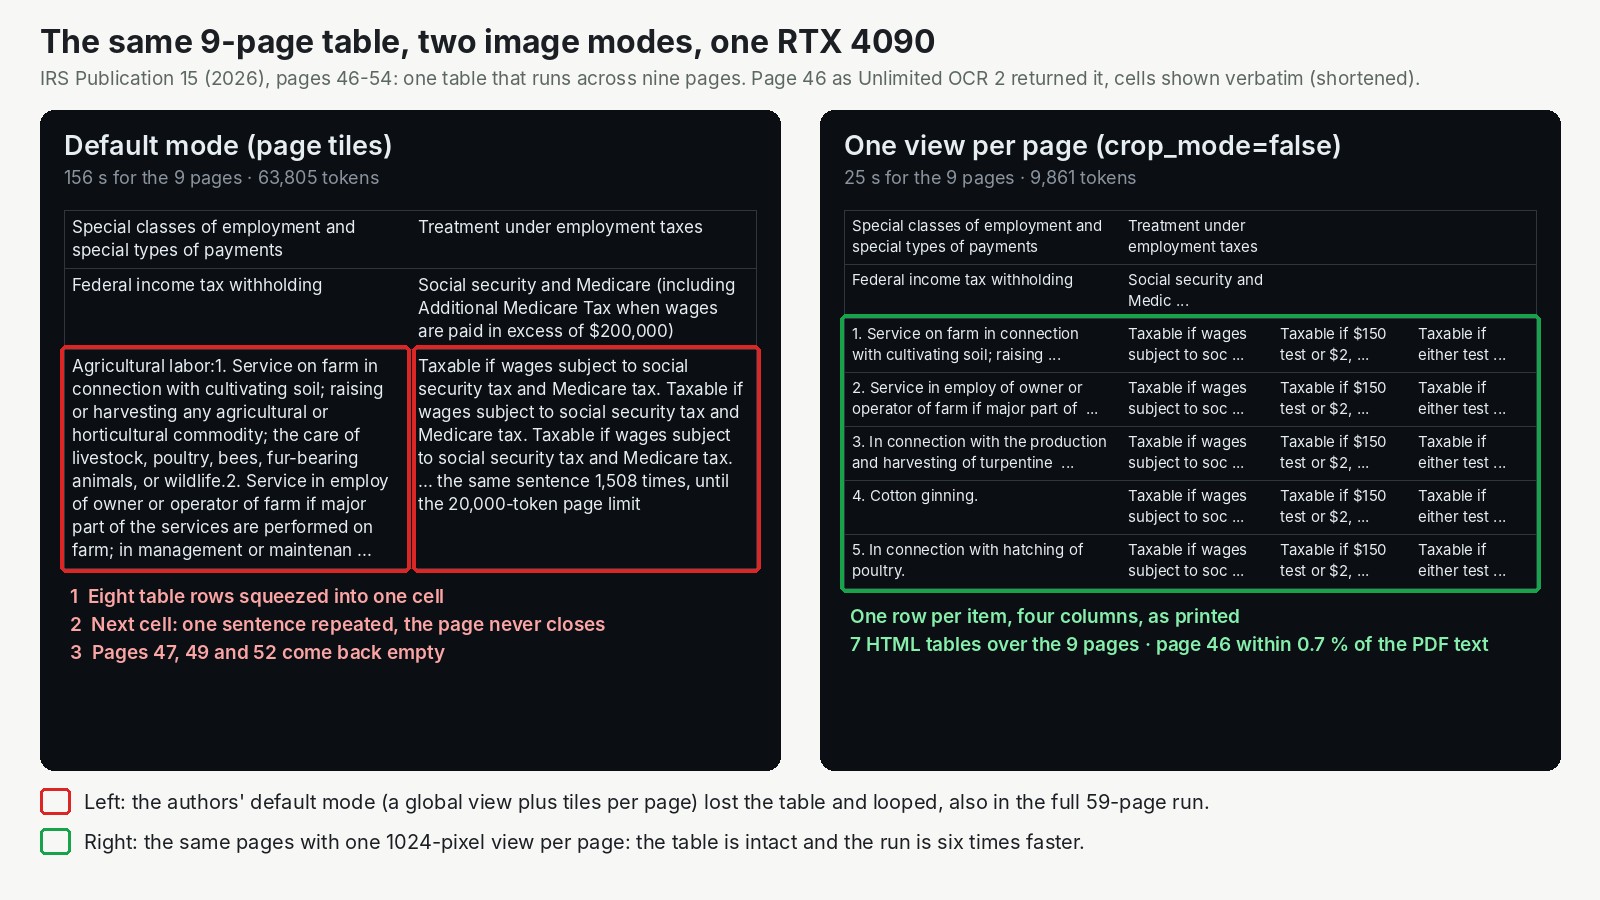
Páginas 46 a 54 enviadas solas, la misma tarjeta, dos formas de enseñar cada página al modelo. A la izquierda, lo que traen los autores por defecto. A la derecha, con un ajuste cambiado: seis veces más rápido y sin la frase repetida.
La diferencia entre los dos lados está en cómo se le enseña cada página al modelo. Por defecto, los autores cortan cada página en recortes (trozos ampliados) además de una imagen general de la página, lo que da al modelo más detalle en la letra pequeña. El otro modo, que se activa con crop_mode=false, solo le enseña la imagen general. Casi todos los resultados que siguen dependen de esa elección.
Qué ha construido Baidu: un lector que solo tiene a la vista unas pocas páginas
Según lo explican los autores, Unlimited OCR 2 lee un documento largo igual que una persona copia un libro a mano. Mira la página que está copiando, no todas las anteriores. Eso es lo que le permite leer un documento largo de una vez sin que su memoria crezca página tras página.
Esto importa por cómo trata un PDF un pipeline página a página. Divide el fichero en páginas, lee cada una por separado y vuelve a pegar el texto. Todo lo que cruza un salto de página se corta. Una tabla que ocupa dos páginas se convierte en dos tablas, y la segunda no tiene cabecera. El canal AI Search, donde vimos el modelo en su vídeo de noticias del 1 de noviembre, lo dijo sin rodeos: los sistemas por página "pierden el contexto cuando el contenido sigue en la página siguiente".
Leer varias páginas juntas no es nuevo. La primera versión de Baidu, Unlimited OCR, ya lo hacía, hasta 40 páginas. La versión 2 apunta a cientos. Enseñarle al modelo todas las páginas a la vez se encarece enseguida. Cada página es una imagen, y las imágenes se convierten en mucha entrada. Sin algún truco, cada palabra nueva que escribe el modelo tiene que volver a mirar todo eso. La ficha del modelo explica el truco de Baidu. El modelo solo mantiene a la vista un número fijo de trozos de imagen, haya las páginas que haya (el ejemplo de la ficha es 512). Así, según los autores, cada palabra nueva cuesta más o menos el mismo tiempo y la misma memoria en la página 3 que en la 300.
Además, las páginas entran por ventanas. Una ventana de páginas es el grupo de páginas que el modelo tiene a la vista mientras escribe, y la memoria de las páginas que quedan fuera se libera. La receta de servicio usa 10. Las ventanas más pequeñas gastan menos memoria, y las notas de los autores dicen que pueden empeorar la unión del contenido entre páginas. El modelo en sí es pequeño: 6,7 GB en disco.
El mérito es del equipo de Baidu. Shu Wei, Jingjing Wu y Qunyi Xie encabezan el paper como contribuidores principales, junto a otros once contribuidores. Partieron de su primer Unlimited OCR y de DeepSeek-OCR, cuyas piezas reutiliza el modelo. Así que parte del mérito es del equipo de DeepSeek-OCR. Baidu publicó los pesos y el código con licencia MIT, que permite el uso comercial. También incluyó en el repositorio del modelo una versión parcheada de SGLang, el framework abierto de servicio, con una receta completa. El mérito del servidor en sí es del proyecto SGLang. Lo nuestro fue el resto: empaquetar ese servidor detrás de una API, probarlo con un documento real, revisar la salida y comprobar que una tarjeta de 16 GB hace el trabajo.
La prueba: una guía fiscal de 59 páginas con una tabla que ocupa siete
Queríamos un documento que castigue la lectura página a página. La IRS Publication 15 (2026), la "Employer's Tax Guide" de Estados Unidos, encaja. Tiene 59 páginas, es de dominio público y en la mayoría de sus páginas hay párrafos que cruzan el salto de página. La sección 15 contiene una tabla que va de la página 46 a la 52.
Ejecutamos la versión de SGLang de los autores, sin cambios, en una RTX 4090, una tarjeta gaming de 24 GB. Cada ejecución mandaba el PDF entero en una sola petición y recibía la respuesta en streaming.
Para puntuar la salida necesitábamos una referencia que nadie hubiera tecleado a mano. El PDF lleva su propia capa de texto, así que comparamos con ella el texto del modelo, carácter a carácter. La puntuación es la proporción de caracteres que habría que cambiar para convertir uno en el otro: 0 % es idéntico. Es estricta con el orden de lectura, así que un recuadro lateral leído antes que su párrafo resta puntos aunque todas las palabras estén bien. ¿Por qué no volcar sin más esa capa de texto? Da una referencia gratuita y exacta para puntuar, pero no da orden de lectura, posiciones de bloque, tablas HTML ni etiquetas entre páginas. Eso lo añade el modelo.
Fue un solo documento, en inglés, leído una vez por configuración, con una petición cada vez. Solo tenía páginas digitales limpias, así que los escaneos, donde no hay capa de texto, quedan sin probar. El documento más largo tenía 59 páginas, no los cientos a los que apuntan los autores, así que lo que digamos de un libro de 300 páginas es lo que afirman ellos, no una medición nuestra. Los demás casos sin probar están en el apéndice.
Resultados: 59 páginas en menos de 4 minutos, a un 4,2 % del texto del PDF, sin recortes
Una vista por página ganó tanto en velocidad como en precisión.
| PDF de 59 páginas, una petición, RTX 4090 | Recortes de página (por defecto de los autores, fracción de memoria 0,7) | Una vista por página (fracción de memoria 0,5) |
|---|---|---|
| Documento completo | 6 min 45 s, 8,7 páginas/min | 3 min 44 s, 15,8 páginas/min |
| Distancia al texto del propio PDF | 38,1 % (2,4 % sin las páginas 46 a 54) | 4,2 % (2,45 % sin las páginas 46 a 54) |
| Páginas 46 a 52 de la tabla | bucles en las páginas 46 y 51, páginas 47, 50 y 52 vacías | tablas HTML, cinco páginas entre un 20 % y un 46 % lejos |
La ejecución con una vista usó además una fracción menor de la memoria de la tarjeta. En el modo con recortes la fracción no cambió la velocidad, pero en este modo no lo comprobamos. La velocidad se mantuvo estable de la primera página a la última.
En el texto corrido los dos modos fueron buenos. Si se dejan fuera las páginas de la tabla, los dos quedaron a un 2,4 % del texto del PDF, dos o tres caracteres de cada cien. El 4,2 % del modo rápido sale sobre todo de las páginas de la tabla: cinco de sus siete páginas por encima del 20 % son de la tabla. Las otras dos son la portada, llena de enlaces, y una página leída fuera de orden.
El modelo marca cada párrafo cortado por un salto de página como continuación en la página siguiente, entre 31 y 34 por ejecución aquí. La tabla volvió en siete trozos, uno por página, como la daría un parser página a página. La diferencia son las etiquetas: cinco de las seis uniones llevan una. La unión de la página 49 no lleva ninguna. Esas etiquetas son lo que necesita un programa para recomponer la tabla en una sola.
Dónde falla: los recortes con una tabla larga, y una sola ventana para todo el documento
El modo por defecto falló en la única tabla que importaba. En la página 46 metió ocho filas de la tabla en una sola celda. En la celda siguiente escribió una frase, "Taxable if wages subject to social security tax and Medicare tax", 1.508 veces. Era un pedal de loop que nadie apagó, cortado solo por el tope de 20.000 tokens por página (los tokens son los trozos de palabra que lee y escribe un modelo). Las páginas 47, 50 y 52 volvieron vacías. En la página 51 volvió a entrar en bucle y escribió "Exempt." 3.088 veces. En la página 53, justo después de la tabla, escribió 6.658 celdas de tabla vacías. Se recuperó en la página 55. La protección contra repeticiones de los propios autores estaba activada. Volvimos a mandar solas las páginas 46 a 54 y obtuvimos el mismo bucle en la página 46. Así que así se comporta el modelo con esta tabla en este modo, no es un accidente de memoria.
En el modo con recortes, una sola ventana para todo el documento no entró. La receta de servicio tiene un interruptor que quita las ventanas y le da al modelo las 59 páginas a la vez. Con recortes, solo las imágenes de las páginas ocuparon unos 89.000 de los 131.072 tokens que el modelo puede manejar a la vez. Quedó muy poco sitio para la respuesta, y se paró a mitad de la página 27. El servidor no da ningún error aquí. Con los ajustes de la receta acorta la respuesta en silencio, así que solo te das cuenta si cuentas las páginas. En las 26 páginas que sí escribió, la calidad igualó a la de la ejecución por ventanas, un 3,67 % en ambas.
Los autores mencionan un límite más en su paper. Como el modelo solo mira unas pocas páginas a la vez, no tiene en la cabeza el documento entero. Eso limita lo bien que entiende la estructura del documento completo, por ejemplo qué título va debajo de cuál.
Qué GPU: una tarjeta real de 16 GB leyó la guía entera en unos diez minutos y medio
Una tarjeta real de 16 GB funcionó: una RTX 2000 Ada, una tarjeta de workstation pequeña de 70 vatios, con una vista por página. Su calidad igualó a la de la 4090.
El servidor reserva una fracción fija de la tarjeta que encuentre, el 70 % por defecto, y la llena de memoria de trabajo. Así que los 19,4 GB de la 4090 no son lo que necesita el modelo. En una tarjeta más grande simplemente reserva más. Para emular una tarjeta de 16 GB, le dijimos al servidor de la 4090 que reservara la mitad. La fracción no cambió la velocidad: con recortes fue a 8,7 páginas por minuto tanto al 70 % como al 50 %.
| Tarjeta | Cómo se ejecutó | Pico de memoria | Velocidad | Salida |
|---|---|---|---|---|
| RTX 4090 24 GB, real | recortes, 70 % de la tarjeta | 19,4 GB | 8,7 páginas/min | bucles en la tabla, como en todas las ejecuciones con recortes que la cubrieron |
| Límite de 16 GB en la 4090, emulado | recortes, 50 % de la tarjeta | 14,7 GB | 8,7 páginas/min | el mismo bucle, texto casi idéntico |
| Límite de 16 GB en la 4090, emulado | una vista por página, 50 % de la tarjeta | 15,2 GB | 15,8 páginas/min | a un 4,18 % |
| RTX 2000 Ada 16 GB, real | una vista por página, valores por defecto (70 %) | 13,8 GB | 5,6 páginas/min | a un 4,23 % |
| RTX 2000 Ada 16 GB, real | recortes, solo páginas 1 a 10 | 13,8 GB | 5,0 páginas/min ida y vuelta | idéntica a la 4090 en esas páginas |
Las filas emuladas muestran que la memoria cabe, no lo rápida que es una tarjeta pequeña.
En InferenceKey: la versión de SGLang de los autores detrás de una API, lista en 61 a 143 segundos con los ficheros en caché
En tu propia GPU puedes ejecutar exactamente el servidor que usan los autores, sin cambios, detrás de una API que tu aplicación ya sabe llamar. InferenceKey no trae soporte listo para este modelo, porque necesita la versión parcheada de SGLang de Baidu en lugar de la estándar. Así que escribimos un backend propio: un fichero corto de Python que InferenceKey instala y ejecuta en tu máquina con GPU. Descarga los pesos en una versión fija e instala el servidor de los autores desde el repositorio del modelo. Tu aplicación lo llama igual que llama a la API de chat de OpenAI, con un enlace al PDF en el mensaje, y recibe el Markdown a medida que se escribe.
Un paso de preparación ya había descargado los pesos e instalado el servidor. A partir de ahí, el primer arranque tardó 143 segundos, la mayor parte en que el servidor se preparase para la tarjeta. Los reinicios tardaron entre 61 y 63 segundos, y la tarjeta de 16 GB estuvo lista en 96. En una máquina sin nada en caché, suma unos 70 segundos de descarga e instalación. Los ajustes que mueven la memoria, la ventana de páginas y la fracción de la tarjeta, son variables normales en el ejemplo. Las opciones para un documento concreto, como un rango de páginas o crop_mode=false, van en el texto del mensaje.
Dos asperezas con las que también te vas a encontrar:
- El paquete de Python de InferenceKey publicado es anterior a este tipo de backend. Si se instala de la forma habitual, el backend no arranca. La solución provisional es instalar nuestra librería directamente desde GitHub en la máquina con GPU, como explica el ejemplo. Estado: abierto, a la espera de la próxima versión del paquete.
- Un PDF enviado dentro de la petición nunca llega a la máquina con GPU. El trabajo entra en la cola pero nunca llega, y el cliente se rinde a los 180 segundos. Manda en su lugar un enlace al PDF, y el backend lo descarga. Estado: abierto, causa todavía sin encontrar.
¿Merece la pena usarlo? Sí para PDFs como este, en una tarjeta de 16 GB y sin recortes
- Si procesas informes largos, manuales o contratos con tablas y párrafos que cruzan páginas, merece la pena probarlo. Una petición por documento te da el texto, las posiciones y etiquetas entre saltos de página, con una licencia que permite el uso comercial.
- Si tus documentos tienen tablas largas, pon
crop_mode=falsey revisa las cifras de las páginas de tabla. - Si mantienes los recortes, deja las ventanas de 10 páginas por defecto y cuenta las páginas que vuelven.
- Si tu tarjeta es pequeña, una de 16 GB basta para un documento como el nuestro.
- Si necesitas cientos de páginas, el benchmark de 100 a 300 páginas de los autores le da un 77, y al siguiente modelo un 34 (su prueba, no la nuestra). Nosotros probamos 59 páginas, así que comprueba tú uno largo.
Para procesar la guía del IRS en tu propia GPU NVIDIA, publica el backend con python publish.py y ejecuta python main.py desde el ejemplo del SDK. Obtienes el documento entero en Markdown con marcadores de página, tablas HTML y tiempos. Necesitas un proyecto de InferenceKey y una tarjeta NVIDIA de 16 GB o más. El README del ejemplo enumera las claves.
Para ingenieros
Modelo y ficheros
Ficha del modelo, GitHub (baidu/Unlimited-OCR), paper (PDF en el repo del modelo), MarathonDocBench.
- Repo
baidu/Unlimited-OCR-2, licencia MIT, sin acceso restringido, shac14071b549f4fcab10909f3c4acc6a2edb366947, lastModified 2026-10-29T09:18:46Z. createdAt en HF 2026-10-26T03:57:46Z; la nota de lanzamiento de la ficha dice 2026/10/27. - Metadatos de safetensors: 3.343.978.240 parámetros BF16. Paper: decoder MoE, 3B en total y 500M activos por token (una figura lo etiqueta como "3B-MOE-A570M" y la tabla 3 como "3B-A0.5B").
- Dos shards, 4.998.430.312 + 1.689.875.264 bytes (unos 6,7 GB). El repo incluye también el wheel de SGLang de los autores
wheel/sglang-0.5.20.dev13+g75b9b06b02-py3-none-any.whl(15,3 MB) y unHarryPotter.gifde 156 MB que reproduce un libro completo procesado en una sola petición. Almacenamiento total del repo: 7,12 GB. No verificamos ninguna versión FP8 ni GGUF. - Requisitos del wheel: torch 2.13.0 (cu130), flashinfer 0.6.18 cu13, sglang-kernel 0.4.7, transformers 5.12.1, así que hace falta un driver de CUDA 13. Backend de atención
unlimited_ocr_v2(Triton, PDL solo en sm90+, así que Ada funciona). - Caminos de inferencia de la ficha: Transformers (
infer_multi, probado con Python 3.10, torch 2.13.0, transformers 4.52.1 en una A800-80GB) y SGLang (recomendado para servir) en un venv de Python 3.10 creado con uv, conpymupdf==1.27.2.2yfastokens==0.3.2. - El
infer.pyde GitHub usa por defecto el modo gundam (recortes) y pasa al modo base en documentos de varias páginas cuyo presupuesto de tokens se queda corto. Usamax_model_len131072 para MPDocBench y 786432 para MarathonDocBench.
Mecanismo (paper, secciones 3.3 y 3.4)
Ficha del modelo: SR-SWA "compresses text-visual attention interactions from ultra-long sequences down to a fixed-size set of working references (e.g., 512 tokens)", con lo que la latencia y la memoria de decodificación por paso se mantienen casi constantes sea cual sea la longitud del documento.
SR-SWA (Sparse Reference Sliding Window Attention) = Page Gate (restringe la atención visual a bloques de las páginas objetivo, con una coordenada de página acotada que alterna 0-1 más una coordenada dentro de la página) + Token Sieve (un router alpha-entmax que se queda con los top-k bloques, entrenado de extremo a extremo, sin pérdida de destilación), más una ventana local fija. El Unlimited-Horizon Decoding Paradigm divide el documento en bloques de páginas solapados que comparten una página frontera cuya KV se reutiliza, y libera la KV visual fuera del bloque activo. Entrenamiento: 25 x 8 nodos H800, batch global de 1.600, secuencia máxima de 64K, inicializado desde Unlimited OCR v1, DeepEncoder congelado, MS-Swift. Sección 3.2: el modelo hereda la base de Unlimited OCR (v1, que llevó el procesado multipágina a decenas de páginas con un límite de entrada de 40 páginas) y usa DeepSeek-OCR como fundamento (DeepEncoder más un decoder MoE).
Lista de autores (sección 8 del paper): contribuidores principales Shu Wei, Jingjing Wu, Qunyi Xie; contribuidores Lingshu Zhang, Xiangcheng Du, Yannian Fu, Mengjie Wang, Zuyi Wang, Zhichao Liu, Yangliu Xu, Youyang Yin, Huanhuan Liu, YY, Yi Yang (Baidu ERNIE Team).
Lo que afirman los autores (no reproducido por nosotros)
- Aceleraciones por paso de 7,0x y 5,6x frente a Full Attention y R-SWA a escala de cientos de páginas (figura de latencia en modo Gundam, batch 3, 1.024 tokens por página).
- Tabla 4 (MarathonDocBench): pico de memoria KV con B=1 de 47,00 GB (estándar) frente a 1,77 GB (unlimited-horizon); throughput con B=16 de 360 frente a 1.315 TPS.
- MarathonDocBench, el benchmark propio de los autores publicado junto con el modelo, resultado global (100 documentos de 100 a 300 páginas, unas 18k páginas, mezcla de chino e inglés): Unlimited OCR 2 77,06, Kimi-K3 33,74, Gemini-3.8-Flash 28,61, Qwen-3.8-Flash-Next 27,8, Gemini-3.1-Pro Preview 26,97, Qwen-3.8-Max 22,93, Minimax-M3 17,97, DeepSeek-4.1-Flash 12,34, GLM-5.3-Flash 7,51. Anotaciones con Apache-2.0, imágenes solo para investigación.
- MPDocBench (hasta 30 páginas), resultado global: Unlimited-OCR 2 84,59, Qwen3.8-Max 78,30, Qwen-3.8-Flash-Next 77,36, Gemini-3.8-Flash 76,25, Gemini-3.1-Pro Preview 71,79, Unlimited-OCR v1 61,89. La v1 no aparece en MarathonDocBench por su límite de entrada de 40 páginas.
- Limitación (sección 6 del paper): la atención dispersa no conserva la información global del documento, lo que limita la estructura a nivel de documento, como la jerarquía de títulos. La diversidad de los datos de entrenamiento es limitada.
Montaje
- Una RTX 4090 24 GB en nuestra nube (driver 595.91.07, CUDA 13.2, 450 W, disco de contenedor de 100 GB) para las ejecuciones principales, y una RTX 2000 Ada Generation 16 GB (70 W, sm 8.9, mismo driver) para la escalera. Las dos registradas como workers en un manager local de InferenceKey. Producción no se tocó en ningún momento.
- Backend propio
unlimited-ocr-2(versión final 0.1.2):setup()descarga la revisión fijada, crea un entorno de Python 3.10 con uv y el wheel de los autores (unos 60 s; no hizo falta el plan B de Transformers), extrae elDeepseekOCRNoRepeatNGramLogitProcessorde los autores y arrancasglang.launch_servercon los flags y las variables de entorno de la ficha.chat_stream()recibe un enlace a un PDF en el texto (o una partefilede OpenAI, o imágenes), renderiza las páginas con PyMuPDF a 300 dpi, construye"<PAGE><image>" * n + "Multi page parsing."y manda una petición en streaming. - Parámetros de la petición (de la ficha): temperature 0,
max_tokens = 8000 x pages, protección de n-gramasngram_size 35,window_size 1024(multipágina),page_token_id 128827,eos_token_id 1,max_page_tokens 20000. - Flags del servidor:
--mem-fraction-static 0.7,--max-running-requests 8(ficha: 64),--max-prefill-tokens 2048,--enable-custom-logit-processor,--allow-auto-truncate,--disable-radix-cache, buckets de CUDA graph de prefill dimensionados amax_prefill_tokens. Variables de entorno:SGLANG_UOCR_EANABLE_DOC_LIMIT=1(así lo escriben los autores; 0 = una sola ventana para todo el documento),SGLANG_UOCR_DOC_GUNDAM_PAGE_WINDOW=10,SGLANG_UOCR_DOC_BASE_PAGE_WINDOW=10,SGLANG_UOCR_MAX_PAGE_TOKENS=20000,SGLANG_OPT_UOCR_SAM_REL_POS_BIAS_MB=64(el valor por defecto 512 "allows a single ~462 MiB allocation and can OOM"),SGLANG_UOCR_SHM_WRAP_MODEL_DATA=1,PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True. - Notas de memoria de la ficha: 0,75 deja muy poco margen con 32 o más peticiones concurrentes, 0,7 es estable;
--max-prefill-tokensdetermina un tensor temporal de unos[tokens, context/32], así que pasar de 4096 a 2048 reduce ese pico a la mitad; el bucket de CUDA graph de prefill más grande debe ser igual amax-prefill-tokens. - Referencia: la capa de texto del PDF (PyMuPDF). NED = Levenshtein / longitud máxima, tras pasar a minúsculas y quitar el marcado, las etiquetas de maquetación y los espacios en blanco.
Tiempo hasta estar listo
| Fase | Tiempo |
|---|---|
| Primer arranque en la plataforma, RTX 4090 (pesos y entorno en caché gracias a un paso de preparación) | 143 s, de los que el arranque de SGLang fueron 105,1 s, incluida la captura de CUDA graphs (graphs de prefill 23,5 s) |
| Descarga de pesos / entorno uv con el wheel | 10 s / 60 s (8 s / 51 s en la RTX 2000 Ada) |
| Reinicios tras redespliegues, RTX 4090 | 61 a 63 s |
| RTX 2000 Ada | 96 s (scheduler 48,4 s, CUDA graphs de prefill 18,8 s + decode 16,6 s) |
| Pool de KV | 160.640 tokens con fracción 0,7 y 83.840 con 0,5 en la 4090; 72.096 en la RTX 2000 Ada |
| Renderizado de 59 páginas a 300 dpi | 16,5 a 17,0 s en la CPU de la máquina con GPU |
Ejecuciones en la RTX 4090
Backend = la línea done: del propio backend. Cliente = ida y vuelta a través de la plataforma. Los tiempos hasta el primer token son del lado del backend; a través de la plataforma fueron 27,6 s (recortes), 21,2 s (una vista) y 71,2 s (una sola ventana).
| Ejecución | Modo | Páginas | Backend s | Primer texto s | Páginas/min backend / cliente | Tokens de prompt / salida | Pico MiB | Resultado |
|---|---|---|---|---|---|---|---|---|
| w10-full | recortes, ventana 10, fracción 0,7 | 59 | 387,87 | 10,53 | 9,1 / 8,7 (404,91 s) | 97.621 / 160.254 | 19.386 | bucle en la 46, otra vez en la 51 ('Exempt.' x3.088) y en la 53 (6.658 celdas vacías); 47, 50, 52 y 54 vacías, la 48 un fragmento de 412 caracteres; NED 38,06 %, 2,38 % sin la 46-54 |
| base-w10-full | una vista, ventana 10, fracción 0,5 | 59 | 206,01 | 3,34 | 17,2 / 15,8 (223,83 s) | 18.277 / 89.477 | 15.212 | NED 4,18 %, 2,45 % sin la 46-54; páginas por encima del 20 %: 1 (30,0 %), 8 (77,6 %), 46 (45,2 %), 47 (23,0 %), 48 (26,9 %), 49 (45,5 %), 51 (20,4 %); 16 tablas, 34 cross_text, 5 append_table |
| whole-full | recortes, una sola ventana | 59 pedidas, 27 escritas | 147,46 | 50,28 | (168,37 s cliente) | 89.331 / 41.739 | 18.058 | cortada a mitad de la página 27 |
| cap16-w10 | recortes, ventana 10, fracción 0,5 | 59 | 386,56 | 9,86 | 9,2 / 8,7 (407,62 s) | 97.621 / 160.242 | 14.670 | igual que w10-full |
| table-gundam | recortes | 46-54 | 156,14 | 8,27 | 3,5 / 3,4 | 13.631 / 63.805 | 14.670 | el mismo bucle en la 46, 47/49/52 vacías |
| table-base | una vista | 46-54 | 25,04 | 2,84 | 21,6 / 18,7 | 2.471 / 9.861 | 15.150 | 7 tablas, NED del documento 11,0 %, página 46 0,68 %, páginas 48/49/51 26-37 %; 5 append_table |
- Decode de unos 430 a 435 tok/s en modo con recortes y unos 445 tok/s en modo base con batch 1, constante a lo largo del documento. La liberación de ventanas se ve en el log de SGLang (
#tokende 29.248 a 19.936 entre ventanas). - Documento entero frente a ventanas en las páginas 1-26 (modo con recortes): NED 3,67 % en ambos casos. 4 de 26 páginas idénticas byte a byte; el resto difiere en comillas y pequeños cambios de redacción.
- Una sola ventana, mensaje exacto del servidor:
Requested token count (89331 input + 472000 new) exceeds the model's context length (131072 tokens). Truncating max_new_tokens.La respuesta se para sin error por--allow-auto-truncate. - Las etiquetas
append_tablese contaron, no se siguieron: la tabla vuelve en 7 trozos en las páginas 46-52, y solo 5 de las 6 uniones están etiquetadas (páginas 47, 48, 50, 51, 52; la tabla de la página 49 no tiene ninguna, en las dos ejecuciones base). No recompusimos los trozos en una sola tabla ni comprobamos que encajen bien. - Formato de salida:
<PAGE>por página,<BLOCK>type[x1, y1, x2, y2]<FORK>textpor bloque en una cuadrícula de 1000 x 1000, tablas en HTML. Enlaces entre páginas:cross_text/append_text(entre 31 y 34 en 59 páginas),append_tableen las continuaciones de tabla.
Página 46, una vista por página (primeras líneas):
<BLOCK>title<LEVEL1>[66, 41, 895, 66]<FORK>15. Special Rules for Various Types of Services and Payments
<BLOCK>table[64, 104, 936, 884]<FORK><table><tr><td rowspan="2">Special classes of employment and special types of payments</td><td colspan="3">Treatment under employment taxes</td></tr>...<tr><td>1. Service on farm in connection with cultivating soil; ...</td><td>Taxable if wages subject to social security tax and Medicare tax.</td><td>Taxable if $150 test or $2,500 test in section 9 is met.</td><td>Taxable if either test in section 14 is met.</td></tr>
La misma página en modo con recortes:
<td>Agricultural labor:1. Service on farm ... 8. Handling or processing commodities ...</td><td>Taxable if wages subject to social security tax and Medicare tax.Taxable if wages subject to social security tax and Medicare tax. ... (x1,508)
Escalera de VRAM
| GPU o límite | Configuración | Pico de VRAM | Tiempo para el PDF de 59 páginas | Salida correcta | Real o emulado |
|---|---|---|---|---|---|
| RTX 4090 24 GB | recortes, fracción 0,7, ventana 10 | 19.386 MiB | 387,9 s backend, 8,7 páginas/min | sí (el bucle de la tabla es comportamiento del modelo, igual en todas las ejecuciones con recortes que cubrieron las páginas 46-54) | real |
| RTX 4090 24 GB | recortes, una sola ventana | 18.058 MiB | 147,5 s, parada en la página 27 | no (límite de contexto) | real |
| Límite de 16 GB en la 4090 | recortes, fracción 0,5, ventana 10 | 14.670 MiB | 386,6 s, 8,7 páginas/min | sí, el mismo bucle; 13 páginas idénticas byte a byte, el resto con diferencias mínimas | emulado |
| Límite de 16 GB en la 4090 | una vista, fracción 0,5, ventana 10 | 15.212 MiB | 206,0 s, 15,8 páginas/min | sí, 4,18 % | emulado |
| RTX 2000 Ada 16 GB (70 W) | una vista, valores por defecto (fracción 0,7, ventana 10) | 13.819 MiB | 614,7 s backend, 634,1 s ida y vuelta, 5,6 páginas/min | sí, 4,23 % | real |
| RTX 2000 Ada 16 GB | recortes, valores por defecto, páginas 1-10 | 13.819 MiB | 116,7 s backend (5,1 páginas/min), 120,5 s cliente (5,0) | sí, idéntica a la 4090 | real |
Unos 147 tok/s en la RTX 2000 Ada frente a unos 440 en la 4090. Sin probar: 12 GB o menos, recortes en las 59 páginas en una tarjeta real de 16 GB, concurrencia por encima de 1, un parser página a página con la misma guía, recomponer los trozos de la tabla, niveles de título, el camino de Transformers, versiones FP8 o GGUF, un documento de 100 páginas, una sola ventana para todo el documento con crop_mode=false (su prompt de 59 páginas fue de 18.277 tokens frente a 89.331 con recortes, así que puede que entre en el contexto de 131.072).
Paso a paso con el ejemplo del SDK
Ejemplo en GitHub, commit 944a21f en main de inferencekey-sdk. Ficheros: backend.py, publish.py (api="openai-chat"), main.py, requirements.txt, .env.example, README.md.
cp .env.example .env    # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY, INFERENCEKEY_PROJECT, IK_WORKER_ID,
                        # plus INFERENCEKEY_TENANT_ID and INFERENCEKEY_USER_TOKEN (dashboard session token) for the upload
pip install -r requirements.txt
python publish.py       # once: builds dist/*.tar.gz and uploads it (only if TENANT_ID and USER_TOKEN are set)
IK_PDF=https://www.irs.gov/pub/irs-pdf/p15.pdf python main.py
-
Sin
INFERENCEKEY_TENANT_IDeINFERENCEKEY_USER_TOKEN,publish.pysolo construyedist/*.tar.gz. Súbelo a mano desde Dashboard -> Custom backends. -
En el worker, apunta
INFERENCEKEY_SDK_PYTHON_DIRa una copia debindings/python/pythondemainde inferencekey-sdk antes de desplegar. El paquete de PyPI (0.260725.739) hace que el backend falle al importar (ver Problemas, 1). -
IK_WORKER_IDtiene que ser un worker NVIDIA con 16 GB o más y un driver de CUDA 13. La ubicación es privada, con una política de ejecuciónFIXED. Usamos un disco de contenedor de 100 GB. -
main.pycrea el workload si no existe, espera a que esté listo, procesaIK_PDF, guardaoutputs/<name>.mdyoutputs/<name>.json(páginas, segundos, páginas por minuto, tiempo hasta el primer texto) y borra el workload salvo queIK_KEEP_ALIVE=1. -
main.pyusa por defectoIK_CROP_MODE=falsetras esta prueba. El backend en sí mantiene el valor por defecto de los autores (crop_mode=true). Opcional:IK_PAGES=1-20. -
Ajustes del backend:
UOCR_PAGE_WINDOW(10; 0 = una sola ventana),UOCR_MEM_FRACTION_STATIC(0.7),UOCR_MAX_RUNNING_REQUESTS(8),max_prefill_tokens2048,max_page_tokens20000, dpi 300. -
Endpoint:
{base}/endpoint/{project}/{workload}/v1/chat/completions,"stream": true. Opciones en el texto del mensaje:"Parse this document: https://example.org/report.pdf pages 10-30 crop_mode=false dpi=200".
Problemas
- El SDK de PyPI es demasiado antiguo para backends propios de chat. Instalado con
pip install inferencekey, el backend falla al importar.inferencekey0.260725.739 en PyPI no tienechat()/chat_stream()para backends propios:cannot import name 'chat_completion' from 'inferencekey.backend'. Solución provisional: el SDK de GitHub en la ruta del worker (INFERENCEKEY_SDK_PYTHON_DIR). Abierto, necesita una versión en PyPI. - El PDF enviado dentro de la petición no llegó al worker. Un PDF de 1,7 MB dentro de la petición (2,2 MB de JSON) llegó a la cola de trabajos pero nunca al worker, y el cliente terminó al saltar el timeout de 180 s del primer token. La ruta acepta 8 MiB. Solución provisional: mandar un enlace, el backend lo descarga. Abierto, sin acotar.
- Se pierden los campos propios de primer nivel del chat. El worker solo reenvía a un backend propio los campos estándar del chat (
build_vllm_chat_stream_bodyenworker/src/jobs.rs). Solución provisional: opciones en el texto del mensaje. Abierto. - Manifiesto sin
api="openai-chat". El primerpublish.pyno lo incluía y se rechazaban las peticiones en streaming. Arreglado en el ejemplo (0.1.1). - SSE decodificado como Latin-1 por
requests(sin charset entext/event-stream). Arreglado enmain.pyconresp.encoding = "utf-8". - El modo con recortes entra en bucle con la tabla de 7 páginas (páginas 46-52) con la protección de n-gramas de los autores activada. Comportamiento del modelo, se cuenta tal cual.
- Una sola ventana para todo el documento corta en silencio con esta longitud (ver arriba).
- La etiqueta Access del panel mostraba "No access" para el workload mientras las llamadas funcionaban. Estético.
Vídeo de la demo
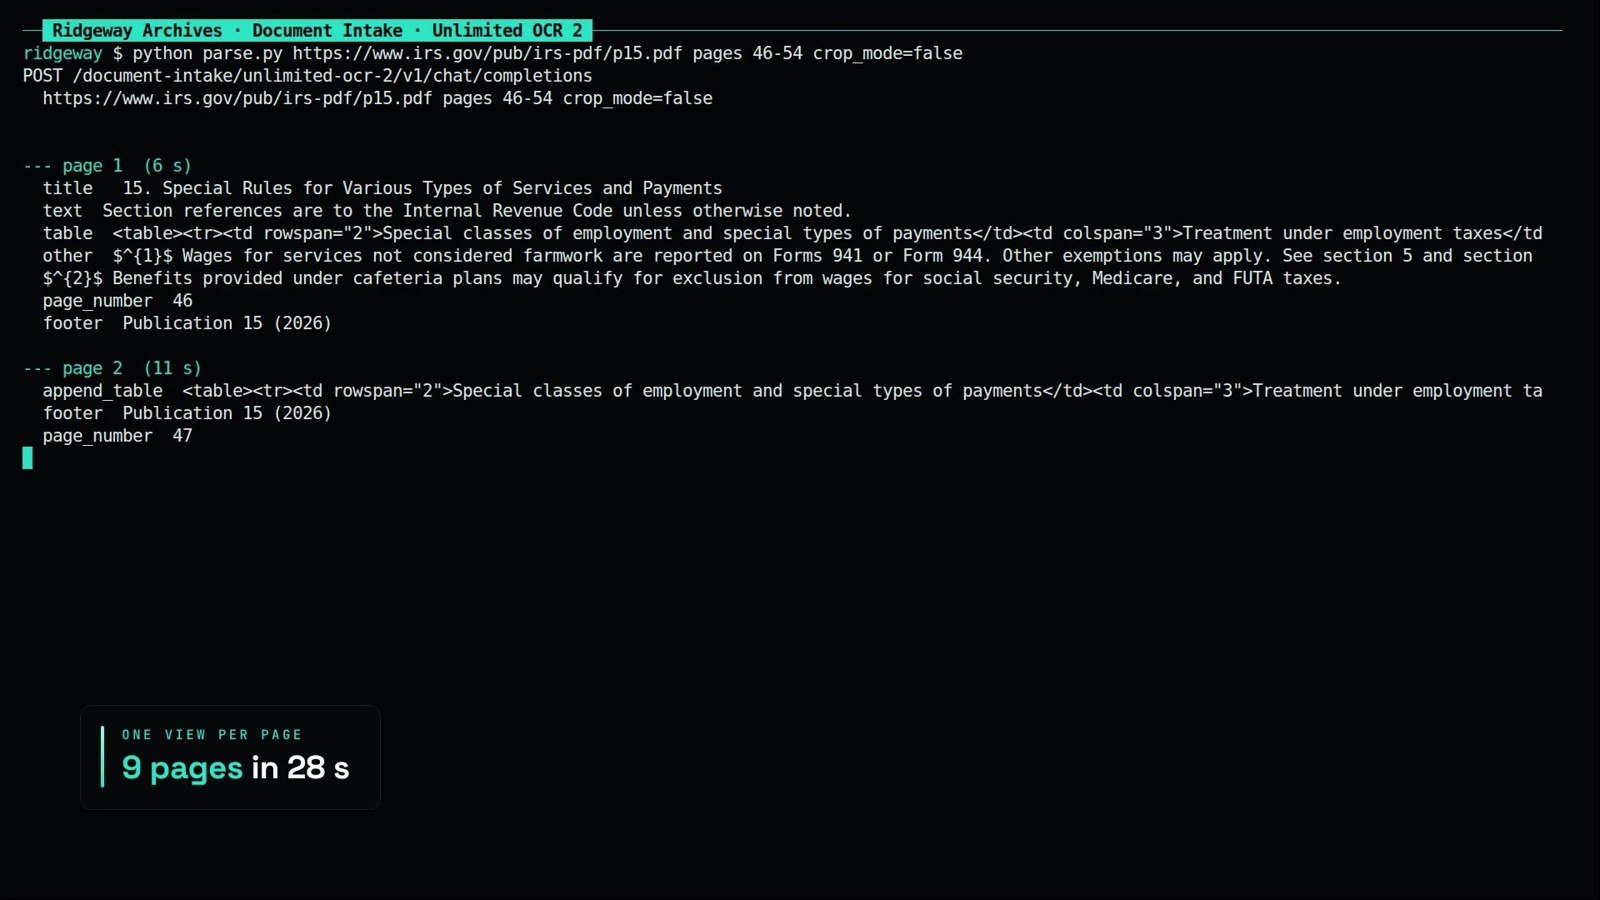
3 minutos y 10 segundos. El probador del panel procesa las páginas 7 y 8 (primer token en 3.268 ms, 10,02 s en total) y luego el terminal procesa las páginas 46 a 54 con una vista por página (9 páginas en 28 s, 19,3 páginas/min). También muestra la reproducción de los autores de un libro entero procesado en una sola petición y las cifras de su benchmark, señaladas como suyas.
Fuentes
- Ficha del modelo: https://huggingface.co/baidu/Unlimited-OCR-2
- Código: https://github.com/baidu/Unlimited-OCR
- Paper: https://huggingface.co/baidu/Unlimited-OCR-2/blob/main/Unlimited-OCR-2.pdf
- MarathonDocBench: https://huggingface.co/datasets/baidu/MarathonDocBench
- Documento de prueba: https://www.irs.gov/pub/irs-pdf/p15.pdf
- Dónde lo vimos: AI Search, 1 de noviembre de 2026, capítulo "Unlimited OCR 2" en el 05:48, https://www.youtube.com/watch?v=IGICYFyP_EI
- Nuestro ejemplo del SDK: https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/unlimited-ocr-2-pdf-parsing-custom-backend-private-nvidia