Groot-19B-A3B tient son contexte complet de 256K sur une seule RTX 5090 de 32 GB, et une limite de 24 GB ne suffit pas
Le modèle d'agent 19B de GrootTeam en FP8 sur une RTX 5090 : fenêtre complète de 262 144 tokens, 262 à 304 tokens/s, un prompt de 205K tokens bien répondu.
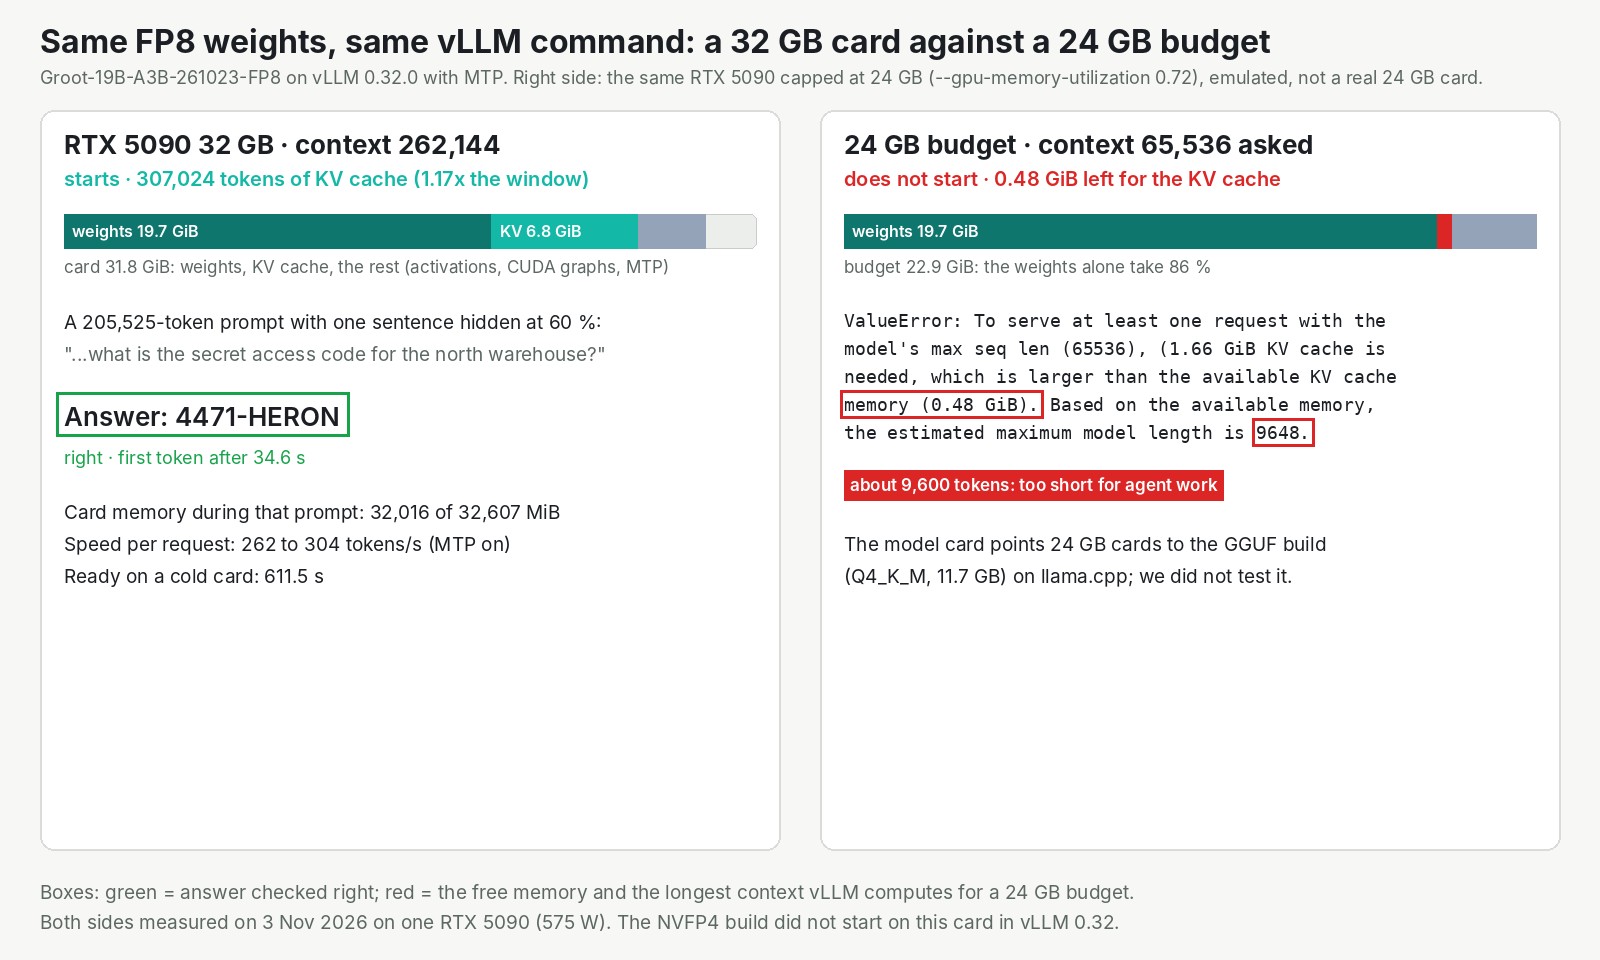
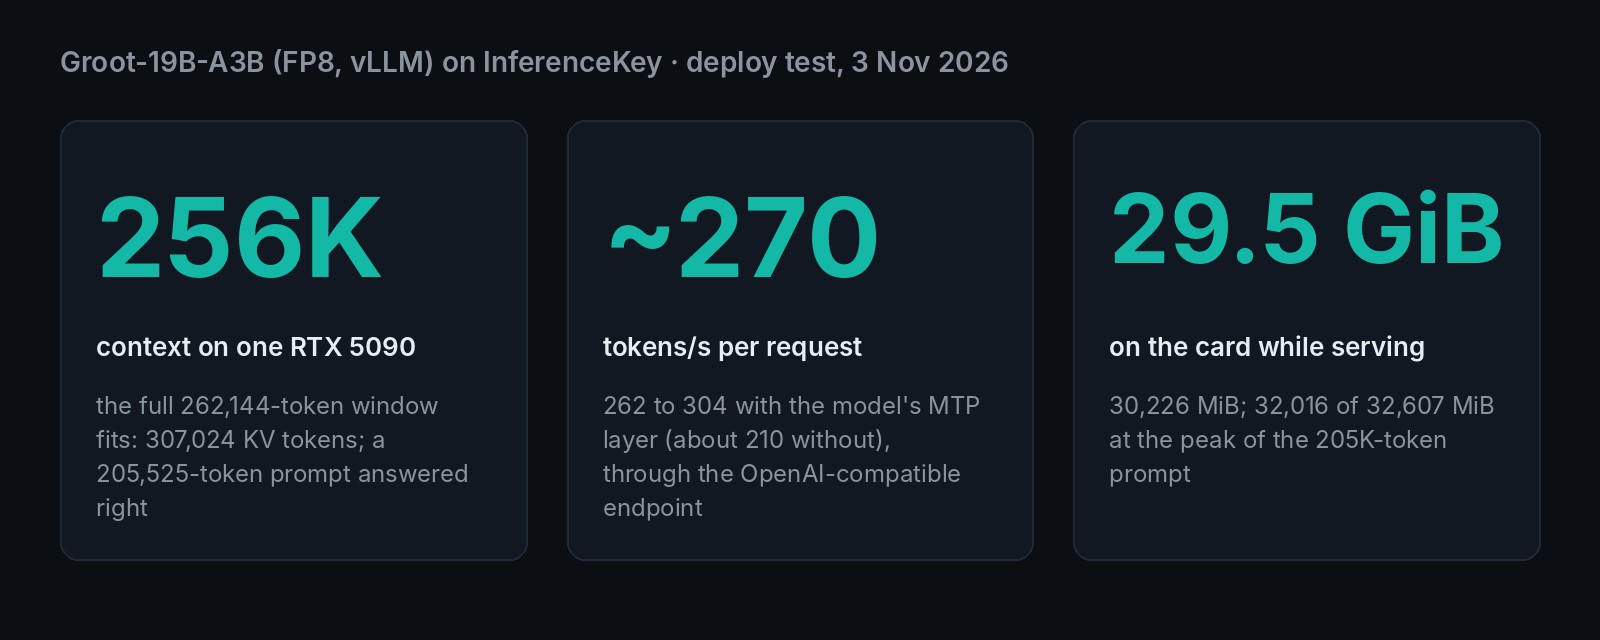
Selon ses auteurs, le contexte complet de 256K de Groot-19B-A3B tient sur une seule RTX 5090 de 32 GB. Nous avons vérifié sur notre cloud, et c'est vrai : les 262 144 tokens (les "256K") ont démarré, et un prompt de 205 525 tokens a reçu une réponse juste. Limité à 24 GB, le même fichier ne laissait de place que pour environ 9 600 tokens, trop peu pour du travail d'agent. Prévoyez donc 32 GB pour cette version. Nous avons utilisé la version compressée de 20,9 GB (FP8), vLLM, le serveur open source que notre plateforme fournit, et les réglages des auteurs. Pour une équipe qui possède son matériel, cela fait une fenêtre de 256K tokens sur une seule carte de gamme gaming.
| Ce que vous voulez savoir | Ce que nous avons mesuré |
|---|---|
| Plus petit GPU qui l'a fait tourner | une vraie RTX 5090, 32 GB, fenêtre complète de 262 144 tokens |
| Vitesse d'écriture, une requête | 262 à 304 tokens/s, 170 à 211 sans sa couche d'accélération |
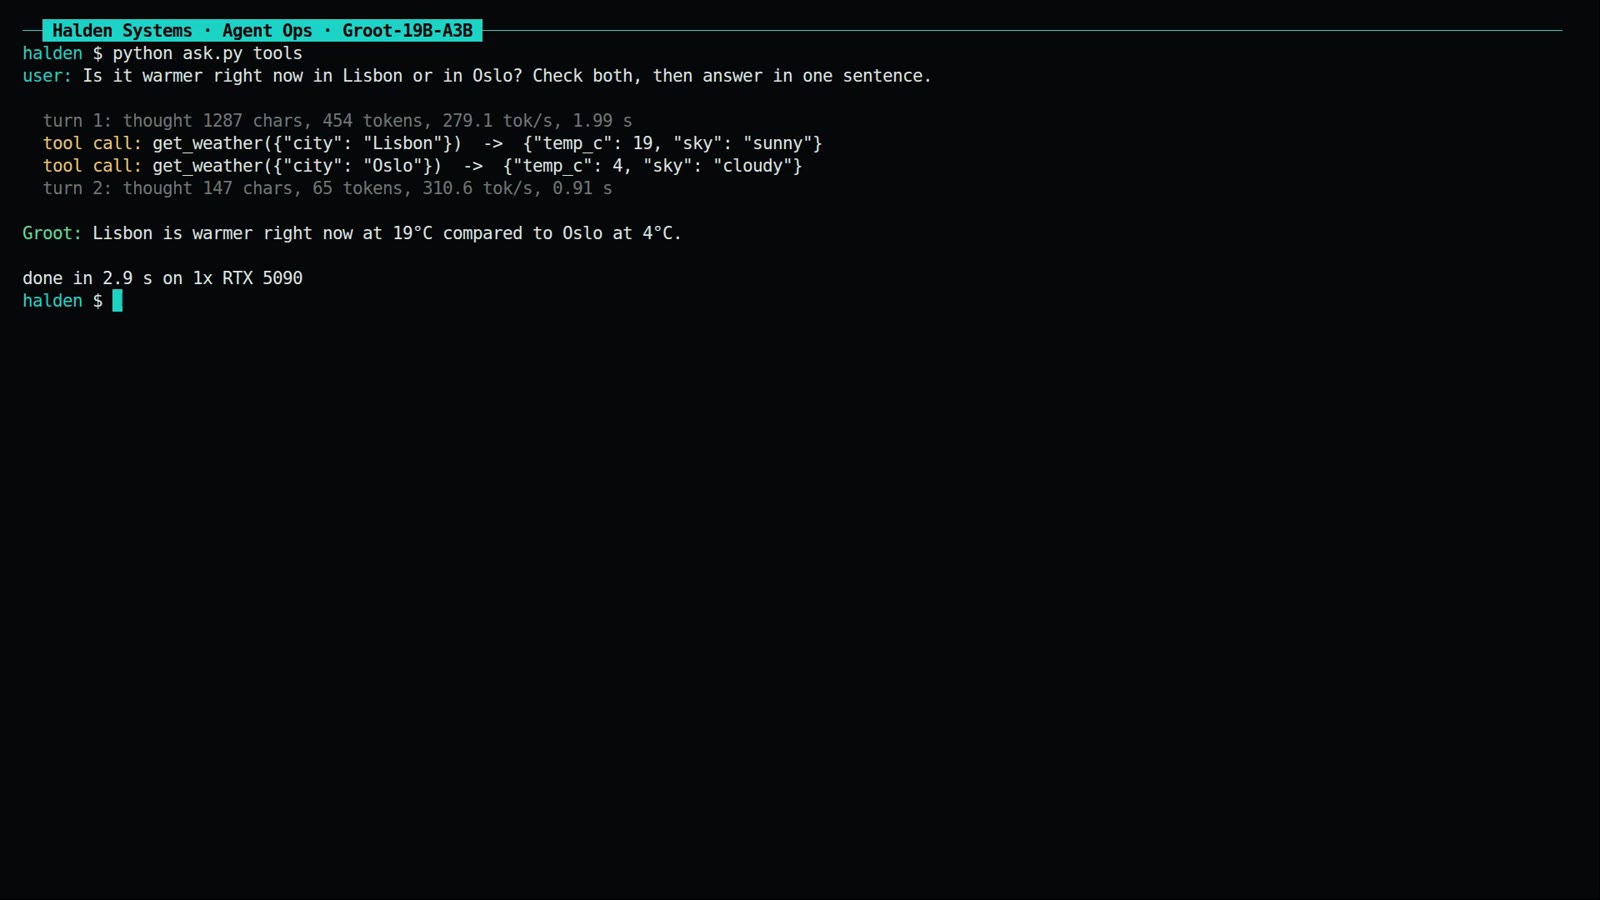
| Appels d'outils | JSON valide, deux appels dans un même tour plus la réponse en 1,8 s |
| 24 GB de mémoire (simulés sur la même carte) | ne démarre pas avec 64K tokens, 9 600 au maximum |
Un modèle 19B que ses auteurs placent devant son propre parent 35B
Groot-19B-A3B est construit à partir d'un modèle plus gros et réentraîné pour les agents. Ses auteurs annoncent qu'il bat l'original. GrootTeam est parti de Qwen3.6-35B-A3B, le modèle ouvert 35B de l'équipe Qwen, et l'a réduit à 19B. La page des auteurs ne dit pas comment. Ils l'ont réentraîné sur une petite quantité de données ouvertes, moins de 0,1 milliard de tokens, selon la page du modèle. Ils l'ont publié le 23 octobre en quatre versions, et nous l'avons repéré dans la vidéo d'actualités d'AI Search du 1er novembre.
Il fonctionne comme une grande équipe où seuls quelques spécialistes traitent chaque mot. Environ 3 milliards de ses 19 milliards de paramètres travaillent sur chaque mot. Il écrit donc vite, mais le GPU doit contenir les 19 milliards.
Dans le tableau des auteurs, il bat à la fois Qwen3.6-35B-A3B et Gemma-4-26B-A4B sur 12 benchmarks sur 16. Deux d'entre eux comptent le plus pour le travail d'agent :
- Terminal-Bench 2.1, où un agent travaille en ligne de commande : 52,1 contre 43,8 pour Qwen3.6 et 26,5 pour Gemma-4.
- NL2Repo, où un agent construit un dépôt de code entier à partir d'une description : 35,7 contre 28,8 et 16,6.
Les auteurs disent aussi que ses réponses étaient les plus courtes de 12 modèles : 23,1 % plus courtes que celles de Qwen3.6, 65,6 % plus courtes que celles de Gemma-4. Leur page demande de lire ce chiffre avec la précision, ce qui est juste. Ils ne le comparent qu'à des modèles ouverts de sa taille, pas aux modèles fermés phares actuels.
Il lit aussi les images : quand nous lui avons demandé de lire le graphique des auteurs, il a donné environ 42, contre 41,44 sur leur page. L'étiquette de licence des quatre dépôts indique Apache-2.0, qui autorise l'usage commercial, même si le fichier LICENSE vers lequel la page renvoie est absent. En plus du fichier complet de 38,9 GB, il existe des versions compressées de 20,9 GB (celle que nous avons testée), 13,5 GB et 11,7 GB.
"256K sur une carte" est une promesse sur la mémoire, et ce sont les poids plus petits de Groot qui font la place
La promesse porte sur la mémoire. Imaginez un bloc-notes. Un modèle sur un GPU a besoin de mémoire pour deux choses : ses propres poids, et un bloc-notes qui garde la conversation jusque-là. Les poids sont un coût fixe. Le bloc-notes grandit avec chaque token de contexte que vous autorisez. Groot garde l'architecture de Qwen3.6-35B-A3B : un quart du modèle prend des notes complètes sur chaque mot, le reste garde un court résumé. Le bloc-notes est donc aussi petit que celui de Qwen3.6. Ce qui libère la place, ce sont les poids, 19B au lieu de 35B.
La page des auteurs dit que les versions de 20,9 GB et 13,5 GB "run the full 256K context on one RTX 5090", et ajoute que c'est une estimation à partir des tailles mémoire. Nous sommes donc allés directement sur cette carte.
Les limites : un GPU, une requête à la fois, nos propres prompts, quelques exécutions chacun. Ce test vérifie si le modèle tient et à quelle vitesse il répond. Ses capacités d'agent viennent des benchmarks des auteurs : au-delà d'un test d'outils à deux appels, nous ne les avons pas testées, et aucune session d'agent en plusieurs étapes n'a tourné.
La fenêtre complète tient : un prompt de 205 525 tokens bien répondu, premier mot après 35 secondes
La fenêtre complète de 262 144 tokens a démarré sur la carte de 32 GB. Après le chargement des poids, il restait à vLLM 6,8 GiB pour le bloc-notes, assez pour 307 024 tokens : la fenêtre complète plus environ 45 000 tokens de marge. Un agent obtient donc la fenêtre complète. Plusieurs agents en même temps doivent chacun en prendre une plus courte.
Nous avons caché une phrase à 60 % d'un prompt de 205 525 tokens : le code d'accès d'un entrepôt. Le modèle l'a trouvée et a rendu le code. Le premier mot de la réponse est arrivé après 34,6 secondes, et la réponse complète après 40,3. Une bonne réponse montre que la fenêtre fonctionne. Elle ne teste pas le raisonnement sur de longs documents.
Le GPU était presque plein pendant ce temps. En service normal, il utilisait environ 93 % de la mémoire de la carte. Le long prompt laissait moins de 2 % de libre. C'est un van de tournée chargé si serré que l'ampli est coincé contre la porte : il roule, mais plus rien ne rentre.
Environ 270 tokens par seconde, et la couche d'accélération ajoute environ un quart
Une réponse de 4 457 tokens a pris environ 17 secondes à travers notre API, de 262 à 304 tokens par seconde. Les réponses courtes étaient en haut de cette fourchette, et celles de 4 500 à 5 200 tokens en bas. La réponse commençait en moins d'une seconde (0,26 à 0,61 s).
Une partie de cette vitesse vient d'une petite couche supplémentaire que les auteurs livrent avec le modèle. Elle devine les deux tokens suivants, et le modèle principal vérifie la supposition dans la même étape qu'il aurait consacrée à un seul. Quand les suppositions sont justes, plusieurs tokens sortent pour le prix d'un. Avec cette couche désactivée, vLLM a écrit de 170 à 211 tokens par seconde. Sur les réponses longues, la couche a ajouté environ 25 %, approximativement : une exécution passait par notre API, l'autre allait directement à vLLM.
Les appels d'outils sont revenus propres, et chaque réponse commence par une longue réflexion
L'appel d'outils a fonctionné du premier coup. Nous avons essayé l'exemple des auteurs eux-mêmes, la météo à Paris. Le modèle a demandé à notre code get_weather avec la ville en JSON valide en 0,9 seconde. Il a répondu avec le résultat en moins d'une seconde de plus.
Puis nous lui avons donné deux villes : fait-il plus chaud en ce moment à Lisbonne ou à Oslo ? En un seul tour, il a demandé les deux villes à la fois, deux appels côte à côte. Après la réponse de notre faux service météo, il a écrit "Lisbon is warmer right now with 19°C compared to Oslo's 4°C". L'échange complet a pris 1,81 seconde. Un framework d'agents attend exactement cette forme.
Prévoyez une longue réflexion même sur les questions courtes : Groot réfléchit avant chaque réponse, et la réflexion compte comme sortie. "The capital of Australia, in one word" a pris de 111 à 131 tokens, presque tous de réflexion, avant "Canberra". Une demande d'essai de 300 mots a produit de 2 383 à 7 156 tokens sur quatre exécutions. Dans les deux exécutions que nous avons comptées, 2 043 et 6 785 de ces tokens étaient de la réflexion. Nous n'avons pas fait tourner Qwen3.6 sur les mêmes prompts, nous ne pouvons donc ni confirmer ni réfuter les 23,1 % des auteurs. Fixez une limite de tokens généreuse.
Quel GPU : une vraie RTX 5090 de 32 GB en contexte complet, rien de plus petit n'a démarré
Seule la vraie carte de 32 GB a démarré. En dessous de 32 GB, rien de ce que nous avons essayé n'a démarré. Nous n'avions pas de cartes plus petites pour ce test, nous avons donc demandé à vLLM, sur la même 5090, de n'utiliser qu'une partie de sa mémoire. Cela émule le budget d'une carte plus petite, mais ce n'est pas une vraie carte plus petite.
- Budget de 24 GB, FP8, 65 536 tokens demandés : n'a pas démarré. Les poids seuls prennent 86 % de ce budget, ce qui laissait 0,48 GiB pour le bloc-notes. vLLM a calculé un maximum de 9 648 tokens, trop court pour un agent qui lit des fichiers et des résultats d'outils. La page des auteurs recommande de garder au moins 128K.
- Budget de 16 GB, la version de 13,5 GB, 32 768 tokens demandés : n'a pas démarré. Il a planté au démarrage, un défaut logiciel plutôt qu'un manque de mémoire, nous n'avons donc pas pu vérifier l'affirmation des auteurs pour cette version.
L'annexe liste tous les échelons que nous avons sautés.
Sur InferenceKey : le backend vLLM standard et la recette des auteurs eux-mêmes, prêt en environ 10 minutes
Un nouveau modèle ne devrait pas avoir besoin d'un moteur sur mesure, et celui-ci n'en a pas eu besoin. Notre plateforme fait tourner un modèle sur un worker, une machine GPU que vous possédez ou louez et que vous y connectez. Nous avons pointé le worker vers la version FP8 avec vLLM et les réglages des auteurs, et il a servi. De l'appel de déploiement à un serveur prêt, il a fallu 611,5 secondes sur une machine neuve. Environ 3 minutes sont allées à l'installation de vLLM, 28 secondes au téléchargement des 20,9 GB, et 5 minutes au préchauffage par vLLM du moteur et de sa couche d'accélération. Au redémarrage, avec ce travail sauvegardé sur disque, le préchauffage a pris 87 secondes au lieu de cinq minutes. Une partie de ce démarrage lent est de notre fait : notre worker omet une pièce précompilée, vLLM la compile donc lui-même. Statut : ouvert.
Le premier problème que vous rencontrerez est l'interrupteur de réflexion. La page des auteurs désactive la réflexion avec un réglage par requête. Notre API ne transmet pas encore ce réglage au modèle, la requête réfléchit donc quand même. Interrogé avec la réflexion désactivée, il a quand même raisonné avant de dire "The Eiffel Tower is located in Paris, France." Statut : ouvert de notre côté. Le contournement consiste à démarrer le serveur avec la réflexion désactivée par défaut, et le README de notre exemple montre le flag d'une ligne. Le reste de ce que nous avons trouvé, y compris deux petites erreurs sur la page des auteurs, est dans l'annexe.
Faut-il l'utiliser ? Oui s'il vous faut une fenêtre de 256K sur une seule carte de 32 GB
- Si vous voulez un long contexte sur du matériel qui vous appartient, c'est un candidat solide pour l'encombrement et la vitesse.
- Si votre carte a 24 GB, laissez de côté la version de 20,9 GB. Les auteurs suggèrent leur version de 11,7 GB, que nous n'avons pas testée.
- S'il vous faut des réponses de chat rapides, prévoyez la réflexion qui précède chaque réponse.
- S'il vous faut la version plus petite de 13,5 GB, testez-la vous-même sur une autre version du serveur : elle n'a pas démarré dans notre configuration.
Pour lancer le même déploiement, un appel d'outil et le graphique des auteurs sur votre propre GPU, lancez python main.py depuis l'exemple Groot-19B-A3B du SDK. Il faut un projet InferenceKey avec un token SDK et une clé d'API, et un worker NVIDIA privé de 32 GB ou plus. Il supprime le déploiement quand il a fini.
Pour les ingénieurs
Crédits
- Groot-19B-A3B-261023 : GrootTeam. Ils ont post-entraîné le modèle, publié les versions BF16, FP8, NVFP4 et GGUF (créées le 2026-10-23, sans accès restreint, étiquette
license:apache-2.0), la couche MTP, les recettes vLLM et SGLang, les tableaux de benchmarks et les graphiques que nous avons utilisés comme tests de vision. Dépôts : BF16, FP8, NVFP4, GGUF. - Modèle de base : Qwen3.6-35B-A3B de l'équipe Qwen.
- Service : le projet vLLM (0.32.0) et FlashInfer.
- Où nous l'avons repéré : AI Search, "AI finally sleeps, Gemini 4 Carbon, ETH cracked, energy-based models, Anthropic IPO: AI NEWS", mise en ligne le 2026-11-01, chapitre Groot à 47:33. La vidéo couvre quatre variantes de Groot ; cet article ne porte que sur le 19B.
- Notre part : le déploiement à travers la plateforme, les prompts et les tests, les mesures, l'échelle de VRAM, l'exemple du SDK et la vidéo de démo.
Modèle et fichiers
- Un modèle mixture-of-experts (MoE), l'architecture que nous avons expliquée dans notre article sur Sage-A1.5. Son architecture hybride vient de Qwen3.6-35B-A3B.
- Architecture
Qwen3_5MoeForConditionalGeneration: environ 19B paramètres au total plus une couche MTP de 0,4B, environ 3B actifs par token. 40 couches, 10 à attention complète (full_attention_interval4) et 30 à attention linéaire. Hidden 2048, 16 têtes d'attention, 2 têtes KV, head_dim 256, vocabulaire de 248 320. 128 experts routés plus 1 partagé, 8 routés actifs par token.max_position_embeddings262 144, extensible à environ 1M avec YaRN (facteur 4.0), selon la page des auteurs. - FP8 : blocs de 128x128, E4M3, activations dynamiques.
- Estimation approximative du KV pour les couches à attention complète : 10 couches x 2 têtes KV x 256 x 2 (K et V) x 2 B = 20 KiB par token, soit environ 5 GiB pour 256K, plus la couche MTP et les états de l'attention linéaire.
| Version | Taille sur la page | usedStorage HF | Sha du dépôt |
|---|---|---|---|
| BF16 | 38,9 GB | 38 883 686 769 B (aucun mtp.safetensors listé) | d089dadf |
| FP8 (E4M3, dynamique) | 20,9 GB | 20 946 032 529 B (6 shards + mtp.safetensors 450 538 880 B) | 49137722 |
| NVFP4 (experts NVFP4, attention FP8) | 13,5 GB | 13 546 543 381 B (4 shards + mtp.safetensors 883 452 968 B) | 8ff73aca |
| GGUF Q4_K_M | 11,7 GB | 11 657 618 560 B + mmproj BF16 902 822 016 B | 2fa1ec95 |
Affirmations des auteurs (non reproduites)
| Benchmark | Groot-19B-A3B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B |
|---|---|---|---|
| Terminal-Bench 2.1 | 52,10 | 43,82 | 26,52 |
| NL2Repo-Bench | 35,65 | 28,77 | 16,55 |
| LongBench v2 | 62,03 | 48,12 | 47,99 |
| Moyenne non pondérée sur 16 benchmarks | 41,44 | 38,08 | 30,05 |
- Devant les deux sur 12 benchmarks sur 16. 45,7 % de paramètres totaux en moins que Qwen3.6-35B-A3B, 26,9 % de moins que Gemma-4-26B-A4B.
- Budget de tokens : sortie moyenne la plus courte des 12 modèles mesurés sur les 16 exécutions, 23,1 % de tokens de sortie en moins que Qwen3.6-35B-A3B et 65,6 % de moins que Gemma-4-26B-A4B.
- Réglages d'évaluation : mode réflexion à l'effort par défaut, temperature 1.0, top_p 0.95, top_k 20, contexte de 256K. Terminal-Bench 2.1 avec l'agent Claude Code (max_output_tokens 128K, max_turns 500, timeout de 12 h). NL2Repo-Bench avec l'agent Claude Code, max_turns 1000, contexte de 80K. HLE jugé par gpt-5.5.
- "Où il tourne" (présenté comme estimé à partir de la capacité mémoire) : BF16 sur un GPU de 48 ou 80 GB ; FP8 et NVFP4 à 256K sur une RTX 5090 ; GGUF à 128K sur une RTX 4060 Ti de 16 GB et à 256K sur une RTX 4090/3090 de 24 GB ; 256K sur les machines à mémoire unifiée de 128 GB. Face à Qwen3.6-35B-A3B : sur 16 GB, Groot tourne à 128K alors que Qwen3.6 ne se charge pas ; sur une RTX 5090, 256K contre 64K.
- Prérequis d'exécution : Transformers >= 5.8.1, vLLM >= 0.19.1, SGLang >= 0.5.10. Réflexion activée par défaut, désactivée avec
chat_template_kwargs={"enable_thinking": False}, pas d'interrupteurs/thinkni/nothink. Échantillonnage recommandé en réflexion : temperature 1.0, top_p 0.95, top_k 20, min_p 0, presence_penalty 1.5. Code : temperature 0.6, presence 0. Sans réflexion : temperature 0.7, top_p 0.8.
Installation
- Une RTX 5090, 32 607 MiB, 575 W, driver 595.91.07 (CUDA 13.2), compute capability 12.0, disque de 100 GB, sur notre cloud (InferenceKey Cloud).
- Pourquoi cette carte : le plan de test prévoyait une L40S pour l'exécution principale, mais l'affirmation phare des auteurs cite la RTX 5090, l'exécution principale est donc allée directement sur elle. Les échelons serrés ont tourné sur la même machine sous des plafonds de mémoire émulés.
- Les requêtes passaient par l'endpoint compatible OpenAI de la plateforme (
/v1/chat/completions, streaming) ; les mesures de vitesse avec MTP désactivé allaient directement à vLLM. - Backend
vllmstandard,vllm_version="0.32.0"(installe Transformers 5.19 et torch 2.13 pour CUDA 13). SGLang non utilisé. - Un manager InferenceKey local construit depuis
origin/maince3af2dca amorcé le worker. La production n'a pas été impliquée. - Échantillonnage pour les mesures de vitesse : temperature 1.0, top_p 0.95, presence_penalty 1.5, streaming.
top_k=20vient degeneration_config.json.
Pas à pas avec l'exemple du SDK
- Clonez inferencekey-sdk et ouvrez
examples/groot-19b-a3b-fp8-agent-vllm-private-nvidia/(commit1c254204). - Compilez le SDK Python en local avec maturin (voir
examples/CONTRIBUTING.md, section 4) etpip install -r requirements.txt(requests>=2.31). cp .env.example .envet renseignezINFERENCEKEY_SDK_TOKEN(ik_sdk_, scopesworkload:readetworkload:write),INFERENCEKEY_API_KEY(ik_live_, avec le workload dansallowed_endpoints),INFERENCEKEY_PROJECTetIK_WORKER_ID(un worker NVIDIA privé de 32 GB ou plus avec un driver CUDA 13, 580 ou plus récent). Optionnel :GROOT_CONTEXT(par défaut 262144),GROOT_MTP(par défaut 1),IK_KEEP_ALIVE=1.python main.py. Le déroulé :ensure()d'un workloadvllmfixe épinglé à votre worker (ExecutionPolicy.FIXED),wait_until_ready(timeout=2400), une question simple avecgenerate_text(), le prompt des auteurs "I love Groot backwards" en streaming, un appel d'outilget_weatheravec le résultat de l'outil renvoyé, le graphique des auteurs comme image, les réponses dansoutputs/answers.json, puisdelete()sauf siIK_KEEP_ALIVE=1.
La commande que l'exemple déploie :
vllm serve GrootTeam/Groot-19B-A3B-261023-FP8 --max-model-len 262144 \
  --gpu-memory-utilization 0.92 --max-num-seqs 8 --enable-prefix-caching \
  --limit-mm-per-prompt '{"image": 2, "video": 0}' \
  --reasoning-parser qwen3 --enable-auto-tool-choice --tool-call-parser qwen3_coder \
  --speculative-config '{"method": "qwen3_next_mtp", "num_speculative_tokens": 2}'
Pour servir sans réflexion, ajoutez :
--default-chat-template-kwargs '{"enable_thinking": false}'
Sortie principale de l'exemple : le prompt à l'envers, 460 tokens en 2,12 s à 307,1 tok/s, réponse "toorG evol I" ; la question d'explication du MoE en 3,8 s.
Délais
- De
ensure()à prêt sur un worker à froid : 611,5 s. Installation de vLLM 0.32.0 environ 170 s, téléchargement des poids 27,8 s, chargement 51,7 s (19,67 GiB), préchauffage du moteur 312,6 s (compilation 37,5 s, deux captures de CUDA graphs et du spéculateur d'environ 2 min chacune, JIT FlashInfer). - Redémarrage à chaud (MTP désactivé, caches sur disque) : préchauffage du moteur 86,8 s (compilation 37,1 s), poids 19,24 GiB en 23,4 s.
Mémoire
--gpu-memory-utilization 0.92, contexte de 262 144, MTP activé : KV disponible 6,77 GiB = 307 024 tokens, concurrence maximale 1,17x. Pool de CUDA graphs 0,19 GiB.- Idem avec MTP désactivé : 7,37 GiB = 376 253 tokens, 1,44x.
- nvidia-smi chaque seconde : 30 226 MiB en service, pic de 32 016 sur 32 607 MiB pendant le prompt de 205K (530 à 566 W).
Vitesse (une requête, streaming)
| Chemin | Prompt | Tokens de complétion | Premier token | Décodage |
|---|---|---|---|---|
| Endpoint, MTP activé | "capital of Australia, one word" | 111 / 115 | 0,26 / 0,60 s | 284,4 / 304,1 tok/s |
| Endpoint, MTP activé | essai de 300 mots | 5 159 / 4 457 | 0,61 / 0,61 s | 265,9 / 261,9 tok/s |
| vLLM en direct, MTP désactivé | court | 125 / 131 | 0,59 / 0,54 s | 170,5 / 187,1 tok/s |
| vLLM en direct, MTP désactivé | essai | 2 383 / 7 156 | 0,79 / 0,68 s | 210,4 / 210,6 tok/s |
| Endpoint, MTP activé | prompt aiguille de 205 525 tokens | 119 | 34,62 s | prefill environ 5 900 tok/s transfert compris, total 40,27 s, "4471-HERON" juste |
- La comparaison MTP mélange deux chemins (MTP activé à travers la gateway, MTP désactivé en direct). Le surcoût de la gateway n'était pas mesurable dans notre précédent test de Sage-A1.5 et n'a pas été remesuré ici.
- Tokens de raisonnement (
usage.completion_tokens_details.reasoning_tokens, exécutions en direct) : 120 sur 125 pour la question courte ; 2 043 sur 2 383 et 6 785 sur 7 156 pour les essais.reasoning_contentde 9,6K à 23,7K caractères sur les essais.
Outils, vision, réflexion
- L'exemple
get_weatherdes auteurs :{"city": "Paris"}, JSON valide, 0,9 s ; réponse finale 0,96 s. - Deux villes : un tour avec deux appels
get_weatherparallèles (Lisbonne, Oslo ; 101 tokens de complétion, 0,93 s), puis la réponse (50 tokens, 0,88 s), 1,81 s au total. Prise enregistrée : 2,9 s (tour 1 de 454 tokens en 1,99 s, tour 2 de 65 tokens en 0,91 s). La longueur du raisonnement sur les tours d'outils n'a pas été capturée de façon fiable dans le test principal (0 caractère enregistré, alors que la prise enregistrée montre 1 287 et 147 caractères). - Graphique en nuage de points (9 279 tokens de prompt) : "Groot-19B-A3B ... approximately 42" en 4,12 s. Graphique en barres (16 329 tokens de prompt) : "52.10 ... Gemma-4 (26.52) and Qwen3.6 (43.82)" en 9,21 s, premier token à 7,25 s.
chat_template_kwargs={"enable_thinking": false}à travers l'endpoint : a quand même réfléchi (571 caractères de raisonnement, 157 tokens de complétion).
Échelle de VRAM
| GPU ou plafond | Config | VRAM de pic | Vitesse | Sortie OK | Réel ou émulé |
|---|---|---|---|---|---|
| RTX 5090 32 GB | FP8, ctx 262 144, util 0.92, MTP activé (l'exemple, à travers l'endpoint) | 30 226 MiB en service, 32 016 MiB pendant le prompt de 205K | 262 à 304 tok/s | oui | réel |
| RTX 5090 32 GB | FP8, ctx 262 144, util 0.92, MTP désactivé (vLLM en direct) | pas échantillonnée séparément | 170 à 211 tok/s | oui | réel |
| Plafond de 24 GB | FP8, ctx 65 536, util 0.72, MTP activé | n'a pas démarré | n/a | non | émulé |
| Plafond de 16 GB | NVFP4, ctx 32 768, util 0.48, MTP activé | n'a pas démarré (poids de 12,66 GiB chargés en 35,6 s) | n/a | non | émulé |
Erreur avec le plafond de 24 GB :
ValueError: To serve at least one request with the model's max seq len (65536), (1.66 GiB KV cache is needed, which is larger than the available KV cache memory (0.48 GiB). Based on the available memory, the estimated maximum model length is 9648.
Plafond de 16 GB, NVFP4 : vLLM journalise que le GPU n'a pas de support FP4 natif et se rabat sur une compression FP4 des poids seuls avec le kernel Marlin, puis la compilation JIT de FlashInfer 0.7.0.post1 de gen_gemm_sm120_group_gemm_fp8_groupwise_e4m3_bf16_majorfalse_sm120 et de ses voisins échoue (nvcc 13.0.88), et se termine par RuntimeError: Engine core initialization failed.
Non essayés : un échelon FP8 de 24 GB à 9,6K ou moins (le propre chiffre de vLLM dit qu'il démarrerait, mais les auteurs recommandent au moins 128K), la version GGUF sur llama.cpp, NVFP4 sur une autre version de vLLM ou de FlashInfer ou sur SGLang, de vraies cartes de 24 et 16 GB, la RTX PRO 4500 32 GB, la L40S, BF16. La ligne de compatibilité du README du SDK cite aussi les RTX PRO 4500/5000, L40S et cartes de classe A6000 ; seule la RTX 5090 a été mesurée.
Problèmes restants
- L'endpoint ignore
chat_template_kwargs,top_ketmin_p. La page des auteurs désactive la réflexion par requête avecchat_template_kwargs={"enable_thinking": False}. LeChatCompletionRequestdu manager n'a pas ces champs, ils sont donc ignorés. La réflexion ne peut pas être désactivée par requête. Contournement :--default-chat-template-kwargssur le serveur. Statut : ouvert, fonctionnalité manquante. - Premier démarrage lent. 611,5 s à froid, surtout le préchauffage du moteur. Le worker n'installe pas
flashinfer-cubinavec vLLM 0.32 (avertissement "FlashInfer's precompiled kernels are missing"). Statut : ouvert. - Fenêtre complète à la limite de la carte. Moins de 600 MiB libres pendant le prompt de 205K. Gardez les autres processus hors du GPU, ou réglez
GROOT_CONTEXT=131072. - NVFP4 ne démarre pas sur la RTX 5090 avec vLLM 0.32.0 (voir l'échelle) : pas de chemin FP4 natif sur sm_120, vLLM utilise donc le repli Marlin sur les poids seuls, puis la compilation JIT de FlashInfer échoue. Cela peut venir de l'image de notre worker, à laquelle il manque
flashinfer-cubin(problème 2). Options : ajouter les kernels précompilés, essayer une autre version de vLLM ou de FlashInfer, ou essayer SGLang (aucune testée). Pour les cartes de 16 et 24 GB, les auteurs renvoient à la version GGUF sur llama.cpp (non testée). Statut : ouvert, peut-être l'image de notre worker. - Erreurs sur la page du modèle. Les commandes de service utilisent
Groot/Groot-19B-A3B-261023, qui ne se résout pas (API HF 401) ; le dépôt estGrootTeam/Groot-19B-A3B-261023. Le front matter renvoie vers un fichierLICENSEqui répond 404 dans les quatre dépôts ; la licence n'existe que comme étiquetteapache-2.0et dans les métadonnées. Statut : signalé ici, toujours sur la page. - Dépréciation. vLLM 0.32 journalise
qwen3_next_mtpcomme alias déprécié demtp. Cela fonctionne. - Limite du scheduler. Les réglages spéculatifs fixent
max_num_scheduled_tokensà 2048.
Image de synthèse
Vidéo de démo
La démo commentée de 143 secondes : le déploiement dans le panneau, l'appel d'outil à deux villes sur la RTX 5090, le graphique des auteurs et l'échelle de mémoire. L'affiche montre notre tenant de démo.
Sources
- Page du modèle et dépôts : BF16, FP8, NVFP4, GGUF (README identique dans les quatre), et le lien LICENSE (404 le 2026-11-03).
- Listings de l'API Hugging Face des quatre dépôts, récupérés le 2026-11-03.
- Exemple du SDK, commit
1c25420460d2277219490af8bcf0ec7c173aa423. - Vidéo d'AI Search, IGICYFyP_EI, où nous avons repéré le modèle.
- Nos propres logs : les logs de vLLM et du worker, les relevés nvidia-smi chaque seconde, et les sorties JSONL des tests de vitesse, d'aiguille, d'outils, de graphiques et de réflexion.