Groot-19B-A3B mete todo su contexto de 256K en una RTX 5090 de 32 GB, y un límite de 24 GB no basta
El agente de 19B de GrootTeam en FP8 en una RTX 5090: ventana completa de 262.144 tokens, de 262 a 304 tokens/s y un prompt de 205K tokens bien respondido.
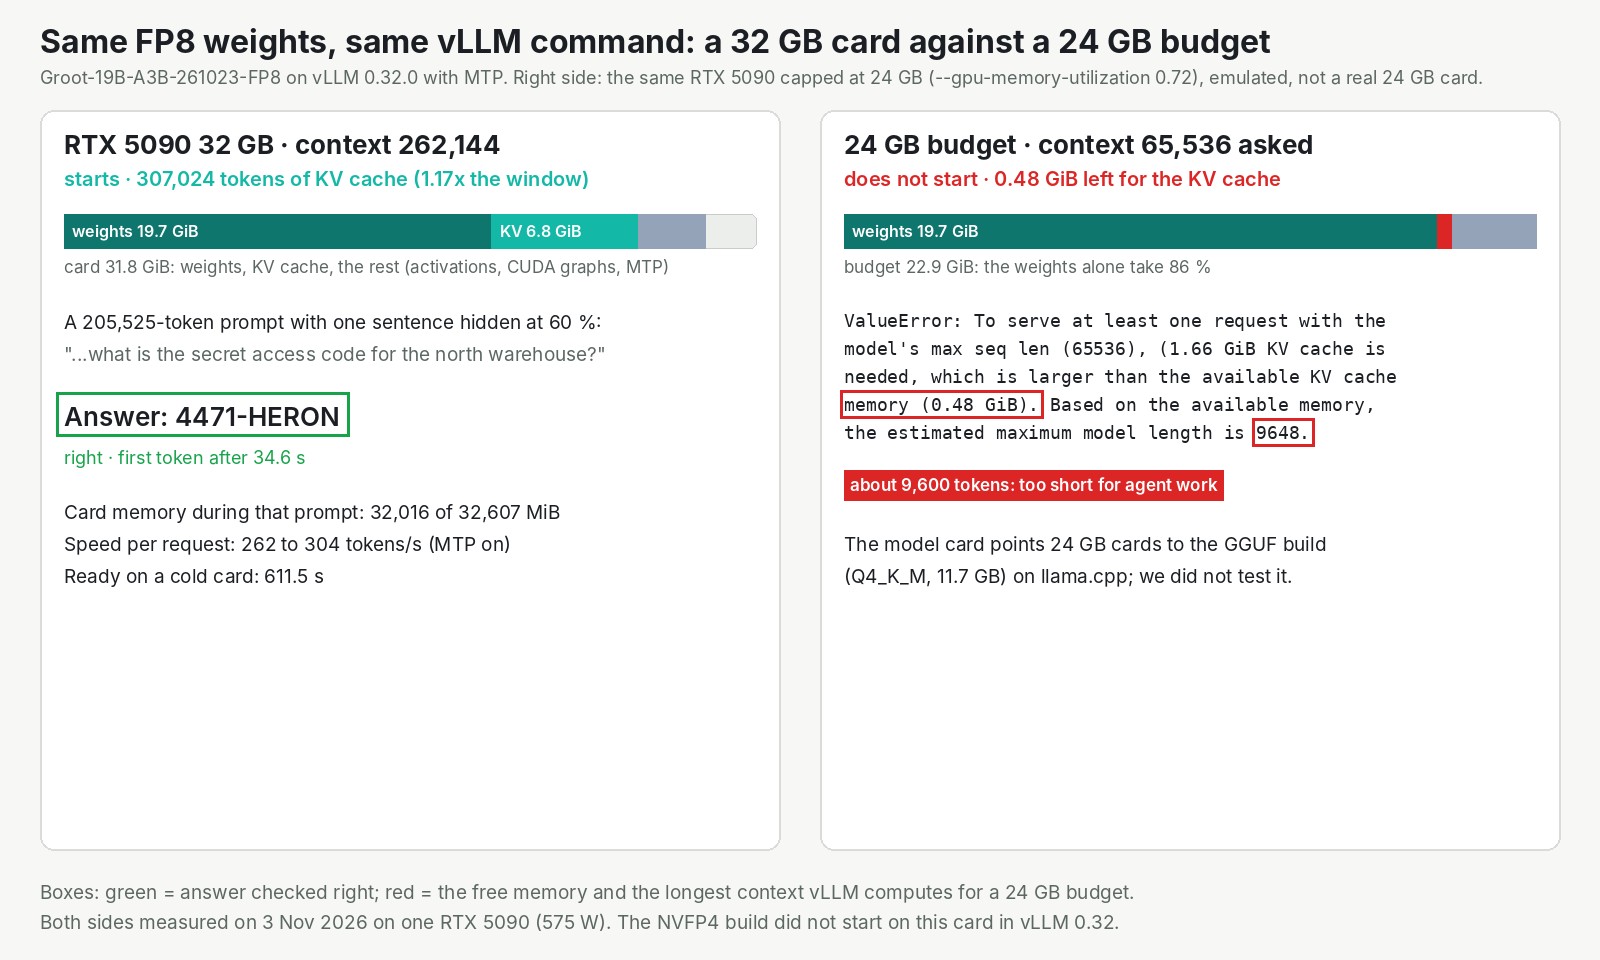
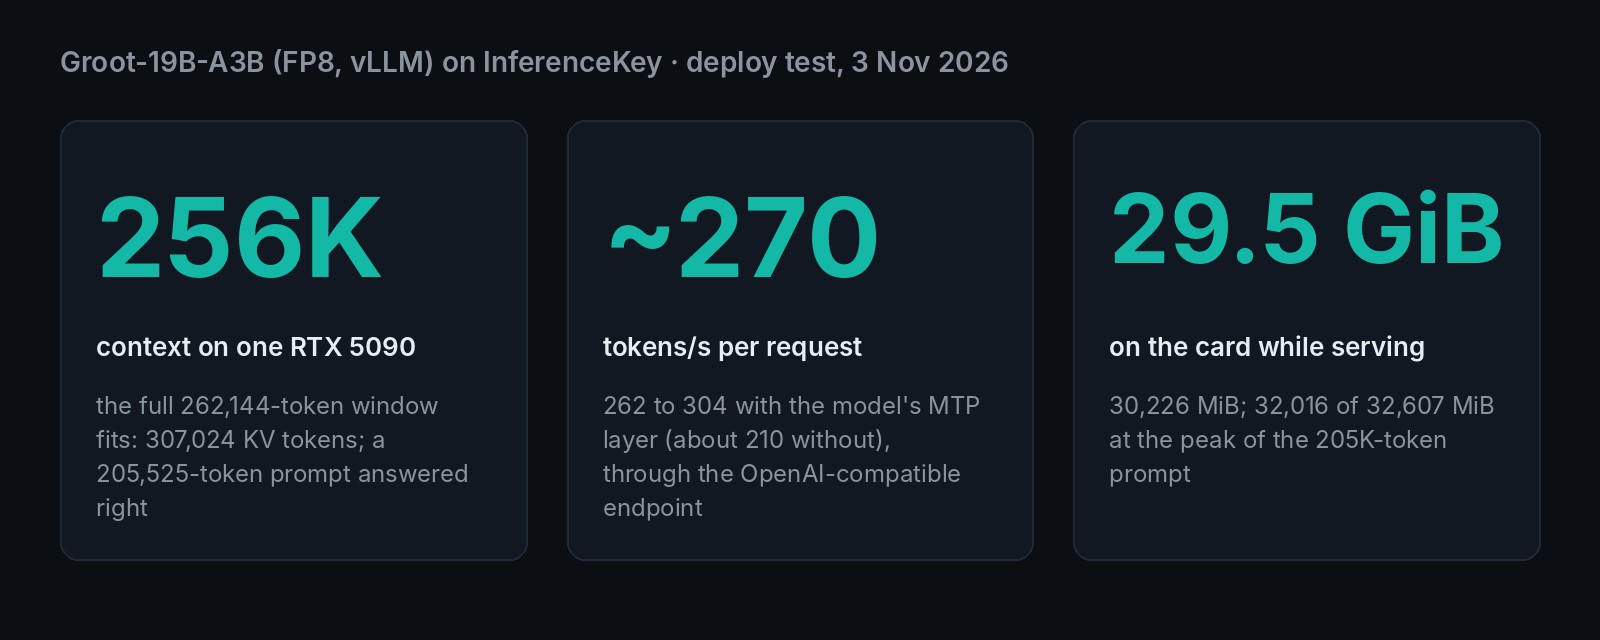
Los autores de Groot-19B-A3B dicen que todo su contexto de 256K entra en una sola RTX 5090 de 32 GB. Lo comprobamos en nuestra nube, y es cierto: arrancó con los 262.144 tokens completos (los "256K") y un prompt de 205.525 tokens volvió con la respuesta correcta. Con un límite de 24 GB, el mismo fichero dejó sitio para unos 9.600 tokens, demasiado poco para trabajo de agente. Así que cuenta con 32 GB para esta versión. Usamos la versión comprimida de 20,9 GB (FP8), vLLM, el servidor de código abierto que incluye nuestra plataforma, y los ajustes de los autores. Para un equipo con su propio hardware, eso es una ventana de 256K tokens en una sola tarjeta de gama gaming.
| Lo que quieres saber | Lo que medimos |
|---|---|
| La GPU más pequeña que lo movió | una RTX 5090 real, 32 GB, ventana completa de 262.144 tokens |
| Velocidad de escritura, una petición | de 262 a 304 tokens/s, de 170 a 211 sin su capa de aceleración |
| Llamadas a herramientas | JSON válido, dos llamadas en un turno más la respuesta en 1,8 s |
| 24 GB de memoria (simulados en la misma tarjeta) | no arranca con 64K tokens, 9.600 como máximo |
Un modelo de 19B que sus autores ponen por delante de su propio padre de 35B
Groot-19B-A3B sale de un modelo más grande y está reentrenado para agentes. Sus autores dicen que supera al original. GrootTeam partió de Qwen3.6-35B-A3B, el modelo abierto de 35B del equipo de Qwen, y lo recortó a 19B. La página de los autores no explica cómo. Lo reentrenaron con una pequeña cantidad de datos abiertos, menos de 100 millones de tokens, según la ficha del modelo. Lo publicaron el 23 de octubre en cuatro versiones, y lo vimos en el vídeo de noticias del 1 de noviembre de AI Search.
Funciona como un equipo grande en el que solo unos pocos especialistas se ocupan de cada palabra. Unos 3B de sus 19B parámetros trabajan en cada palabra. Así que escribe rápido, pero la GPU tiene que guardar los 19B.
En la tabla de los autores, supera tanto a Qwen3.6-35B-A3B como a Gemma-4-26B-A4B en 12 de 16 benchmarks. Dos de ellos son los que más pesan para trabajo de agente:
- Terminal-Bench 2.1, donde un agente trabaja en una línea de comandos: 52,1 frente a 43,8 de Qwen3.6 y 26,5 de Gemma-4.
- NL2Repo, donde un agente construye un repositorio de código entero a partir de una descripción: 35,7 frente a 28,8 y 16,6.
Los autores también dicen que sus respuestas fueron las más cortas de 12 modelos: un 23,1 % más cortas que las de Qwen3.6 y un 65,6 % más cortas que las de Gemma-4. Su página pide leer ese dato junto con la precisión, y es justo. Solo lo comparan con modelos abiertos de su tamaño, no con los modelos punteros cerrados actuales.
También lee imágenes: le pedimos que leyera la gráfica de los autores y dio unos 42, frente al 41,44 de su página. La etiqueta de licencia de los cuatro repos dice Apache-2.0, que permite uso comercial, aunque el fichero LICENSE que enlaza la página no existe. Además del fichero completo de 38,9 GB hay versiones comprimidas de 20,9 GB (la que probamos), 13,5 GB y 11,7 GB.
"256K en una tarjeta" es una promesa sobre memoria, y los pesos más pequeños de Groot hacen el hueco
La promesa va de memoria. Imagina un bloc de notas. Un modelo en una GPU necesita memoria para dos cosas: sus propios pesos y un bloc de notas que guarda la conversación hasta el momento. Los pesos son un coste fijo. El bloc crece con cada token de contexto que permites. Groot conserva la estructura de Qwen3.6-35B-A3B: una cuarta parte del modelo toma notas completas de cada palabra y el resto guarda un resumen corto. Así que el bloc es tan pequeño como el de Qwen3.6. Lo que libera el hueco son los pesos, 19B en lugar de 35B.
La página de los autores dice que las versiones de 20,9 GB y 13,5 GB "run the full 256K context on one RTX 5090", y añade que es una estimación a partir de los tamaños de memoria. Así que fuimos directos a esa tarjeta.
Los límites: una GPU, una petición cada vez, nuestros propios prompts, unas pocas ejecuciones de cada cosa. Esto comprueba si el modelo entra y lo rápido que responde. Su habilidad como agente sale de los benchmarks de los autores: más allá de una prueba de herramientas con dos llamadas, no la probamos, y no ejecutamos ninguna sesión de agente de varios pasos.
La ventana completa entra: un prompt de 205.525 tokens bien respondido, primera palabra a los 35 segundos
La ventana completa de 262.144 tokens arrancó en la tarjeta de 32 GB. Tras cargar los pesos, a vLLM le quedaron 6,8 GiB para el bloc de notas, suficiente para 307.024 tokens: la ventana completa más unos 45.000 tokens de margen. Así que un agente tiene la ventana completa. Varios agentes a la vez tienen que conformarse cada uno con una más corta.
Escondimos una frase al 60 % de un prompt de 205.525 tokens: el código de acceso de un almacén. El modelo la encontró y devolvió el código. La primera palabra de la respuesta llegó a los 34,6 segundos, y la respuesta completa a los 40,3. Una respuesta correcta demuestra que la ventana funciona. No pone a prueba el razonamiento sobre documentos largos.
La GPU estaba casi llena mientras lo hacía. Sirviendo con normalidad, usaba alrededor del 93 % de la memoria de la tarjeta. El prompt largo dejó menos del 2 % libre. Es una furgoneta de gira tan cargada que el amplificador va encajado contra la puerta: rueda, pero no entra nada más.
Unos 270 tokens por segundo, y la capa de aceleración añade alrededor de una cuarta parte
Una respuesta de 4.457 tokens tardó unos 17 segundos a través de nuestra API, de 262 a 304 tokens por segundo. Las respuestas cortas quedaron en lo alto de ese rango, y las de 4.500 a 5.200 tokens en lo bajo. La respuesta empezó en menos de un segundo (de 0,26 a 0,61 s).
Parte de esa velocidad viene de una pequeña capa extra que los autores publican con el modelo. Adivina los dos tokens siguientes, y el modelo principal comprueba la apuesta en el mismo paso que habría gastado en uno. Cuando acierta, salen varios tokens por el precio de uno. Con esa capa apagada, vLLM escribió de 170 a 211 tokens por segundo. En respuestas largas la capa añadió en torno a un 25 %, de forma aproximada: una ejecución pasó por nuestra API y la otra fue directa a vLLM.
Las llamadas a herramientas volvieron limpias, y cada respuesta empieza con un largo razonamiento
Las llamadas a herramientas funcionaron a la primera. Probamos el ejemplo de los propios autores, el tiempo en París. El modelo pidió a nuestro código get_weather con la ciudad en JSON válido en 0,9 segundos. Con el resultado respondió en menos de un segundo más.
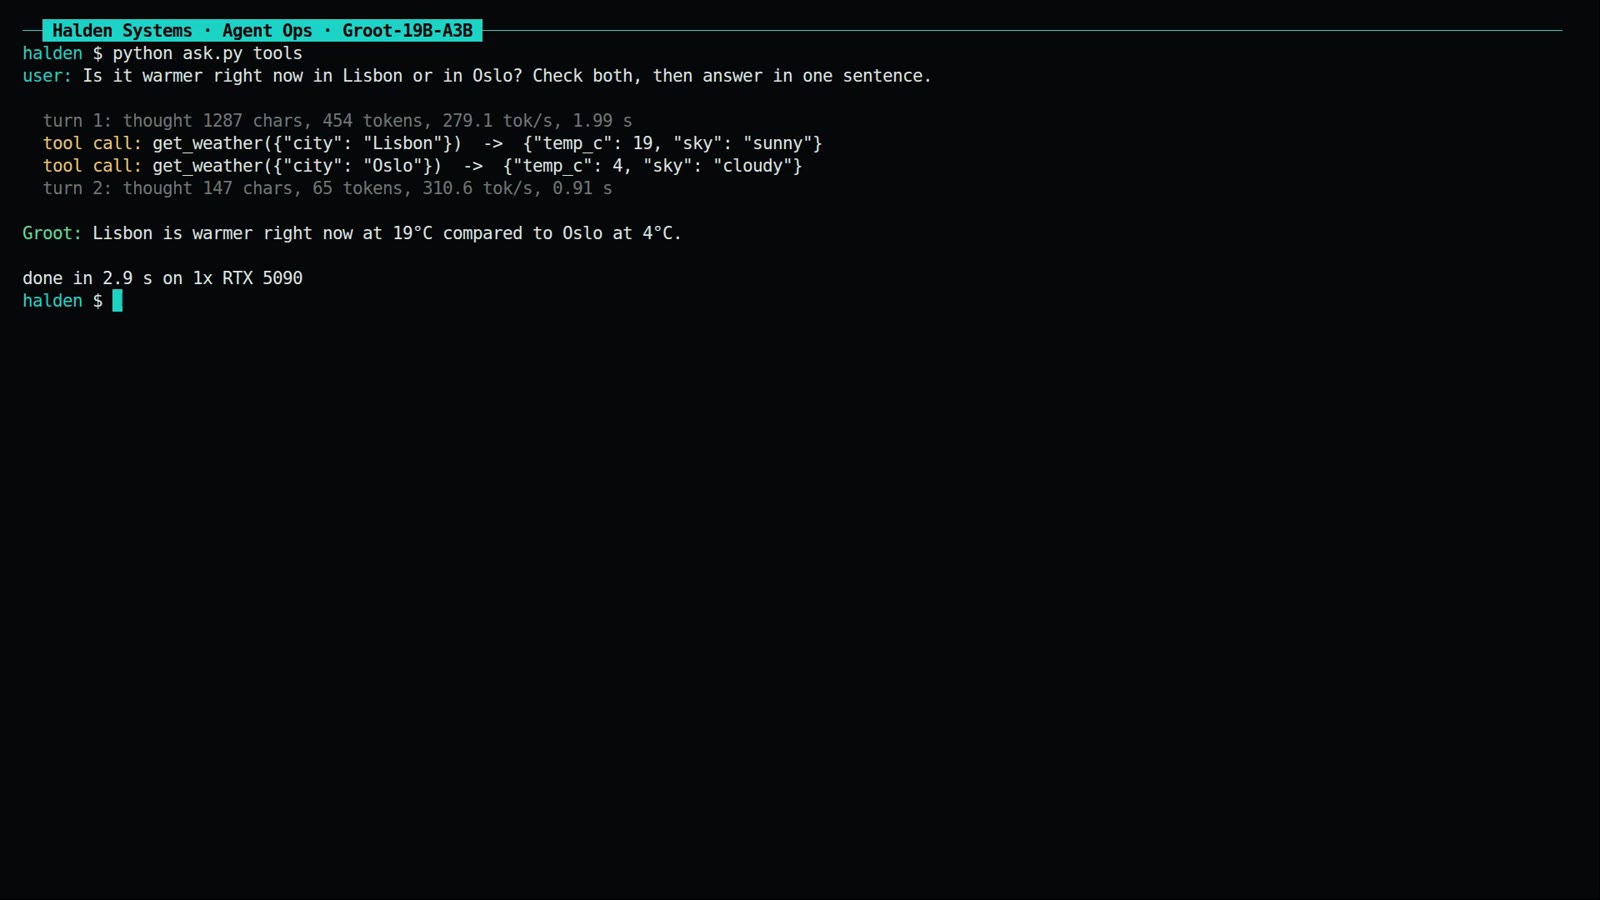
Después le dimos dos ciudades: ¿hace más calor ahora en Lisboa o en Oslo? En un solo turno pidió las dos ciudades a la vez, dos llamadas en paralelo. Cuando nuestro servicio meteorológico de pega respondió, escribió "Lisbon is warmer right now with 19°C compared to Oslo's 4°C". Todo el intercambio tardó 1,81 segundos. Es justo la forma que espera un framework de agentes.
Cuenta con razonamientos largos incluso en preguntas cortas: Groot piensa antes de cada respuesta, y ese razonamiento cuenta como salida. "La capital de Australia, en una palabra" costó de 111 a 131 tokens, casi todos de razonamiento, antes de "Canberra". Una petición de una redacción de 300 palabras produjo de 2.383 a 7.156 tokens en cuatro ejecuciones. En las dos ejecuciones que contamos, 2.043 y 6.785 de esos tokens fueron de razonamiento. No ejecutamos Qwen3.6 con los mismos prompts, así que no podemos confirmar ni desmentir el 23,1 % de los autores. Pon un límite de tokens generoso.
Qué GPU: una RTX 5090 real de 32 GB con el contexto completo, nada más pequeño arrancó
Solo arrancó la tarjeta real de 32 GB. Por debajo de 32 GB, nada de lo que probamos arrancó. No teníamos tarjetas más pequeñas para esta prueba, así que le dijimos a vLLM que usara solo parte de la memoria de la misma 5090. Eso emula el presupuesto de una tarjeta más pequeña, pero no es una tarjeta más pequeña de verdad.
- Presupuesto de 24 GB, FP8, 65.536 tokens pedidos: no arrancó. Solo los pesos ocupan el 86 % de ese presupuesto, lo que dejó 0,48 GiB para el bloc de notas. vLLM calculó un máximo de 9.648 tokens, demasiado corto para un agente que lee ficheros y resultados de herramientas. La página de los autores recomienda mantener al menos 128K.
- Presupuesto de 16 GB, la versión de 13,5 GB, 32.768 tokens pedidos: no arrancó. Falló al arrancar, por un fallo de software y no por falta de memoria, así que no pudimos comprobar lo que dicen los autores de esta versión.
El apéndice recoge todos los peldaños que nos saltamos.
En InferenceKey: el backend vLLM de serie y la receta de los propios autores, listo en unos 10 minutos
Un modelo nuevo no debería necesitar un motor a medida, y este no lo necesitó. Nuestra plataforma ejecuta un modelo en un worker, una máquina con GPU que tienes o alquilas y conectas a ella. Apuntamos el worker a la versión FP8 con vLLM y los ajustes de los autores, y sirvió. De la llamada de despliegue a un servidor listo pasaron 611,5 segundos en una máquina nueva. Unos 3 minutos se fueron en instalar vLLM, 28 segundos en descargar 20,9 GB y 5 minutos en que vLLM calentara el motor y su capa de aceleración. En un reinicio, con ese trabajo guardado en disco, el calentamiento tardó 87 segundos en lugar de cinco minutos. Parte de ese arranque lento es culpa nuestra: nuestro worker no incluye una pieza ya compilada, así que vLLM la compila por su cuenta. Estado: abierto.
El primer problema con el que te vas a encontrar es el interruptor del razonamiento. La página de los autores apaga el razonamiento con un ajuste por petición. Nuestra API todavía no pasa ese ajuste al modelo, así que la petición sigue razonando. Con el razonamiento apagado, siguió razonando antes de decir "The Eiffel Tower is located in Paris, France." Estado: abierto por nuestra parte. El apaño es arrancar el servidor con el razonamiento apagado por defecto, y el README de nuestro ejemplo muestra la opción en una línea. El resto de lo que encontramos, incluidos dos pequeños errores de la página de los autores, está en el apéndice.
¿Merece la pena? Sí, si necesitas una ventana de 256K en una tarjeta de 32 GB
- Si quieres un contexto largo en hardware propio, es un candidato sólido por tamaño y velocidad.
- Si tu tarjeta tiene 24 GB, sáltate la versión de 20,9 GB. Los autores sugieren la de 11,7 GB, que no probamos.
- Si necesitas respuestas rápidas en un chat, cuenta con el razonamiento que va antes de cada respuesta.
- Si necesitas la versión más pequeña de 13,5 GB, pruébala tú mismo con otra versión del servidor: en nuestro montaje no arrancó.
Para ejecutar el mismo despliegue, una llamada a herramientas y la gráfica de los autores en tu propia GPU, ejecuta python main.py desde el ejemplo del SDK de Groot-19B-A3B. Necesita un proyecto de InferenceKey con un token del SDK y una API key, y un worker NVIDIA privado con 32 GB o más. Borra el despliegue al terminar.
Para ingenieros
Créditos
- Groot-19B-A3B-261023: GrootTeam. Hicieron el post-entrenamiento del modelo y publicaron las versiones BF16, FP8, NVFP4 y GGUF (creadas el 2026-10-23, sin acceso restringido, etiqueta
license:apache-2.0), la capa MTP, las recetas de vLLM y SGLang, las tablas de benchmarks y las gráficas que usamos como pruebas de visión. Repos: BF16, FP8, NVFP4, GGUF. - Modelo base: Qwen3.6-35B-A3B, del equipo de Qwen.
- Servicio: el proyecto vLLM (0.32.0) y FlashInfer.
- Dónde lo vimos: AI Search, "AI finally sleeps, Gemini 4 Carbon, ETH cracked, energy-based models, Anthropic IPO: AI NEWS", subido el 2026-11-01, capítulo de Groot en el 47:33. El vídeo trata cuatro variantes de Groot; este post solo trata la de 19B.
- Nuestra parte: el despliegue a través de la plataforma, los prompts y las pruebas, las mediciones, la escalera de VRAM, el ejemplo del SDK y el vídeo de la demo.
Modelo y ficheros
- Un modelo mixture-of-experts (MoE), el diseño que explicamos en nuestro post de Sage-A1.5. Su estructura híbrida viene de Qwen3.6-35B-A3B.
- Arquitectura
Qwen3_5MoeForConditionalGeneration: unos 19B parámetros en total más una capa MTP de 0,4B, unos 3B activos por token. 40 capas, 10 de atención completa (full_attention_interval4) y 30 de atención lineal. Hidden 2048, 16 cabezas de atención, 2 cabezas KV, head_dim 256, vocabulario de 248.320. 128 expertos enrutados más 1 compartido, 8 enrutados activos por token.max_position_embeddings262.144, ampliable a cerca de 1M con YaRN (factor 4,0), según la página de los autores. - FP8: bloques de 128x128, E4M3, activaciones dinámicas.
- Estimación aproximada de la KV de las capas de atención completa: 10 capas x 2 cabezas KV x 256 x 2 (K y V) x 2 B = 20 KiB por token, así que unos 5 GiB para 256K, más la capa MTP y los estados de la atención lineal.
| Versión | Tamaño en la página | usedStorage de HF | Sha del repo |
|---|---|---|---|
| BF16 | 38,9 GB | 38.883.686.769 B (sin mtp.safetensors en la lista) | d089dadf |
| FP8 (E4M3, dinámico) | 20,9 GB | 20.946.032.529 B (6 shards + mtp.safetensors de 450.538.880 B) | 49137722 |
| NVFP4 (expertos NVFP4, atención FP8) | 13,5 GB | 13.546.543.381 B (4 shards + mtp.safetensors de 883.452.968 B) | 8ff73aca |
| GGUF Q4_K_M | 11,7 GB | 11.657.618.560 B + mmproj BF16 de 902.822.016 B | 2fa1ec95 |
Lo que dicen los autores (no reproducido)
| Benchmark | Groot-19B-A3B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B |
|---|---|---|---|
| Terminal-Bench 2.1 | 52,10 | 43,82 | 26,52 |
| NL2Repo-Bench | 35,65 | 28,77 | 16,55 |
| LongBench v2 | 62,03 | 48,12 | 47,99 |
| Media sin ponderar de 16 benchmarks | 41,44 | 38,08 | 30,05 |
- Por delante de los dos en 12 de 16 benchmarks. Un 45,7 % menos de parámetros totales que Qwen3.6-35B-A3B y un 26,9 % menos que Gemma-4-26B-A4B.
- Presupuesto de tokens: la salida media más corta de los 12 modelos medidos en las 16 ejecuciones, un 23,1 % menos de tokens de salida que Qwen3.6-35B-A3B y un 65,6 % menos que Gemma-4-26B-A4B.
- Ajustes de evaluación: modo de razonamiento con el esfuerzo por defecto, temperatura 1,0, top_p 0,95, top_k 20, contexto de 256K. Terminal-Bench 2.1 con el agente Claude Code (max_output_tokens 128K, max_turns 500, timeout de 12 h). NL2Repo-Bench con el agente Claude Code, max_turns 1000, contexto de 80K. HLE juzgado por gpt-5.5.
- "Dónde funciona" (presentado como estimación a partir de la capacidad de memoria): BF16 en una GPU de 48 u 80 GB; FP8 y NVFP4 con 256K en una RTX 5090; GGUF con 128K en una RTX 4060 Ti de 16 GB y con 256K en una RTX 4090/3090 de 24 GB; 256K en máquinas de 128 GB de memoria unificada. Frente a Qwen3.6-35B-A3B: en 16 GB Groot funciona con 128K mientras que Qwen3.6 no carga; en una RTX 5090, 256K frente a 64K.
- Requisitos de software: Transformers >= 5.8.1, vLLM >= 0.19.1, SGLang >= 0.5.10. Razonamiento activado por defecto, se apaga con
chat_template_kwargs={"enable_thinking": False}, sin interruptores/thinkni/nothink. Muestreo recomendado con razonamiento: temperatura 1,0, top_p 0,95, top_k 20, min_p 0, presence_penalty 1,5. Programación: temperatura 0,6, presence 0. Sin razonamiento: temperatura 0,7, top_p 0,8.
Montaje
- Una RTX 5090, 32.607 MiB, 575 W, driver 595.91.07 (CUDA 13.2), compute capability 12.0, disco de 100 GB, en nuestra nube (InferenceKey Cloud).
- Por qué esta tarjeta: el plan de pruebas nombraba una L40S para la ejecución principal, pero la afirmación estrella de los autores nombra la RTX 5090, así que la ejecución principal fue directa a ella. Los peldaños con menos memoria se ejecutaron en la misma máquina con límites de memoria emulados.
- Las peticiones pasaron por el endpoint compatible con OpenAI de la plataforma (
/v1/chat/completions, streaming); las ejecuciones de velocidad sin MTP fueron directas a vLLM. - Backend
vllmde serie,vllm_version="0.32.0"(instala Transformers 5.19 y torch 2.13 para CUDA 13). No usamos SGLang. - Un manager local de InferenceKey compilado desde
origin/maince3af2dcpuso en marcha el worker. Producción no intervino. - Muestreo de las ejecuciones de velocidad: temperatura 1,0, top_p 0,95, presence_penalty 1,5, streaming.
top_k=20viene degeneration_config.json.
Paso a paso con el ejemplo del SDK
- Clona inferencekey-sdk y abre
examples/groot-19b-a3b-fp8-agent-vllm-private-nvidia/(commit1c254204). - Compila el SDK de Python en local con maturin (consulta
examples/CONTRIBUTING.md, sección 4) y ejecutapip install -r requirements.txt(requests>=2.31). cp .env.example .envy rellenaINFERENCEKEY_SDK_TOKEN(ik_sdk_, scopesworkload:readyworkload:write),INFERENCEKEY_API_KEY(ik_live_, con el workload enallowed_endpoints),INFERENCEKEY_PROJECTeIK_WORKER_ID(un worker NVIDIA privado con 32 GB o más y un driver de CUDA 13, 580 o posterior). Opcional:GROOT_CONTEXT(262144 por defecto),GROOT_MTP(1 por defecto),IK_KEEP_ALIVE=1.python main.py. El flujo:ensure()de un workloadvllmfijo en tu worker (ExecutionPolicy.FIXED),wait_until_ready(timeout=2400), una pregunta simple congenerate_text(), el prompt en streaming de los autores "I love Groot backwards", una llamada a la herramientaget_weathercon el resultado devuelto al modelo, la gráfica de los autores como imagen, respuestas aoutputs/answers.json, y despuésdelete()salvo conIK_KEEP_ALIVE=1.
El comando que despliega el ejemplo:
vllm serve GrootTeam/Groot-19B-A3B-261023-FP8 --max-model-len 262144 \
  --gpu-memory-utilization 0.92 --max-num-seqs 8 --enable-prefix-caching \
  --limit-mm-per-prompt '{"image": 2, "video": 0}' \
  --reasoning-parser qwen3 --enable-auto-tool-choice --tool-call-parser qwen3_coder \
  --speculative-config '{"method": "qwen3_next_mtp", "num_speculative_tokens": 2}'
Para servir sin razonamiento, añade:
--default-chat-template-kwargs '{"enable_thinking": false}'
Salida principal del ejemplo: el prompt al revés, 460 tokens en 2,12 s a 307,1 tok/s, con la respuesta "toorG evol I"; la pregunta que explica MoE, en 3,8 s.
Tiempos
- De
ensure()a listo en un worker en frío: 611,5 s. Instalación de vLLM 0.32.0 unos 170 s, descarga de pesos 27,8 s, carga 51,7 s (19,67 GiB), calentamiento del motor 312,6 s (compilación 37,5 s, dos capturas de CUDA graphs y del especulador de unos 2 min cada una, JIT de FlashInfer). - Reinicio en caliente (MTP apagado, cachés en disco): calentamiento del motor 86,8 s (compilación 37,1 s), pesos de 19,24 GiB en 23,4 s.
Memoria
--gpu-memory-utilization 0.92, contexto de 262.144, MTP encendido: KV disponible 6,77 GiB = 307.024 tokens, concurrencia máxima 1,17x. Pool de CUDA graphs 0,19 GiB.- Lo mismo con MTP apagado: 7,37 GiB = 376.253 tokens, 1,44x.
- nvidia-smi cada segundo: 30.226 MiB sirviendo, pico de 32.016 de 32.607 MiB durante el prompt de 205K (de 530 a 566 W).
Velocidad (una petición, streaming)
| Vía | Prompt | Tokens de completion | Primer token | Decode |
|---|---|---|---|---|
| Endpoint, MTP encendido | "capital of Australia, one word" | 111 / 115 | 0,26 / 0,60 s | 284,4 / 304,1 tok/s |
| Endpoint, MTP encendido | redacción de 300 palabras | 5.159 / 4.457 | 0,61 / 0,61 s | 265,9 / 261,9 tok/s |
| vLLM directo, MTP apagado | corto | 125 / 131 | 0,59 / 0,54 s | 170,5 / 187,1 tok/s |
| vLLM directo, MTP apagado | redacción | 2.383 / 7.156 | 0,79 / 0,68 s | 210,4 / 210,6 tok/s |
| Endpoint, MTP encendido | prompt de aguja de 205.525 tokens | 119 | 34,62 s | prefill de unos 5.900 tok/s incluida la transferencia, total 40,27 s, "4471-HERON" correcto |
- La comparación de MTP mezcla dos vías (MTP encendido a través del gateway, MTP apagado directo). La sobrecarga del gateway no se pudo medir en nuestra prueba anterior de Sage-A1.5 y no se volvió a medir aquí.
- Tokens de razonamiento (
usage.completion_tokens_details.reasoning_tokens, ejecuciones directas): 120 de 125 en la pregunta corta; 2.043 de 2.383 y 6.785 de 7.156 en las redacciones.reasoning_contentde 9,6K a 23,7K caracteres en las redacciones.
Herramientas, visión, razonamiento
- El ejemplo
get_weatherde los autores:{"city": "Paris"}, JSON válido, 0,9 s; respuesta final 0,96 s. - Dos ciudades: un turno con dos llamadas
get_weatheren paralelo (Lisboa, Oslo; 101 tokens de completion, 0,93 s), después la respuesta (50 tokens, 0,88 s), 1,81 s en total. Toma grabada: 2,9 s (turno 1 de 454 tokens en 1,99 s, turno 2 de 65 tokens en 0,91 s). La longitud del razonamiento en los turnos con herramientas no se capturó de forma fiable en la prueba principal (0 caracteres registrados, mientras que la toma grabada muestra 1.287 y 147 caracteres). - Gráfica de dispersión (9.279 tokens de prompt): "Groot-19B-A3B ... approximately 42" en 4,12 s. Gráfica de barras (16.329 tokens de prompt): "52.10 ... Gemma-4 (26.52) and Qwen3.6 (43.82)" en 9,21 s, primer token a los 7,25 s.
chat_template_kwargs={"enable_thinking": false}a través del endpoint: siguió razonando (571 caracteres de razonamiento, 157 tokens de completion).
Escalera de VRAM
| GPU o límite | Configuración | VRAM pico | Velocidad | Salida correcta | Real o emulada |
|---|---|---|---|---|---|
| RTX 5090 32 GB | FP8, contexto de 262.144, util 0.92, MTP encendido (el ejemplo, a través del endpoint) | 30.226 MiB sirviendo, 32.016 MiB durante el prompt de 205K | de 262 a 304 tok/s | sí | real |
| RTX 5090 32 GB | FP8, contexto de 262.144, util 0.92, MTP apagado (vLLM directo) | sin medir por separado | de 170 a 211 tok/s | sí | real |
| Límite de 24 GB | FP8, contexto de 65.536, util 0.72, MTP encendido | no arrancó | n/a | no | emulada |
| Límite de 16 GB | NVFP4, contexto de 32.768, util 0.48, MTP encendido | no arrancó (pesos de 12,66 GiB cargados en 35,6 s) | n/a | no | emulada |
Error con el límite de 24 GB:
ValueError: To serve at least one request with the model's max seq len (65536), (1.66 GiB KV cache is needed, which is larger than the available KV cache memory (0.48 GiB). Based on the available memory, the estimated maximum model length is 9648.
Límite de 16 GB, NVFP4: vLLM registra que la GPU no tiene soporte nativo de FP4 y recurre a la compresión FP4 solo de pesos con el kernel Marlin; después falla la compilación JIT de FlashInfer 0.7.0.post1 de gen_gemm_sm120_group_gemm_fp8_groupwise_e4m3_bf16_majorfalse_sm120 y sus hermanos (nvcc 13.0.88), y termina en RuntimeError: Engine core initialization failed.
Sin probar: un peldaño FP8 de 24 GB con 9,6K o menos (la propia cifra de vLLM dice que arrancaría, pero los autores recomiendan al menos 128K), la versión GGUF con llama.cpp, NVFP4 con otra versión de vLLM o FlashInfer o con SGLang, tarjetas reales de 24 y 16 GB, la RTX PRO 4500 de 32 GB, la L40S, BF16. La línea de compatibilidad del README del SDK también incluye RTX PRO 4500/5000, L40S y tarjetas de la clase A6000; solo se midió la RTX 5090.
Problemas pendientes
- El endpoint descarta
chat_template_kwargs,top_kymin_p. La página de los autores apaga el razonamiento por petición conchat_template_kwargs={"enable_thinking": False}. ElChatCompletionRequestdel manager no tiene esos campos, así que se descartan. El razonamiento no se puede apagar por petición. Apaño:--default-chat-template-kwargsen el servidor. Estado: abierto, funcionalidad que falta. - Primer arranque lento. 611,5 s en frío, sobre todo calentamiento del motor. El worker no instala
flashinfer-cubincon vLLM 0.32 (aviso "FlashInfer's precompiled kernels are missing"). Estado: abierto. - Ventana completa al límite de la tarjeta. Menos de 600 MiB libres durante el prompt de 205K. Mantén otros procesos fuera de la GPU, o pon
GROOT_CONTEXT=131072. - NVFP4 no arranca en la RTX 5090 con vLLM 0.32.0 (ver la escalera): no hay ruta FP4 nativa en sm_120, así que vLLM usa el fallback Marlin solo de pesos, y después falla la compilación JIT de FlashInfer. Puede deberse a nuestra imagen del worker, a la que le falta
flashinfer-cubin(problema 2). Opciones: añadir los kernels precompilados, probar otra versión de vLLM o FlashInfer, o probar SGLang (ninguna probada). Para tarjetas de 16 y 24 GB los autores remiten a la versión GGUF con llama.cpp (no probada). Estado: abierto, posiblemente por nuestra imagen del worker. - Errores de la ficha del modelo. Los comandos de servicio usan
Groot/Groot-19B-A3B-261023, que no resuelve (API de HF 401); el repo esGrootTeam/Groot-19B-A3B-261023. El front matter enlaza un ficheroLICENSEque devuelve 404 en los cuatro repos; la licencia solo está en la etiquetaapache-2.0y en los metadatos. Estado: lo señalamos aquí, sigue en la página. - Deprecación. vLLM 0.32 registra
qwen3_next_mtpcomo alias obsoleto demtp. Funciona. - Límite del planificador. Los ajustes especulativos fijan
max_num_scheduled_tokensen 2048.
Imagen resumen
Vídeo de la demo
La demo narrada de 143 segundos: el despliegue en el panel, la llamada a herramientas con dos ciudades en la RTX 5090, la gráfica de los autores y la escalera de memoria. El póster muestra nuestro tenant de demo.
Fuentes
- Ficha del modelo y repos: BF16, FP8, NVFP4, GGUF (README idéntico en los cuatro), y el enlace a LICENSE (404 el 2026-11-03).
- Listados de la API de Hugging Face de los cuatro repos, consultados el 2026-11-03.
- Ejemplo del SDK, commit
1c25420460d2277219490af8bcf0ec7c173aa423. - Vídeo de AI Search, IGICYFyP_EI, donde vimos el modelo.
- Nuestros propios registros: los logs de vLLM y del worker, las muestras de nvidia-smi cada segundo y las salidas JSONL de las pruebas de velocidad, aguja, herramientas, gráficas y razonamiento.