Hy-SimulMT interpreta chino e inglés mientras habla el orador, en una tarjeta de 48 GB
El intérprete abierto de Tencent en una RTX 6000 Ada: primeras palabras en 2 a 5,5 s y cada frase del primer clip chino, lista a 2 s del orador.
A los cinco segundos y medio de un clip en chino llegaron las primeras palabras en inglés: "The United Nations also". El orador seguía hablando. Eso es Hy-SimulMT, el modelo abierto de Tencent Hunyuan para interpretar en directo entre chino e inglés. Lo probamos en una RTX 6000 Ada de 48 GB en nuestra nube. Las primeras palabras llegaron entre 2,3 y 5,5 segundos después de empezar cada clip. En el primer clip chino, el único que cronometramos frase a frase, cada frase quedó terminada como mucho unos 2 segundos después que el orador. Si tienes tus propias GPU, el audio de la reunión y su traducción no salen nunca de una tarjeta tuya o alquilada. Ocupó 38 GB de la tarjeta, y un clon de la voz del orador llenó el resto. Dos límites: uno de nuestros dos clips en inglés perdió dos de sus seis frases, y nuestra API acepta ficheros grabados reproducidos a velocidad de habla, todavía no un micrófono en directo.
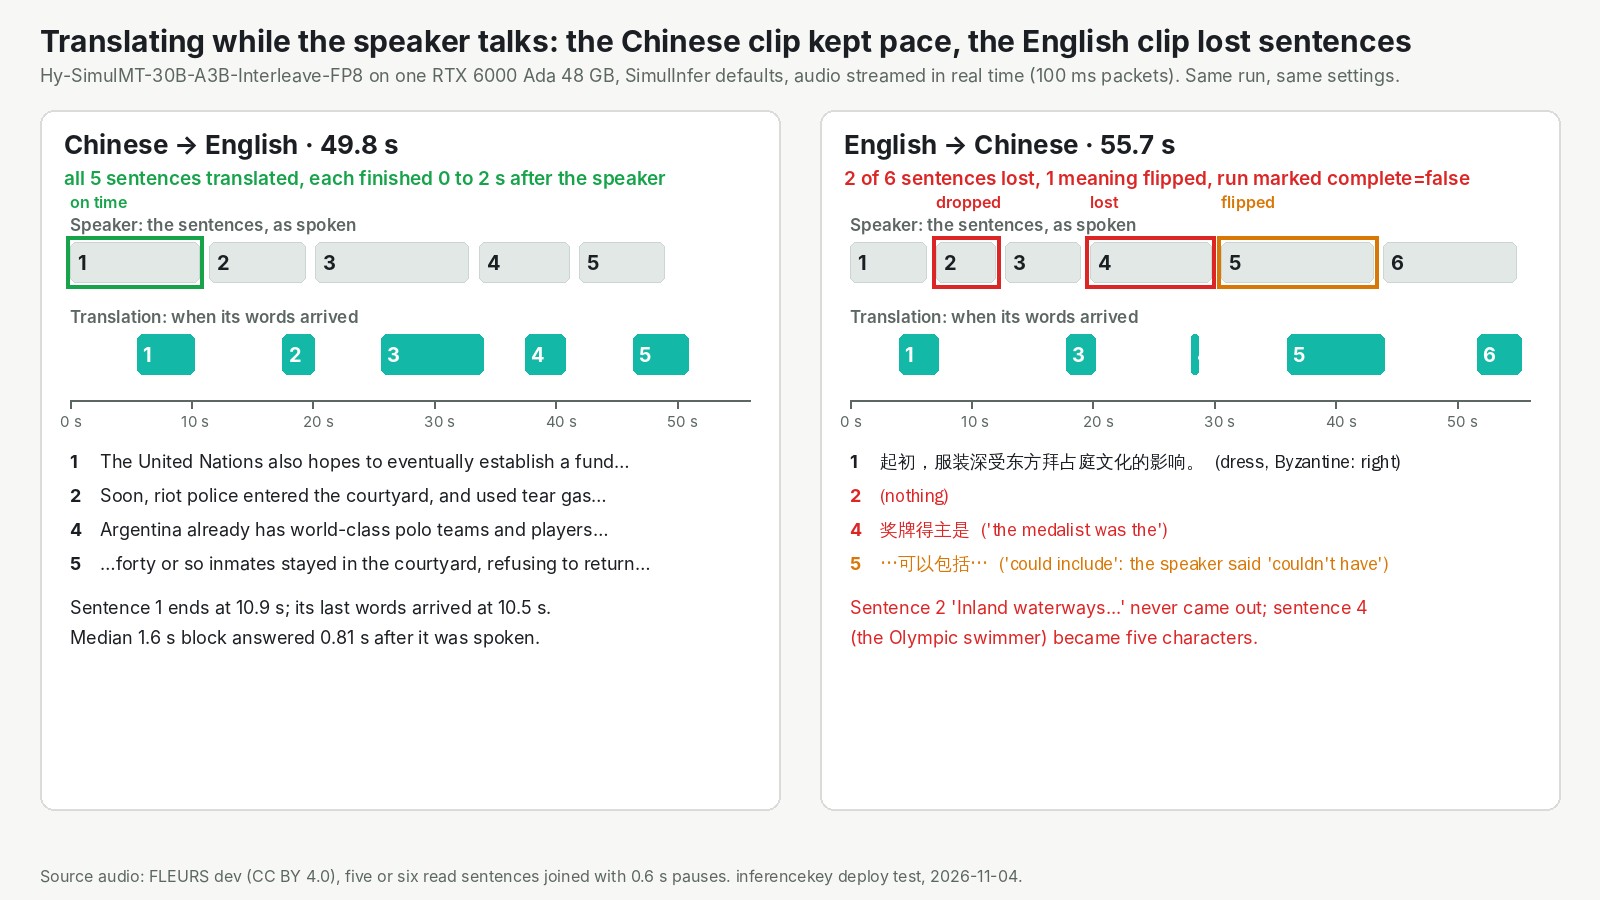
| Lo que quieres saber | Lo que medimos |
|---|---|
| Cuánto va por detrás del orador | primeras palabras a los 2,3 a 5,5 s, y en el primer clip chino cada frase terminada entre 0 y 2 s después del orador |
| Memoria en la tarjeta | 38 GB de 48 sirviendo, casi los 48 con el clon de voz |
| La GPU más pequeña que lo sirvió | una tarjeta real de 48 GB (32 GB solo funcionó con un límite simulado) |
| Precisión | de chino a inglés, sólida; de inglés a chino, irregular (un clip perdió 2 de 6 frases) |
| Salida de voz | funcionó de chino a inglés, se atascó de inglés a chino (pendiente) |
Un intérprete en un solo modelo, no un transcriptor y un traductor en fila
Hy-SimulMT escucha y traduce en el mismo modelo, así que puede empezar la traducción antes de que acabe la frase. Lo habitual para traducir voz es un relevo. Un programa apunta lo que se dijo y luego otro traduce el texto terminado. Es como un taquígrafo de juzgado que pasa las páginas a un traductor en la sala de al lado. El traductor no puede empezar hasta que la página está acabada, así que el retraso crece con cada frase larga.
Hy-SimulMT funciona más bien como la persona de la cabina en un congreso. Oye un trozo de habla, decide si tiene suficiente para decir algo y lo dice. Un pequeño servicio de los mismos autores, SimulInfer, le pasa el audio en trozos de 1,6 segundos y va cosiendo las piezas.
Tencent Hunyuan lo publicó el 26 de octubre con licencia Apache-2.0, que permite el uso comercial, y cualquiera puede descargarlo sin pedir permiso. Es un modelo de 30B en el que solo unos 3B parámetros trabajan en cada palabra. Imagina un gran equipo de especialistas en el que cada palabra consulta a unos pocos y el resto espera. Eso lo hace rápido, pero la tarjeta tiene que alojar al equipo entero.
Probamos una versión comprimida de 32 GB que además escribe el habla original junto a la traducción. Las demás versiones están en el apéndice.
Dos límites de entrada. Solo hace de chino a inglés y de inglés a chino. Su página de descarga enumera 40 idiomas, pero su texto y el software oficial solo admiten esas dos direcciones. SimulInfer rechaza cualquier otra dirección con un error. Y no habla por sí mismo: la salida de voz necesita un segundo modelo, Qwen3-TTS, que corre como un servicio aparte a su lado.
Los autores prometen el retraso y la calidad de un intérprete, y no repetimos sus pruebas
La afirmación principal de los autores va sobre el retraso. En charlas largas grabadas de una prueba pública, iba unos 3 segundos por detrás del orador según su medida. Fue el valor más bajo de todos los sistemas de su comparación, que incluye servicios comerciales de traducción en directo. En FLEURS, un conjunto público de clips cortos leídos, su puntuación de calidad de traducción queda entre la de los traductores en directo de Google y de Alibaba: 90,3, frente a 92,4 y 88,4. En otras tres pruebas de clips cortos queda primero en una y por detrás de Google o de Alibaba en las otras dos.
También lo compararon con seis intérpretes profesionales en 18 grabaciones en chino e inglés de unos seis minutos cada una. Su página del modelo dice que la calidad estuvo a la altura de los expertos, a menudo con menos retraso, y solo para esas muestras. Vimos el modelo en el vídeo de noticias de AI Search del 1 de noviembre. El vídeo dice que supera a los intérpretes humanos, lo que es más fuerte que lo que afirman los autores. Nos quedamos con los autores.
Nuestra prueba: una tarjeta, cuatro clips leídos, reproducidos a velocidad de habla
Tres preguntas: ¿funciona en una tarjeta de 48 GB, cuánto va por detrás y qué cuesta la voz? Usamos una RTX 6000 Ada en nuestra nube.
El audio salió de FLEURS, un conjunto público de frases de estilo Wikipedia leídas en voz alta, con traducciones humanas. Montamos cuatro clips de 50 a 56 segundos, dos en chino y dos en inglés, de cinco o seis frases cada uno. Mandamos cada clip al servicio en trozos de una décima de segundo a velocidad normal de habla, como lo haría un micrófono. Después apuntamos cuándo volvía cada trozo de traducción.
Los límites: cuatro clips leídos, una ejecución de cada uno más algunas repeticiones, una sesión cada vez. No probamos charlas largas, habla espontánea, acentos ni salas con ruido. Te dice si el modelo sigue el ritmo y, a grandes rasgos, cómo traduce. No es un benchmark, y nadie habló encima de nadie.
Siguió el ritmo: primeras palabras en 2 a 5,5 segundos
Cada frase del primer clip chino quedó terminada entre 0 y 2 segundos después de que el orador la acabara. Su primera frase terminó a los 10,9 segundos, y su traducción ya estaba completa a los 10,5. Por dentro, el servicio le pasa al modelo un trozo nuevo de 1,6 segundos de audio. Un trozo típico tuvo respuesta entre 0,4 y 0,8 segundos después de acabar, en los cuatro clips. Uno de cada diez tardó 1,5 segundos o más, el más lento 2,9.
| Clip | Espera típica al acabar un trozo | Primeras palabras | ¿Terminado? |
|---|---|---|---|
| Chino 1 (49,8 s) | 0,81 s | 5,5 s | sí |
| Chino 2 (52,7 s) | 0,74 s | 2,3 s | sí |
| Inglés 1 (53,6 s) | 0,73 s | 4,4 s | sí |
| Inglés 2 (55,7 s) | 0,43 s | 4,0 s | no |
Las primeras palabras tardan unos segundos porque el modelo espera hasta tener algo que merezca la pena decir.
Si no lo necesitas en directo, hay un modo más rápido. Subidos como un fichero entero, de 50 a 56 segundos de habla volvieron traducidos en unos 26 segundos, más o menos el doble de rápido de lo que dura el audio.
De chino a inglés aguantó, de inglés a chino se dejó frases
La velocidad fue pareja en las dos direcciones, la precisión no. Puntuamos cuánto se parecía la redacción de cada salida a traducciones humanas, de 0 a 100. Como referencia, una versión más pequeña que probamos más abajo acertó todas las frases del primer clip chino y sacó 66. Los clips chinos sacaron 60,6 y 51,7 hacia el inglés, y los ingleses 42,2 y 23,4 hacia el chino.
El clip del 23,4 perdió dos de sus seis frases. Una frase, sobre las vías navegables interiores como tema de viaje, no salió nunca. Repetimos ese clip aparte y volvió a descartarla. Otra frase, sobre un nadador olímpico, se encogió a cinco caracteres chinos que significan "el medallista fue". Una tercera frase invirtió su sentido: el orador dijo "couldn't have included" y la traducción dice "could include". El servicio marcó esa ejecución como incompleta. En el otro clip en inglés, la ejecución principal se dejó una frase sobre los raíles de hierro en 1767.
Esa negación invertida es el tipo de error que quien escucha no puede detectar. Una frase que falta deja un hueco que quizá notes. Un "could" equivocado suena perfectamente fluido.
No sabemos por qué. Subido como fichero entero, el mismo clip también volvió marcado como incompleto, así que el montaje en directo no es la única causa. Trata la dirección de inglés a chino como algo que hay que probar antes con tu propio audio.
El clon de voz llena la tarjeta, y solo funcionó de chino a inglés
El clon de voz funcionó en una dirección y se atascó en la otra. Copia la voz del orador a partir de los primeros segundos de su propia habla y lee la traducción en voz alta con ella. No hace falta una grabación de referencia. Corre como un segundo modelo pequeño, Qwen3-TTS-0.6B del equipo Qwen de Alibaba, en la misma tarjeta.
En el primer clip chino, la primera voz en inglés salió a los 8,7 segundos del clip. En total produjo 33,7 segundos de audio en inglés para 49,8 segundos de chino. La traducción de texto mantuvo su ritmo, así que la voz no frenó al traductor. Lo que sí se llevó fue la memoria: la tarjeta pasó de 38 GB a 48 GB en uso, casi la tarjeta entera.
De inglés a chino con la voz activada no respondió nunca. El audio terminó y después no volvió nada durante más de cuatro minutos. Estado: pendiente, sin investigar. En esta ejecución desatendida nadie escuchó tampoco la voz clonada, así que no afirmamos nada sobre cuánto se parece.
Qué GPU: una tarjeta real de 48 GB es el tamaño probado, 32 GB está sin probar
La tarjeta más pequeña que lo sirvió es una tarjeta real de 48 GB. Probamos dos opciones más baratas en la misma tarjeta de 48 GB.
- Un presupuesto de 32 GB, simulado. Le dijimos al servidor que usara solo 32 GB de los 48. Arrancó, con sitio para una conversación mucho más corta y un solo oyente cada vez. Tradujo los dos clips de prueba al mismo ritmo en directo. Pero el arranque ocupa un momento la tarjeta entera, en todas las ejecuciones, antes de estabilizarse. Un límite de memoria no lo impide, así que una tarjeta real de 32 GB, como una RTX 5090, puede fallar al arrancar.
- La versión de 4 bits, unos 21 GB. El fichero de 4 bits de los autores, una versión solo de traducción, funcionó en 21 GB en la tarjeta de 48 GB. Tradujo todas las frases de los dos clips que recibió, menos de un minuto de habla en unos 3 segundos, sin contar la carga del modelo. La pega: necesita una versión preliminar de otra herramienta y solo traduce un fichero terminado. Todavía no hay ningún servidor que pueda cargarla.
No probamos la versión completa de 61 GB, una tarjeta real de 32 GB o de 24 GB, ni varios oyentes a la vez.
En InferenceKey: tres servicios en una tarjeta que controlas, en marcha en unos 6 minutos, 73 segundos al reiniciar
Una tarjeta de 48 GB alojó el traductor, su servicio de streaming y la voz. En nuestra plataforma, un worker es una máquina con GPU, tuya o alquilada, que conectas a ella. Este modelo necesita algo más que un servidor de modelos normal, así que escribimos código Python que lo instala junto con SimulInfer y los arranca en orden.
Desde el primer despliegue en una máquina nueva, el servidor del modelo estuvo listo en unos 6 minutos. Un reinicio en la misma máquina estuvo listo en 73 segundos.
El primer problema con el que te vas a topar si despliegas tú la versión comprimida: SimulInfer no la reconoce. Solo conoce las versiones completas por su nombre, y se para con un error en chino que dice que no puede identificar el formato de salida del modelo. Nuestro código escribe el pequeño fichero que busca SimulInfer. Estado: arreglado en nuestro ejemplo, todavía sin arreglar por los autores cuando lo probamos.
Hay un límite que es nuestro. Nuestra API acepta un fichero subido de hasta un minuto, más o menos, y se lo reproduce al modelo a velocidad de habla. La línea de tiempo de llegadas vuelve al final. Un micrófono en directo todavía no puede pasar por nuestra API. Estado: pendiente. Los demás problemas y todos los tiempos están en el apéndice.
Para unas pocas llamadas a la semana, un servicio alojado de traducción en directo es el camino más corto. Este montaje es para equipos que quieren el modelo en una tarjeta que controlan.
¿Merece la pena? Sí de chino a inglés en tu propia tarjeta; la otra dirección, pruébala antes
- Si necesitas chino a inglés en directo, es una opción abierta sólida. Para un micrófono en directo hoy, conéctate directamente a SimulInfer en la tarjeta.
- Si necesitas inglés a chino, pruébalo con tu propio audio antes de que nadie dependa de él.
- Si quieres también la voz del orador, cuenta con una tarjeta entera de 48 GB y, por ahora, solo la dirección de chino a inglés.
- Si tienes una tarjeta de 24 GB o de 32 GB, la versión de 4 bits usó 20,5 GB en una tarjeta de 48 GB, solo para ficheros grabados. No la hemos probado en una tarjeta real de 24 GB, y necesita una compilación de llama.cpp sin fusionar.
- Si necesitas cualquier otro idioma, este no es tu modelo.
Ejecuta python publish.py y después python main.py desde el ejemplo del SDK de Hy-SimulMT. Despliega el mismo montaje en tu GPU y vuelve a reproducir tus clips a velocidad de habla, con los tiempos de llegada de cada trozo. Necesita un proyecto de InferenceKey con un token del SDK y una API key. Trae un worker privado de NVIDIA con 48 GB y unos 70 GB de disco. Los pasos de instalación están en el apéndice.
Para ingenieros
Créditos
- Hy-SimulMT: Tencent Hunyuan. Entrenaron el modelo y publicaron las versiones BF16, FP8, GGUF, Interleave, Interleave-FP8 e Interleave-GGUF, el plugin de vLLM
simulst, el servicio SimulInfer y su lanzador, la integración de TTS, el soporte de llama.cpp para las versiones GGUF (PR #31198, todavía abierta), los benchmarks y la comparación con intérpretes. Repos: base, Interleave-FP8, GGUF, GitHub. - Voz: Qwen3-TTS-12Hz-0.6B-Base del equipo Qwen, servido con vLLM-Omni.
- Servicio: el proyecto vLLM (0.32.0 para la traducción, 0.31.0 para la parte de TTS), el proyecto llama.cpp, al que se envió el soporte de GGUF, y el equipo de SGLang-Omni por su cookbook.
- Audio de prueba: FLEURS dev (Google, CC BY 4.0).
- Dónde lo vimos: AI Search, "AI finally sleeps, Gemini 4 Carbon, ...", 2026-11-01, Hy-SimulMT en el 10:02. Usamos su transcripción guardada, no lo vimos entero.
- Nuestra parte: el backend propio, el despliegue a través de la plataforma, el arnés de streaming, las mediciones, la escalera de VRAM, el ejemplo del SDK y el vídeo de la demo.
Modelo y ficheros
HYV3SpeechForCausalLM: torre de audio más un MoE Hunyuan v3, 48 capas, 128 expertos con top-8 por token más 1 compartido, 4 cabezas KV, head_dim 128. Unos 30B en total, unos 3B activos.- Interleave-FP8 (la versión que probamos; Interleave también escribe la transcripción del original): fp8 e4m3, activaciones dinámicas,
weight_block_size[128,128] en los expertos. lm_head, las compuertas del router y las proyecciones de atención se quedan en BF16. 32,16 GB (17 shards más un fichero de 0,66 GB con la torre de audio), sha7f37cb76. - Tamaños según la API de HF: BF16 60,86 GB, GGUF Q4_K_M 19,75 GB, Q8_0 33,31 GB (solo traducción, un único fichero con el proyector de audio dentro).
- Licencia:
apache-2.0en las fichas de base e Interleave-FP8,LICENSE-Hy-SimulMT.txten el repo (Apache-2.0 salvo las partes de terceros indicadas). La ficha de GGUF no tiene campo de licencia. Ninguno de los repos tiene acceso restringido. - Etiquetas de idioma: la ficha enumera 40, pero el texto de la ficha, SimulInfer y la receta de SGLang-Omni solo admiten zh<->en.
- Direcciones: SimulInfer lanza un
ValueErrorsalvo que la dirección seazh-enoen-zh(simulinfer/translation.py:36), y el cliente solo ofrece esas dos (client.py:90). - Tabla de clips cortos de los autores (no reproducida): Hy-SimulMT FLEURS 90,3, CoVoST2 75,5, ACL6060 81,2, RealSI-Sentence 84,7. Gemini3.5-LiveTranslate 92,4 / 74,4 / 82,6 / 82,2, Qwen3.8-LiveTranslate 88,4 / 82,1 / 80,5 / 84,4. StreamLAAL en RealSI de formato largo unos 3 s, el más bajo de su gráfica; GEMBA por encima de los modelos abiertos y de cuatro de cinco APIs comerciales. StreamLAAL no es el tiempo hasta la primera voz.
- SGLang-Omni (no lo probamos): checkpoint BF16 solo de traducción, solo texto, unos 57 GiB de pesos, una sola H200.
sgl-omni serve --model-path tencent/Hy-SimulMT-30B-A3B --mem-fraction-static 0.75 --enable-realtime --port 8000. Entrada offline de hasta 30 s por petición, tiempo real en/v1/realtime?intent=transcription(PCM16 a 16 kHz, hipótesis cada 1,6 s), el contexto se reinicia pasados 30 s, sin el VAD ni las heurísticas de recuperación de SimulInfer.
Elección de GPU y backend
- GPU prevista: una L40S de 48 GB. No había disponible en nuestra nube en el momento de la prueba. Una primera máquina L40 arrancó sin SSH directo y el manager la descartó a los 3 minutos, más o menos. Usamos una RTX 6000 Ada Generation de 48 GB (49.140 MiB, sm_89, driver 595.91.07, CUDA 13.2), misma generación Ada y misma memoria que la L40S.
- FP8 en Ada: vLLM 0.32.0 ejecuta estos expertos FP8 por bloques con el kernel Marlin de solo pesos ("Your GPU does not have native support for FP8 computation ... Weight-only FP8 compression will be used"). Una L40S haría lo mismo. El modo fichero siguió yendo a unas 2x tiempo real.
- Por qué un backend propio: el backend
vllmde serie no puede añadir el pluginsimulst, y la lógica simultánea vive en SimulInfer, un servicio aparte delante de vLLM. - Backend
hy-simulmt0.1.2:setup()descarga Hy-SimulMT en7efcb18c, monta un entorno de Python 3.12 con uv (vllm==0.32.0,simulst[audio]==0.1.0,SimulInfer[vad]), descarga la revisión fijada al disco del contenedor, ejecutasimulinfer-prepare-model, escribeexport_manifest.jsoncuando falta, saca el comando de vLLM desimulinfer.launch --dry-runy después arranca SimulInfer con la configuración por defecto de los autores apuntando a loopback. Entorno de TTS opcional (vllm==0.31.0,vllm-omni==0.31.0rc1) consimulinfer-tts-omnia util 0.15. - Flags de vLLM tal como se ejecutó:
--enforce-eager, prefix caching, chunked prefill,--limit-mm-per-prompt '{"audio":1024}', la plantilla de chat de los autores,--gpu-memory-utilization 0.78 --max-model-len 8192 --max-num-seqs 4 --max-num-batched-tokens 4096. process(): multipart o JSON,direction(olanguage),transportrealtime(WebSocket, paquetes PCM16 de 100 ms al ritmo del tiempo real) ofile(SSE de/translate/stream),tts. Devuelve el texto, el texto original, cada evento cont_ms, los retrasos, el primer texto y el wav del TTS.- Los procesos hijos reciben
PR_SET_PDEATHSIG, y un backend reiniciado para los servidores que quedaron enservers.pid.
Paso a paso con el ejemplo del SDK
Ejemplo: hy-simulmt-speech-translation-custom-backend-private-nvidia, commits 61f823f (ejemplo) y 769745e (nota en el README sobre el pico de memoria al arrancar).
git clone https://github.com/inferencekey/inferencekey-sdk
cd inferencekey-sdk/examples/hy-simulmt-speech-translation-custom-backend-private-nvidia
cp .env.example .env        # SDK token, API key, IK_WORKER_ID, IK_CLIPS
pip install -r requirements.txt
python publish.py           # uploads the custom backend
python main.py              # ensure -> wait -> each clip in realtime -> outputs -> delete
- Necesita una GPU NVIDIA de 48 GB, probada con y sin el sidecar de voz (el README del ejemplo dice 40 GB o más, que no probamos; el pico de arranque llena 47,4 GiB), un driver con soporte de CUDA 13 y unos 70 GB de disco.
- Variables de entorno:
IK_WORKER_ID,IK_KEEP_ALIVE=1(mantiene el despliegue),HYSIMULMT_TTS=1(clon de voz),HYSIMULMT_GPU_MEMORY_UTILIZATION,HYSIMULMT_MAX_MODEL_LEN,HYSIMULMT_MAX_NUM_SEQS. - Endpoint:
/v1/audio/transcriptionsconfile,direction(zh-enoen-zh),transport(realtimeofile) ytts. Límite de 2 MiB por petición, más o menos un minuto de WAV a 16 kHz.
Fuera de nuestra plataforma, el camino de un solo comando de los autores es:
git clone https://github.com/Tencent-Hunyuan/Hy-SimulMT && cd Hy-SimulMT/SimulInfer
git checkout 7efcb18c   # the commit we tested
bash deploy.sh --install-server --model tencent/Hy-SimulMT-30B-A3B-Interleave
# Ready: http://127.0.0.1:8080/   (model server on :8800)
curl -N http://127.0.0.1:8080/translate/stream -F direction=en-zh -F file=@audio.wav
Ese comando carga la versión Interleave en BF16 (solo la base BF16 ya ocupa 60,86 GB), que no entra en la tarjeta de 48 GB que probamos aquí. En 7efcb18c, SimulInfer tampoco reconoce los nombres de los repos FP8 sin el arreglo de export_manifest.json (problema 1).
Endpoints de SimulInfer: GET /health, GET /config, GET /, POST /translate/submit, GET /translate/task/{task_id}, POST /translate/stream, WebSocket /translate/ws. Valores por defecto: bloques de 1600 ms (standard), VAD activado, max_sessions 4, timeout de 900 s, ws_audio_mode noise_resistant. Para la voz: simulinfer-tts-omni --model Qwen/Qwen3-TTS-12Hz-0.6B-Base --host 0.0.0.0 --port 8091 y [tts] tts_backend = "vllm_omni", tts_url = "http://127.0.0.1:8091/v1".
Todas las mediciones
Tiempo hasta estar listo:
- En frío (backend 0.1.0): unos 6,2 min desde
ensure()hasta la API de vLLM. Entorno 47,2 s, descarga de 32 GB 26,0 s, import de vLLM unos 2 min (la CPU de la máquina también estaba compilando llama.cpp), carga de pesos 27,5 s, inicio del motor 71,2 s. - En caliente (0.1.1): 73 s (vLLM 57,2 s, SimulInfer 6,0 s).
- Con la construcción del entorno de TTS (0.1.2): 376 s.
Traducción, RTX 6000 Ada, FP8 Interleave, valores por defecto de SimulInfer:
| Clip | Modo | Audio s | Reloj s | Primer texto | Retraso por bloque mediana / p90 / máx. (ms) | Retraso tipo LAAL (nuestro) | chrF | BLEU | complete |
|---|---|---|---|---|---|---|---|---|---|
| zh1 zh->en | realtime | 49,8 | 51,07 | 5,51 s | 809 / 1546 / 2058 | 7,34 s | 60,6 | 28,8 | true |
| zh2 zh->en | realtime | 52,66 | 53,55 | 2,34 s | 738 / 1847 / 2907 | 3,98 s | 51,7 | 15,8 | true |
| en1 en->zh | realtime | 53,64 | 54,08 | 4,44 s | 733 / 1633 / 1876 | 1,58 s | 42,2 | 48,5 | true |
| en2 en->zh | realtime | 55,68 | 55,82 | 3,97 s | 434 / 1774 / 2729 | 15,18 s (inflado por las frases perdidas) | 23,4 | 25,1 | false |
| zh1 | file | 49,8 | 26,29 | no CA 5,50 s | 62,8 | 32,0 | true | ||
| zh2 | file | 52,66 | 27,52 | no CA 3,02 s | 51,8 | 16,4 | true | ||
| en1 | file | 53,64 | 25,34 | no CA 4,22 s | 29,5 | 33,2 | true | ||
| en2 | file | 55,68 | 25,05 | no CA 6,50 s | 39,2 | 47,1 | false |
- Retraso por bloque = hora de reloj de llegada menos la posición final en el audio del bloque que la produjo. Los bloques son de 1,6 s, así que una palabra del principio de un bloque espera más que el retraso por bloque.
- Puntuación de calidad: chrF de sacrebleu, que cuenta las secuencias de caracteres compartidas entre la salida y la referencia, de 0 a 100.
- El retraso tipo LAAL es nuestra aproximación sobre el clip entero (alineación uniforme frente a la longitud de la referencia, teniendo en cuenta el cómputo), no el StreamLAAL de los autores, y no es comparable con sus 3 s.
- chrF y BLEU con sacrebleu 2.6.0 (tokenizador BLEU
zhpara la salida en chino). Un clip de cada: no es un benchmark. - A través de
main.pyen la plataforma: zh1, primeras palabras a los 6,14 s, mediana de 825 ms; en1, 4,44 s, mediana de 713 ms. - Tester del panel: un clip chino de 20 s devolvió
ok · 20943 mscon "The UN also hopes to eventually establish a fund to help relevant countries address the impacts of global warming. Soon, police equipped with riot gear entered the courtyard, and used tear gas to corner the prisoners."
Memoria de la GPU:
- vLLM: carga del modelo 30,05 GiB, caché KV 5,09 GiB = 55.552 tokens, concurrencia máxima 6,78x a 8.192 tokens.
- nvidia-smi cada segundo: 38.256 MiB sirviendo, 48.302 MiB con Qwen3-TTS, 48.510 MiB (la tarjeta entera) durante el perfilado del codificador en el arranque, en todas las ejecuciones.
Clon de voz (zh1 con tts=true): primer audio a los 8.721 ms, 33,67 s de inglés mono a 24 kHz para 49,8 s de entrada, primer texto a los 5,52 s, retraso por bloque mediana de 820 ms, p90 de 1.538 ms, ida y vuelta de 56,2 s.
Escalera de VRAM
| GPU o límite | Configuración | VRAM pico | Tiempo por salida | ¿Salida correcta? | Real o emulada |
|---|---|---|---|---|---|
| RTX 6000 Ada 48 GB | FP8 Interleave, vLLM 0.32 + SimulInfer, util 0.78, len 8192, 4 seqs, batched 4096 | 37,4 GiB (47,4 GiB al arrancar) | unos 26 s por fichero de 50 a 56 s | sí (en2 pierde frases) | real |
| la misma + Qwen3-TTS 0.6B | + vLLM-Omni 0.31.0rc1, util 0.15 | 47,2 GiB | primer audio a los 8,7 s | zh->en sí, en->zh atascado | real |
| Límite de 32 GB en la tarjeta de 48 GB | util 0.66 (31,27 GiB), len 4096, 1 seq, 7.136 tokens de KV | 31,6 GiB (el arranque sigue en 47,4 GiB) | 51,6 s de reloj zh1, 55,0 s en1 (realtime) | sí: zh1 chrF 62,8, en1 chrF 37,6 | emulada |
| GGUF Q4_K_M, 19,75 GB | llama.cpp PR #31198 (d38e66aa), llama-mtmd-cli -ngl 99 -c 16384, fichero offline | 20,5 GiB | 3,2 s de turnos por clip, unas 16x tiempo real | sí: todas las frases, zh1 chrF 66,1, en1 chrF 42,3 | medido en la tarjeta de 48 GB, no se puede servir |
El límite de 32 GB se queda en 32.394 MiB frente a los 32.607 MiB de una RTX 5090, sin margen, y el límite no cubre el pico del arranque. Sin probar: una tarjeta real de 32 GB o de 24 GB, BF16, SGLang-Omni, Interleave-GGUF, el FP8 sin Interleave, concurrencia.
Problemas y estado
- SimulInfer no reconoce los checkpoints FP8.
ValueError: 无法识别所选模型的输出格式...desdemodel_discovery.py: no hayexport_manifest.jsony el nombre no está enPROVIDED_CHECKPOINTS. Arreglado en nuestro backend (escribe el manifiesto). Pendiente en el proyecto original en7efcb18c. - El perfilado del codificador al arrancar llena la tarjeta. Con los 16.384 batched tokens de los autores, vLLM perfiló 3.276 elementos de audio ficticios, registró miles de avisos de OOM del asignador y después se recuperó. Nosotros usamos 4.096. El pico de 47,4 GiB (48.510 MiB) se mantiene, incluso con un límite de 0,66. Una tarjeta más pequeña puede fallar aquí.
- La trampa de versiones de vLLM-Omni. 0.32.0 y 0.32.0rc1 fallan con
ImportError: cannot import name 'Qwen3TTSSpeakerEncoder'. 0.31.0rc1 sobre vLLM 0.31.0 funciona. Arreglado en el backend 0.1.2. - De inglés a chino con voz se atascó al terminar el audio, sin respuesta tras 4 minutos con la GPU ociosa. Pendiente, sin investigar.
- Frases perdidas y deformadas de inglés a chino (en2 en tiempo real y en modo fichero, la misma frase perdida en una segunda ejecución; en1 perdió una vez la frase de 1767). Comportamiento del modelo o del streaming, lo contamos tal cual.
- Sin micrófono en directo a través de nuestra API. Límite de 2 MiB por petición y sin paso directo de WebSocket. El backend reproduce el audio subido a su ritmo y devuelve los eventos con sus tiempos al final. Pendiente.
- Un vLLM huérfano tras un reintento del watchdog retuvo 47,4 GiB después de un arranque fallido. Arreglado en 0.1.1 con una comprobación de servidores obsoletos.
- FP8 Marlin de solo pesos en Ada (ver arriba). No es un fallo, es una nota de velocidad.
Vídeo de la demo
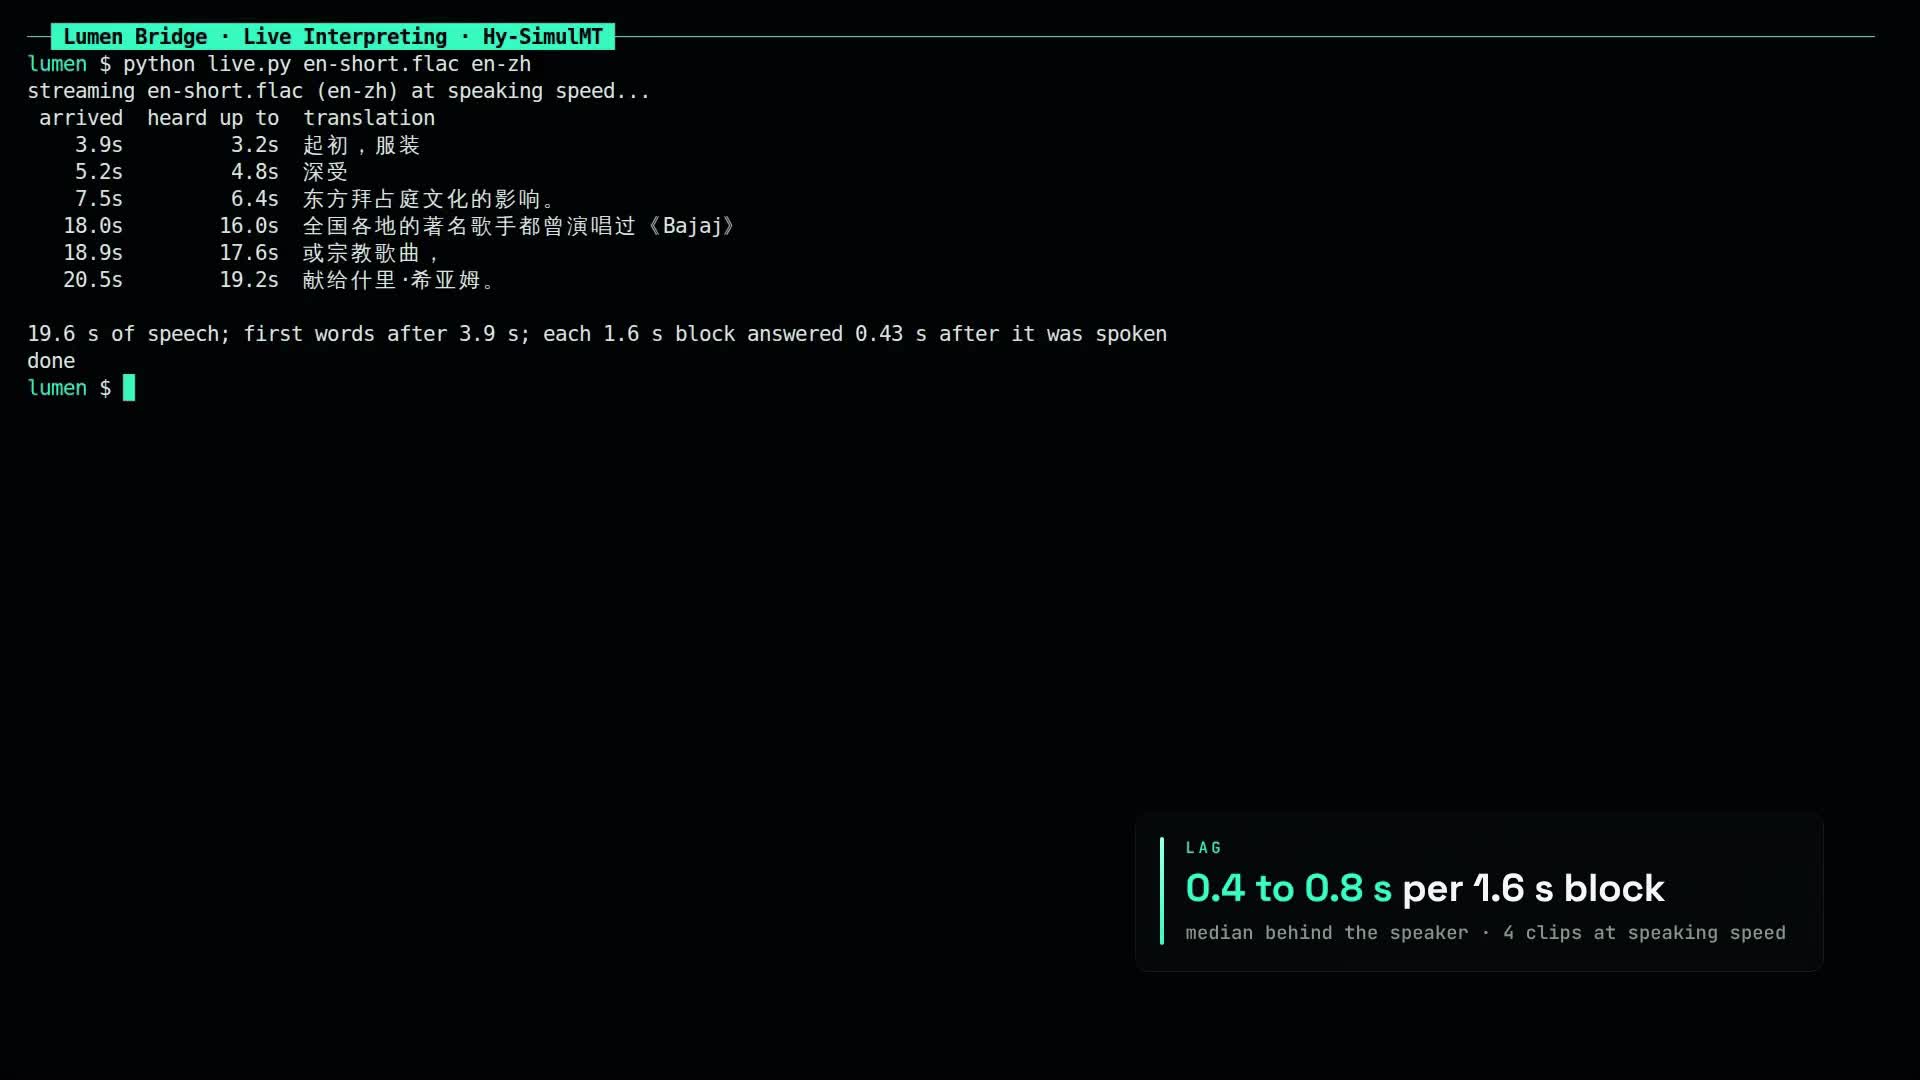
161 s, 1920x1080, narrado, con capítulos y un fichero de subtítulos de 40 entradas. Muestra las demos de los autores con su crédito, el despliegue en el panel, el tester, los tiempos de llegada en el terminal y la escalera de memoria.
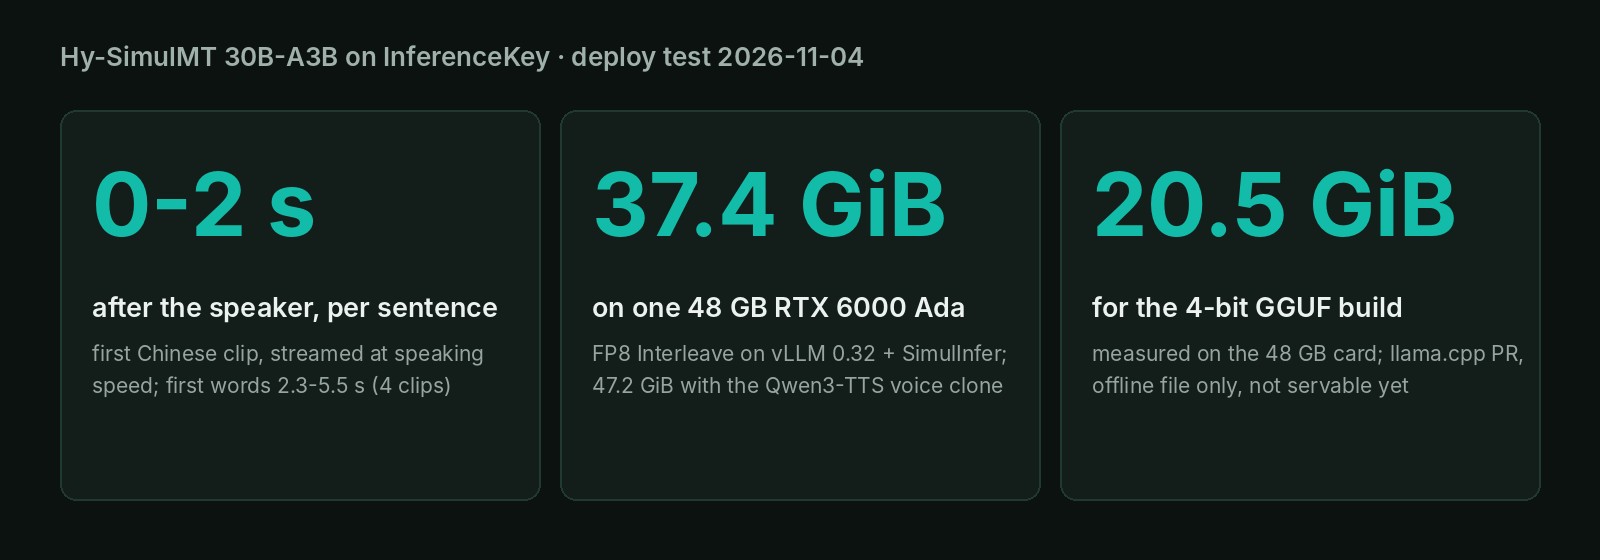
Límites de esta prueba
- Cuatro clips leídos de FLEURS, una ejecución de cada uno más repeticiones, una sesión cada vez. chrF sobre clips sueltos no es un benchmark.
- Nuestra medida del retraso no es StreamLAAL. No reprodujimos los benchmarks de los autores ni la comparación con intérpretes.
- Ninguna persona escuchó la voz clonada.
- Los datos de origen salen del repo en el commit
7efcb18c(2026-10-27). No comprobamos cambios posteriores en el proyecto original, como que SimulInfer aprenda los nombres FP8 o que se fusione la PR de llama.cpp.
Fuentes
- tencent/Hy-SimulMT-30B-A3B (ficha del modelo, benchmarks, comparación con intérpretes)
- tencent/Hy-SimulMT-30B-A3B-Interleave-FP8
- tencent/Hy-SimulMT-30B-A3B-GGUF
- Tencent-Hunyuan/Hy-SimulMT y su guía de TTS
- Cookbook de SGLang-Omni para Hy-SimulMT (solo BF16, solo texto, una sola H200)
- Vídeo de noticias de AI Search, 2026-11-01 (donde lo vimos)
- Nuestros artículos anteriores sobre voz: Nemotron 3.5 Transcribe, Underdog Bark, Ming TTS