LFM3-Omni-2B: ein 4,5-GB-Modell hört, sieht und antwortet laut, auf 5 GB GPU
Das 2B-Omni-Modell von Liquid AI beantwortete gesprochene Fragen laut und las Fotos und Videos mit etwa 5 GB GPU-Speicher. Eine 16-GB-Karte hielt mit.
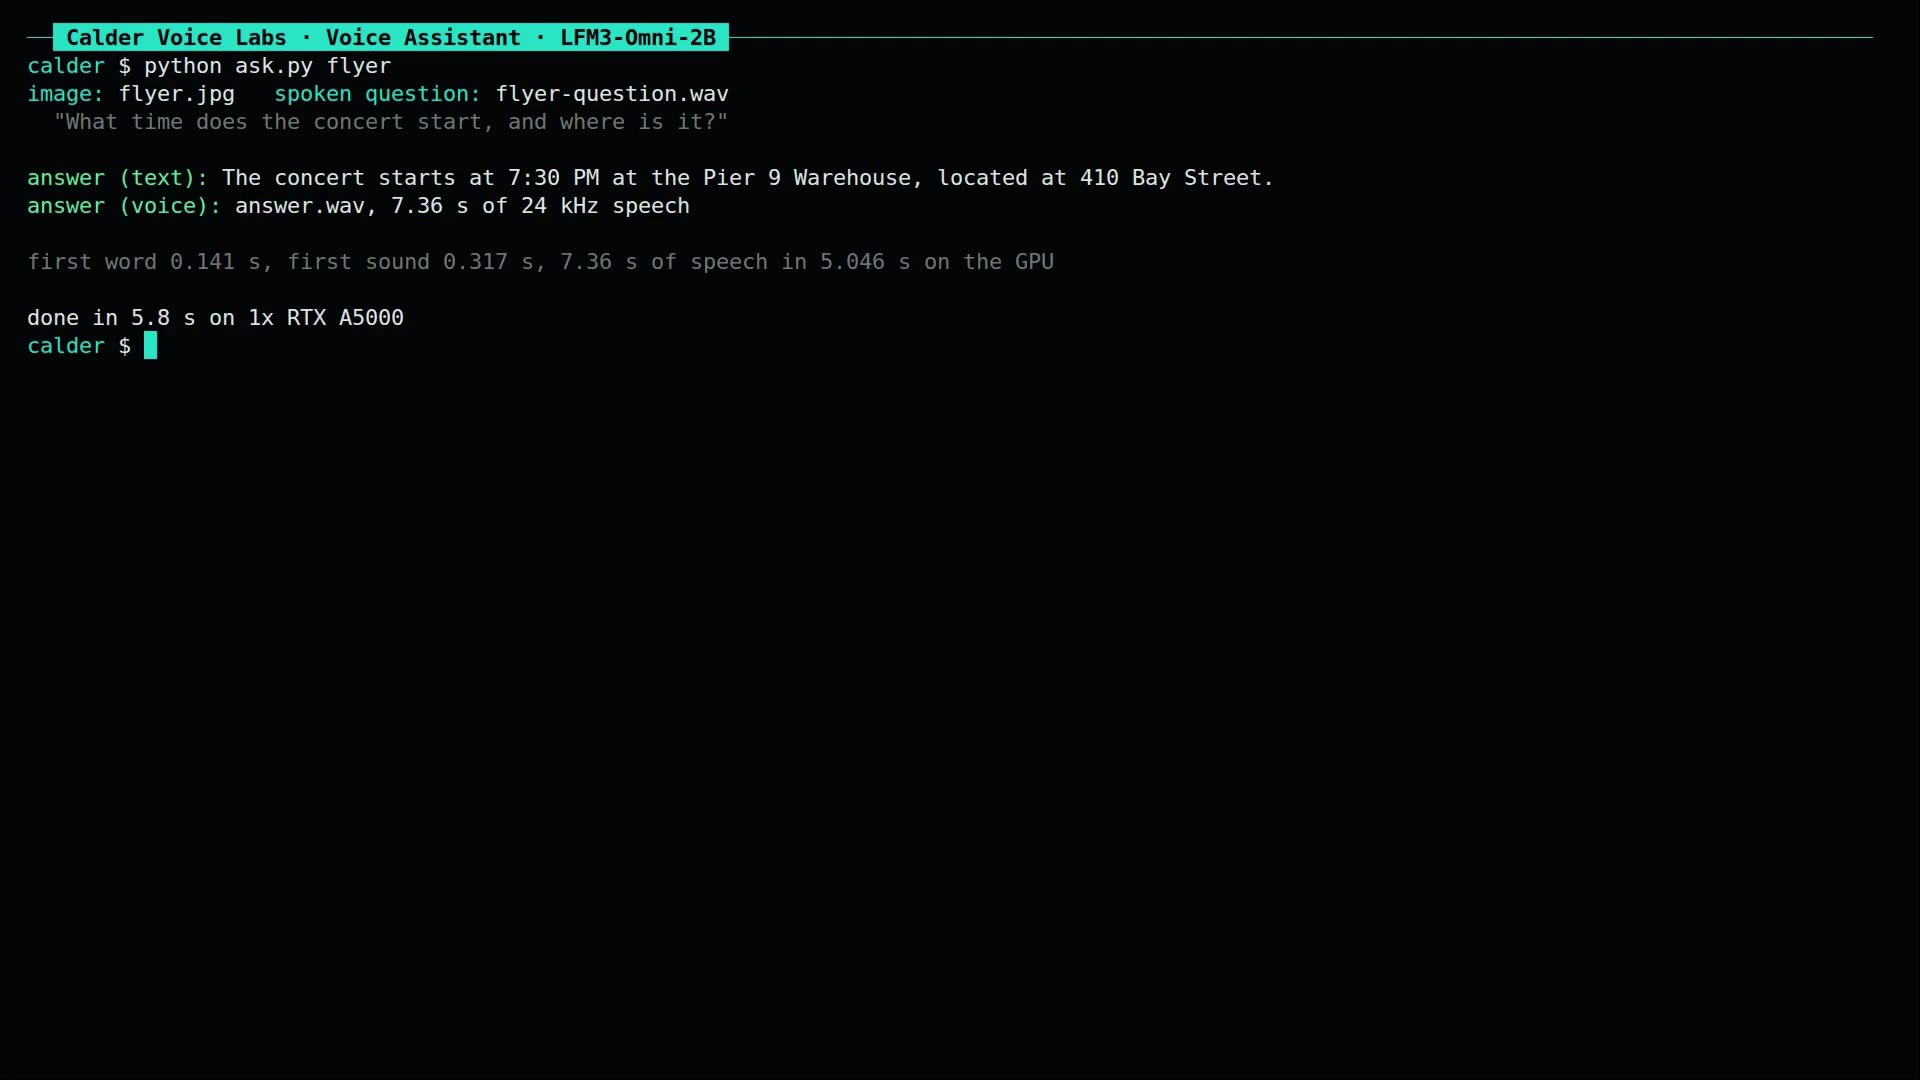
Wir haben LFM3-Omni-2B ein Konzertplakat gezeigt, laut gefragt, wann und wo das Konzert ist, und die GPU hatte die schriftliche Antwort in unter einer Sekunde: 7:30 PM, Pier 9 Warehouse. Ein Sprachassistent braucht dafür normalerweise vier Modelle: eins zum Hören, eins zum Sehen, eins zum Denken und eins zum Sprechen. Dieses offene Modell von Liquid AI ist ein einziger Satz Gewichte mit 4,5 GB, der alle vier Aufgaben übernimmt. Wir haben es über InferenceKey auf einer RTX A5000 in unserer Cloud laufen lassen, und es antwortete auch mit eigener Stimme, mit etwa 5 GB GPU-Speicher.
Wenn du eigene GPUs betreibst, heißt das: Jede Stufe eines Sprachassistenten passt auf eine kleine Karte. Es gibt zwei Haken. Der schnelle Open-Source-Server für dieses Modell, SGLang, schreibt nur Text. Für Sprache haben wir deshalb den Code des Modells selbst verwendet, in unserem Test bei Text etwa viermal langsamer. Und die Lizenz endet für kommerzielle Nutzung bei 10 Millionen US-Dollar Jahresumsatz.
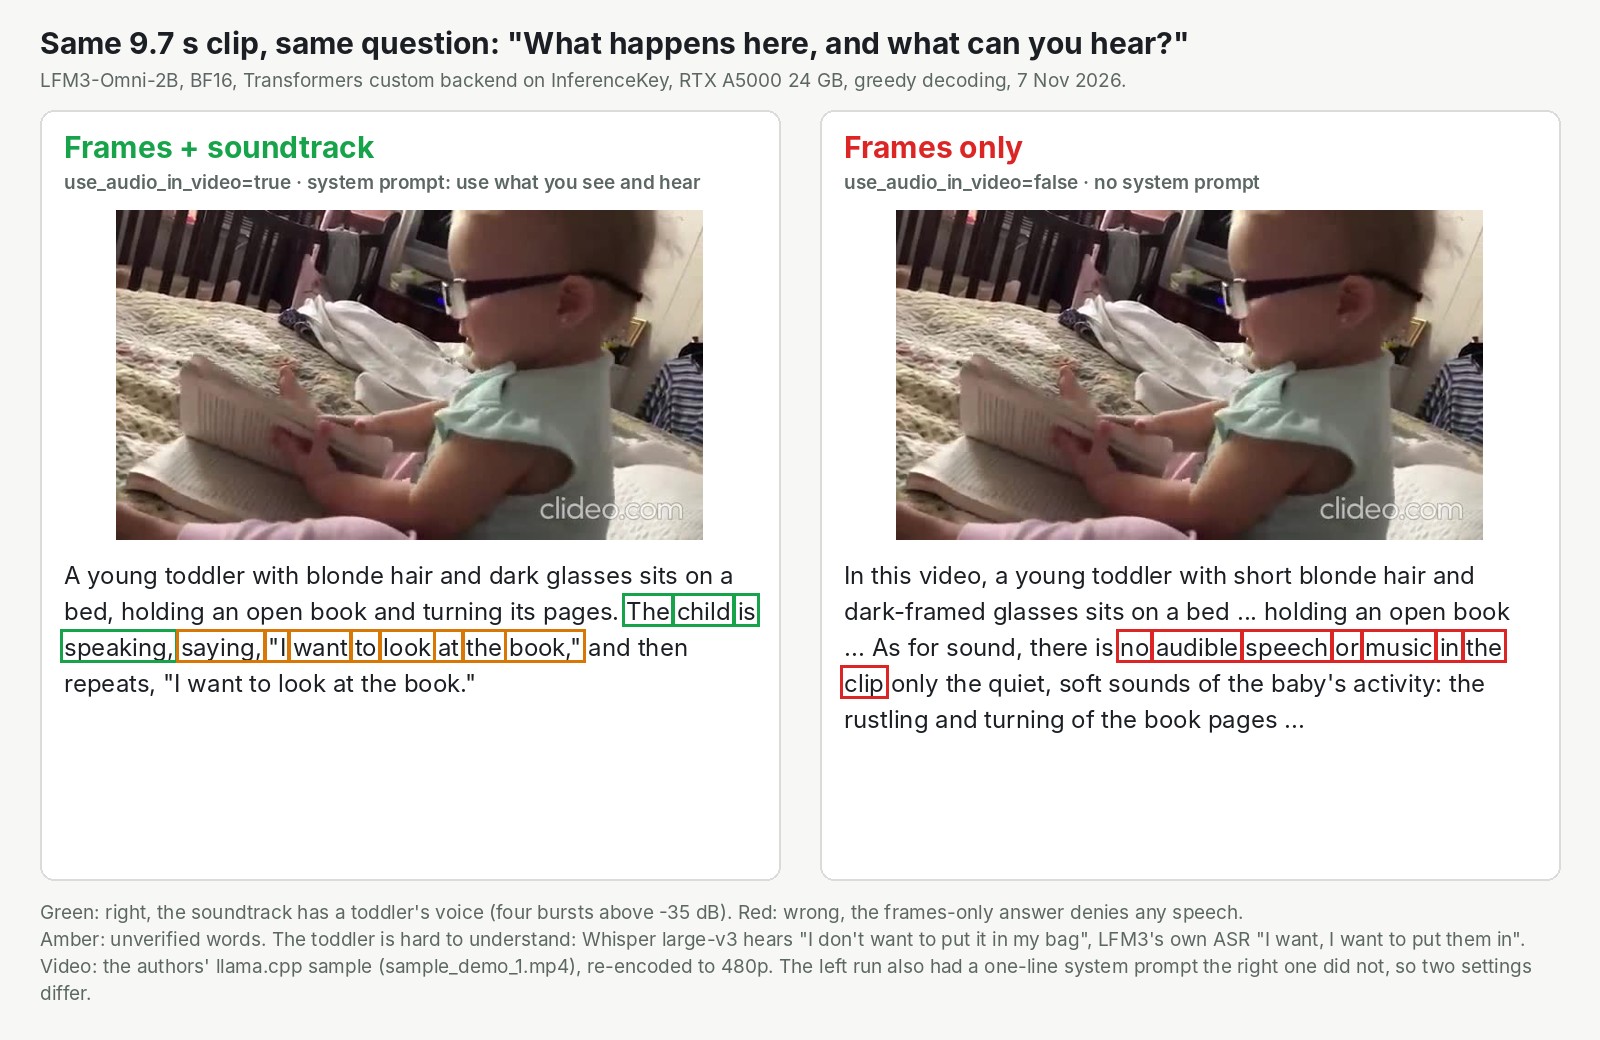
Derselbe Clip, dieselbe getippte Frage. Mit Tonspur hört das Modell ein Kind sprechen. Nur mit Bildern sagt es, der Clip sei still. Der Lauf mit Ton hatte zusätzlich eine einzeilige Anweisung, das Gesehene und Gehörte zu nutzen, also änderten sich zwei Einstellungen, nicht eine. Trotzdem konnte nur der Lauf, der den Ton bekam, erkennen, dass da etwas zu hören war.
Ein kleines Modell, wo ein Sprachassistent sonst vier hintereinanderschaltet
Laut der Model Card von Liquid AI „replaces a separate ASR model, vision-language model, LLM and TTS model“. Einfach gesagt: Spracherkennung, ein Bildmodell, ein Sprachmodell und eine Sprachsynthese in einem Netz. Unser Test fragte, ob das auf einer kleinen Karte hält.
Es nimmt Text, Bilder, Video mit Tonspur und aufgenommene Sprache an. Es antwortet in Text, in Sprache oder in beidem zugleich. Im letzten Modus schreibt es einen Satz und spricht ihn im selben Durchgang, sodass Bildschirm und Lautsprecher dieselbe Antwort bekommen. Laut der Liste von Liquid AI spricht es 19 Kombinationen aus Sprache und Akzent, von Arabisch bis Chinesisch, mit Frauen- und Männerstimmen; wir haben Englisch und Spanisch ausprobiert. Es kann etwa 32.000 Wortteile im Blick behalten: ein langes schriftliches Transkript, aber nur wenige Minuten Video, denn allein unser einminütiger Clip belegte etwa 8.500. Es antwortet sofort, ohne vorher verdeckt nachzudenken.
Liquid AI hat es auf LFM3-1.7B aufgebaut, ihrem neuen kleinen Sprachmodell. Dazu kamen ein Bildleser, ein Tonleser, der schon anfängt, während du noch sprichst, und ein Teil, der die Ausgabe in Audio umwandelt. Die LFM3-Ankündigung von Liquid AI stammt vom 27. Oktober. Es ist eines von sechs kleinen Modellen der Familie. Entdeckt haben wir es im News-Video von AI Search, dessen Sprecher es als ein winziges Modell zusammenfasste, das „see, hear, understand, and even talk back to you“ kann.
Die Autoren vergleichen es mit anderen kleinen offenen Modellen, die ebenfalls Ton und Video annehmen. Das sind ihre Zahlen. Wir haben sie nicht reproduziert.
| Test (Zahlen der Autoren) | LFM3-Omni-2B | Qwen2.5-Omni-3B | Qwen2.5-Omni-7B |
|---|---|---|---|
| Daily-Omni, Fragen zu Alltagsvideos mit Ton | 70,09 | 58,81 | 61,32 |
| OmniBench, gemischtes Schlussfolgern über Bild und Audio | 46,32 | 47,11 | 49,65 |
| Fehlerrate bei englischer Transkription (niedriger ist besser) | 6,36 | 6,30 | nicht angegeben |
Die erste Zeile gewinnt es deutlich, die zweite verliert es gegen beide Qwen-Modelle. Bei der Transkription liegt es gleichauf mit dem kleineren Qwen. Die Autoren drucken auch die Niederlagen ab, und das macht die Tabelle glaubwürdiger. Die vollständige Übersicht, einschließlich der kleinen Gemma-4-Modelle von Google, steht im Anhang.
Unser Test: zwei kleine Karten und eine Handvoll kurzer Aufnahmen
Wir haben das vollständige, unkomprimierte Modell über InferenceKey auf zwei GPUs in unserer Cloud laufen lassen: einer RTX A5000 mit 24 GB für den Hauptlauf und einer RTX 2000 Ada mit 16 GB auf einer frischen Maschine. Beide nutzten denselben Code.
Die Fälle waren klein und praktisch. Eine gesprochene Frage zu einem Berg, per Stimme beantwortet. Ein ausgedachtes Konzertplakat plus eine gesprochene Frage dazu. Ein Clip aus einem öffentlichen Hörbuch-Datensatz zum Transkribieren. Eine gesprochene Bitte, die Lautstärke zu senken, die als Befehl zurückkommen sollte, den eine App ausführen kann. Zwei Sätze zum Vorlesen, auf Englisch und auf Spanisch. Und ein 10-Sekunden-Clip aus den eigenen Beispielen von Liquid AI, mit und ohne Ton.
Die Grenzen, einmal gesagt. Eine Anfrage nach der anderen. Unsere eigenen kurzen Eingaben, nicht die Benchmarks der Autoren. Kein Mensch hat die Stimme beurteilt: Ein separater Spracherkenner, Whisper, hat das Audio zurückgelesen. Nicht getestet haben wir die komprimierten Builds, den Echtzeit-Sprachserver, auf den Liquid AI verweist, und keine echte Karte unter 16 GB. Wir haben auch keine Kette aus vier separaten kleinen Modellen auf derselben Karte laufen lassen. Nichts hier zeigt also, dass der Weg mit einem Modell schneller, kleiner oder besser ist als diese Pipeline.
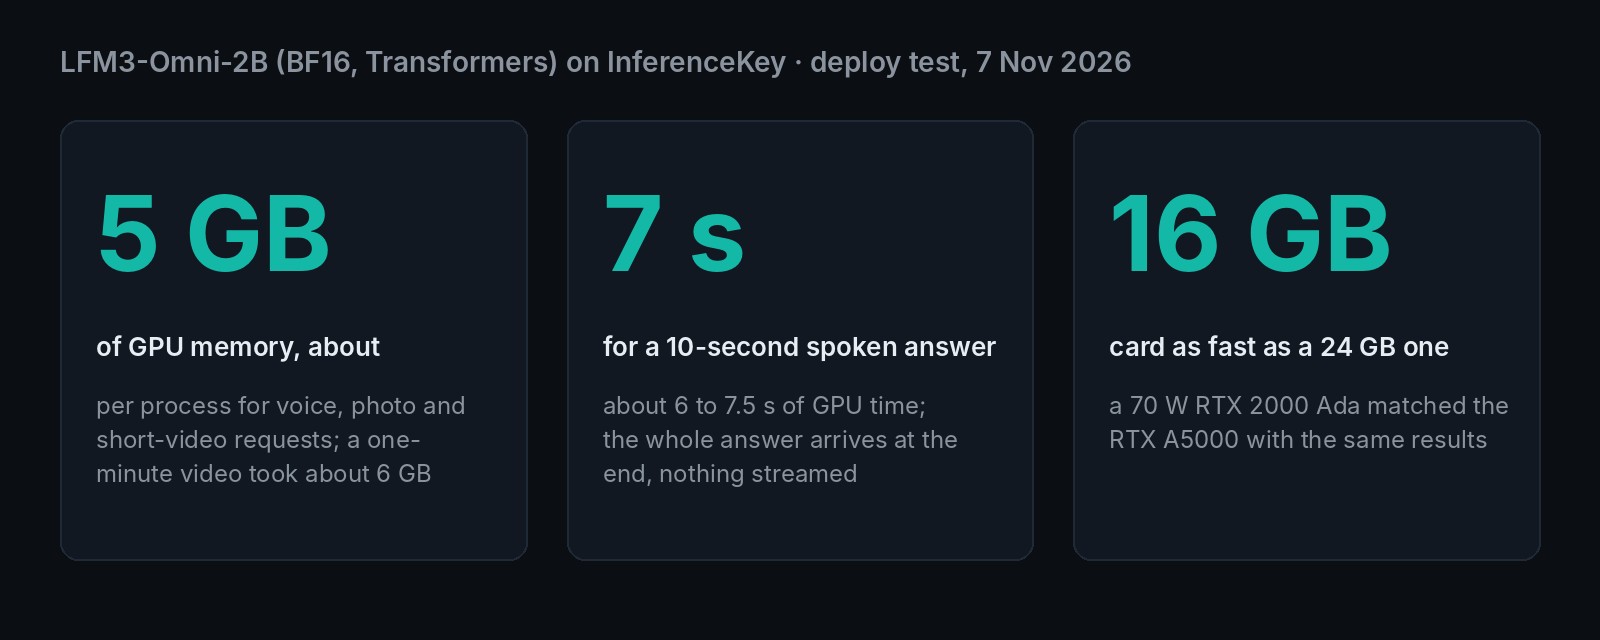
Eine gesprochene Antwort von 10 Sekunden: erzeugt in etwa 7 Sekunden, geliefert nach 8 bis 10
Eine gesprochene Antwort von 10 Sekunden war auf der GPU nach etwa 6 bis 7,5 Sekunden fertig. Beim Aufrufer kam sie nach 8 bis 10 Sekunden an, weil unser Setup das Audio am Ende als eine Datei schickt. Jede gesprochene Antwort brauchte zum Erzeugen weniger Zeit als zum Abspielen: Ein Satz von 4 Sekunden brauchte 2 bis 3 Sekunden.
| Was wir gefragt haben | Was zurückkam | GPU-Zeit (A5000 / 16-GB-Karte) |
|---|---|---|
| Eine gesprochene Frage nach dem höchsten Berg Afrikas, Antwort per Stimme | Kilimandscharo, 5.895 Meter, etwa 10 s Sprache | 7,4 s / 6,6 s |
| Konzertplakat plus gesprochene Frage nach Zeit und Ort | „The concert starts at 7:30 PM, and it is located at Pier 9 Warehouse, 410 Bay Street.“ | 0,84 s / 0,93 s |
| Hörbuch-Clip von 12,5 s, transkribieren | Exakt, abgesehen von Großschreibung und Kommas | 1,16 s / 1,01 s |
| Eine gesprochene Bitte, die Lautstärke auf 30 zu stellen, mit einem Lautstärke-Tool | set_volume({"volume": 30}) | 0,56 s / 0,45 s |
| Einen spanischen Satz vorlesen | Whisper hörte „El museo abre a las 10 de la mañana y cierra a las 6 de la tarde.“ | 2,3 s / 2,2 s |
So klingt die eigene Stimme des Modells, wenn es die Frage zum Plakat beantwortet:
Die gesprochene Antwort des Modells auf die Frage zum Plakat, 7,4 s, erzeugt auf der A5000
Im Server war das erste Stück Sprache nach 0,2 bis 0,5 Sekunden fertig. Streaming könnte die Wartezeit also verkürzen, aber wir haben Streaming weder gebaut noch getestet.
Wo es danebenliegt: eine Zahl in Fuß und Worte im Brabbeln eines Kleinkinds
Die einfachen Fakten stimmten. Die Ausrutscher waren eine Einheitenumrechnung und zwei Videobeschreibungen. Wir haben die Höhe des Kilimandscharo zehnmal per Stimme abgefragt, auf beiden Karten und mit mehreren Speichergrenzen. Die Meter stimmten neun von zehn Mal, die Fuß waren in den meisten Läufen falsch. Gesprochene Antworten schwanken von Lauf zu Lauf, weil die Stimme mit eingebautem Zufall erzeugt wird und die Worte ihr folgen. Ein Sprachassistent, der Zahlen vorliest, braucht für Umrechnungen eine Prüfung oder ein Tool.
Die Videoantwort ist die andere Warnung. Das Modell zitierte das Kind mit „I want to look at the book“. Dieser Satz ist nicht geprüft. Whisper hörte „I don't want to put it in my bag“. Das Modell selbst, nur zum Transkribieren des Tons aufgefordert, hörte „I want, I want to put them in“. Das Kind ist schwer zu verstehen, also nimm zitierte Worte aus undeutlichem Audio als Vermutung.
Bei einem einminütigen Clip aus der eigenen Straßendemo von Liquid AI beschrieb es die Szene und las die Ladenschilder richtig. Es nannte echte Straßenaufnahmen aber auch „a driving video game“.
Welche GPU: etwa 5 GB Speicher, und eine echte 16-GB-Karte war so schnell wie 24 GB
Das Modell braucht etwa 5 GB frei für Stimme, Fotos und kurze Clips und etwa 6 GB für ein einminütiges Video. Die kleinste echte Karte, die wir genutzt haben, ist die RTX 2000 Ada mit 16 GB, eine Workstation-Karte mit 70 Watt. Sie lieferte dieselben Ergebnisse wie die A5000 mit 24 GB, ohne langsamer zu sein.
Um zu sehen, wie weit es nach unten geht, haben wir auf der A5000 Schritt für Schritt begrenzt, wie viel Speicher der Code des Modells nutzen durfte. Das ist eine Softwaregrenze auf einer größeren Karte, keine kleinere Karte, und der ganze Prozess braucht etwa 0,4 GB zusätzlich zur Grenze.
| Karte oder Speichergrenze | Stimme, Foto, Transkription, Sprachausgabe und ein 10-s-Video |
|---|---|
| RTX 2000 Ada 16 GB, echte Karte | alles bestanden, echte Karte |
| Modellspeicher auf 4,8 GB begrenzt (simuliert) | alles bestanden |
| Modellspeicher auf 4,7 GB begrenzt (simuliert) | beim 10-s-Video geht der Speicher aus |
Die Aufteilung beim Serving: Der schnelle Server ist bei Text viermal schneller und kann nicht sprechen
Mit einem noch nicht veröffentlichten Fix schreibt der schnelle Server, SGLang, Text viermal schneller, aber er kann nicht sprechen.
Auf dieses Problem stößt du zuerst. Die Doku von Liquid AI nennt einen einzeiligen SGLang-Befehl, aber das veröffentlichte SGLang (Version 0.5.23) unterstützt dieses Modell nicht, und auf unserer Karte stürzte es beim Start ab. Der Fix existiert als vorgeschlagene Änderung, #46858, die am Tag des Tests noch offen war. Der fertige SGLang-Server von InferenceKey nutzt die veröffentlichte Version, kann LFM3 also erst ausliefern, wenn dieser Fix erscheint. Status: wartet auf SGLang.
Wir haben diese Änderung von Hand gebaut, außerhalb der Plattform, um zu sehen, was sie bringt. Bei identischen Antworten brauchte ein Absatz etwa eine Sekunde statt vier (158 Wortteile pro Sekunde gegenüber 38 bis 40). Für einen Aufrufer nach dem anderen reicht der langsamere Weg; mehrere gleichzeitig haben wir nicht getestet. Für viel Text-Traffic wartest du besser auf das Release.
Die Lizenz: Kommerzielle Nutzung endet bei 10 Millionen Dollar Umsatz
Die Gewichte stehen unter der LFM Open License v1.0, keiner Standard-Open-Source-Lizenz. Kommerzielle Nutzung ist nur erlaubt, solange der Jahresumsatz deiner Organisation unter 10 Millionen US-Dollar bleibt. Darüber ist kommerzielle Nutzung nicht lizenziert. Qualifizierte gemeinnützige Organisationen sind für Forschung und nichtkommerzielle Nutzung ausgenommen.
Für ein Startup oder ein kleines Produktteam ist das offen genug, um damit zu liefern. Für ein großes Unternehmen heißt es, vor dem ersten Deployment mit Liquid AI über andere Bedingungen zu sprechen, nicht danach. Der Lizenztext ist kurz.
Auf InferenceKey: bereit in unter einer Minute, ein Custom Backend für jeden Modus
Ein Custom Backend auf einer GPU in unserer Cloud bediente Stimme, Fotos, Video und Befehle über eine Adresse, bereit in unter einer Minute. Ein Custom Backend ist eine kurze Python-Datei, die du zu InferenceKey hochlädst: Die Plattform installiert ihre Abhängigkeiten auf deiner GPU-Maschine und schickt ihr die Anfragen. Keine der eingebauten Engines von InferenceKey bringt dieses Modell zum Sprechen (der Echtzeit-Server von llama.cpp kann es, aber den haben wir nicht getestet). Unseres steuert deshalb den Code des Modells selbst und gibt Text und Audiodatei in einer Antwort zurück.
Auf der A5000 war das Modell 46 Sekunden nach unserer Anforderung bereit. Auf der frischen 16-GB-Maschine, die alles von Grund auf installieren musste, dauerte es 59,5 Sekunden. Der Download der 4,5 GB selbst dauerte 5 bis 6 Sekunden.
Die Plattform lief aus einer lokalen Kopie von InferenceKey, mit demselben Code wie der gehostete Dienst. Das SDK-Beispiel bindet das Modell an eine GPU-Maschine, die du registrierst, sodass das Modell auf Hardware läuft, die du kontrollierst. Die Anfragen laufen trotzdem über die InferenceKey-API, außer du hostest InferenceKey selbst auf deinen eigenen Servern.
Solltest du es nutzen? Ja, für einen Sprachassistenten auf deiner eigenen kleinen Karte, mit Zahlenprüfung
- Du willst einen Sprachassistenten, der auf deiner eigenen Hardware hört, sieht und spricht: ja, als Grundlage, mit einer Prüfung für Zahlen, die er vorliest. So wie getestet wartet der Aufrufer auf die ganze Antwort.
- Du brauchst schnellen Text für viel Traffic: noch nicht. Warte auf das SGLang-Release.
- Du hast eine Karte unter 16 GB: Die Speichergrenzen oben sagen, dass etwa 5 GB frei reichen.
- Dein Unternehmen macht 10 Millionen Dollar im Jahr oder mehr: Sprich mit Liquid AI, bevor du darauf aufbaust.
Um drei dieser Antworten von deiner eigenen GPU zu hören (die Sprachantwort, das Plakat und Text zu Sprache), führe das SDK-Beispiel für LFM3-Omni-2B aus. Es braucht ein Projekt, ein SDK-Token, einen API-Key und eine NVIDIA-GPU-Maschine, die du registrierst (eine aktuelle Karte), mit etwa 5 GB frei. Lade das Backend einmal mit python publish.py hoch und starte dann python main.py. Am Ende löscht es das Deployment.
Für Ingenieure
Credits
- Liquid AI: das Modell, das Backbone LFM3-1.7B, der Vision-Encoder, der kausale Audio-Encoder, der Audio-Tokenizer LiquidCodec, die Model Card, die Benchmarks, die Doku, die GGUF-Builds und die Beispielvideos (darunter der Kleinkind-Clip aus ihrem llama.cpp-Beispiel und die Straßendemo aus ihrem Launch-Video).
- Der Autor des SGLang-PR (tugot17, sgl-project/sglang#46858): die SGLang-Implementierung, die wir von Hand gebaut haben.
- Die Maintainer von Hugging Face Transformers: die Bibliothek, auf der das Custom Backend läuft (
trust_remote_code,AutoModelForMultimodalLM). - Die Maintainer von llama.cpp: GGUF- und Echtzeit-Server-Unterstützung (von uns nicht getestet).
- OpenAI Whisper large-v3 (über faster-whisper): das unabhängige Zurücklesen jeder WAV. LibriSpeech: der Transkriptions-Clip.
- Kyutai Pocket TTS (Stimme „alba“): hat unsere gesprochenen Testfragen erzeugt.
- AI Search: wo wir das Modell entdeckt haben (News-Video vom 2026-11-01, LFM3-Kapitel bei 44:17).
- Unser Teil: das Custom Backend, das Deployment über die Plattform auf zwei Karten, die Testeingaben, die Prüfung der Tonspur, die Speicherleiter, die SGLang-Versuche, das SDK-Beispiel und das Demovideo.
Modell und Dateien
LiquidAI/LFM3-Omni-2B, Revision21d75123f86c1f7ffb4bef1ea202710c4e7ebe67(erstellt 2026-10-21, zuletzt geändert 2026-11-03, nicht zugangsbeschränkt). 4.499.839.711 Bytes:model.safetensors4.333.941.640 B,audio_tokenizer/model.safetensors147.143.540 B,tokenizer.json17.908.634 B. Manche Kataloge nennen „5.4 GB“: Das ist eine VRAM-Schätzung, nicht der Checkpoint.- 2,17B Parameter. Eingaben: Text, Bilder und Video in nativer Auflösung (jeder 2x2-Patch-Block ist ein Token, bis zu 2.048 Tokens pro Bild), Video mit 2 fps und standardmäßig 4 bis 384 Frames, Audio mit 16 kHz. Ausgaben: Text, Sprache mit 24 kHz oder verschränkt. Kontext 32K Tokens (Eingabe plus Ausgabe). Textvokabular mit 128.000 Tokens.
- Sprach-Locales (19): Arabisch, Dänisch, Deutsch, Griechisch, britisches Englisch, amerikanisches Englisch, Finnisch, Französisch, Hebräisch, Italienisch, Japanisch, Koreanisch, Niederländisch, Polnisch, Portugiesisch, Spanisch, Schwedisch, Türkisch, Chinesisch. Textsprachen (16): Englisch, Arabisch, Chinesisch, Französisch, Deutsch, Italienisch, Japanisch, Koreanisch, Portugiesisch, Spanisch, Vietnamesisch, Thai, Indonesisch, Hindi, Russisch, Polnisch.
- Ohne Reasoning:
enable_thinking=Truewird nicht unterstützt, jede Antwort beginnt mit einem leeren Think-Block. - Benötigt
transformers>=5.20.2mittrust_remote_code. Video mit Ton brauchtload_audio_from_video=Trueunduse_audio_in_video=True, sonst nur Bilder. - Empfohlenes Sampling: greedy für Text; für Sprache
audio_temperature=0.4,audio_repetition_penalty=1.2(die Doku ergänztaudio_repetition_window=64). - GGUF-Repo
LiquidAI/LFM3-Omni-2B-GGUF(shad508b88f, erstellt 2026-10-27): F16/BF16 3,47 GB, Q8_0 1,85 GB, Q4_K_M 1,10 GB, Q4_0 1,05 GB; mmproj F16/BF16 0,95 GB, Q8_0 0,51 GB, Q4_K_M 0,29 GB, Q4_0 0,27 GB. Benötigt llama.cpp b11960 (v0.8.0) oder neuer; Echtzeit-Sprache mit Tool-Calls über den/v1/realtime-WebSocket vonllama serve, zum Beispielllama serve -hf LiquidAI/LFM3-Omni-2B-GGUF:Q4_K_M --reasoning off --temp 0 --port 8080; Sprachsynthese überllama-tts. Von uns nicht getestet. - Blog von Liquid AI: sechs LFM3-Modelle mit etwa 2B aus LFM3-1.7B-Base, 22T Tokens Pre-Training. Der kausale Audio-Encoder kann vorab verarbeiten, während der Nutzer spricht („as low as 50 ms“ bis zum ersten Token); LiquidCodec dekodiert mit etwa 87-facher Echtzeit auf einem CPU-Thread (Apple M4 Max), 12 Tokens pro 80 ms Sprache. Ihre Angaben, nicht von uns gemessen.
Angaben der Autoren (nicht reproduziert)
Alles von Liquid AI gemessen, aus der Model Card:
| Benchmark | LFM3-Omni-2B | Qwen2.5-Omni-3B | Qwen2.5-Omni-7B | Gemma 4 E2B | Gemma 4 E4B | Phi-4-mm |
|---|---|---|---|---|---|---|
| Daily-Omni | 70,09 | 58,81 | 61,32 | 50,63 | 54,14 | 48,87 |
| WorldSense | 47,10 | 44,99 | 45,37 | 38,11 | 43,51 | 42,37 |
| OmniBench gesamt | 46,32 | 47,11 | 49,65 | 16,81 | 20,67 | 38,97 |
| Englische ASR-WER (niedriger ist besser) | 6,36 | 6,30 | nicht angegeben | 8,26 | 7,82 | 5,14 |
| Englische TTS, UTMOSv2 | 3,80 | 3,42 | nicht angegeben | nicht angegeben | nicht angegeben | nicht angegeben |
| VoiceBench | 64,73 | 66,37 | nicht angegeben | 63,28 | 72,90 | 64,97 |
| Tool Calling (interne Auswertung) | 52,20 | 44,30 | nicht angegeben | 55,60 | 72,40 | nicht angegeben |
„Nicht angegeben“: Die Audio-Tabelle der Card hat keine Spalte für Qwen2.5-Omni-7B, nennt UTMOSv2 nur für LFM3-Omni-2B und Qwen2.5-Omni-3B und hat keinen Tool-Calling-Wert für Phi-4-mm. Beim Tool Calling schlägt LFM3-Omni-2B Qwen2.5-Omni-3B und liegt hinter beiden Gemma-4-Modellen. Die Card meldet außerdem Ergebnisse zu AV-SpeakerBench, OmniBench Speech, gesprochenem Visual QA, Vision, mehrsprachiger ASR und MMAR, die wir hier nicht übernommen haben.
Setup
- GPUs auf InferenceKey Cloud: RTX A5000 24 GB (24.564 MiB, 230 W, Compute Capability 8.6, Treiber 595.91.07, CUDA 13.2) für den Hauptlauf; RTX 2000 Ada Generation 16 GB (16.380 MiB, 70 W, Compute Capability 8.9) für die echte 16-GB-Stufe, auf einem frischen Worker. Die A5000 war die erste 24-GB-Karte, die verfügbar wurde; die RTX 2000 Ada war die kleinste verfügbare echte Karte.
- Anderer Weg auf der Card: GGUF-Builds für llama.cpp, auf CPUs und GPUs, mit einem Echtzeit-Sprachserver (Details unter Modell und Dateien). Nicht getestet.
- Backend: ein Custom Python Backend (
lfm3-omni-2b0.1.0, Tasktext2audio, Chat-Route) auf transformers 5.22.2, torch 2.15.0, torchvision 0.29.2, BF16. Warum custom: Sprache und verschränkte Ausgabe gibt es nur im Transformers-Code des Checkpoints; keine eingebaute Engine von InferenceKey liefert Sprache für dieses Modell (der Echtzeit-Server von llama.cpp ist hier nicht getestet), und das veröffentlichte SGLang liefert es überhaupt nicht aus. setup()installiert ffmpeg, falls es fehlt, lädt den Checkpoint in der festgelegten Revision herunter, lädtAutoModelForMultimodalLM.from_pretrained(dtype=bf16, trust_remote_code=True), den Processor und LiquidCodec und wärmt Text und Sprache vor.process()nimmt OpenAI-Messages an (text,input_audio,image_url/video_urlals Data-URLs) und gibt Text, eine base64-WAV mit 24 kHz, geparstetool_callsund Zeiten zurück (erstes Text-Token, erster Sprach-Frame über Streamer, GPU-Sekunden, VRAM-Spitze).- Ein lokaler InferenceKey-Manager (derselbe Code wie der gehostete Dienst). Die Produktion wurde nie angefasst.
- Greedy für Text; Sprache mit
audio_temperature0.4 undaudio_repetition_penalty1.2. Gesprochene Eingaben mit Pocket TTS von Kyutai erzeugt (Stimme „alba“), lokal ausgeführt; das Plakat ist ein ausgedachtes Bild. Die Videofragen wurden getippt, und jede Videoantwort war reiner Text (modetext).
Schritt für Schritt mit dem SDK-Beispiel
- Klone inferencekey-sdk und öffne
examples/lfm3-omni-2b-voice-vision-custom-backend-private-nvidia(Commitba49628ec5b24b68e8c404b1e54772df6b499f6b). cp .env.example .envund trageINFERENCEKEY_SDK_TOKEN,INFERENCEKEY_API_KEY,INFERENCEKEY_PROJECTundIK_WORKER_IDein (ein registrierter NVIDIA-Worker, bf16-fähig, Ampere oder neuer, etwa 5 GB freier GPU-Speicher, 6 GB für ein einminütiges Video, ein Treiber für CUDA 12.8 oder neuer, ffmpeg für Video). Fürpublish.pyaußerdemINFERENCEKEY_TENANT_IDundINFERENCEKEY_USER_TOKEN.- Installiere den Client und den lokalen SDK-Build:
python -m venv .venv && . .venv/bin/activate
pip install requests
pip install maturin && ( cd ../../bindings/python && maturin develop --release )
python publish.pyeinmal: Es packtbackend.pyund lädt es in deinen Tenant hoch (oder ladedist/*.tar.gzim Dashboard unter Custom backends hoch und schalte in den Endpoint settings „Chat“ ein).python main.py:ensure()deklariert den Workload (backend="lfm3-omni-2b",task_type="text2audio", feste Policy, eine Replica), gebunden an deinen Worker, wartet, bis er bereit ist, schickt drei Anfragen (gesprochene Frage zu verschränkter Sprache, Plakat plus gesprochene Frage, Text zu Sprache), schreibt die Antworten nach./outputsund ruftdelete()auf, außer beiIK_KEEP_ALIVE=1.
Anfrageoptionen in extra_body: mode (text, audio, interleaved), max_new_tokens (ein Sprach-Frame von 80 ms zählt als eins), temperature, audio_temperature, audio_repetition_penalty, use_audio_in_video (Standard true), fps, tools (OpenAI-Function-Schemas). LFM3_VRAM_LIMIT_GIB begrenzt den PyTorch-Speicher. Schicke "model": "default". Eingebettete Medien zählen gegen ein Anfragelimit von etwa 2 MiB JSON: Ein MP4 mit 480p und 10 s hat etwa 230 KB.
Zeiten
| Schritt | RTX A5000 | RTX 2000 Ada |
|---|---|---|
ensure() bis bereit | 46,0 s (warmer uv-Cache) | 59,5 s (frischer Worker, leerer uv-Cache) |
| venv-Build plus Setup | 20,0 s | |
| Download der Gewichte (parallel vorab geladen) | 5 s | 6 s |
| Laden | 3,6 s | |
| Aufwärmen (Text und Sprache) | 3,1 s | |
| Belegt nach dem Laden | 4.274 MiB |
Alle Messungen (über die Plattform)
| Fall | RTX A5000 | RTX 2000 Ada 16 GB | Ausgabe |
|---|---|---|---|
| Gesprochene Frage (3,3 s) zu verschränktem Text plus Sprache | 10,48 s Sprache in 7,418 s (1,41x), Round Trip 10,11 s; Testlauf 9,76 s in 6,938 s, erster Text 0,047 s, erster Sprach-Frame 0,275 s | 10,08 s in 6,563 s (1,54x), Round Trip 8,24 s; Testlauf 10,08 s in 6,148 s (1,64x), erster Frame 0,203 s | Kilimandscharo, 5.895 m richtig; Fuß falsch (19.004 / „19,34“ / 19.031) |
| Plakatbild plus gesprochene Frage, Text | 0,836 s, 1.135 Prompt-Tokens | 0,931 s | richtig |
| Dasselbe, verschränkte Sprache | 7,12 s Sprache in 5,41 s (1,32x), erster Frame 0,35 s | 6,32 s in 4,26 s (1,48x) | dieselben Fakten, gesprochen |
| ASR, LibriSpeech 1272-128104-0002 (12,5 s) | 1,16 s | 1,01 s | exakt, abgesehen von Groß- und Kleinschreibung und Zeichensetzung |
| 9,7-s-Video mit Tonspur, getippte Frage, System-Prompt „Answer questions about the video using what you see and hear.“ | 2,63 s | 2,47 s | „The child is speaking, saying, 'I want to look at the book'“ (Zitat nicht geprüft) |
| Dasselbe Video und dieselbe Frage, nur Bilder, kein System-Prompt | 5,38 s | 4,87 s | „there is no audible speech or music in the clip“ (falsch) |
Gesprochene Tool-Anfrage mit set_volume-Schema | 0,56 s | 0,45 s | set_volume({"volume": 30}) |
| TTS Englisch weiblich / Spanisch männlich | 4,64 s in 2,93 s (1,58x) / 3,68 s in 2,26 s (1,63x), erster Frame etwa 0,05 s | 4,8 s in 2,68 s (1,79x) / 4,16 s in 2,19 s (1,9x) | Whisper liest die Sätze zurück |
| Text, Absatz mit 146 Tokens | 37,6 tok/s | 40,5 tok/s | richtig |
| 60-s-Video, 8.472 Prompt-Tokens | 5,9 bis 6,4 s, Prozess 5.966 MiB | Prozess 5.824 MiB | Szene und Schilder richtig, echte Straße als „a driving video game“ bezeichnet |
Die beiden Videoläufe unterscheiden sich in zwei Einstellungen (use_audio_in_video und der System-Prompt), daher sind ihre Prompt-Größen und Zeiten kein sauberer Vergleich nur mit und ohne Audio; einen Lauf nur mit Bildern und demselben System-Prompt haben wir nicht gemacht. Die Zeiten bis zum ersten Sprach-Frame sind im Backend ab Start der Generierung gemessen. Das Backend gibt die ganze Antwort als eine base64-WAV zurück, der Client bekommt das Audio also erst am Ende des Round Trips.
GPU-Speicher: PyTorch-Spitze 4.285 bis 4.434 MiB pro Anfrage, Prozess 4.772 bis 4.832 MiB in nvidia-smi. Die Tonspur hat vier Abschnitte über -35 dB (silencedetect). Whisper large-v3 mit automatischer Spracherkennung hörte „Ola, ola...“; mit erzwungenem Englisch „I don't want to put it in my bag.“; die reine Audio-ASR von LFM3 „I want, I want to put them in.“
VRAM-Leiter
Die emulierten Stufen nutzen torch.cuda.set_per_process_memory_fraction auf der A5000. Fünf Fälle: ASR, Bild plus Stimme, TTS, Stimme zu Sprache, 10-s-Video. Die Grenze begrenzt nur den PyTorch-Speicher, nicht den ganzen Prozess: Der Prozesswert in nvidia-smi enthält etwa 400 MiB Speicher außerhalb von PyTorch (4.832 MiB Prozess gegenüber 4.434 MiB PyTorch-Spitze). Im Text oben sind 4,45 GiB gleich 4,8 GB und 4,35 GiB gleich 4,7 GB; 4.772 bis 4.832 MiB sind 5,0 bis 5,1 GB.
| GPU oder Grenze | Konfiguration | Spitzenspeicher (MiB, nvidia-smi-Prozess, sofern nicht anders angegeben) | Zeit pro Ausgabe | Ausgabe OK | Echt oder emuliert |
|---|---|---|---|---|---|
| RTX A5000 24 GB | BF16, Custom Transformers Backend, über die Plattform | 4.832 (4.434 PyTorch) | 7,4 s (Sprachantwort) | ja | echt |
| RTX 2000 Ada 16 GB | dasselbe, frischer Worker über die Plattform | 4.434 PyTorch-Spitze; 5.824 Prozess für das 60-s-Video | 6,6 s | ja, dieselben Antworten | echt |
| Grenze 8 GiB | 5 Fälle | 4.832 | 6,9 s | ja | emuliert |
| Grenze 6 GiB | 5 Fälle | 4.832 | 5,1 s | ja | emuliert |
| Grenze 5 GiB | 5 Fälle | 4.832 | 6,8 s | ja | emuliert |
| Grenze 4,6 GiB | 5 Fälle | 4.832 | 7,2 s | ja | emuliert |
| Grenze 4,45 GiB | 5 Fälle | 4.772 | 6,8 s | ja | emuliert |
| Grenze 4,35 GiB | 5 Fälle | 4.718 | nein: 10-s-Video OutOfMemoryError ... Tried to allocate 20.00 MiB ... 4.35 GiB allowed | emuliert | |
| Grenze 5,6 GiB, 60-s-Video | 8.472 Prompt-Tokens | 5.966 (5.242 PyTorch) | 5,9 s | ja | emuliert |
| Grenze 5,2 GiB, 60-s-Video | 8.472 Prompt-Tokens | nein: OutOfMemoryError ... Tried to allocate 142.00 MiB ... 5.20 GiB allowed (auch OOM bei 4,6) | emuliert |
Das Tempo blieb unter den Grenzen gleich. Die Antworten von Stimme zu Sprache waren über die Grenzen hinweg nicht identisch: Der Kilimandscharo kam als 5.895 m mit 19.031, 19.341, „19,34“, 19.285 und 19.000 Fuß zurück und einmal (Grenze 6 GiB) als „five thousand seven hundred and three meters“. Nicht ausprobiert: echte Karten mit 6, 8 oder 12 GB (für diesen Test war in unserer Cloud keine unter 16 GB verfügbar), die GGUF-Builds und der Echtzeit-Server von llama.cpp, quantisierte Gewichte, Parallelität, CPU.
SGLang
- Eingebautes
sglang-Backend über die Plattform (PyPI sglang 0.5.23,sglang serve ... --mem-fraction-static 0.35): zuerst vom VRAM-Preflight des Workers abgelehnt, „GPU out of memory before sglang spawn: only 19328 MiB free“ (er will 80 % der Karte frei, unabhängig von--mem-fraction-static). MitINFERENCEKEY_VRAM_MIN_FREE_MB=9000: „Lfm3OmniForConditionalGeneration has no SGLang implementation, falling back to Transformers implementation“, dann „Exception: Capture cuda graph failed: The size of tensor a (48) must match the size of tensor b (16) at non-singleton dimension 2“. Nicht ausgeliefert. - PR #46858 von Hand auf der A5000 gebaut, außerhalb der Plattform (
sglang 0.5.6.post3.dev14179+g47737555a,SGLANG_BUILD_RUST_EXTS=none,--mem-fraction-static 0.3): bereit nach 185 s kalt (CUDA-Graphen) / 47 s warm, Prozess 7.036 bis 7.338 MiB. Text 157 bis 159 tok/s bei einem Absatz mit 137 Tokens (4,2x Transformers). Bild plus gesprochene Frage 0,41 bis 0,43 s. Video mit Tonspur 0,95 s warm, aber nur mituse_audio_in_video: trueauf oberster Ebene (mm_processor_kwargswird ignoriert und liefert die Antwort nur aus Bildern). Alle greedy-Antworten identisch mit dem Transformers-Backend. Nur Textausgabe.input_audiomitformat: flacgab 400 zurück. - Der Befehl aus der Doku von Liquid AI:
python -m sglang.launch_server --model-path LiquidAI/LFM3-Omni-2B(Textausgabe). Er braucht diesen PR, bis ein Release ihn enthält. PR-Status und PyPI-Version geprüft am 2026-11-07 um 06:40 UTC.
Offene Probleme
- SGLang-Unterstützung nicht veröffentlicht (siehe oben). Unser eingebautes Backend installiert sglang von PyPI und kann LFM3 daher noch nicht ausliefern. Offen, upstream.
- Der VRAM-Preflight des Workers blockiert eine zweite Engine auf einer Karte, auf der schon die erste läuft (Regel 80 % frei). Workaround:
INFERENCEKEY_VRAM_MIN_FREE_MB. Offen auf unserer Seite. - Falsches Ready:
wait_until_readyfür den sglang-Workload gab nach 23 s „ready [server_up]“ aus, während uv noch sglang installierte; ein anderer Workload auf demselben Worker war der, der lief. Offen auf unserer Seite. - Modellname am Endpoint:
"model": "lfm3"gibt 400model_not_availablezurück; schicke"model": "default". Im Beispiel dokumentiert. - Kein Streaming der Sprache zum Client in diesem Backend: Der Client wartet auf die ganze WAV. Nicht gebaut.
- Text-Dekodierung mit Transformers ist langsam: 38 bis 40 tok/s, auf der 70-W-Karte genauso wie auf der A5000. Transformers loggt außerdem, dass
causal_conv1d_fnauf seine PyTorch-Referenzimplementierung zurückfällt, weilcausal_conv1dnicht installiert ist („This is correct but much slower“); ob das das Tempo erklärt, ist nicht geprüft. - Ausrutscher des Modells: Kilimandscharo in zehn Sprachläufen: Meter neunmal richtig (einmal 5.703), Fuß einmal richtig (19.341) und in den anderen acht Läufen mit Fußangabe daneben; verschränkte Antworten schwanken mit dem Audio-Sampling; zitierte Worte aus undeutlichem Audio nicht geprüft; echte Straßenaufnahmen als „a driving video game“ bezeichnet. Whisper las eine Kilimandscharo-WAV als „19,034 feet“, während im Text „19,34“ stand, Audio und Text können bei dieser Zahl also leicht abweichen.
- Zwei Maschinen in unserer Cloud (eine A5000 und eine A4000) öffneten innerhalb von 180 s nie direktes SSH, und der Manager verwarf sie vor dem Lauf.
Demovideo
Das kommentierte Erklärvideo mit 172 Sekunden: die eigenen Beispiele von Liquid AI mit Quellenangabe, ein Architektur-Einschub und ein Benchmark-Einschub aus der Model Card, dann unser Deployment auf der A5000, die eigene gesprochene Antwort des Modells zum Plakat, ohne Kommentar abgespielt, der gesprochene Tool-Call, der zentrale Vergleich und die Speicherleiter. Untertitel verfügbar.
Weitere Hörbeispiele
- Text zu Sprache, spanische Männerstimme, 3,7 s: „El museo abre a las 10 de la mañana y cierra a las 6 de la tarde.“
- Gesprochene Antwort zum Kilimandscharo, verschränkt, 9,8 s (Meter richtig, Fuß falsch)
Quellen
- LiquidAI/LFM3-Omni-2B (Model Card, Configs, Modellcode).
- LFM Open License v1.0.
- LiquidAI/LFM3-Omni-2B-GGUF.
- Introducing LFM3: Every Modality for Specialized Intelligence (Blog von Liquid AI, 27. Okt. 2026).
- Doku von Liquid AI, SGLang-Deployment.
- sgl-project/sglang#46858.
- News-Video von AI Search, 2026-11-01 (wo wir es entdeckt haben).
- SDK-Beispiel, Commit
ba49628ec5b24b68e8c404b1e54772df6b499f6b. - Frühere Tests einzelner Stufen auf dieser Seite: Ming TTS, Nemotron Transcribe, Underdog Bark.