LFM3-Omni-2B : un seul modèle de 4,5 GB écoute, regarde et répond à voix haute sur 5 GB de GPU
Le modèle omni 2B de Liquid AI a répondu à voix haute à des questions orales, lu photos et vidéos sur environ 5 GB de GPU. Une carte de 16 GB a tenu le rythme.
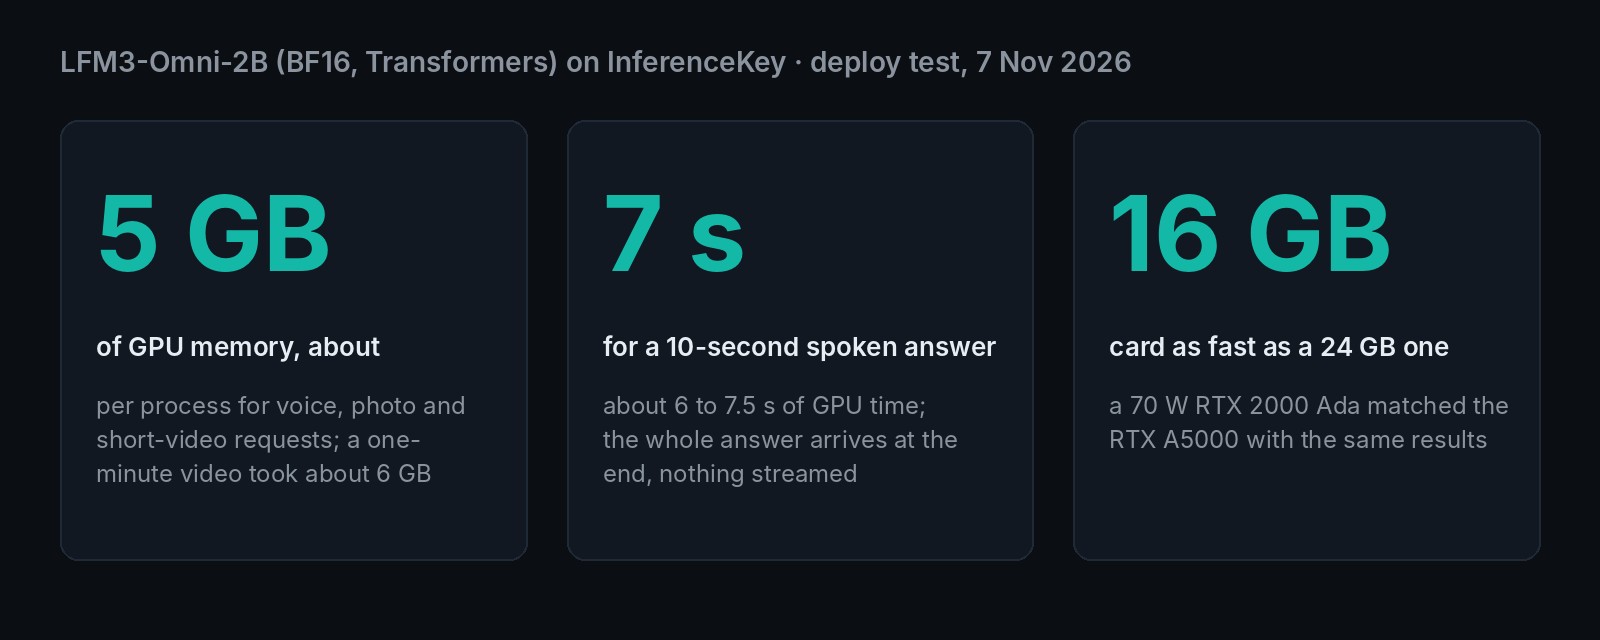
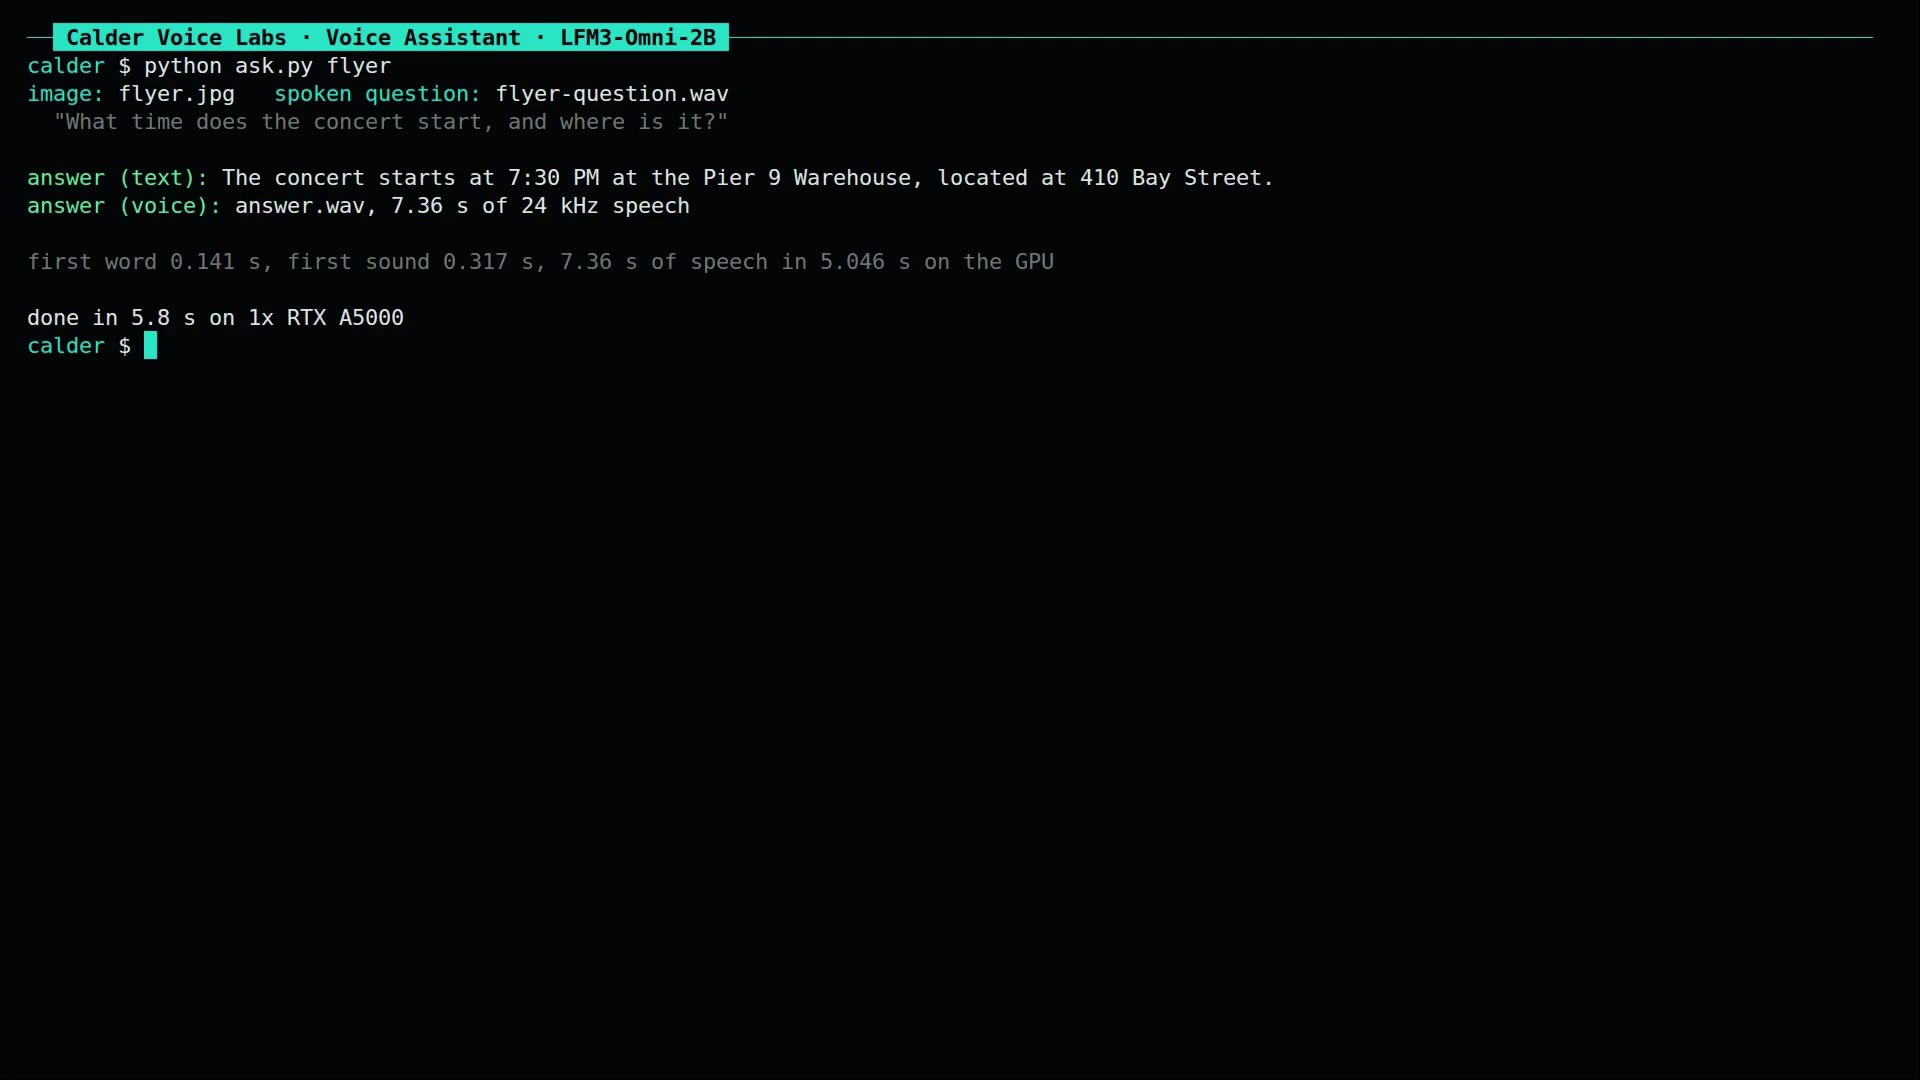
Nous avons montré à LFM3-Omni-2B l'affiche d'un concert, demandé à voix haute quand et où avait lieu le spectacle, et le GPU tenait la réponse écrite en moins d'une seconde : 7:30 PM, Pier 9 Warehouse. Un assistant vocal a d'habitude besoin de quatre modèles pour ça : un pour entendre, un pour regarder, un pour réfléchir et un pour parler. Ce modèle ouvert de Liquid AI est un seul jeu de poids de 4,5 GB qui fait les quatre. Nous l'avons fait tourner sur une RTX A5000 de notre cloud à travers InferenceKey, et il a aussi répondu avec sa propre voix, sur environ 5 GB de mémoire GPU.
Si vous faites tourner vos propres GPU, cela veut dire que chaque étage d'un assistant vocal tient sur une petite carte. Il y a deux pièges. Le serveur open source rapide pour ce modèle, SGLang, n'écrit que du texte, donc pour la voix nous avons utilisé le code du modèle lui-même, environ quatre fois plus lent en texte dans notre test. La licence arrête l'usage commercial à 10 millions de dollars de chiffre d'affaires annuel.
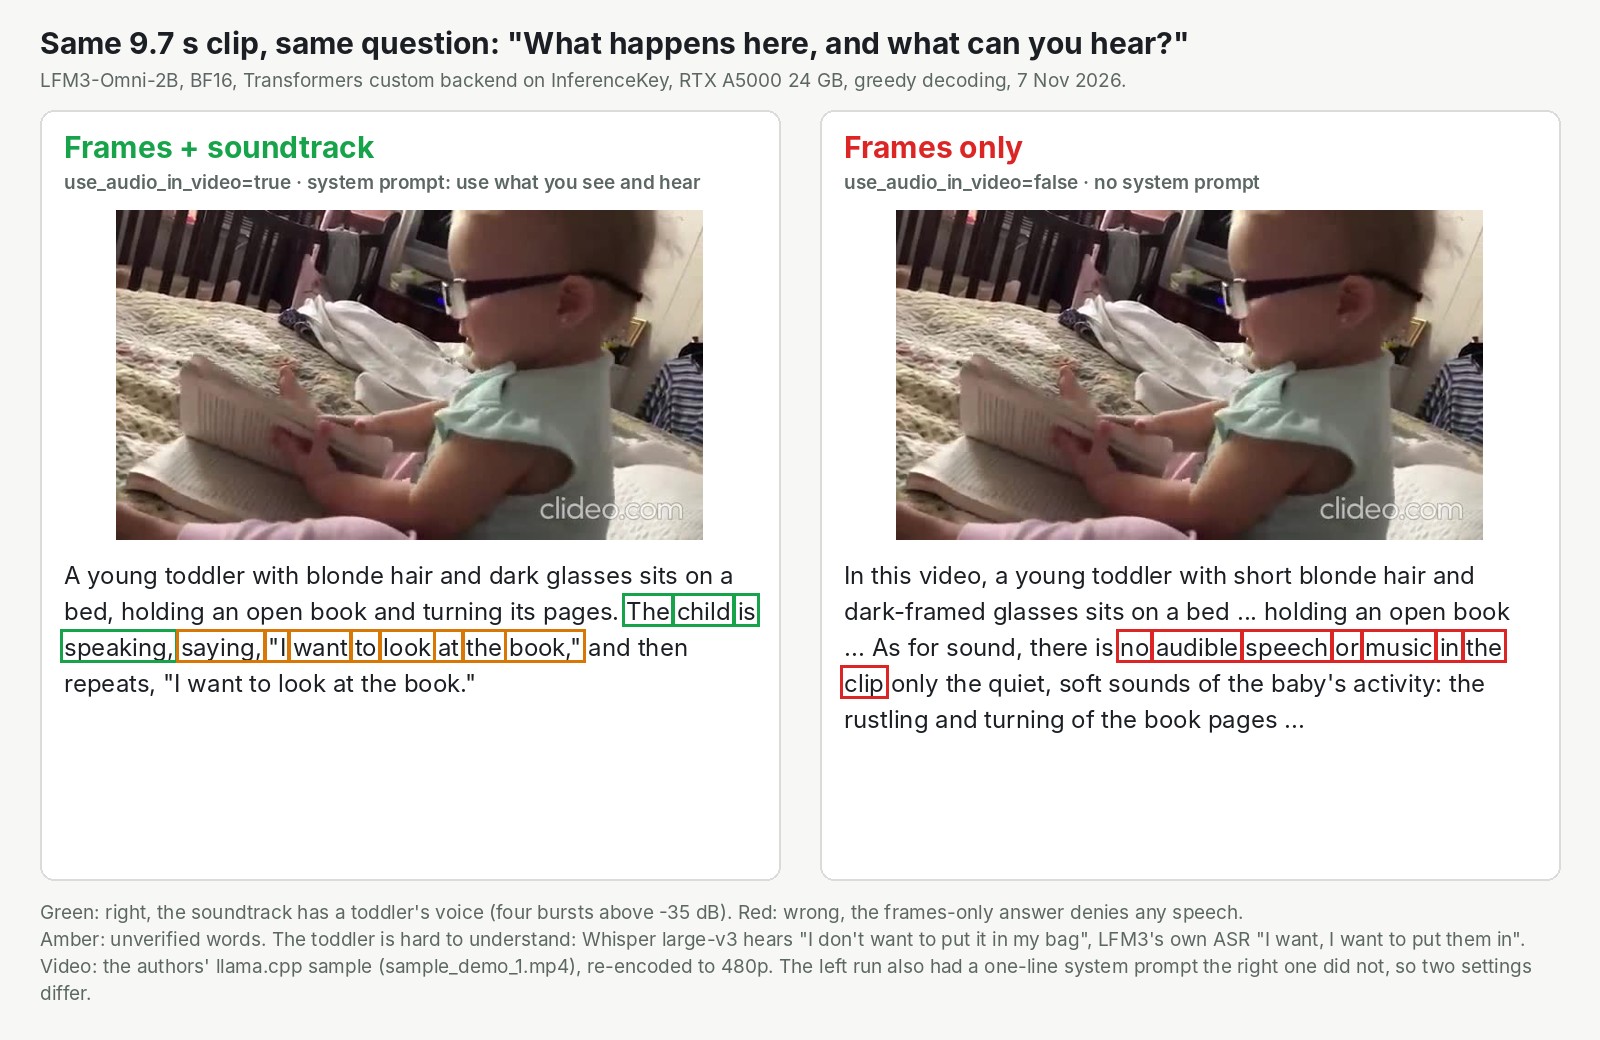
Même extrait, même question tapée. Avec la bande son, le modèle entend un enfant parler. Avec les images seules, il dit que l'extrait est silencieux. L'exécution avec le son portait aussi une consigne d'une ligne pour utiliser ce qu'il voit et entend, donc deux réglages ont changé, pas un. Reste que seule l'exécution qui recevait le son pouvait savoir qu'il était là.
Un seul petit modèle là où un assistant vocal en enchaîne d'habitude quatre
La page du modèle de Liquid AI dit qu'il "replaces a separate ASR model, vision-language model, LLM and TTS model". En clair : reconnaissance vocale, modèle de vision, modèle de langage et synthèse vocale, dans un seul réseau. Notre test cherchait à savoir si cela tient sur une seule petite carte.
Il prend du texte, des images, de la vidéo avec sa bande son et de la parole enregistrée. Il répond en texte, en voix, ou les deux à la fois. Dans ce dernier mode, il écrit une phrase et la prononce dans la même passe, donc un écran et un haut-parleur reçoivent la même réponse. D'après la liste de Liquid AI, il parle 19 combinaisons de langue et d'accent, de l'arabe au chinois, avec des voix féminines et masculines ; nous avons essayé l'anglais et l'espagnol. Il peut garder environ 32 000 fragments de mots en vue : une longue transcription écrite, mais seulement quelques minutes de vidéo, puisque notre extrait d'une minute en a pris à lui seul environ 8 500. Il répond tout de suite, sans étape de raisonnement cachée avant.
Liquid AI l'a construit sur LFM3-1.7B, son nouveau petit modèle de langage. L'équipe a ajouté un lecteur d'images, un lecteur de son qui démarre pendant que vous parlez encore, et une partie qui transforme la sortie en audio. L'annonce de LFM3 de Liquid AI est datée du 27 octobre. C'est l'un des six petits modèles de la famille. Nous l'avons repéré dans la vidéo d'actualités d'AI Search, dont le narrateur le résumait comme un minuscule modèle unique qui peut "see, hear, understand, and even talk back to you".
Les auteurs le comparent à d'autres petits modèles ouverts qui prennent aussi du son et de la vidéo. Voici leurs chiffres. Nous ne les avons pas reproduits.
| Test (chiffres des auteurs) | LFM3-Omni-2B | Qwen2.5-Omni-3B | Qwen2.5-Omni-7B |
|---|---|---|---|
| Daily-Omni, questions sur des vidéos du quotidien avec son | 70,09 | 58,81 | 61,32 |
| OmniBench, raisonnement mixte image et audio | 46,32 | 47,11 | 49,65 |
| Taux d'erreur de transcription en anglais (plus bas, c'est mieux) | 6,36 | 6,30 | non indiqué |
Il gagne la première ligne avec une large marge et perd la deuxième face aux deux modèles Qwen. En transcription, il est au niveau du plus petit Qwen. Les auteurs publient aussi les défaites, ce qui rend le tableau plus facile à croire. L'ensemble complet, avec les petits modèles Gemma 4 de Google, est en annexe.
Notre test : deux petites cartes et une poignée d'enregistrements courts
Nous avons fait tourner le modèle complet, non compressé, sur deux GPU de notre cloud à travers InferenceKey : une RTX A5000 de 24 GB pour l'exécution principale, et une RTX 2000 Ada de 16 GB sur une machine neuve. Les deux ont utilisé le même code.
Les cas étaient petits et concrets. Une question orale sur une montagne, avec une réponse à voix haute. Une affiche de concert inventée plus une question orale à son sujet. Un extrait d'un jeu de données public de livres audio à transcrire. Une demande orale pour baisser le volume, qui devait revenir sous forme de commande qu'une application peut exécuter. Deux phrases à lire à voix haute, en anglais et en espagnol. Et un extrait de 10 secondes tiré des propres exemples de Liquid AI, avec et sans son.
Les limites, une fois pour toutes. Une requête à la fois. Nos propres entrées courtes, pas les benchmarks des auteurs. Aucun humain n'a jugé la voix : un reconnaisseur vocal séparé, Whisper, a relu l'audio. Nous n'avons pas testé les versions compressées, le serveur vocal temps réel que Liquid AI recommande, ni aucune vraie carte sous 16 GB. Nous n'avons pas non plus fait tourner une chaîne de quatre petits modèles séparés sur la même carte, donc rien ici ne montre que la voie à un seul modèle est plus rapide, plus petite ou meilleure que ce pipeline.
Une réponse orale de 10 secondes : produite en environ 7 secondes, livrée en 8 à 10
Une réponse orale de 10 secondes était prête sur le GPU en environ 6 à 7,5 secondes. Elle arrivait à l'appelant au bout de 8 à 10 secondes, parce que notre configuration envoie l'audio en un seul fichier à la fin. Chaque réponse orale a pris moins de temps à produire qu'à écouter : une phrase de 4 secondes a pris 2 à 3 secondes.
| Ce que nous avons demandé | Ce qui est revenu | Temps GPU (A5000 / carte de 16 GB) |
|---|---|---|
| Une question orale sur la plus haute montagne d'Afrique, réponse à voix haute | Kilimandjaro, 5 895 mètres, environ 10 s de parole | 7,4 s / 6,6 s |
| Affiche de concert plus une question orale sur quand et où | "The concert starts at 7:30 PM, and it is located at Pier 9 Warehouse, 410 Bay Street." | 0,84 s / 0,93 s |
| Extrait de livre audio de 12,5 s, à transcrire | Exact, à part les majuscules et les virgules | 1,16 s / 1,01 s |
| Une demande orale pour mettre le volume à 30, avec un outil de volume | set_volume({"volume": 30}) | 0,56 s / 0,45 s |
| Lire une phrase en espagnol à voix haute | Whisper a entendu "El museo abre a las 10 de la mañana y cierra a las 6 de la tarde." | 2,3 s / 2,2 s |
Voici la voix du modèle lui-même qui répond à la question sur l'affiche :
La réponse orale du modèle à la question sur l'affiche, 7,4 s, générée sur l'A5000
Dans le serveur, le premier morceau de parole était prêt au bout de 0,2 à 0,5 seconde, donc le streaming pourrait réduire l'attente, mais nous n'avons ni construit ni testé le streaming.
Là où il dérape : un chiffre en pieds, et des mots dans le babillage d'un tout-petit
Les faits simples étaient justes. Les dérapages ont été une conversion d'unités et deux descriptions de vidéo. Nous avons demandé la hauteur du Kilimandjaro à voix haute dix fois, sur les deux cartes et avec plusieurs limites de mémoire. Les mètres étaient justes neuf fois sur dix, et les pieds étaient faux dans la plupart des exécutions. Les réponses orales varient d'une exécution à l'autre, parce que la voix est générée avec une part de hasard intégrée et que les mots la suivent. Un assistant vocal qui lit des chiffres à voix haute a besoin d'une vérification, ou d'un outil, pour les conversions.
La réponse sur la vidéo est l'autre mise en garde. Le modèle a cité l'enfant disant "I want to look at the book". Cette phrase n'est pas vérifiée. Whisper a entendu "I don't want to put it in my bag". Le modèle lui-même, quand on lui demandait seulement de transcrire le son, a entendu "I want, I want to put them in". L'enfant est difficile à comprendre, donc prenez les mots cités à partir d'un audio peu clair pour une supposition.
Sur un extrait d'une minute de la propre démo de rue de Liquid AI, il a décrit la scène et lu correctement les enseignes des boutiques. Il a aussi qualifié de vraies images de rue de "a driving video game".
Quel GPU : environ 5 GB de mémoire, et une vraie carte de 16 GB aussi rapide que 24 GB
Le modèle a besoin d'environ 5 GB libres pour la voix, les photos et les extraits courts, et d'environ 6 GB pour une vidéo d'une minute. La plus petite vraie carte que nous avons utilisée est la RTX 2000 Ada de 16 GB, une carte de station de travail de 70 watts. Elle a donné les mêmes résultats que l'A5000 de 24 GB, sans ralentissement.
Pour voir jusqu'où il descend, nous avons limité pas à pas la mémoire que le code du modèle pouvait utiliser sur l'A5000. C'est une limite logicielle sur une carte plus grande, pas une carte plus petite, et le processus entier a besoin d'environ 0,4 GB en plus de la limite.
| Carte ou limite de mémoire | Voix, photo, transcription, synthèse vocale et une vidéo de 10 s |
|---|---|
| RTX 2000 Ada 16 GB, vraie carte | tout passe, vraie carte |
| Mémoire du modèle limitée à 4,8 GB (simulé) | tout passe |
| Mémoire du modèle limitée à 4,7 GB (simulé) | la vidéo de 10 s manque de mémoire |
Le partage du service : le serveur rapide est quatre fois plus vif en texte, et ne sait pas parler
Avec un correctif non publié, le serveur rapide, SGLang, écrit le texte quatre fois plus vite, mais il ne sait pas parler.
C'est le problème que vous rencontrerez en premier. La documentation de Liquid AI donne une commande SGLang d'une ligne, mais la version publiée de SGLang (0.5.23) ne prend pas ce modèle en charge, et sur notre carte elle a planté au démarrage. Le correctif existe sous forme de modification proposée, #46858, toujours ouverte quand nous avons vérifié le jour du test. Le serveur SGLang prêt à l'emploi d'InferenceKey utilise la version publiée, il ne peut donc pas servir LFM3 tant que ce correctif n'est pas sorti. État : en attente de SGLang.
Nous avons compilé cette modification à la main, hors de la plateforme, pour voir ce qu'elle vaut. Avec des réponses identiques, un paragraphe a pris environ une seconde au lieu de quatre (158 fragments de mots par seconde contre 38 à 40). Pour un seul appelant à la fois, la voie plus lente suffit ; nous n'en avons pas testé plusieurs à la fois. Pour un gros trafic de texte, attendez la version publiée.
La licence : l'usage commercial s'arrête à 10 millions de dollars de chiffre d'affaires
Les poids sont distribués sous la LFM Open License v1.0, pas sous une licence open source standard. L'usage commercial n'est autorisé que tant que le chiffre d'affaires annuel de votre organisation reste sous 10 millions de dollars américains. Au-delà, l'usage commercial n'est pas couvert par la licence. Les organisations à but non lucratif qualifiées sont exemptées pour la recherche et l'usage non commercial.
Pour une startup ou une petite équipe produit, c'est assez ouvert pour livrer. Pour une grande entreprise, cela veut dire discuter d'autres conditions avec Liquid AI avant le premier déploiement, pas après. Le texte de la licence est court.
Sur InferenceKey : prêt en moins d'une minute, un seul backend personnalisé pour tous les modes
Un seul backend personnalisé sur un seul GPU de notre cloud a servi la voix, les photos, la vidéo et les commandes depuis une seule adresse, prêt en moins d'une minute. Un backend personnalisé est un court fichier Python que vous téléversez sur InferenceKey : la plateforme installe ses dépendances sur votre machine GPU et lui envoie les requêtes. Aucun des moteurs intégrés d'InferenceKey ne sait faire parler ce modèle (le serveur temps réel de llama.cpp le peut, mais nous ne l'avons pas testé), donc le nôtre pilote le code du modèle lui-même et renvoie le texte et le fichier audio dans une seule réponse.
Sur l'A5000, le modèle était prêt 46 secondes après que nous l'avons demandé. Sur la machine neuve de 16 GB, qui devait tout installer depuis zéro, il a fallu 59,5 secondes. Le téléchargement des 4,5 GB lui-même a pris 5 à 6 secondes.
La plateforme tournait depuis une copie locale d'InferenceKey, même code que le service hébergé. L'exemple du SDK épingle le modèle à une machine GPU que vous enregistrez, donc le modèle tourne sur du matériel que vous contrôlez. Les requêtes passent quand même par l'API d'InferenceKey, sauf si vous hébergez InferenceKey lui-même sur vos propres serveurs.
Faut-il l'utiliser ? Oui pour construire un assistant vocal sur votre propre petite carte, avec une vérification des chiffres
- Vous voulez un assistant vocal qui entend, voit et parle sur votre propre matériel : oui, comme base de travail, avec une vérification des chiffres qu'il lit à voix haute. Tel que testé, l'appelant attend la réponse entière.
- Vous avez besoin de texte rapide pour un gros trafic : pas encore. Attendez la version publiée de SGLang.
- Vous avez une carte de moins de 16 GB : les limites de mémoire ci-dessus disent qu'environ 5 GB libres suffisent.
- Votre entreprise fait 10 millions de dollars par an ou plus : parlez à Liquid AI avant de construire dessus.
Pour entendre trois de ces mêmes réponses depuis votre propre GPU (la réponse orale, l'affiche et la synthèse vocale), lancez l'exemple du SDK pour LFM3-Omni-2B. Il faut un projet, un token SDK, une clé d'API et une machine GPU NVIDIA que vous enregistrez (une carte récente) avec environ 5 GB libres. Téléversez le backend une fois avec python publish.py, puis lancez python main.py. Il supprime le déploiement à la fin.
Pour les ingénieurs
Crédits
- Liquid AI : le modèle, la base LFM3-1.7B, l'encodeur de vision, l'encodeur audio causal, le tokenizer audio LiquidCodec, la page du modèle, les benchmarks, la documentation, les versions GGUF et les vidéos d'exemple (dont l'extrait du tout-petit de leur exemple llama.cpp et la démo de rue de leur vidéo de lancement).
- L'auteur de la PR SGLang (tugot17, sgl-project/sglang#46858) : l'implémentation SGLang que nous avons compilée à la main.
- Les mainteneurs de Hugging Face Transformers : la bibliothèque sur laquelle tourne le backend personnalisé (
trust_remote_code,AutoModelForMultimodalLM). - Les mainteneurs de llama.cpp : le support de GGUF et du serveur temps réel (non testé par nous).
- OpenAI Whisper large-v3 (via faster-whisper) : la relecture indépendante de chaque WAV. LibriSpeech : l'extrait de transcription.
- Kyutai Pocket TTS (voix "alba") : a généré nos questions orales de test.
- AI Search : là où nous avons repéré le modèle (vidéo d'actualités du 2026-11-01, chapitre LFM3 à 44:17).
- Notre part : le backend personnalisé, le déploiement à travers la plateforme sur deux cartes, les entrées de test, la vérification de la bande son, l'échelle de mémoire, les essais SGLang, l'exemple du SDK et la vidéo de démo.
Modèle et fichiers
LiquidAI/LFM3-Omni-2B, révision21d75123f86c1f7ffb4bef1ea202710c4e7ebe67(créé le 2026-10-21, dernière modification le 2026-11-03, accès libre). 4 499 839 711 octets :model.safetensors4 333 941 640 B,audio_tokenizer/model.safetensors147 143 540 B,tokenizer.json17 908 634 B. Certains catalogues indiquent "5.4 GB" : c'est une estimation de VRAM, pas le checkpoint.- 2,17B paramètres. Entrées : texte, images et vidéo en résolution native (chaque bloc de patchs 2x2 fait un token, jusqu'à 2 048 tokens par image), vidéo à 2 fps avec 4 à 384 images par défaut, audio à 16 kHz. Sorties : texte, parole à 24 kHz, ou entrelacées. Contexte de 32K tokens (entrée plus sortie). Vocabulaire texte de 128 000 tokens.
- Variantes de parole (19) : arabe, danois, allemand, grec, anglais britannique, anglais américain, finnois, français, hébreu, italien, japonais, coréen, néerlandais, polonais, portugais, espagnol, suédois, turc, chinois. Langues du texte (16) : anglais, arabe, chinois, français, allemand, italien, japonais, coréen, portugais, espagnol, vietnamien, thaï, indonésien, hindi, russe, polonais.
- Sans raisonnement :
enable_thinking=Truen'est pas pris en charge, chaque réponse s'ouvre sur un bloc de réflexion vide. - Nécessite
transformers>=5.20.2avectrust_remote_code. La vidéo avec son a besoin deload_audio_from_video=Trueetuse_audio_in_video=True, sinon images seules. - Échantillonnage recommandé : greedy pour le texte ; pour la parole
audio_temperature=0.4,audio_repetition_penalty=1.2(la documentation ajouteaudio_repetition_window=64). - Dépôt GGUF
LiquidAI/LFM3-Omni-2B-GGUF(shad508b88f, créé le 2026-10-27) : F16/BF16 3,47 GB, Q8_0 1,85 GB, Q4_K_M 1,10 GB, Q4_0 1,05 GB ; mmproj F16/BF16 0,95 GB, Q8_0 0,51 GB, Q4_K_M 0,29 GB, Q4_0 0,27 GB. Nécessite llama.cpp b11960 (v0.8.0) ou plus récent ; voix temps réel avec appels d'outils sur le WebSocket/v1/realtimedellama serve, par exemplellama serve -hf LiquidAI/LFM3-Omni-2B-GGUF:Q4_K_M --reasoning off --temp 0 --port 8080; synthèse vocale viallama-tts. Non testé par nous. - Blog de Liquid AI : six modèles LFM3 d'environ 2B issus de LFM3-1.7B-Base, 22T tokens de pré-entraînement. L'encodeur audio causal peut faire le prefill pendant que l'utilisateur parle ("as low as 50 ms" jusqu'au premier token) ; LiquidCodec décode à environ 87x le temps réel sur un seul thread CPU (Apple M4 Max), 12 tokens par 80 ms de parole. Ce sont leurs affirmations, non mesurées par nous.
Affirmations des auteurs (non reproduites)
Tout est mesuré par Liquid AI, d'après la page du modèle :
| Benchmark | LFM3-Omni-2B | Qwen2.5-Omni-3B | Qwen2.5-Omni-7B | Gemma 4 E2B | Gemma 4 E4B | Phi-4-mm |
|---|---|---|---|---|---|---|
| Daily-Omni | 70,09 | 58,81 | 61,32 | 50,63 | 54,14 | 48,87 |
| WorldSense | 47,10 | 44,99 | 45,37 | 38,11 | 43,51 | 42,37 |
| OmniBench global | 46,32 | 47,11 | 49,65 | 16,81 | 20,67 | 38,97 |
| WER ASR en anglais (plus bas, c'est mieux) | 6,36 | 6,30 | non indiqué | 8,26 | 7,82 | 5,14 |
| UTMOSv2 TTS en anglais | 3,80 | 3,42 | non indiqué | non indiqué | non indiqué | non indiqué |
| VoiceBench | 64,73 | 66,37 | non indiqué | 63,28 | 72,90 | 64,97 |
| Appels d'outils (évaluation interne) | 52,20 | 44,30 | non indiqué | 55,60 | 72,40 | non indiqué |
"Non indiqué" : le tableau audio de la page n'a pas de colonne Qwen2.5-Omni-7B, ne donne UTMOSv2 que pour LFM3-Omni-2B et Qwen2.5-Omni-3B, et n'a pas de score d'appels d'outils pour Phi-4-mm. En appels d'outils, LFM3-Omni-2B bat Qwen2.5-Omni-3B et reste derrière les deux modèles Gemma 4. La page rapporte aussi des résultats AV-SpeakerBench, OmniBench parole, QA visuelle orale, vision, ASR multilingue et MMAR, non recopiés ici.
Installation
- GPU sur InferenceKey Cloud : RTX A5000 24 GB (24 564 MiB, 230 W, compute capability 8.6, driver 595.91.07, CUDA 13.2) pour l'exécution principale ; RTX 2000 Ada Generation 16 GB (16 380 MiB, 70 W, compute capability 8.9) pour le vrai échelon de 16 GB, sur un worker neuf. L'A5000 était la première carte de 24 GB disponible ; la RTX 2000 Ada était la plus petite vraie carte disponible.
- Autre voie indiquée sur la page : les versions GGUF pour llama.cpp, sur CPU et GPU, avec un serveur vocal temps réel (détails dans Modèle et fichiers). Non testé.
- Backend : un backend Python personnalisé (
lfm3-omni-2b0.1.0, tâchetext2audio, route chat) sur transformers 5.22.2, torch 2.15.0, torchvision 0.29.2, BF16. Pourquoi personnalisé : la sortie vocale et entrelacée n'existe que dans le code Transformers du checkpoint ; aucun moteur intégré d'InferenceKey ne sert la parole pour ce modèle (le serveur temps réel de llama.cpp n'est pas testé ici), et la version publiée de SGLang ne le sert pas du tout. setup()installe ffmpeg s'il manque, télécharge le checkpoint à la révision épinglée, chargeAutoModelForMultimodalLM.from_pretrained(dtype=bf16, trust_remote_code=True), le processor et LiquidCodec, et fait un warm-up du texte et de la parole.process()prend des messages OpenAI (text,input_audio,image_url/video_urlen data URLs) et renvoie le texte, un WAV 24 kHz en base64, lestool_callsanalysés et les temps (premier token de texte, première trame de parole via les streamers, secondes GPU, pic de VRAM).- Un manager InferenceKey local (même code que le service hébergé). La production n'a jamais été touchée.
- Texte en greedy ; parole avec
audio_temperature0.4 etaudio_repetition_penalty1.2. Entrées orales produites avec Pocket TTS de Kyutai (voix "alba"), exécuté en local ; l'affiche est une image inventée. Les questions sur les vidéos étaient tapées, et chaque réponse sur une vidéo était uniquement textuelle (modetext).
Pas à pas avec l'exemple du SDK
- Clonez inferencekey-sdk et ouvrez
examples/lfm3-omni-2b-voice-vision-custom-backend-private-nvidia(commitba49628ec5b24b68e8c404b1e54772df6b499f6b). cp .env.example .envet renseignezINFERENCEKEY_SDK_TOKEN,INFERENCEKEY_API_KEY,INFERENCEKEY_PROJECTetIK_WORKER_ID(un worker NVIDIA enregistré, compatible bf16, Ampere ou plus récent, environ 5 GB de mémoire GPU libre, 6 GB pour une vidéo d'une minute, un driver pour CUDA 12.8 ou plus récent, ffmpeg pour la vidéo). Pourpublish.py, aussiINFERENCEKEY_TENANT_IDetINFERENCEKEY_USER_TOKEN.- Installez le client et la build locale du SDK :
python -m venv .venv && . .venv/bin/activate
pip install requests
pip install maturin && ( cd ../../bindings/python && maturin develop --release )
python publish.pyune fois : il empaquettebackend.pyet le téléverse sur votre tenant (ou téléversezdist/*.tar.gzdans Dashboard, Custom backends, et activez "Chat" dans Endpoint settings).python main.py:ensure()déclare le workload (backend="lfm3-omni-2b",task_type="text2audio", politique fixe, une réplique) épinglé à votre worker, attend qu'il soit prêt, envoie trois requêtes (question orale vers parole entrelacée, affiche plus question orale, texte vers parole), écrit les réponses dans./outputset appelledelete()sauf siIK_KEEP_ALIVE=1.
Options de requête dans extra_body : mode (text, audio, interleaved), max_new_tokens (une trame de parole de 80 ms compte pour un), temperature, audio_temperature, audio_repetition_penalty, use_audio_in_video (true par défaut), fps, tools (schémas de fonctions OpenAI). LFM3_VRAM_LIMIT_GIB limite la mémoire PyTorch. Envoyez "model": "default". Les médias inline comptent dans une limite de requête d'environ 2 MiB de JSON : un MP4 de 10 s en 480p fait environ 230 KB.
Délais
| Étape | RTX A5000 | RTX 2000 Ada |
|---|---|---|
De ensure() à prêt | 46,0 s (cache uv chaud) | 59,5 s (worker neuf, cache uv vide) |
| Construction du venv plus setup | 20,0 s | |
| Téléchargement des poids (préchargés en parallèle) | 5 s | 6 s |
| Chargement | 3,6 s | |
| Warm-up (texte et parole) | 3,1 s | |
| Alloué après chargement | 4 274 MiB |
Mesures complètes (à travers la plateforme)
| Cas | RTX A5000 | RTX 2000 Ada 16 GB | Sortie |
|---|---|---|---|
| Question orale (3,3 s) vers texte plus parole entrelacés | 10,48 s de parole en 7,418 s (1,41x), aller-retour 10,11 s ; exécution de test 9,76 s en 6,938 s, premier texte 0,047 s, première trame de parole 0,275 s | 10,08 s en 6,563 s (1,54x), aller-retour 8,24 s ; exécution de test 10,08 s en 6,148 s (1,64x), première trame 0,203 s | Kilimandjaro, 5 895 m juste ; pieds faux (19 004 / "19,34" / 19 031) |
| Image de l'affiche plus question orale, texte | 0,836 s, 1 135 tokens de prompt | 0,931 s | juste |
| Idem, parole entrelacée | 7,12 s de parole en 5,41 s (1,32x), première trame 0,35 s | 6,32 s en 4,26 s (1,48x) | mêmes faits, à l'oral |
| ASR, LibriSpeech 1272-128104-0002 (12,5 s) | 1,16 s | 1,01 s | exact à part la casse et la ponctuation |
| Vidéo de 9,7 s avec bande son, question tapée, prompt système "Answer questions about the video using what you see and hear." | 2,63 s | 2,47 s | "The child is speaking, saying, 'I want to look at the book'" (citation non vérifiée) |
| Même vidéo et même question, images seules, sans prompt système | 5,38 s | 4,87 s | "there is no audible speech or music in the clip" (faux) |
Demande d'outil orale avec le schéma set_volume | 0,56 s | 0,45 s | set_volume({"volume": 30}) |
| TTS anglais voix féminine / espagnol voix masculine | 4,64 s en 2,93 s (1,58x) / 3,68 s en 2,26 s (1,63x), première trame environ 0,05 s | 4,8 s en 2,68 s (1,79x) / 4,16 s en 2,19 s (1,9x) | Whisper relit les phrases |
| Texte, paragraphe de 146 tokens | 37,6 tok/s | 40,5 tok/s | juste |
| Vidéo de 60 s, 8 472 tokens de prompt | 5,9 à 6,4 s, processus à 5 966 MiB | processus à 5 824 MiB | scène et enseignes justes, vraie rue qualifiée de "a driving video game" |
Les deux exécutions vidéo diffèrent sur deux réglages (use_audio_in_video et le prompt système), donc leurs tailles de prompt et leurs temps ne forment pas une comparaison propre sur l'audio seul ; une réexécution en images seules avec le même prompt système n'a pas été faite. Les temps de première trame de parole sont mesurés dans le backend à partir du début de la génération. Le backend renvoie la réponse entière en un seul WAV en base64, donc le client ne reçoit l'audio qu'à la fin de l'aller-retour.
Mémoire GPU : pic PyTorch de 4 285 à 4 434 MiB par requête, processus de 4 772 à 4 832 MiB dans nvidia-smi. La bande son a quatre salves au-dessus de -35 dB (silencedetect). Whisper large-v3 en langue automatique a entendu "Ola, ola..." ; en anglais forcé "I don't want to put it in my bag." ; l'ASR audio seul de LFM3 "I want, I want to put them in."
Échelle de VRAM
Les échelons émulés utilisent torch.cuda.set_per_process_memory_fraction sur l'A5000. Cinq cas : ASR, image plus voix, TTS, voix vers parole, vidéo de 10 s. La limite ne contraint que la mémoire PyTorch, pas le processus entier : le chiffre du processus dans nvidia-smi ajoute environ 400 MiB de mémoire hors PyTorch (processus à 4 832 MiB contre un pic PyTorch de 4 434 MiB). Dans le récit, 4,45 GiB font 4,8 GB et 4,35 GiB font 4,7 GB ; 4 772 à 4 832 MiB font 5,0 à 5,1 GB.
| GPU ou limite | Config | Mémoire de pic (MiB, processus nvidia-smi sauf mention contraire) | Temps par sortie | Sortie OK | Réel ou émulé |
|---|---|---|---|---|---|
| RTX A5000 24 GB | BF16, backend Transformers personnalisé, à travers la plateforme | 4 832 (4 434 PyTorch) | 7,4 s (réponse orale) | oui | réel |
| RTX 2000 Ada 16 GB | idem, worker neuf à travers la plateforme | pic PyTorch 4 434 ; processus à 5 824 pour la vidéo de 60 s | 6,6 s | oui, mêmes réponses | réel |
| Limite de 8 GiB | 5 cas | 4 832 | 6,9 s | oui | émulé |
| Limite de 6 GiB | 5 cas | 4 832 | 5,1 s | oui | émulé |
| Limite de 5 GiB | 5 cas | 4 832 | 6,8 s | oui | émulé |
| Limite de 4,6 GiB | 5 cas | 4 832 | 7,2 s | oui | émulé |
| Limite de 4,45 GiB | 5 cas | 4 772 | 6,8 s | oui | émulé |
| Limite de 4,35 GiB | 5 cas | 4 718 | non : vidéo de 10 s OutOfMemoryError ... Tried to allocate 20.00 MiB ... 4.35 GiB allowed | émulé | |
| Limite de 5,6 GiB, vidéo de 60 s | 8 472 tokens de prompt | 5 966 (5 242 PyTorch) | 5,9 s | oui | émulé |
| Limite de 5,2 GiB, vidéo de 60 s | 8 472 tokens de prompt | non : OutOfMemoryError ... Tried to allocate 142.00 MiB ... 5.20 GiB allowed (OOM aussi à 4,6) | émulé |
Les vitesses n'ont pas changé sous les limites. Les réponses voix vers parole n'étaient pas identiques d'une limite à l'autre : le Kilimandjaro est revenu à 5 895 m avec 19 031, 19 341, "19,34", 19 285 et 19 000 pieds, et une fois (limite de 6 GiB) à "five thousand seven hundred and three meters". Non essayés : de vraies cartes de 6, 8 ou 12 GB (aucune sous 16 GB n'était disponible sur notre cloud pour ce test), les versions GGUF et le serveur temps réel de llama.cpp, les poids quantifiés, la concurrence, le CPU.
SGLang
- Backend
sglangintégré à travers la plateforme (sglang 0.5.23 de PyPI,sglang serve ... --mem-fraction-static 0.35) : d'abord refusé par la vérification préalable de VRAM du worker, "GPU out of memory before sglang spawn: only 19328 MiB free" (elle veut 80 % de la carte libre quel que soit--mem-fraction-static). AvecINFERENCEKEY_VRAM_MIN_FREE_MB=9000: "Lfm3OmniForConditionalGeneration has no SGLang implementation, falling back to Transformers implementation", puis "Exception: Capture cuda graph failed: The size of tensor a (48) must match the size of tensor b (16) at non-singleton dimension 2". Non servi. - PR #46858 compilée à la main sur l'A5000, hors de la plateforme (
sglang 0.5.6.post3.dev14179+g47737555a,SGLANG_BUILD_RUST_EXTS=none,--mem-fraction-static 0.3) : prête en 185 s à froid (CUDA graphs) / 47 s à chaud, processus de 7 036 à 7 338 MiB. Texte à 157 à 159 tok/s sur un paragraphe de 137 tokens (4,2x Transformers). Image plus question orale 0,41 à 0,43 s. Vidéo avec bande son 0,95 s à chaud, mais seulement avec unuse_audio_in_video: trueau premier niveau (mm_processor_kwargsest ignoré et donne la réponse en images seules). Toutes les réponses greedy sont identiques à celles du backend Transformers. Sortie texte uniquement.input_audioavecformat: flaca renvoyé 400. - La commande de la documentation de Liquid AI :
python -m sglang.launch_server --model-path LiquidAI/LFM3-Omni-2B(sortie texte). Elle a besoin de cette PR jusqu'à ce qu'une version publiée l'inclue. L'état de la PR et la version PyPI ont été vérifiés le 2026-11-07 à 06:40 UTC.
Problèmes restants
- Support SGLang non publié (ci-dessus). Notre backend intégré installe sglang depuis PyPI, il ne peut donc pas encore servir LFM3. Ouvert, en amont.
- La vérification préalable de VRAM du worker bloque un second moteur sur une carte où le premier tourne déjà (règle des 80 % libres). Contournement :
INFERENCEKEY_VRAM_MIN_FREE_MB. Ouvert de notre côté. - Faux prêt :
wait_until_readypour le workload sglang a affiché "ready [server_up]" au bout de 23 s alors qu'uv installait encore sglang ; c'était un autre workload du même worker qui était démarré. Ouvert de notre côté. - Nom de modèle de l'endpoint :
"model": "lfm3"renvoie 400model_not_available; envoyez"model": "default". Documenté dans l'exemple. - Pas de streaming de la parole vers le client dans ce backend : le client attend le WAV entier. Non construit.
- Le décodage texte de Transformers est lent : 38 à 40 tok/s, le même sur la carte de 70 W que sur l'A5000. Transformers signale aussi que
causal_conv1d_fnse rabat sur son implémentation PyTorch de référence parce quecausal_conv1dn'est pas installé ("This is correct but much slower") ; que cela explique la vitesse n'est pas vérifié. - Dérapages du modèle : le Kilimandjaro en dix exécutions vocales : mètres justes neuf fois (5 703 une fois), pieds justes une fois (19 341) et faux dans les huit autres qui donnaient des pieds ; les réponses entrelacées varient avec l'échantillonnage audio ; mots cités à partir d'un audio peu clair non vérifiés ; vraies images de rue qualifiées de "a driving video game". Whisper a lu un WAV du Kilimandjaro comme "19,034 feet" alors que le texte disait "19,34", donc l'audio et le texte peuvent légèrement différer sur ce chiffre.
- Deux machines de notre cloud (une A5000 et une A4000) n'ont jamais ouvert de SSH direct en 180 s et le manager les a écartées avant l'exécution.
Vidéo de démo
La vidéo explicative commentée de 172 secondes : les propres exemples de Liquid AI avec crédit, un insert sur l'architecture et un insert de benchmarks tirés de la page du modèle, puis notre déploiement sur l'A5000, la réponse orale du modèle sur l'affiche jouée sans commentaire, l'appel d'outil oral, la comparaison clé et l'échelle de mémoire. Sous-titres disponibles.
Autres échantillons
- Synthèse vocale, voix masculine en espagnol, 3,7 s : "El museo abre a las 10 de la mañana y cierra a las 6 de la tarde."
- Réponse orale sur le Kilimandjaro, entrelacée, 9,8 s (mètres justes, pieds faux)
Sources
- LiquidAI/LFM3-Omni-2B (page du modèle, configs, code de modélisation).
- LFM Open License v1.0.
- LiquidAI/LFM3-Omni-2B-GGUF.
- Introducing LFM3: Every Modality for Specialized Intelligence (blog de Liquid AI, 27 octobre 2026).
- Documentation de Liquid AI, déploiement SGLang.
- sgl-project/sglang#46858.
- Vidéo d'actualités d'AI Search, 2026-11-01 (là où nous l'avons repéré).
- Exemple du SDK, commit
ba49628ec5b24b68e8c404b1e54772df6b499f6b. - Tests antérieurs d'un seul étage sur ce site : Ming TTS, Nemotron Transcribe, Underdog Bark.