Nanbeige4.3-33B : un 33B dense à 42 tokens/s sur 24 GB, en 3 bits pour 16 GB
Un 33B dense pour agents sur une carte de 24 GB : 42 tokens/s, appels d'outils propres, 64K de contexte. En 3 bits, 14 tokens/s sur une vraie carte de 16 GB.
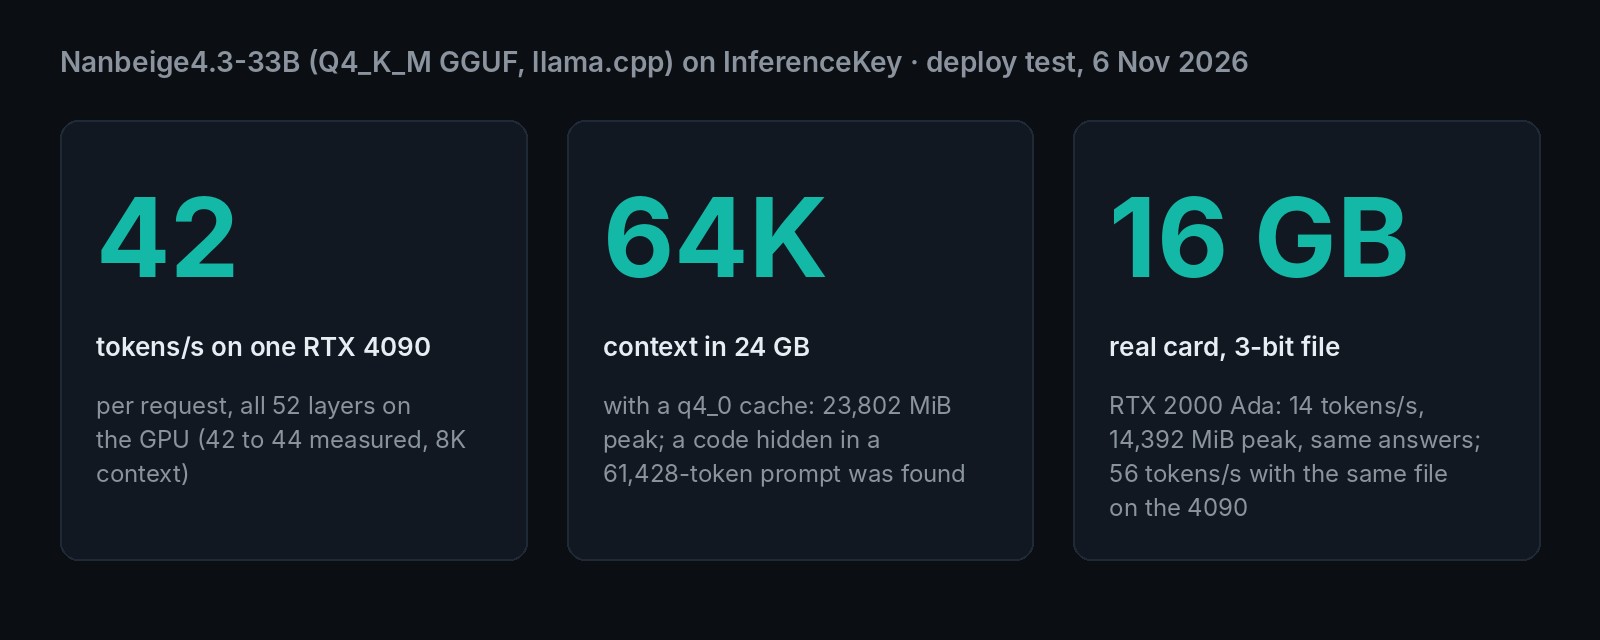
Quelle carte faut-il pour un modèle de code de 33 milliards de paramètres qui les utilise tous à chaque mot ? Nous avons fait tourner Nanbeige4.3-33B, un modèle sous Apache-2.0, sur une seule RTX 4090 de 24 GB louée sur notre cloud. Avec un fichier compressé en 4 bits, il écrivait environ 42 tokens par seconde. Ses appels d'outils sont revenus valides dans tous nos essais. La 4090 a aussi tenu un prompt de 64K tokens, environ 50 000 mots. Une vraie carte de station de travail de 16 GB a passé nos tests avec un fichier en 3 bits, à environ 14 tokens par seconde. Ses auteurs le placent devant Qwen3.8-27B sur deux tests de code agentique sur trois. Toute l'exécution est empaquetée comme exemple du SDK pour votre propre carte. Un problème sérieux : quand le modèle réfléchit avant de répondre (le comportement par défaut), sa réponse finale d'agent est revenue vide dans 2 exécutions sur 3.
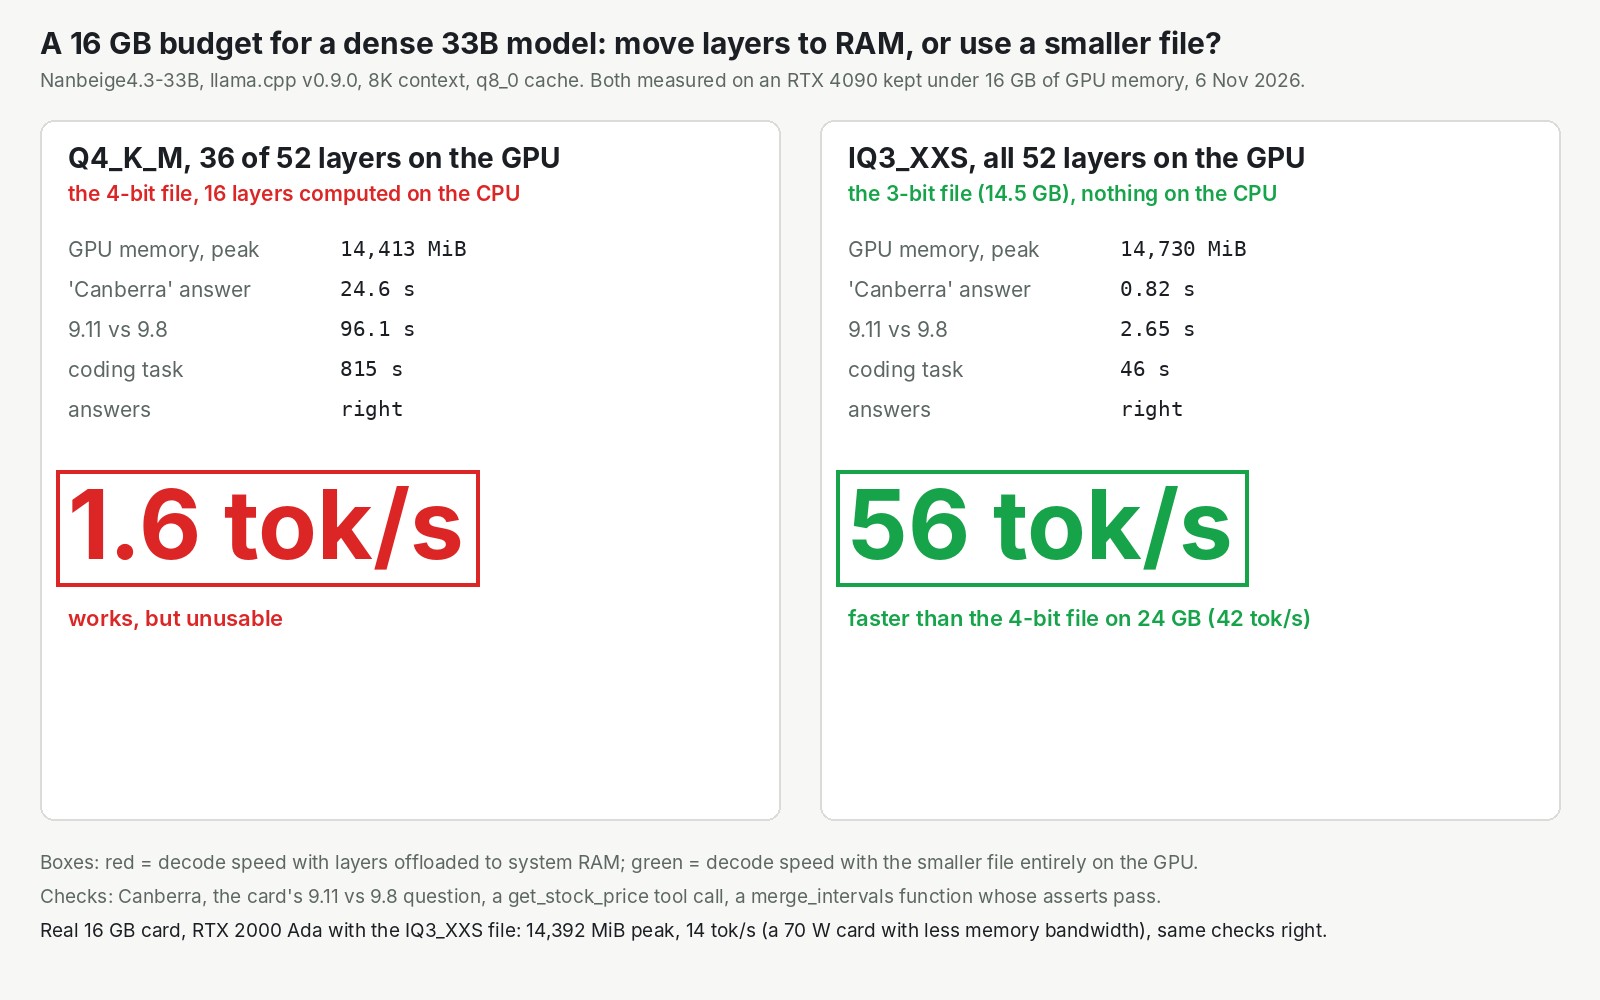
Cette image, c'est la décision pour quiconque a moins de 24 GB.
Un 33B dense paie chaque paramètre à chaque mot
Pour écrire chaque mot, la carte doit lire tout le fichier du modèle depuis sa propre mémoire, et le fichier fait 20,8 GB. Cette lecture fixe le plafond de vitesse. Un fichier plus petit, c'est moins à lire et plus de mots par seconde. Tout ce qui reste hors de la mémoire de la carte se lit beaucoup plus lentement, et la vitesse s'effondre.
C'est le prix d'un modèle dense. Les modèles d'agent que nous avons testés avant lui, comme Groot-19B et Clover-35B-A3B, fonctionnent autrement. Imaginez un big band où, à chaque mesure, seuls quelques solistes jouent pendant que les autres se taisent. Un modèle de 35 milliards de paramètres de ce type peut n'en utiliser que 3 milliards par mot, il est donc rapide. Nanbeige4.3-33B est dense : tout l'orchestre joue à chaque mesure. Les 33 milliards de paramètres travaillent sur chaque token.
Le modèle est arrivé sur Hugging Face le 24 octobre. Ses auteurs en font le "professeur" de la série : des modèles plus petits apprendront de lui plus tard. Ils annoncent "state-of-the-art agentic performance among open models in the ~30B parameter class". Sa page indique des prompts jusqu'à 512K tokens. Nous sommes allés jusqu'à 64K. Il réfléchit avant de répondre par défaut, et tout le monde peut le télécharger sans demander d'accès.
Les auteurs le comparent à trois modèles ouverts de taille similaire. Voici leurs chiffres, obtenus de la même façon pour chaque modèle, à l'effort de réflexion maximal. Nous ne les avons pas reproduits.
| Test (chiffres des auteurs) | Nanbeige4.3-33B | Qwen3.8-27B |
|---|---|---|
| Terminal-Bench 2.1, travail d'agent en ligne de commande | 80,9 | 73,0 |
| DeepSWE, ingénierie logicielle agentique | 65,5 | 42,5 |
| SWE-Bench Pro, corriger de vrais tickets dans du vrai code | 60,3 | 61,7 |
La troisième ligne est une défaite, et les auteurs la publient, avec deux autres défaites sur d'autres tests. Claude, GPT et les autres modèles fermés ne sont pas dans le tableau.
La taille est le point dur. Non compressé, le modèle fait 66 GB. Les recettes de service des auteurs répartissent le modèle sur quatre GPU et ne disent rien d'une exécution sur un seul. bartowski a publié des versions compressées en un seul fichier pour llama.cpp, un programme gratuit pour faire tourner des modèles soi-même. Ces fichiers comptent déjà 123 000 téléchargements.
Notre test : un fichier en 4 bits, une carte de 24 GB, nos propres prompts
Nous avons utilisé le fichier en 4 bits recommandé par bartowski (20,8 GB). Il a tourné sur une RTX 4090, le modèle entier sur la carte, avec notre configuration llama.cpp standard. La plupart des tests sont passés par la même API de style OpenAI qu'appellerait un produit.
Nos tests étaient modestes. Nous avons demandé une réponse en un mot, la question 9.11 ou 9.8 tirée de la page du modèle, et une tâche de code avec ses propres tests. Nous avons aussi essayé deux appels d'outils et un mot secret caché dans de longs prompts. Un appel d'outil, c'est le modèle qui demande à votre code d'exécuter une fonction : ici un cours de bourse, et une météo pour deux villes à la fois.
Les limites : une requête à la fois, nos propres prompts plutôt que les benchmarks des auteurs, deux vraies cartes, rien au-delà de 64K, et pas la configuration serveur à quatre GPU des auteurs. Nous avons testé des appels d'outils isolés et un tour d'agent, pas un agent qui travaille sur une base de code. Nous avons analysé les appels d'outils avec llama.cpp, pas avec le parser qwen3_coder que la page du modèle recommande pour vLLM et SGLang. Cette voie n'est pas testée.
Environ 42 tokens par seconde sur une RTX 4090, avec des appels d'outils valides
Sur la 4090, le modèle écrivait 42 à 44 tokens par seconde pour une requête. Le premier token arrivait en un quart à une demi-seconde sur les prompts courts. En temps de lecture, un long paragraphe s'affiche en environ quatre secondes.
| Ce que nous avons demandé | Ce qui est revenu | Temps |
|---|---|---|
| "Capital of Australia, one word" | Canberra, après une courte réflexion | environ 1,2 s |
| "Which number is bigger, 9.11 or 9.8?" | 9.8, avec la position décimale expliquée, dans les deux exécutions | 3,6 à 4,6 s |
| Une tâche de code avec ses propres tests | Du code qui tourne, les tests passent | 24,6 s |
| Un outil de cours de bourse | get_stock_price({"symbol":"AAPL"}), valide | environ 2,2 s |
| "Is it warmer in Lisbon or in Oslo?" | Deux appels météo à la fois, tous deux valides | 2,8 à 3,0 s |
| La même, après le retour des résultats des outils | "Lisbon is warmer ... 19°C ... 4°C" (voir plus bas) | 3,1 s |
Chaque appel d'outil est revenu au format OpenAI standard, valide dans les deux essais de chaque appel sur la 4090.
Pour un développeur seul qui pilote un agent, cette vitesse est confortable.
64K de contexte tiennent dans 24 GB, et l'écriture ralentit à mesure qu'il se remplit
La 4090 a tenu un prompt de 64K tokens et a trouvé un mot secret caché au token 61 428. Pour que cela tienne, la mémoire qu'elle garde du prompt a dû être comprimée au quart de sa taille, et l'écriture est tombée à 16 tokens par seconde.
En plus du modèle, la carte garde des notes sur tout ce que le modèle a lu jusque-là, et elles grossissent à chaque token. Les notes en taille réelle s'arrêtent à 16K. Les diviser par deux mène à 32K, par quatre à 64K, avec moins de 1 GB de libre sur la carte.
| Contexte | Notes compressées en | Mémoire de pic (MiB) | Mot secret trouvé à | Réponse en | Vitesse d'écriture à cette profondeur |
|---|---|---|---|---|---|
| 16K | non (16 bits) | 23 186 | 14 909 tokens | 7,9 s | 37 tokens/s |
| 32K | 8 bits | 23 434 | 30 734 tokens | 18,8 s | 25 tokens/s |
| 64K | 4 bits | 23 802 | 61 428 tokens | 49,1 s | 16 tokens/s |
Les trois ont trouvé le mot. À 64K, l'écriture tourne à moins de la moitié de la vitesse sur prompt court, parce que chaque nouveau mot lit aussi 61 000 tokens de notes.
Quel GPU : une vraie carte de 16 GB fonctionne avec le fichier en 3 bits, à environ 14 tokens par seconde
La plus petite carte qui a réussi est une vraie carte : une RTX 2000 Ada, une carte de station de travail de 16 GB et 70 watts, avec le fichier en 3 bits de bartowski. Elle a passé les mêmes tests à environ un tiers de la vitesse de la 4090 : une réponse de 400 tokens prend donc environ 30 secondes au lieu de 10.
| Carte ou budget mémoire | Fichier et configuration | Mémoire de pic (MiB) | Vitesse | Tests | Vraie carte ? |
|---|---|---|---|---|---|
| RTX 2000 Ada 16 GB | 3 bits, 8K, notes en 8 bits | 14 392 | 13,6 à 14,4 tokens/s | tous justes | oui |
| Budget de 16 GB | 3 bits, tout sur la carte | 14 730 | 56,5 tokens/s | tous justes | non, exécuté sur la 4090 |
| Budget de 16 GB | 4 bits, un tiers hors de la carte | 14 413 | 1,6 token/s | justes, inutilisable | non, exécuté sur la 4090 |
| Budget de 12 GB | 2 bits, 8K | 10 670 | 74,9 tokens/s | une explication fausse | non, exécuté sur la 4090 |
Lisez les lignes "non" comme des mesures de mémoire, pas comme des promesses de vitesse. Chacune a tourné sur la 4090 complète de 24 GB, sans limite de mémoire, et son pic est resté sous le budget. Là, le fichier en 3 bits tournait à 56,5 tokens par seconde, parce qu'il y a moins à lire. La vraie carte de 16 GB l'a fait tourner à 14, parce qu'elle lit sa mémoire beaucoup plus lentement.
Le fichier en 2 bits, dont le pic est resté sous 12 GB sur la 4090, a donné les bons chiffres, mais a dit que le 8 de 9.8 se trouve "in the hundredths place", au rang des centièmes. Il est au rang des dixièmes. Une erreur sur quatre tests suffit pour tenir le 2 bits à l'écart du code.
Le problème que vous rencontrerez : les réponses atterrissent dans le canal de réflexion et reviennent vides
Avec la réflexion activée, le réglage par défaut, certaines réponses arrivent avec une réponse vide. Toute la réponse se trouve à la place dans le champ de réflexion du modèle. Statut : ouvert.
C'est arrivé sur chaque essai de 400 mots que nous avons demandé, trois sur trois. Cela a aussi touché la courte réponse finale de l'agent après les résultats météo dans deux exécutions sur trois, une fois sur chaque carte. Les réponses courtes ponctuelles et les appels d'outils eux-mêmes n'ont jamais été touchés.
L'enveloppe de prompt du modèle ouvre un bloc de réflexion, le modèle répond parfois sans le fermer, et llama.cpp range toute la réponse comme réflexion. Quand nous avons envoyé la requête directement à llama.cpp avec la réflexion désactivée, l'essai est arrivé dans la réponse normale, avec ses 3 151 caractères.
À travers InferenceKey, cet interrupteur par requête ne passe pas encore : notre endpoint l'ignore. Ce manque est de notre côté et reste ouvert. En attendant le correctif, un réglage serveur dans la commande de lancement (en annexe) devrait désactiver la réflexion pour toutes les requêtes. Nous ne l'avons pas exécuté, son effet sur la réponse finale de l'agent n'est donc pas testé. Les auteurs ont mesuré leurs scores à l'effort de réflexion maximal et recommandent de le garder pour les agents. L'exemple du SDK signale aussi une réponse vide et affiche le texte du champ de réflexion.
Un point plus mineur : si vous ne donnez au modèle aucune instruction permanente, son template ajoute les siennes, en chinois. Elles disent que le modèle est Nanbeige, créé par BOSS Zhipin. Elles n'ont rien abîmé dans nos tests, mais envoyez les vôtres.
Sur InferenceKey : prêt en cinq minutes, presque toutes passées à compiler
La carte est à vous à l'heure, et notre configuration llama.cpp standard a fait tourner ce modèle sans aucun changement de la plateforme. Nous avons fixé un numéro de version et écrit une commande de lancement.
Sur InferenceKey, un worker est le petit programme sur votre machine GPU qui reçoit les ordres de la plateforme. Le nôtre compile llama.cpp pour le GPU exact la première fois qu'on le lui demande. Sur la 4090, le déploiement était prêt 303,7 secondes après la demande. Presque tout ce temps est allé à cette compilation, environ cinq minutes. Le fichier de 20,8 GB avait été récupéré en parallèle en 15 secondes, et son chargement a pris environ 4. Une fois la compilation faite, relancer llama.cpp avec le fichier en cache était prêt en 3 à 5 secondes.
Sur la machine de la RTX 2000 Ada, la même compilation a pris 19 minutes 50 secondes, parce que les processeurs de cet hôte étaient bridés. Elle était prête après environ 20 minutes. Prévoyez un premier démarrage lent sur un petit hôte : il nous manque encore un llama.cpp précompilé pour NVIDIA.
Cette exécution a utilisé notre propre copie locale de la plateforme InferenceKey, avec le même code que le service hébergé. L'exemple du SDK envoie le modèle sur une machine que vous désignez, les poids et l'inférence restent donc sur votre matériel.
Faut-il l'utiliser ? À essayer sur 24 GB, si vous pouvez vivre pour l'instant avec des réponses d'agent vides
- Vous avez une carte de 24 GB et voulez un modèle d'agent ouvert pour coder : à essayer. Confrontez les scores des auteurs à vos propres tâches.
- Il vous faut de longs prompts : jusqu'à 64K sur une carte de 24 GB, plus lent à mesure qu'il se remplit.
- Vous avez une carte de 16 GB : utilisez le fichier en 3 bits entièrement sur la carte, jamais le fichier en 4 bits avec un tiers hors de la carte. La vitesse dépend de la mémoire de votre carte.
- Vous l'utilisez comme agent aujourd'hui : attendez-vous à des réponses finales vides avec la réflexion activée. Désactiver la réflexion sur le serveur devrait régler le problème.
Pour lancer les mêmes tests sur votre propre worker NVIDIA de 24 GB, exécutez python main.py depuis l'exemple Nanbeige4.3-33B du SDK. Il faut un projet, un token SDK et une clé d'API, et il supprime le déploiement à la fin.
Pour les ingénieurs
Crédits
- L'équipe Nanbeige (BOSS Zhipin) : le modèle, le modèle de base, les pages des modèles, le tableau de benchmarks et le chat template avec des appels d'outils XML de style Qwen3-Coder. Publié le 2026-10-24 sous Apache-2.0.
- bartowski : les quants GGUF imatrix (llama.cpp b11845) que nous avons utilisés : Q4_K_M, IQ3_XXS et IQ2_XXS.
- axteam : une version NVFP4A16 pour vLLM (non testée par nous).
- Les mainteneurs de llama.cpp : le serveur, le support des templates
--jinjaqui a analysé les appels d'outils XML, et la version v0.9.0. - AI Search : là où nous avons repéré le modèle (vidéo d'actualités du 2026-11-01, chapitre à 43:03), qui signalait la taille de 66,3 GB et "quite some high-end hardware".
- Notre part : le déploiement à travers la plateforme, les tests et les prompts, l'échelle de mémoire sur deux vraies cartes plus trois exécutions sur la 4090 dimensionnées pour des budgets de 16 et 12 GB, le diagnostic du problème des réponses vides, l'exemple du SDK et la vidéo de démo.
Modèle et fichiers
Nanbeige/Nanbeige4.3-33B: shadf919e1e, dernière modification le 2026-10-28, 33 118 977 024 paramètres BF16, environ 66,3 GB en 14 shards, 19 178 téléchargements et 1 052 likes au 2026-11-06. Modèle de baseNanbeige4.3-33B-Base: shae061adde.- Architecture :
LlamaForCausalLMdense, 52 couches, 56 têtes d'attention, 8 têtes KV, head_dim 128, hidden 7168, FFN 22016, vocabulaire de 166 912,max_position_embeddings524 288,rope_theta1.2e8. bartowski/Nanbeige_Nanbeige4.3-33B-GGUF: sha9beb6842, créé le 2026-10-25, 123 000 téléchargements. Q4_K_M 20,79 GB, Q4_K_S 19,74 GB, IQ4_XS 18,64 GB, IQ3_XXS 14,49 GB, IQ2_XXS 10,07 GB, Q5_K_M 25,07 GB, Q8_0 35,20 GB, bf16 66,24 GB. Q4_K_M utilisé : 20 788 825 216 B, sha2562cef7985...identique au hash LFS de Hugging Face.axteam/Nanbeige4.3-33B-NVFP4A16: FP4 W4A16 pour vLLM, environ 22,1 GB, testé par son auteur sur vLLM 0.32.0 sur B200 uniquement, sa propre moyenne lm-eval à 98,9 % de BF16. Non testé par nous.- Cache KV en f16 : 52 x 8 x 128 x 2 x 2 B = 208 KiB par token (8K font 1,6 GiB, 32K font 6,5 GiB).
q8_0environ la moitié,q4_0environ un quart. - Dimensionnement approximatif d'après les notes de la vidéo source (une estimation, non mesurée) : environ 80 GB pour servir en BF16, environ 40 GB en 8 bits, environ 20 GB en 4 bits.
Affirmations des auteurs (non reproduites)
Nanbeige4.3-33B / Qwen3.8-27B / Muse-Glimmer-30B / Gemma4-31B, effort de réflexion maximal, même harnais, preserve_thinking=true :
| Benchmark | Nanbeige4.3-33B | Qwen3.8-27B | Muse-Glimmer-30B | Gemma4-31B |
|---|---|---|---|---|
| Terminal-Bench 2.1 (Terminus 2) | 80,9 | 73,0 | 61,8 | 47,2 |
| Terminal-Bench 4.0 | 23,8 | 6,3 | 1,6 | 0,0 |
| DeepSWE | 65,5 | 42,5 | 4,4 | 2,7 |
| SWE-Bench Pro | 60,3 | 61,7 | 51,2 | 36,9 |
| JobBench | 44,8 | 34,5 | 16,6 | 9,0 |
| GDPval | 84,8 | 86,4 | 75,8 | 71,4 |
| GPQA Diamond | 89,5 | 89,2 | 83,5 | 91,3 |
| AIME 2026 | 95,2 | 94,5 | 94,7 | 89,2 |
| AA-LCR | 84,0 | 82,0 | 83,3 | 72,0 |
Également Nanbeige contre Qwen : SWE-Atlas-QnA 50,8 contre 41,9, NL2Repo 53,0 contre 48,3, SkillsBench 61,1 contre 56,4, Automation Bench 54,2 contre 38,3, Toolathlon-Verified 70,4 contre 68,5, Tau3-Bench 48,8 contre 48,5. Modèle de base contre Gemma4-31B-Base : MMLU-Pro 66,9 contre 59,3, GPQA 62,0 contre 41,5, SuperGPQA 45,6 contre 33,8, GSM8K 92,9 contre 88,9, Math 57,3 contre 43,6, MBPP 74,6 contre 72,5, MMLU 85,5 contre 84,2, CMMLU 86,8 contre 76,9.
Une incohérence dans la page : JobBench pour Muse-Glimmer-30B vaut 16,6 dans le tableau et dans la carte thermique par métier, 18,3 dans le graphique en barres. Les auteurs ne se comparent qu'à des modèles ouverts d'environ 30B ; les classements tiers de Terminal-Bench 2.1 utilisent d'autres harnais, nous ne faisons donc aucune comparaison avec les modèles de pointe.
Notes d'usage de la page : réflexion activée par défaut (enable_thinking) ; preserve_thinking recommandé pour l'usage d'outils sur plusieurs tours ; format d'outils xml (par défaut) ou json ; échantillonnage 1.0 / 0.95 (jusqu'à 65 536 nouveaux tokens) pour l'usage agentique et les outils, 0.6 / 0.95 (jusqu'à 262 144) pour le raisonnement et le chat. Recettes SGLang et vLLM : tensor parallel 4, --reasoning-parser qwen3 --tool-call-parser qwen3_coder (vLLM aussi --enable-auto-tool-choice, --gpu-memory-utilization 0.8).
Installation
- GPU sur InferenceKey Cloud : RTX 4090 24 GB (450 W, compute capability 8.9) pour l'exécution principale ; RTX 2000 Ada 16 GB (70 W) pour le vrai échelon de 16 GB.
- Backend : le backend
llamacppintégré,INFERENCEKEY_LLAMACPP_TAG=v0.9.0(le GGUF a été produit avec b11845, la version par défaut du worker est plus ancienne). Architecture Llama, donc n'importe quel tag récent le charge ; v0.9.0 est plus récent que la build du quantificateur. - Pourquoi llama.cpp et pas vLLM : les recettes de la page supposent quatre GPU en BF16, et la voie GGUF est celle qui tient dans 24 GB. Le parser
qwen3_codern'a pas été testé ;--jinjade llama.cpp a converti les appels d'outils XML entool_callsOpenAI. - Routage : les tests courts, l'exemple du SDK et les tests sur la RTX 2000 Ada sont passés par l'endpoint de style OpenAI ; les échelons de contexte long et de budget sont allés directement à llama-server sur le pod.
- Un manager InferenceKey local (même code que le service hébergé) avec deux workers. La production n'a jamais été touchée.
- Échantillonnage : les valeurs de la page, 0.6 / 0.95 pour le chat et 1.0 / 0.95 pour les outils. Échelons de l'échelle avec la seed 42.
Pas à pas avec l'exemple du SDK
- Clonez inferencekey-sdk et ouvrez
examples/nanbeige43-33b-agent-llamacpp-private-nvidia(commit10209c3596fe1fd28dd63a30442eb543e6a456cc). cp .env.example .envet renseignezINFERENCEKEY_SDK_TOKEN,INFERENCEKEY_API_KEY,INFERENCEKEY_PROJECTetIK_WORKER_ID(un worker NVIDIA privé de 24 GB). Optionnel :NANBEIGE_CONTEXT(par défaut 8192),NANBEIGE_KV_TYPE(par défautf16),NANBEIGE_GGUF_FILE,IK_KEEP_ALIVE=1.pip install -r requirements.txtplus la build locale du SDK avec maturin (voirexamples/CONTRIBUTING.mddans le dépôt du SDK).- Si l'image du worker a
nvcchors duPATH(les images PyTorch CUDA 13), définissez ceci dans l'environnement du worker et redémarrez-le :
CUDACXX=/usr/local/cuda/bin/nvcc
PATH=/usr/local/cuda/bin:$PATH
CMAKE_BUILD_PARALLEL_LEVEL=<number of CPU cores>
python main.py. Il fait unensure()d'un workloadllamacppfixe (task_typetext2text,ExecutionPolicy.FIXED) épinglé à votre worker, attend jusqu'à 3 600 s, pose la question de la page avecgenerate_text(), fait l'appelget_stock_price, exécute le tour d'agent météo à deux appels, écritoutputs/answers.jsonet appelledelete()sauf siIK_KEEP_ALIVE=1.
La commande de lancement qu'exécute le backend :
INFERENCEKEY_LLAMACPP_TAG=v0.9.0 llama-server \
  -hf bartowski/Nanbeige_Nanbeige4.3-33B-GGUF \
  --hf-file Nanbeige_Nanbeige4.3-33B-Q4_K_M.gguf \
  --alias nanbeige4.3-33b -ngl 99 -fa on \
  -c 8192 -ctk f16 -ctv f16 \
  --jinja --reasoning-format deepseek
Pour 32K, utilisez -c 32768 -ctk q8_0 -ctv q8_0 ; pour 64K, -c 65536 -ctk q4_0 -ctv q4_0. Pour une carte de 16 GB, définissez NANBEIGE_GGUF_FILE=Nanbeige_Nanbeige4.3-33B-IQ3_XXS.gguf et NANBEIGE_KV_TYPE=q8_0. Devrait éviter les réponses vides : ajoutez --chat-template-kwargs '{"enable_thinking":false}' (réflexion désactivée pour toutes les requêtes). Non testé : nous n'avons jamais lancé ce flag, et le tour final de l'agent n'a jamais été réexécuté avec la réflexion désactivée ; la qualité de l'agent sans réflexion n'est pas mesurée.
Délais
| Étape | RTX 4090 | RTX 2000 Ada |
|---|---|---|
De ensure() à prêt, worker neuf | 303,7 s | 1 203,6 s |
| Compilation CUDA de llama.cpp v0.9.0 | environ 5 min (32 jobs en parallèle) | 19 min 50 s (hôte au CPU bridé, 48 vCPU visibles, charge d'environ 7) |
| Téléchargement du GGUF (préchargé en parallèle, hors du chemin vers prêt) | 15 s (Q4_K_M) | 20 s (IQ3_XXS) |
| Chargement du modèle | environ 4 s | |
| Relance de llama-server sur le pod (binaire compilé, fichier en cache ; pas un déploiement de la plateforme) | 2,7 à 4,5 s |
Vitesse et sorties (RTX 4090, Q4_K_M, 8K, cache f16, streaming à travers l'endpoint)
| Test | Tokens de complétion | Secondes | Premier token (s) | Décodage tokens/s | Résultat |
|---|---|---|---|---|---|
| Capitale de l'Australie x2 | 40 / 40 | 1,19 / 1,27 | 0,28 / 0,37 | 43,7 / 44,4 | Canberra |
| 9.11 ou 9.8 | 183 | 4,55 | 0,28 | 42,9 | juste, position décimale expliquée |
merge_intervals + 3 asserts | 1 026 | 24,62 | 0,43 | 42,4 | les asserts passent |
| Essai de 400 mots x3 | 641 / 552 / 591 | 15,4 / 13,2 / 14,2 | 0,26 à 0,37 | 42,6 | content vide, tout dans reasoning_content |
get_stock_price | 72 | 2,17 | 0,50 | 43,2 | {"symbol":"AAPL"}, finish tool_calls |
| Lisbonne ou Oslo | 101 | 2,82 | 0,47 | 43,0 | deux appels get_weather parallèles |
| Aiguille, prompt de 6 142 tokens | 81 | 4,65 | 2,65 | 40,4 | trouvée |
chat_template_kwargs enable_thinking=false via l'endpoint | 40 | 2,16 | 1,24 | 43,5 | ignoré par la gateway, réfléchit quand même |
Exécution de l'exemple du SDK sur la 4090 : question de la page 3,6 s ; appel boursier 2,27 s ; étape 1 de l'agent (deux appels) 2,97 s ; étape 2 3,12 s à 44,3 tokens/s, réponse juste. Pic de puissance 448,6 W.
Contexte long sur la 4090 : prefill 2 514 / 2 038 / 1 544 tokens/s à 14 909 / 30 734 / 61 428 tokens ; réponses courtes à environ 41 à 42 tokens/s dans les trois configurations.
RTX 2000 Ada à travers l'endpoint : Canberra 2,9 à 3,1 s, question de la page 8,65 s (14,0 s dans l'exécution de l'exemple) juste, appel boursier 4,64 à 5,26 s, deux appels météo parallèles 8,09 à 8,23 s, merge_intervals 1 398 tokens en 102,7 s avec les asserts qui passent, réponse finale de l'agent vide (problème 1). Pic de puissance 69,8 W, à sa limite de 70 W.
Échelle de VRAM
VRAM de pic d'après nvidia-smi. Les échelons émulés ont tourné sur la 4090 complète de 24 GB sans limite de mémoire ; le pic de la configuration est resté sous le budget. Tests : Canberra, 9.11 contre 9.8, l'appel get_stock_price, et merge_intervals avec ses propres asserts.
| GPU ou budget | Config | VRAM de pic | Vitesse | Sortie OK | Réel ou émulé |
|---|---|---|---|---|---|
| RTX 4090 24 GB | Q4_K_M, 8K, f16 (l'exemple, à travers l'endpoint) | 21 907 MiB | 42 à 44 tokens/s ; Canberra 1,2 s | oui | réel |
| RTX 4090 24 GB | Q4_K_M, 16K, f16 | 23 186 MiB | 42,1 ; aiguille à 14 909 tokens 7,9 s, 37,3 en profondeur | oui | réel |
| RTX 4090 24 GB | Q4_K_M, 32K, q8_0 | 23 434 MiB | 41,3 ; aiguille à 30 734 tokens 18,8 s, 24,6 en profondeur | oui | réel |
| RTX 4090 24 GB | Q4_K_M, 64K, q4_0 | 23 802 MiB | 41,2 ; aiguille à 61 428 tokens 49,1 s, 16,4 en profondeur | oui | réel |
| Budget de 16 GB | IQ3_XXS, 8K, q8_0, tout sur le GPU | 14 730 MiB | 56,5 ; Canberra 0,82 s, question de la page 2,65 s, code 2 537 tokens 46,0 s | oui | émulé sur la 4090 |
| Budget de 16 GB | Q4_K_M, -ngl 36 (16 des 52 couches sur le CPU), 8K, q8_0 | 14 413 MiB | 1,6 ; Canberra 24,6 s, question de la page 96,1 s, code 815 s | oui, inutilisable | émulé sur la 4090 |
| Budget de 12 GB | IQ2_XXS, 8K, q8_0 | 10 670 MiB | 74,9 ; code 1 395 tokens 18,7 s | réponses justes, une explication fausse | émulé sur la 4090 |
| RTX 2000 Ada 16 GB | IQ3_XXS, 8K, q8_0, à travers l'endpoint | 14 392 MiB | 13,6 à 14,4 | oui ; réponse finale de l'agent vide | réel |
Le plus petit qui a réussi : la vraie RTX 2000 Ada 16 GB avec IQ3_XXS, à environ un tiers de la vitesse de la 4090. Le README de l'exemple indique 21 508 MiB pour sa configuration (un échelon de référence) ; 21 907 MiB est le pic pendant les tests principaux, prise enregistrée comprise.
Non essayés : un agent de code en plusieurs étapes sur un vrai dépôt (seulement des appels d'outils isolés et un tour d'agent) ; l'endpoint hébergé (uniquement un manager local) ; les requêtes concurrentes ; 128K ou plus sur 24 GB ; une autre carte de 24 GB (A5000, RTX 3090) ; une vraie carte de 12 GB ; un budget de 8 GB ; NVFP4A16 sur vLLM ; vLLM ou SGLang avec le parser qwen3_coder ; la qualité du cache q4_0 au-delà du test de l'aiguille ; les benchmarks des auteurs.
Problèmes restants
- Réponses dans le canal de réflexion. Avec la réflexion activée, le template termine le prompt par
<|im_start|>assistant\n<think>\n. Sur certaines réponses, le modèle écrit directement la réponse et n'émet jamais</think>;--reasoning-format deepseekrenvoie alors tout commereasoning_contentaveccontent= "". Observé sur l'essai (3 sur 3) et sur le tour final de l'agent (2 exécutions sur 3 : la prise enregistrée sur la 4090 et l'exécution sur la RTX 2000 Ada ; la première exécution de l'exemple avait du contenu). Avecenable_thinking=false, le template insère<think>\n\n</think>\n\net l'essai est revenu danscontent(3 151 caractères). Contournement proposé à travers InferenceKey, non exécuté :--chat-template-kwargs '{"enable_thinking":false}'.main.pysignale les réponses vides avecanswer_text(). Non testés : d'autres formats de raisonnement,--reasoning-budget. Ouvert. - L'endpoint ignore
chat_template_kwargspar requête, la réflexion ne peut donc pas être désactivée par requête à travers InferenceKey. Manque connu de notre côté, ouvert. - Le déchargement partiel n'est pas un moyen de tenir dans 16 GB avec un modèle dense : 1,6 token/s avec 16 des 52 couches sur le CPU. Utilisez le quant plus petit entièrement sur le GPU.
- Premier démarrage lent : le worker compile llama.cpp depuis les sources sur NVIDIA (5 min sur l'hôte de la 4090, 19 min 50 s sur un hôte bridé). Pas encore de binaire CUDA précompilé. Ouvert.
- La compilation du worker a besoin de
nvccdans lePATHsur certaines images ; contournement dans le pas à pas ci-dessus. Ouvert dans le worker. - Prompt système chinois par défaut : sans message système, le template injecte "你是南北阁,一款由BOSS直聘自主研发并训练的专业大语言模型。" ("You are Nanbeige, a professional LLM developed and trained by BOSS Zhipin") ; avec des outils et sans message système, un autre prompt chinois d'expert en outils. Envoyez le vôtre.
- Page du modèle : l'incohérence de JobBench ci-dessus, et aucune indication pour un seul GPU ou pour GGUF.
- Qualité en 2 bits : IQ2_XXS a expliqué 9.8 comme "8 in the hundredths place".
Vidéo de démo
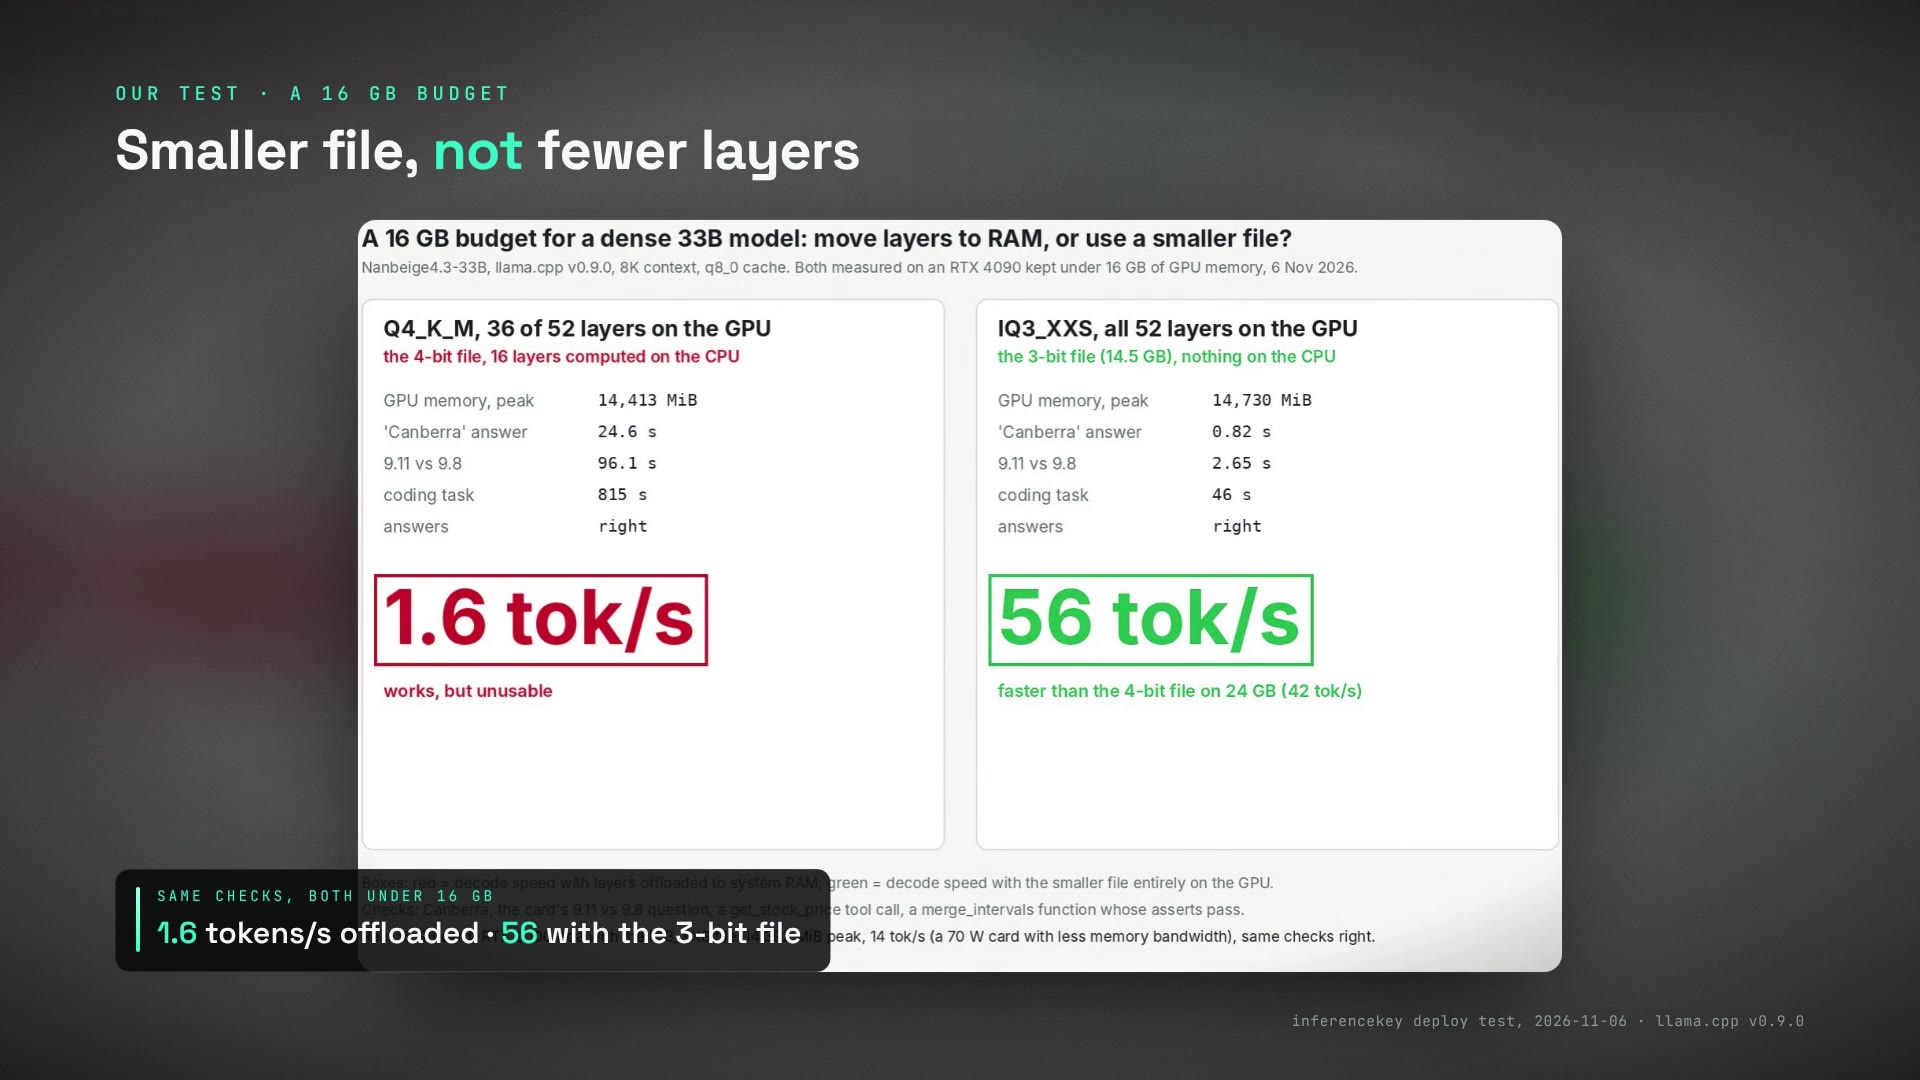
La démo commentée de 154 secondes : les benchmarks des auteurs (crédités à l'équipe Nanbeige), le déploiement dans le panneau sur la RTX 4090, la question de la page et le tour d'agent (avec la réponse vide racontée comme le point faible), les résultats en contexte long et l'échelle de mémoire.
Sources
- Nanbeige/Nanbeige4.3-33B (page du modèle, config, chat template).
- Nanbeige/Nanbeige4.3-33B-Base.
- bartowski/Nanbeige_Nanbeige4.3-33B-GGUF.
- axteam/Nanbeige4.3-33B-NVFP4A16.
- Vidéo d'actualités d'AI Search, 2026-11-01 (là où nous l'avons repéré).
- Exemple du SDK, commit
10209c3596fe1fd28dd63a30442eb543e6a456cc.