Nanbeige4.3-33B: ein dichtes 33B mit 42 Tokens/s auf 24 GB, 3 Bit für 16 GB
Ein dichtes 33B-Agentenmodell auf einer 24-GB-Karte: 42 Tokens/s, saubere Tool-Calls, 64K Kontext. Mit 3 Bit läuft es auf echten 16 GB mit 14 Tokens/s.
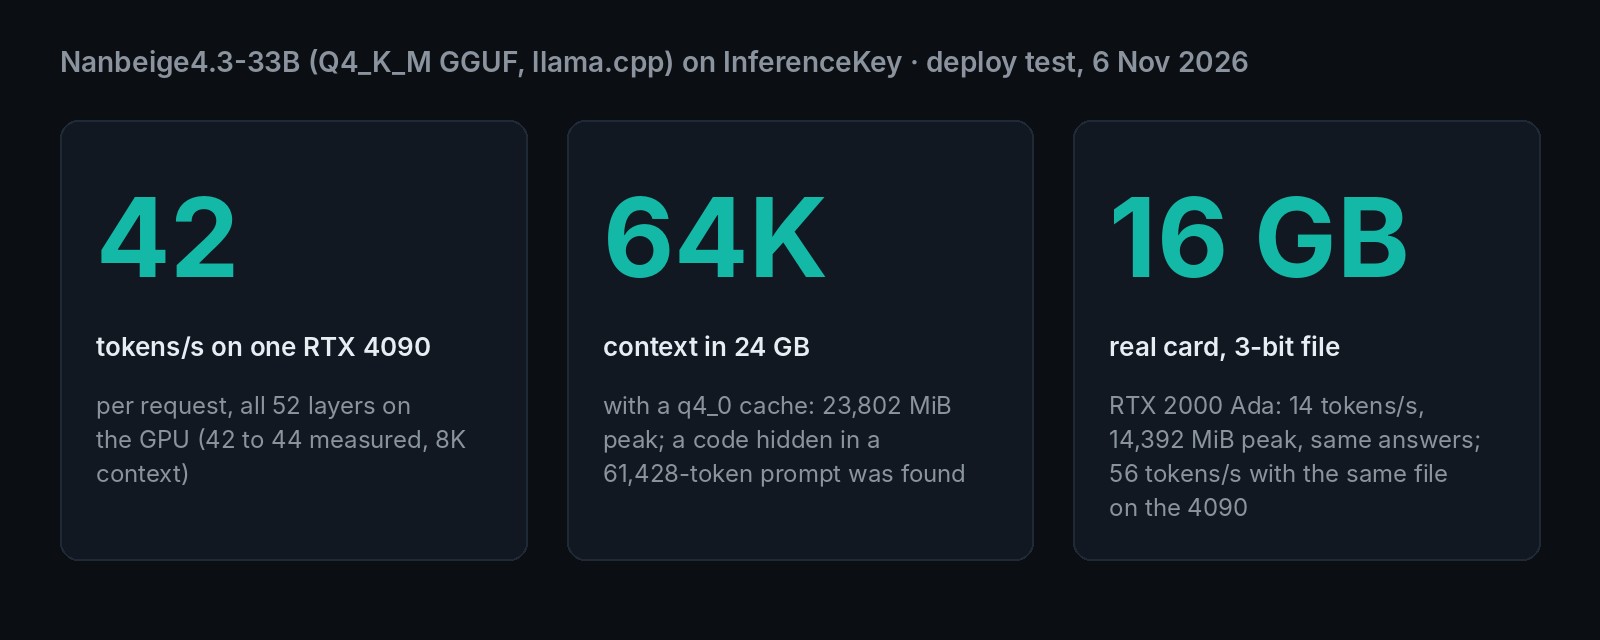
Welche Karte brauchst du für ein Coding-Modell mit 33 Milliarden Parametern, das bei jedem Wort alle davon einsetzt? Wir haben Nanbeige4.3-33B, ein Modell unter Apache-2.0, auf einer einzelnen RTX 4090 mit 24 GB laufen lassen, gemietet in unserer Cloud. Mit einer auf 4 Bit komprimierten Datei schrieb es etwa 42 Tokens pro Sekunde. Seine Tool-Calls kamen in all unseren Versuchen gültig zurück. Die 4090 fasste außerdem einen Prompt mit 64K Tokens, grob 50.000 Wörter. Eine echte Workstation-Karte mit 16 GB bestand unsere Prüfungen mit einer 3-Bit-Datei, bei etwa 14 Tokens pro Sekunde. Seine Autoren sehen es in zwei von drei Agenten-Coding-Tests vor Qwen3.8-27B. Der ganze Lauf steckt in einem SDK-Beispiel für deine eigene Karte. Ein ernstes Problem: Wenn das Modell vor der Antwort nachdenkt (die Voreinstellung), kam seine finale Agentenantwort in 2 von 3 Läufen leer zurück.
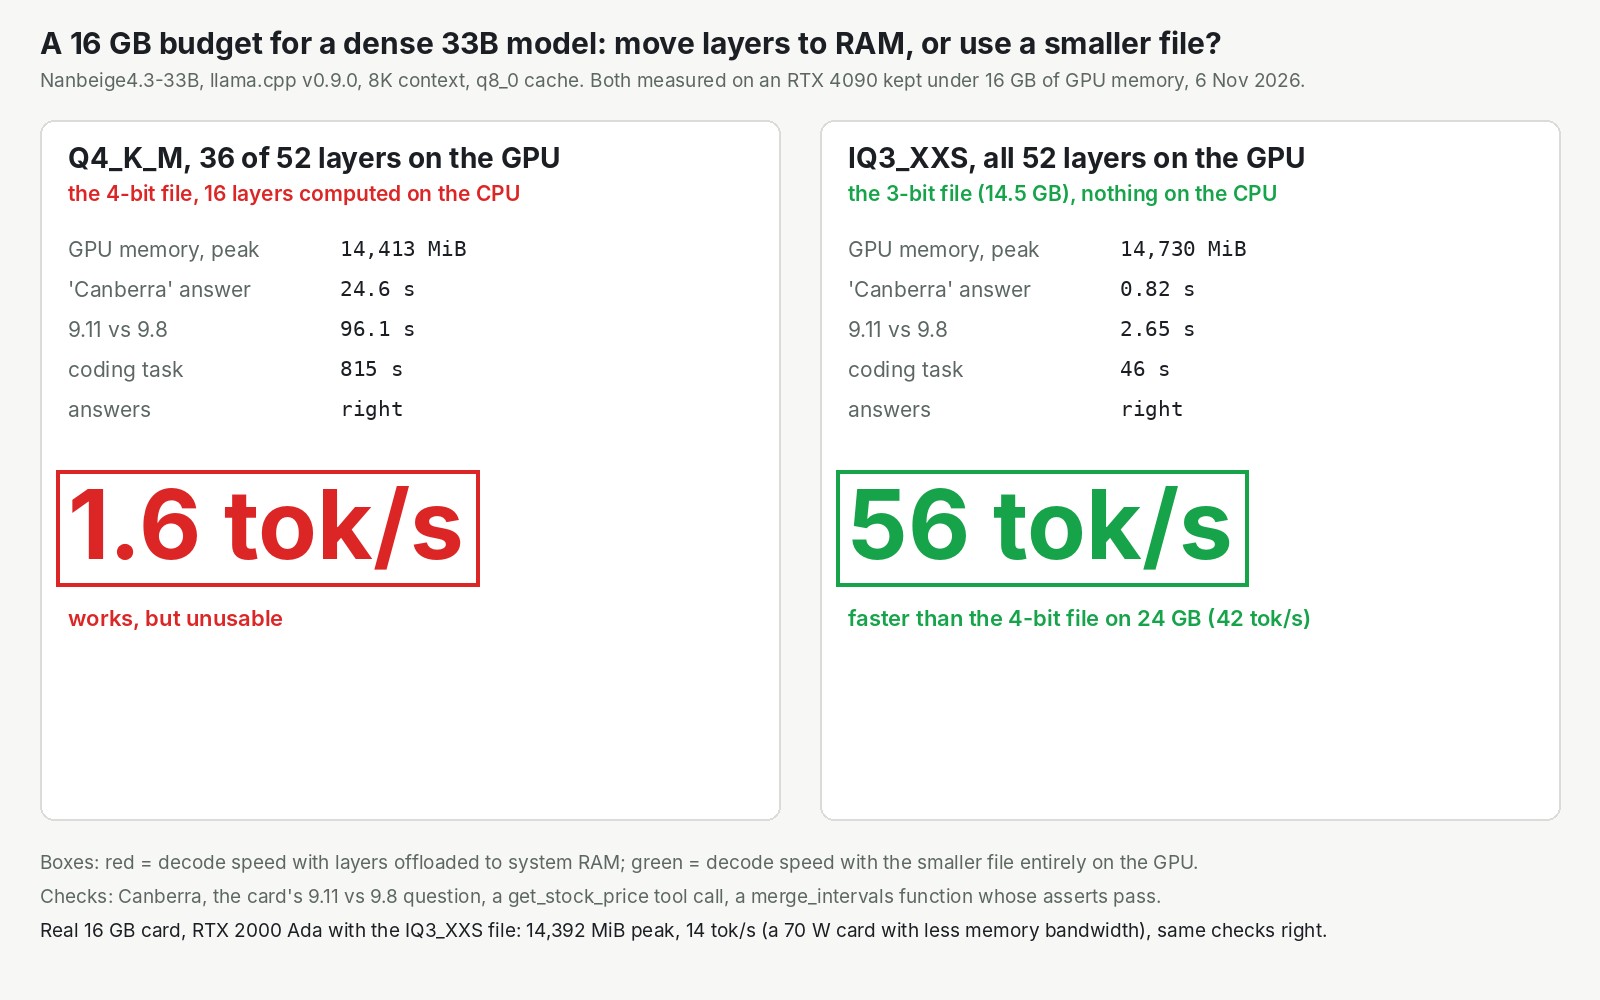
Dieses Bild ist die Entscheidung für alle mit weniger als 24 GB.
Ein dichtes 33B bezahlt bei jedem Wort für jeden Parameter
Um jedes Wort zu schreiben, muss die Karte die ganze Modelldatei aus ihrem eigenen Speicher lesen, und die Datei hat 20,8 GB. Dieses Lesen setzt die Obergrenze fürs Tempo. Eine kleinere Datei heißt weniger zu lesen und mehr Wörter pro Sekunde. Alles, was außerhalb des Kartenspeichers liegt, wird viel langsamer gelesen, und das Tempo bricht ein.
Das ist der Preis eines dichten Modells. Die Agentenmodelle, die wir davor getestet haben, etwa Groot-19B und Clover-35B-A3B, funktionieren anders. Stell dir eine Big Band vor, in der in jedem Takt nur ein paar Solisten spielen und der Rest Pause hat. Ein Modell mit 35 Milliarden Parametern in diesem Stil nutzt vielleicht nur 3 Milliarden pro Wort, also ist es schnell. Nanbeige4.3-33B ist dicht: Die ganze Band spielt jeden Takt. Alle 33 Milliarden Parameter arbeiten an jedem Token.
Das Modell erschien am 24. Oktober auf Hugging Face. Seine Autoren nennen es den „Lehrer“ der Reihe: Kleinere Modelle sollen später von ihm lernen. Sie beanspruchen „state-of-the-art agentic performance among open models in the ~30B parameter class“. Die Modellseite nennt Prompts mit bis zu 512K Tokens. Wir sind bis 64K gegangen. Es denkt standardmäßig nach, bevor es antwortet, und jeder kann es herunterladen, ohne zu fragen.
Die Autoren vergleichen es mit drei offenen Modellen ähnlicher Größe. Das sind ihre Zahlen, für jedes Modell gleich gemessen, mit maximalem Nachdenken. Wir haben sie nicht reproduziert.
| Test (Zahlen der Autoren) | Nanbeige4.3-33B | Qwen3.8-27B |
|---|---|---|
| Terminal-Bench 2.1, Agentenarbeit auf der Kommandozeile | 80,9 | 73,0 |
| DeepSWE, agentisches Software Engineering | 65,5 | 42,5 |
| SWE-Bench Pro, echte Issues in echtem Code beheben | 60,3 | 61,7 |
Die dritte Zeile ist eine Niederlage, und die Autoren drucken sie ab, zusammen mit zwei weiteren Niederlagen in anderen Tests. Claude, GPT und andere geschlossene Modelle stehen nicht in der Tabelle.
Die Größe ist der schwierige Teil. Unkomprimiert hat das Modell 66 GB. Die eigenen Serving-Rezepte der Autoren verteilen das Modell auf vier GPUs und sagen nichts darüber, wie es auf einer läuft. bartowski hat komprimierte Versionen als einzelne Dateien für llama.cpp veröffentlicht, ein freies Programm, mit dem man Modelle selbst betreibt. Diese Dateien haben schon 123.000 Downloads.
Unser Test: eine 4-Bit-Datei, eine 24-GB-Karte, unsere eigenen Prompts
Wir haben die von bartowski empfohlene 4-Bit-Datei (20,8 GB) verwendet. Sie lief auf einer RTX 4090, das ganze Modell auf der Karte, über unser unverändertes llama.cpp-Setup. Die meisten Tests liefen über dieselbe API im OpenAI-Stil, die ein Produkt aufrufen würde.
Unsere Prüfungen waren klein. Wir haben nach einer Antwort mit einem Wort gefragt, die Frage 9.11 oder 9.8 von der Modellseite gestellt und eine Coding-Aufgabe mit eigenen Tests gegeben. Außerdem haben wir zwei Tool-Calls probiert und ein geheimes Wort in langen Prompts versteckt. Ein Tool-Call heißt, dass das Modell deinen Code bittet, eine Funktion auszuführen: hier ein Aktienkurs und eine Wetterabfrage für zwei Städte gleichzeitig.
Die Grenzen: eine Anfrage nach der anderen, unsere eigenen Prompts statt der Benchmarks der Autoren, zwei echte Karten, nichts über 64K und nicht das eigene Server-Setup der Autoren mit vier GPUs. Wir haben einzelne Tool-Calls und einen Agentenschritt getestet, keinen Agenten, der sich durch eine Codebasis arbeitet. Die Tool-Calls hat llama.cpp geparst, nicht der Parser qwen3_coder, den die Modellseite für vLLM und SGLang empfiehlt. Dieser Weg ist ungetestet.
Etwa 42 Tokens pro Sekunde auf einer RTX 4090, mit gültigen Tool-Calls
Auf der 4090 schrieb das Modell 42 bis 44 Tokens pro Sekunde für eine Anfrage. Das erste Token kam bei kurzen Prompts nach einer Viertel- bis halben Sekunde zurück. Zum Lesen übersetzt: Ein langer Absatz steht in etwa vier Sekunden da.
| Was wir gefragt haben | Was zurückkam | Zeit |
|---|---|---|
| „Hauptstadt von Australien, ein Wort“ | Canberra, nach kurzem Nachdenken | etwa 1,2 s |
| „Welche Zahl ist größer, 9.11 oder 9.8?“ | 9.8, mit erklärter Dezimalstelle, in beiden Läufen | 3,6 bis 4,6 s |
| Eine Coding-Aufgabe mit eigenen Tests | Code, der läuft, Tests bestanden | 24,6 s |
| Ein Aktienkurs-Tool | get_stock_price({"symbol":"AAPL"}), gültig | etwa 2,2 s |
| „Ist es in Lissabon oder in Oslo wärmer?“ | Zwei Wetter-Calls gleichzeitig, beide gültig | 2,8 bis 3,0 s |
| Dasselbe, nachdem die Tool-Ergebnisse zurückkamen | „Lisbon is warmer ... 19°C ... 4°C“ (siehe unten) | 3,1 s |
Jeder Tool-Call kam im Standardformat von OpenAI zurück, auf der 4090 in beiden Versuchen pro Call gültig.
Für einen Entwickler, der einen Agenten steuert, ist dieses Tempo angenehm.
64K Kontext passen in 24 GB, und das Schreiben wird langsamer, je voller es wird
Die 4090 fasste einen Prompt mit 64K Tokens und fand ein geheimes Wort, versteckt bei Token 61.428. Damit das passte, musste das, was sie sich vom Prompt merkt, auf ein Viertel seiner Größe gequetscht werden, und das Schreiben fiel auf 16 Tokens pro Sekunde.
Neben dem Modell führt die Karte Notizen über alles, was das Modell bisher gelesen hat, und sie wachsen mit jedem Token. Notizen in voller Größe enden bei 16K. Halbiert reichen sie bis 32K, geviertelt bis 64K, mit weniger als 1 GB frei auf der Karte.
| Kontext | Notizen komprimiert auf | Spitzenspeicher (MiB) | Geheimes Wort gefunden bei | Antwort dauerte | Schreibtempo in dieser Tiefe |
|---|---|---|---|---|---|
| 16K | nein (16 Bit) | 23.186 | 14.909 Tokens | 7,9 s | 37 Tokens/s |
| 32K | 8 Bit | 23.434 | 30.734 Tokens | 18,8 s | 25 Tokens/s |
| 64K | 4 Bit | 23.802 | 61.428 Tokens | 49,1 s | 16 Tokens/s |
Alle drei fanden das Wort. Bei 64K läuft das Schreiben mit weniger als dem halben Tempo kurzer Prompts, weil jedes neue Wort auch 61.000 Tokens an Notizen liest.
Welche GPU: Eine echte 16-GB-Karte funktioniert mit der 3-Bit-Datei, mit etwa 14 Tokens pro Sekunde
Die kleinste Karte, die bestanden hat, ist eine echte: eine RTX 2000 Ada, eine Workstation-Karte mit 16 GB und 70 Watt, mit der 3-Bit-Datei von bartowski. Sie bestand dieselben Prüfungen mit etwa einem Drittel des Tempos der 4090, eine Antwort mit 400 Tokens dauert also etwa 30 Sekunden statt 10.
| Karte oder Speicherbudget | Datei und Setup | Spitzenspeicher (MiB) | Tempo | Prüfungen | Echte Karte? |
|---|---|---|---|---|---|
| RTX 2000 Ada 16 GB | 3 Bit, 8K, Notizen mit 8 Bit | 14.392 | 13,6 bis 14,4 Tokens/s | alle richtig | ja |
| Budget 16 GB | 3 Bit, alles auf der Karte | 14.730 | 56,5 Tokens/s | alle richtig | nein, auf der 4090 gelaufen |
| Budget 16 GB | 4 Bit, ein Drittel außerhalb der Karte | 14.413 | 1,6 Tokens/s | richtig, unbrauchbar | nein, auf der 4090 gelaufen |
| Budget 12 GB | 2 Bit, 8K | 10.670 | 74,9 Tokens/s | eine falsche Erklärung | nein, auf der 4090 gelaufen |
Lies die Zeilen mit „nein“ als Speichermessungen, nicht als Tempoversprechen. Jede lief auf der vollen 4090 mit 24 GB, ohne Speichergrenze, und blieb in der Spitze unter dem Budget. Dort lief die 3-Bit-Datei mit 56,5 Tokens pro Sekunde, weil es weniger zu lesen gibt. Die echte 16-GB-Karte schaffte 14, weil sie ihren Speicher viel langsamer liest.
Die 2-Bit-Datei, die auf der 4090 unter 12 GB blieb, hatte die Zahlen richtig, sagte aber, die 8 in 9.8 stehe „in the hundredths place“. Sie steht an der Zehntelstelle. Ein Ausrutscher in vier Prüfungen reicht, um 2 Bit von Code fernzuhalten.
Das Problem, auf das du stoßen wirst: Antworten landen im Denkkanal und kommen leer zurück
Mit eingeschaltetem Nachdenken, der Voreinstellung, kommen manche Antworten mit leerer Antwort an. Die ganze Antwort steckt stattdessen im Denkfeld des Modells. Status: offen.
Es passierte bei jedem Essay mit 400 Wörtern, den wir angefordert haben, drei von drei. Es traf auch die kurze finale Antwort des Agenten nach den Wetterergebnissen in zwei von drei Läufen, einmal auf jeder Karte. Kurze Einzelantworten und die Tool-Calls selbst waren nie betroffen.
Die Prompt-Vorlage des Modells öffnet einen Denkblock, das Modell antwortet manchmal, ohne ihn zu schließen, und llama.cpp legt die ganze Antwort als Nachdenken ab. Als wir die Anfrage direkt an llama.cpp geschickt und das Nachdenken abgeschaltet haben, kam der Essay in der normalen Antwort an, alle 3.151 Zeichen.
Über InferenceKey kommt dieser Schalter pro Anfrage noch nicht durch: Unser Endpoint verwirft ihn. Diese Lücke liegt auf unserer Seite und ist noch offen. Bis sie behoben ist, sollte eine Server-Einstellung im Startbefehl (im Anhang) das Nachdenken für jede Anfrage abschalten. Wir haben sie nicht ausgeführt, ihre Wirkung auf die finale Agentenantwort ist also ungetestet. Die Autoren haben ihre Ergebnisse mit maximalem Nachdenken gemessen und empfehlen, es für Agenten beizubehalten. Das SDK-Beispiel markiert außerdem eine leere Antwort und zeigt den Text aus dem Denkfeld.
Eine kleinere Sache: Wenn du dem Modell keine festen Anweisungen gibst, fügt seine Vorlage eigene hinzu, auf Chinesisch. Sie besagen, das Modell sei Nanbeige, entwickelt von BOSS Zhipin. In unseren Tests haben sie nicht geschadet, aber schick deine eigenen.
Auf InferenceKey: bereit in fünf Minuten, fast alles davon Kompilieren
Die Karte gehört dir stundenweise, und unser Standard-Setup mit llama.cpp hat dieses Modell ohne Änderungen an der Plattform betrieben. Wir haben eine Versionsnummer gesetzt und einen Startbefehl geschrieben.
Auf InferenceKey ist ein Worker das kleine Programm auf deiner GPU-Maschine, das Aufträge von der Plattform annimmt. Unserer baut llama.cpp für genau diese GPU, wenn er zum ersten Mal danach gefragt wird. Auf der 4090 war das Deployment 303,7 Sekunden nach unserer Anfrage bereit. Fast alles davon war dieser Build, etwa fünf Minuten. Die Datei mit 20,8 GB war parallel in 15 Sekunden geladen worden, und das Laden ins Modell dauerte etwa 4. Nach dem Build war llama.cpp mit der zwischengespeicherten Datei bei einem Neustart in 3 bis 5 Sekunden bereit.
Auf der Maschine mit der RTX 2000 Ada dauerte derselbe Build 19 Minuten 50 Sekunden, weil die Prozessoren dieses Hosts gedrosselt waren. Bereit war sie nach etwa 20 Minuten. Plane auf einem kleinen Host einen langsamen ersten Start ein: Ein fertig gebautes llama.cpp für NVIDIA fehlt auf unserer Seite noch.
Dieser Lauf nutzte unsere eigene lokale Kopie der InferenceKey-Plattform, mit demselben Code wie der gehostete Dienst. Das SDK-Beispiel schickt das Modell auf eine Maschine, die du benennst, die Gewichte und die Inferenz bleiben also auf deiner Hardware.
Solltest du es nutzen? Auf 24 GB einen Versuch wert, wenn du vorerst mit leeren Agentenantworten leben kannst
- Du hast eine 24-GB-Karte und willst ein offenes Agentenmodell zum Coden: einen Versuch wert. Prüf die Ergebnisse der Autoren an deinen eigenen Aufgaben.
- Du brauchst lange Prompts: bis 64K auf einer 24-GB-Karte, langsamer, je voller es wird.
- Du hast eine 16-GB-Karte: Nimm die 3-Bit-Datei komplett auf der Karte, nie die 4-Bit-Datei mit einem Drittel außerhalb. Das Tempo hängt vom Speicher deiner Karte ab.
- Du setzt es heute als Agent ein: Rechne mit leeren finalen Antworten bei eingeschaltetem Nachdenken. Das Nachdenken auf dem Server abzuschalten sollte das beheben.
Um dieselben Tests auf deinem eigenen NVIDIA-Worker mit 24 GB laufen zu lassen, führe python main.py aus dem SDK-Beispiel zu Nanbeige4.3-33B aus. Es braucht ein Projekt, einen SDK-Token und einen API-Key und löscht das Deployment, wenn es fertig ist.
Für Ingenieure
Credits
- Das Nanbeige-Team (BOSS Zhipin): das Modell, das Basismodell, die Model Cards, die Benchmark-Tabelle und die Chat-Vorlage mit XML-Tool-Calls im Stil von Qwen3-Coder. Veröffentlicht am 2026-10-24 unter Apache-2.0.
- bartowski: die imatrix-GGUF-Quants (llama.cpp b11845), die wir verwendet haben: Q4_K_M, IQ3_XXS und IQ2_XXS.
- axteam: ein NVFP4A16-Build für vLLM (von uns nicht getestet).
- Die Maintainer von llama.cpp: der Server, die Vorlagenunterstützung über
--jinja, die die XML-Tool-Calls geparst hat, und das Release v0.9.0. - AI Search: wo wir das Modell entdeckt haben (News-Video vom 2026-11-01, Kapitel bei 43:03), mit dem Hinweis auf die Größe von 66,3 GB und „quite some high-end hardware“.
- Unser Teil: das Deployment über die Plattform, die Tests und Prompts, die Speicherleiter auf zwei echten Karten plus drei Läufe auf der 4090, zugeschnitten auf Budgets von 16 und 12 GB, die Diagnose des Problems mit den leeren Antworten, das SDK-Beispiel und das Demovideo.
Modell und Dateien
Nanbeige/Nanbeige4.3-33B: shadf919e1e, zuletzt geändert am 2026-10-28, 33.118.977.024 BF16-Parameter, etwa 66,3 GB in 14 Shards, 19.178 Downloads und 1.052 Likes am 2026-11-06. BasismodellNanbeige4.3-33B-Base: shae061adde.- Architektur: dichtes
LlamaForCausalLM, 52 Schichten, 56 Attention-Heads, 8 KV-Heads, head_dim 128, hidden 7168, FFN 22016, Vokabular 166.912,max_position_embeddings524.288,rope_theta1.2e8. bartowski/Nanbeige_Nanbeige4.3-33B-GGUF: sha9beb6842, erstellt am 2026-10-25, 123.000 Downloads. Q4_K_M 20,79 GB, Q4_K_S 19,74 GB, IQ4_XS 18,64 GB, IQ3_XXS 14,49 GB, IQ2_XXS 10,07 GB, Q5_K_M 25,07 GB, Q8_0 35,20 GB, bf16 66,24 GB. Verwendetes Q4_K_M: 20.788.825.216 B, sha2562cef7985..., passend zum LFS-Hash auf Hugging Face.axteam/Nanbeige4.3-33B-NVFP4A16: W4A16 FP4 für vLLM, etwa 22,1 GB, von seinem Autor nur auf vLLM 0.32.0 auf B200 getestet, sein eigener lm-eval-Durchschnitt liegt bei 98,9 % von BF16. Von uns nicht getestet.- KV-Cache in f16: 52 x 8 x 128 x 2 x 2 B = 208 KiB pro Token (8K sind 1,6 GiB, 32K sind 6,5 GiB).
q8_0etwa die Hälfte,q4_0etwa ein Viertel. - Grobe Größenabschätzung aus den Notizen des Quellvideos (eine Schätzung, nicht gemessen): etwa 80 GB für BF16-Serving, etwa 40 GB mit 8 Bit, etwa 20 GB mit 4 Bit.
Angaben der Autoren (nicht reproduziert)
Nanbeige4.3-33B / Qwen3.8-27B / Muse-Glimmer-30B / Gemma4-31B, höchster Denkaufwand, dasselbe Harness, preserve_thinking=true:
| Benchmark | Nanbeige4.3-33B | Qwen3.8-27B | Muse-Glimmer-30B | Gemma4-31B |
|---|---|---|---|---|
| Terminal-Bench 2.1 (Terminus 2) | 80,9 | 73,0 | 61,8 | 47,2 |
| Terminal-Bench 4.0 | 23,8 | 6,3 | 1,6 | 0,0 |
| DeepSWE | 65,5 | 42,5 | 4,4 | 2,7 |
| SWE-Bench Pro | 60,3 | 61,7 | 51,2 | 36,9 |
| JobBench | 44,8 | 34,5 | 16,6 | 9,0 |
| GDPval | 84,8 | 86,4 | 75,8 | 71,4 |
| GPQA Diamond | 89,5 | 89,2 | 83,5 | 91,3 |
| AIME 2026 | 95,2 | 94,5 | 94,7 | 89,2 |
| AA-LCR | 84,0 | 82,0 | 83,3 | 72,0 |
Außerdem Nanbeige gegen Qwen: SWE-Atlas-QnA 50,8 zu 41,9, NL2Repo 53,0 zu 48,3, SkillsBench 61,1 zu 56,4, Automation Bench 54,2 zu 38,3, Toolathlon-Verified 70,4 zu 68,5, Tau3-Bench 48,8 zu 48,5. Basismodell gegen Gemma4-31B-Base: MMLU-Pro 66,9 zu 59,3, GPQA 62,0 zu 41,5, SuperGPQA 45,6 zu 33,8, GSM8K 92,9 zu 88,9, Math 57,3 zu 43,6, MBPP 74,6 zu 72,5, MMLU 85,5 zu 84,2, CMMLU 86,8 zu 76,9.
Eine Unstimmigkeit in der Card: JobBench für Muse-Glimmer-30B steht in der Tabelle und in der Heatmap nach Berufen bei 16,6, in der Balkengrafik bei 18,3. Die Autoren vergleichen nur mit offenen Modellen um 30B; Bestenlisten Dritter zu Terminal-Bench 2.1 nutzen andere Harnesses, also ziehen wir keinen Vergleich mit den Spitzenmodellen.
Hinweise zur Nutzung aus der Card: Nachdenken standardmäßig an (enable_thinking); preserve_thinking empfohlen für Tool-Nutzung über mehrere Runden; Tool-Format xml (Standard) oder json; Sampling 1,0 / 0,95 (bis zu 65.536 neue Tokens) für Agenten und Tool-Nutzung, 0,6 / 0,95 (bis zu 262.144) für Reasoning und Chat. Rezepte für SGLang und vLLM: Tensor Parallel 4, --reasoning-parser qwen3 --tool-call-parser qwen3_coder (vLLM außerdem --enable-auto-tool-choice, --gpu-memory-utilization 0.8).
Setup
- GPUs auf InferenceKey Cloud: RTX 4090 24 GB (450 W, Compute Capability 8.9) für den Hauptlauf; RTX 2000 Ada 16 GB (70 W) für die echte 16-GB-Stufe.
- Backend: das eingebaute Backend
llamacpp,INFERENCEKEY_LLAMACPP_TAG=v0.9.0(das GGUF wurde mit b11845 erstellt, der Standard des Workers ist älter). Llama-Architektur, also lädt es jeder aktuelle Tag; v0.9.0 ist neuer als der Build des Quantisierers. - Warum llama.cpp und nicht vLLM: Die Rezepte der Card setzen vier GPUs mit BF16 voraus, und der GGUF-Weg ist der, der in 24 GB passt. Der Parser
qwen3_coderwurde nicht getestet; llama.cpp--jinjahat die XML-Tool-Calls in OpenAI-tool_callsgeparst. - Routing: Die kurzen Tests, das SDK-Beispiel und die Prüfungen auf der RTX 2000 Ada liefen über den Endpoint im OpenAI-Stil; die Stufen für langen Kontext und für die Budgets gingen direkt an llama-server auf dem Pod.
- Ein lokaler InferenceKey-Manager (derselbe Code wie der gehostete Dienst) mit zwei Workern. Die Produktion wurde nie angefasst.
- Sampling: die Werte der Card, 0,6 / 0,95 für Chat und 1,0 / 0,95 für Tools. Stufen der Leiter mit Seed 42.
Schritt für Schritt mit dem SDK-Beispiel
- Klone inferencekey-sdk und öffne
examples/nanbeige43-33b-agent-llamacpp-private-nvidia(Commit10209c3596fe1fd28dd63a30442eb543e6a456cc). cp .env.example .envund trageINFERENCEKEY_SDK_TOKEN,INFERENCEKEY_API_KEY,INFERENCEKEY_PROJECTundIK_WORKER_IDein (ein privater NVIDIA-Worker mit 24 GB). Optional:NANBEIGE_CONTEXT(Standard 8192),NANBEIGE_KV_TYPE(Standardf16),NANBEIGE_GGUF_FILE,IK_KEEP_ALIVE=1.pip install -r requirements.txtplus den lokalen SDK-Build mit maturin (sieheexamples/CONTRIBUTING.mdim SDK-Repo).- Wenn das Image des Workers
nvccaußerhalb vonPATHhat (die PyTorch-Images mit CUDA 13), setz das in der Umgebung des Workers und starte ihn neu:
CUDACXX=/usr/local/cuda/bin/nvcc
PATH=/usr/local/cuda/bin:$PATH
CMAKE_BUILD_PARALLEL_LEVEL=<number of CPU cores>
python main.py. Es machtensure()für einen festen Workloadllamacpp(task_typetext2text,ExecutionPolicy.FIXED), gepinnt auf deinen Worker, wartet bis zu 3.600 s, stellt die Frage der Card mitgenerate_text(), macht den Callget_stock_price, führt den Agentenschritt mit den zwei Wetter-Calls aus, schreibtoutputs/answers.jsonund ruftdelete()auf, außer beiIK_KEEP_ALIVE=1.
Der Startbefehl, den das Backend ausführt:
INFERENCEKEY_LLAMACPP_TAG=v0.9.0 llama-server \
  -hf bartowski/Nanbeige_Nanbeige4.3-33B-GGUF \
  --hf-file Nanbeige_Nanbeige4.3-33B-Q4_K_M.gguf \
  --alias nanbeige4.3-33b -ngl 99 -fa on \
  -c 8192 -ctk f16 -ctv f16 \
  --jinja --reasoning-format deepseek
Für 32K -c 32768 -ctk q8_0 -ctv q8_0; für 64K -c 65536 -ctk q4_0 -ctv q4_0. Für eine 16-GB-Karte NANBEIGE_GGUF_FILE=Nanbeige_Nanbeige4.3-33B-IQ3_XXS.gguf und NANBEIGE_KV_TYPE=q8_0 setzen. Sollte leere Antworten vermeiden: --chat-template-kwargs '{"enable_thinking":false}' anhängen (Nachdenken für jede Anfrage aus). Ungetestet: Wir haben diese Option nie gestartet, und der finale Agentenschritt wurde mit abgeschaltetem Nachdenken nie wiederholt; die Agentenqualität ohne Nachdenken ist nicht gemessen.
Zeiten
| Schritt | RTX 4090 | RTX 2000 Ada |
|---|---|---|
ensure() bis bereit, frischer Worker | 303,7 s | 1.203,6 s |
| CUDA-Build von llama.cpp v0.9.0 | etwa 5 min (32 parallele Jobs) | 19 min 50 s (Host mit gedrosselter CPU, 48 vCPU sichtbar, Last etwa 7) |
| GGUF-Download (parallel vorab geladen, nicht auf dem Weg zu bereit) | 15 s (Q4_K_M) | 20 s (IQ3_XXS) |
| Laden des Modells | etwa 4 s | |
| Neustart von llama-server auf dem Pod (Binary gebaut, Datei zwischengespeichert; kein Deployment der Plattform) | 2,7 bis 4,5 s |
Tempo und Ausgaben (RTX 4090, Q4_K_M, 8K, f16-Cache, Streaming über den Endpoint)
| Test | Completion-Tokens | Sekunden | Erstes Token s | Decode Tokens/s | Ergebnis |
|---|---|---|---|---|---|
| Hauptstadt von Australien x2 | 40 / 40 | 1,19 / 1,27 | 0,28 / 0,37 | 43,7 / 44,4 | Canberra |
| 9.11 oder 9.8 | 183 | 4,55 | 0,28 | 42,9 | richtig, Dezimalstelle erklärt |
merge_intervals + 3 Asserts | 1.026 | 24,62 | 0,43 | 42,4 | Asserts bestanden |
| Essay mit 400 Wörtern x3 | 641 / 552 / 591 | 15,4 / 13,2 / 14,2 | 0,26 bis 0,37 | 42,6 | content leer, alles in reasoning_content |
get_stock_price | 72 | 2,17 | 0,50 | 43,2 | {"symbol":"AAPL"}, finish tool_calls |
| Lissabon oder Oslo | 101 | 2,82 | 0,47 | 43,0 | zwei parallele Calls get_weather |
| Nadel, Prompt mit 6.142 Tokens | 81 | 4,65 | 2,65 | 40,4 | gefunden |
chat_template_kwargs enable_thinking=false über den Endpoint | 40 | 2,16 | 1,24 | 43,5 | vom Gateway verworfen, denkt weiter nach |
Lauf des SDK-Beispiels auf der 4090: Frage der Card 3,6 s; Aktien-Call 2,27 s; Agentenschritt 1 (zwei Calls) 2,97 s; Schritt 2 3,12 s mit 44,3 Tokens/s, richtige Antwort. Leistungsspitze 448,6 W.
Langer Kontext auf der 4090: Prefill 2.514 / 2.038 / 1.544 Tokens/s bei 14.909 / 30.734 / 61.428 Tokens; kurze Antworten etwa 41 bis 42 Tokens/s in allen drei Konfigurationen.
RTX 2000 Ada über den Endpoint: Canberra 2,9 bis 3,1 s, Frage der Card 8,65 s (14,0 s im Lauf des Beispiels) richtig, Aktien-Call 4,64 bis 5,26 s, zwei parallele Wetter-Calls 8,09 bis 8,23 s, merge_intervals 1.398 Tokens in 102,7 s mit bestandenen Asserts, finale Agentenantwort leer (Problem 1). Leistungsspitze 69,8 W, an ihrer Grenze von 70 W.
VRAM-Leiter
Spitzen-VRAM aus nvidia-smi. Die emulierten Stufen liefen auf der vollen 4090 mit 24 GB ohne gesetzte Speichergrenze; die Konfiguration blieb in der Spitze unter dem Budget. Prüfungen: Canberra, 9.11 gegen 9.8, der Call get_stock_price und merge_intervals mit seinen eigenen Asserts.
| GPU oder Budget | Konfiguration | Spitzen-VRAM | Tempo | Ausgabe OK | Echt oder emuliert |
|---|---|---|---|---|---|
| RTX 4090 24 GB | Q4_K_M, 8K, f16 (das Beispiel, über den Endpoint) | 21.907 MiB | 42 bis 44 Tokens/s; Canberra 1,2 s | ja | echt |
| RTX 4090 24 GB | Q4_K_M, 16K, f16 | 23.186 MiB | 42,1; Nadel bei 14.909 Tokens 7,9 s, 37,3 in der Tiefe | ja | echt |
| RTX 4090 24 GB | Q4_K_M, 32K, q8_0 | 23.434 MiB | 41,3; Nadel bei 30.734 Tokens 18,8 s, 24,6 in der Tiefe | ja | echt |
| RTX 4090 24 GB | Q4_K_M, 64K, q4_0 | 23.802 MiB | 41,2; Nadel bei 61.428 Tokens 49,1 s, 16,4 in der Tiefe | ja | echt |
| Budget 16 GB | IQ3_XXS, 8K, q8_0, alles auf der GPU | 14.730 MiB | 56,5; Canberra 0,82 s, Card 2,65 s, Code 2.537 Tokens 46,0 s | ja | emuliert auf der 4090 |
| Budget 16 GB | Q4_K_M, -ngl 36 (16 von 52 Schichten auf der CPU), 8K, q8_0 | 14.413 MiB | 1,6; Canberra 24,6 s, Card 96,1 s, Code 815 s | ja, unbrauchbar | emuliert auf der 4090 |
| Budget 12 GB | IQ2_XXS, 8K, q8_0 | 10.670 MiB | 74,9; Code 1.395 Tokens 18,7 s | Antworten richtig, eine Erklärung falsch | emuliert auf der 4090 |
| RTX 2000 Ada 16 GB | IQ3_XXS, 8K, q8_0, über den Endpoint | 14.392 MiB | 13,6 bis 14,4 | ja; finale Agentenantwort leer | echt |
Die kleinste, die bestanden hat: die echte RTX 2000 Ada 16 GB mit IQ3_XXS, etwa ein Drittel des Tempos der 4090. Das README des Beispiels nennt 21.508 MiB für seine Konfiguration (eine Referenzstufe); 21.907 MiB ist die Spitze während der Haupttests, einschließlich der aufgezeichneten Aufnahme.
Nicht probiert: ein mehrstufiger Coding-Agent auf einem echten Repository (nur einzelne Tool-Calls und ein Agentenschritt); der gehostete Endpoint (nur ein lokaler Manager); parallele Anfragen; 128K oder mehr auf 24 GB; eine andere 24-GB-Karte (A5000, RTX 3090); eine echte 12-GB-Karte; ein Budget von 8 GB; NVFP4A16 auf vLLM; vLLM oder SGLang mit dem Parser qwen3_coder; die Qualität des q4_0-Cache über den Nadeltest hinaus; die Benchmarks der Autoren.
Offene Probleme
- Antworten im Denkkanal. Mit eingeschaltetem Nachdenken beendet die Vorlage den Prompt mit
<|im_start|>assistant\n<think>\n. Bei manchen Antworten schreibt das Modell direkt die Antwort und gibt nie</think>aus;--reasoning-format deepseekliefert dann alles alsreasoning_contentmitcontent= "". Gesehen beim Essay (3 von 3) und beim finalen Agentenschritt (2 von 3 Läufen: die aufgezeichnete Aufnahme auf der 4090 und der Lauf auf der RTX 2000 Ada; der erste Lauf des Beispiels hatte Content). Mitenable_thinking=falsefügt die Vorlage<think>\n\n</think>\n\nein, und der Essay kam incontentzurück (3.151 Zeichen). Vorgeschlagener Workaround über InferenceKey, nicht ausgeführt:--chat-template-kwargs '{"enable_thinking":false}'.main.pymarkiert leere Antworten mitanswer_text(). Nicht getestet: andere Reasoning-Formate,--reasoning-budget. Offen. - Der Endpoint verwirft
chat_template_kwargspro Anfrage, das Nachdenken lässt sich über InferenceKey also nicht pro Anfrage abschalten. Bekannte Lücke auf unserer Seite, offen. - Teilweises Auslagern ist kein Weg, ein dichtes Modell in 16 GB zu bringen: 1,6 Tokens/s mit 16 von 52 Schichten auf der CPU. Nimm den kleineren Quant komplett auf der GPU.
- Langsamer erster Start: Der Worker baut llama.cpp auf NVIDIA aus dem Quellcode (5 min auf dem Host der 4090, 19 min 50 s auf einem gedrosselten Host). Noch kein vorgebautes CUDA-Binary. Offen.
- Der Build des Workers braucht
nvccinPATHauf manchen Images; Workaround im Schritt für Schritt oben. Im Worker offen. - Chinesischer Standard-Systemprompt: Ohne Systemnachricht fügt die Vorlage „你是南北阁,一款由BOSS直聘自主研发并训练的专业大语言模型。“ ein („Du bist Nanbeige, ein professionelles LLM, entwickelt und trainiert von BOSS Zhipin“); mit Tools und ohne Systemnachricht einen anderen chinesischen Prompt für Tool-Experten. Schick deinen eigenen.
- Model Card: die JobBench-Unstimmigkeit oben und keine Hinweise zu einer einzelnen GPU oder zu GGUF.
- Qualität mit 2 Bit: IQ2_XXS erklärte 9.8 als „8 in the hundredths place“.
Demovideo
Die vertonte Demo mit 154 Sekunden: die Benchmarks der Autoren (dem Nanbeige-Team zugeschrieben), das Deployment im Panel auf der RTX 4090, die Frage der Card und der Agentenschritt (mit der leeren Antwort, als Haken erzählt), die Ergebnisse mit langem Kontext und die Speicherleiter.
Quellen
- Nanbeige/Nanbeige4.3-33B (Model Card, Config, Chat-Vorlage).
- Nanbeige/Nanbeige4.3-33B-Base.
- bartowski/Nanbeige_Nanbeige4.3-33B-GGUF.
- axteam/Nanbeige4.3-33B-NVFP4A16.
- News-Video von AI Search, 2026-11-01 (wo wir es entdeckt haben).
- SDK-Beispiel, Commit
10209c3596fe1fd28dd63a30442eb543e6a456cc.