Clover-35B-A3B auf einer RTX 4090: 208 Tokens/s, aber nicht als Diffusionsmodell
DiffuSpaces Diffusions-LLM auf einer RTX 4090 mit llama.cpp v0.9.0: 208 Tokens/s und das volle 128K-Fenster, aber nur Token für Token.
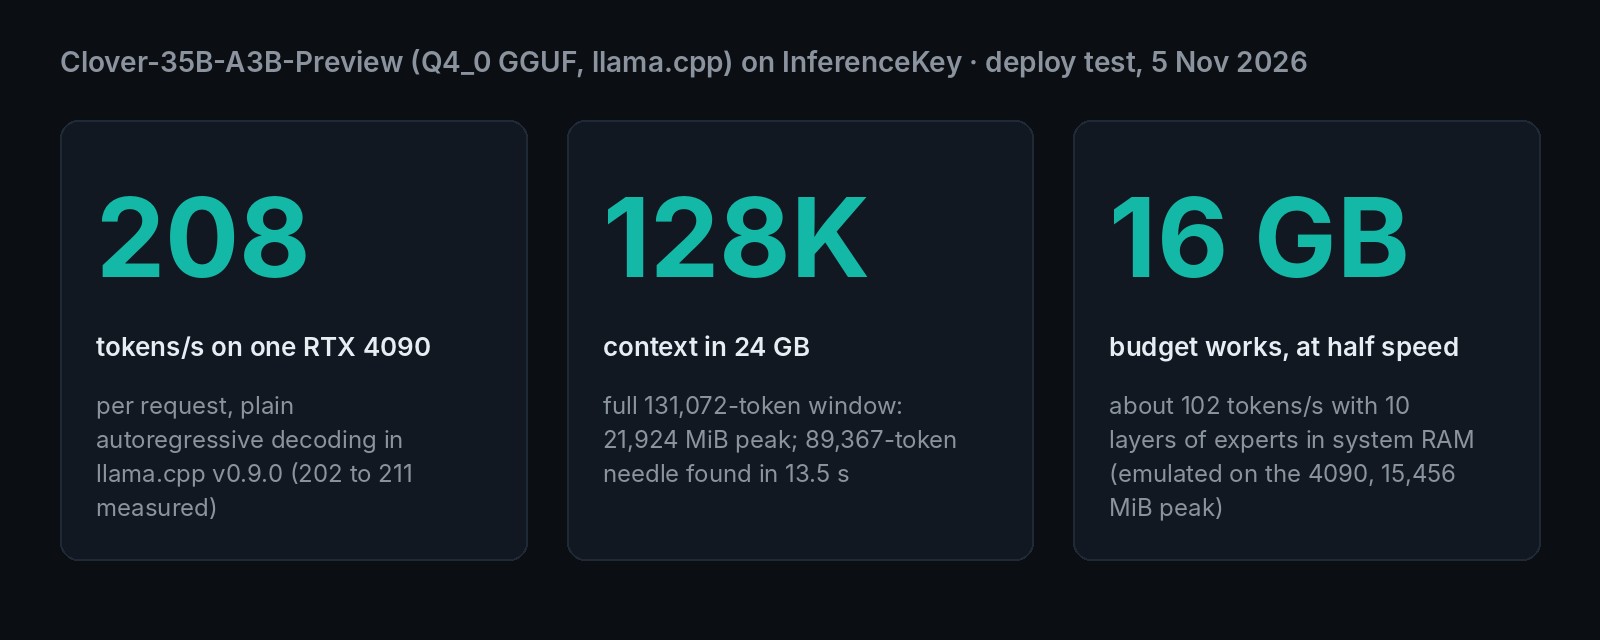
„Add support for DiffuSpace's Clover-35B-A3B-Preview, in AR mode only.“ Diese Zeile wurde diese Woche in llama.cpp gemergt, das verbreitete freie Programm, mit dem man Modelle selbst betreibt. Diese Einschränkung bestimmt dein Tempo. AR heißt schlichtes Schreiben, ein Token nach dem anderen. Clover ist ein offenes Diffusions-Sprachmodell, gebaut, um Textblöcke parallel zu schreiben, nicht Wort für Wort. Wir haben die offizielle komprimierte Datei mit dem unveränderten llama.cpp auf eine einzige RTX 4090 gebracht. Nach einer Korrektur der Datei, die 17 Sekunden dauerte, schrieb es etwa 208 Tokens (Wortteile) pro Sekunde, eine Seite Text in etwa drei Sekunden. Es las auch Prompts mit bis zu 128K Tokens (ein kurzer Roman) und belegte dabei 21,4 der 24 GB der Karte. Die 515 und 680 Tokens pro Sekunde der Autoren stammen von größeren Karten und dem vollen Modell, und der Parallel-Trick steckt nicht in diesem Code. Clover ist heute einen Versuch auf einer einzelnen 24-GB-Karte wert. Kauf noch keine Hardware wegen des Diffusionstempos.
Ein Modell, das Textblöcke ausfüllt, statt Wort für Wort zu tippen
Clovers Versprechen ist Tempo, und das kommt von der Art, wie es schreibt. Ein gewöhnliches Sprachmodell arbeitet wie eine Schreibkraft. Es erzeugt ein Token, dann das nächste, und jedes wartet auf das vorherige. Clover wurde darauf trainiert, eher wie jemand zu arbeiten, der ein Kreuzworträtsel löst. Es legt einen Block aus 32 leeren Feldern an. In jedem Durchgang füllt es alle Felder, bei denen es sich zu mindestens 95 % sicher ist, auf einmal aus, und kommt für den Rest zurück. Weniger Durchgänge pro Block bedeuten mehr Text pro Sekunde, aber nur, wenn die Software, die es ausführt, das Kreuzworträtsel auch löst.
Das Modell selbst ist DiffuSpaces erste Veröffentlichung. Teammitglieder kommen aus der Gruppe der University of Hong Kong hinter Dream 7B, einem früheren Diffusionsmodell. Clover ist von Qwen3.6-35B-A3B abgeleitet, einem offenen Modell des Qwen-Teams von Alibaba. Es hat insgesamt 35 Milliarden Parameter, aber nur etwa 3 Milliarden arbeiten an jedem Token. Stell dir ein Team aus 256 Spezialisten vor: Jedes Wort fragt 8 von ihnen plus einen Generalisten, und der Rest wartet im Hinterzimmer. Deshalb kann ein so großes Modell schnell sein. Es liest bis zu 131.072 Tokens aus Prompt und Antwort zusammen (die „128K“). Die Lizenz ist Apache-2.0, kommerzielle Nutzung ist also in Ordnung.
DiffuSpaces Blog macht starke Aussagen zum Tempo. Auf einer NVIDIA H200, einer Rechenzentrumskarte, meldet er 515 Tokens pro Sekunde bei Agentenaufgaben, gegen 365 für ein beschleunigtes Qwen-Modell ähnlicher Größe. Auf einer neueren GB300-Rechenzentrumskarte meldet er 680. Beides gilt für eine Anfrage nach der anderen, mit dem vollen, unkomprimierten Modell. Der Blog sagt nicht, welche Software sie ausgeführt hat oder in welchem Modus. Er meldet außerdem starke Ergebnisse in Coding-Tests.
Ihre anschaulichste Demo ist eine Drohnen-Disposition: eine zusammengesetzte Nachricht mit fünf Aufgaben. In ihrer Demo hat Clover alle fünf in 0,97 Sekunden richtig, während ein Qwen-Modell 3,78 Sekunden braucht und den Kartierungsauftrag einer Drohne für einen medizinischen hält. Wir haben dieselbe Idee laufen lassen: Unsere Läufe brauchten 2,1 bis 2,3 Sekunden gegen ihre 0,97, auf einer 4090 mit einer komprimierten Datei im Ein-Token-Modus, es ist also kein Vergleich unter gleichen Bedingungen.
Die Engine, die es auf einer 24-GB-Karte ausführt, tippt ein Token nach dem anderen
Auf einer 24-GB-Karte mit llama.cpp läuft Clover als gewöhnliches Modell. Das ist kein Fehler in unserem Setup. Genau das sagt der gemergte Code, dass er tut.
Von den drei Wegen, die DiffuSpace aufführt, hat nur llama.cpp fertigen Support, der in 24 GB passt. Dieser Support, Pull Request #31306 von Maphist0, wurde am 2. November gemergt und kam mit dem Release vom 4. November, v0.9.0. Dessen Notes führen „Clover-35B-A3B-Preview diffusion model, AR mode“ auf: die Schreibkraft. Ein späterer Pull Request soll einen schnelleren Modus hinzufügen, der Blöcke parallel entwirft. Einen solchen offenen Pull Request haben wir in llama.cpp nicht gefunden.
Die Setup-Schritte auf der Modellseite verwenden genau diese fehlende Beschleunigung, eine selbstspekulative Option, die v0.9.0 nicht enthält. Wir haben sie nicht ausgeführt.
Die schnelleren Modi gibt es an zwei anderen Stellen, keine davon einfach auf einer einzelnen Gaming-Karte:
- DiffuSpaces eigener Python-Code macht das volle blockweise Ausfüllen. Er braucht allein für die Gewichte etwa 69 GB, in voller Präzision. Das heißt eine Rechenzentrumskarte mit 80 GB.
- Ein Pull Request an SGLang, ein weiteres freies Serving-Programm (#46927, von Zirui Wu), fügt den Modus Raten-dann-Prüfen hinzu. Das Modell entwirft einen ganzen Block in einem parallelen Durchgang und prüft den Entwurf dann auf die gewöhnliche Weise. Er ist noch offen, wartet auf ein Review, und seine Testsuite ist noch nicht gelaufen. Seine eigene Validierung meldet 453,59 Tokens pro Sekunde für eine Anfrage auf einer H200.
Also haben wir gemessen, was du auf einer Karte mit Code, den du heute installieren kannst, tatsächlich bekommst.
Die offizielle Datei brauchte einen 17-Sekunden-Patch, bevor sie „Canberra“ antwortete
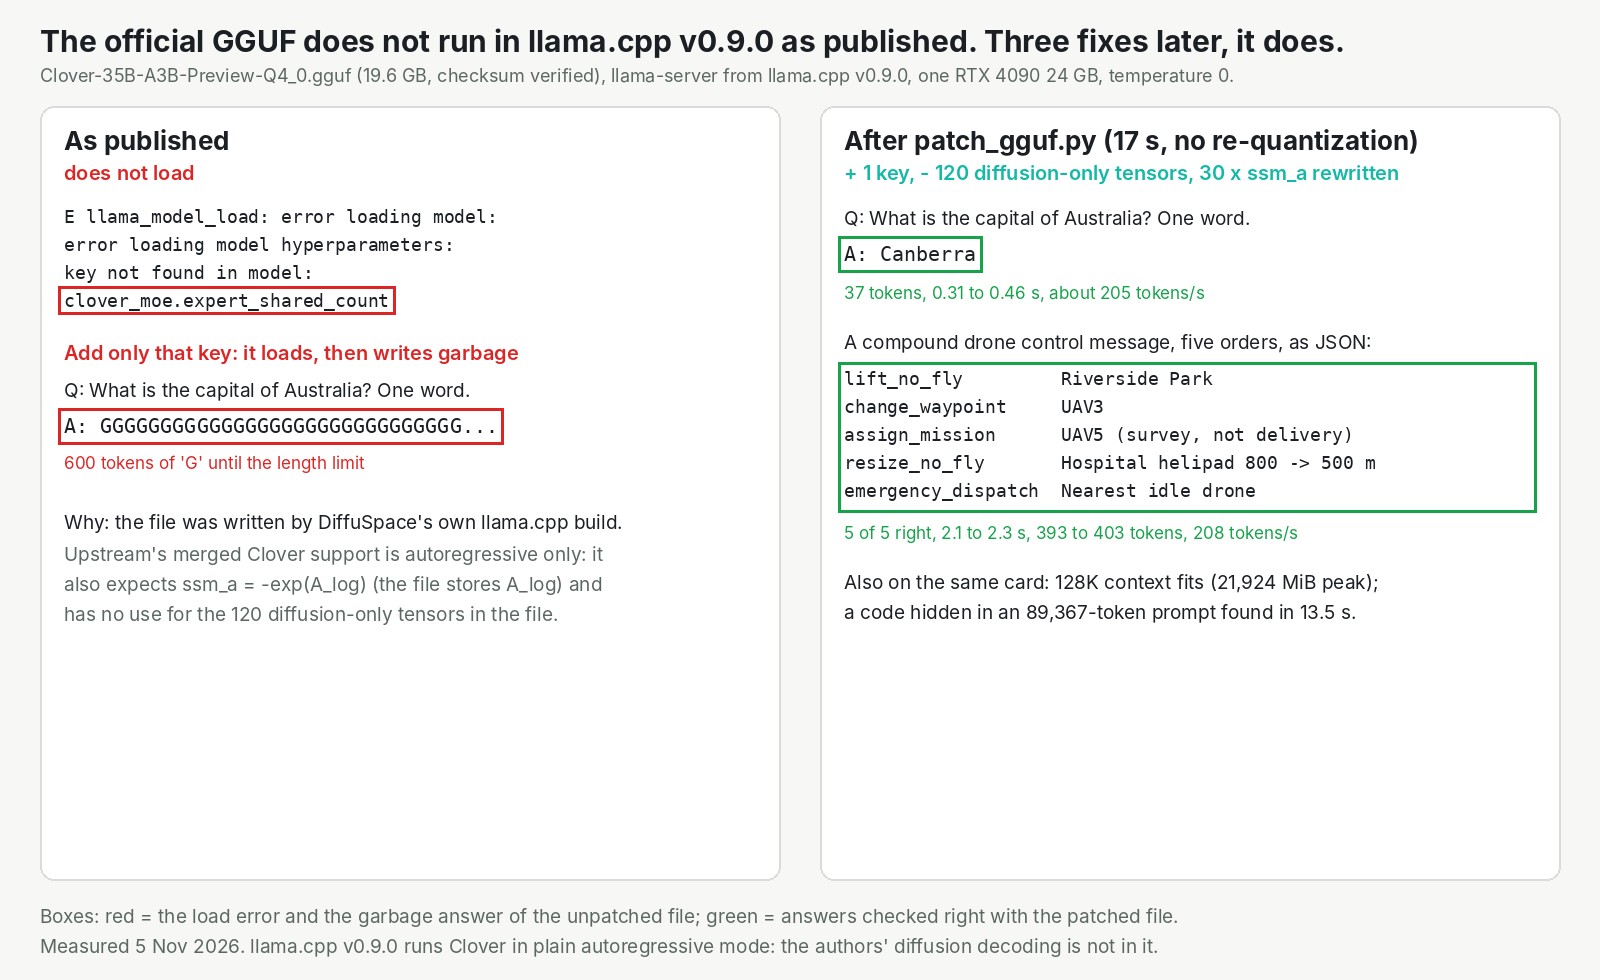
Nach einem kleinen Patch lädt die offizielle Datei im unveränderten llama.cpp und antwortet richtig. Ohne ihn läufst du in der ersten Minute gegen eine Wand.
Wie veröffentlicht weigert sich llama.cpp v0.9.0, die Datei zu laden. Es bricht ab mit key not found in model: clover_moe.expert_shared_count. Wir haben nur diesen fehlenden Eintrag ergänzt und es erneut versucht. Das Modell lud, und auf „What is the capital of Australia? One word.“ antwortete es mit 600 Kopien des Buchstabens G, ein einziger Ton, gehalten wie Gitarren-Feedback.
Die Ursache: DiffuSpace hat seine Dateien mit einem eigenen Build von llama.cpp geschrieben, dem mit der Beschleunigung. Die Datei weicht in drei kleinen Punkten von dem ab, was llama.cpp erwartet. Ihr fehlt dieser eine Eintrag. Sie trägt 120 zusätzliche Teile, die nur der Diffusionsmodus nutzt. Und in jeder von 30 Schichten speichert sie einen kleinen Satz Zahlen in einer anderen mathematischen Form.
Unser Skript, patch_gguf.py, behebt alle drei. Es kopiert jedes andere Byte unverändert, das Modell wird also nicht neu komprimiert. Auf der Datei mit 19,6 GB dauerte das 17 Sekunden. Danach lautete die Antwort Canberra.
Status: in unserem SDK-Beispiel behoben, in DiffuSpaces Dateien und in llama.cpp weiterhin offen. Die gepatchte Datei haben wir nur mit llama.cpp v0.9.0 getestet.
Etwa 208 Tokens pro Sekunde auf einer RTX 4090, und das ganze 128K-Fenster passt
Mit der gepatchten Datei schrieb Clover 202 bis 211 Tokens pro Sekunde für eine Anfrage, und das erste Token kam nach 0,13 bis 0,31 Sekunden zurück.
In diesem Modus sind 208 Tokens pro Sekunde das Tempo der Schreibkraft, nicht das des Kreuzworträtsels. Die Basis Qwen3.6-35B-A3B haben wir auf dieser Karte nicht laufen lassen, wir wissen also nicht, ob Clover in diesem Modus schneller oder besser ist als seine Basis.
| Was wir gefragt haben | Was zurückkam | Zeit |
|---|---|---|
| Die zusammengesetzte Nachricht zur Drohnen-Disposition, fünf Aufträge | 5 von 5 richtig, als sauberes JSON, in jedem Lauf | 2,1 bis 2,3 s |
| „Ist es in Lissabon oder in Oslo wärmer?“ mit einem Wetter-Tool | Zwei Tool-Calls gleichzeitig, beide gültig | 1,29 s |
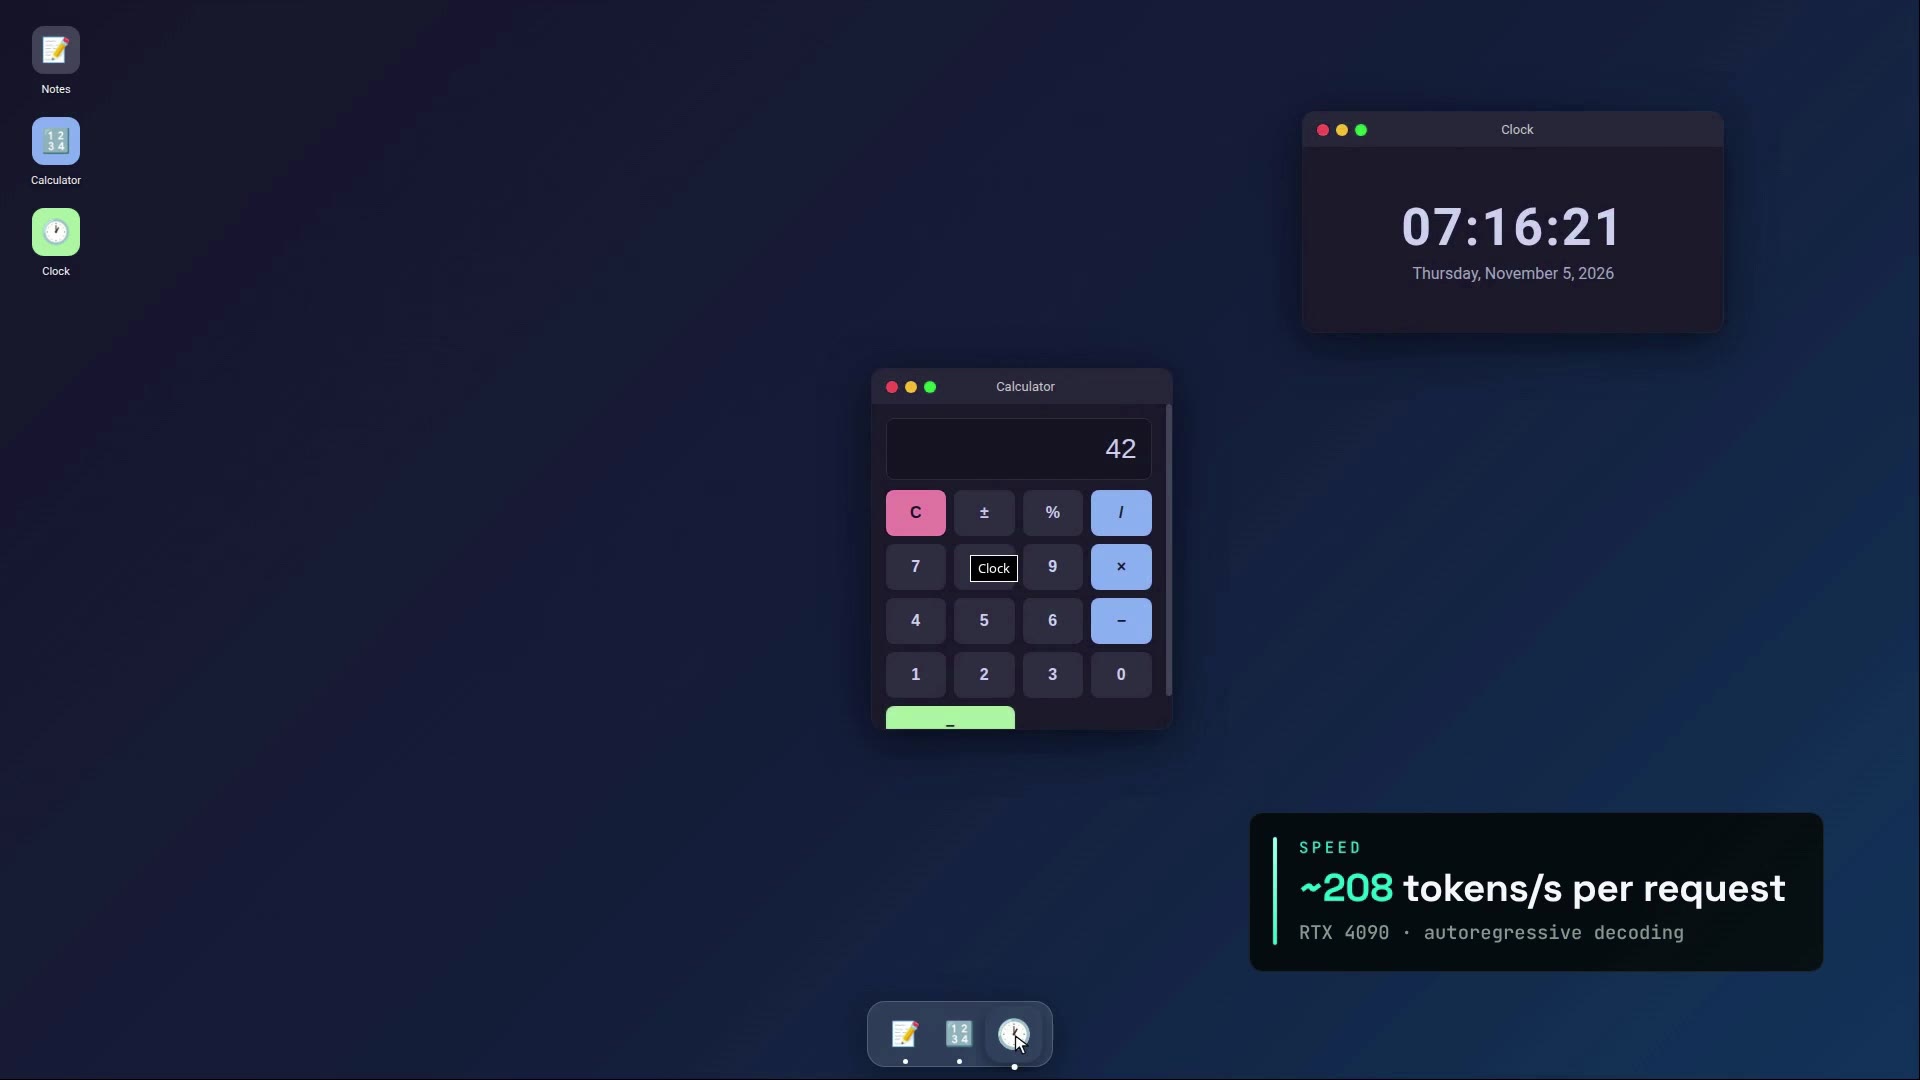
| Ein ganzer Desktop in einer HTML-Datei (die Showcase-Idee der Autoren) | Eine funktionierende Seite: Dock, verschiebbare Fenster, Uhr, Notizen, ein Taschenrechner, der 7 x 6 = 42 sagt | 20,3 s |
| Ein Code, versteckt in einem Prompt mit 89.367 Tokens, volles 128K-Fenster | Gefunden | 13,45 s |
Zwei raue Stellen, die dir auffallen werden:
- Es denkt immer zuerst nach. Bei „Canberra“ ist das eine kurze Notiz an sich selbst. Ein Essay mit 400 Wörtern brauchte 22,7 Sekunden und 4.665 Tokens, die meisten davon fürs Nachdenken. Den Schalter, mit dem man das Nachdenken abschaltet, reicht unser Endpoint noch nicht durch. Das ist eine bekannte Lücke auf unserer Seite, weiterhin offen.
- Beim generierten Taschenrechner ist die Taste „=“ abgeschnitten. Das Fenster ist zu kurz, also ist die halbe Taste verdeckt. Die Seite kam zweimal byte-identisch heraus, Fehler inklusive.
Welche GPU: 24 GB schaffen alles, ein Budget von 16 GB lief mit halbem Tempo
Jedes Speicherbudget hat richtig geantwortet, und ein Budget von 16 GB behielt etwa das halbe Tempo.
Der Trick für kleinere Karten ist das Hinterzimmer aus dem Bild mit den Spezialisten. llama.cpp kann die Experten einiger Schichten im Hauptspeicher des Rechners (RAM) halten statt auf der Karte. Jedes Wort besucht sie trotzdem, also wird es langsamer, aber die Karte braucht weniger Speicher.
| Karte oder Speicherbudget | Wie es lief | Spitzenspeicher auf der Karte | Tempo | Echte Karte? |
|---|---|---|---|---|
| RTX 4090 24 GB | alles auf der Karte | siehe oben | siehe oben | ja |
| Budget 16 GB | Experten von 10 Schichten im RAM | 15.456 MiB | etwa 102 Tokens/s | nein |
| Budget 12 GB | Experten von 22 Schichten im RAM | 10.270 MiB | etwa 65 Tokens/s | nein |
| Budget 8 GB | alle Experten im RAM | 2.494 MiB | etwa 43 Tokens/s | nein |
Die Zeile mit 16 GB ist die Entscheidungslinie. Sie passt in 15.456 MiB und schreibt immer noch etwa 102 Tokens pro Sekunde, die Drohnen-Disposition dauerte also 4,4 Sekunden statt 2,2. Die Budgets mit 12 GB und 8 GB haben ebenfalls jede Frage richtig beantwortet, nur langsamer.
Die mit „nein“ markierten Zeilen liefen auf derselben 4090 mit begrenztem Speicher, lies sie also als Speichermessung, nicht als Tempoversprechen. Auf einer echten 16-GB-Karte in einem kleineren Desktop hängt das Tempo vom Prozessor und Speicher dieser Maschine ab. Du brauchst außerdem genug RAM für die Experten, die du von der Karte auslagerst. Ein Ergebnis von einer echten 16-GB- oder 12-GB-Karte haben wir nicht.
DiffuSpace meldet 101,8 Tokens pro Sekunde auf einer RTX 5070 Ti mit 16 GB, neben unseren 102. Die Übereinstimmung ist Zufall: eine andere Karte, eine andere Kompression, eine ungenannte Engine.
Auf InferenceKey: ein Versions-Pin, ein Datei-Patch, ein erster Build von fünf Minuten
Unser Standard-Setup mit llama.cpp hat ein Modell betrieben, dessen Support drei Tage alt war. Den Code der Plattform haben wir nicht geändert. Wir haben eine Version gesetzt, die Datei gepatcht und dem Worker drei CUDA-Build-Einstellungen gegeben, die er noch nicht selbst setzt (auf unserer Seite offen, im SDK-Beispiel aufgeführt).
Auf InferenceKey ist ein Worker das kleine Programm auf deiner GPU-Maschine, das Aufträge von der Plattform annimmt. Unser Worker baut llama.cpp selbst. Seine Standardversion ist älter und kennt Clover nicht. Also haben wir ihm gesagt, Version v0.9.0 zu verwenden, und der Worker hat beim ersten Mal genau dieses Release für die GPU gebaut. Dieser Build dauerte 4 min 50 s. Danach lieferte die Plattform auf Anfrage nach dem Modell in 11,7 Sekunden einen bereiten Endpoint.
Ab da ist es dieselbe API im OpenAI-Stil wie bei jedem anderen Modell auf der Plattform. Die Drohnenaufträge, die Tool-Calls und die Desktop-Seite oben liefen alle darüber. Dieser Lauf nutzte unsere eigene Kopie der InferenceKey-Plattform, mit demselben Code wie der gehostete Dienst. Den gehosteten Endpoint haben wir nicht aufgerufen, betrachte diesen Weg also als ungetestet. Unser Beispielprogramm schickt das Modell auf eine Maschine, die du benennst, die Inferenz läuft also auf deiner eigenen Hardware. Die Anfragen gehen trotzdem über die Plattform, gehostet oder deine eigene Kopie.
Solltest du es nutzen? Ja als Agentenmodell auf 24 GB, noch nicht wegen des Diffusionstempos
- Du willst ein offenes Agentenmodell auf einer einzelnen 24-GB-Karte: einen Versuch wert. Spiel zuerst den Patch ein und vergleiche es auf deinen eigenen Aufgaben mit seiner Qwen-Basis.
- Du hast eine 16-GB-Karte: wahrscheinlich, mit den Experten im RAM, mit etwa halbem Tempo.
- Du willst das Diffusionstempo, das der Blog zeigt: heute nicht auf llama.cpp. Behalte den SGLang-Pull-Request im Auge oder nutze DiffuSpaces eigenen Python-Code auf einer 80-GB-Karte.
- Dir sind die Benchmark-Ergebnisse wichtig: Sie stammen vom Hersteller und gelten im Ein-Token-Modus vielleicht nicht. Wir haben ein paar eigene Prompts probiert, und alle kamen richtig zurück: ein Anfang, kein Beweis.
Um dasselbe Deployment, dieselbe Drohnen-Disposition und dieselbe Desktop-Seite auf deiner eigenen Karte laufen zu lassen, führe python main.py aus dem Clover-35B-A3B-SDK-Beispiel aus. Dafür brauchst du ein InferenceKey-Projekt mit einem SDK-Token und einem API-Key. Außerdem brauchst du einen privaten NVIDIA-Worker mit 24 GB, auf dem die Datei einmal mit dem patch_gguf.py des Beispiels gepatcht wurde.
Für Ingenieure
Credits
- DiffuSpace: das Modell, die offiziellen GGUF-Dateien mit Prüfsummen, der Blog, die Demos zur UAV-Disposition und zum GenUI-Desktop. Teammitglieder kommen aus der NLP-Gruppe der HKU hinter Dream 7B (April 2025; die Dream-Familie hat 2,7 Millionen Downloads auf Hugging Face überschritten).
- Das Qwen-Team von Alibaba: Qwen3.6-35B-A3B, die Basis, von der Clover abgeleitet ist.
- Maphist0: llama.cpp PR #31306, der Clover-Support im AR-Modus, validiert auf BF16 CPU und H200 CUDA. Die Maintainer von llama.cpp haben ihn gemergt und v0.9.0 ausgeliefert.
- Zirui Wu (WilliamZR): SGLang PR #46927, natives Serving und selbstspekulatives Decoding (offen).
- AI Search: wo wir das Modell entdeckt haben (News-Video vom 2026-11-01, Kapitel bei 49:23), mit dem Hinweis, dass das volle Modell 69 GB wiegt.
- Unser Teil: das Deployment über die Plattform, die Diagnose der GGUF-Inkompatibilität und das Schreiben von
patch_gguf.py, die Prompts und Tests, die Messungen, die VRAM-Leiter, das SDK-Beispiel und das Demovideo.
Modell und Dateien
model_typeclover_moe, 40 Schichten: volle Attention in jeder 4., 30 Schichten mit linearer Attention (Gated DeltaNet). Hidden 2048, 16 Heads / 2 KV-Heads, head_dim 256, 256 geroutete Experten top-8 plus 1 geteilter, Vokabular 248.320,max_position_embeddings131072.- Diffusionseinstellungen in
config.json:block_size32, LowConfidence-Denoising mit Schwelle 0,95. - Generierungs-Defaults: greedy,
presence_penalty0.9,repetition_penalty1.05, dazu die reinen Diffusionseinstellungendllm_length_penalty10.0 (Start 8192, Fenster 8192) unddllm_think_end_bias10.0 (Start 4096, Fenster 4096), für die es in llama.cpp keine Entsprechung gibt.max_new_tokens24576. - GGUF-Repo
Diffuspace/Clover-35B-A3B-Preview-GGUF, nicht zugangsbeschränkt, apache-2.0, Snapshot32e22a02b885e173177b7ce7661ad13448b4f89e(zuletzt geändert 2026-10-29). Q4_0 19.586.909.600 B (18,24 GiB), Q4_K_M 22.998.009.248 B, Q8_0 37.863.343.264 B. - Q4_0 sha256
3e2cf14ca47f6e41c251f08237ac79cd37ad81a2ea2a220fff731e34c66930d5, stimmt überein. - BF16-Repo: etwa 69 GB Gewichte, eigener Code,
transformers==5.19.0, PyTorch 2.10+. - Die Backend-Tabelle im GitHub-Repo: Transformers = Block-Diffusion-Denoising; SGLang (#46927) = Block-Diffusion-Denoising und selbstspekulativ; llama.cpp (#31306) = selbstspekulativ. Das Repo enthält derzeit nur
README.md,benchmark.pngundsft/; der Backend-Code „will be added“.
Stand der Runtimes am 2026-11-05
- PR #31306 gemergt am 2026-11-02T17:37:28Z, Merge-Commit
e4b6c8ca6a6e8da70248da30709e897e7cc8615e. Seine Beschreibung: „in AR mode only. Self-speculative generation for Clover is split into a separate PR.“ - Erster Build mit Clover:
b12052(2026-11-02T17:37:44Z). Releasev0.9.0(2026-11-04T13:08:06Z), Notes: „Four new architectures are supported (Clover, Limite, Metis-1.6 and Mistral Large 4)“ und „Clover-35B-A3B-Preview diffusion model, AR mode (#31306)“. common/arg.cppbeiv0.9.0: 0 Vorkommen vondraft-self. Keinen offenen selbstspekulativen Clover-PR in llama.cpp gefunden (die anderen PRs von Maphist0 sind #31706 und #28919).- Der Quick Start der GGUF-Card holt
pull/31306/headund führtllama-speculative-simple --spec-type draft-selfaus. Unverändert am 2026-11-05. Wir haben ihn nicht ausgeführt. - SGLang #46927: offen, erstellt 2026-10-28, aktualisiert 2026-11-04, Review erforderlich, CI nicht gelaufen (kein Label
run-ci), 42 Dateien. Seine Validierung auf einer H200: MATH500 96,6 % bei 453,59 Ausgabe-Tokens/s pro Anfrage (Block 16, DP=1, Concurrency 1); DP=4 bei Concurrency 8: 95,2 %, 4.268,73 Tokens/s gesamt, 192,13 pro Anfrage.
Angaben der Autoren (nicht reproduziert)
Aus dem Blog (die Seite ist standardmäßig auf Chinesisch; die Zahlen stimmen mit unserer englischen Aufnahme überein):
| Benchmark | Clover-35B-A3B-Preview |
|---|---|
| SWE-bench Verified | 73,6 |
| Terminal-Bench 2.1 | 51,7 |
| tau3 Overall | 65,3 |
| GPQA Diamond | 83,8 |
| ZebraLogic | 95,8 |
| AA-LCR | 72,0 |
| BFCL-v4 | 67,9 |
| MMLU-Pro | 84,8 |
- SWE-bench Verified ist ein Test mit echten Coding-Aufgaben.
- Im Blog verglichen mit LLaDA2.2 flash, Mercury 2.5, Qwen3.6-35B-A3B und Qwen3.5-35B-A3B.
- Tempo: 680 Tokens/s auf einer GB300 bei internen Agenten-Workloads; 515 Tokens/s auf einer H200 gegen 365 für ein Qwen ähnlicher Größe mit DFlash2. BF16, Batch 1. Engine und Decoding-Modus nicht genannt.
- On-Device: INT4 auf einer RTX 5070 Ti 16 GB, 101,8 Tokens/s bei MATH-500 gegen 48,5 für MiniCPM- und Qwen-Modelle ähnlicher Größe. Engine nicht genannt.
- Demo zur UAV-Disposition: fünf richtige Ergebnisse in 0,97 s; Qwen mit 3,78 s hält den Kartierungsauftrag von UAV5 für einen medizinischen.
Setup
- Eine RTX 4090 24 GB (24.564 MiB, 450 W, Compute Capability 8.9) auf InferenceKey Cloud, Host mit 32 vCPU und 124 GB RAM, 100 GB Container-Disk.
- Ein lokaler InferenceKey-Manager (nie Produktion) hat den Worker gebootstrappt. Jeder Aufruf des Hauptlaufs ging über
/v1/chat/completionsdieses Managers. - Backend: das eingebaute
llamacpp. Der Standard-Tag von llama.cpp im Worker istb9748, der kein Clover kennt, daher ist der Pin pro Workload nötig. Pins pro Workload überschreiben die Umgebung des ganzen Workers. Auf NVIDIA Linux baut der Workerllama-serverzur Laufzeit mit-DGGML_CUDA=ON. - Warum llama.cpp: Von den drei Backends, die DiffuSpace aufführt, ist es das einzige mit gemergtem Support, und Q4_0 passt in 24 GB. Die anderen Wege, DiffuSpaces eigener Code für Hugging Face Transformers und der offene SGLang-Branch, brauchen etwa 69 GB BF16-Gewichte.
- Die Hauptaufrufe gingen über den Endpoint des Managers. Der 128K-Lauf und die kleineren Speicherbudgets waren direkte
llama-server-Läufe auf demselben Worker.
Schritt für Schritt mit dem SDK-Beispiel
Auf dem Worker-Host, einmalig:
pip install -U "huggingface_hub[hf_xet]" gguf numpy
hf download Diffuspace/Clover-35B-A3B-Preview-GGUF Clover-35B-A3B-Preview-Q4_0.gguf --local-dir /root/models
curl -LO https://raw.githubusercontent.com/inferencekey/inferencekey-sdk/main/examples/clover-35b-a3b-llamacpp-private-nvidia/patch_gguf.py
python ./patch_gguf.py /root/models/Clover-35B-A3B-Preview-Q4_0.gguf /root/models/Clover-35B-A3B-Preview-Q4_0-ar.gguf
Auf PyTorch-Images mit CUDA 13 vor dem ersten Build in die Umgebung des Workers aufnehmen (siehe Offene Probleme, 4):
CUDACXX=/usr/local/cuda/bin/nvcc
PATH=/usr/local/cuda/bin:$PATH
CMAKE_BUILD_PARALLEL_LEVEL=<cores>
Halte die Datei auf der lokalen Platte, nicht auf einem Netzwerk-Mount. Was patch_gguf.py macht:
- fügt
clover_moe.expert_shared_count= 1 hinzu; - lässt die 120 reinen Diffusions-Tensoren weg:
ssm_bd_history.weight,ssm_bd_history.bias,ssm_bd_logit_scale.weightundssm_conv1d.weight_right, 4 pro GDN-Schicht (dasconversion/clover.pyvon Upstream filtert sie ebenfalls); - schreibt die 30 Vektoren
blk.N.ssm_aals-exp(A_log)neu, so wie dasconversion/qwen.pyvon Upstream sie schreibt. Die offizielle Datei speichert rohesA_log(Schicht 0ssm_a[0]= -3,3125 =A_log[0]des BF16-Checkpoints); - kopiert jeden anderen Tensor byteweise, ohne Neuquantisierung, so wie es der Konvertierungscode von Upstream selbst tut. 17 s.
Auf deinem Rechner:
git clone https://github.com/inferencekey/inferencekey-sdk
cd inferencekey-sdk/examples/clover-35b-a3b-llamacpp-private-nvidia
cp .env.example .env      # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY, INFERENCEKEY_PROJECT, IK_WORKER_ID
pip install -r requirements.txt   # plus the local SDK build with maturin, see ../CONTRIBUTING.md
python main.py            # IK_KEEP_ALIVE=1 keeps the workload afterwards
Optional: CLOVER_GGUF (Standard /root/models/Clover-35B-A3B-Preview-Q4_0-ar.gguf) und CLOVER_CONTEXT (Standard 16384; 131072 passt in 24 GB).
main.py ruft ensure() auf einem festen llamacpp-Workload auf, der an IK_WORKER_ID gepinnt ist, mit diesem Befehl:
INFERENCEKEY_LLAMACPP_TAG=v0.9.0 llama-server -m /root/models/Clover-35B-A3B-Preview-Q4_0-ar.gguf \
  --alias clover-35b-a3b -ngl 99 -fa on -c 16384 --jinja --reasoning-format deepseek \
  --presence-penalty 0.9 --repeat-penalty 1.05
Danach wartet es, bis alles bereit ist, stellt mit generate_text() eine kurze Frage, schickt die Dispositionsnachricht und erwartet ein JSON-Array, bittet um die Desktop-Seite und speichert outputs/desktop.html und outputs/answers.json. Am Ende ruft es delete() auf, außer bei IK_KEEP_ALIVE=1.
Zeiten
| Schritt | Zeit |
|---|---|
| Worker online nach dem Anlegen der Maschine | etwa 47 s |
CUDA-Build von llama.cpp v0.9.0 auf dem Worker (-j30, Arch 89) | 4 min 50 s |
| GGUF-Download (parallel zum Build) | 35 s, etwa 560 MB/s |
patch_gguf.py | 17 s |
ensure() bis bereit, gebaut und gepatchte Datei auf lokaler Platte | 11,7 s |
Direktes Laden der gepatchten Datei mit llama-server | etwa 6 s kalt, 1,6 bis 3,6 s warm |
| Erster Plattformlauf mit der ungepatchten Datei | bei 292 s gescheitert, bootstrap step failed |
Tempo und Ausgaben (Temperatur 0, Streaming über den Endpoint, sofern nicht anders angegeben)
| Test | Completion-Tokens | Zeit | Erstes Token | Decode Tokens/s | Ergebnis |
|---|---|---|---|---|---|
| „Hauptstadt Australiens, ein Wort“ x3 | 37 | 0,31 bis 0,46 s | 0,13 bis 0,28 s | 204 bis 211 | Canberra |
Dasselbe mit enable_thinking: false | 37 | 0,46 s | 211 | denkt trotzdem: das Gateway verwirft chat_template_kwargs | |
| „Was ist Diffusion?“ | 1.402 | 6,8 s | 0,13 s | 210 | korrekte Antwort aus der Physik |
| Essay mit 400 Wörtern | 4.665 | 22,7 s | 0,20 s | 207 | fertig |
| Tools (Lissabon gegen Oslo) | 206 | 1,29 s | 0,31 s | 210 | zwei parallele get_weather-Aufrufe, gültiges JSON, finish tool_calls |
| Disposition (3 Tests, Beispiel, aufgezeichnetes Terminal) | 393 bis 403 | 2,10 bis 2,28 s | 0,21 bis 0,31 s | 208 bis 209 | 5 von 5 Aufträgen richtig |
| GenUI-Desktop (Beispiel) | 4.163 | 20,29 s | 208,5 | HTML mit 11.880 Zeichen, funktioniert, = abgeschnitten | |
| Erklärseite zur Sonnenfinsternis | 11.526 | 56,94 s | 0,14 s | 202,9 | HTML erzeugt, nicht im Detail geprüft |
| Nadel, Prompt mit 10.788 Tokens, 16K-Kontext | 56 | 1,77 s | 1,48 s | 194,5 | 7319-CLOVER |
Nadel, Prompt mit 89.367 Tokens, 128K-Kontext (direkt llama-server, derselbe Worker) | 13,45 s | 143,4 | 7319-CLOVER; Prefill 7.363 Tokens/s |
VRAM-Leiter
Alle Zeilen: gepatchtes Q4_0, llama.cpp v0.9.0, -ngl 99 -fa on. Nur die erste Zeile lief über die Plattform; die anderen waren direkte llama-server-Läufe auf demselben Worker, nachdem der Workload gelöscht war. Spitzen-VRAM aus nvidia-smi, jede Sekunde.
| Ziel | Konfiguration | Spitzen-VRAM | Tempo; Zeit der Disposition | Ausgabe OK | Echte Karte |
|---|---|---|---|---|---|
| RTX 4090 24 GB | -c 16384 (SDK-Beispiel, über die Plattform) | 19.572 MiB | 202 bis 211 Tokens/s; 2,1 bis 2,3 s | ja | ja |
| RTX 4090 24 GB | -c 131072, Nadel mit 89.367 Tokens (direkt llama-server) | 21.924 MiB | 202 kurz, 143,4 bei 89K; 2,09 s | ja, Nadel gefunden | ja |
| Grenze 16 GB | -c 16384 --n-cpu-moe 10 | 15.456 MiB | 101,9 bis 102,5; 4,41 s | ja | nein, emuliert |
| Grenze 16 GB | -c 16384 --n-cpu-moe 14 | 13.728 MiB | 82,7 bis 82,9; 5,46 s | ja | nein, emuliert |
| Grenze 12 GB | -c 16384 --n-cpu-moe 22 | 10.270 MiB | 64,9 bis 65,1; 7,03 s | ja | nein, emuliert |
| Grenze 8 GB | -c 16384 --cpu-moe | 2.494 MiB | 43,1; 10,74 s | ja | nein, emuliert |
| RTX 5080 16 GB | -c 16384 --n-cpu-moe 10 und 8, zwei Maschinen auf demselben Host | n/a | n/a | verworfen | echte Karte, defekter Host |
- „Ausgabe OK“ heißt Canberra und 5 von 5 Dispositionsaufträgen. Mit den Experten auf der CPU unterscheidet sich der Wortlaut der Disposition vom Lauf ganz auf der GPU, aber alle fünf Aufträge sind richtig.
- Die emulierten Zeilen liefen auf dem Host der 4090 mit 16 CPU-Threads für llama.cpp und den Experten von N Schichten im System-RAM. Sie messen den GPU-Speicher, den eine kleinere Karte braucht, nicht ihr Tempo.
- RTX 5080 16 GB, zwei Maschinen auf demselben Host:
ggml_cuda_init: failed to initialize CUDA: unknown error, dannno usable GPU found, --gpu-layers option will be ignored; torch warf ebenfallsRuntimeError: CUDA unknown error. llama-server lief auf der CPU (etwa 22 Tokens/s, 1 MiB auf der GPU). Verworfen: Es gibt keine echte Zahl für 16 GB oder 12 GB. - Nicht probiert: eine funktionierende echte Karte mit 16 oder 12 GB, dieser Modus auf einer H200, der Diffusionsmodus überhaupt, die Basis Qwen3.6-35B-A3B auf der 4090, Q4_K_M, Q8_0, der BF16-Diffusionsweg mit Transformers, der SGLang-Branch.
Offene Probleme
- Offizielle GGUF inkompatibel mit llama.cpp v0.9.0 von Upstream.
E llama_model_load: error loading model: error loading model hyperparameters: key not found in model: clover_moe.expert_shared_count; mit nur dem ergänzten Schlüssel 600 xG. Umgangen mitpatch_gguf.pyim SDK-Beispiel. Upstream offen: Die Dateien müssen mit dem Konverter von Upstream neu erzeugt werden, oder llama.cpp muss das Layout des Forks akzeptieren. Ein Issue bei Upstream haben wir nicht eröffnet. - Die Anleitung der GGUF-Card nutzt eine Option, die Upstream fehlt.
--spec-type draft-selfexistiert in v0.9.0 nicht. Von uns nicht ausgeführt. Offen. - Kein Ergebnis von einer echten 16-GB-Karte. Defekter Host, siehe die Leiter. Offen.
- Der CUDA-Build des Workers braucht Umgebungsvariablen, die der Bootstrap nicht setzt, auf Images mit
nvccaußerhalb vonPATH(die PyTorch-Images mit CUDA 13), sonstcmake configure failed. Workaround in der Umgebung des Workers:CUDACXX=/usr/local/cuda/bin/nvcc,PATH=/usr/local/cuda/bin:$PATH,CMAKE_BUILD_PARALLEL_LEVEL=<cores>, dazuINFERENCEKEY_LLAMACPP_READY_TIMEOUT_SECSfür den ersten Build. Im Worker weiterhin offen. - Das Gateway verwirft
chat_template_kwargs, das Nachdenken lässt sich also nicht pro Anfrage abschalten. Bekannt, offen. - Fenster des generierten Taschenrechners zu kurz, die Taste
=halb abgeschnitten. Ein Fehler in der Ausgabe des Modells, bei Temperatur 0 reproduzierbar.
Demovideo
Die vertonte Demo mit 173 Sekunden: zuerst die Benchmarks und Demos der Autoren (DiffuSpace zugeschrieben), dann unser Deployment im Panel, die Disposition und die Desktop-Seite auf der RTX 4090 und die Speicherleiter.
Quellen
- Diffuspace/Clover-35B-A3B-Preview (Model Card, Config, Generation Config).
- Diffuspace/Clover-35B-A3B-Preview-GGUF.
- DiffuSpace/Clover-35B-A3B-Preview auf GitHub.
- Blogpost von DiffuSpace.
- llama.cpp PR #31306 und die Release Notes von v0.9.0.
- SGLang PR #46927.
- News-Video von AI Search, 2026-11-01 (wo wir es entdeckt haben).
- SDK-Beispiel, Commit
f10c3749717c0d7fcfd58fa8c3be5c1d7dc2ef35.