Clover-35B-A3B en una RTX 4090: 208 tokens/s, pero no como modelo de difusión
El LLM de difusión de DiffuSpace en una RTX 4090 con llama.cpp v0.9.0: 208 tokens/s y la ventana de 128K entera, pero solo escribiendo token a token.
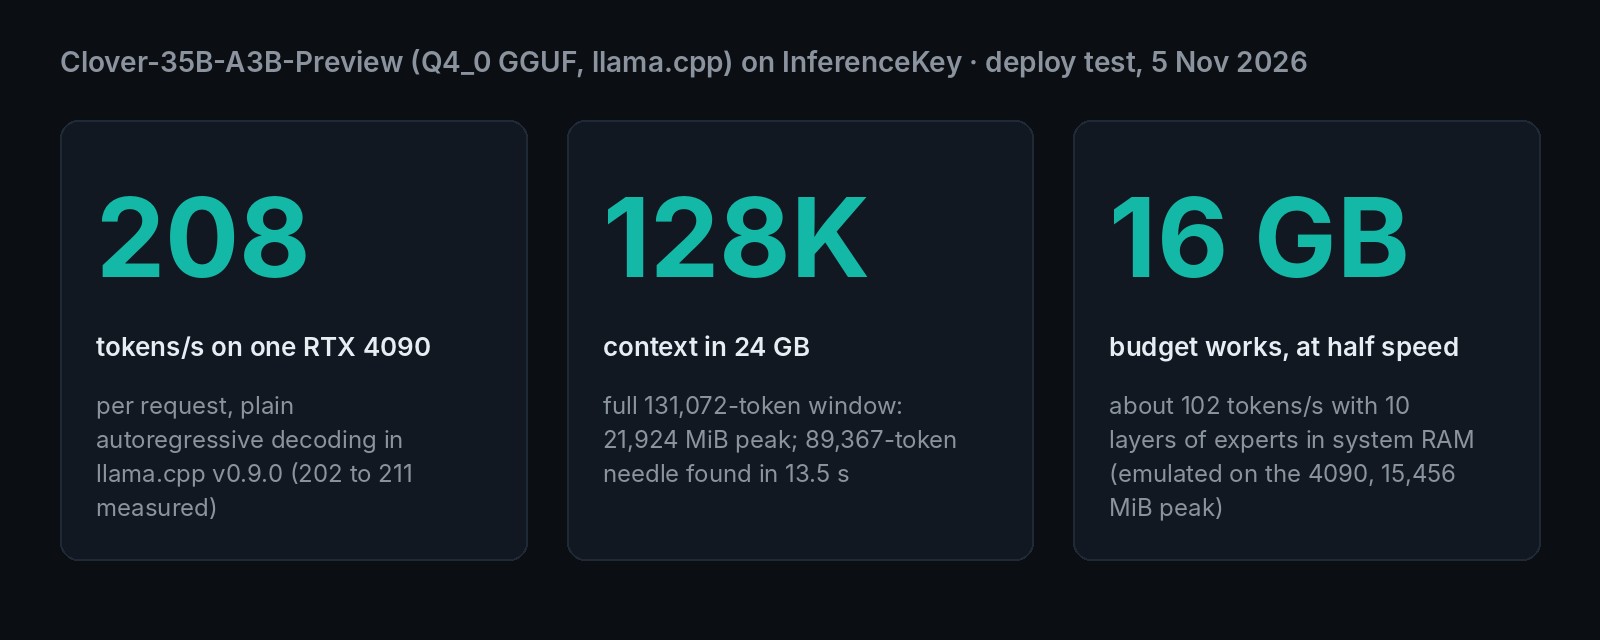
"Add support for DiffuSpace's Clover-35B-A3B-Preview, in AR mode only." Esa línea entró esta semana en llama.cpp, el programa libre de referencia para ejecutar modelos por tu cuenta. Ese límite marca tu velocidad. AR significa escritura normal, un token detrás de otro. Clover es un modelo de lenguaje de difusión abierto, hecho para escribir bloques de texto en paralelo, no palabra a palabra. Pusimos el fichero comprimido oficial en una sola RTX 4090 con llama.cpp de serie. Tras un arreglo de 17 segundos en el fichero, escribió unos 208 tokens (trozos de palabra) por segundo, una página de texto en unos tres segundos. También leyó prompts de hasta 128K tokens (una novela corta) con 21,4 de los 24 GB de la tarjeta. Los 515 y 680 tokens por segundo de los autores salieron de tarjetas más grandes y del modelo completo, y el truco en paralelo no está en este código. Clover merece una prueba hoy en una tarjeta de 24 GB. No compres hardware todavía por la velocidad de difusión.
Un modelo hecho para rellenar bloques de texto, no para teclear palabra a palabra
Lo que promete Clover es velocidad, y le viene de su forma de escribir. Un modelo de lenguaje normal trabaja como un mecanógrafo. Produce un token, luego el siguiente, y cada uno espera al anterior. A Clover lo entrenaron para trabajar más bien como quien rellena un crucigrama. Prepara un bloque de 32 casillas vacías. En cada pasada rellena de golpe todas las casillas de las que está seguro al menos al 95 %, y vuelve a por el resto. Menos pasadas por bloque significa más texto por segundo, pero solo si el software que lo ejecuta hace el crucigrama.
El modelo es el primer lanzamiento de DiffuSpace. Parte del equipo viene del grupo de la Universidad de Hong Kong que hizo Dream 7B, un modelo de difusión anterior. Clover deriva de Qwen3.6-35B-A3B, un modelo abierto del equipo Qwen de Alibaba. Tiene 35B parámetros en total, pero solo unos 3B trabajan en cada token. Imagina un equipo de 256 especialistas: cada palabra consulta a 8 de ellos más a un generalista, y el resto espera en la trastienda. Por eso un modelo tan grande puede ser rápido. Lee hasta 131.072 tokens entre prompt y respuesta (los "128K"). La licencia es Apache-2.0, así que el uso comercial está permitido.
El blog de DiffuSpace hace afirmaciones fuertes sobre velocidad. En una NVIDIA H200, una tarjeta de centro de datos, da 515 tokens por segundo en tareas de agente, frente a 365 de un modelo Qwen acelerado de tamaño parecido. En una GB300, una tarjeta de centro de datos más nueva, da 680. Las dos cifras son con una petición cada vez y el modelo completo sin comprimir. El blog no dice qué software las ejecutó ni en qué modo. También da puntuaciones altas en pruebas de programación.
Su demo más vistosa es un despacho de drones: un solo mensaje compuesto con cinco tareas. En su demo Clover acierta las cinco en 0,97 segundos, mientras que un modelo Qwen tarda 3,78 segundos y confunde la misión de cartografía de un dron con una médica. Repetimos la misma idea: la nuestra tardó de 2,1 a 2,3 segundos frente a sus 0,97, en una 4090 con un fichero comprimido y en modo de un token cada vez, así que no es una carrera en igualdad de condiciones.
El motor que lo ejecuta en una tarjeta de 24 GB escribe un token cada vez
En una tarjeta de 24 GB con llama.cpp, Clover funciona como un modelo normal. No es un fallo de nuestra configuración. Es lo que dice que hace el código fusionado.
De las tres vías que lista DiffuSpace, solo llama.cpp tiene un soporte terminado que entra en 24 GB. Ese soporte, la pull request #31306 de Maphist0, se fusionó el 2 de noviembre y salió en la versión del 4 de noviembre, v0.9.0. Sus notas dicen "Clover-35B-A3B-Preview diffusion model, AR mode": el mecanógrafo. Una pull request posterior debería añadir un modo más rápido que redacta bloques en paralelo. No encontramos ninguna pull request así abierta en llama.cpp.
Los pasos de instalación de la página del modelo usan esa aceleración que falta, una opción autoespeculativa que v0.9.0 no incluye. No los ejecutamos.
Los modos más rápidos existen en otros dos sitios, ninguno sencillo en una sola tarjeta gaming:
- El propio código Python de DiffuSpace hace el relleno completo bloque a bloque. Necesita unos 69 GB solo para los pesos, a precisión completa. Eso significa una tarjeta de centro de datos de 80 GB.
- Una pull request a SGLang, otro programa libre para servir modelos (#46927, de Zirui Wu), añade el modo de adivinar y comprobar. El modelo redacta un bloque entero en una pasada en paralelo y luego comprueba el borrador de la forma normal. Sigue abierta, pendiente de revisión, sin haber pasado aún su batería de tests. Su propia validación da 453,59 tokens por segundo para una petición en una H200.
Así que medimos lo que de verdad obtienes en una tarjeta con código que puedes instalar hoy.
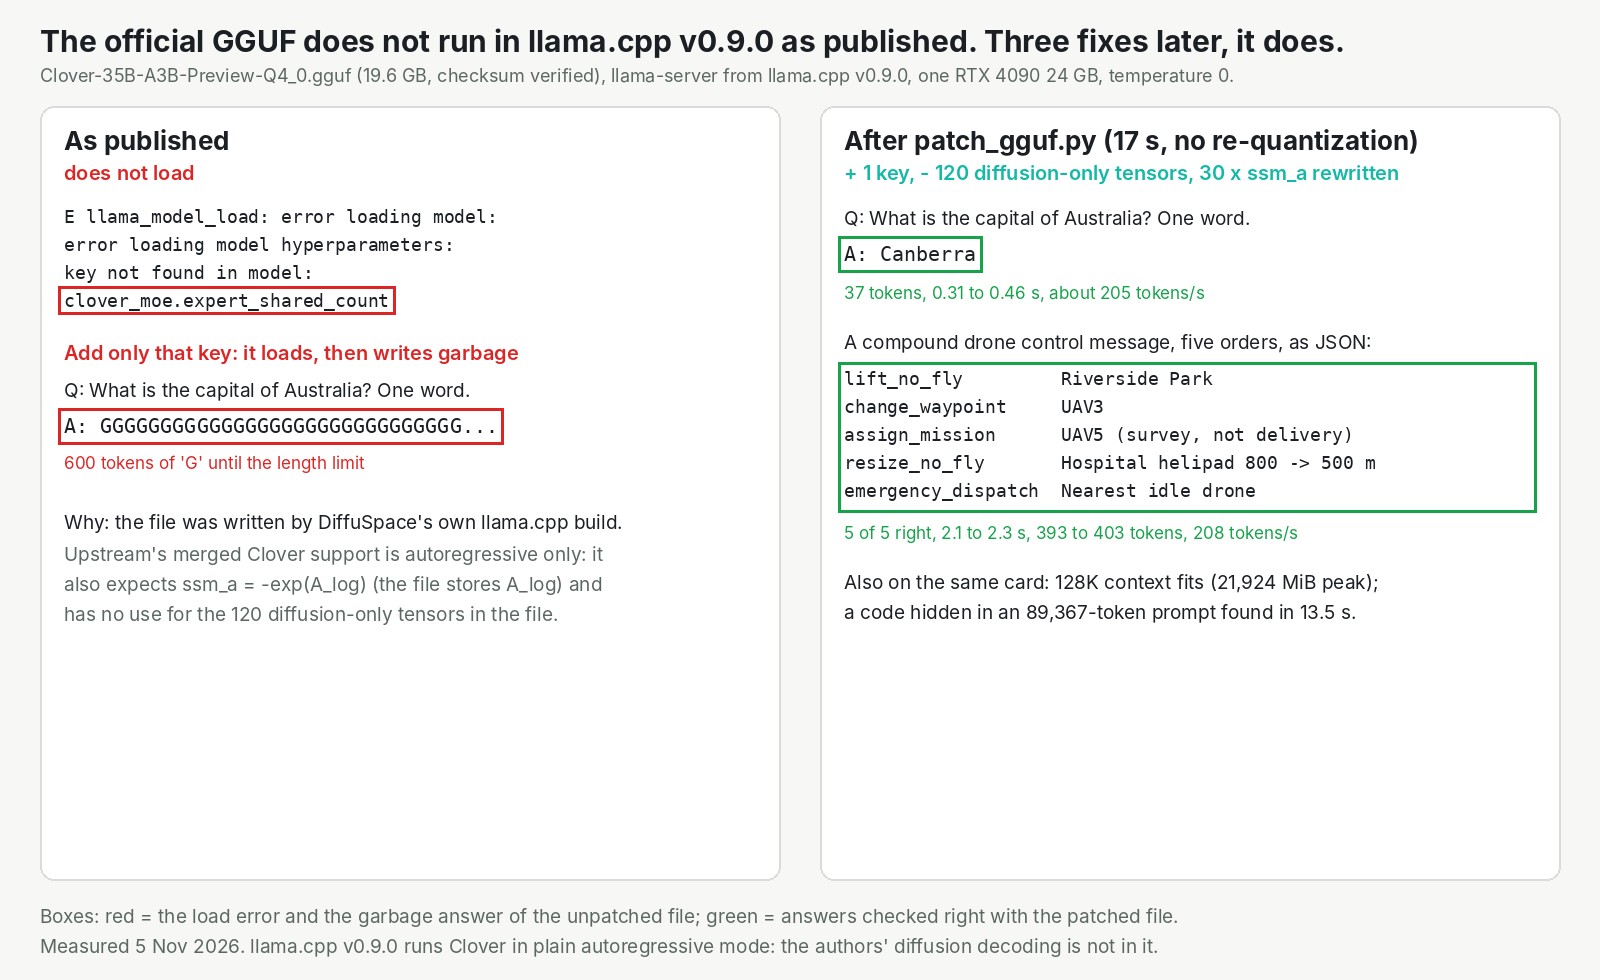
El fichero oficial necesitó un parche de 17 segundos antes de responder "Canberra"
Tras un pequeño parche, el fichero oficial carga en llama.cpp de serie y responde bien. Sin él, te das contra un muro en el primer minuto.
Tal como se publicó, llama.cpp v0.9.0 se niega a cargar el fichero. Se para con key not found in model: clover_moe.expert_shared_count. Añadimos solo esa etiqueta que faltaba y volvimos a probar. El modelo cargó y, a "What is the capital of Australia? One word.", respondió con 600 copias de la letra G, una nota sostenida como el acople de una guitarra.
La causa: DiffuSpace escribió sus ficheros con su propia versión de llama.cpp, la que tiene la aceleración. El fichero se aparta de lo que espera llama.cpp en tres detalles. Le falta esa etiqueta. Lleva 120 piezas extra que solo usa el modo de difusión. Y en cada una de 30 capas guarda un pequeño conjunto de números en otra forma matemática.
Nuestro script, patch_gguf.py, arregla las tres cosas. Copia tal cual todos los demás bytes, así que el modelo no se vuelve a comprimir. Tardó 17 segundos con el fichero de 19,6 GB. Después, la respuesta fue Canberra.
Estado: arreglado en nuestro ejemplo del SDK, todavía pendiente en los ficheros de DiffuSpace y en llama.cpp. Solo probamos el fichero parcheado con llama.cpp v0.9.0.
Unos 208 tokens por segundo en una RTX 4090, y la ventana de 128K entera cabe
Con el fichero parcheado, Clover escribió de 202 a 211 tokens por segundo para una petición, y el primer token llegó en 0,13 a 0,31 segundos.
En este modo, 208 tokens por segundo es velocidad de mecanógrafo, no de crucigrama. No ejecutamos la base Qwen3.6-35B-A3B en esta tarjeta, así que no sabemos si Clover en este modo es más rápido o mejor que su base.
| Lo que pedimos | Lo que volvió | Tiempo |
|---|---|---|
| El mensaje compuesto de despacho de drones, cinco órdenes | 5 de 5 bien, en JSON limpio, en todas las ejecuciones | 2,1 a 2,3 s |
| "¿Hace más calor en Lisboa o en Oslo?" con una herramienta del tiempo | Dos llamadas a herramientas a la vez, las dos válidas | 1,29 s |
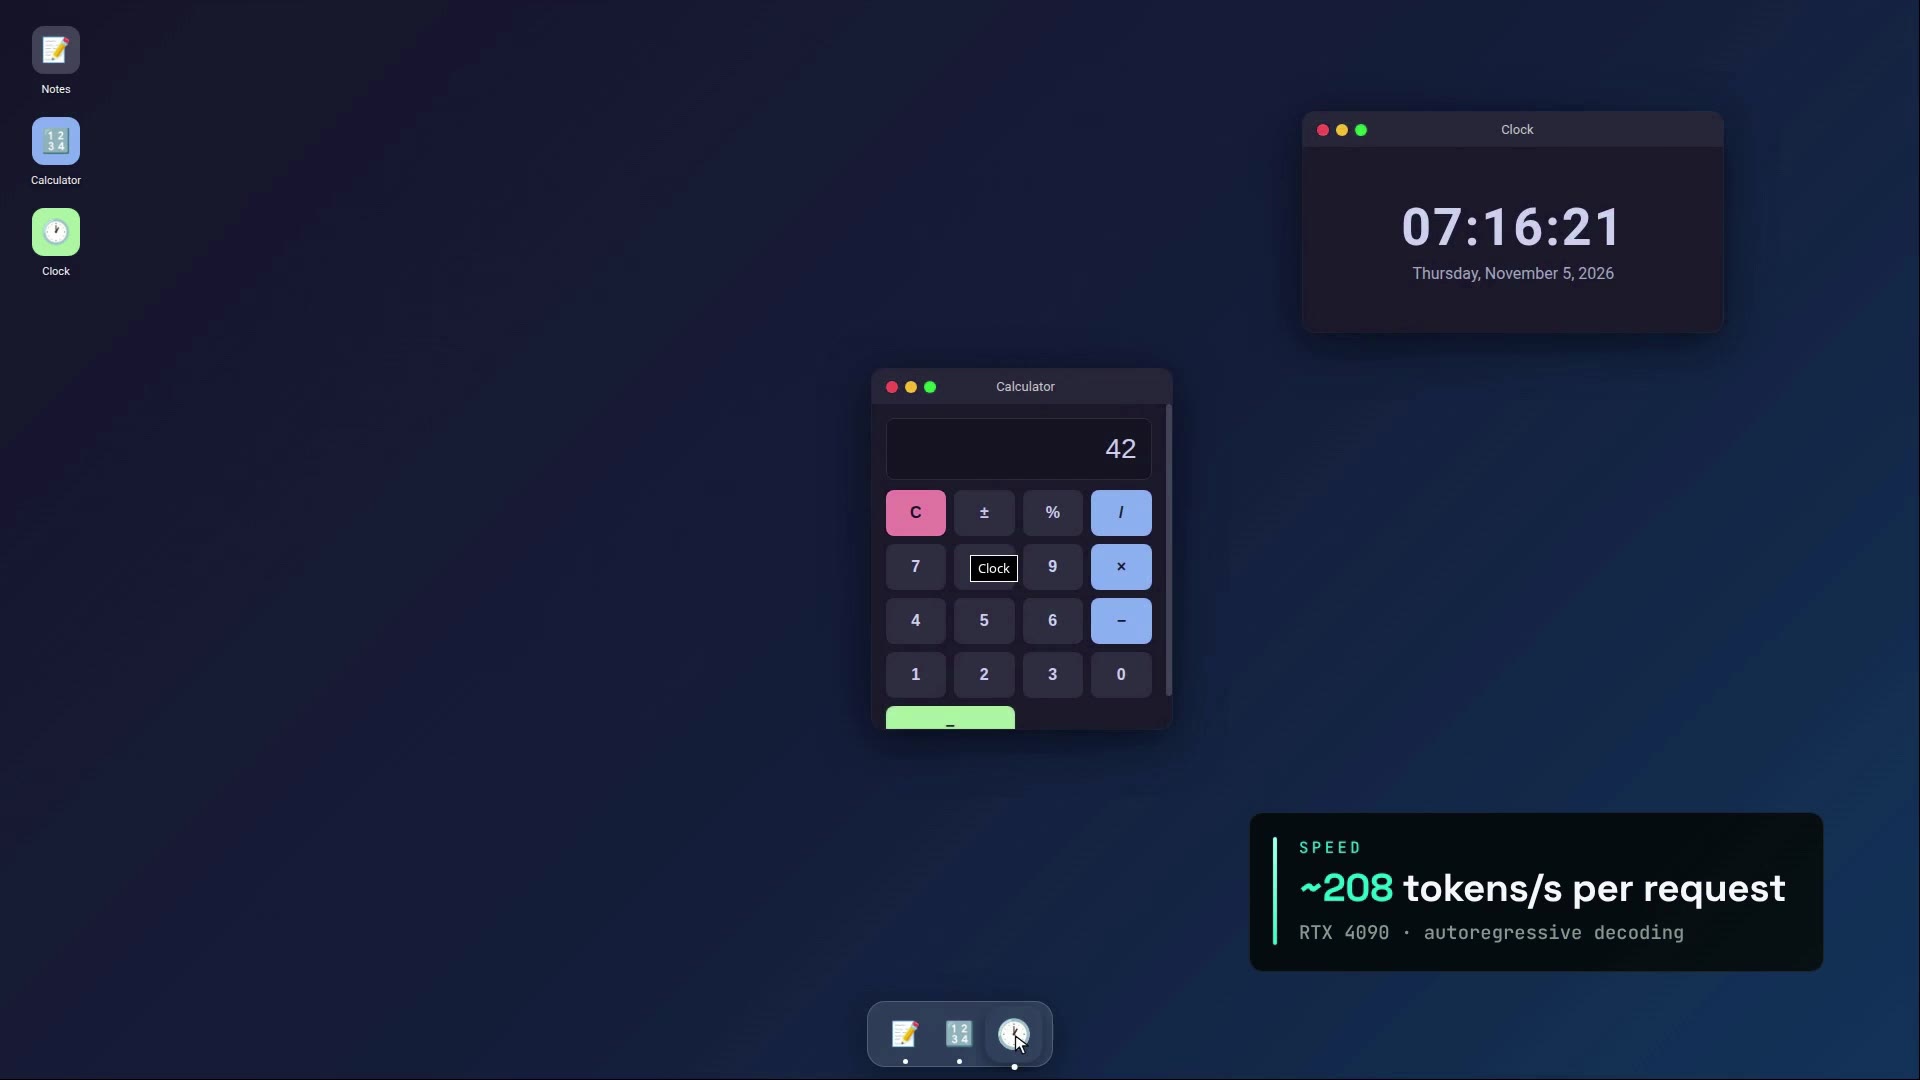
| Un escritorio entero en un fichero HTML (la idea estrella de los autores) | Una página que funciona: dock, ventanas que se arrastran, reloj, notas y una calculadora que dice 7 x 6 = 42 | 20,3 s |
| Un código escondido en un prompt de 89.367 tokens, ventana completa de 128K | Encontrado | 13,45 s |
Dos asperezas que vas a notar:
- Siempre piensa primero. Para "Canberra" es una nota breve para sí mismo. Un ensayo de 400 palabras tardó 22,7 segundos y 4.665 tokens, la mayoría gastados en pensar. Nuestro endpoint todavía no deja pasar el interruptor para desactivar el razonamiento. Es una carencia conocida por nuestra parte, todavía pendiente.
- A la calculadora generada se le corta la tecla "=". La ventana es demasiado baja, así que media tecla queda oculta. La página salió idéntica byte a byte dos veces, defecto incluido.
Qué GPU: con 24 GB va todo, con un presupuesto de 16 GB funcionó a media velocidad
Todos los presupuestos de memoria respondieron bien, y uno de 16 GB mantuvo más o menos la mitad de la velocidad.
El truco para tarjetas más pequeñas es la trastienda de la imagen de los especialistas. llama.cpp puede dejar los expertos de algunas capas en la memoria principal del ordenador (RAM) en vez de en la tarjeta. Cada palabra sigue pasando por ellos, así que va más lento, pero la tarjeta necesita menos memoria.
| Tarjeta o presupuesto de memoria | Cómo se ejecutó | Pico de memoria en la tarjeta | Velocidad | ¿Tarjeta real? |
|---|---|---|---|---|
| RTX 4090 24 GB | todo en la tarjeta | ver arriba | ver arriba | sí |
| Presupuesto de 16 GB | expertos de 10 capas en RAM | 15.456 MiB | unos 102 tokens/s | no |
| Presupuesto de 12 GB | expertos de 22 capas en RAM | 10.270 MiB | unos 65 tokens/s | no |
| Presupuesto de 8 GB | todos los expertos en RAM | 2.494 MiB | unos 43 tokens/s | no |
La fila de 16 GB es la que decide. Entra en 15.456 MiB y sigue escribiendo unos 102 tokens por segundo, así que el despacho de drones tardó 4,4 segundos en vez de 2,2. Los presupuestos de 12 GB y 8 GB también respondieron bien a todo, solo que más despacio.
Las filas marcadas con "no" se ejecutaron en la misma 4090 con la memoria limitada, así que tómalas como una medida de memoria, no como una promesa de velocidad. En una tarjeta real de 16 GB en un ordenador de sobremesa más pequeño, la velocidad dependerá del procesador y la memoria de esa máquina. También necesitas RAM suficiente para los expertos que saques de la tarjeta. No tenemos ningún resultado de una tarjeta real de 16 GB ni de 12 GB.
DiffuSpace da 101,8 tokens por segundo en una RTX 5070 Ti de 16 GB, junto a nuestros 102. La coincidencia es casual: otra tarjeta, otra compresión y un motor sin nombre.
En InferenceKey: fijar una versión, parchear un fichero y una primera compilación de cinco minutos
Nuestra configuración estándar de llama.cpp ejecutó un modelo con un soporte de tres días. No cambiamos el código de la plataforma. Fijamos una versión, parcheamos el fichero y le dimos al worker tres ajustes de compilación de CUDA que todavía no pone por su cuenta (pendiente por nuestra parte, listado en el ejemplo del SDK).
En InferenceKey, un worker es el pequeño programa de tu máquina con GPU que recibe órdenes de la plataforma. Nuestro worker compila llama.cpp él mismo. Su versión por defecto es más antigua y no conoce Clover. Así que le dijimos que usara la versión v0.9.0, y el worker compiló esa versión exacta para la GPU la primera vez. Esa compilación tardó 4 min 50 s. A partir de ahí, pedirle el modelo a la plataforma dio un endpoint listo en 11,7 segundos.
Desde ahí es la misma API al estilo de OpenAI que la de cualquier otro modelo de la plataforma. Las órdenes de drones, las llamadas a herramientas y la página de escritorio de arriba pasaron todas por ella. Esta ejecución usó nuestra propia copia de la plataforma InferenceKey, con el mismo código que el servicio alojado. No hemos llamado al endpoint alojado, así que tómalo como un camino sin probar. Nuestro programa de ejemplo manda el modelo a una máquina que tú eliges, así que la inferencia corre en tu propio hardware. Las peticiones siguen pasando por la plataforma, alojada o tu propia copia.
¿Merece la pena? Sí como modelo de agente en 24 GB, todavía no por la velocidad de difusión
- Quieres un modelo abierto de agente en una tarjeta de 24 GB: merece una prueba. Aplica antes el parche y compáralo con su base Qwen en tus propias tareas.
- Tienes una tarjeta de 16 GB: probablemente sí, con los expertos en RAM, a media velocidad más o menos.
- Quieres la velocidad de difusión que enseña el blog: hoy no en llama.cpp. Sigue la pull request de SGLang, o usa el propio código Python de DiffuSpace en una tarjeta de 80 GB.
- Te importan las puntuaciones de los benchmarks: son las del fabricante, y puede que no se mantengan en modo de un token cada vez. Probamos unos cuantos prompts nuestros y todos salieron bien: un comienzo, no una prueba.
Para repetir el mismo despliegue, el despacho de drones y la página de escritorio en tu propia tarjeta, ejecuta python main.py desde el ejemplo del SDK de Clover-35B-A3B. Necesitas un proyecto de InferenceKey con un token del SDK y una API key. También necesitas un worker NVIDIA privado con 24 GB, con el fichero parcheado una vez con su patch_gguf.py.
Para ingenieros
Créditos
- DiffuSpace: el modelo, los ficheros GGUF oficiales con sus checksums, el blog y las demos del despacho de UAV y del escritorio GenUI. Parte del equipo viene del grupo HKU NLP que hizo Dream 7B (abril de 2025; la familia Dream superó los 2,7 millones de descargas en Hugging Face).
- El equipo Qwen de Alibaba: Qwen3.6-35B-A3B, la base de la que deriva Clover.
- Maphist0: la PR #31306 de llama.cpp, el soporte de Clover en modo AR, validado en CPU con BF16 y en CUDA con H200. Los mantenedores de llama.cpp la fusionaron y publicaron v0.9.0.
- Zirui Wu (WilliamZR): la PR #46927 de SGLang, servicio nativo y decodificación autoespeculativa (abierta).
- AI Search: donde vimos el modelo (vídeo de noticias del 2026-11-01, capítulo en el 49:23), que señaló que el modelo completo pesa 69 GB.
- Nuestra parte: el despliegue a través de la plataforma, el diagnóstico de la incompatibilidad del GGUF y
patch_gguf.py, los prompts y las pruebas, las mediciones, la escalera de VRAM, el ejemplo del SDK y el vídeo de la demo.
Modelo y ficheros
model_typeclover_moe, 40 capas: atención completa cada 4, 30 capas de atención lineal (Gated DeltaNet). Hidden 2048, 16 cabezas / 2 cabezas KV, head_dim 256, 256 expertos enrutados top-8 más 1 compartido, vocabulario de 248.320,max_position_embeddings131072.- Ajustes de difusión en
config.json:block_size32, eliminación de ruido LowConfidence con umbral 0,95. - Valores por defecto de generación: greedy,
presence_penalty0.9,repetition_penalty1.05, más los exclusivos de difusióndllm_length_penalty10.0 (inicio 8192, ventana 8192) ydllm_think_end_bias10.0 (inicio 4096, ventana 4096), que no tienen equivalente en llama.cpp.max_new_tokens24576. - Repo GGUF
Diffuspace/Clover-35B-A3B-Preview-GGUF, sin acceso restringido, apache-2.0, snapshot32e22a02b885e173177b7ce7661ad13448b4f89e(última modificación 2026-10-29). Q4_0 19.586.909.600 B (18,24 GiB), Q4_K_M 22.998.009.248 B, Q8_0 37.863.343.264 B. - sha256 de Q4_0
3e2cf14ca47f6e41c251f08237ac79cd37ad81a2ea2a220fff731e34c66930d5, coincide. - Repo BF16: unos 69 GB de pesos, código propio,
transformers==5.19.0, PyTorch 2.10+. - La tabla de backends del repo de GitHub: Transformers = eliminación de ruido por bloques de difusión; SGLang (#46927) = eliminación de ruido por bloques de difusión y autoespeculativo; llama.cpp (#31306) = autoespeculativo. Ahora mismo el repo solo tiene
README.md,benchmark.pngysft/; el código de los backends "will be added".
Estado del software a 2026-11-05
- PR #31306 fusionada el 2026-11-02T17:37:28Z, commit de merge
e4b6c8ca6a6e8da70248da30709e897e7cc8615e. Su descripción: "in AR mode only. Self-speculative generation for Clover is split into a separate PR." - Primera build con Clover:
b12052(2026-11-02T17:37:44Z). Versiónv0.9.0(2026-11-04T13:08:06Z), notas: "Four new architectures are supported (Clover, Limite, Metis-1.6 and Mistral Large 4)" y "Clover-35B-A3B-Preview diffusion model, AR mode (#31306)". common/arg.cppenv0.9.0: 0 apariciones dedraft-self. No encontramos ninguna PR autoespeculativa de Clover abierta en llama.cpp (las otras PR de Maphist0 son #31706 y #28919).- El inicio rápido de la ficha del GGUF descarga
pull/31306/heady ejecutallama-speculative-simple --spec-type draft-self. Sin cambios a 2026-11-05. No lo ejecutamos. - SGLang #46927: abierta, creada el 2026-10-28, actualizada el 2026-11-04, pendiente de revisión, CI sin ejecutar (sin la etiqueta
run-ci), 42 ficheros. Su validación en una H200: MATH500 96,6 % a 453,59 tokens/s de salida por petición (bloque 16, DP=1, concurrencia 1); DP=4 con concurrencia 8: 95,2 %, 4.268,73 tokens/s agregados, 192,13 por petición.
Lo que dicen los autores (no reproducido)
Del blog (la página sale en chino por defecto; las cifras coinciden con nuestra captura en inglés):
| Benchmark | Clover-35B-A3B-Preview |
|---|---|
| SWE-bench Verified | 73,6 |
| Terminal-Bench 2.1 | 51,7 |
| tau3 Overall | 65,3 |
| GPQA Diamond | 83,8 |
| ZebraLogic | 95,8 |
| AA-LCR | 72,0 |
| BFCL-v4 | 67,9 |
| MMLU-Pro | 84,8 |
- SWE-bench Verified es una prueba con tareas de programación reales.
- En el blog se compara con LLaDA2.2 flash, Mercury 2.5, Qwen3.6-35B-A3B y Qwen3.5-35B-A3B.
- Velocidad: 680 tokens/s en una GB300 con cargas internas de agente; 515 tokens/s en una H200 frente a 365 de un Qwen de tamaño parecido con DFlash2. BF16, batch 1. No dicen el motor ni el modo de decodificación.
- En dispositivo: INT4 en una RTX 5070 Ti de 16 GB, 101,8 tokens/s en MATH-500 frente a 48,5 de modelos MiniCPM y Qwen de tamaño parecido. Motor sin nombrar.
- Demo del despacho de UAV: cinco resultados correctos en 0,97 s; Qwen, en 3,78 s, interpreta la misión de cartografía del UAV5 como médica.
Montaje
- Una RTX 4090 de 24 GB (24.564 MiB, 450 W, compute capability 8.9) en InferenceKey Cloud, host con 32 vCPU y 124 GB de RAM, 100 GB de disco de contenedor.
- Un manager local de InferenceKey (nunca producción) arrancó el worker. Todas las llamadas de la ejecución principal pasaron por
/v1/chat/completionsde ese manager. - Backend: el
llamacppintegrado. El tag de llama.cpp por defecto del worker esb9748, que no tiene Clover, así que hace falta fijar la versión por workload. Lo que se fija por workload pisa el entorno de todo el worker. En NVIDIA con Linux el worker compilallama-servercon-DGGML_CUDA=ONen tiempo de ejecución. - Por qué llama.cpp: de los tres backends que lista DiffuSpace, es el único con soporte fusionado, y el Q4_0 entra en 24 GB. Las otras vías, el código propio de DiffuSpace para Hugging Face Transformers y la rama abierta de SGLang, necesitan unos 69 GB de pesos BF16.
- Las llamadas principales pasaron por el endpoint del manager. La ejecución de 128K y los presupuestos de memoria más pequeños fueron ejecuciones directas de
llama-serveren el mismo worker.
Paso a paso con el ejemplo del SDK
En el host del worker, una vez:
pip install -U "huggingface_hub[hf_xet]" gguf numpy
hf download Diffuspace/Clover-35B-A3B-Preview-GGUF Clover-35B-A3B-Preview-Q4_0.gguf --local-dir /root/models
curl -LO https://raw.githubusercontent.com/inferencekey/inferencekey-sdk/main/examples/clover-35b-a3b-llamacpp-private-nvidia/patch_gguf.py
python ./patch_gguf.py /root/models/Clover-35B-A3B-Preview-Q4_0.gguf /root/models/Clover-35B-A3B-Preview-Q4_0-ar.gguf
En las imágenes de PyTorch con CUDA 13, añade esto al entorno del worker antes de la primera compilación (ver Problemas pendientes, 4):
CUDACXX=/usr/local/cuda/bin/nvcc
PATH=/usr/local/cuda/bin:$PATH
CMAKE_BUILD_PARALLEL_LEVEL=<cores>
Deja el fichero en disco local, no en un montaje de red. Lo que hace patch_gguf.py:
- añade
clover_moe.expert_shared_count= 1; - deja fuera los 120 tensores exclusivos de difusión:
ssm_bd_history.weight,ssm_bd_history.bias,ssm_bd_logit_scale.weightyssm_conv1d.weight_right, 4 por capa GDN (elconversion/clover.pydel proyecto original también los filtra); - reescribe los 30 vectores
blk.N.ssm_acomo-exp(A_log), igual que los escribe elconversion/qwen.pydel proyecto original. El fichero oficial guardaA_logen bruto (en la capa 0,ssm_a[0]= -3,3125 =A_log[0]del checkpoint BF16); - copia byte a byte todos los demás tensores, sin recuantizar, como hace el propio código de conversión del proyecto original. 17 s.
En tu máquina:
git clone https://github.com/inferencekey/inferencekey-sdk
cd inferencekey-sdk/examples/clover-35b-a3b-llamacpp-private-nvidia
cp .env.example .env      # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY, INFERENCEKEY_PROJECT, IK_WORKER_ID
pip install -r requirements.txt   # plus the local SDK build with maturin, see ../CONTRIBUTING.md
python main.py            # IK_KEEP_ALIVE=1 keeps the workload afterwards
Opcional: CLOVER_GGUF (por defecto /root/models/Clover-35B-A3B-Preview-Q4_0-ar.gguf) y CLOVER_CONTEXT (por defecto 16384; 131072 entra en 24 GB).
main.py llama a ensure() sobre un workload llamacpp fijo, asignado a IK_WORKER_ID, con este comando:
INFERENCEKEY_LLAMACPP_TAG=v0.9.0 llama-server -m /root/models/Clover-35B-A3B-Preview-Q4_0-ar.gguf \
  --alias clover-35b-a3b -ngl 99 -fa on -c 16384 --jinja --reasoning-format deepseek \
  --presence-penalty 0.9 --repeat-penalty 1.05
Luego espera a que esté listo, hace una pregunta corta con generate_text(), manda el mensaje de despacho y espera un array JSON, pide la página de escritorio y guarda outputs/desktop.html y outputs/answers.json. Al final llama a delete() salvo que IK_KEEP_ALIVE=1.
Tiempos
| Paso | Tiempo |
|---|---|
| Worker en línea tras crear la máquina | unos 47 s |
Compilación CUDA de llama.cpp v0.9.0 en el worker (-j30, arch 89) | 4 min 50 s |
| Descarga del GGUF (en paralelo con la compilación) | 35 s, unos 560 MB/s |
patch_gguf.py | 17 s |
ensure() hasta listo, ya compilado y con el fichero parcheado en disco local | 11,7 s |
Carga directa del fichero parcheado en llama-server | unos 6 s en frío, de 1,6 a 3,6 s en caliente |
| Primera ejecución en la plataforma con el fichero sin parchear | falló a los 292 s, bootstrap step failed |
Velocidad y salidas (temperatura 0, en streaming por el endpoint salvo que se indique)
| Prueba | Tokens generados | Tiempo | Primer token | Tokens/s de decodificación | Resultado |
|---|---|---|---|---|---|
| "Capital of Australia, one word" x3 | 37 | 0,31 a 0,46 s | 0,13 a 0,28 s | 204 a 211 | Canberra |
Igual con enable_thinking: false | 37 | 0,46 s | 211 | sigue pensando: el gateway descarta chat_template_kwargs | |
| "What is diffusion?" | 1.402 | 6,8 s | 0,13 s | 210 | respuesta de física correcta |
| Ensayo de 400 palabras | 4.665 | 22,7 s | 0,20 s | 207 | hecho |
| Herramientas (Lisboa frente a Oslo) | 206 | 1,29 s | 0,31 s | 210 | dos llamadas get_weather en paralelo, JSON válido, finish tool_calls |
| Despacho (3 pruebas, ejemplo, terminal grabado) | 393 a 403 | 2,10 a 2,28 s | 0,21 a 0,31 s | 208 a 209 | 5 de 5 órdenes bien |
| Escritorio GenUI (ejemplo) | 4.163 | 20,29 s | 208,5 | HTML de 11.880 caracteres, funciona, = cortado | |
| Página explicativa de un eclipse | 11.526 | 56,94 s | 0,14 s | 202,9 | HTML generado, sin revisar a fondo |
| Aguja, prompt de 10.788 tokens, contexto de 16K | 56 | 1,77 s | 1,48 s | 194,5 | 7319-CLOVER |
Aguja, prompt de 89.367 tokens, contexto de 128K (llama-server directo, mismo worker) | 13,45 s | 143,4 | 7319-CLOVER; prefill de 7.363 tokens/s |
Escalera de VRAM
Todas las filas: Q4_0 parcheado, llama.cpp v0.9.0, -ngl 99 -fa on. Solo la primera fila pasó por la plataforma; las demás fueron ejecuciones directas de llama-server en el mismo worker después de borrar el workload. VRAM de pico según nvidia-smi cada segundo.
| Objetivo | Configuración | VRAM de pico | Velocidad; tiempo de despacho | Salida correcta | Tarjeta real |
|---|---|---|---|---|---|
| RTX 4090 24 GB | -c 16384 (ejemplo del SDK, por la plataforma) | 19.572 MiB | 202 a 211 tokens/s; 2,1 a 2,3 s | sí | sí |
| RTX 4090 24 GB | -c 131072, aguja de 89.367 tokens (llama-server directo) | 21.924 MiB | 202 en cortas, 143,4 a 89K; 2,09 s | sí, aguja encontrada | sí |
| Límite de 16 GB | -c 16384 --n-cpu-moe 10 | 15.456 MiB | 101,9 a 102,5; 4,41 s | sí | no, emulada |
| Límite de 16 GB | -c 16384 --n-cpu-moe 14 | 13.728 MiB | 82,7 a 82,9; 5,46 s | sí | no, emulada |
| Límite de 12 GB | -c 16384 --n-cpu-moe 22 | 10.270 MiB | 64,9 a 65,1; 7,03 s | sí | no, emulada |
| Límite de 8 GB | -c 16384 --cpu-moe | 2.494 MiB | 43,1; 10,74 s | sí | no, emulada |
| RTX 5080 16 GB | -c 16384 --n-cpu-moe 10 y 8, dos máquinas en el mismo host | n/d | n/d | descartada | tarjeta real, host roto |
- "Salida correcta" significa Canberra y 5 de 5 órdenes de despacho. Con los expertos en la CPU la redacción del despacho cambia respecto a la ejecución todo en GPU, pero las cinco órdenes salen bien.
- Las filas emuladas se ejecutaron en el host de la 4090 con 16 hilos de CPU para llama.cpp y los expertos de N capas en la RAM del sistema. Miden la memoria de GPU que necesita una tarjeta más pequeña, no su velocidad.
- RTX 5080 16 GB, dos máquinas en el mismo host:
ggml_cuda_init: failed to initialize CUDA: unknown error, luegono usable GPU found, --gpu-layers option will be ignored; torch también lanzóRuntimeError: CUDA unknown error. llama-server corrió en la CPU (unos 22 tokens/s, 1 MiB en la GPU). Descartadas: no hay ninguna cifra real de 16 GB ni de 12 GB. - Sin probar: una tarjeta real de 16 o 12 GB que funcione, este modo en una H200, el modo de difusión en sí, la base Qwen3.6-35B-A3B en la 4090, Q4_K_M, Q8_0, la vía de difusión BF16 con Transformers y la rama de SGLang.
Problemas pendientes
- El GGUF oficial es incompatible con llama.cpp v0.9.0 original.
E llama_model_load: error loading model: error loading model hyperparameters: key not found in model: clover_moe.expert_shared_count; añadiendo solo la clave, 600 xG. Lo sorteamos conpatch_gguf.pyen el ejemplo del SDK. Pendiente en el proyecto original: hay que regenerar los ficheros con el conversor oficial, o que llama.cpp acepte el formato del fork. No hemos abierto ninguna incidencia en el proyecto original. - Las instrucciones de la ficha del GGUF usan una opción que el proyecto original no tiene.
--spec-type draft-selfno existe en v0.9.0. No lo ejecutamos. Pendiente. - Ningún resultado real de 16 GB. Host roto, ver la escalera. Pendiente.
- La compilación CUDA del worker necesita variables de entorno que el bootstrap no pone en imágenes con
nvccfuera delPATH(las imágenes de PyTorch con CUDA 13); si no,cmake configure failed. Solución provisional en el entorno del worker:CUDACXX=/usr/local/cuda/bin/nvcc,PATH=/usr/local/cuda/bin:$PATH,CMAKE_BUILD_PARALLEL_LEVEL=<cores>, másINFERENCEKEY_LLAMACPP_READY_TIMEOUT_SECSpara la primera compilación. Sigue pendiente en el worker. - El gateway descarta
chat_template_kwargs, así que el razonamiento no se puede desactivar por petición. Conocido, pendiente. - La ventana de la calculadora generada es demasiado baja, con la tecla
=medio cortada. Un defecto de la salida del modelo, reproducible a temperatura 0.
Vídeo de la demo
La demo narrada de 173 segundos: primero los benchmarks y las demos de los autores (con el crédito a DiffuSpace), luego nuestro despliegue en el panel, el despacho y la página de escritorio en la RTX 4090, y la escalera de memoria.
Fuentes
- Diffuspace/Clover-35B-A3B-Preview (ficha del modelo, config y configuración de generación).
- Diffuspace/Clover-35B-A3B-Preview-GGUF.
- DiffuSpace/Clover-35B-A3B-Preview en GitHub.
- Artículo del blog de DiffuSpace.
- PR #31306 de llama.cpp y las notas de la versión v0.9.0.
- PR #46927 de SGLang.
- Vídeo de noticias de AI Search, 2026-11-01 (donde lo vimos).
- Ejemplo del SDK, commit
f10c3749717c0d7fcfd58fa8c3be5c1d7dc2ef35.