Nanbeige4.3-33B: un 33B denso a 42 tokens/s en 24 GB, y en 3 bits para 16 GB
Un modelo de agente denso de 33B en una tarjeta de 24 GB: 42 tokens/s, llamadas a herramientas limpias y 64K de contexto. En 3 bits va a 14 tokens/s en 16 GB.
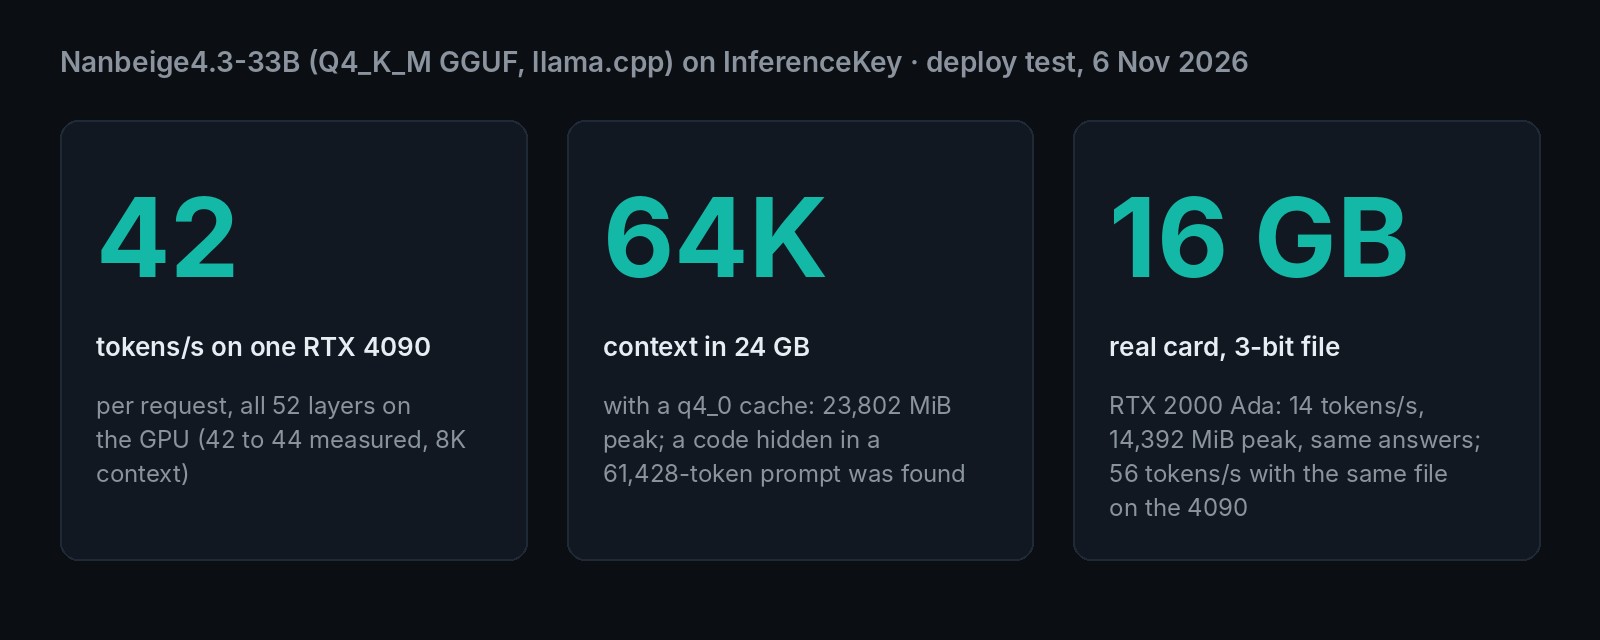
¿Qué tarjeta necesitas para un modelo de programación de 33B parámetros que los usa todos en cada palabra? Probamos Nanbeige4.3-33B, un modelo con licencia Apache-2.0, en una sola RTX 4090 de 24 GB alquilada en nuestra nube. Con un fichero comprimido a 4 bits escribió unos 42 tokens por segundo. Sus llamadas a herramientas volvieron válidas en todos nuestros intentos. La 4090 también aguantó un prompt de 64K tokens, unas 50.000 palabras. Una tarjeta de estación de trabajo real de 16 GB pasó nuestras pruebas con un fichero de 3 bits, a unos 14 tokens por segundo. Sus autores lo ponen por delante de Qwen3.8-27B en dos de tres pruebas de programación con agentes. Toda la prueba está empaquetada como ejemplo del SDK para tu propia tarjeta. Un problema serio: cuando el modelo razona antes de responder (lo que hace por defecto), su respuesta final como agente volvió vacía en 2 de 3 ejecuciones.
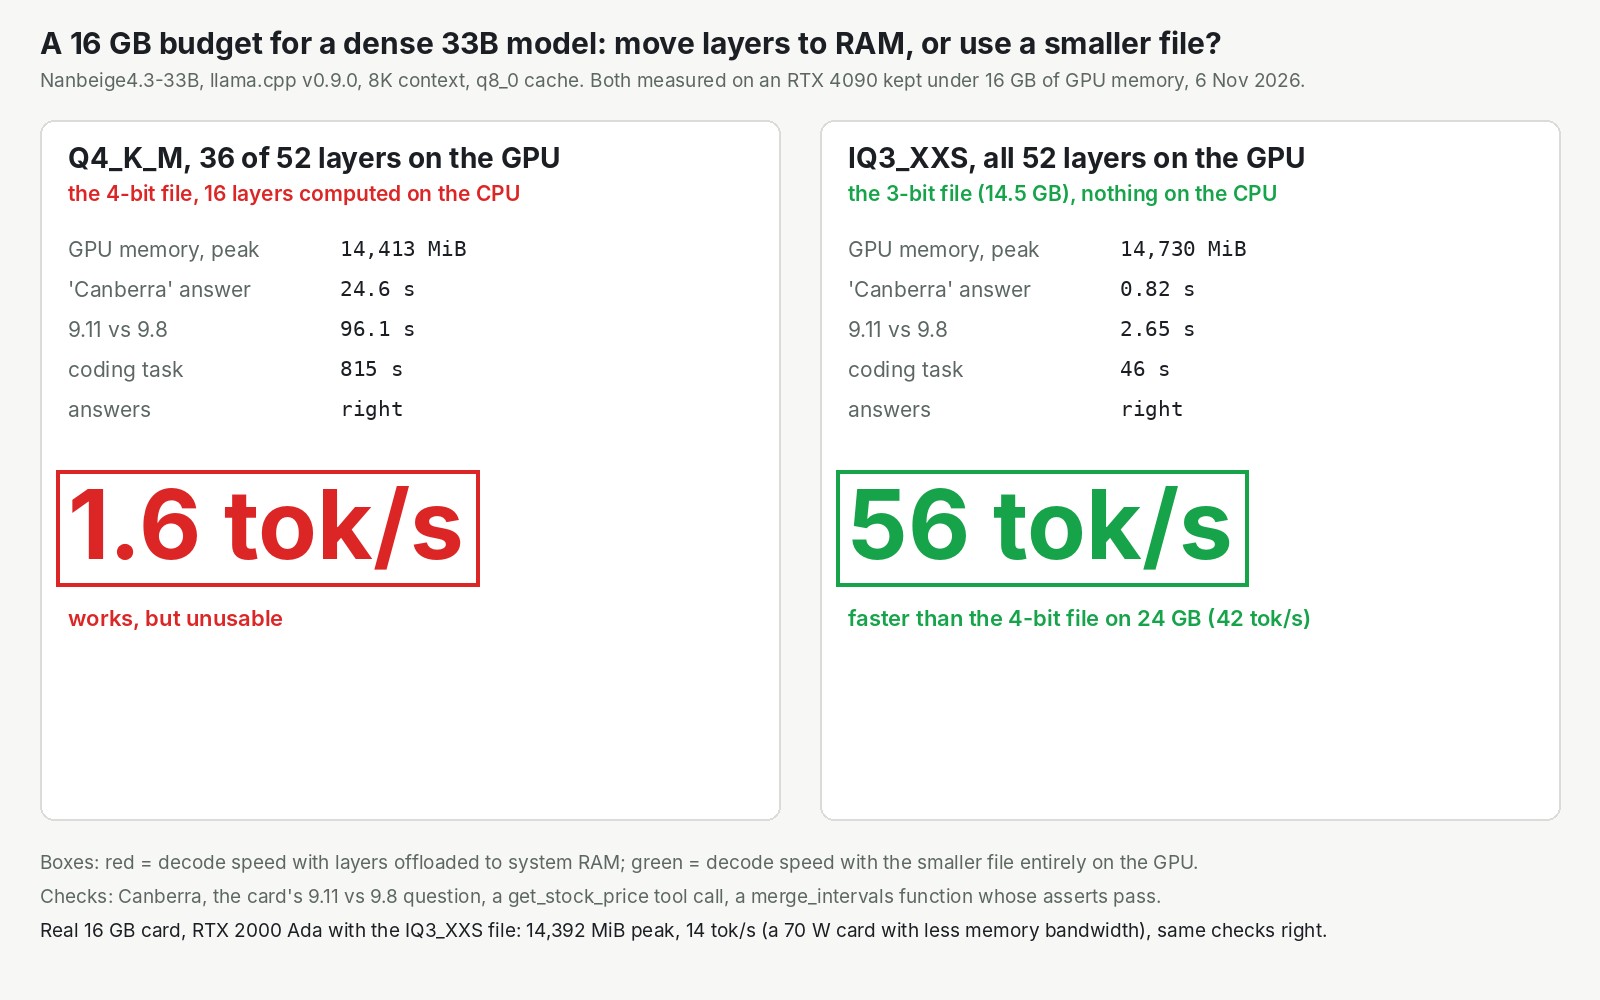
Esa imagen es la decisión para quien tenga menos de 24 GB.
Un 33B denso paga por cada parámetro en cada palabra
Para escribir cada palabra, la tarjeta tiene que leer el fichero del modelo entero desde su propia memoria, y el fichero ocupa 20,8 GB. Esa lectura marca el techo de velocidad. Un fichero más pequeño significa menos que leer y más palabras por segundo. Lo que se quede fuera de la memoria de la tarjeta se lee muchísimo más despacio, y la velocidad se hunde.
Ese es el precio de ser denso. Los modelos de agente que probamos antes, como Groot-19B y Clover-35B-A3B, funcionan de otra manera. Imagina una big band en la que, en cada compás, solo tocan unos pocos solistas y el resto descansa. Un modelo de 35B de ese estilo puede usar solo 3B por palabra, así que es rápido. Nanbeige4.3-33B es denso: toca la banda entera en cada compás. Los 33B parámetros trabajan en cada token.
El modelo se subió a Hugging Face el 24 de octubre. Sus autores lo llaman el "profesor" de la serie: modelos más pequeños aprenderán de él más adelante. Dicen que tiene "state-of-the-art agentic performance among open models in the ~30B parameter class". Su página indica prompts de hasta 512K tokens. Nosotros llegamos a 64K. Razona antes de responder por defecto, y cualquiera puede descargarlo sin pedir permiso.
Los autores lo comparan con tres modelos abiertos de tamaño parecido. Estas son sus cifras, medidas igual para todos los modelos, con el razonamiento al máximo. No las reprodujimos.
| Prueba (cifras de los autores) | Nanbeige4.3-33B | Qwen3.8-27B |
|---|---|---|
| Terminal-Bench 2.1, trabajo de agente en una línea de comandos | 80,9 | 73,0 |
| DeepSWE, ingeniería de software con agentes | 65,5 | 42,5 |
| SWE-Bench Pro, arreglar incidencias reales en código real | 60,3 | 61,7 |
La tercera fila es una derrota, y los autores la publican, junto con otras dos derrotas en otras pruebas. Claude, GPT y otros modelos cerrados no están en la tabla.
Lo difícil es el tamaño. Sin comprimir, el modelo ocupa 66 GB. Las recetas de servicio de los propios autores reparten el modelo entre cuatro GPU y no dicen nada de moverlo en una. bartowski publicó versiones comprimidas de un solo fichero para llama.cpp, un programa gratuito para ejecutar modelos por tu cuenta. Esos ficheros ya suman 123.000 descargas.
Nuestra prueba: un fichero de 4 bits, una tarjeta de 24 GB, nuestros propios prompts
Usamos el fichero de 4 bits que recomienda bartowski (20,8 GB). Funcionó en una RTX 4090, con el modelo entero en la tarjeta, sobre nuestra configuración de serie de llama.cpp. Casi todas las pruebas pasaron por la misma API de estilo OpenAI a la que llamaría un producto.
Nuestras pruebas fueron pequeñas. Pedimos una respuesta de una palabra, la pregunta de si es mayor 9,11 o 9,8 que aparece en la propia página del modelo y una tarea de programación con sus propios tests. También probamos dos llamadas a herramientas y una palabra secreta escondida en prompts largos. Una llamada a herramienta es el modelo pidiendo a tu código que ejecute una función: aquí, el precio de una acción y una consulta del tiempo para dos ciudades a la vez.
Los límites: una petición cada vez, nuestros propios prompts en lugar de los benchmarks de los autores, dos tarjetas reales, nada por encima de 64K y no la configuración de servidor con cuatro GPU de los autores. Probamos llamadas sueltas a herramientas y un turno de agente, no un agente trabajando sobre una base de código. Interpretamos las llamadas a herramientas con llama.cpp, no con el parser qwen3_coder que la página del modelo recomienda para vLLM y SGLang. Esa vía está sin probar.
Unos 42 tokens por segundo en una RTX 4090, con llamadas a herramientas válidas
En la 4090 el modelo escribió de 42 a 44 tokens por segundo con una petición. El primer token llegó en entre un cuarto y medio segundo con prompts cortos. En términos de lectura, un párrafo largo aparece en unos cuatro segundos.
| Lo que pedimos | Lo que volvió | Tiempo |
|---|---|---|
| "Capital de Australia, una palabra" | Canberra, tras pensar un poco | unos 1,2 s |
| "¿Qué número es mayor, 9,11 o 9,8?" | 9,8, con la posición decimal explicada, en las dos ejecuciones | de 3,6 a 4,6 s |
| Una tarea de programación con sus propios tests | Código que funciona, tests en verde | 24,6 s |
| Una herramienta de precio de acciones | get_stock_price({"symbol":"AAPL"}), válida | unos 2,2 s |
| "¿Hace más calor en Lisboa o en Oslo?" | Dos llamadas al tiempo a la vez, las dos válidas | de 2,8 a 3,0 s |
| Lo mismo, cuando volvieron los resultados de las herramientas | "Lisbon is warmer ... 19°C ... 4°C" (ver más abajo) | 3,1 s |
Cada llamada a herramienta volvió en el formato estándar de OpenAI, válida en los dos intentos por llamada en la 4090.
Para un desarrollador que maneja un agente, esa velocidad es cómoda.
64K de contexto entran en 24 GB, y la escritura se frena según se llena
La 4090 aguantó un prompt de 64K tokens y encontró una palabra secreta escondida en el token 61.428. Para que entrara, la memoria que guarda del prompt tuvo que comprimirse a una cuarta parte de su tamaño, y la escritura bajó a 16 tokens por segundo.
Además del modelo, la tarjeta guarda notas de todo lo que el modelo ha leído hasta el momento, y crecen con cada token. Con notas a tamaño completo, el tope está en 16K. A la mitad se llega a 32K, y a una cuarta parte a 64K, con menos de 1 GB libre en la tarjeta.
| Contexto | Notas comprimidas a | Memoria pico (MiB) | Palabra secreta encontrada en | La respuesta tardó | Velocidad de escritura a esa profundidad |
|---|---|---|---|---|---|
| 16K | sin comprimir (16 bits) | 23.186 | 14.909 tokens | 7,9 s | 37 tokens/s |
| 32K | 8 bits | 23.434 | 30.734 tokens | 18,8 s | 25 tokens/s |
| 64K | 4 bits | 23.802 | 61.428 tokens | 49,1 s | 16 tokens/s |
Las tres encontraron la palabra. Con 64K, la escritura va a menos de la mitad de la velocidad con prompts cortos, porque cada palabra nueva también lee 61.000 tokens de notas.
Qué GPU: una tarjeta real de 16 GB funciona con el fichero de 3 bits, a unos 14 tokens por segundo
La tarjeta más pequeña que pasó es una real: una RTX 2000 Ada, una tarjeta de estación de trabajo de 16 GB y 70 vatios, con el fichero de 3 bits de bartowski. Pasó las mismas pruebas a un tercio de la velocidad de la 4090, así que una respuesta de 400 tokens tarda unos 30 segundos en lugar de 10.
| Tarjeta o límite de memoria | Fichero y configuración | Memoria pico (MiB) | Velocidad | Pruebas | ¿Tarjeta real? |
|---|---|---|---|---|---|
| RTX 2000 Ada 16 GB | 3 bits, 8K, notas de 8 bits | 14.392 | de 13,6 a 14,4 tokens/s | todas bien | sí |
| Límite de 16 GB | 3 bits, todo en la tarjeta | 14.730 | 56,5 tokens/s | todas bien | no, ejecutado en la 4090 |
| Límite de 16 GB | 4 bits, un tercio fuera de la tarjeta | 14.413 | 1,6 tokens/s | bien, inutilizable | no, ejecutado en la 4090 |
| Límite de 12 GB | 2 bits, 8K | 10.670 | 74,9 tokens/s | una explicación errónea | no, ejecutado en la 4090 |
Lee las filas con "no" como medidas de memoria, no como promesas de velocidad. Cada una se ejecutó en la 4090 completa de 24 GB, sin límite de memoria, y su pico quedó por debajo del límite. Allí el fichero de 3 bits fue a 56,5 tokens por segundo, porque hay menos que leer. La tarjeta real de 16 GB lo movió a 14, porque lee su memoria mucho más despacio.
El fichero de 2 bits, cuyo pico quedó por debajo de 12 GB en la 4090, acertó las cifras pero dijo que el 8 de 9,8 está "in the hundredths place", en las centésimas. Está en las décimas. Un fallo en cuatro pruebas basta para mantener los 2 bits lejos del código.
El problema con el que te vas a topar: las respuestas caen en el canal de razonamiento y vuelven vacías
Con el razonamiento encendido, que es lo que viene por defecto, algunas respuestas llegan vacías. La respuesta entera queda en el campo de razonamiento del modelo. Estado: abierto.
Pasó en todas las redacciones de 400 palabras que pedimos, tres de tres. También afectó a la respuesta final corta del agente tras los resultados del tiempo en dos de tres ejecuciones, una en cada tarjeta. Las respuestas cortas sueltas y las propias llamadas a herramientas nunca se vieron afectadas.
La plantilla de prompt del modelo abre un bloque de razonamiento, el modelo a veces responde sin cerrarlo, y llama.cpp archiva toda la respuesta como razonamiento. Cuando enviamos la petición directamente a llama.cpp con el razonamiento apagado, la redacción llegó en la respuesta normal, con sus 3.151 caracteres.
A través de InferenceKey, ese interruptor por petición todavía no pasa: nuestro endpoint lo descarta. Ese hueco es nuestro y sigue abierto. Hasta que se arregle, un ajuste del servidor en el comando de arranque (en el apéndice) debería apagar el razonamiento para todas las peticiones. No lo hemos ejecutado, así que su efecto en la respuesta final del agente está sin probar. Los autores midieron sus resultados con el razonamiento al máximo y recomiendan mantenerlo para agentes. El ejemplo del SDK también señala una respuesta vacía y muestra el texto del campo de razonamiento.
Una cosa menor: si no le das al modelo instrucciones de sistema, su plantilla añade las suyas, en chino. Dicen que el modelo es Nanbeige, hecho por BOSS Zhipin. No hicieron daño en nuestras pruebas, pero envía las tuyas.
En InferenceKey: listo en cinco minutos, casi todos compilando
La tarjeta es tuya por horas, y nuestra configuración estándar de llama.cpp movió este modelo sin cambios en la plataforma. Fijamos un número de versión y escribimos un comando de arranque.
En InferenceKey, un worker es el pequeño programa de tu máquina con GPU que recibe órdenes de la plataforma. El nuestro compila llama.cpp para la GPU concreta la primera vez que se le pide. En la 4090 el despliegue estuvo listo 303,7 segundos después de pedirlo. Casi todo ese tiempo fue esa compilación, unos cinco minutos. El fichero de 20,8 GB se había descargado en paralelo en 15 segundos, y cargarlo llevó unos 4. Una vez compilado, relanzar llama.cpp con el fichero en caché estuvo listo en 3 a 5 segundos.
En la máquina con la RTX 2000 Ada la misma compilación tardó 19 minutos y 50 segundos, porque los procesadores de ese host estaban limitados. Estuvo listo tras unos 20 minutos. Cuenta con un primer arranque lento en un host pequeño: todavía nos falta un llama.cpp ya compilado para NVIDIA.
Esta prueba usó nuestra propia copia local de la plataforma InferenceKey, con el mismo código que el servicio alojado. El ejemplo del SDK envía el modelo a una máquina que tú eliges, así que los pesos y la inferencia se quedan en tu hardware.
¿Deberías usarlo? Merece una prueba en 24 GB, si de momento puedes vivir con respuestas de agente vacías
- Tienes una tarjeta de 24 GB y quieres un modelo de agente abierto para programar: merece la pena probarlo. Contrasta los resultados de los autores con tus propias tareas.
- Necesitas prompts largos: hasta 64K en una tarjeta de 24 GB, más lento según se llena.
- Tienes una tarjeta de 16 GB: usa el fichero de 3 bits entero en la tarjeta, nunca el de 4 bits con un tercio fuera. La velocidad depende de la memoria de tu tarjeta.
- Lo usas hoy como agente: cuenta con respuestas finales vacías con el razonamiento encendido. Apagar el razonamiento en el servidor debería arreglarlo.
Para ejecutar las mismas pruebas en tu propio worker NVIDIA de 24 GB, lanza python main.py desde el ejemplo del SDK de Nanbeige4.3-33B. Necesita un proyecto, un token del SDK y una API key, y borra el despliegue al terminar.
Para ingenieros
Créditos
- El equipo de Nanbeige (BOSS Zhipin): el modelo, el modelo base, las fichas del modelo, la tabla de benchmarks y la plantilla de chat con llamadas a herramientas en XML al estilo de Qwen3-Coder. Publicado el 2026-10-24 con licencia Apache-2.0.
- bartowski: las cuantizaciones GGUF con imatrix (llama.cpp b11845) que usamos: Q4_K_M, IQ3_XXS e IQ2_XXS.
- axteam: una versión NVFP4A16 para vLLM (no la probamos).
- Los mantenedores de llama.cpp: el servidor, el soporte de plantillas
--jinjaque interpretó las llamadas a herramientas en XML y la versión v0.9.0. - AI Search: donde vimos el modelo (vídeo de noticias del 2026-11-01, capítulo en el 43:03), que señalaba el tamaño de 66,3 GB y "quite some high-end hardware".
- Nuestra parte: el despliegue a través de la plataforma, las pruebas y los prompts, la escalera de memoria en dos tarjetas reales más tres ejecuciones en la 4090 dimensionadas para límites de 16 y 12 GB, el diagnóstico del problema de las respuestas vacías, el ejemplo del SDK y el vídeo de la demo.
Modelo y ficheros
Nanbeige/Nanbeige4.3-33B: shadf919e1e, modificado por última vez el 2026-10-28, 33.118.977.024 parámetros BF16, unos 66,3 GB en 14 fragmentos, 19.178 descargas y 1.052 likes el 2026-11-06. Modelo baseNanbeige4.3-33B-Base: shae061adde.- Arquitectura:
LlamaForCausalLMdenso, 52 capas, 56 cabezas de atención, 8 cabezas KV, head_dim 128, hidden 7168, FFN 22016, vocabulario de 166.912,max_position_embeddings524.288,rope_theta1.2e8. bartowski/Nanbeige_Nanbeige4.3-33B-GGUF: sha9beb6842, creado el 2026-10-25, 123.000 descargas. Q4_K_M 20,79 GB, Q4_K_S 19,74 GB, IQ4_XS 18,64 GB, IQ3_XXS 14,49 GB, IQ2_XXS 10,07 GB, Q5_K_M 25,07 GB, Q8_0 35,20 GB, bf16 66,24 GB. Q4_K_M usado: 20.788.825.216 B, sha2562cef7985..., que coincide con el hash LFS de Hugging Face.axteam/Nanbeige4.3-33B-NVFP4A16: W4A16 FP4 para vLLM, unos 22,1 GB, probado por su autor en vLLM 0.32.0 solo en B200, con una media propia de lm-eval del 98,9 % de BF16. No lo probamos.- Caché KV en f16: 52 x 8 x 128 x 2 x 2 B = 208 KiB por token (8K son 1,6 GiB, 32K son 6,5 GiB).
q8_0aproximadamente la mitad,q4_0aproximadamente una cuarta parte. - Dimensionado aproximado a partir de las notas del vídeo de origen (una estimación, no medido): unos 80 GB para servir BF16, unos 40 GB a 8 bits, unos 20 GB a 4 bits.
Lo que dicen los autores (no reproducido)
Nanbeige4.3-33B / Qwen3.8-27B / Muse-Glimmer-30B / Gemma4-31B, máximo esfuerzo de razonamiento, mismo arnés, preserve_thinking=true:
| Benchmark | Nanbeige4.3-33B | Qwen3.8-27B | Muse-Glimmer-30B | Gemma4-31B |
|---|---|---|---|---|
| Terminal-Bench 2.1 (Terminus 2) | 80,9 | 73,0 | 61,8 | 47,2 |
| Terminal-Bench 4.0 | 23,8 | 6,3 | 1,6 | 0,0 |
| DeepSWE | 65,5 | 42,5 | 4,4 | 2,7 |
| SWE-Bench Pro | 60,3 | 61,7 | 51,2 | 36,9 |
| JobBench | 44,8 | 34,5 | 16,6 | 9,0 |
| GDPval | 84,8 | 86,4 | 75,8 | 71,4 |
| GPQA Diamond | 89,5 | 89,2 | 83,5 | 91,3 |
| AIME 2026 | 95,2 | 94,5 | 94,7 | 89,2 |
| AA-LCR | 84,0 | 82,0 | 83,3 | 72,0 |
Además, Nanbeige frente a Qwen: SWE-Atlas-QnA 50,8 frente a 41,9, NL2Repo 53,0 frente a 48,3, SkillsBench 61,1 frente a 56,4, Automation Bench 54,2 frente a 38,3, Toolathlon-Verified 70,4 frente a 68,5, Tau3-Bench 48,8 frente a 48,5. Modelo base frente a Gemma4-31B-Base: MMLU-Pro 66,9 frente a 59,3, GPQA 62,0 frente a 41,5, SuperGPQA 45,6 frente a 33,8, GSM8K 92,9 frente a 88,9, Math 57,3 frente a 43,6, MBPP 74,6 frente a 72,5, MMLU 85,5 frente a 84,2, CMMLU 86,8 frente a 76,9.
Una incoherencia en la ficha: JobBench de Muse-Glimmer-30B es 16,6 en la tabla y en el mapa de calor por ocupaciones, y 18,3 en la gráfica de barras. Los autores solo se comparan con modelos abiertos de unos 30B; las clasificaciones de terceros de Terminal-Bench 2.1 usan otros arneses, así que no hacemos ninguna comparación con los modelos punteros.
Notas de uso de la ficha: razonamiento encendido por defecto (enable_thinking); preserve_thinking recomendado para uso de herramientas en varios turnos; formato de herramientas xml (por defecto) o json; muestreo 1,0 / 0,95 (hasta 65.536 tokens nuevos) para agentes y herramientas, 0,6 / 0,95 (hasta 262.144) para razonamiento y chat. Recetas de SGLang y vLLM: tensor parallel 4, --reasoning-parser qwen3 --tool-call-parser qwen3_coder (vLLM también --enable-auto-tool-choice, --gpu-memory-utilization 0.8).
Montaje
- GPU en InferenceKey Cloud: RTX 4090 de 24 GB (450 W, compute capability 8.9) para la prueba principal; RTX 2000 Ada de 16 GB (70 W) para el peldaño real de 16 GB.
- Backend: el backend
llamacppintegrado,INFERENCEKEY_LLAMACPP_TAG=v0.9.0(el GGUF se hizo con b11845, y el valor por defecto del worker es más antiguo). Arquitectura Llama, así que cualquier tag reciente lo carga; v0.9.0 es más nueva que la build del cuantizador. - Por qué llama.cpp y no vLLM: las recetas de la ficha dan por hecho cuatro GPU en BF16, y la vía GGUF es la que entra en 24 GB. El parser
qwen3_coderno se probó;--jinjade llama.cpp convirtió las llamadas a herramientas en XML entool_callsde OpenAI. - Enrutado: las pruebas cortas, el ejemplo del SDK y las pruebas de la RTX 2000 Ada pasaron por el endpoint de estilo OpenAI; los peldaños de contexto largo y de límite de memoria fueron directos a llama-server en el pod.
- Un manager local de InferenceKey (el mismo código que el servicio alojado) con dos workers. Producción no se tocó.
- Muestreo: los valores de la ficha, 0,6 / 0,95 para chat y 1,0 / 0,95 para herramientas. Peldaños de la escalera con semilla 42.
Paso a paso con el ejemplo del SDK
- Clona inferencekey-sdk y abre
examples/nanbeige43-33b-agent-llamacpp-private-nvidia(commit10209c3596fe1fd28dd63a30442eb543e6a456cc). cp .env.example .envy rellenaINFERENCEKEY_SDK_TOKEN,INFERENCEKEY_API_KEY,INFERENCEKEY_PROJECTeIK_WORKER_ID(un worker NVIDIA privado con 24 GB). Opcional:NANBEIGE_CONTEXT(8192 por defecto),NANBEIGE_KV_TYPE(f16por defecto),NANBEIGE_GGUF_FILE,IK_KEEP_ALIVE=1.pip install -r requirements.txtmás la build local del SDK con maturin (consultaexamples/CONTRIBUTING.mden el repo del SDK).- Si la imagen del worker tiene
nvccfuera delPATH(las imágenes de PyTorch con CUDA 13), pon esto en el entorno del worker y reinícialo:
CUDACXX=/usr/local/cuda/bin/nvcc
PATH=/usr/local/cuda/bin:$PATH
CMAKE_BUILD_PARALLEL_LEVEL=<number of CPU cores>
python main.py. Haceensure()de un workloadllamacppfijo (task_typetext2text,ExecutionPolicy.FIXED) asignado a tu worker, espera hasta 3.600 s, hace la pregunta de la ficha congenerate_text(), hace la llamada aget_stock_price, ejecuta el turno de agente del tiempo con dos llamadas, escribeoutputs/answers.jsony llama adelete()salvo conIK_KEEP_ALIVE=1.
El comando de arranque que ejecuta el backend:
INFERENCEKEY_LLAMACPP_TAG=v0.9.0 llama-server \
  -hf bartowski/Nanbeige_Nanbeige4.3-33B-GGUF \
  --hf-file Nanbeige_Nanbeige4.3-33B-Q4_K_M.gguf \
  --alias nanbeige4.3-33b -ngl 99 -fa on \
  -c 8192 -ctk f16 -ctv f16 \
  --jinja --reasoning-format deepseek
Para 32K usa -c 32768 -ctk q8_0 -ctv q8_0; para 64K, -c 65536 -ctk q4_0 -ctv q4_0. Para una tarjeta de 16 GB pon NANBEIGE_GGUF_FILE=Nanbeige_Nanbeige4.3-33B-IQ3_XXS.gguf y NANBEIGE_KV_TYPE=q8_0. Lo esperado para evitar respuestas vacías: añadir --chat-template-kwargs '{"enable_thinking":false}' (razonamiento apagado para todas las peticiones). Sin probar: nunca arrancamos con este flag, y el turno final del agente no se volvió a ejecutar con el razonamiento apagado; la calidad como agente con el razonamiento apagado no está medida.
Tiempos
| Paso | RTX 4090 | RTX 2000 Ada |
|---|---|---|
De ensure() a listo, worker nuevo | 303,7 s | 1.203,6 s |
| Compilación CUDA de llama.cpp v0.9.0 | unos 5 min (32 trabajos en paralelo) | 19 min 50 s (host con CPU limitada, 48 vCPU visibles, carga de unos 7) |
| Descarga del GGUF (adelantada en paralelo, fuera del camino hasta listo) | 15 s (Q4_K_M) | 20 s (IQ3_XXS) |
| Carga del modelo | unos 4 s | |
| Relanzamiento de llama-server en el pod (binario compilado, fichero en caché; no es un despliegue de la plataforma) | de 2,7 a 4,5 s |
Velocidad y salidas (RTX 4090, Q4_K_M, 8K, caché f16, streaming a través del endpoint)
| Prueba | Tokens generados | Segundos | Primer token (s) | Decode (tokens/s) | Resultado |
|---|---|---|---|---|---|
| Capital de Australia x2 | 40 / 40 | 1,19 / 1,27 | 0,28 / 0,37 | 43,7 / 44,4 | Canberra |
| 9,11 o 9,8 | 183 | 4,55 | 0,28 | 42,9 | bien, posición decimal explicada |
merge_intervals + 3 asserts | 1.026 | 24,62 | 0,43 | 42,4 | los asserts pasan |
| Redacción de 400 palabras x3 | 641 / 552 / 591 | 15,4 / 13,2 / 14,2 | de 0,26 a 0,37 | 42,6 | content vacío, todo en reasoning_content |
get_stock_price | 72 | 2,17 | 0,50 | 43,2 | {"symbol":"AAPL"}, finish tool_calls |
| Lisboa u Oslo | 101 | 2,82 | 0,47 | 43,0 | dos llamadas get_weather en paralelo |
| Aguja, prompt de 6.142 tokens | 81 | 4,65 | 2,65 | 40,4 | encontrada |
chat_template_kwargs enable_thinking=false a través del endpoint | 40 | 2,16 | 1,24 | 43,5 | el gateway lo descarta, sigue razonando |
Ejecución del ejemplo del SDK en la 4090: pregunta de la ficha 3,6 s; llamada de acciones 2,27 s; paso 1 del agente (dos llamadas) 2,97 s; paso 2 3,12 s a 44,3 tokens/s, respuesta correcta. Pico de consumo 448,6 W.
Contexto largo en la 4090: prefill de 2.514 / 2.038 / 1.544 tokens/s con 14.909 / 30.734 / 61.428 tokens; respuestas cortas a unos 41 o 42 tokens/s en las tres configuraciones.
RTX 2000 Ada a través del endpoint: Canberra de 2,9 a 3,1 s, pregunta de la ficha 8,65 s (14,0 s en la ejecución del ejemplo) bien, llamada de acciones de 4,64 a 5,26 s, dos llamadas al tiempo en paralelo de 8,09 a 8,23 s, merge_intervals 1.398 tokens en 102,7 s con los asserts pasando, respuesta final del agente vacía (problema 1). Pico de consumo 69,8 W, en su límite de 70 W.
Escalera de VRAM
VRAM pico de nvidia-smi. Los peldaños emulados se ejecutaron en la 4090 completa de 24 GB sin ningún límite de memoria; el pico de la configuración quedó por debajo del límite. Pruebas: Canberra, 9,11 frente a 9,8, la llamada a get_stock_price y merge_intervals con sus propios asserts.
| GPU o límite | Configuración | VRAM pico | Velocidad | Salida correcta | Real o emulada |
|---|---|---|---|---|---|
| RTX 4090 24 GB | Q4_K_M, 8K, f16 (el ejemplo, a través del endpoint) | 21.907 MiB | de 42 a 44 tokens/s; Canberra 1,2 s | sí | real |
| RTX 4090 24 GB | Q4_K_M, 16K, f16 | 23.186 MiB | 42,1; aguja en 14.909 tokens 7,9 s, 37,3 a esa profundidad | sí | real |
| RTX 4090 24 GB | Q4_K_M, 32K, q8_0 | 23.434 MiB | 41,3; aguja en 30.734 tokens 18,8 s, 24,6 a esa profundidad | sí | real |
| RTX 4090 24 GB | Q4_K_M, 64K, q4_0 | 23.802 MiB | 41,2; aguja en 61.428 tokens 49,1 s, 16,4 a esa profundidad | sí | real |
| Límite de 16 GB | IQ3_XXS, 8K, q8_0, todo en la GPU | 14.730 MiB | 56,5; Canberra 0,82 s, ficha 2,65 s, código 2.537 tokens 46,0 s | sí | emulada en la 4090 |
| Límite de 16 GB | Q4_K_M, -ngl 36 (16 de 52 capas en la CPU), 8K, q8_0 | 14.413 MiB | 1,6; Canberra 24,6 s, ficha 96,1 s, código 815 s | sí, inutilizable | emulada en la 4090 |
| Límite de 12 GB | IQ2_XXS, 8K, q8_0 | 10.670 MiB | 74,9; código 1.395 tokens 18,7 s | respuestas bien, una explicación errónea | emulada en la 4090 |
| RTX 2000 Ada 16 GB | IQ3_XXS, 8K, q8_0, a través del endpoint | 14.392 MiB | de 13,6 a 14,4 | sí; respuesta final del agente vacía | real |
La más pequeña que pasó: la RTX 2000 Ada real de 16 GB con IQ3_XXS, a un tercio de la velocidad de la 4090. El README del ejemplo indica 21.508 MiB para su configuración (un peldaño de referencia); 21.907 MiB es el pico durante las pruebas principales, incluida la toma grabada.
Sin probar: un agente de programación de varios pasos sobre un repositorio real (solo llamadas sueltas a herramientas y un turno de agente); el endpoint alojado (solo un manager local); peticiones concurrentes; 128K o más en 24 GB; otra tarjeta de 24 GB (A5000, RTX 3090); una tarjeta real de 12 GB; un límite de 8 GB; NVFP4A16 en vLLM; vLLM o SGLang con el parser qwen3_coder; la calidad de la caché q4_0 más allá de la prueba de la aguja; los benchmarks de los autores.
Problemas pendientes
- Respuestas en el canal de razonamiento. Con el razonamiento encendido, la plantilla termina el prompt con
<|im_start|>assistant\n<think>\n. En algunas respuestas el modelo escribe la respuesta directamente y nunca emite</think>;--reasoning-format deepseekla devuelve entonces entera comoreasoning_content, concontent= "". Visto en la redacción (3 de 3) y en el turno final del agente (2 de 3 ejecuciones: la toma grabada en la 4090 y la ejecución en la RTX 2000 Ada; la primera ejecución del ejemplo sí tuvo contenido). Conenable_thinking=falsela plantilla inserta<think>\n\n</think>\n\ny la redacción volvió encontent(3.151 caracteres). Apaño propuesto a través de InferenceKey, sin ejecutar:--chat-template-kwargs '{"enable_thinking":false}'.main.pyseñala las respuestas vacías conanswer_text(). Sin probar: otros formatos de razonamiento,--reasoning-budget. Abierto. - El endpoint descarta
chat_template_kwargspor petición, así que el razonamiento no se puede apagar por petición a través de InferenceKey. Hueco conocido por nuestra parte, abierto. - La descarga parcial a la CPU no sirve para entrar en 16 GB con un modelo denso: 1,6 tokens/s con 16 de 52 capas en la CPU. Usa la cuantización más pequeña entera en la GPU.
- Primer arranque lento: el worker compila llama.cpp desde el código fuente en NVIDIA (5 min en el host de la 4090, 19 min 50 s en un host limitado). Todavía no hay binario CUDA precompilado. Abierto.
- La compilación del worker necesita
nvccen elPATHen algunas imágenes; el apaño está en el paso a paso de arriba. Abierto en el worker. - Prompt de sistema en chino por defecto: sin mensaje de sistema, la plantilla inyecta "你是南北阁,一款由BOSS直聘自主研发并训练的专业大语言模型。" ("Eres Nanbeige, un LLM profesional desarrollado y entrenado por BOSS Zhipin"); con herramientas y sin mensaje de sistema, otro prompt distinto en chino de experto en herramientas. Envía el tuyo.
- Ficha del modelo: la incoherencia de JobBench de arriba, y ninguna indicación para una sola GPU ni para GGUF.
- Calidad a 2 bits: IQ2_XXS explicó 9,8 como "8 in the hundredths place".
Vídeo de la demo
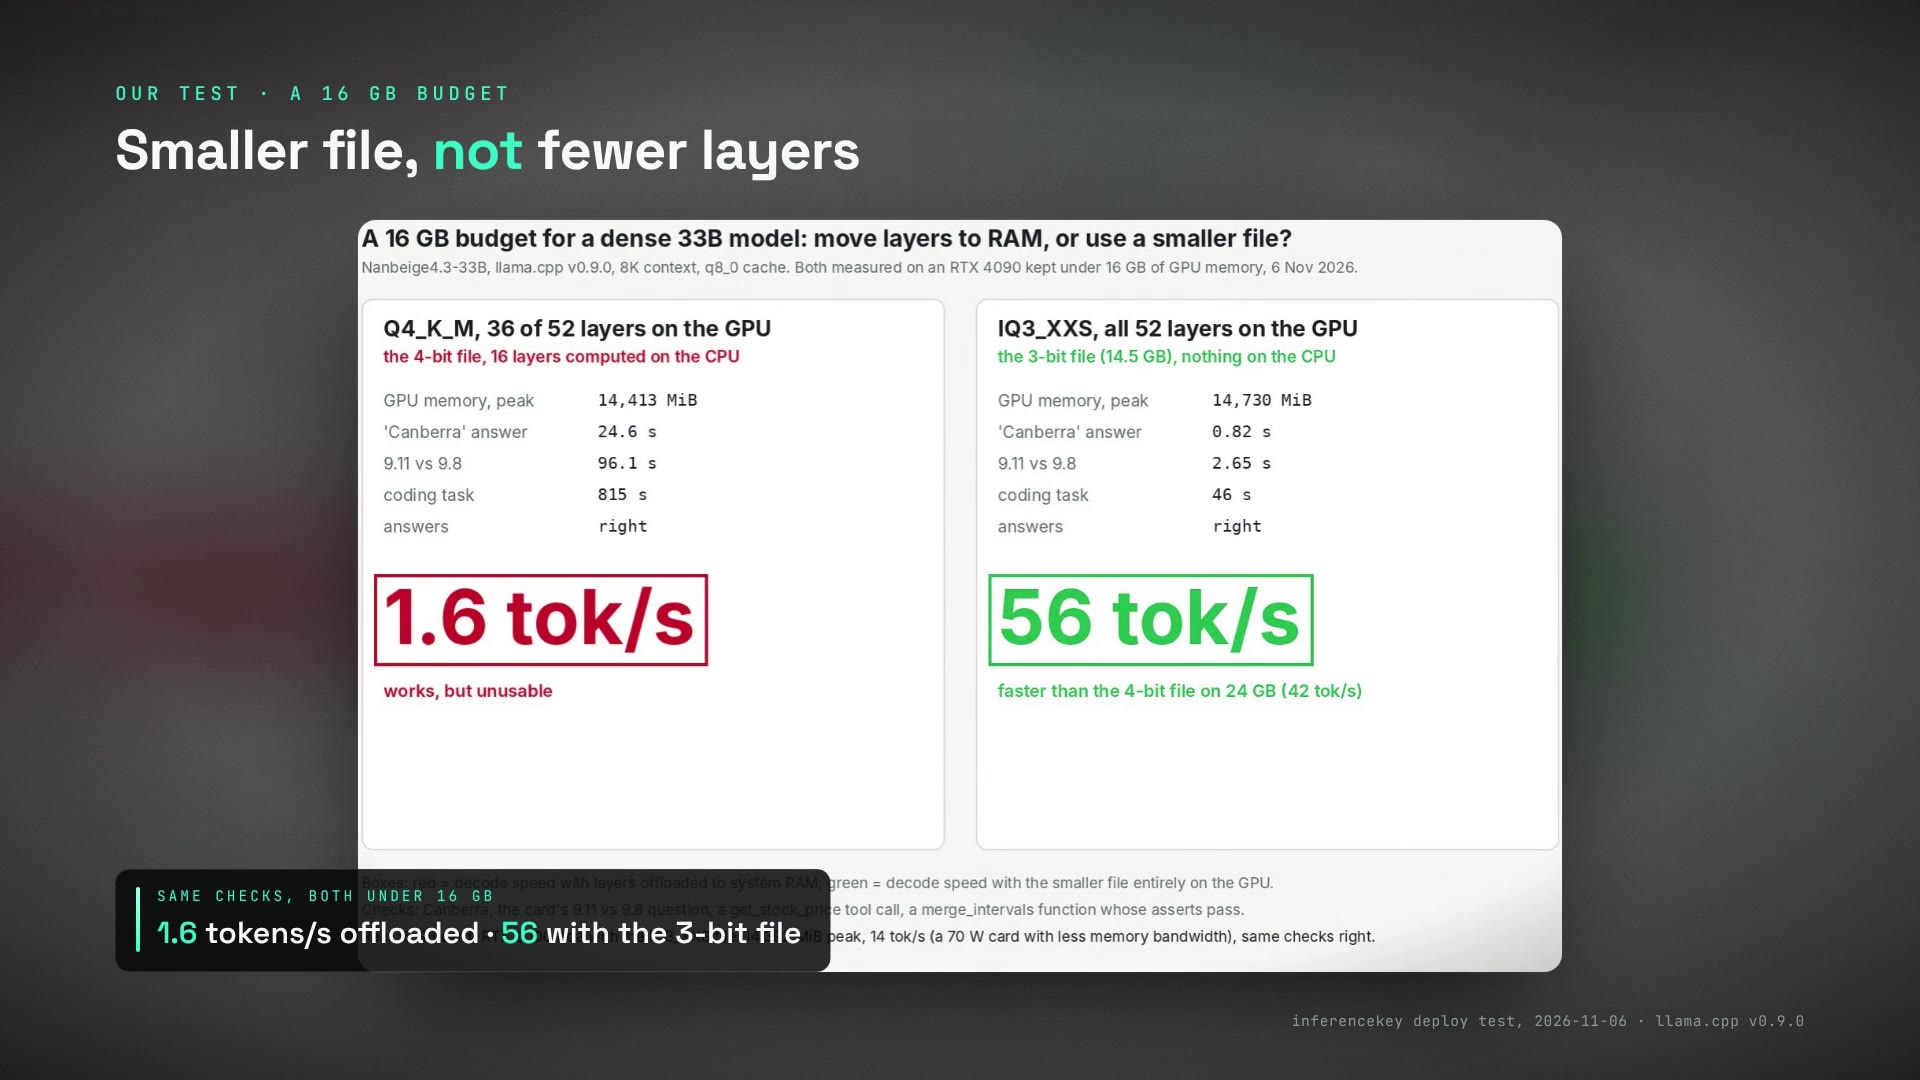
La demo narrada de 154 segundos: los benchmarks de los autores (atribuidos al equipo de Nanbeige), el despliegue en el panel en la RTX 4090, la pregunta de la ficha y el turno de agente (con la respuesta vacía narrada como la pega), los resultados de contexto largo y la escalera de memoria.
Fuentes
- Nanbeige/Nanbeige4.3-33B (ficha del modelo, config, plantilla de chat).
- Nanbeige/Nanbeige4.3-33B-Base.
- bartowski/Nanbeige_Nanbeige4.3-33B-GGUF.
- axteam/Nanbeige4.3-33B-NVFP4A16.
- Vídeo de noticias de AI Search, 2026-11-01 (donde lo vimos).
- Ejemplo del SDK, commit
10209c3596fe1fd28dd63a30442eb543e6a456cc.